
Nota del autor: A partir de la noticia de que Apple redujo el presupuesto diario de tokens de sus ingenieros de 300 a 200 dólares, analizamos cuatro mecanismos para gestionar el costo de las invocaciones de IA en equipos empresariales: niveles de presupuesto, aprobación de excepciones, uso de modelos por niveles y monitoreo del consumo.
Según Bloomberg, el mes pasado Apple redujo el presupuesto diario de tokens de algunos ingenieros de 300 a 200 dólares. Más adelante, planea bajarlo a 100 dólares diarios, mientras que algunos equipos no técnicos podrían contar con solo 25 dólares. Los empleados que necesiten más pueden solicitar una excepción a sus responsables. Además, algunos equipos pasarán a usar modelos más baratos o IA local ejecutada en el dispositivo.
No es un rumor. El 5 de noviembre de 2026, The Decoder publicó estas cifras citando el informe de Bloomberg y señaló que Microsoft, Tesla, Uber y Meta también habían puesto límites recientemente a su gasto interno en IA. El paso de las grandes empresas de «usar sin restricciones» a «usar con presupuesto» muestra que el costo de las invocaciones de IA ya es un problema que la dirección debe afrontar.
Qué te llevarás: Al terminar este artículo, conocerás las medidas concretas que ha tomado Apple para ajustar el presupuesto de tokens y tendrás un marco que podrás aplicar directamente para gestionar el costo de las invocaciones de IA en tu empresa. Incluye niveles de presupuesto, aprobación de excepciones, uso de modelos por niveles y monitoreo del consumo.
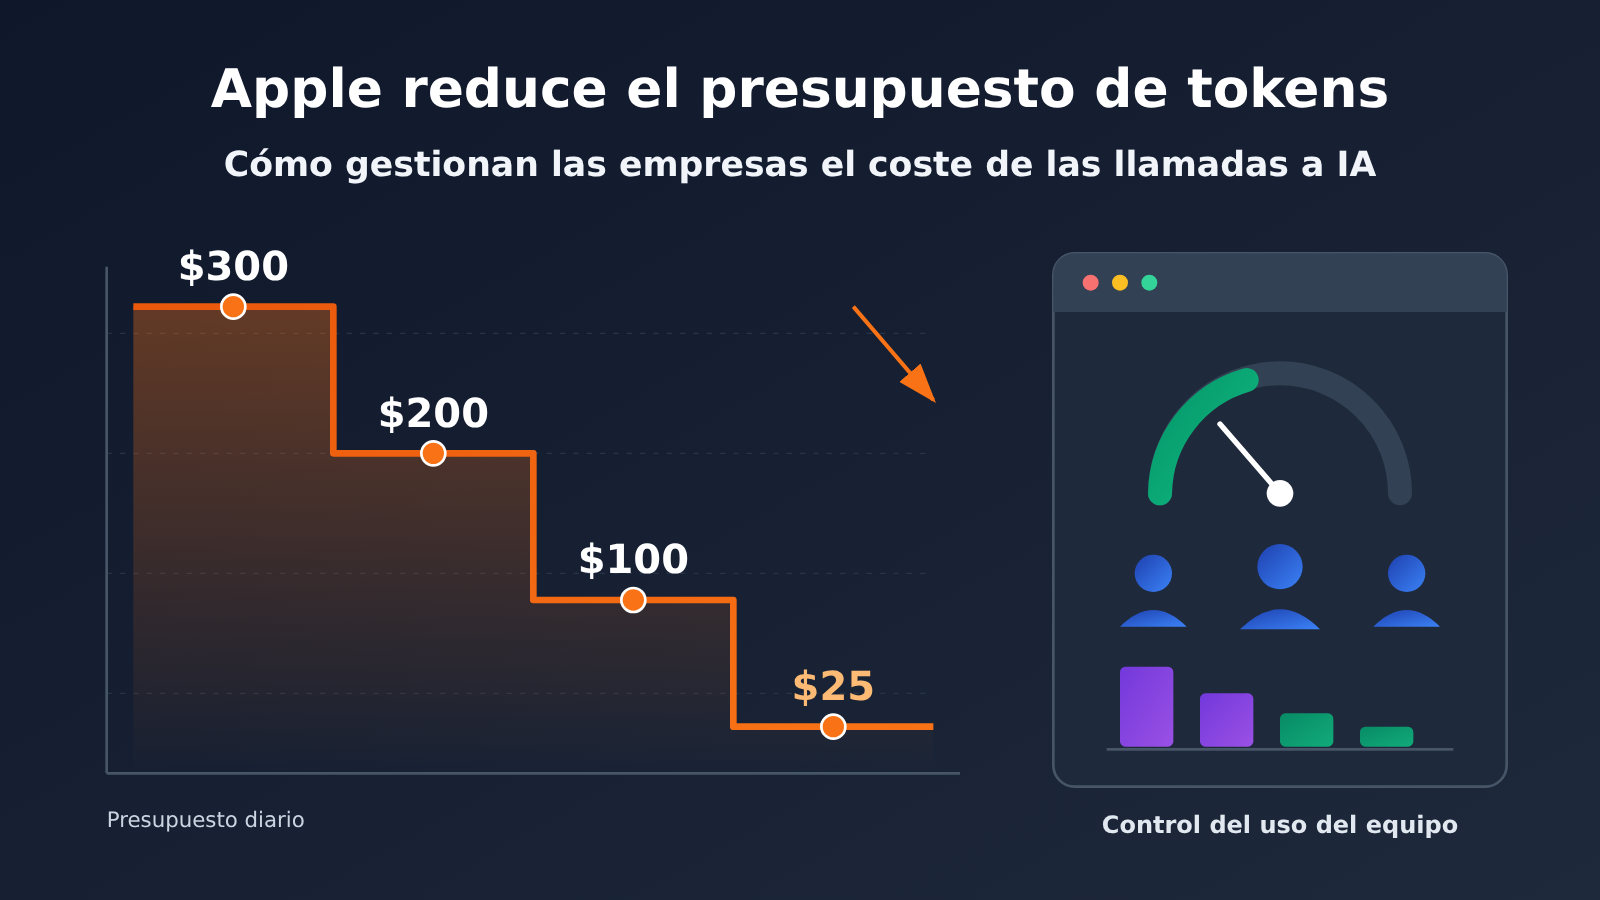
Apple reduce el presupuesto de tokens: resumen
| Dato | Detalle |
|---|---|
| Fuente | Información de Bloomberg recogida por The Decoder el 2026-11-05 |
| Afectados | Algunos ingenieros y equipos no técnicos |
| Ajuste aplicado | El mes pasado, el presupuesto diario de tokens se redujo de 300 a 200 dólares |
| Planes futuros | Podría bajar a 100 dólares diarios y, para algunos equipos no técnicos, hasta 25 dólares |
| Gestión de excesos | Los empleados pueden solicitar una excepción a la dirección |
| Modelos disponibles | Anthropic Claude, OpenAI ChatGPT, Google Gemini, entre otros |
| Alternativas | Algunos equipos recurren a modelos más baratos o a IA local en el dispositivo |
| Contexto | El nuevo CEO, John Ternus, impulsa medidas de eficiencia; el gasto en I+D creció un 32 % en el ejercicio fiscal 2026, principalmente por los costos de infraestructura e IA |
| Tendencia en el sector | Microsoft, Tesla, Uber y Meta también han limitado recientemente su gasto interno en IA |
Tres detalles sobre el ajuste del presupuesto de tokens de Apple
El primer detalle es que el presupuesto se calcula por persona y por día. Apple no se limita a asignar una partida anual a cada departamento, sino que establece una cuota diaria para cada empleado. Este nivel de detalle permite que cada persona vea directamente cuánto cuestan sus invocaciones de IA y facilita que la dirección ajuste las asignaciones según el puesto.
El segundo detalle es que los equipos técnicos y no técnicos tienen cuotas diferentes. La cuota prevista para los ingenieros ronda los 100 dólares, mientras que algunos equipos no técnicos podrían contar con solo 25 dólares: una diferencia de cuatro veces. Esto indica que Apple considera que el consumo de tokens al escribir código o ejecutar agentes no está en la misma escala que al redactar correos o preparar resúmenes.
El tercer detalle es que el límite no es absoluto. Los empleados pueden solicitar excepciones y se orienta a algunos equipos hacia modelos más baratos o modelos locales. La idea no es tanto «usar menos IA» como «reservar la capacidad de cómputo más cara para las tareas que lo merecen». Sin embargo, la información publicada no revela cómo clasifica Apple los modelos ni cómo aplica los límites; habrá que esperar para conocer esos detalles.
Por qué el costo de las llamadas a la IA lleva a las grandes empresas a restringir el presupuesto de tokens
La mayor diferencia entre el costo de las llamadas a la IA y una suscripción de software tradicional es que se cobra según el consumo y su costo marginal no es cero. Si un empleado abre 100 veces al día la misma herramienta SaaS, el precio no cambia. Pero si le pide a un Modelo de Lenguaje Grande que lea 100 documentos extensos, cada lectura genera un costo real en tokens. Cuando el uso se extiende a más de diez mil empleados, el gasto puede dispararse.
El gasto en investigación y desarrollo de Apple creció un 32 % en el año fiscal 2026. Los informes señalan que el aumento de los costos de infraestructura e IA fue uno de los factores que impulsaron ese crecimiento. En un contexto en el que el nuevo CEO busca optimizar la empresa, el gasto interno en IA se convierte en una partida fácil de cuantificar y ajustar. Microsoft, Tesla, Uber y Meta también establecieron límites durante el mismo período, lo que indica que no se trata de una decisión aislada.
Entre las reacciones internas, algunos empleados consideran que el límite anterior ya era demasiado generoso: para la mayoría de los puestos, era difícil gastar hasta 300 dólares al día. Esto apunta a un problema común: muchas empresas fijan presupuestos para IA sin calcularlos bien al principio de su adopción y, cuando los reducen más adelante, es fácil que surjan controversias.
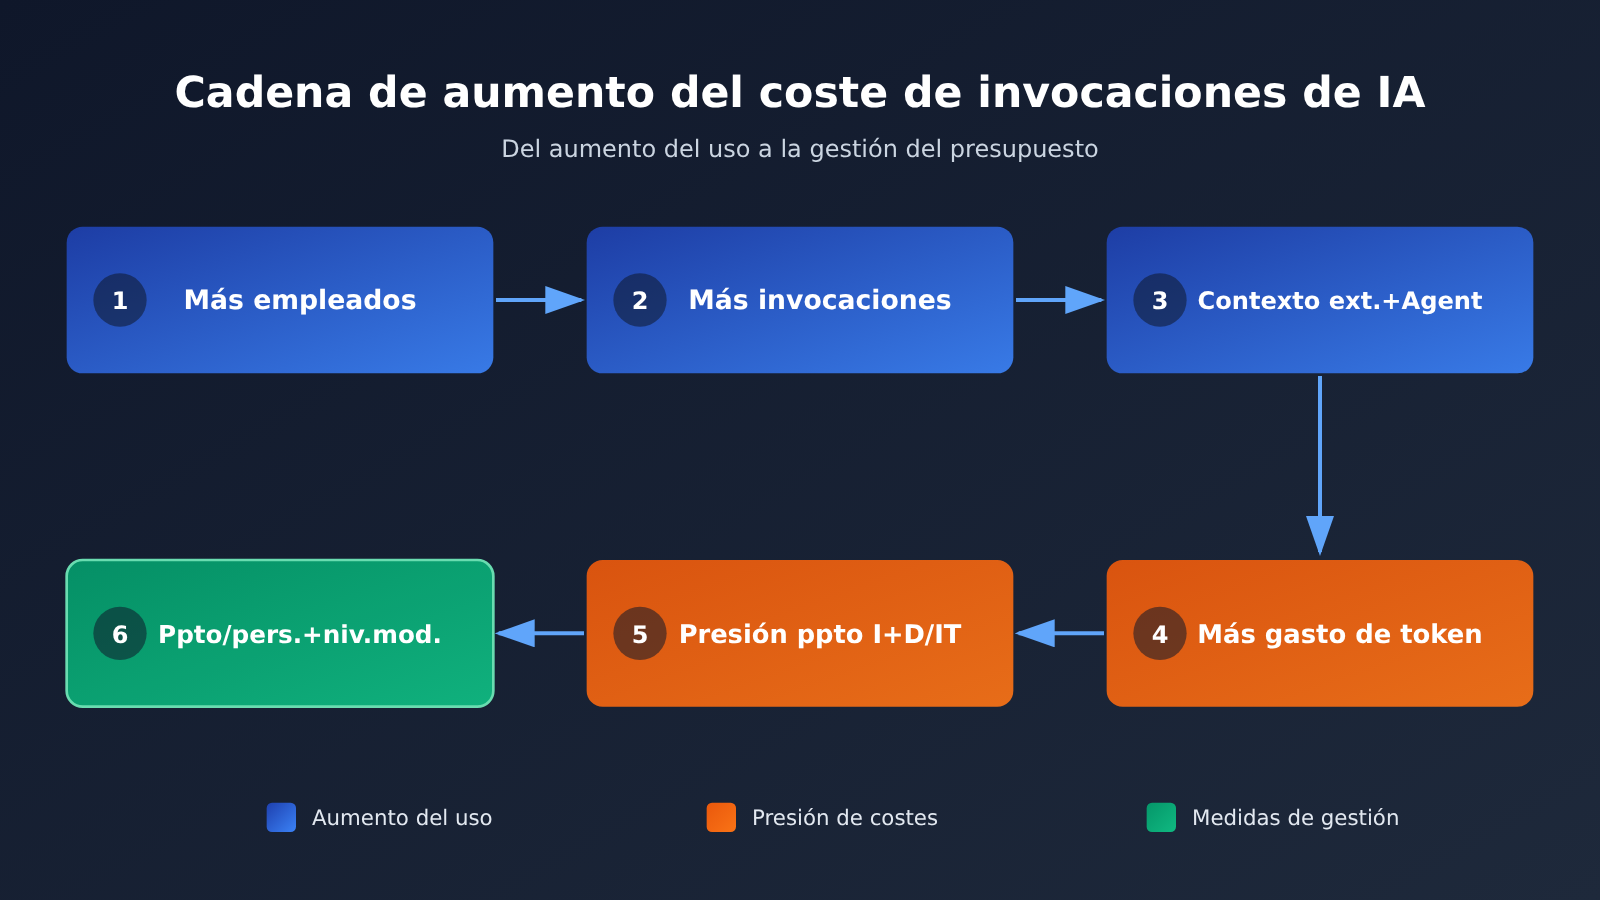
4 mecanismos para gestionar el costo del uso de IA en equipos empresariales
Si analizamos el enfoque de Apple, podemos extraer 4 mecanismos de gestión reutilizables. Funcionan en conjunto: los presupuestos establecen límites, las aprobaciones aportan flexibilidad, los niveles reducen costos y el monitoreo garantiza que se cumplan.
Mecanismo 1: establecer presupuestos de tokens por nivel según el rol
La clave del presupuesto por persona está en «establecer niveles», no en repartirlo por igual. Cada puesto usa la IA de forma muy distinta: asignar la misma cifra a todos puede dejar a los ingenieros sin recursos suficientes o mantener sin usar buena parte de la cuota de quienes la necesitan poco. La siguiente tabla presenta un ejemplo de niveles inspirado en el enfoque de Apple; las cifras concretas deben calcularse a partir del uso histórico de tu equipo.
| Nivel de rol | Tareas habituales | Enfoque presupuestario | Nivel de modelo predeterminado |
|---|---|---|---|
| Desarrollo e investigación principales | Generación de código, programación con agentes, análisis de documentos largos | Cuota alta, calculada por día, con posibilidad de solicitar excepciones | Modelo insignia + modelo de gama media |
| Puestos técnicos generales | Revisión de código, creación de scripts, documentación técnica | Cuota media, cercana al nivel para ingenieros previsto en el plan de Apple | Principalmente modelos de gama media |
| Puestos de negocio no técnicos | Correos electrónicos, resúmenes, traducción, organización de información | Cuota baja, tomando como referencia el nivel de Apple de hasta 25 dólares | Principalmente modelos ligeros |
| Proyectos piloto / nuevos proyectos | Validación exploratoria | Cuota temporal específica, con fecha límite | Acceso según las necesidades |
Para definir los niveles, conviene consultar primero el uso real de los últimos 1-3 meses y revisar tanto la mediana como los valores altos de cada puesto. Después, fija el presupuesto por encima de la mediana y por debajo de esos valores altos. Así, la mayoría tendrá suficiente para su trabajo diario y los pocos usuarios intensivos podrán recurrir al proceso de excepciones, con un costo de gestión mínimo.
Mecanismo dos: aprobar excepciones en lugar de aplicar un límite rígido
Apple permite que los empleados que superan su cuota soliciten una excepción a la dirección, una práctica que merece la pena considerar. Un límite completamente rígido puede dejar tareas importantes a medias, mientras que no establecer ningún límite hace que el presupuesto pierda sentido. Para diseñar la aprobación de excepciones, se pueden tener en cuenta estos puntos:
- Definir condiciones claras: por ejemplo, agotar la cuota diaria o necesitar un uso intensivo durante varios días consecutivos para un proyecto;
- Limitar la duración de la aprobación: conceder la cuota excepcional por día o por proyecto y retirarla automáticamente al vencimiento, para evitar que lo «temporal» se vuelva «permanente»;
- Pedir una breve justificación: indicar el tipo de tarea y el resultado esperado, para poder evaluar después si valió la pena el costo de esas invocaciones de IA;
- Revisar el conjunto cada mes: si una persona o equipo solicita excepciones con frecuencia, es señal de que su presupuesto base es demasiado bajo; conviene ajustar su nivel en lugar de seguir aprobando excepciones.
Mecanismo tres: modelos por niveles y cambio automático a un nivel inferior
Según el reporte, Apple está trasladando a algunos equipos a modelos más económicos o a IA local en el dispositivo. Detrás de esta decisión está la forma más eficaz de reducir los costos de uso de IA: asignar modelos según la dificultad de la tarea. Los modelos ligeros pueden resolver muchas tareas cotidianas; solo unas pocas tareas complejas necesitan realmente un modelo de gama alta.
| Nivel de modelo | Tareas adecuadas | Características de costo | Plataformas disponibles |
|---|---|---|---|
| Modelos de gama alta (como las versiones avanzadas de Claude, GPT y Gemini) | Razonamiento complejo, cambios de código en varios archivos, análisis para decisiones importantes | Mayor precio por uso; conviene usarlos cuando sea necesario | APIYI apiyi.com, API oficiales de cada proveedor |
| Modelos de gama media | Programación habitual, redacción técnica, extracción estructurada | Equilibrio entre calidad y costo | APIYI, API oficiales de cada proveedor |
| Modelos ligeros | Resúmenes, traducción, clasificación, organización de formatos | Bajo precio por uso; adecuados para invocaciones frecuentes | APIYI, API oficiales de cada proveedor |
| Modelos en el dispositivo / locales | Tareas sensibles desde el punto de vista de la privacidad, trabajo sin conexión, completado sencillo | Sin cargos por uso, pero con costos de hardware y operación | Despliegue local |
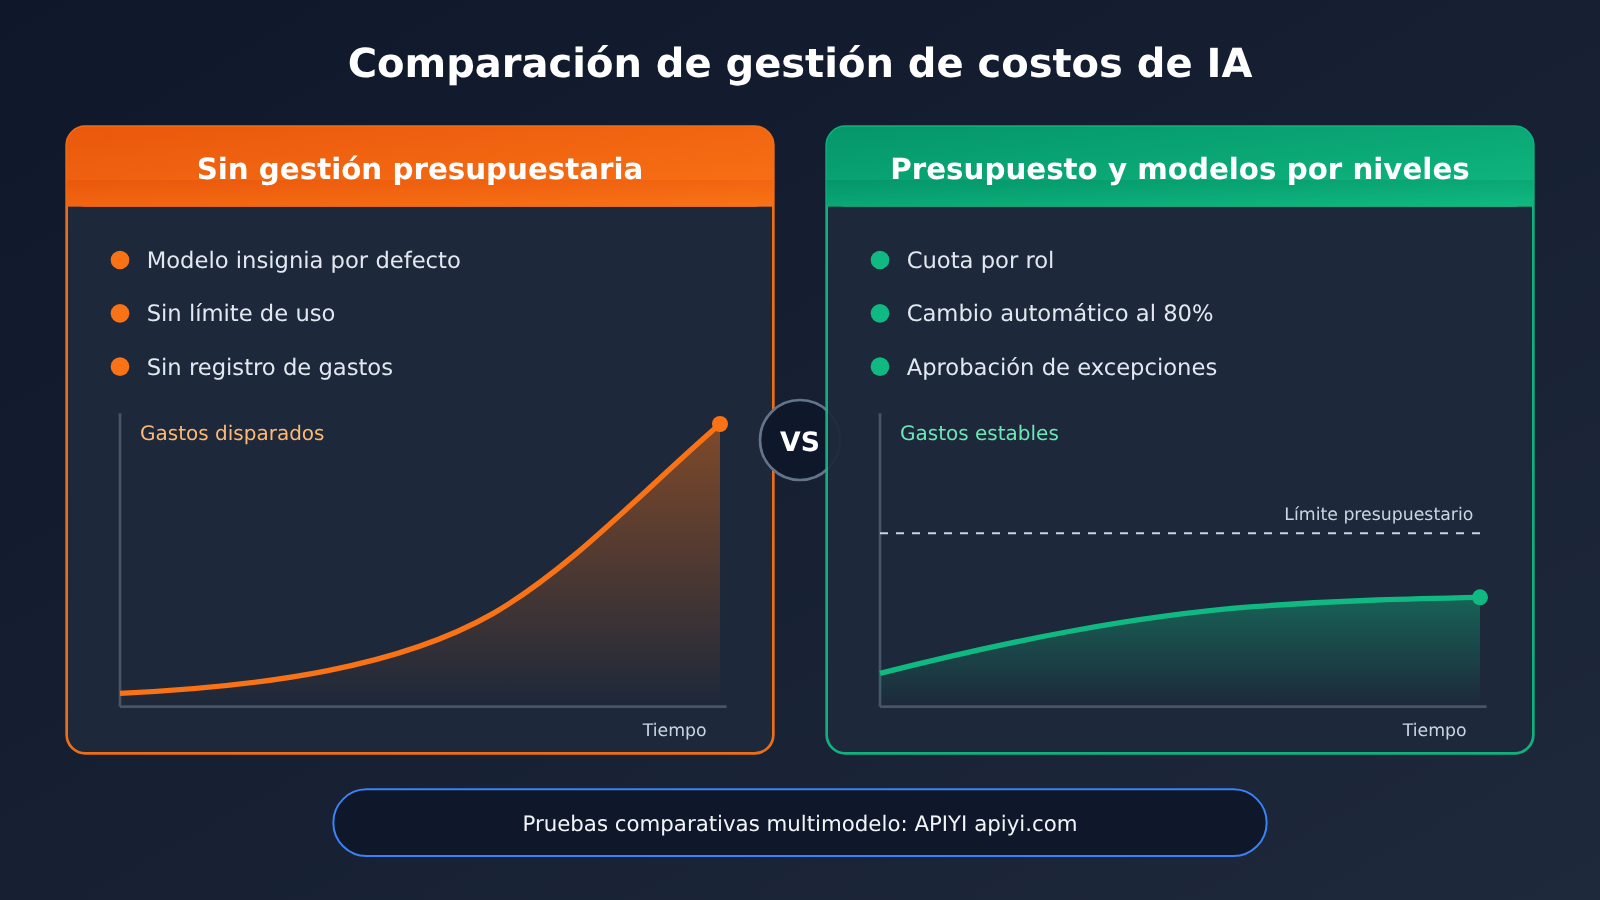
Una regla habitual para el cambio automático es pasar las tareas no críticas al siguiente nivel de modelos cuando el consumo alcanza cierto porcentaje del presupuesto, por ejemplo, el 80 %. Una vez agotada la cuota, solo quedan disponibles los modelos ligeros o se recurre a la aprobación de una excepción. Así, los empleados no se quedan de repente sin acceso y pueden seguir trabajando con menos interrupciones. La diferencia real de precios entre modelos depende de las tarifas vigentes de cada plataforma, por lo que conviene hacer los cálculos antes de implementar este sistema.
💡 Recomendación: Para organizar los modelos por niveles, primero hay que poder cambiar fácilmente entre proveedores. Con una plataforma de agregación como APIYI apiyi.com, basta una clave API para invocar modelos de OpenAI, Claude, Gemini y otros proveedores. La interfaz es compatible con el formato de OpenAI, por lo que solo hay que cambiar el parámetro model para dirigir las solicitudes entre niveles.
Mecanismo cuatro: el monitoreo de uso hace viable el presupuesto
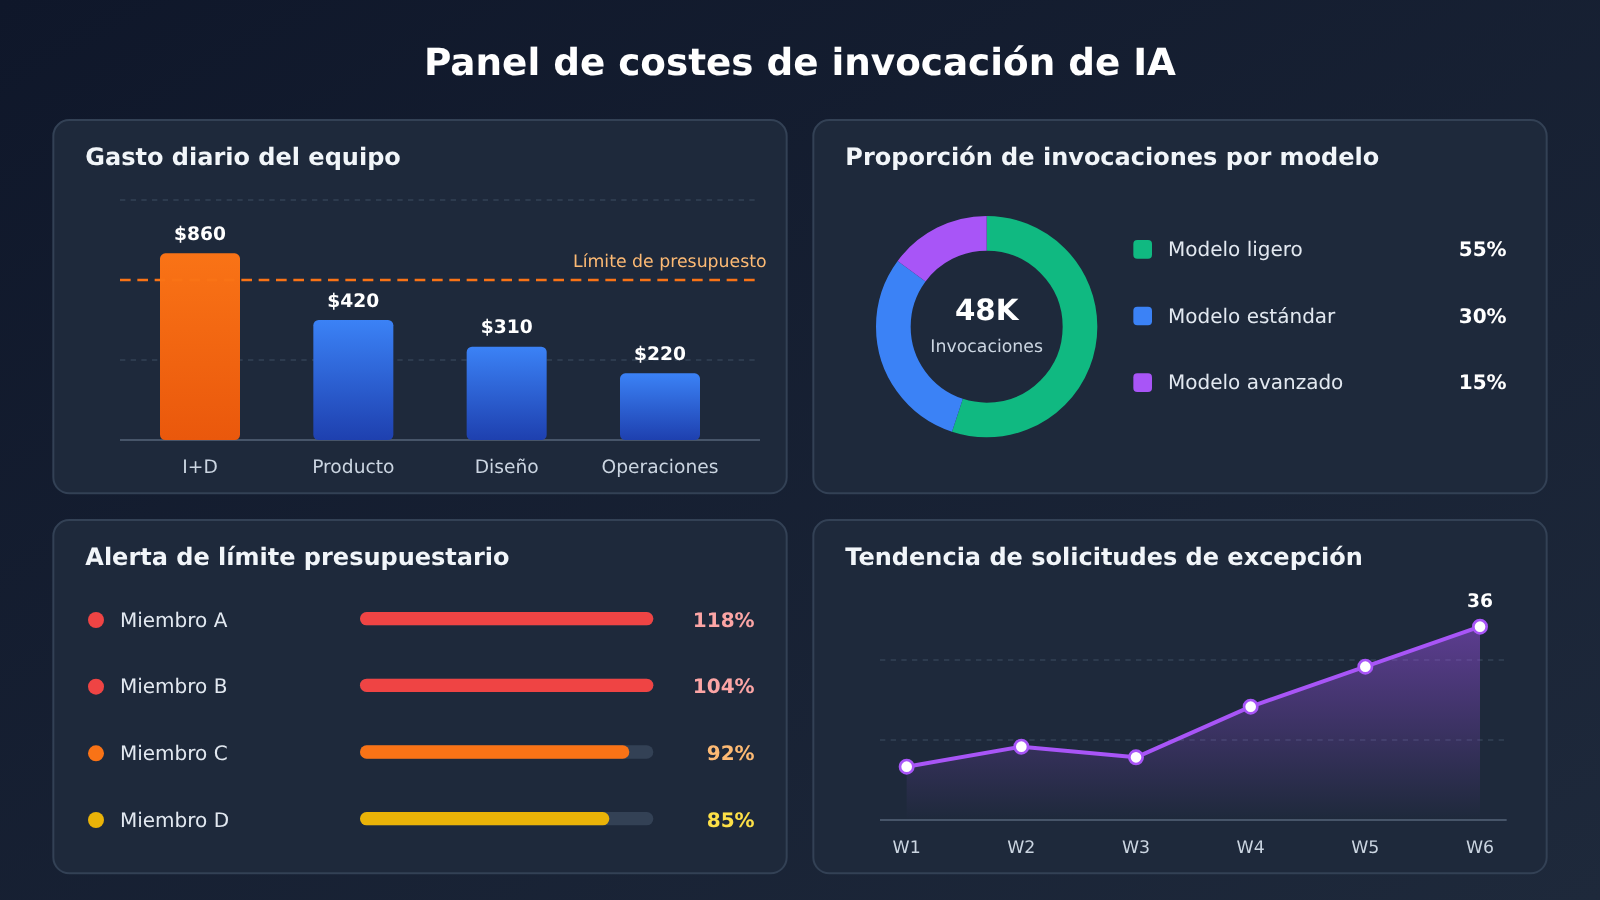
Sin monitoreo, el presupuesto de tokens por persona no pasa de ser una norma sobre el papel. Su función no es solo detectar gastos excesivos: también aporta datos para definir los niveles de presupuesto y de modelos. Como mínimo, conviene seguir estos indicadores:
| Indicador de monitoreo | Nivel de desglose | Uso |
|---|---|---|
| Consumo diario de tokens y costo | Por persona y por equipo | Evaluar si el presupuesto es razonable y detectar invocaciones anómalas |
| Proporción de invocaciones de cada modelo | Por equipo y por tipo de tarea | Evaluar si la estrategia de niveles está funcionando |
| Frecuencia con que se alcanza el límite de presupuesto | Por persona y por semana | Identificar los puestos cuyo nivel de presupuesto necesita ajustarse |
| Número de solicitudes de excepción y tasa de aprobación | Por equipo y por mes | Revisar si el mecanismo de aprobación es demasiado flexible o demasiado estricto |
| Costo promedio por tarea | Por tipo de tarea | Identificar los escenarios de alto costo donde más conviene optimizar |
Desde el punto de vista técnico, puedes registrar el campo usage de cada solicitud en la puerta de enlace de IA de la empresa y después agrupar los datos mediante etiquetas de empleados o equipos. Si usas una plataforma de terceros, comprueba primero si el nivel de desglose de sus estadísticas de uso permite distribuir los costos como necesitas. Para saber si admite subcuentas, límites por miembro y alertas, consulta las capacidades reales de la plataforma.
Primeros pasos para controlar los costos de las llamadas a IA: enrutamiento de modelos según el presupuesto
Este ejemplo simplificado muestra cómo llevar al código un presupuesto por usuario y un cambio automático a modelos más ligeros. Empecemos con una llamada básica y prestemos atención al uso de tokens que devuelve cada solicitud:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI: una sola clave para acceder a modelos de distintos proveedores
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Priorizar un modelo ligero para tareas cotidianas
    messages=[{"role": "user", "content": "把这段会议纪要整理成 5 条要点:..."}]
)
print(resp.choices[0].message.content)
print("本次消耗 tokens:", resp.usage.total_tokens)
Ver la implementación completa: presupuesto por rol y cambio automático de modelo
from collections import defaultdict
from datetime import date
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Niveles de modelos: reemplaza estos nombres por los disponibles en la plataforma
TIERS = ["your-premium-model", "your-standard-model", "your-light-model"]

# Precios de referencia (dólares / millón de tokens): introduce las tarifas vigentes de la plataforma
PRICE = {
    "your-premium-model":  {"in": 0.0, "out": 0.0},
    "your-standard-model": {"in": 0.0, "out": 0.0},
    "your-light-model":    {"in": 0.0, "out": 0.0},
}

# Presupuesto diario por rol (dólares), inspirado en el enfoque por niveles de Apple
DAILY_BUDGET = {"engineer": 100, "non_tech": 25}

spent = defaultdict(float)   # (user, date) -> gasto acumulado del día
exceptions = set()           # (user, date) con excepciones aprobadas


def pick_model(user: str, role: str, preferred: str) -> str:
    key = (user, date.today())
    budget = DAILY_BUDGET[role]
    used = spent[key]
    if key in exceptions:
        return preferred
    if used >= budget:
        return TIERS[-1]                      # Presupuesto agotado: solo se permite el modelo ligero
    if used >= budget * 0.8:
        idx = min(TIERS.index(preferred) + 1, len(TIERS) - 1)
        return TIERS[idx]                     # Cerca del límite: bajar un nivel
    return preferred


def chat(user: str, role: str, prompt: str, preferred: str = "your-standard-model"):
    model = pick_model(user, role, preferred)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    p = PRICE[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    spent[(user, date.today())] += cost
    print(f"[{user}] model={model} cost=${cost:.4f} today=${spent[(user, date.today())]:.2f}")
    return resp.choices[0].message.content


# Ejemplo de uso
print(chat("alice", "non_tech", "把这封邮件翻译成英文:..."))
Este ejemplo omite el almacenamiento persistente, la concurrencia y el flujo de aprobación. En producción, conviene guardar spent en una base de datos o caché e integrar la aprobación de excepciones con el sistema interno de tickets. La idea central no cambia: registrar el gasto de cada llamada y consultar el presupuesto antes de elegir el modelo.
🚀 Primeros pasos: si quieres comprobar cómo funciona el enrutamiento por niveles, puedes obtener crédito gratuito de prueba para nuevos usuarios a través de APIYI apiyi.com. Usa la misma clave para comparar la calidad y el consumo de modelos de distintos niveles en tus tareas reales, y después decide cuál será el modelo predeterminado para cada puesto.
Análisis del impacto del ajuste del presupuesto de tokens de Apple
Impacto para los desarrolladores
- La conciencia de costos se vuelve esencial: en las grandes empresas, los desarrolladores tendrán que prestar atención a cuántos tokens consume cada tarea y moderar las operaciones de alto consumo, como el uso de contextos largos y los reintentos repetidos.
- Se valora más la capacidad de trabajar con varios modelos: quienes sepan elegir el modelo adecuado para cada tarea y delegar las tareas sencillas a modelos ligeros o locales serán más eficientes cuando se reduzca el presupuesto.
- Crece la demanda de pasarelas de IA y capas de enrutamiento: las empresas necesitan un punto de entrada unificado para contabilizar el consumo, establecer límites y cambiar a modelos de menor costo. Esto aumentará el trabajo de desarrollo de infraestructura interna.
Impacto para los responsables de empresas
- De «fomentar el uso» a «gestionar con precisión»: los costos de invocación de IA pasan a formar parte de la gestión presupuestaria habitual y deben asignarse y revisarse como los recursos en la nube.
- Las cifras del presupuesto deben tener fundamento: los empleados de Apple consideraban que las cuotas anteriores eran «demasiado generosas», lo que muestra que fijar límites sin datos puede generar costos de ajuste más adelante.
- No hay que ignorar los riesgos de comunicación interna: según la noticia, algunos empleados temen que los recortes de costos sean el preludio de despidos. Si la reducción del presupuesto no se explica, puede interpretarse fácilmente como una señal de cambios organizativos más amplios.
La siguiente tabla resume los riesgos organizativos más comunes al controlar los costos de invocación de IA y las posibles formas de afrontarlos:
| Riesgo | Manifestación | Cómo afrontarlo |
|---|---|---|
| Ansiedad entre empleados | Interpretar los límites como una señal de despidos | Explicar de antemano que el objetivo es optimizar la estructura de costos y hacer públicos los criterios de asignación por niveles |
| Descenso de la productividad | Interrupción de tareas clave por falta de cuota | Configurar el cambio automático a modelos de menor costo en lugar de cortar el acceso y ofrecer una vía rápida para solicitar excepciones |
| Sobrecostos ocultos | Los empleados recurren a cuentas personales o herramientas no aprobadas | Garantizar que los canales internos sean suficientes y fáciles de usar, en línea con los requisitos de cumplimiento |
| Carga de aprobaciones | Demasiadas solicitudes de excepción que saturan a los responsables | Aumentar periódicamente las cuotas básicas en función de los datos para reducir las solicitudes innecesarias |
| Dificultad para evaluar los resultados | Medir solo el gasto, sin tener en cuenta los resultados | Revisar conjuntamente el costo por tarea y la calidad del resultado |
Preguntas frecuentes
P1: ¿Cuánto redujo Apple el presupuesto de tokens?
Según Bloomberg, el mes pasado Apple redujo el presupuesto diario de tokens de algunos ingenieros de 300 a 200 dólares. Más adelante podría bajarlo a 100 dólares diarios y, en algunos equipos no técnicos, hasta 25 dólares. Los empleados que necesiten más pueden solicitar una excepción a la dirección.
P2: ¿Cómo se establece un presupuesto razonable de tokens por persona?
Conviene empezar por analizar el uso real de cada puesto durante los últimos 1-3 meses y establecer niveles según el rol. El presupuesto básico debe quedar por encima del uso mediano y por debajo del uso más alto. Para quienes consuman más, se pueden aprobar excepciones y ajustar los niveles cada mes según la frecuencia con que se alcanza el límite y el número de excepciones.
P3: Además de Apple, ¿qué otras empresas están limitando el gasto interno en IA?
El informe menciona que Microsoft, Tesla, Uber y Meta también han establecido límites recientemente para su gasto interno en IA, aunque no revela las medidas ni los importes concretos.
P4: ¿Clasificar los modelos por niveles puede afectar la calidad del trabajo?
La clave está en asignar el modelo según la tarea, en lugar de reducir la capacidad para todo. Para resúmenes, traducciones y ajustes de formato, normalmente basta con un modelo ligero; el razonamiento complejo y los cambios críticos en el código pueden reservarse para un modelo de gama alta. Antes de implementarlo, conviene comparar los resultados con tareas reales. Por ejemplo, en APIYI apiyi.com puedes probar modelos de varios niveles con una misma clave API y elegir el nivel predeterminado una vez que hayas confirmado que la calidad es aceptable.
P5: Si un equipo pequeño o mediano no tiene una pasarela interna de IA, ¿cómo puede empezar a gestionar rápidamente el costo de las invocaciones?
Puedes empezar con tres pasos: unificar el punto de acceso, registrar en el código el uso de cada solicitud y establecer un modelo predeterminado para cada tarea. Con plataformas de agregación como APIYI apiyi.com, una sola clave API permite alternar entre modelos de OpenAI, Claude y Gemini, entre otros, con pago por uso. Esto facilita poner en marcha el enrutamiento entre varios modelos. Para saber si la plataforma admite límites o alertas por miembro, conviene consultarlo directamente.
Puntos clave para gestionar los costos de uso de IA
- Apple ya ha reducido el presupuesto: el presupuesto diario de tokens para ingenieros pasó de 300 a 200 dólares, y la empresa planea seguir bajándolo.
- Es mejor asignar presupuestos por niveles que por igual: el consumo varía mucho entre puestos técnicos y no técnicos; en los niveles previstos por Apple, la asignación más alta es cuatro veces mayor que la más baja.
- Las excepciones aportan flexibilidad: el límite no es absoluto; se puede solicitar una asignación temporal para tareas críticas.
- Asignar modelos por niveles ahorra dinero: deja las tareas cotidianas a modelos ligeros o locales y reserva los modelos más avanzados para las tareas complejas.
- El monitoreo hace viable el presupuesto: registra los tokens y costos por persona y equipo, y ajusta los niveles según los datos.
- La comunicación interna es imprescindible: una reducción presupuestaria puede generar inquietud por posibles despidos, así que conviene explicar el objetivo de antemano.
- Empieza probando el enrutamiento: con APIYI apiyi.com puedes comparar modelos de distintos niveles usando una sola clave API y validar tu estrategia.
Resumen
La reducción del presupuesto diario de tokens para los empleados de Apple es una señal clara de que el uso de IA en las grandes empresas está pasando de la «expansión a escala» al cálculo detallado de costos. Para los equipos empresariales, las conclusiones se pueden resumir en tres puntos:
- Asignar el presupuesto por niveles: establece una asignación por persona según el rol y el tipo de tarea, basándote en datos históricos y no en intuiciones;
- Crear mecanismos flexibles: combina la aprobación de excepciones con el cambio automático a modelos de menor costo para evitar que una interrupción abrupta afecte al trabajo crítico;
- Organizar los modelos por niveles: asigna a cada tarea el modelo adecuado y optimiza continuamente la estrategia mediante el monitoreo del uso.
Si tu equipo está planificando cómo gestionar los costos de uso de IA, puedes empezar con una prueba piloto en uno o dos casos de uso frecuentes y asignarles modelos de distintos niveles. Una vez que tengas datos reales de costo y calidad, podrás ampliar la estrategia. Con APIYI apiyi.com puedes crear rápidamente un entorno de pruebas con varios modelos; el saldo gratuito para nuevos usuarios basta para hacer una comparación inicial.
📚 Referencias
- Apple slashes internal AI budgets, with deeper cuts still planned: resumen de The Decoder sobre un reportaje de Bloomberg
- Enlace:
the-decoder.com/apple-slashes-internal-ai-budgets-with-deeper-cuts-still-planned/ - Descripción: incluye cifras sobre los ajustes al presupuesto diario de tokens de Apple, reacciones de los empleados y contexto sobre cómo otras empresas limitan el gasto en IA.
Autor: equipo técnico de APIYI
Intercambio técnico: contáctanos desde la página principal de APIYI para conversar sobre la gestión de costos de uso de IA en empresas y las prácticas de integración de múltiples modelos.


