
Note de l’auteur : à partir de l’annonce de la réduction par Apple du budget quotidien de tokens de ses ingénieurs, passé de 300 à 200 dollars, cet article détaille quatre mécanismes pour aider les équipes à maîtriser leurs coûts d’utilisation de l’IA : niveaux de budget, approbation des exceptions, répartition des modèles et suivi de la consommation.
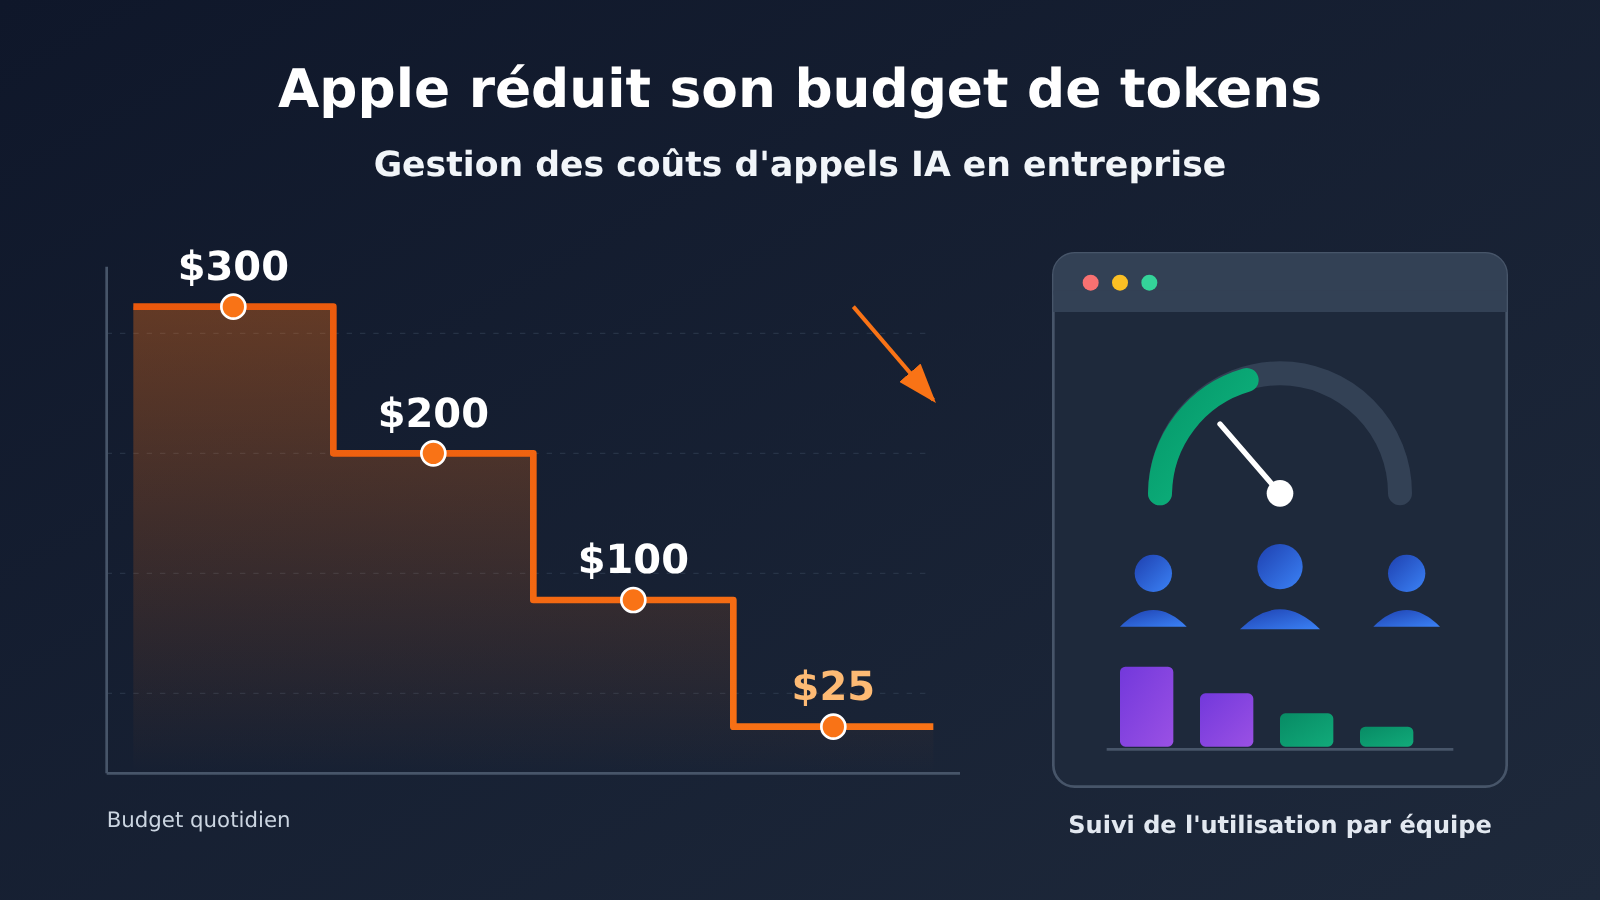
Selon Bloomberg, Apple a réduit le mois dernier le budget quotidien de tokens de certains ingénieurs de 300 à 200 dollars. L’entreprise prévoit de le ramener ensuite à 100 dollars par jour, tandis que certaines équipes non techniques pourraient ne disposer que de 25 dollars. Les employés qui ont besoin d’un budget supérieur peuvent demander une exception à leur direction. Certaines équipes seront également orientées vers des modèles moins coûteux ou des IA locales exécutées sur leurs appareils.
Ce n’est pas une simple rumeur. Le 5 novembre 2026, The Decoder a repris ces chiffres publiés par Bloomberg et indiqué que Microsoft, Tesla, Uber et Meta avaient également plafonné récemment leurs dépenses internes en IA. Les grandes entreprises passent d’une utilisation libre à une utilisation encadrée par un budget : signe que le coût des appels à l’IA est devenu un sujet que leurs directions doivent traiter de front.
Ce que vous allez retenir : cet article présente les mesures prises par Apple pour réduire les budgets de tokens, ainsi qu’un cadre directement applicable pour gérer les coûts d’utilisation de l’IA en entreprise : niveaux de budget, approbation des exceptions, répartition des modèles et suivi de la consommation.
Apple réduit les budgets de tokens : l’essentiel
| Élément | Détails |
|---|---|
| Source | Bloomberg, repris par The Decoder le 5 novembre 2026 |
| Personnes concernées | Certains ingénieurs et certaines équipes non techniques |
| Réduction déjà appliquée | Le budget quotidien de tokens est passé de 300 à 200 dollars le mois dernier |
| Prochaines étapes | Le budget pourrait descendre à 100 dollars par jour, voire à 25 dollars pour certaines équipes non techniques |
| Dépassement | Les employés peuvent demander une dérogation à la direction |
| Modèles disponibles | Anthropic Claude, OpenAI ChatGPT, Google Gemini, entre autres |
| Solutions de rechange | Certaines équipes se tournent vers des modèles moins chers ou une IA locale exécutée sur l’appareil |
| Contexte | Le nouveau CEO John Ternus cherche à rationaliser les dépenses ; les dépenses de R&D ont augmenté de 32 % pendant l’exercice 2026, principalement en raison des coûts d’infrastructure et d’IA |
| Tendance dans le secteur | Microsoft, Tesla, Uber et Meta ont également limité récemment leurs dépenses internes en IA |
Trois détails sur la réduction du budget de tokens chez Apple
Premier détail : le budget est calculé par personne et par jour. Apple ne se contente pas d’allouer une enveloppe annuelle à chaque service : elle fixe un quota quotidien pour chaque employé. Cette approche permet à chacun de voir directement ce que coûte son utilisation de l’IA et facilite l’adaptation des budgets aux différents postes.
Deuxième détail : les équipes techniques et non techniques ont des quotas distincts. Le budget visé pour les ingénieurs tourne autour de 100 dollars, tandis que certaines équipes non techniques pourraient n’avoir que 25 dollars, soit quatre fois moins. Apple considère donc que la consommation de tokens liée à la programmation ou à l’exécution d’agents n’est pas du même ordre que celle nécessaire pour rédiger des courriels ou produire des résumés.
Troisième détail : le plafond n’est pas absolu. Les employés peuvent demander une dérogation, et certaines équipes sont orientées vers des modèles moins chers ou des modèles locaux. L’objectif n’est pas tant de « moins utiliser l’IA » que de « réserver la puissance de calcul coûteuse aux tâches qui en valent la peine ». Le reportage ne précise toutefois pas comment Apple classe les modèles ni comment elle applique les limites : il faudra attendre d’autres informations sur ces points.
Pourquoi le coût des appels à l’IA pousse les grandes entreprises à limiter les budgets de tokens
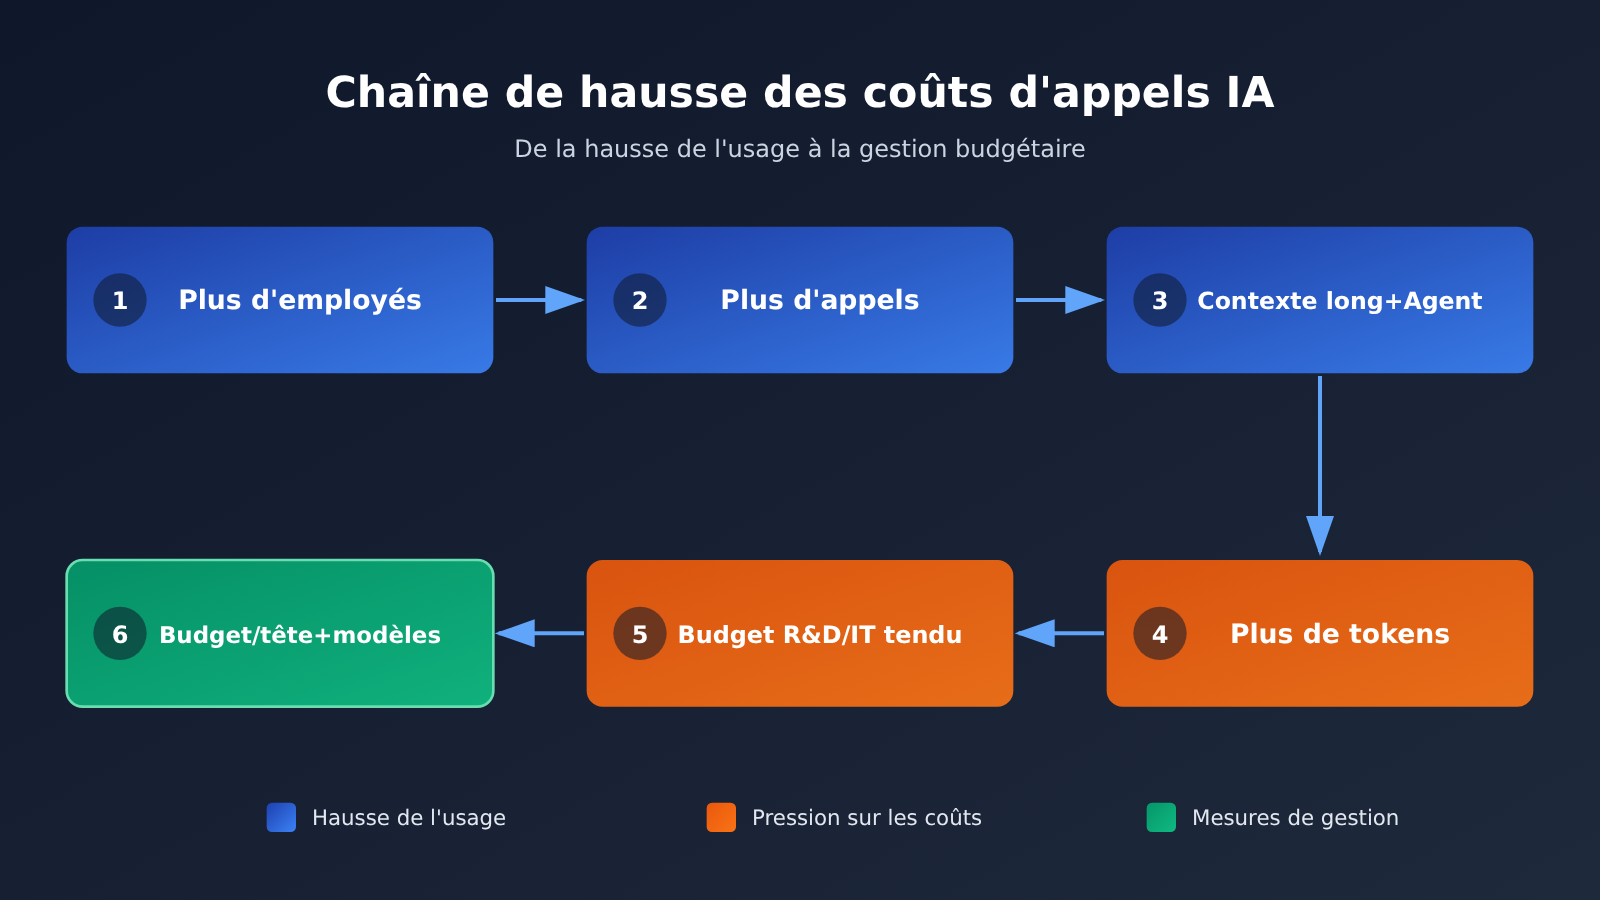
La principale différence entre le coût des appels à l’IA et celui d’un abonnement logiciel classique, c’est que la facturation dépend de l’usage et que le coût marginal n’est pas nul. Un employé peut ouvrir 100 fois par jour le même outil SaaS sans changer le montant de l’abonnement. Mais s’il demande chaque jour à un grand modèle de langage de lire 100 longs documents, chaque appel entraîne un coût réel en tokens. À l’échelle de dizaines de milliers de personnes, la facture augmente rapidement.
Les dépenses de R&D d’Apple ont augmenté de 32 % pendant l’exercice 2026. Selon les informations publiées, cette hausse s’explique notamment par l’augmentation des coûts d’infrastructure et d’IA. Dans un contexte où le nouveau PDG cherche à rationaliser les dépenses, les coûts internes liés à l’IA constituent un poste facile à mesurer et à ajuster. Microsoft, Tesla, Uber et Meta ont également imposé des limites à la même période, ce qui montre qu’il ne s’agit pas d’une décision isolée.
En interne, certains employés estiment que les anciens plafonds étaient trop généreux : pour la plupart des postes, il était difficile d’atteindre la limite de 300 dollars par jour. Cela met en lumière un problème courant : au début du déploiement de l’IA, de nombreuses entreprises fixent des budgets sans calcul précis. Lorsqu’elles les réduisent par la suite, cela peut facilement susciter des tensions.
4 mécanismes pour gérer les coûts d’utilisation de l’IA en entreprise
En examinant l’approche d’Apple, on peut dégager quatre mécanismes réutilisables. Ils fonctionnent ensemble : le budget fixe les limites, les approbations apportent de la souplesse, le choix des modèles réduit les coûts et le suivi garantit le respect des règles.
Mécanisme 1 : définir des budgets de tokens par rôle
La clé d’un budget individuel, c’est de le différencier plutôt que d’appliquer une moyenne. Les usages de l’IA varient beaucoup d’un poste à l’autre : avec un même montant pour tout le monde, les ingénieurs risquent de manquer de ressources, tandis que les utilisateurs occasionnels laisseront une partie de leur quota inutilisée. Le tableau ci-dessous propose des niveaux inspirés de l’approche d’Apple. Les montants précis sont à calculer à partir de l’historique d’utilisation de votre équipe.
| Niveau de rôle | Tâches typiques | Approche budgétaire | Gamme de modèles par défaut |
|---|---|---|---|
| Équipe de R&D principale | Génération de code, programmation avec des agents, analyse de longs documents | Quota élevé, calculé par jour, avec possibilité de demander une exception | Modèles haut de gamme + modèles intermédiaires |
| Autres postes techniques | Revue de code, écriture de scripts, documentation technique | Quota intermédiaire, proche du niveau prévu pour les ingénieurs dans le plan d’Apple | Principalement des modèles intermédiaires |
| Postes métier non techniques | Courriels, résumés, traduction, organisation de documents | Quota réduit, en référence au niveau d’Apple pouvant descendre jusqu’à 25 dollars | Principalement des modèles légers |
| Projets pilotes / nouveaux projets | Tests exploratoires | Quota temporaire dédié, avec une date limite | Accès selon les besoins |
Pour définir ces niveaux, commencez par examiner l’utilisation réelle des 1 à 3 derniers mois. Repérez la médiane et les niveaux d’utilisation élevés pour chaque rôle, puis fixez le budget entre les deux. Ainsi, la plupart des personnes disposent d’un quota suffisant au quotidien, tandis que les quelques utilisateurs intensifs passent par une procédure d’exception. Cela permet de limiter les efforts de gestion.
Mécanisme 2 : approuver les exceptions plutôt qu’imposer une limite rigide
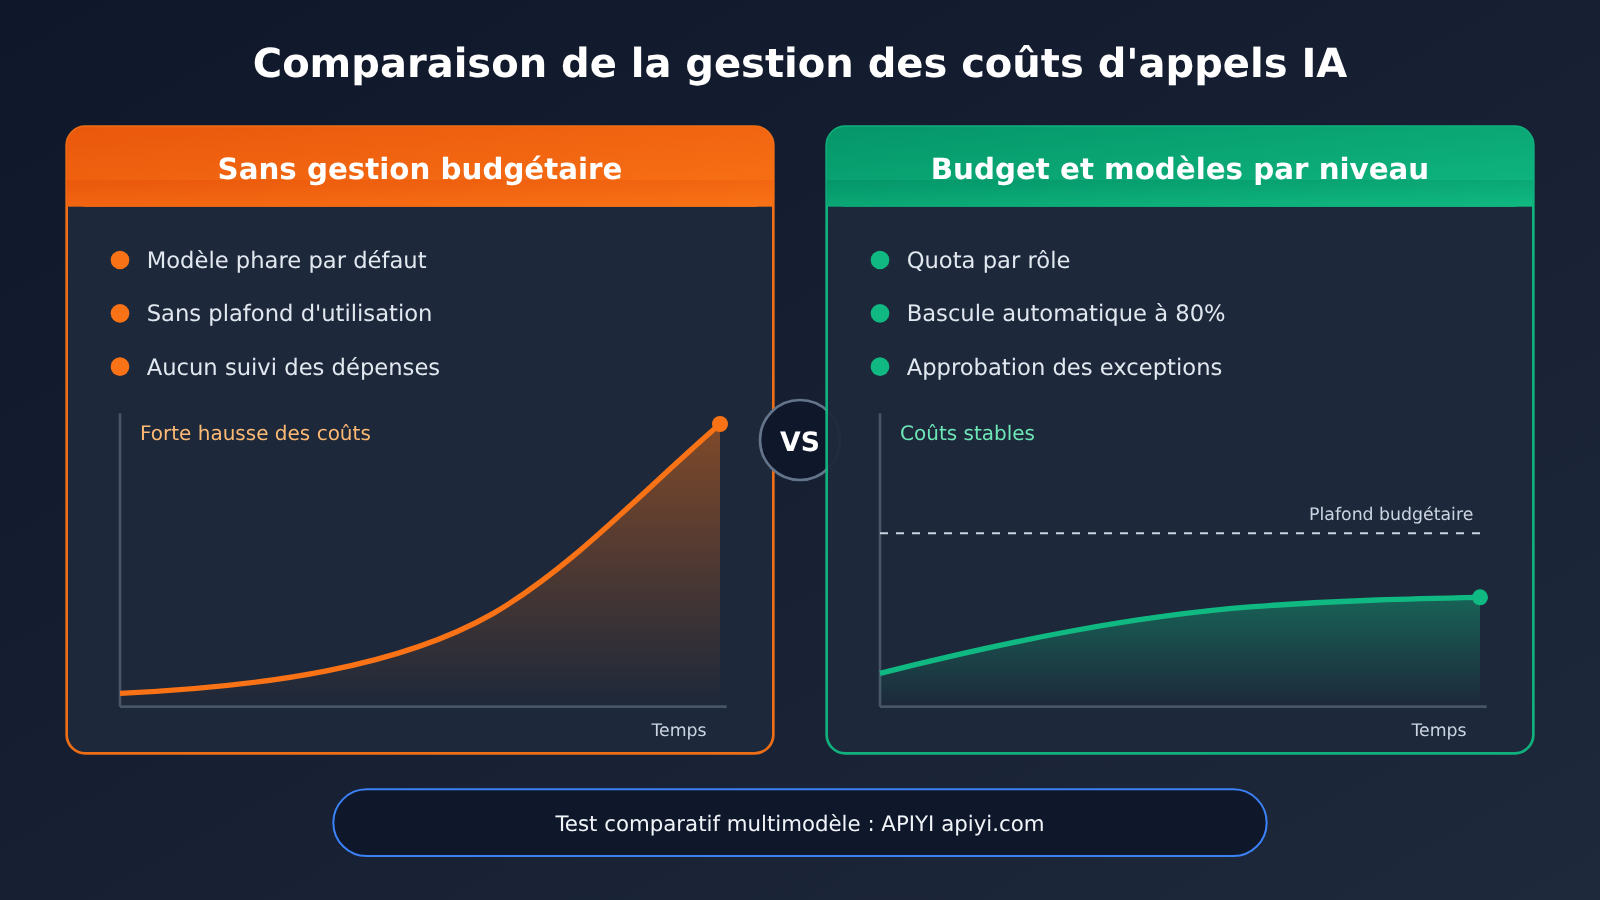
Apple permet aux employés qui dépassent leur quota de demander une exception à leur direction : c’est une pratique dont on peut s’inspirer. Un plafond strict risque de bloquer des tâches essentielles en cours de route, tandis qu’une absence totale de limite rend le budget inutile. Voici quelques pistes pour encadrer les exceptions :
- Définir les conditions de déclenchement : par exemple, un quota journalier épuisé ou un projet nécessitant des appels intensifs pendant plusieurs jours consécutifs ;
- Limiter la durée de l’autorisation : accorder le quota supplémentaire pour une journée ou un projet, puis le retirer automatiquement à échéance, pour éviter que le « temporaire » ne devienne permanent ;
- Demander une brève justification : préciser le type de tâche et le résultat attendu pour pouvoir évaluer ensuite si le coût des appels à l’IA était justifié ;
- Faire un bilan mensuel : si une personne ou une équipe demande souvent des exceptions, c’est probablement que son budget de base est trop bas. Mieux vaut alors revoir son niveau de budget que continuer à approuver des exceptions.
Mécanisme 3 : hiérarchiser les modèles et prévoir un basculement automatique
Selon l’article, Apple oriente certaines équipes vers des modèles moins coûteux ou des solutions d’IA locales sur l’appareil. Cette approche repose sur l’un des moyens les plus efficaces de réduire le coût des appels à l’IA : choisir le modèle selon la difficulté de la tâche. Un modèle léger suffit pour de nombreuses tâches courantes ; seules quelques tâches complexes nécessitent réellement un modèle haut de gamme.
| Niveau de modèle | Tâches adaptées | Coût | Plateformes disponibles |
|---|---|---|---|
| Modèles haut de gamme (comme les modèles Claude, GPT et Gemini les plus avancés) | Raisonnement complexe, modification de code dans plusieurs fichiers, analyse de décisions critiques | Coût unitaire le plus élevé, à utiliser selon les besoins | APIYI apiyi.com, API officielles des fournisseurs |
| Modèles intermédiaires | Programmation courante, rédaction technique, extraction structurée | Bon équilibre entre qualité et coût | APIYI, API officielles des fournisseurs |
| Modèles légers | Résumé, traduction, classification, mise en forme | Coût unitaire faible, adapté aux appels fréquents | APIYI, API officielles des fournisseurs |
| Modèles sur l’appareil / locaux | Données sensibles, travail hors ligne, complétion simple | Pas de facturation à l’usage, mais des coûts de matériel et d’exploitation | Déploiement local |
Une règle courante consiste à basculer automatiquement les tâches non critiques vers le niveau de modèle inférieur lorsque l’utilisation atteint une certaine part du budget, par exemple 80 %. Une fois le quota épuisé, seuls les modèles légers restent disponibles, ou une procédure d’exception est déclenchée. Les employés ne se retrouvent ainsi pas soudainement privés d’accès et peuvent travailler plus sereinement. Les écarts de prix réels entre les modèles dépendent des tarifs en vigueur sur chaque plateforme : mieux vaut faire ses propres calculs avant la mise en place.
💡 Conseil : la hiérarchisation des modèles suppose de pouvoir passer facilement de l’un à l’autre. Avec une plateforme d’agrégation comme APIYI apiyi.com, une seule clé API permet d’invoquer des modèles OpenAI, Claude, Gemini et autres. L’interface est compatible avec le format OpenAI : il suffit donc de modifier le paramètre
modelpour router les requêtes entre les différents niveaux.
Mécanisme 4 : suivre l’utilisation pour faire respecter les budgets
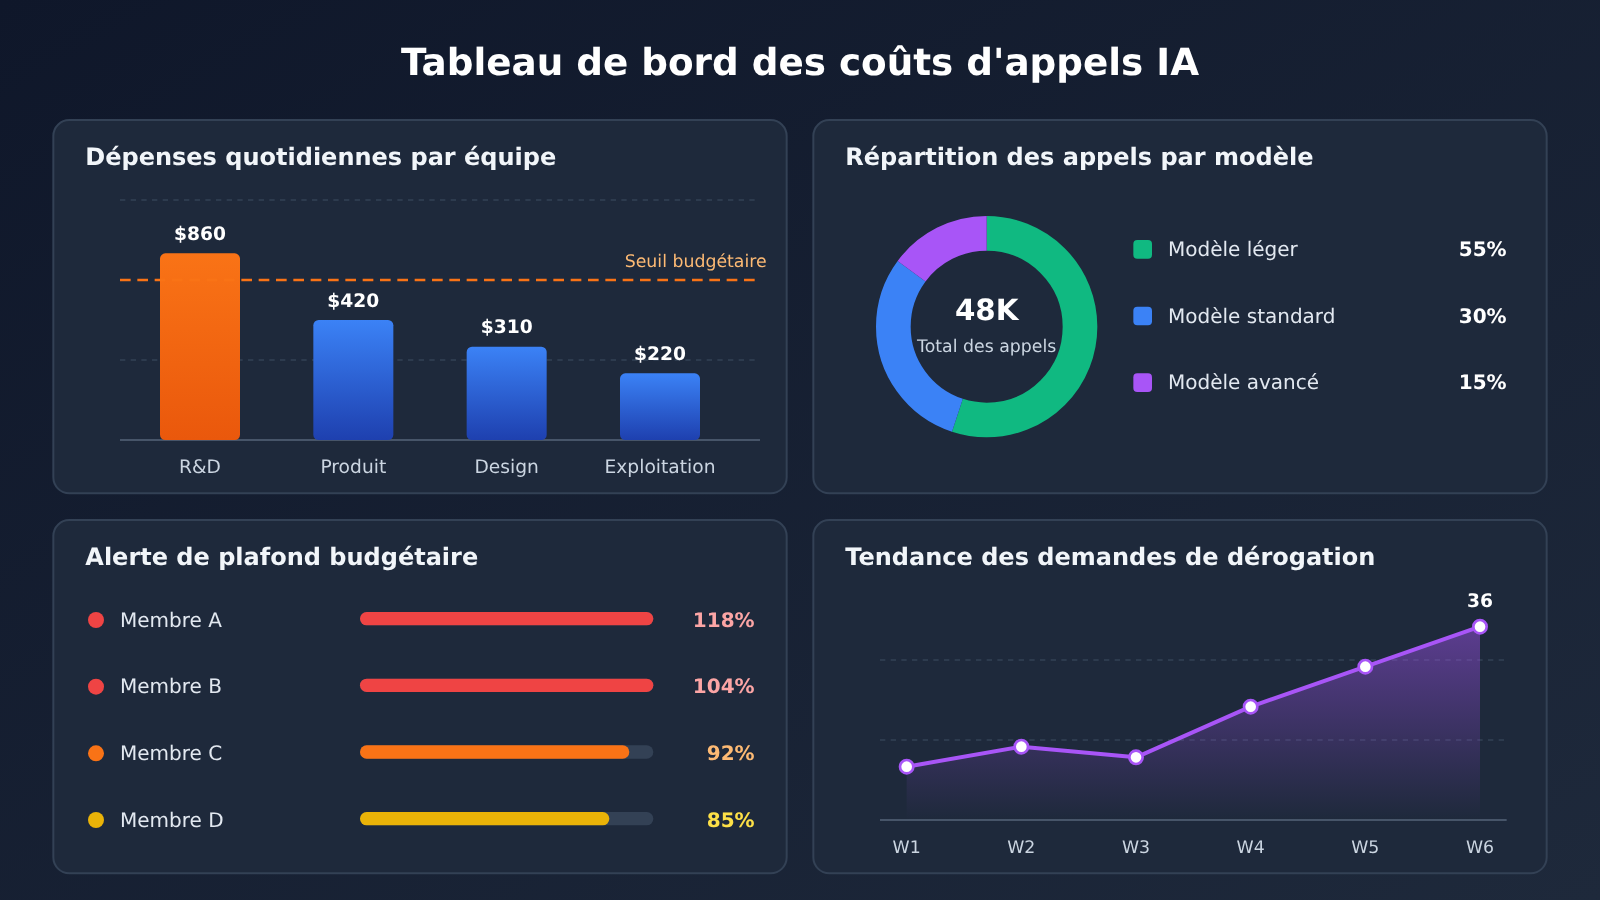
Sans suivi, un budget de tokens par personne reste une simple règle sur le papier. Le suivi ne sert pas seulement à repérer les dépassements : il fournit aussi les données nécessaires pour définir les niveaux de budget et répartir les usages entre les modèles. Voici les indicateurs à suivre au minimum :
| Indicateur | Niveau de détail | Utilité |
|---|---|---|
| Consommation quotidienne de tokens et coût | Par personne, par équipe | Vérifier si les budgets sont adaptés et repérer les appels anormaux |
| Répartition des appels par modèle | Par équipe, par type de tâche | Évaluer l’efficacité de la stratégie de répartition entre les modèles |
| Fréquence d’atteinte du plafond budgétaire | Par personne, par semaine | Repérer les postes dont le niveau de budget doit être ajusté |
| Nombre de demandes d’exception et taux d’approbation | Par équipe, par mois | Vérifier si le mécanisme d’approbation est trop souple ou trop strict |
| Coût moyen par tâche | Par type de tâche | Repérer les usages coûteux à optimiser en priorité |
Sur le plan technique, vous pouvez enregistrer le champ usage de chaque requête au niveau de la passerelle IA interne, puis agréger les données à l’aide des étiquettes associées aux employés ou aux équipes. Si vous utilisez une plateforme tierce, vérifiez d’abord que le niveau de détail de ses statistiques d’utilisation répond à vos besoins de répartition des coûts. Pour les sous-comptes, les plafonds par membre et les alertes, fiez-vous aux fonctionnalités réellement proposées par la plateforme.
Maîtriser rapidement les coûts des appels à l’IA : un routage des modèles adapté au budget
Voici un exemple simplifié pour mettre en œuvre un « budget par personne + une rétrogradation automatique ». Commençons par un appel simple : l’essentiel est de lire le nombre de tokens renvoyé avec chaque réponse.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI : une seule clé pour les modèles de plusieurs fournisseurs
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Privilégier un modèle léger pour les tâches courantes
    messages=[{"role": "user", "content": "把这段会议纪要整理成 5 条要点:..."}]
)
print(resp.choices[0].message.content)
print("本次消耗 tokens:", resp.usage.total_tokens)
Voir l’implémentation complète : budget par rôle et routage avec rétrogradation automatique
from collections import defaultdict
from datetime import date
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Niveaux de modèles : remplacez ces noms par ceux disponibles sur la plateforme
TIERS = ["your-premium-model", "your-standard-model", "your-light-model"]

# Tarifs indicatifs (dollars / million de tokens) : renseignez les prix actuels de la plateforme
PRICE = {
    "your-premium-model":  {"in": 0.0, "out": 0.0},
    "your-standard-model": {"in": 0.0, "out": 0.0},
    "your-light-model":    {"in": 0.0, "out": 0.0},
}

# Budget quotidien par rôle (en dollars), inspiré de l'approche par niveaux d'Apple
DAILY_BUDGET = {"engineer": 100, "non_tech": 25}

spent = defaultdict(float)   # (user, date) -> montant dépensé dans la journée
exceptions = set()           # (user, date) ayant obtenu une dérogation


def pick_model(user: str, role: str, preferred: str) -> str:
    key = (user, date.today())
    budget = DAILY_BUDGET[role]
    used = spent[key]
    if key in exceptions:
        return preferred
    if used >= budget:
        return TIERS[-1]                      # Budget épuisé : seul le modèle léger reste disponible
    if used >= budget * 0.8:
        idx = min(TIERS.index(preferred) + 1, len(TIERS) - 1)
        return TIERS[idx]                     # Proche de la limite : passer au niveau inférieur
    return preferred


def chat(user: str, role: str, prompt: str, preferred: str = "your-standard-model"):
    model = pick_model(user, role, preferred)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    p = PRICE[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    spent[(user, date.today())] += cost
    print(f"[{user}] model={model} cost=${cost:.4f} today=${spent[(user, date.today())]:.2f}")
    return resp.choices[0].message.content


# Exemple d'utilisation
print(chat("alice", "non_tech", "把这封邮件翻译成英文:..."))
Cet exemple ne couvre pas le stockage persistant, la concurrence ni le processus d’approbation. En production, il est conseillé de placer spent dans une base de données ou un cache, et de relier les demandes de dérogation au système interne de tickets. Le principe reste le même : comptabiliser chaque appel et vérifier le budget avant de choisir le modèle.
🚀 Pour commencer : si vous voulez d’abord tester le routage par niveaux, APIYI apiyi.com propose aux nouveaux utilisateurs un crédit d’essai gratuit. Avec une seule clé API, comparez la qualité et la consommation des modèles de différents niveaux sur vos tâches réelles, puis choisissez le modèle par défaut de chaque rôle.
Analyse des effets de l’ajustement des budgets de tokens chez Apple
Effets pour les développeurs
- La maîtrise des coûts devient une compétence de base : dans les grandes entreprises, les développeurs doivent commencer à surveiller le nombre de tokens consommés par chaque tâche et à limiter les opérations coûteuses, comme l’utilisation de contextes longs ou les tentatives répétées.
- La capacité à utiliser plusieurs modèles gagne en importance : les développeurs capables de choisir le bon modèle pour chaque tâche et de confier les tâches simples à un modèle léger ou local seront plus efficaces lorsque les budgets se resserrent.
- La demande en passerelles IA et en couches de routage augmente : les entreprises ont besoin d’un point d’entrée unique pour suivre les dépenses, fixer des limites et basculer vers des modèles moins coûteux. Le développement de ce type d’infrastructure interne va donc prendre de l’ampleur.
Effets pour les responsables d’entreprise
- De « l’encouragement à l’utilisation » à une « gestion affinée » : les coûts d’invocation des modèles d’IA entrent dans la gestion budgétaire courante. Il faut désormais répartir les dépenses et les analyser, comme pour les ressources cloud.
- Les montants alloués doivent être justifiés : certains employés d’Apple jugeaient les anciens quotas « trop généreux ». Fixer des limites au jugé peut donc entraîner des coûts d’ajustement par la suite.
- Le risque lié à la communication interne ne doit pas être négligé : selon les informations rapportées, certains employés craignent que les réductions de coûts annoncent des licenciements. Sans explication, un resserrement du budget peut facilement être interprété comme le signe de changements organisationnels plus importants.
Le tableau ci-dessous résume les risques organisationnels courants lors de la mise en place d’un contrôle des coûts d’invocation de l’IA, ainsi que des pistes pour y répondre :
| Risque | Manifestation | Pistes de réponse |
|---|---|---|
| Anxiété des employés | Les limites sont interprétées comme un signe de licenciements | Expliquer à l’avance que l’objectif est d’optimiser la structure des coûts et rendre publics les critères de répartition |
| Baisse de productivité | Des tâches essentielles sont interrompues faute de quota | Prévoir un basculement automatique vers un modèle moins coûteux plutôt qu’une coupure nette, et proposer une procédure d’exception rapide |
| Dépassements de budget cachés | Les employés se tournent vers des comptes personnels ou des outils non approuvés | Veiller à ce que les canaux internes soient suffisants et faciles à utiliser, tout en respectant les exigences de conformité |
| Charge d’approbation | Les demandes d’exception sont trop nombreuses et mobilisent excessivement les responsables | Relever régulièrement les quotas de base en fonction des données afin de réduire les demandes inutiles |
| Difficulté à évaluer les résultats | Seules les dépenses sont prises en compte, pas les résultats | Analyser ensemble le coût par tâche et la qualité des résultats |
Questions fréquentes (FAQ)
Q1 : De combien Apple a-t-elle réduit les budgets de tokens ?
Selon Bloomberg, Apple a ramené le mois dernier le budget quotidien de certains ingénieurs de 300 à 200 dollars. Il pourrait ensuite passer à 100 dollars par jour, tandis que celui de certaines équipes non techniques descendrait à 25 dollars. Les employés qui ont besoin d’un budget plus élevé peuvent demander une dérogation à leur direction.
Q2 : Comment définir un budget de tokens raisonnable par personne ?
Commencez par mesurer l’utilisation réelle des différents postes sur les 1 à 3 derniers mois, puis définissez des niveaux selon les rôles. Fixez le budget de base au-dessus de l’utilisation médiane, mais en dessous des usages les plus élevés. Les utilisateurs intensifs peuvent obtenir un complément sur dérogation. Ajustez ensuite les niveaux chaque mois en fonction de la fréquence à laquelle les plafonds sont atteints et du nombre de dérogations.
Q3 : Quelles autres entreprises limitent leurs dépenses internes en IA ?
Selon l’article, Microsoft, Tesla, Uber et Meta ont également fixé récemment des plafonds pour leurs dépenses internes en IA. Les modalités et les montants précis n’ont toutefois pas été divulgués.
Q4 : La répartition des modèles par niveau risque-t-elle de nuire à la qualité du travail ?
L’essentiel est de choisir le modèle selon la tâche, plutôt que de passer systématiquement à un modèle moins performant. Un modèle léger suffit généralement pour les résumés, les traductions ou la mise en forme. Réservez les modèles phares au raisonnement complexe et aux modifications critiques du code. Avant le déploiement, comparez les résultats sur des tâches réelles : par exemple, sur APIYI apiyi.com, utilisez la même clé API pour tester plusieurs niveaux de modèles, puis choisissez le niveau par défaut une fois la qualité jugée acceptable.
Q5 : Comment une petite ou moyenne équipe sans passerelle IA interne peut-elle commencer à gérer rapidement ses coûts d’invocation ?
Vous pouvez commencer en trois étapes : centraliser les appels, enregistrer l’`usage` de chaque requête dans le code et définir un modèle par défaut selon la tâche. Avec une plateforme d’agrégation comme APIYI apiyi.com, une seule clé API permet de passer d’un modèle OpenAI, Claude ou Gemini à un autre. La facturation à l’usage facilite la mise en place initiale du routage entre plusieurs modèles. Pour savoir si la plateforme permet de définir des quotas ou des alertes par membre, mieux vaut le vérifier directement auprès d’elle.
Gestion des coûts d’utilisation de l’IA : points clés
- Apple a resserré son budget : le budget quotidien de tokens des ingénieurs est passé de 300 à 200 dollars, avec de nouvelles baisses prévues.
- Mieux vaut adapter les budgets que les uniformiser : les usages varient fortement entre les postes techniques et non techniques ; chez Apple, les plafonds visés vont du simple au quadruple.
- Les dérogations préservent la souplesse : les limites ne sont pas absolues et un quota temporaire peut être demandé pour les tâches critiques.
- Répartir les tâches entre modèles réduit les coûts : confiez les tâches courantes à des modèles légers ou locaux, et réservez les modèles les plus avancés aux tâches complexes.
- Le suivi permet d’appliquer le budget : enregistrez les tokens consommés et les coûts par personne et par équipe, puis ajustez les budgets à partir de ces données.
- La communication interne est indispensable : un resserrement budgétaire peut susciter des inquiétudes sur l’emploi ; mieux vaut en expliquer les raisons en amont.
- Commencez par tester le routage : avec APIYI apiyi.com, une seule clé API permet de comparer plusieurs gammes de modèles et de valider votre stratégie.
Conclusion
La baisse du budget quotidien de tokens des employés d’Apple montre clairement que les grandes entreprises passent d’une phase d’expansion de l’usage de l’IA à une gestion plus précise des coûts. Pour les équipes en entreprise, trois leçons se dégagent :
- Adaptez les budgets : fixez les quotas individuels selon les rôles et les types de tâches, en vous appuyant sur les données historiques plutôt que sur l’intuition ;
- Gardez de la souplesse : associez des dérogations à un basculement automatique vers un modèle moins coûteux, pour éviter qu’une interruption brutale ne bloque les tâches critiques ;
- Répartissez les tâches entre modèles : choisissez le modèle adapté à chaque tâche et optimisez vos choix en continu grâce au suivi de l’utilisation.
Si votre équipe prépare une stratégie de gestion des coûts d’utilisation de l’IA, commencez par tester cette répartition sur un ou deux cas d’usage fréquents. Vous pourrez ensuite l’étendre en vous appuyant sur des données réelles de coût et de qualité. APIYI apiyi.com permet de mettre rapidement en place un environnement de test multimodèle : le crédit gratuit offert aux nouveaux utilisateurs suffit pour effectuer une première comparaison.
📚 Références
- Apple slashes internal AI budgets, with deeper cuts still planned : synthèse par The Decoder d’un article de Bloomberg
- Lien :
the-decoder.com/apple-slashes-internal-ai-budgets-with-deeper-cuts-still-planned/ - Description : chiffres sur la réduction des budgets quotidiens de tokens chez Apple, réactions des employés et contexte sur les restrictions des dépenses en IA dans d’autres entreprises
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel d’APIYI pour discuter de la gestion des coûts d’utilisation de l’IA en entreprise et des pratiques d’intégration de plusieurs modèles


