
Anmerkung des Autors: Apple hat das tägliche Token-Budget für Ingenieure von 300 auf 200 US-Dollar gesenkt. Ausgehend von dieser Nachricht zeigt der Artikel vier Mechanismen, mit denen Unternehmen ihre Kosten für KI-Aufrufe steuern können: Budgetstufen, Ausnahmegenehmigungen, Modellstaffelung und Nutzungsüberwachung.
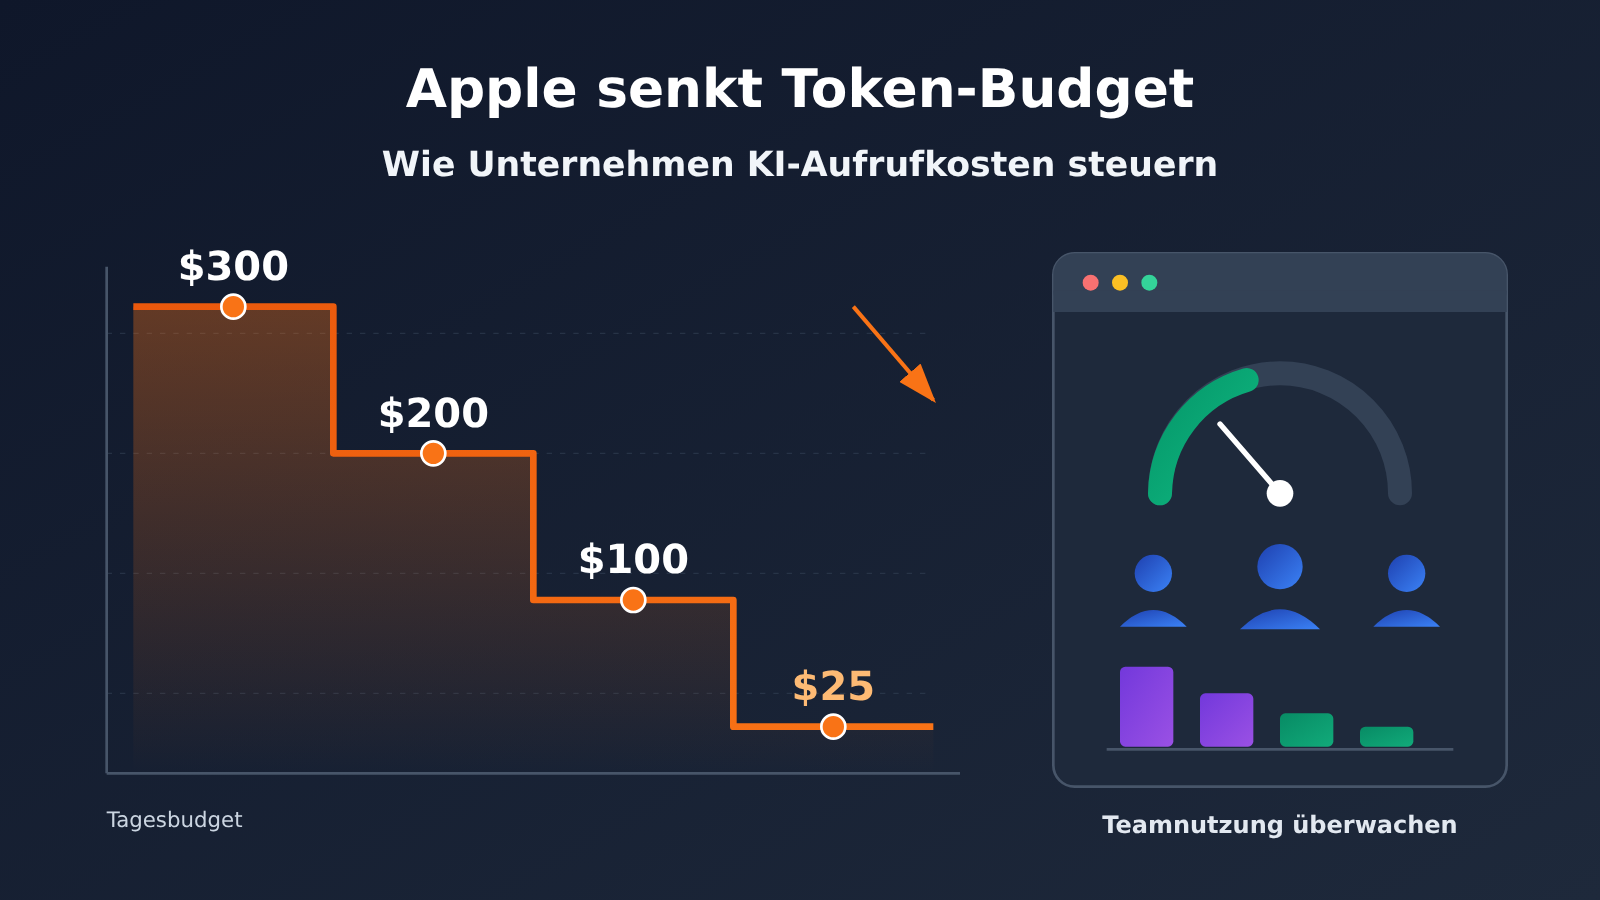
Bloomberg zufolge hat Apple im vergangenen Monat das tägliche Token-Budget einiger Ingenieure von 300 auf 200 US-Dollar gesenkt. Später soll es auf 100 US-Dollar pro Tag sinken, für einige nicht technische Teams möglicherweise sogar auf 25 US-Dollar. Mitarbeitende, die mehr benötigen, können bei der Geschäftsleitung eine Ausnahme beantragen. Einige Teams sollen zudem auf günstigere Modelle oder lokale KI umsteigen, die direkt auf dem Gerät läuft.
Das ist kein Gerücht: The Decoder nannte diese Zahlen am 5. November 2026 unter Berufung auf Bloomberg und berichtete, dass auch Microsoft, Tesla, Uber und Meta ihre internen KI-Ausgaben kürzlich gedeckelt haben. Große Unternehmen wechseln von „einfach nutzen“ zu „nach Budget nutzen“. Das zeigt: Die Kosten für KI-Aufrufe sind ein Thema, mit dem sich die Unternehmensleitung befassen muss.
Das nehmen Sie mit: Sie erfahren, wie Apple sein Token-Budget einschränkt, und erhalten ein direkt anwendbares Konzept für das Kostenmanagement von KI-Aufrufen im Unternehmen – mit Budgetstufen, Ausnahmegenehmigungen, Modellstaffelung und Nutzungsüberwachung.
Apple senkt Token-Budgets: Das Wichtigste im Überblick
| Punkt | Details |
|---|---|
| Quelle | Bericht von Bloomberg, aufgegriffen von The Decoder am 05.11.2026 |
| Betroffene | Ein Teil der Ingenieure sowie einige nichttechnische Teams |
| Bereits umgesetzte Kürzung | Das tägliche Token-Budget wurde im vergangenen Monat von 300 auf 200 US-Dollar gesenkt |
| Weitere Pläne | Mögliche Senkung auf 100 US-Dollar pro Tag, für einige nichttechnische Teams auf bis zu 25 US-Dollar |
| Bei Überschreitung | Mitarbeitende können bei der Führung eine Ausnahme beantragen |
| Verfügbare Modelle | Anthropic Claude, OpenAI ChatGPT, Google Gemini und weitere |
| Alternativen | Einige Teams wechseln zu günstigeren Modellen oder lokal auf dem Gerät ausgeführter KI |
| Hintergrund | Der neue CEO John Ternus treibt Einsparungen voran; die Ausgaben für Forschung und Entwicklung stiegen im Geschäftsjahr 2026 um 32 %, hauptsächlich aufgrund von Infrastruktur- und KI-Kosten |
| Branchentrend | Auch Microsoft, Tesla, Uber und Meta haben zuletzt interne KI-Ausgaben begrenzt |
Drei Details zu Apples Token-Budgets
Erstens gilt das Budget pro Person und Tag. Apple stellt den Abteilungen also nicht einfach ein jährliches Gesamtbudget zur Verfügung, sondern legt ein tägliches Limit für jeden Mitarbeitenden fest. So werden die Kosten der eigenen KI-Nutzung unmittelbar sichtbar, und das Management kann die Budgets je nach Tätigkeit unterschiedlich verteilen.
Zweitens gibt es getrennte Budgets für technische und nichttechnische Teams. Für Ingenieure ist ein Betrag von rund 100 US-Dollar vorgesehen, für einige nichttechnische Teams möglicherweise nur 25 US-Dollar – ein Unterschied um den Faktor vier. Das deutet darauf hin, dass Apple den Token-Verbrauch beim Programmieren oder Ausführen von Agenten deutlich höher einschätzt als beim Schreiben von E-Mails oder Erstellen von Zusammenfassungen.
Drittens ist das Limit keine starre Obergrenze. Mitarbeitende können Ausnahmen beantragen, und einige Teams werden auf günstigere oder lokale Modelle verwiesen. Im Kern geht es also nicht darum, „weniger KI zu nutzen“, sondern „teure Rechenleistung für Aufgaben einzusetzen, bei denen sie sich lohnt“. Der Bericht verrät allerdings nicht, wie Apple die Modelle einstuft oder die Limits durchsetzt. Hier bleiben weitere Informationen abzuwarten.
Warum große Unternehmen ihre Token-Budgets wegen steigender KI-Kosten begrenzen
KI-Aufrufe unterscheiden sich von herkömmlichen Software-Abos vor allem dadurch, dass nutzungsabhängig abgerechnet wird und jeder zusätzliche Aufruf Kosten verursacht. Öffnet ein Mitarbeiter dasselbe SaaS-Tool täglich 100-mal, ändert sich der Preis nicht. Lässt er dagegen ein Großes Sprachmodell täglich 100 lange Dokumente lesen, fallen jedes Mal Token-Kosten an. Bei Zehntausenden Mitarbeitern summieren sich diese Ausgaben schnell.
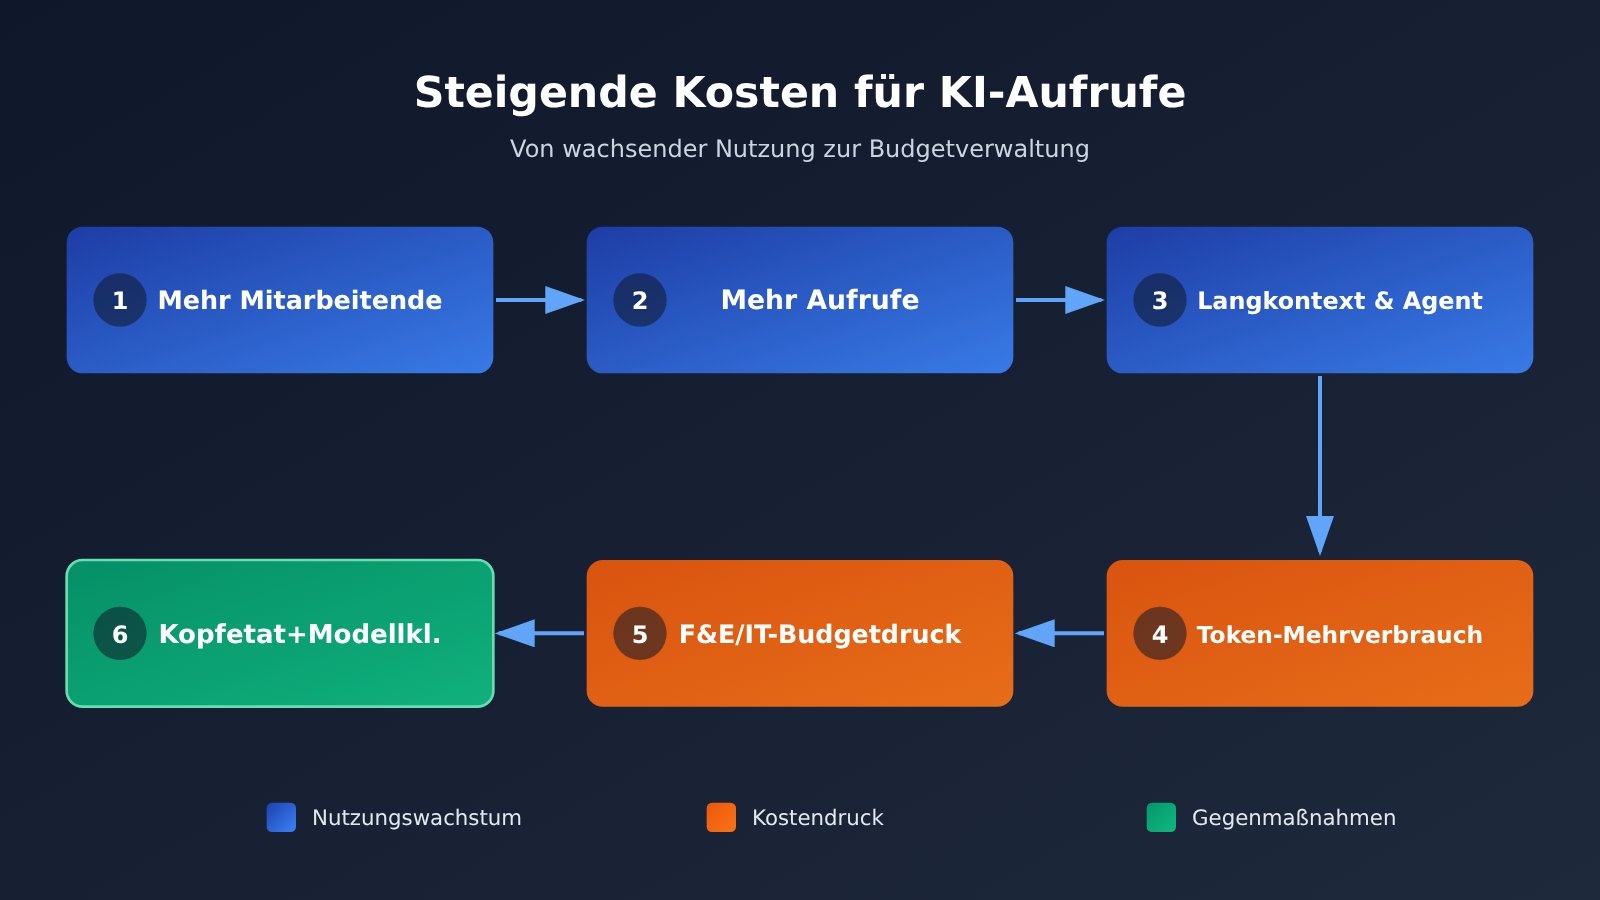
Apples Forschungs- und Entwicklungsausgaben stiegen im Geschäftsjahr 2026 um 32 %. Als treibende Faktoren nennt der Bericht ausdrücklich höhere Infrastruktur- und KI-Kosten. Während der neue CEO das Unternehmen verschlankt, sind interne KI-Ausgaben ein Posten, der sich leicht beziffern und anpassen lässt. Dass Microsoft, Tesla, Uber, Meta und andere Unternehmen im selben Zeitraum ebenfalls Limits einführten, zeigt: Es handelt sich nicht um eine Einzelentscheidung.
Interne Reaktionen zeigen allerdings auch, dass manche Mitarbeiter die bisherigen Budgets für zu großzügig hielten. Ein Tageslimit von 300 US-Dollar sei für die meisten Tätigkeiten kaum auszuschöpfen. Das verweist auf ein häufiges Problem: Viele Unternehmen legen ihre Budgets bei der Einführung von KI zunächst ohne genaue Kalkulation fest. Werden sie später gekürzt, führt das leicht zu Diskussionen.
4 Mechanismen zur Steuerung der KI-Nutzungskosten in Unternehmensteams
Aus Apples Vorgehen lassen sich vier übertragbare Managementmechanismen ableiten. Sie greifen ineinander: Budgets setzen Grenzen, Genehmigungen schaffen Flexibilität, Modellstufen senken Kosten und Monitoring stellt die Umsetzung sicher.
Mechanismus 1: Token-Budgets nach Rollen staffeln
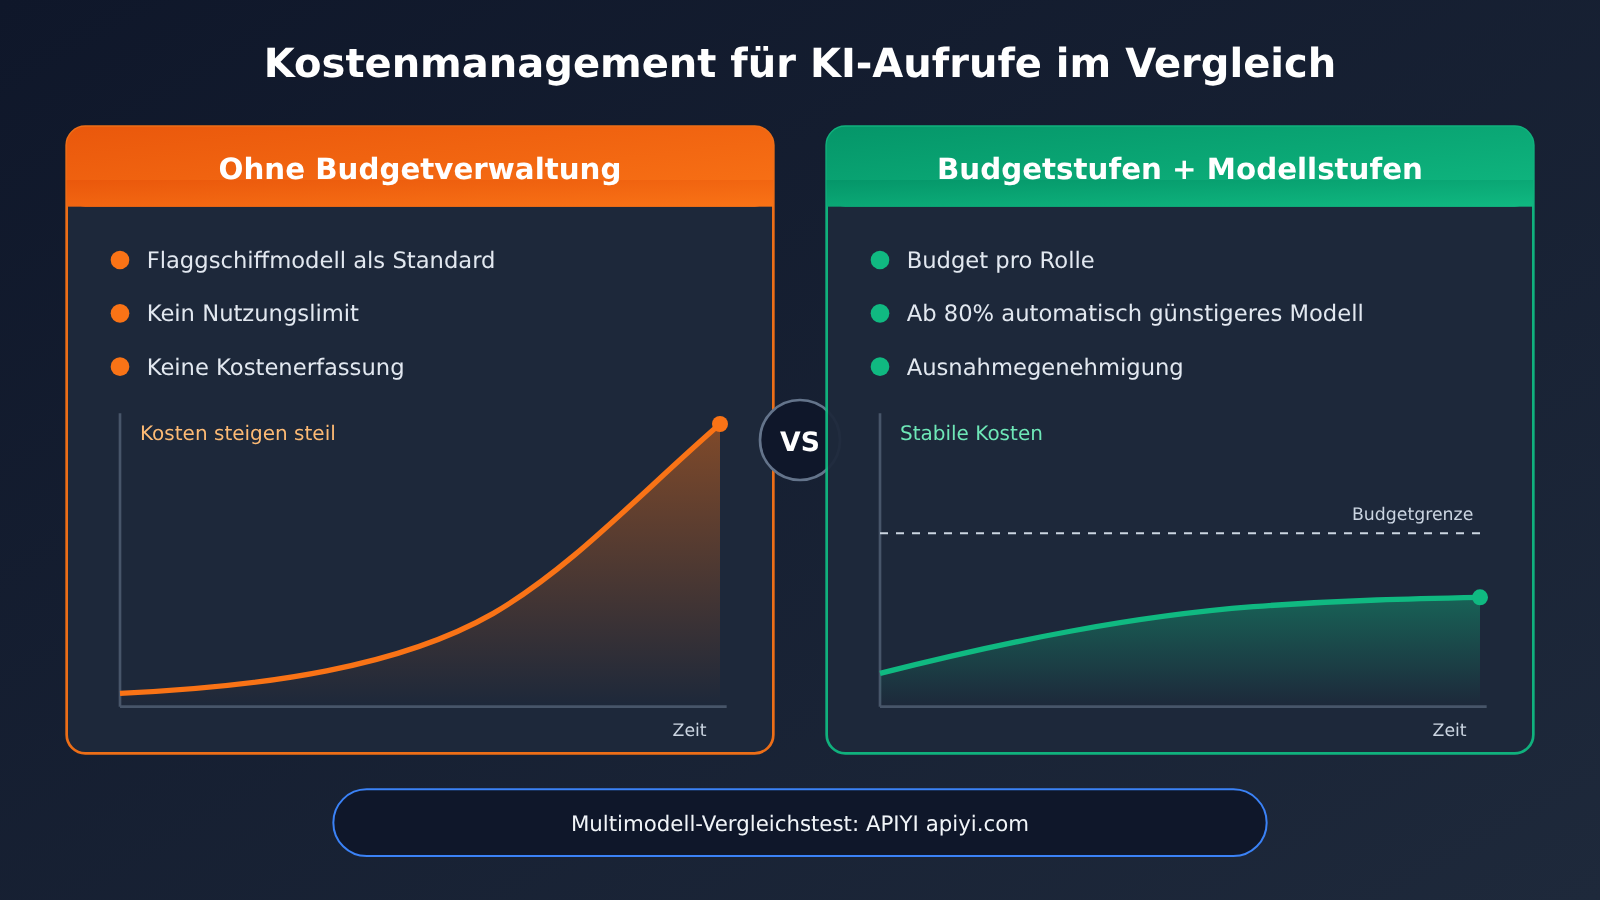
Bei Budgets pro Person kommt es auf die Staffelung an, nicht auf den Durchschnitt. Je nach Rolle wird KI sehr unterschiedlich genutzt. Eine einheitliche Grenze für alle führt entweder dazu, dass das Budget für Entwickler nicht reicht, oder dass das Kontingent von Gelegenheitsnutzern dauerhaft ungenutzt bleibt. Die folgende Tabelle zeigt ein an Apples Ansatz angelehntes Beispiel. Die konkreten Zahlen sollten Sie anhand der bisherigen Nutzung Ihres Teams ermitteln.
| Rollenstufe | Typische Aufgaben | Budgetansatz | Standard-Modellstufe |
|---|---|---|---|
| Kernentwicklung | Codegenerierung, Agent-Programmierung, Analyse langer Dokumente | Hohes Tagesbudget, Ausnahmen auf Antrag | Flaggschiffmodell + Mittelklassemodell |
| Allgemeine technische Rollen | Code-Reviews, Skripterstellung, technische Dokumentation | Mittleres Budget, ähnlich der von Apple geplanten Stufe für Entwickler | Hauptsächlich Mittelklassemodelle |
| Nichttechnische Fachbereiche | E-Mails, Zusammenfassungen, Übersetzungen, Aufbereitung von Informationen | Niedriges Budget, angelehnt an Apples Stufe ab 25 US-Dollar | Hauptsächlich leichtgewichtige Modelle |
| Pilotprojekte / neue Projekte | Erkundende Tests | Zeitlich begrenztes Sonderbudget mit festem Enddatum | Je nach Bedarf |
Für die Staffelung empfiehlt es sich, zunächst die tatsächliche Nutzung der letzten 1–3 Monate auszuwerten. Betrachten Sie für jede Rolle den Median und die hohen Verbrauchswerte und legen Sie das Budget dazwischen fest. So reicht es für die meisten im Alltag aus, während die wenigen Personen mit besonders hohem Bedarf eine Ausnahme beantragen. Das hält den Verwaltungsaufwand gering.
Mechanismus zwei: Ausnahmen genehmigen statt pauschal begrenzen
Apple erlaubt Beschäftigten, die ihr Limit überschreiten, bei der Geschäftsleitung eine Ausnahme zu beantragen. Das ist ein guter Ansatz: Eine starre Obergrenze könnte wichtige Aufgaben auf halbem Weg ausbremsen. Ganz ohne Limit wiederum verliert das Budget seinen Zweck. Für die Genehmigung von Ausnahmen bieten sich folgende Regeln an:
- Auslöser klar definieren: etwa wenn das Tageskontingent aufgebraucht ist oder ein Projekt über mehrere Tage intensive Modellaufrufe erfordert;
- Genehmigungen zeitlich begrenzen: Zusätzliche Kontingente gelten für einen Tag oder ein Projekt und laufen danach automatisch aus. So wird aus „vorübergehend“ nicht „dauerhaft“;
- Kurze Begründung verlangen: Aufgabentyp und erwartetes Ergebnis sollten festgehalten werden. So lässt sich später prüfen, ob sich die Kosten für die KI-Aufrufe gelohnt haben;
- Monatlich auswerten: Beantragt dieselbe Person oder dasselbe Team häufig Ausnahmen, ist das Grundbudget vermutlich zu niedrig. Dann sollte die Budgetstufe angepasst werden, statt immer neue Ausnahmen zu genehmigen.
Mechanismus drei: Modellstufen und automatischer Wechsel auf günstigere Modelle
Dem Bericht zufolge setzt Apple in manchen Teams auf günstigere Modelle oder lokal auf dem Gerät ausgeführte KI. Dahinter steckt einer der wirksamsten Wege, die Kosten für KI-Aufrufe zu senken: Modelle passend zur Schwierigkeit der Aufgabe auswählen. Viele Alltagsaufgaben lassen sich mit einem leichtgewichtigen Modell erledigen. Nur wenige komplexe Aufgaben brauchen tatsächlich ein Spitzenmodell.
| Modellstufe | Geeignete Aufgaben | Kostenmerkmale | Verfügbare Plattformen |
|---|---|---|---|
| Spitzenmodelle (z. B. hochwertige Modelle von Claude, GPT und Gemini) | Komplexes Reasoning, dateiübergreifende Codeänderungen, Analysen für wichtige Entscheidungen | Höchster Stückpreis, nach Bedarf einsetzen | APIYI apiyi.com, offizielle APIs der Anbieter |
| Mittelklassemodelle | Routinemässige Programmierung, technische Texte, strukturierte Extraktion | Ausgewogenes Verhältnis von Qualität und Kosten | APIYI, offizielle APIs der Anbieter |
| Leichtgewichtige Modelle | Zusammenfassungen, Übersetzungen, Klassifizierung, Formatierung | Niedriger Stückpreis, geeignet für häufige Aufrufe | APIYI, offizielle APIs der Anbieter |
| Modelle auf dem Gerät / lokale Modelle | Datenschutzsensible Aufgaben, Offline-Nutzung, einfache Vervollständigungen | Keine nutzungsabhängigen Gebühren, aber Hardware- und Betriebskosten | Lokale Bereitstellung |
Eine verbreitete Regel für den automatischen Wechsel lautet: Sobald ein bestimmter Anteil des Budgets erreicht ist, etwa 80 %, werden nicht kritische Aufgaben automatisch an die nächstgünstigere Modellstufe weitergeleitet. Ist das Kontingent aufgebraucht, stehen nur noch leichtgewichtige Modelle zur Verfügung oder es kann eine Ausnahme beantragt werden. So wird Beschäftigten der Zugang nicht plötzlich vollständig entzogen, und sie können weitgehend ohne Unterbrechung weiterarbeiten. Wie gross die tatsächlichen Preisunterschiede zwischen den Modellen sind, hängt von den aktuellen Preisen der jeweiligen Plattform ab. Daher empfiehlt es sich, vor der Einführung selbst nachzurechnen.
💡 Empfehlung: Damit Modellstufen funktionieren, sollte sich einfach zwischen den Modellen verschiedener Anbieter wechseln lassen. Über eine Aggregationsplattform wie APIYI apiyi.com genügt ein API-Schlüssel, um Modelle von OpenAI, Claude, Gemini und anderen aufzurufen. Die Schnittstelle ist mit dem OpenAI-Format kompatibel; für das Routing zwischen den Modellstufen muss lediglich der Parameter model geändert werden.
Mechanismus 4: Nutzungsüberwachung macht Budgets durchsetzbar
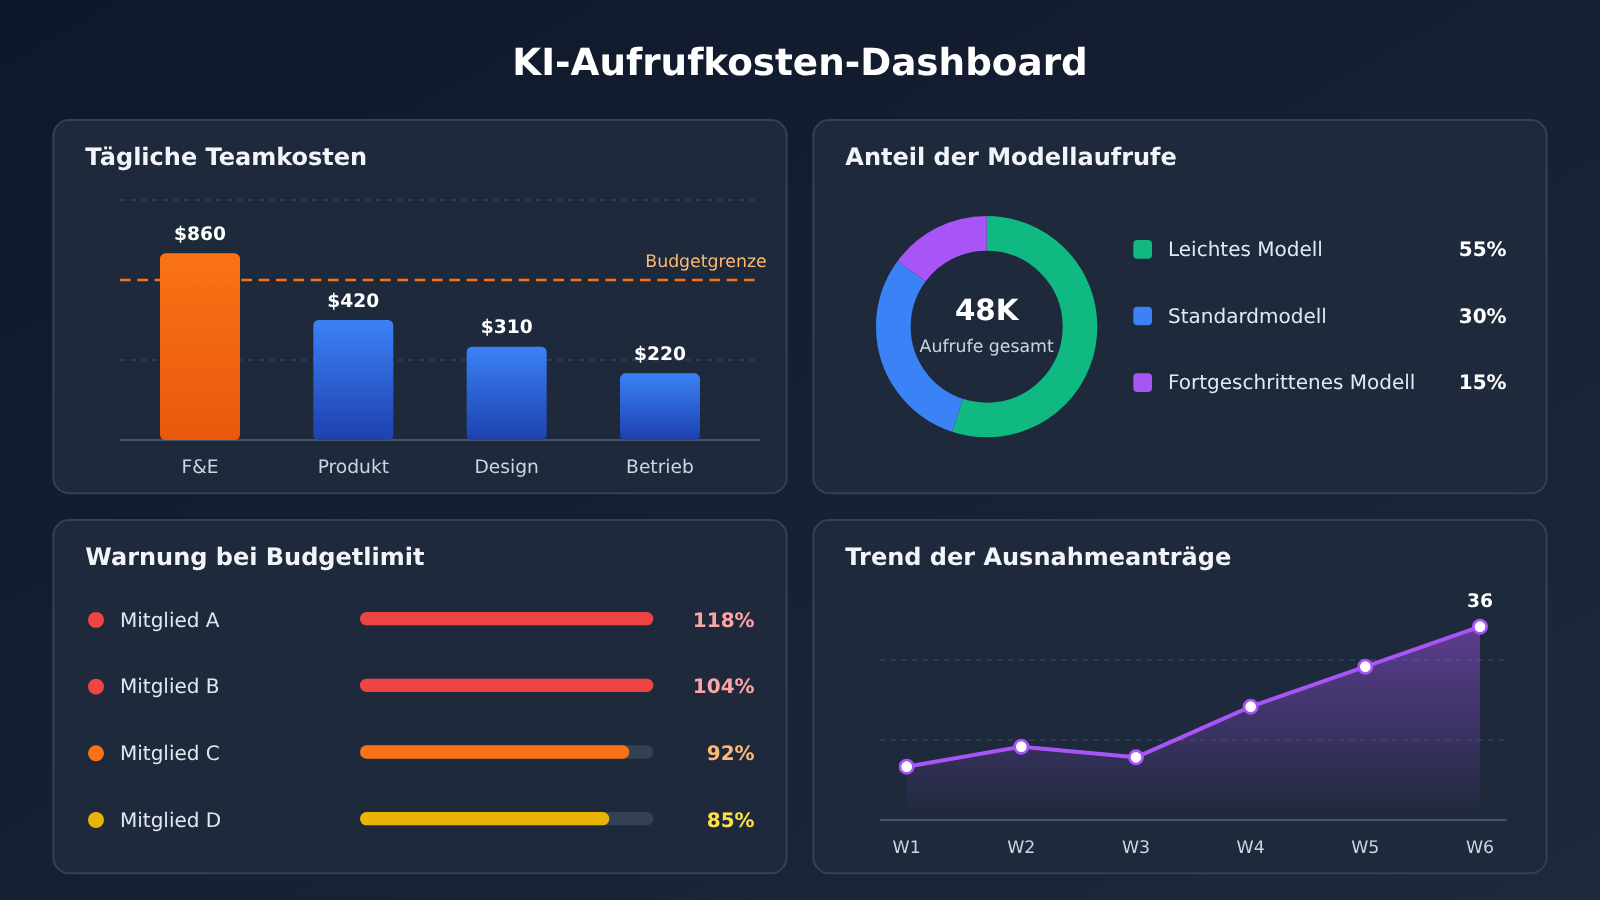
Ohne Überwachung bleibt ein Token-Budget pro Person nur eine Vorgabe auf dem Papier. Dabei geht es nicht nur darum, Budgetüberschreitungen aufzuspüren. Noch wichtiger ist, Daten für die Budgetstufen und die Einteilung der Modelle bereitzustellen. Mindestens die folgenden Kennzahlen sollten erfasst werden:
| Kennzahl | Aufschlüsselung | Zweck |
|---|---|---|
| Täglicher Token-Verbrauch und Kosten | Nach Person und Team | Beurteilen, ob das Budget angemessen ist, und ungewöhnliche Aufrufe erkennen |
| Anteil der Modellaufrufe nach Modell | Nach Team und Aufgabentyp | Prüfen, ob die Modellstufung funktioniert |
| Häufigkeit ausgeschöpfter Budgets | Nach Person und Woche | Erkennen, für welche Rollen die Budgetstufe angepasst werden muss |
| Anzahl und Bewilligungsquote von Ausnahmeanträgen | Nach Team und Monat | Prüfen, ob das Genehmigungsverfahren zu locker oder zu streng ist |
| Durchschnittliche Kosten pro Aufgabe | Nach Aufgabentyp | Kostenintensive Anwendungsfälle mit dem größten Optimierungspotenzial finden |
Technisch lässt sich das usage-Feld jeder Anfrage im unternehmensinternen AI-Gateway protokollieren und anschließend anhand von Mitarbeiter- oder Team-Tags auswerten. Wenn Sie eine Drittanbieterplattform nutzen, prüfen Sie zunächst, ob deren Nutzungsstatistiken für Ihre Kostenverrechnung ausreichend detailliert sind. Ob Unterkonten, individuelle Limits und Warnmeldungen unterstützt werden, hängt vom tatsächlichen Funktionsumfang der Plattform ab.
KI-Aufrufkosten kontrollieren: Einstieg ins budgetbewusste Modell-Routing
Ein vereinfachtes Beispiel zeigt, wie sich ein Budget pro Person und der automatische Wechsel auf günstigere Modelle im Code umsetzen lassen. Zunächst ein einfacher Aufruf: Entscheidend ist, den Token-Verbrauch aus der Antwort jeder Anfrage auszulesen.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle: Modelle mehrerer Anbieter mit einem Schlüssel aufrufen
)

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Für Alltagsaufgaben bevorzugt ein leichtgewichtiges Modell verwenden
    messages=[{"role": "user", "content": "把这段会议纪要整理成 5 条要点:..."}]
)
print(resp.choices[0].message.content)
print("本次消耗 tokens:", resp.usage.total_tokens)
Vollständige Implementierung ansehen: Budget nach Rolle und automatischer Modellwechsel
from collections import defaultdict
from datetime import date
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Modellstufen: Bitte durch die tatsächlich auf der Plattform verfügbaren Modellnamen ersetzen
TIERS = ["your-premium-model", "your-standard-model", "your-light-model"]

# Platzhalter für Preise (US-Dollar / Million Tokens): Bitte aktuelle Plattformpreise eintragen
PRICE = {
    "your-premium-model":  {"in": 0.0, "out": 0.0},
    "your-standard-model": {"in": 0.0, "out": 0.0},
    "your-light-model":    {"in": 0.0, "out": 0.0},
}

# Tagesbudget nach Rolle (US-Dollar), angelehnt an Apples Abstufung
DAILY_BUDGET = {"engineer": 100, "non_tech": 25}

spent = defaultdict(float)   # (user, date) -> heutige Ausgaben
exceptions = set()           # (user, date) mit genehmigter Ausnahme


def pick_model(user: str, role: str, preferred: str) -> str:
    key = (user, date.today())
    budget = DAILY_BUDGET[role]
    used = spent[key]
    if key in exceptions:
        return preferred
    if used >= budget:
        return TIERS[-1]                      # Budget aufgebraucht: nur leichtgewichtiges Modell verwenden
    if used >= budget * 0.8:
        idx = min(TIERS.index(preferred) + 1, len(TIERS) - 1)
        return TIERS[idx]                     # Budgetgrenze nahe: eine Stufe herunterwechseln
    return preferred


def chat(user: str, role: str, prompt: str, preferred: str = "your-standard-model"):
    model = pick_model(user, role, preferred)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    p = PRICE[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    spent[(user, date.today())] += cost
    print(f"[{user}] model={model} cost=${cost:.4f} today=${spent[(user, date.today())]:.2f}")
    return resp.choices[0].message.content


# Anwendungsbeispiel
print(chat("alice", "non_tech", "把这封邮件翻译成英文:..."))
Das Beispiel verzichtet auf dauerhafte Speicherung, gleichzeitige Zugriffe und Genehmigungsabläufe. Für den Produktivbetrieb empfiehlt es sich, spent in einer Datenbank oder einem Cache zu speichern und die Genehmigung von Ausnahmen an das interne Ticketsystem anzubinden. Das Grundprinzip bleibt gleich: Jeden Aufruf abrechnen und vor dem Routing das Budget prüfen.
🚀 Schnellstart: Wenn Sie das abgestufte Routing zunächst testen möchten, können Sie über APIYI apiyi.com kostenloses Testguthaben für neue Nutzer erhalten. Vergleichen Sie mit demselben Schlüssel die Qualität und den Verbrauch verschiedener Modellstufen bei Ihren tatsächlichen Aufgaben. Anschließend können Sie für jede Rolle ein Standardmodell festlegen.
Auswirkungen der Anpassung von Apples Token-Budget
Auswirkungen auf Entwickler
- Kostenbewusstsein wird zur Grundkompetenz: Entwickler in großen Unternehmen müssen darauf achten, wie viele Token eine Aufgabe verbraucht. Bei aufwendigen Vorgängen wie langen Kontexten oder wiederholten Versuchen ist ein sparsamer Umgang gefragt.
- Erfahrung mit mehreren Modellen wird wichtiger: Entwickler arbeiten bei knapperen Budgets effizienter, wenn sie für jede Aufgabe das passende Modell auswählen und einfache Aufgaben an leichtgewichtige oder lokale Modelle übergeben.
- Die Nachfrage nach KI-Gateways und Routing-Schichten steigt: Unternehmen brauchen einen einheitlichen Zugang, um Kosten zu erfassen, Limits festzulegen und bei Bedarf auf günstigere Modelle zu wechseln. Dadurch fällt mehr Entwicklungsarbeit für solche internen Infrastrukturen an.
Auswirkungen auf Führungskräfte
- Von der „Nutzung fördern“ zum „gezielten Kostenmanagement“: Die Kosten für KI-Aufrufe werden Teil der regulären Budgetplanung. Wie bei Cloud-Ressourcen müssen sie zugeordnet und ausgewertet werden.
- Budgets brauchen eine fundierte Grundlage: Apple-Mitarbeitende hielten die alten Kontingente für „zu großzügig“. Das zeigt, dass willkürlich festgelegte Budgets später aufwendige Anpassungen nach sich ziehen können.
- Kommunikationsrisiken dürfen nicht unterschätzt werden: Laut dem Bericht befürchten einige Mitarbeitende, dass Kostensenkungen ein Vorbote von Stellenabbau sind. Werden knappere Budgets nicht erklärt, können sie leicht als Zeichen für größere organisatorische Veränderungen verstanden werden.
Die folgende Tabelle fasst häufige organisatorische Risiken bei der Kostenkontrolle für KI-Aufrufe und mögliche Gegenmaßnahmen zusammen:
| Risiko | Auswirkung | Gegenmaßnahme |
|---|---|---|
| Verunsicherung der Mitarbeitenden | Limits werden als Zeichen für Stellenabbau verstanden | Frühzeitig erklären, dass die Kostenstruktur optimiert werden soll, und die Kriterien für die Budgetstufen offenlegen |
| Produktivitätsverlust | Wichtige Aufgaben werden wegen fehlender Kontingente unterbrochen | Automatisch auf günstigere Modelle wechseln statt den Zugang abrupt zu sperren; schnelle Ausnahmegenehmigungen ermöglichen |
| Versteckte Mehrkosten | Mitarbeitende weichen auf private Konten oder nicht genehmigte Tools aus | Für ausreichende und benutzerfreundliche interne Angebote sorgen und Compliance-Anforderungen berücksichtigen |
| Genehmigungsaufwand | Zu viele Ausnahmeanträge belasten Führungskräfte | Grundkontingente regelmäßig anhand von Daten erhöhen und unnötige Anträge reduzieren |
| Schwer messbare Wirkung | Es werden nur die Ausgaben betrachtet, nicht die Ergebnisse | Kosten pro Aufgabe gemeinsam mit der Ergebnisqualität auswerten |
Häufig gestellte Fragen (FAQ)
Q1: Wie stark hat Apple das Token-Budget gesenkt?
Laut Bloomberg hat Apple im vergangenen Monat das tägliche Token-Budget einiger Ingenieure von 300 auf 200 US-Dollar gesenkt. Später könnte es auf 100 US-Dollar pro Tag sinken, bei einigen nichttechnischen Teams sogar auf 25 US-Dollar. Wer mehr benötigt, kann bei der Führungsebene eine Ausnahme beantragen.
Q2: Wie lässt sich ein angemessenes Token-Budget pro Person festlegen?
Erfassen Sie zunächst die tatsächliche Nutzung der verschiedenen Rollen in den vergangenen 1-3 Monaten und teilen Sie diese in Stufen ein. Das Grundbudget sollte über dem Median, aber unter den höchsten Verbrauchswerten liegen. Personen mit hohem Bedarf können per Ausnahmeantrag zusätzliches Budget erhalten. Passen Sie die Stufen anschließend monatlich an – je nachdem, wie oft Budgets ausgeschöpft und Ausnahmen beantragt werden.
Q3: Welche Unternehmen begrenzen neben Apple ihre internen KI-Ausgaben?
Dem Bericht zufolge haben auch Microsoft, Tesla, Uber und Meta kürzlich Obergrenzen für interne KI-Ausgaben eingeführt. Wie diese Unternehmen dabei konkret vorgehen und wie hoch die Budgets sind, wurde jedoch nicht bekannt gegeben.
Q4: Beeinträchtigt eine Einteilung der Modelle in Leistungsstufen die Qualität der Arbeit?
Entscheidend ist, Modelle passend zur Aufgabe zuzuweisen, statt pauschal auf schwächere Modelle umzusteigen. Für Zusammenfassungen, Übersetzungen und Formatierungen reichen leichtgewichtige Modelle meist aus. Komplexe Schlussfolgerungen und wichtige Codeänderungen können dagegen Flaggschiff-Modelle übernehmen. Vor der Einführung empfiehlt sich ein Vergleich anhand echter Aufgaben: Testen Sie beispielsweise auf APIYI apiyi.com mit demselben API-Schlüssel Modelle verschiedener Leistungsstufen. Legen Sie die Standardstufe erst fest, wenn die Qualität überzeugt.
Q5: Wie können kleine und mittlere Teams ohne internes KI-Gateway schnell damit beginnen, ihre Kosten für KI-Aufrufe zu steuern?
Beginnen Sie mit drei Schritten: Vereinheitlichen Sie den Zugang für Modellaufrufe, erfassen Sie im Code für jede Anfrage die usage und legen Sie je nach Aufgabe ein Standardmodell fest. Über Aggregationsplattformen wie APIYI apiyi.com können Sie mit einem API-Schlüssel zwischen Modellen von OpenAI, Claude, Gemini und anderen wechseln. Die Abrechnung erfolgt nutzungsabhängig – so lässt sich das Routing zwischen mehreren Modellen zunächst unkompliziert einrichten. Ob Limits oder Warnmeldungen pro Teammitglied unterstützt werden, klären Sie am besten direkt mit der Plattform.
Die wichtigsten Punkte zum Management von KI-Nutzungskosten
- Apple hat das Budget gekürzt: Das tägliche Token-Budget für Engineers wurde von 300 auf 200 US-Dollar gesenkt. Weitere Kürzungen sind geplant.
- Abstufung statt Durchschnitt: Der Verbrauch unterscheidet sich stark zwischen technischen und nichttechnischen Rollen. Apples angestrebte Budgetstufen unterscheiden sich um das Vierfache.
- Ausnahmegenehmigungen schaffen Flexibilität: Limits sind keine starre Obergrenze. Für wichtige Aufgaben lässt sich ein temporäres Zusatzbudget beantragen.
- Modellabstufung spart am meisten: Alltagsaufgaben übernehmen schlanke oder lokale Modelle, Flaggschiffmodelle bleiben komplexen Aufgaben vorbehalten.
- Monitoring macht Budgets umsetzbar: Token-Verbrauch und Kosten pro Person und Team erfassen und die Budgetstufen anhand der Daten anpassen.
- Kommunikation ist unverzichtbar: Engere Budgets können Sorgen vor Stellenabbau auslösen. Deshalb sollte der Zweck frühzeitig erklärt werden.
- Zum Einstieg Routing testen: Über APIYI apiyi.com lassen sich mit einem API-Schlüssel mehrere Modellklassen vergleichen und Abstufungsstrategien prüfen.
Fazit
Dass Apple das tägliche Token-Budget seiner Mitarbeitenden senkt, ist ein deutliches Signal: Bei der KI-Nutzung geht es in grossen Unternehmen nicht mehr nur um Wachstum, sondern zunehmend auch um eine genaue Kostenrechnung. Für Unternehmensteams lassen sich daraus drei Lehren ziehen:
- Budgets abstufen: Pro Person ein Budget nach Rolle und Aufgabentyp festlegen – auf Basis historischer Daten statt nach Bauchgefühl;
- Mechanismen flexibel gestalten: Ausnahmegenehmigungen und automatischer Wechsel auf günstigere Modelle verhindern, dass ein starres Limit wichtige Arbeit ausbremst;
- Modelle abstufen: Für jede Aufgabe das passende Modell wählen und die Auswahl mithilfe von Nutzungsmonitoring laufend optimieren.
Wenn Ihr Team die Kosten seiner KI-Aufrufe plant, starten Sie am besten mit einem Pilotprojekt zur Modellabstufung für ein oder zwei häufige Anwendungsfälle. Sobald echte Kosten- und Qualitätsdaten vorliegen, können Sie den Ansatz ausweiten. Über APIYI apiyi.com lässt sich schnell eine Testumgebung mit mehreren Modellen einrichten. Das kostenlose Guthaben für neue Nutzer reicht für einen ersten Vergleich aus.
📚 Quellen
- Apple slashes internal AI budgets, with deeper cuts still planned: Bericht von The Decoder über die Berichterstattung von Bloomberg
- Link:
the-decoder.com/apple-slashes-internal-ai-budgets-with-deeper-cuts-still-planned/ - Inhalt: Zahlen zur Anpassung von Apples täglichem Token-Budget, Reaktionen der Mitarbeitenden und Hintergrundinformationen zu den Beschränkungen von KI-Ausgaben bei anderen Unternehmen
Autor: Technikteam von APIYI
Technischer Austausch: Kontaktieren Sie uns über die Startseite von APIYI, um sich über das Kostenmanagement von KI-Aufrufen in Unternehmen und die Anbindung mehrerer Modelle auszutauschen.


