
Sparen ist möglich – aber unter Bedingungen. Laut zwei hypothetischen Rechenbeispielen aus der offiziellen Google-Dokumentation sinkt in einem Szenario mit 200 Tools und einem Basiskontext von 2.000 Tokens die Zahl der Eingabe-Token bei Gemini Tool Retrieval von 164.000 auf 23.650, also um rund 85,6 %. In einem Szenario mit 10 Tools und 30.000 Tokens Basiskontext steigt sie von 68.000 auf 92.830, also um etwa 36,5 %. Ob sich das rechnet, hängt an einer einzigen Frage: Können die eingesparten vollständigen Tool-Schemas die zusätzlichen Kontextkosten aufwiegen, die durch die serverseitige Suche entstehen?
Was Sie nach dem Lesen dieses Artikels wissen
- Welchen Teil der Token Tool Retrieval einspart und welcher Teil neu hinzukommt.
- Die vollständigen Voraussetzungen und die Einzelaufschlüsselung der offiziellen Rechenbeispiele mit 200 Tools und mit 10 Tools.
- Die aus den offiziellen Parametern abgeleitete Break-even-Formel und die Methode, mit der Sie beurteilen, ab wie vielen Tools sich die Aktivierung lohnt.
- Wie Sie mit dem Feld
interaction.usageund den Caching-Regeln die tatsächlichen Kosten einer Agent-Aufgabe nachrechnen.
Aufbau: Zuerst helfen Ihnen eine Begriffstabelle und eine Kurzübersicht der Auswirkungen dabei, die Terminologie zu vereinheitlichen und sich selbst der richtigen Lesergruppe zuzuordnen. Der Abschnitt „Objektive Fakten“ erläutert den von Google veröffentlichten Mechanismus, die Abrechnungsregeln und die Originalformulierungen der beiden Rechenbeispiele. Der Abschnitt „Analyse und Einschätzung“ liefert den aus den offiziellen Parametern abgeleiteten Schwellenwert, die Unterscheidung der drei Arten von „Einsparung“, die Kostenformel für eine einzelne Aufgabe und eine Entscheidungstabelle für die Aktivierung.
Gemini Tool Retrieval Kostenanalyse To Know: Begriffserklärung
| Konzept | Kurze Erklärung |
|---|---|
| Input-Token | Maßeinheit für Text, historischen Kontext, Tool-Deklarationen und weitere Inhalte, die zur Verarbeitung an das Modell übergeben werden |
| Tool-Schema | Die vollständige Parameterdefinition, auf der das Modell beim Erzeugen von Funktionsaufrufen basiert; im Rechenbeispiel jeweils etwa 400 Token |
| Liste der zurückgestellten Tools | Nach dem Setzen von defer_loading: true sieht das Modell zunächst nur Tool-Namen und Kurzbeschreibungen; in offiziellen frühen Tests etwa 26 Token pro Eintrag |
| Basis-Kontext B | Verlauf und Aufgabeninformationen, die bei jedem Modellaufruf im Rechenbeispiel ohnehin verarbeitet werden müssen |
| Inferenz nach der Suche | Ein zusätzlicher Modellaufruf, nachdem der Server die Tools gefunden hat, mit dem vorhandenen Kontext und den neu hinzugefügten Schemas |
total_tool_use_tokens |
Die zusätzliche Eingabemenge für Modellaufrufe, die innerhalb derselben Anfrage durch serverseitige Tools und die Suche ausgelöst wird |
total_cached_tokens |
Der Teil des Eingabeverbrauchs, der aus dem Cache bedient und zum Cache-Tarif abgerechnet wird |
| Gewinnschwelle | Die Grenze, bei der unter denselben Annahmen die Eingabekosten von statischem Laden und bedarfsgesteuertem Laden gleich sind |
| Kosten eines einzelnen erfolgreichen Tasks | Die Summe der Kosten aller Modellaufrufe und Tool-Nutzungen, die für das Erreichen eines Geschäftsziels anfallen |
Gemini Tool Retrieval: Auswirkungen auf einen Blick
- Agent-Entwickler, die große Tool-Bibliotheken einbinden: Wenn viele Tools verfügbar sind, pro Aufgabe aber nur wenige genutzt werden, lässt sich der Schema-Overhead durch wiederholte Eingaben deutlich senken. Das entspricht dem offiziellen Rechenbeispiel mit 200 Tools.
- App-Entwickler mit kleinem Tool-Set und langem Kontext: Jede serverseitige Suche erfordert eine zusätzliche Modellinferenz und die erneute Verarbeitung des langen Kontexts – aktiviert kann das teurer werden. Das offizielle Rechenbeispiel mit 10 Tools ist der Gegenfall.
- Engineering- und FinOps-Verantwortliche für die Kostenkalkulation: Wer nur die
total_input_tokensder ersten Anfrage betrachtet, unterschätzt die Kosten;total_tool_use_tokens, Cache-Treffer und Ausgabe-Token müssen mit eingerechnet werden. - Plattform-Teams, die ein Unternehmens-Tool-Registry pflegen: Der clientseitige Retrieval-Modus lässt sich mit eigenen Berechtigungsfiltern und dynamischen Tools kombinieren, aber jede Suche bedeutet einen zusätzlichen API-Roundtrip – die Kostenbasis muss separat bewertet werden.
Faktenlage: Veröffentlichung und Abrechnungsmechanik von Gemini Tool Retrieval
Was ist Gemini Tool Retrieval und wann wurde es veröffentlicht
Am 19. November 2026 kündigte Google im offiziellen Blog an, dass Tool Retrieval in der Gemini Interactions API als Preview verfügbar ist. Die Funktion befindet sich in der Preview-Phase, erfordert die API-Version v1beta und wird von der älteren Methode generateContent nicht unterstützt. Im serverseitigen Modus aktiviert man sie, indem man {"type": "tool_search"} in tools aufnimmt und für function oder mcp_server, die verzögert geladen werden sollen, defer_loading: true setzt.
In der Entwicklerdokumentation sind mit Stand 20. November 2026 vier kompatible Modell-IDs explizit aufgeführt: gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, gemini-3.6-flash. Die Formulierung „Gemini 3.6 und neuere Modelle“ in der Ankündigung ist breiter gefasst; Modelle, die nicht in der Dokumentation aufgeführt sind, muss man selbst prüfen. Bei nicht unterstützten Modellen führt defer_loading zu HTTP 400.
Ein leicht misszuverstehender Punkt sollte betont werden: Im serverseitigen Modus müssen Entwickler bei jeder Anfrage weiterhin das vollständige tools-Array übermitteln, einschließlich der vollständigen Parameter der verzögerten Tools – auch bei Verwendung von previous_interaction_id. Tool Retrieval verändert den Zeitpunkt, zu dem das vollständige Schema in den Modellkontext gelangt – nicht aber, dass diese Definitionen nicht mehr im Request-Body gesendet werden.
Woher kommen die Kosten bei statischem Laden und bei Gemini Tool Retrieval?
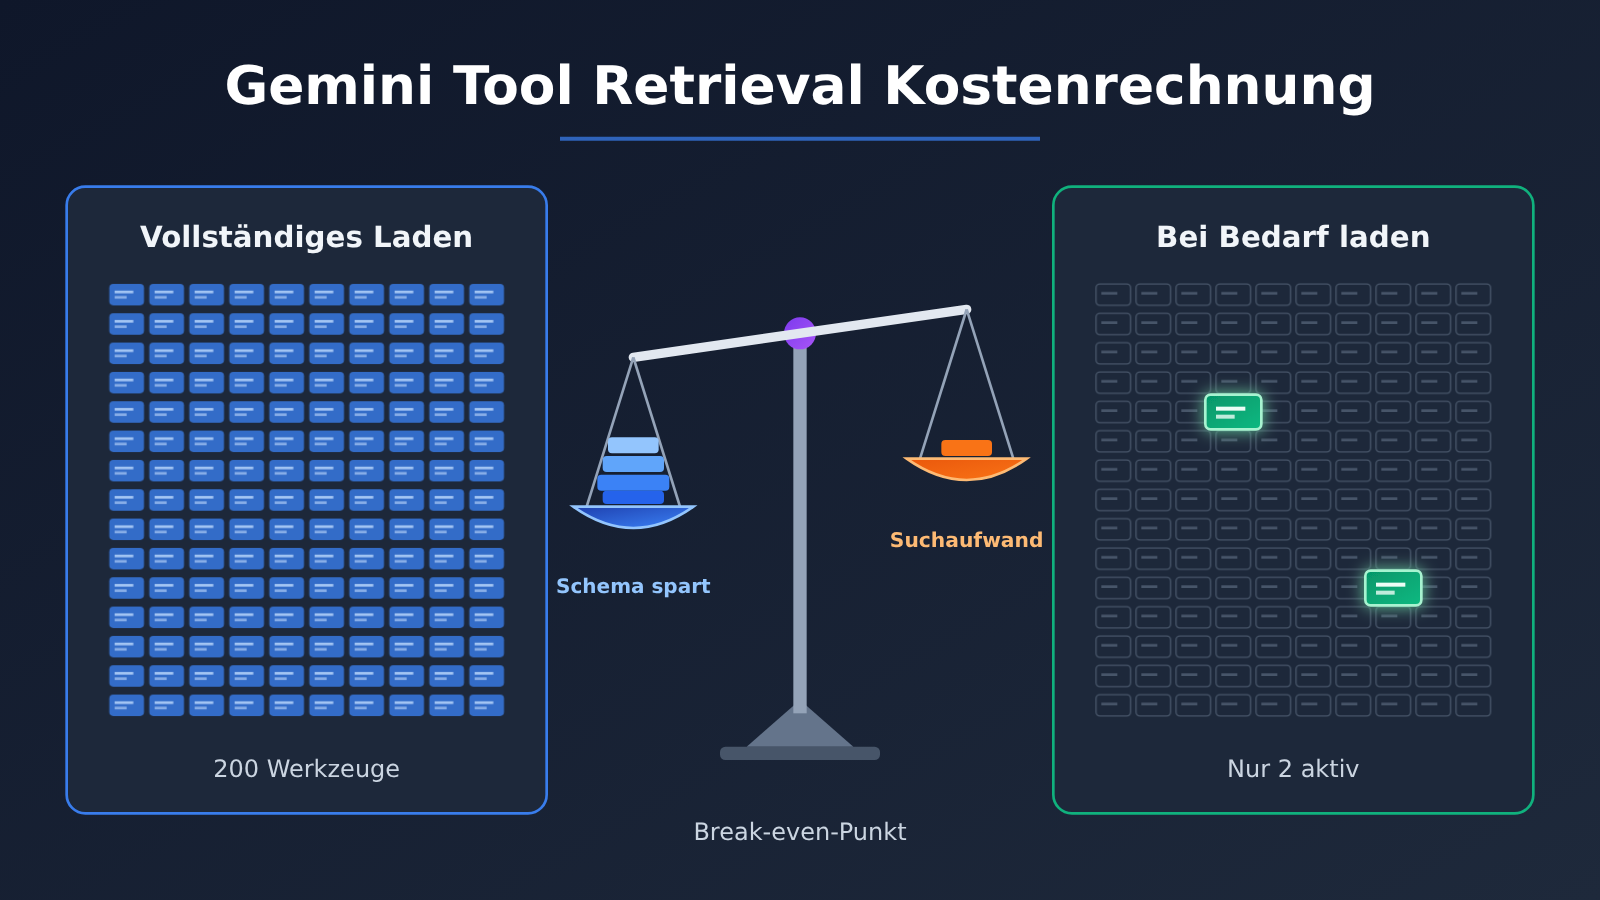
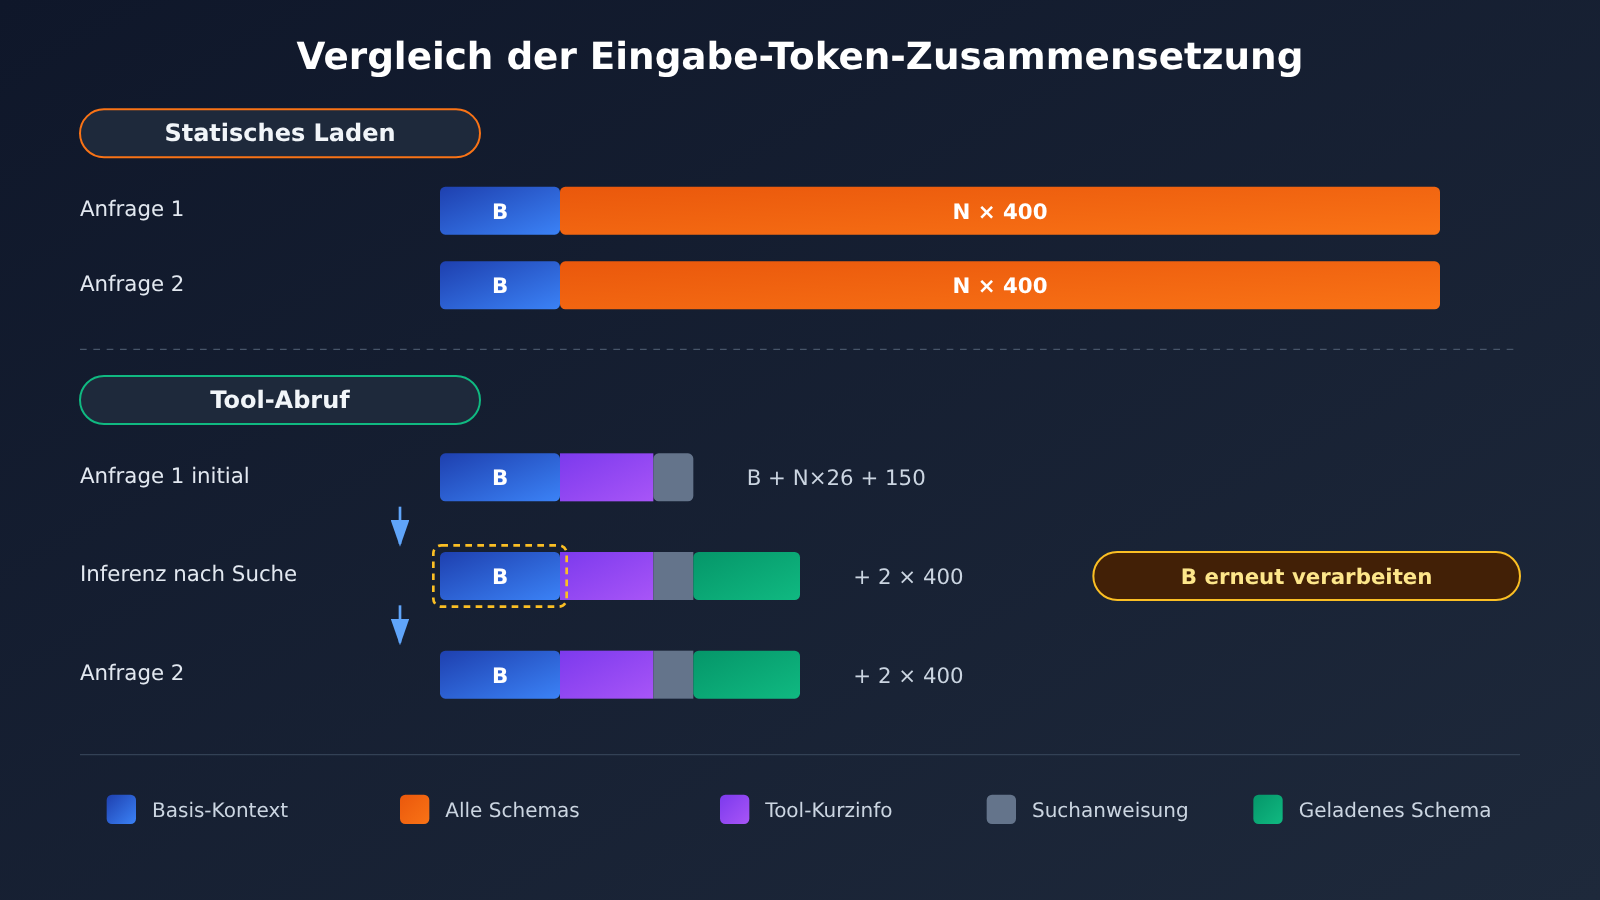
Beim statischen Laden muss bei jedem Modellaufruf das vollständige Schema aller Tools gelesen werden – selbst wenn in dieser Runde nur eine einzige Rückerstattungsfunktion zum Einsatz kommt. Tool Retrieval ersetzt diese vollständigen Definitionen durch eine kurze Toolliste: Wenn das Modell sie benötigt, startet es einen tool_search_call, der Server liefert ein tool_search_result mit dem vollständigen Schema zurück, und das Modell erzeugt daraus anschließend einen function_call.
Google stellt ausdrücklich klar, dass Tool Retrieval keine eigene Funktionsgebühr hat – dennoch wird Folgendes weiterhin zum Tarif des gewählten Modells abgerechnet:
- Alle kurzen Listeneinträge der zurückgestellten Tools.
- Die feste Suchanweisung, die zusätzlich anfällt, sobald
tool_searchaktiviert ist. - Die zusätzliche Modellinferenz, die jede serverseitige Suche auslöst – dabei werden der vollständige Kontext und das neu geladene Schema erneut verarbeitet.
- Die vollständigen Schemas der geladenen Tools sowie deren fortlaufende Belegung in den nachfolgenden Runden (ein Mechanismus zum Entladen ist in der aktuellen Dokumentation nicht vorgesehen).
- Die üblichen Token für Ausgabe, Thinking und Ergebnisse der Tool-Ausführung.
Offizielle Rechenbeispiele zu Gemini Tool Retrieval: 200 Tools und 10 Tools
Beide Rechenbeispiele stammen aus der Google-Tool-Retrieval-Dokumentation. Es handelt sich um offiziell gekennzeichnete hypothetische Berechnungen, nicht um Produktions-Benchmarks, und beide vernachlässigen Output-Token sowie Cache-Gewinne. Die einheitliche Grundlage: jedes vollständige Schema 400 Token, jede verzögerte Kurzbeschreibung eines Tools etwa 26 Token, Suchanweisung 150 Token, eine Aufgabe mit 2 externen Anfragen, wobei in der ersten Anfrage 1 serverseitige Suche läuft und insgesamt 2 Tools geladen werden.
| Berechnungsposten | 200 Tools, B=2.000 | 10 Tools, B=30.000 |
|---|---|---|
| Statisches Laden: 2 × (B + N × 400) | 164.000 | 68.000 |
| Anfrage 1, initiale Eingabe (B + N × 26 + 150) | 7.350 | 30.410 |
| Anfrage 1, Inferenz nach der Suche (plus 2 Schemata) | 8.150 | 31.210 |
| Eingabe für Anfrage 2 | 8.150 | 31.210 |
| Tool Retrieval insgesamt | 23.650 | 92.830 |
| Veränderung | -140.350 | +24.830 |
| Veränderung in Prozent (aus den offiziellen Zahlen nachgerechnet) | ca. -85,6 % | ca. +36,5 % |
Der Grund, warum das 200-Tool-Szenario so deutlich spart: Die statische Variante muss bei jedem Aufruf 80.000 Token an Tool-Definitionen mitschleppen, während der Basis-Kontext nur 2.000 Token umfasst – die zusätzliche Inferenz durch die Suche kostet also wenig. Beim 10-Tool-Szenario ist es genau umgekehrt: Die Tool-Definitionen kommen insgesamt nur auf 4.000 Token, es gibt also kaum Spielraum zum Sparen, und die Inferenz nach der Suche muss den langen Kontext von 30.000 Token noch einmal verarbeiten – der zusätzliche Aufwand übersteigt die Einsparung direkt.
Usage-Felder, Preise und Cache-Regeln bei Gemini Tool Retrieval
Google stellt in interaction.usage die Felder bereit, die für die Analyse der Tool-Retrieval-Kosten benötigt werden:
| Feld | Bedeutung | Rolle bei der Kostenanalyse |
|---|---|---|
total_input_tokens |
Eingabe des ersten Modellaufrufs innerhalb der Anfrage | Zeigt nur, „um wie viel der anfängliche Kontext kürzer geworden ist“ |
total_tool_use_tokens |
Zusätzliche Modellaufruf-Eingaben durch serverseitige Tools und Suche | Hauptkostenquelle der Suche und wird am ehesten übersehen |
total_cached_tokens |
Der Teil der Eingabe, der bereits vom Cache verarbeitet wurde | Wird zum Cache-Tarif abgerechnet und darf nicht erneut addiert werden |
total_output_tokens |
Vom Modell erzeugte Ausgabe | Wird zum Ausgabetarif abgerechnet |
total_thought_tokens |
Token, die im Reasoning-Prozess entstehen | Werden zum Ausgabetarif des gewählten Modells abgerechnet |
Bei den Preisen gilt im Standard-Tarif der Google-Preisseite: Gemini 4 Hydrogen kostet $1.50 pro Million Token für die Eingabe, $7.50 für die Ausgabe (inkl. Thinking) und $0.075 für gecachte Eingaben. Rechnet man die offiziellen Beispielrechnungen ausschließlich mit diesem Eingabepreis arithmetisch um, kommt man für das Szenario mit 200 Tools auf etwa $0.246 gegenüber $0.0355 und für das Szenario mit 10 Tools auf etwa $0.102 gegenüber $0.139. Das ist lediglich eine Multiplikation der angenommenen Token-Zahlen mit den offiziellen Tarifen – keine echte Abrechnung.
Bei den Cache-Regeln sind zwei Schwellenwerte getrennt zu betrachten. Erstens unterstützt die Interactions API nur implizites Caching; Stand 20. November 2026 beträgt die Mindestgröße für implizites Caching bei der Gemini-4-Reihe, Gemini 3.8 Flash und Gemini 3.6 Flash jeweils 4.096 Token. Zweitens muss in Multi-Turn-Dialogen und Agent-Loops mit Gemini 4 eine neue Anfrage mindestens 2.050 Token hinzufügen, damit das System die vollständige vorherige Anfrage zwischenspeichert. Ist die Menge geringer, werden die letzten 2.050 Token der vorherigen Anfrage erneut zum Standard-Eingabepreis abgerechnet. Modellausgaben, Thinking und Funktionsergebnisse zählen zu dieser hinzugefügten Menge.
Zum Zeitpunkt der Quellenprüfung hat Google weder das Token-Einsparverhältnis von Tool Retrieval auf realen Aufgaben-Sets noch die Verbesserung der Latenz oder die Steigerung der Tool-Auswahlgenauigkeit veröffentlicht. Auch belastbare Produktionsmessungen unabhängiger Entwickler liegen nicht vor.
Analyse: Wann spart Gemini Tool Retrieval wirklich Token?
Der Break-even-Punkt von Gemini Tool Retrieval: Ab wie vielen Tools sich die Aktivierung lohnt
Im Folgenden finden Sie ein erweitertes Beispiel, das aus den Parametern des offiziellen Rechenbeispiels abgeleitet wurde – es handelt sich nicht um einen von Google veröffentlichten allgemeinen Schwellenwert. Sei N die Gesamtzahl der Tools und B der Basis-Kontext; wir bleiben bei S=400, D=26, H=150, K=2 und der Annahme „zwei Anfragen, eine Suche“:
- Statisches Laden: T_static = 2 ×(B + 400N)
- Bedarfsgerechtes Laden: T_retrieval = 3 ×(B + 26N + 150)+ 2 × 2 × 400
Mit dieser Formel lassen sich beide offiziellen Ergebnisreihen vollständig reproduzieren. Setzt man T_retrieval < T_static, erhält man nach Umformung 722N > B + 2050, also N > (B + 2050) / 722. Die 2050 stammen hier aus 3 × 150 + 1600 und sind reines algebraisches Ergebnis – sie haben nichts mit der Bedingung von 2.050 zusätzlichen Token beim mehrrundigen Caching von Gemini 4 im Cache-Dokument zu tun. Bitte nicht verwechseln.
| Basis-Kontext B | Tool-Anzahl N | Statisches Laden | Tool Retrieval | Änderung | Größenordnung | Datenherkunft |
|---|---|---|---|---|---|---|
| 2,000 | 200 | 164,000 | 23,650 | -140,350 | -85.6% | Offizielles Rechenbeispiel |
| 30,000 | 10 | 68,000 | 92,830 | +24,830 | +36.5% | Offizielles Rechenbeispiel |
| 30,000 | 44 | 95,200 | 95,482 | +282 | +0.3% | Erweiterte Ableitung |
| 30,000 | 45 | 96,000 | 95,560 | -440 | -0.5% | Erweiterte Ableitung |
| 30,000 | 50 | 100,000 | 95,950 | -4,050 | -4.1% | Erweiterte Ableitung |
| 30,000 | 100 | 140,000 | 99,850 | -40,150 | -28.7% | Erweiterte Ableitung |
Bei B=30,000 liegt der kritische Wert bei N > 44.39 – erst ab dem 45. Tool ist bedarfsgerechtes Laden also leicht im Vorteil, und in der Nähe des Break-even-Punkts ist die Ersparnis praktisch vernachlässigbar. Mit derselben Formel ergibt sich für B=2,000 ein kritischer Wert von etwa 5.6, das heißt schon bei 6 Tools kippt die Rechnung. Daraus folgt: Je länger der Basis-Kontext, desto größer muss die Tool-Bibliothek sein, um die Kosten für die erneute Verarbeitung des Kontexts bei der Suche zu amortisieren.
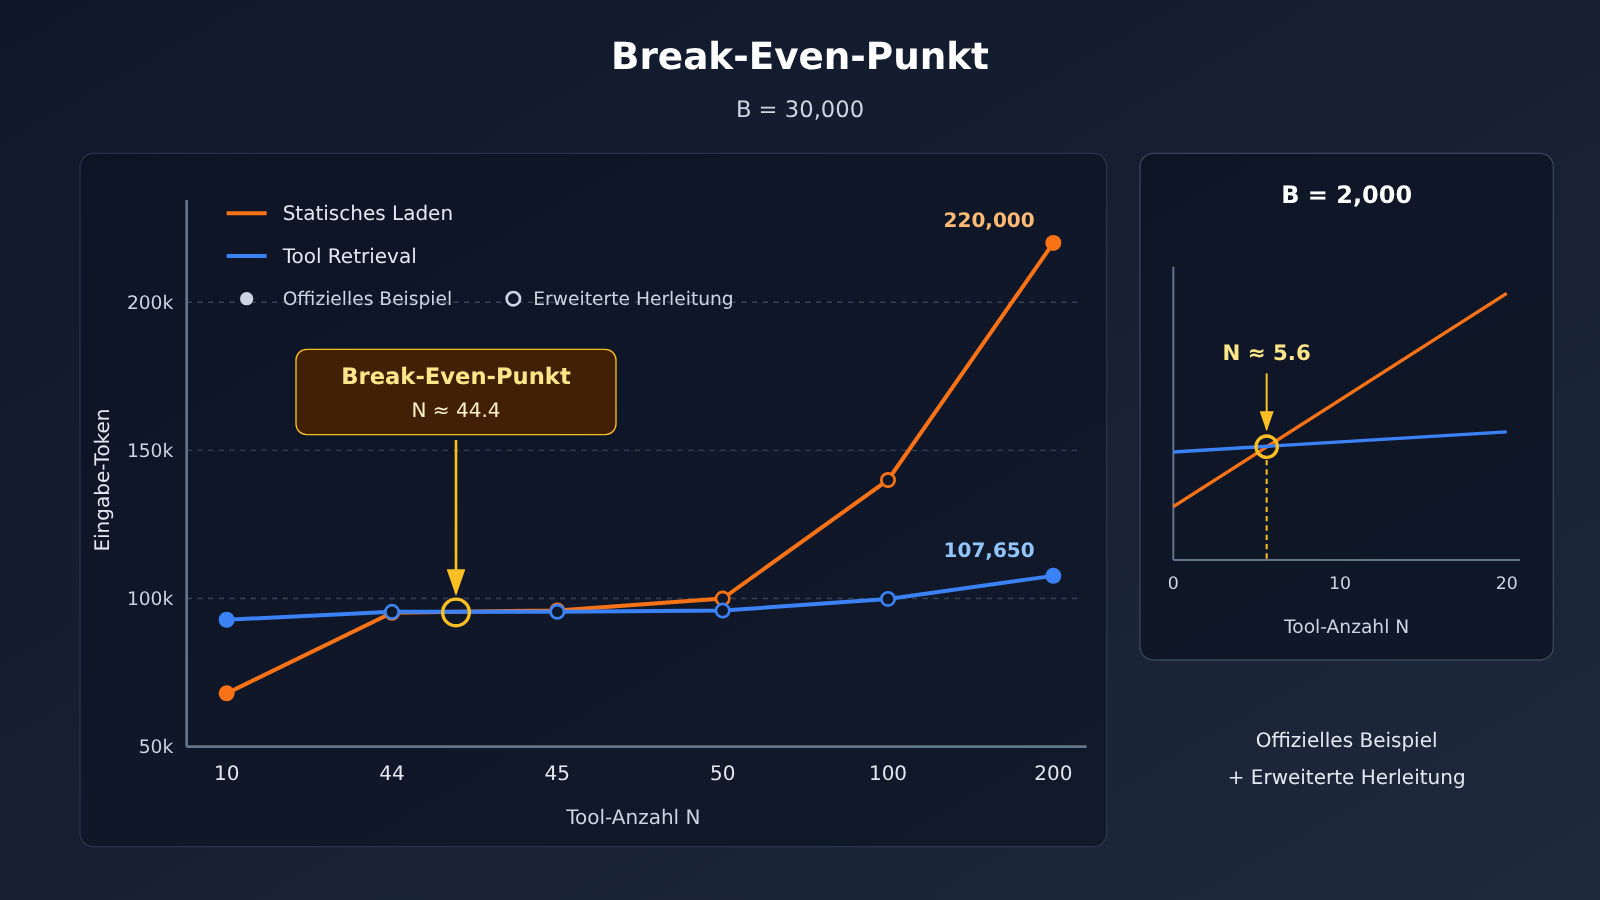
Bildunterschrift: Die ersten beiden Datenzeilen sind Googles offizielle Rechenbeispiele, der Rest ist eine Ableitung nach derselben Methodik. In echten Aufgaben verändern Suchhäufigkeit und Ladeumfang die Kurve – am besten testen Sie das mit Ihren eigenen Geschäftsanfragen erneut. Über die einheitliche Schnittstelle von APIYI apiyi.com lassen sich schnell statische Lade-Baselines mehrerer Modelle zum Vergleich aufsetzen.
Reale Aufgaben entsprechen diesen Annahmen selten exakt; die folgenden Variablen verschieben den Break-even-Punkt:
- Anzahl der Suchvorgänge: Jede zusätzliche serverseitige Suche bedeutet eine weitere Modelleingabe in der Größenordnung von „B + Tool-Liste + geladene Schemas“. In langen Kontexten läuft es praktisch darauf hinaus, dass B jedes Mal erneut bezahlt wird.
- Tatsächlich geladene Anzahl K: Je mehr Tools geladen werden, desto geringer fällt die Einsparung aus; bereits geladene Schemas lassen sich nicht entladen und summieren sich in langen Sitzungen immer weiter.
- Größe eines einzelnen Schemas S: Bei Tools mit komplexen Parametern und langen Beschreibungen bringt bedarfsgerechtes Laden mehr; ist das Schema sehr kurz, werden die Einsparungen durch Listeneinträge und Suchanweisungen aufgezehrt.
- Anzahl der Gesprächsrunden: Beim statischen Ansatz müssen in jeder Runde alle Schemas wiederholt werden. Je mehr Runden es gibt und je weniger dabei neue Suchen ausgelöst werden, desto deutlicher wird der Vorteil des bedarfsgerechten Ladens.
Weniger Eingabe-Token, niedrigere Gesamtkosten, schnellere Antworten: die drei Arten von „Einsparungen“ bei Gemini Tool Retrieval
Diese drei Dinge werden oft in einen Topf geworfen, sind aber nicht gleichbedeutend. Die Reduzierung der Eingabe-Token ist am offensichtlichsten, aber wer nur total_input_tokens betrachtet, übersieht die Inferenz nach der Suche, die unter total_tool_use_tokens verbucht wird, und überschätzt dadurch das Ausmaß der Einsparung.
Niedrigere Gesamtkosten hängen außerdem von Caching und dem Preis pro Token ab. Bedarfsgerechtes Laden macht den initialen Prompt kürzer. Wenn man die implizite Cache-Schwelle von 4,096 Token ursprünglich nur dank einer großen Zahl von Schemas überschritten hat, kann man den Cache nach der Aktivierung sogar verlieren. Wenn die kurze Schleife aus Funktionsaufruf und Ergebnisrückgabe weniger als 2,050 Token an neuem Inhalt hinzufügt, erhält Gemini 4 auch nicht den vollständigen Cache der vorherigen Anfrage. Mit anderen Worten: Es sind weniger Token, aber die Preisstruktur kann sich verschlechtern.
Schnellere Antworten sind derzeit durch keine offiziellen oder unabhängigen Daten belegt. Die serverseitige Suche verursacht keine zusätzlichen Client-Roundtrips, aber innerhalb der Anfrage läuft sehr wohl zusätzliche Modellinferenz; die clientseitige Suche fügt pro Suche einen zusätzlichen API-Roundtrip hinzu. Ob die Latenz nun sinkt oder steigt, lässt sich nur mit eigenen End-to-End-Tests beantworten.
So berechnen Sie die tatsächliche Abrechnung einer Gemini Tool Retrieval Agent-Aufgabe
Nach der offiziellen Usage-Semantik lässt sich eine einzelne Anfrage – unter der Voraussetzung einer Standardabrechnung, dass Cache-Token bereits in der Eingabe enthalten sind und keine weiteren pro Aufruf abgerechneten Tools zum Einsatz kommen – wie folgt schätzen:
USD ≈ [(I + U − C) × P_in + C × P_cache + (O + T) × P_out] / 1,000,000
Dabei entsprechen I, U, C, O und T der Reihe nach den fünf Feldern aus der obigen Tabelle. Eine Agent-Aufgabe erstreckt sich oft über mehrere Anfragen. Deshalb müssen die Usage-Werte jeder Anfrage zunächst summiert und dann berechnet werden. Die Kosten pro erfolgreich abgeschlossener Aufgabe ergeben sich schließlich als „Gesamtkosten ÷ Anzahl erfolgreich abgeschlossener Aufgaben“.
Bevor Sie Tool Retrieval aktivieren, ist es am sichersten, zuerst eine Baseline für das statische Laden zu messen. Im folgenden Beispiel wird über eine OpenAI-kompatible Schnittstelle ein statischer Function-Calling-Aufruf ausgeführt und die Baseline-Usage protokolliert:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Einheitliche APIYI-Schnittstelle für die statische Lade-Baseline
)

resp = client.chat.completions.create(
    model="gemini-3.8-flash",  # Modellname gemäß Modellliste der Plattform
    messages=[{"role": "user", "content": "Refund 40 USD for order A-1042."}],
    tools=[{"type": "function", "function": {"name": "issue_refund",
            "parameters": {"type": "object", "properties": {
                "order_id": {"type": "string"}, "amount": {"type": "number"}},
                "required": ["order_id", "amount"]}}}]
)
print(resp.usage)  # Eingabe- und Ausgabe-Token beim statischen vollständigen Laden protokollieren
Hinweis: Tool Retrieval selbst hängt von der Version v1beta der Google Interactions API ab. Das obige Beispiel dient nur dazu, Vergleichsdaten für das statische Laden zu erhalten. Für das bedarfsgesteuerte Laden verwenden Sie bitte eine Aufrufmethode, die die Interactions API unterstützt, und setzen Sie anschließend die Usage-Werte beider Ansätze in dieselbe Kostenformel, um sie zu vergleichen.
Vollständigen Implementierungscode ansehen: Break-even-Berechnung + Usage-Abrechnungsschätzung
import openai

# ---------- 1. Theoretische Berechnung nach offizieller Beispielrechnung (erweitertes Beispiel, keine offiziellen Schwellenwerte) ----------
def static_tokens(B: int, N: int, S: int = 400) -> int:
    return 2 * (B + N * S)

def retrieval_tokens(B: int, N: int, D: int = 26, H: int = 150,
                     K: int = 2, S: int = 400) -> int:
    return 3 * (B + N * D + H) + 2 * K * S

def breakeven_tools(B: int) -> float:
    return (B + 2050) / 722  # gilt nur bei S=400, D=26, H=150, K=2

for B, N in [(2000, 200), (30000, 10), (30000, 45), (30000, 100)]:
    s, r = static_tokens(B, N), retrieval_tokens(B, N)
    print(f"B={B:>6} N={N:>3} static={s:>7} retrieval={r:>7} "
          f"change={(r - s) / s:+.1%}")
print("B=30000 临界工具数:", round(breakeven_tools(30000), 2))

# ---------- 2. Kosten pro Anfrage anhand der Usage-Felder schätzen (US-Dollar) ----------
def request_cost(I, U, C, O, T, p_in, p_cache, p_out) -> float:
    """I/U/C/O/T entsprechen total_input / tool_use / cached / output / thought tokens"""
    return ((I + U - C) * p_in + C * p_cache + (O + T) * p_out) / 1_000_000

# Beispiel: Gemini 4 Hydrogen Standardpreis 1.50 / 0.075 / 7.50 (pro Million Token)
print(request_cost(I=7350, U=8150, C=0, O=200, T=0,
                   p_in=1.50, p_cache=0.075, p_out=7.50))

# ---------- 3. Baseline mit statischem Laden (OpenAI-kompatible Schnittstelle) ----------
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_static_baseline(prompt: str, tools: list, model: str = "gemini-3.8-flash"):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools
    )
    return resp.usage  # bei der Aggregation über mehrere Runden pro Anfrage aufsummieren
🚀 Schnellstart: Am besten führst du zuerst auf APIYI (apiyi.com) mit einem einzigen Key die Baseline mit statischem Laden aus, hältst die Token-Werte und die Abschlussrate für dein echtes Aufgabenset fest und entscheidest erst danach, ob du den Agenten auf bedarfsgesteuertes Laden umstellst – so vermeidest du, die Architektur allein aufgrund der offiziellen Beispielzahlen umzubauen.
Gemini Tool Retrieval: Aktivierungsentscheidung – erfüllt Ihre Tool-Bibliothek die Voraussetzungen?
Auf Basis der offiziellen Engineering-Empfehlungen und der obigen Herleitung lässt sich mit der folgenden Tabelle eine erste Einschätzung vornehmen. Endgültig ausschlaggebend sind jedoch die Kosten pro erfolgreich abgeschlossenem Task und die Abschlussrate bei echten Aufgaben:
| Workload-Merkmale | Empfohlene Strategie | Begründung |
|---|---|---|
| Weniger als etwa 20 stabile Tools, die meisten werden in jeder Runde genutzt | Weiterhin statisch laden | Offizielle Empfehlung; das eingesparte Schema ist gering, der Suchaufwand hat einen hohen Anteil |
| Wenige Tools, aber sehr langer Basiskontext | Statisch laden oder nur wenige Tools mit großem Schema verzögert laden | Jede Suche verarbeitet den langen Kontext erneut – das Rechenbeispiel mit 10 Tools ist ein Gegenbeispiel |
| Dutzende bis Hunderte Tools, pro Aufruf nur wenige genutzt | Vorrangig serverseitige Retrieval prüfen | Eine große Long-Tail-Tool-Bibliothek entspricht dem offiziellen Rechenbeispiel mit 200 Tools |
| Mischung aus häufig genutzten Tools + vielen selten genutzten Fach-Tools | Häufige Tools direkt laden, seltene über defer_loading |
Offiziell empfohlene Mischform; vermeidet, dass auch einfache Aufgaben zuerst suchen müssen |
| Multi-Tenant, dynamische Tools, Filterung nach Benutzerberechtigungen erforderlich | Client-seitiges Retrieval prüfen | Lässt sich an eine selbst gebaute Registry anbinden, aber jede Suche bedeutet einen zusätzlichen Roundtrip |
| Tools, die in Systemanweisungen oft namentlich genannt werden | Direkt geladen lassen | Offizielle Warnung: Namentlich genannte, verzögerte Tools können die Suche umgehen und direkt aufgerufen werden – das führt zu Fehlern |
💡 Auswahlhinweis: Dieselbe Aufgabengruppe einmal mit der statischen und einmal mit der bedarfsgesteuerten Variante durchlaufen und dabei Modell, Tool-Bibliothek, Kontextlänge und Cache-Bedingungen konstant halten. Über APIYI apiyi.com lassen sich unter einer einheitlichen Schnittstelle verschiedene Gemini- und andere gängige Modelle als Baseline-Vergleich umschalten – so können Sie Kostendifferenzen direkt auf die Tool-Lade-Strategie zurückführen.
Ein paar Engineering-Details wirken sich direkt auf die Rechnung aus: Bei store=false und selbst verwalteter Historie müssen tool_search_call, tool_search_result und deren signature unverändert beibehalten werden, sonst können nachfolgende Anfragen mit HTTP 400 fehlschlagen. Die parameters verzögerter Tools dürfen nicht weggelassen werden, nur um den Request-Body zu verkleinern. Beim Debugging muss man die function_call-Einträge in interaction.steps prüfen und nicht nur auf interaction.status schauen. Sobald diese Probleme einen Retry auslösen, zählen auch die Tokens der wiederholten Anfragen in die Kosten.
Letztlich ist Tool Retrieval ein Kostenwerkzeug, das auf der Prämisse beruht, dass „wenige Tools häufig genutzt werden, die meisten aber dauerhaft ungenutzt bleiben“. Die beiden offiziellen Rechenbeispiele mit entgegengesetzter Stoßrichtung haben die Grenzen klar aufgezeigt: Je größer die Tool-Bibliothek, je kürzer der Kontext und je seltener die Suche, desto wahrscheinlicher lässt sich sparen; umgekehrt kann es teurer werden. Was wirklich optimiert werden sollte, ist nicht die Token-Zahl der ersten Anfrage, sondern die Gesamtrechnung pro erfolgreich abgeschlossenem Task.
Wie der Qing-Gelehrte Chen Danran in „Wuyan · Qian Du Jianfan Yi“ schrieb: „Wer das Ganze nicht im Blick hat, ist nicht in der Lage, einen einzelnen Bereich zu gestalten.“
Referenzen
- Offizielle Google-Ankündigung: Introducing Tool Retrieval in the Gemini API (19.11.2026)
- Link:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- Link:
- Google Tool Retrieval – Technische Dokumentation: Konfiguration, Abrechnung, offizielle Beispielrechnungen und Einschränkungen
- Link:
aistudio.google.com/docs/tool-retrieval
- Link:
- Google Context Caching – Dokumentation: Schwellenwerte für implizites Caching und Regeln für Multi-Turn-Caching in Gemini 4
- Link:
aistudio.google.com/docs/caching
- Link:
- Google Gemini Developer API – Preise: Tarife für Modelleingabe, -ausgabe und Caching
- Link:
aistudio.google.com/docs/pricing
- Link:
Autor: APIYI Technikteam
Technischer Austausch: Wenn Sie die Token-Kosten verschiedener Modelle wie Gemini im Agent-Szenario vergleichen möchten, besuchen Sie gerne APIYI unter apiyi.com, um Testguthaben zu erhalten. Weitere Hinweise zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.


