
Anmerkung des Autors: Bei der Produktion eines Videos müssen Transkription, Szenenanalyse, Cover-Erstellung und Textüberarbeitung erledigt werden. Die Modelle können jeweils ihre eigene Rolle übernehmen, aber die kostenpflichtigen Schritte sollten möglichst unter derselben base_url laufen – nur dann stimmt die Abrechnung am Ende.
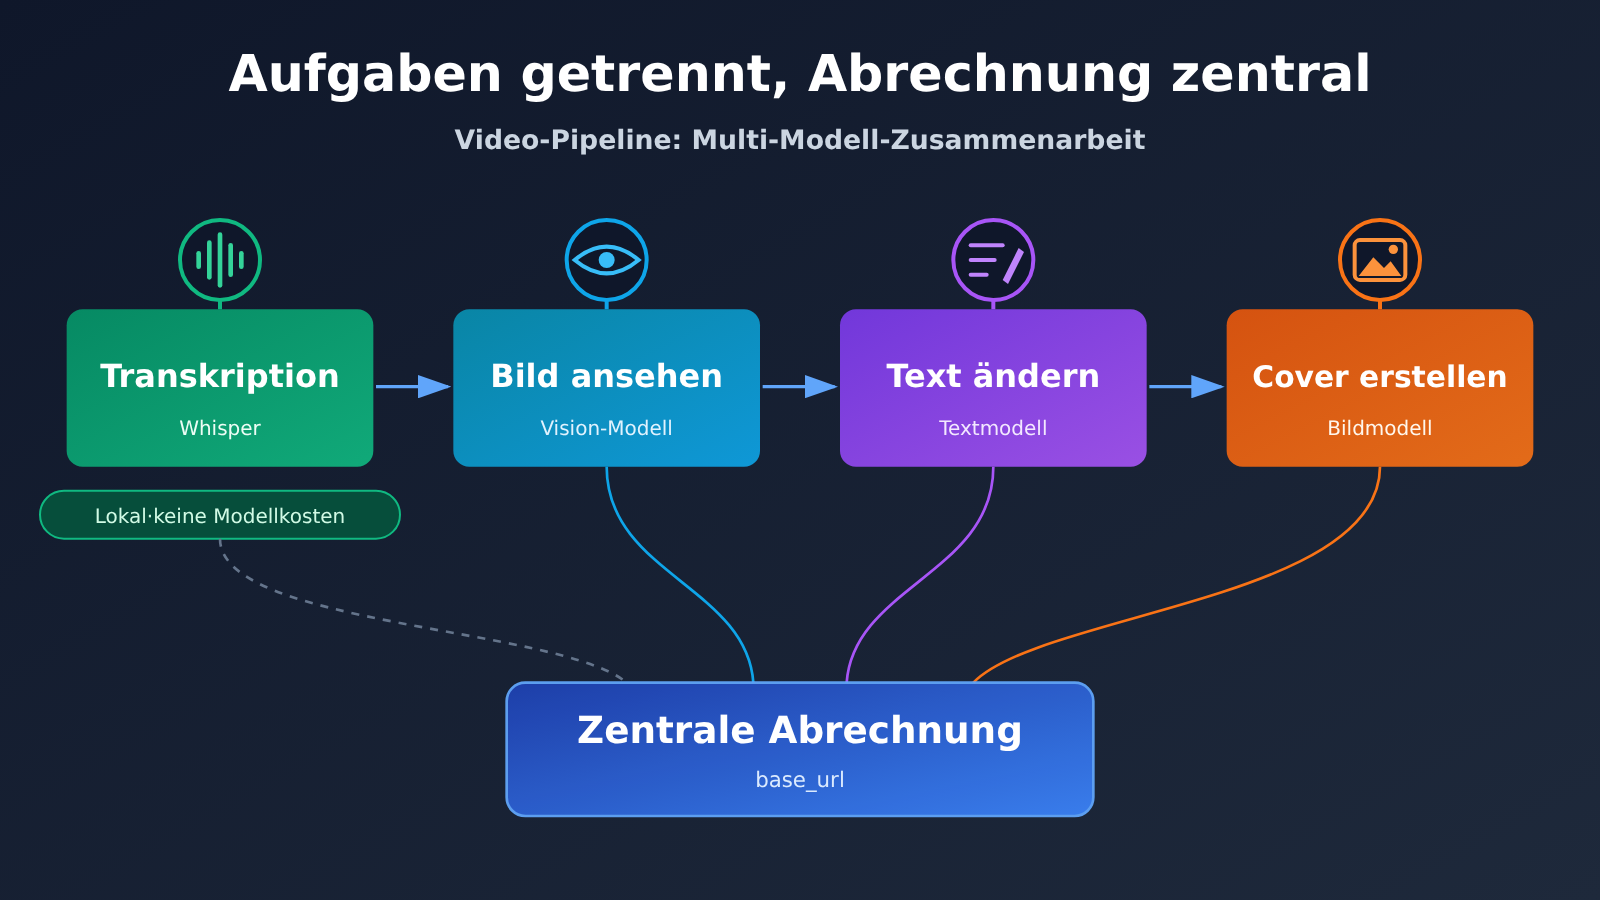
Wer schon einmal ein komplettes Langvideo produziert hat, kennt vermutlich dieses Phänomen: Die Transkription läuft bei einem Anbieter, die Szenenanalyse bei einem anderen, die Cover-Erstellung wieder woanders, und für die Überarbeitung von Titel und Text öffnet man noch ein weiteres Fenster. Jeder Schritt wirkt für sich vernünftig, doch am Monatsende stehen vier oder fünf Rechnungen mit unterschiedlicher Abrechnungslogik auf dem Tisch – mal nach Token, mal pro Aufruf, mal mit einem Abonnement vermischt. In diesem Artikel geht es um beibehaltene Arbeitsteilung, gebündelte Abrechnung: Zuerst klären wir, welcher Schritt lokal bleiben kann und welcher wirklich Kosten verursacht. Danach bündeln wir die kostenpflichtigen Schritte an einem einzigen Aufruf-Einstiegspunkt.
Das ist keine Empfehlung, nur ein einziges Modell zu verwenden. Unterschiedliche Phasen eignen sich ohnehin für unterschiedliche Modelle. Was wirklich vereinheitlicht werden muss, sind der Abrechnungszugang und die Abrechnungslogik – nicht das Modell selbst.
Der Kernnutzen: Nach dem Lesen dieses Artikels haben Sie eine Aufteilungstabelle „lokal / kostenpflichtig“ für die Videopipeline, eine am 2026-11-20 geprüfte Übersicht über Modelle und Preise sowie eine Anleitung, wie Sie kostenpflichtige Schritte auf dieselbe base_url umstellen.
Die Kernpunkte, wenn für ein Video mehrere Modelle zusammenspielen
Auslöser dieser Diskussion war eine Videobearbeitungs-Fähigkeit, die MindStudio am 2026-11-19 wiedergegeben hat. Der Autor beschreibt, dass ein langes Video mit einer fortgeschrittenen multimodalen Pipeline etwa 2,71 US-Dollar kostet. Wichtig klarzustellen: Diese Zahl ist die Aussage des Autors selbst, sie stammt von OpenRouter und ist weder eine Rechnung von APIYI noch ein Messergebnis dieses Artikels. Ihr Referenzwert liegt darin, dass die Modellkosten für ein Video auf einem sehr niedrigen Niveau bleiben können – vorausgesetzt, man weiß, in welchen Schritten das Geld ausgegeben wird.
| Punkt | Erläuterung | Nutzen |
|---|---|---|
| Lokales und Bezahltes zuerst trennen | Die Transkription kann mit lokalem Whisper laufen, ohne Modellkosten | Eine Rechnung weniger und ein Datenabfluss weniger |
| Bezahlte Schritte bündeln | Sichtprüfung, Textüberarbeitung und Cover-Erstellung laufen über dieselbe base_url | Alle Verbräuche in einem Backend einsehen |
| Modellwechsel nur über die ID | Die Schnittstelle ist OpenAI-kompatibel, beim Wechsel ändert man das Feld model |
Die Arbeitsteilung lässt sich jederzeit anpassen, ohne Code umzuschreiben |
| Pro Aufruf und pro Token getrennt rechnen | Cover pro Aufruf, Text und Vision pro Token | Klare Grundlage für die Budgetschätzung |
| Schritte außerhalb des Sortiments separat erfassen | Stimmklonung ist nicht im APIYI-Sortiment | Bei der Abrechnung wird nichts falsch gezählt |
Die Arbeitsteilung in der Videopipeline im Detail
Der erste Schwerpunkt ist die „Arbeitsteilung“ selbst. Das Ansehen des Videobilds und das Verstehen der Kamerainhalte erfordert Modelle mit starker multimodaler Verständnisfähigkeit und langem Kontextfenster; die Cover-Erstellung braucht ein Bildgenerierungsmodell; die Textüberarbeitung ist empfindlicher gegenüber Schreibqualität und Kosten. Steckt man diese Aufgaben in dasselbe Modell, leidet oft die Qualität in einem Glied oder die Kosten in einem anderen. Arbeitsteilung ist also sinnvoll – das Problem entsteht nur dadurch, dass jeder Anbieter ein eigenes Konto, eine eigene Aufladung und eine eigene Abrechnung hat.
Der zweite Schwerpunkt ist das „Bündeln“. APIYI apiyi.com ist eine Aggregationsplattform für LLM-APIs: Mit einem API-Schlüssel ruft man gängige Modelle wie OpenAI, Claude und Gemini auf, die Schnittstelle ist OpenAI-kompatibel und die Abrechnung erfolgt nach Verbrauch. Für eine Videopipeline bedeutet das: Die bezahlten Schritte Sichtprüfung, Textüberarbeitung und Cover-Erstellung können einen gemeinsamen Schlüssel und eine gemeinsame base_url nutzen, und der Verbrauch wird an einer Stelle verbucht. Beim Modellwechsel ändert man die Modell-ID, nicht den Anbieter oder das SDK.
Schnellstart, wenn für ein Video mehrere Modelle aufgerufen werden
Erster Schritt: Die Video-Pipeline in lokale und kostenpflichtige Teile aufteilen
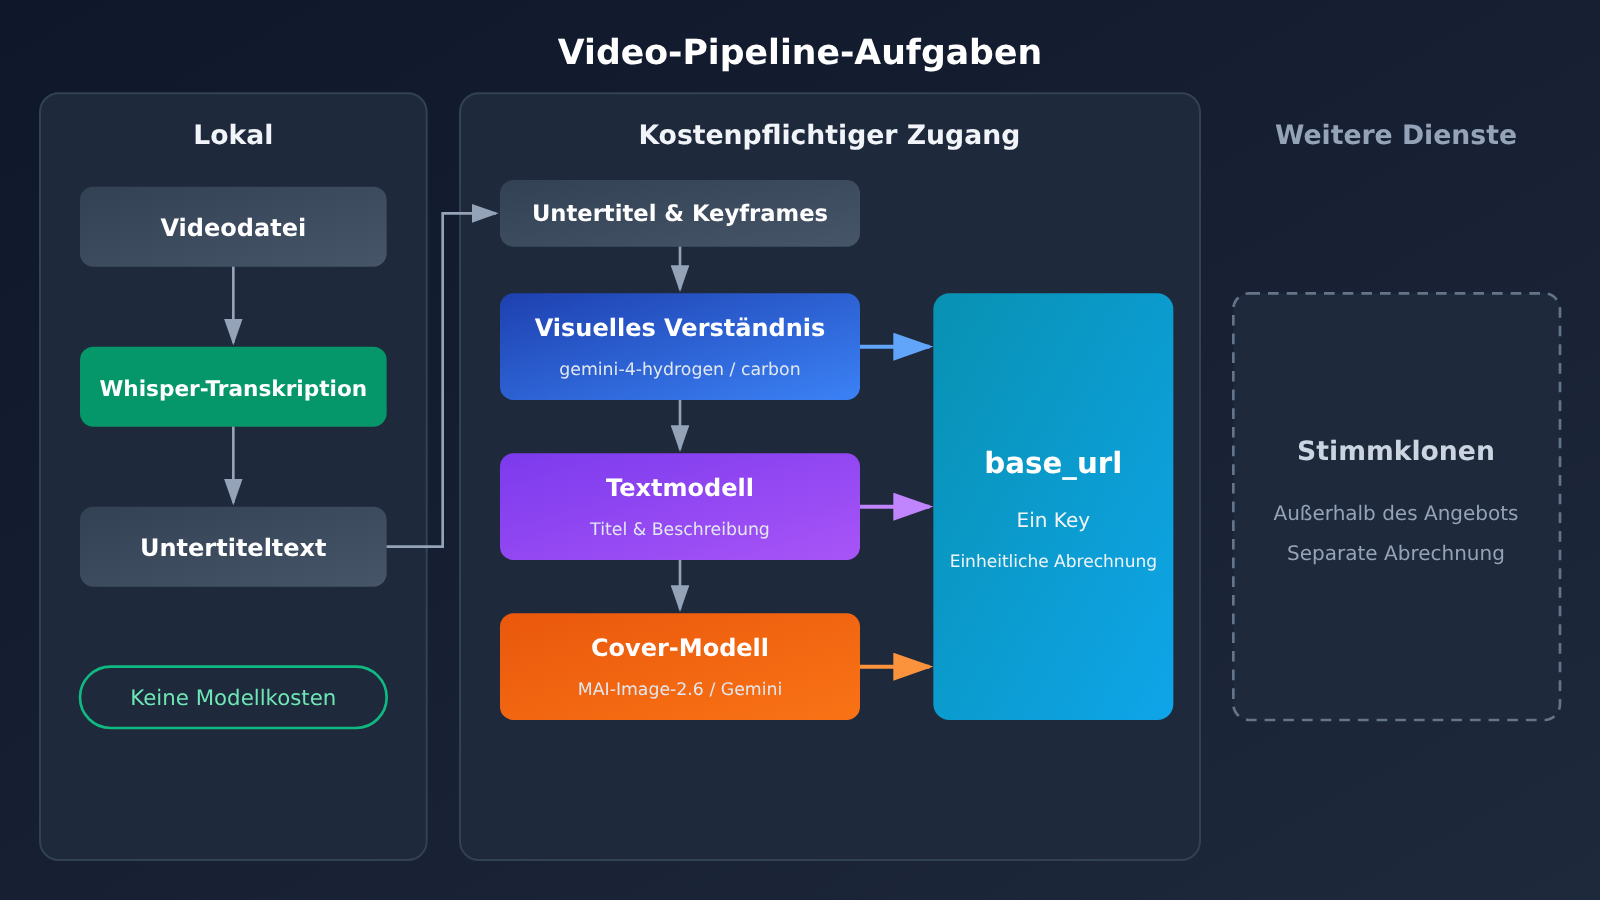
Bevor Sie die APIs anbinden, sollten Sie für jeden Schritt klar festhalten, welche Art von Abrechnung anfällt. Die folgende Tabelle zeigt die Aufteilung einer typischen Langvideo-Pipeline – Sie können sie je nach eigenem Ablauf ergänzen oder kürzen.
| Schritt | Empfohlener Ausführungsort | Modellkosten? | Abrechnungsgrundlage |
|---|---|---|---|
| Audiotranskription | Lokales Whisper | Nein | Beansprucht nur lokale Rechenleistung |
| Schnitt, Zusammenfügen, Export | Lokales Schnittwerkzeug | Nein | Keine |
| Bildanalyse, Szenenverständnis | Einheitlicher API-Zugang | Ja | Nach Eingabe-/Ausgabe-Token |
| Titel überarbeiten, Beschreibung schreiben | Einheitlicher API-Zugang | Ja | Nach Eingabe-/Ausgabe-Token |
| Cover erstellen | Einheitlicher API-Zugang | Ja | Pro Aufruf |
| Stimmklon | Anderer Dienst | Ja | Nicht im APIYI-Sortiment, separate Abrechnung |
Nach dieser Aufteilung bleiben nur drei kostenpflichtige Schritte übrig, die wirklich zentral abgewickelt werden müssen. Die Transkription läuft lokal – das kostet keine Modellgebühren, und das Originalaudio muss nicht hochgeladen werden. Falls Sie das Stimmklonen tatsächlich brauchen, ist es eine eigene Rechnung: Planen Sie dafür im Budget einen separaten Posten ein und rechnen Sie es nicht dem einheitlichen Zugang zu.
Schritt 2: Modellbezeichnungen und Preise prüfen
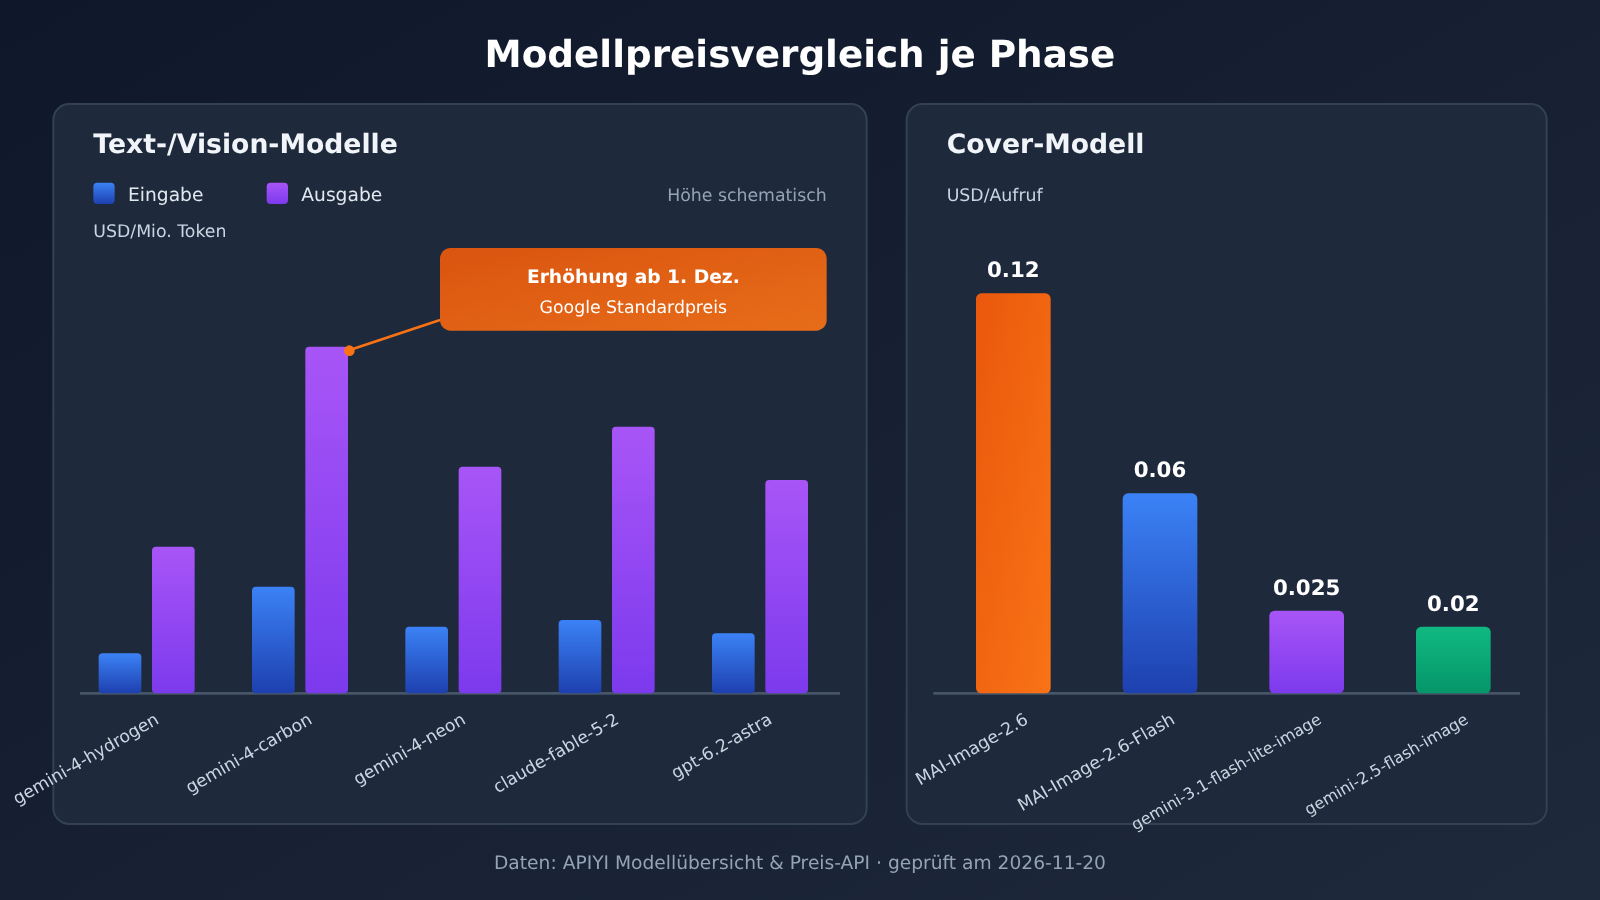
Als Nächstes geht es um die Modellbezeichnungen und den Preisabgleich. Die folgenden Preise wurden am 2026-11-20 geprüft; Quelle sind die Modellübersicht von APIYI unter docs.apiyi.com/models.md (diese Version wurde am 2026-11-19 10:59 UTC+8 aktualisiert) sowie die Pricing-API api.apiyi.com/api/pricing (Version shell-api-modelmak-v1). In der Pricing-API entspricht model_ratio = 1 einer Eingabe von 2 USD pro Million Token – damit lässt sich alles selbst umrechnen.
| Modell-ID | Eingabe (USD/Million Token) | Ausgabe | Cache-Lesen | Geeignet für |
|---|---|---|---|---|
gemini-4-hydrogen |
1.5 | 7.5 | 0.075 | Bild prüfen, Text überarbeiten – kostengünstig |
gemini-4-carbon |
2 | 10 | 0.1 | Bild prüfen, Text überarbeiten – Einführungspreis bis 2026-11-30 |
gemini-4-argon |
2 | 10 | 0.1 | Text- und Verständnisaufgaben |
gemini-4-neon |
3 | 15 | 0.15 | Reserve, wenn mehr Leistung gefragt ist |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 40 | 0.2 | Lange Texte verfeinern, komplexe Umschreibungen |
gpt-6.2-astra |
8 (über 272000 Token: 16) | 40 | 0.4 | Anspruchsvolle Textaufgaben |
Zwei Punkte verdienen besondere Aufmerksamkeit. Die Werte 2 / 10 / 0.1 für gemini-4-carbon entsprechen Googles Einführungspreis bis 2026-11-30; ab dem 1. Dezember gilt Googles Standardpreis mit Eingabe 4 und Ausgabe 20, dann verdoppeln sich die Kosten – vor lang laufenden Batch-Jobs also erneut nachprüfen. Bei gpt-6.2-astra steht in der Modellübersicht ab 272000 Token eine Eingabe von 16, während die Pricing-API für diese Stufe zusätzlich Ausgabe 60 und Cache-Lesen 0.8 nennt. Welche Angabe gilt, entscheidet letztlich die Abrechnung im Backend bei deinem tatsächlichen Aufruf. gemini-4-neon ist in dieser Version der Modellübersicht nicht aufgeführt, taucht aber in der Pricing-API auf; die umgerechneten Werte stimmen mit Googles Listenpreis überein.
Der Cover-Schritt wird pro Aufruf abgerechnet, deshalb dafür eine eigene Tabelle:
| Cover-Modell-ID | Preis pro Aufruf (USD) | Geeignete Szenarien |
|---|---|---|
MAI-Image-2.6 |
0.12 | Hauptcover, wenn höhere Qualität gefragt ist |
MAI-Image-2.6-Flash |
0.06 | Mehrere Varianten zum Ausprobieren |
gemini-3.1-flash-lite-image |
0.025 | Skizzen in großen Mengen |
gemini-2.5-flash-image |
0.02 | Schnelle Bilderzeugung zu geringen Kosten |
Achtung: MAI-Image-2.7 gibt es derzeit noch nicht – schreibe es nicht als aufrufbares Modell in dein Skript. Kling, Muse und gemini-4-flash-lite fehlen sowohl in der Modellübersicht als auch in der Pricing-API und sind bei der Planung der Pipeline direkt auszuschließen.
Schritt 3: Die kostenpflichtigen Aufrufe auf dieselbe base_url umstellen
Dieser Schritt ist sehr klein. Wenn du bisher das offizielle OpenAI SDK verwendet hast, musst du nur zwei Dinge ändern:
- Ersetze
api_keydurch den Key, den du im APIYI-Backend erzeugt hast. - Setze
base_urlaufhttps://api.apiyi.com/v1.
Danach schreibst du für die Anfrage zur Bildanalyse als model gemini-4-hydrogen, für die Anfrage zur Textüberarbeitung claude-fable-5-2 oder verwendest weiterhin Gemini, und für die Cover-Erstellung MAI-Image-2.6-Flash. Alle drei Bereiche nutzen dasselbe Client-Objekt; der Unterschied liegt nur in der Modell-ID. Chat-Anfragen laufen über den OpenAI-kompatiblen Endpunkt /chat/completions. Die konkreten Parameter und Rückgabeformate der Bildmodelle richten sich nach den Angaben in der Modell-Dokumentation.
Konfigurationscheckliste für die einzelnen Schritte anzeigen
– **Client**: Nur einmal initialisieren, `base_url` unverändert lassen, den Key in eine Umgebungsvariable legen, zum Beispiel `APIYI_API_KEY`.
– **Bildanalyse**: Keyframe-Screenshots und die lokal transkribierten Untertitel gemeinsam als Eingabe verwenden, `model` auf `gemini-4-hydrogen` setzen; wenn das Budget es zulässt oder ein besseres Verständnis nötig ist, auf `gemini-4-carbon` wechseln.
– **Textüberarbeitung**: Die im vorherigen Schritt ausgegebene Szenenzusammenfassung als Kontext verwenden, als `model` `claude-fable-5-2` wählen; für längere Skripte, die mehrstufiges Reasoning erfordern, kann `claude-fable-5-2-thinking` verwendet werden.
– **Cover-Erstellung**: Zuerst mit `gemini-2.5-flash-image` einige Entwürfe erzeugen, nach der Finalisierung mit `MAI-Image-2.6` das offizielle Cover erstellen.
– **Cache**: Die Untertitel derselben Videodatei werden in mehreren Schritten wiederholt gelesen. Achte darauf, dass der gemeinsame Teil einen einheitlichen Präfix behält, damit du vom günstigeren Cache-Lesetarif profitierst.
– **Logs**: Bei jeder Anfrage die Modell-ID und den zurückgegebenen Token-Verbrauch protokollieren und zum Monatsende den Verbrauch Posten für Posten mit dem Backend abgleichen.
🚀 Tipp für den schnellen Einstieg: Nutze zuerst auf APIYI unter apiyi.com das kostenlose Testkontingent für neue Nutzer, führe ein kurzes Video vollständig durch die drei oben genannten Schritte aus, notiere den tatsächlichen Token-Verbrauch pro Schritt und entscheide dann, welche Modellstufe du für längere Videos einsetzen solltest.
Schritt 4: Das Budget für ein Video schätzen
Bei der Schätzung sollten Sie Token-Kosten und Kosten pro Aufruf getrennt berechnen. Ein hypothetisches Beispiel: Wenn das Sichten des Bildmaterials und das Überarbeiten des Skripts zusammen 1 Million Eingabe-Token und 100.000 Ausgabe-Token verbrauchen, ergibt sich mit gemini-4-hydrogen ein Betrag von 1,5 + 0,75, also etwa 2,25 US-Dollar. Für das Cover werden vier Flash-Entwürfe und eine finale Version erzeugt, das sind 4 × 0,06 + 0,12, also 0,36 US-Dollar. Die Token-Zahlen sind hier nur hypothetische Demo-Werte; Ihr tatsächlicher Verbrauch hängt von der Videolänge, der Frame-Dichte und der Anzahl der Skript-Iterationen ab.
Der Vorteil dieser Schätzmethode: Jeder Posten lässt sich Zeile für Zeile mit der Abrechnung im Backend abgleichen. Wenn die vier Schritte dagegen auf vier verschiedene Anbieter verteilt sind, unterscheiden sich Wechselkurse, Abrechnungseinheiten und Abbuchungszeitpunkte – selbst wenn der Gesamtbetrag klein ist, kostet die Abstimmung viel Zeit.
Häufig gestellte Fragen (FAQ)
F1: Bei einem Video kommen mehrere Modelle zum Einsatz – welche Schritte sind damit genau gemeint?
In der Regel sind das vier Schritte: Transkription, Bildanalyse, Textüberarbeitung und Cover-Erstellung; manche Workflows ergänzen noch Voiceover oder Stimmklonierung. Die Transkription lässt sich lokal mit Whisper erledigen, ohne Modellkosten. Modellkosten entstehen meist bei der Bildanalyse, der Cover-Erstellung und der Textüberarbeitung.
F2: Widersprechen sich Arbeitsteilung und Bündelung? Ist ein einziges Modell nicht einfacher?
Nein, sie widersprechen sich nicht. Arbeitsteilung sorgt dafür, dass Qualität und Kosten zusammenpassen, Bündelung sorgt für eine saubere Rechnung und Abrechnung. Ein einziges Modell ist tatsächlich bequemer, aber Bildanalyse, Texterstellung und Bildgenerierung stellen sehr unterschiedliche Anforderungen an die Fähigkeiten – eine erzwungene Vereinheitlichung zahlt sich oft nicht aus. Sinnvoller ist es, die Modelle jeweils passend auszuwählen und dennoch einen einzigen Einstiegspunkt für die Aufrufe zu behalten.
F3: Kann ich die 2,71 US-Dollar pro Langvideo direkt als Budget ansetzen?
Das würde ich nicht direkt übernehmen. Es handelt sich um eine vom Autor genannte Zahl, die MindStudio wiedergibt, und sie stammt aus einem Lauf über OpenRouter – nicht aus einer Abrechnung bei APIYI. Auch Modellkombination, Videolänge und Anzahl der extrahierten Frames dürften bei Ihnen anders aussehen. Sicherer ist es, die Kosten wie in Schritt 4 dieses Artikels mit dem eigenen Token-Verbrauch und den aktuellen Stückpreisen neu zu berechnen.
F4: Soll ich für die Bildanalyse gemini-4-hydrogen oder gemini-4-carbon wählen?
Bei knappem Budget ist `gemini-4-hydrogen` die Wahl: Input 1,5, Output 7,5, Cache-Read 0,075 – das ist der niedrigste Stückpreis in dieser Gruppe. Brauchen Sie ein stärkeres Verständnis, wählen Sie `gemini-4-carbon`. Beachten Sie aber, dass die 2 / 10 ein Einführungspreis bis zum 30.11.2026 sind; ab dem 1. Dezember gilt bei Google der Standardpreis von Input 4 und Output 20. Vor einer langfristigen Nutzung sollten Sie die Preise also erneut prüfen.
F5: Wie stelle ich ein bestehendes Skript auf den einheitlichen Einstiegspunkt um?
Registrieren Sie sich bei APIYI auf apiyi.com und erzeugen Sie einen API-Schlüssel. Ändern Sie dann die `base_url` des SDK auf die Aufrufadresse der Plattform und passen Sie pro Schritt das Feld `model` an. Die bestehende Request-Struktur müssen Sie im Wesentlichen nicht verändern. Neue Nutzer erhalten außerdem ein kostenloses Testkontingent, sodass Sie die gesamte Pipeline zunächst mit einem kurzen Video verifizieren können.
F6: Lässt sich die Stimmklonierung ebenfalls über diesen Einstiegspunkt abwickeln?
Nein. Stimmklonierung ist derzeit nicht im Angebot von APIYI. Falls Sie diesen Schritt benötigen, müssen Sie auf einen anderen Dienst ausweichen und ihn separat abrechnen. Bei der Budgetplanung sollten Sie ihn als eigene Position aufführen, damit er nicht mit dem Verbrauch über den einheitlichen Einstiegspunkt vermischt wird.
F7: Gibt es bekannte Einschränkungen, die ich vorab beachten sollte?
Einige Punkte: `MAI-Image-2.7` gibt es derzeit nicht, und auch Kling, Muse und `gemini-4-flash-lite` sind weder in der Übersichtstabelle noch in der Preis-API zu finden – nehmen Sie diese also nicht in Ihre Skripte auf. Bei `gpt-6.2-astra` steigt der Stückpreis ab mehr als 272000 Token; die Angaben zur Staffelung in der Übersichtstabelle und in der Preis-API weichen leicht voneinander ab, maßgeblich ist die tatsächliche Abrechnung. Preise ändern sich – prüfen Sie vor einem Batch-Lauf am besten noch einmal die Modellübersicht des jeweiligen Tages.
Kerngedanken: Mehrere Modelle in einem Video
- Erst trennen, dann verbinden: Transkription und Schnitt bleiben lokal, nur die kostenverursachenden Schritte werden an die API angebunden.
- Arbeitsteilung beibehalten: Für Bildanalyse, Textüberarbeitung und Cover-Erstellung jeweils das passendste Modell wählen, keine Einheitlichkeit erzwingen.
- Einheitlicher Einstiegspunkt: Alle kostenpflichtigen Schritte teilen sich einen Key und eine base_url – beim Modellwechsel ändert sich nur die Modell-ID.
- Getrennte Abrechnung: Text und Vision werden nach Token abgerechnet, Cover nach Aufrufen – das Budget in zwei Spalten kalkulieren.
- Laufzeit beachten: Der Einführungspreis für
gemini-4-carbongilt bis 2026-11-30, danach steigt der Standardpreis. - Außerhalb des Regals separat aufführen: Voice-Cloning liegt nicht im einheitlichen Einstiegspunkt und muss separat verbucht werden.
- Externe Zahlen nur als Referenz: Die 2,71 USD sind die Angabe des Autors auf OpenRouter, keine APIYI-Rechnung.
Zusammenfassung
Ein Video mehrere Modelle aufrufen zu lassen, ist an sich kein Problem – das Problem ist, dass die Rechnung nicht mehr zusammenpasst. Zusammengefasst drei Punkte:
- Lokal zuerst: Transkription mit lokalem Whisper, Schnitt lokal erledigt – diese beiden Schritte verursachen keine Modellkosten.
- Kostenpflichtige Schritte bündeln: Bildanalyse, Textüberarbeitung und Cover-Erstellung laufen über eine base_url, aufgeteilt nach Modell-ID.
- Nach Tagespreisen kalkulieren: Token-basierte und aufrufbasierte Kosten getrennt schätzen, vor dem Batch-Lauf Preise und verfügbare Modelle erneut prüfen.
Empfehlung: Zuerst mit einem kurzen Video die gesamte Pipeline durchlaufen lassen, den tatsächlichen Verbrauch jedes Schritts notieren und dann auf längere Videos skalieren. Am besten bei APIYI apiyi.com mit dem kostenlosen Testkontingent diese Validierung abschließen – Arbeitsteilung wie gehabt, die Rechnung nur an einem Einstiegspunkt.
📚 Referenzen
-
APIYI-Modellübersicht: Überblick über Modelle und Stückpreise
- Link:
docs.apiyi.com/models.md - Hinweis: Hauptquelle für die Preise in diesem Artikel; diese Version wurde am 2026-11-19 10:59 (UTC+8) aktualisiert
- Link:
-
APIYI-Preis-API: Echtzeitpreise, umgerechnet über den Multiplikator
- Link:
api.apiyi.com/api/pricing - Hinweis: Version
shell-api-modelmak-v1; einmodel_ratiovon 1 entspricht 2 USD pro Million Token Input
- Link:
-
MindStudio-Videoediting-Fähigkeit (sinngemäße Wiedergabe): veröffentlicht am 2026-11-19
- Hinweis: Die Angabe „2,71 USD pro Langvideo“ stammt aus der im Beitrag wiedergegebenen Schilderung des Autors selbst; zum Einsatz kommt OpenRouter
Autor: APIYI-Technikerteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Weitere Modelle und Hinweise zur Nutzung finden Sie im Dokumentationszentrum unter docs.apiyi.com


