
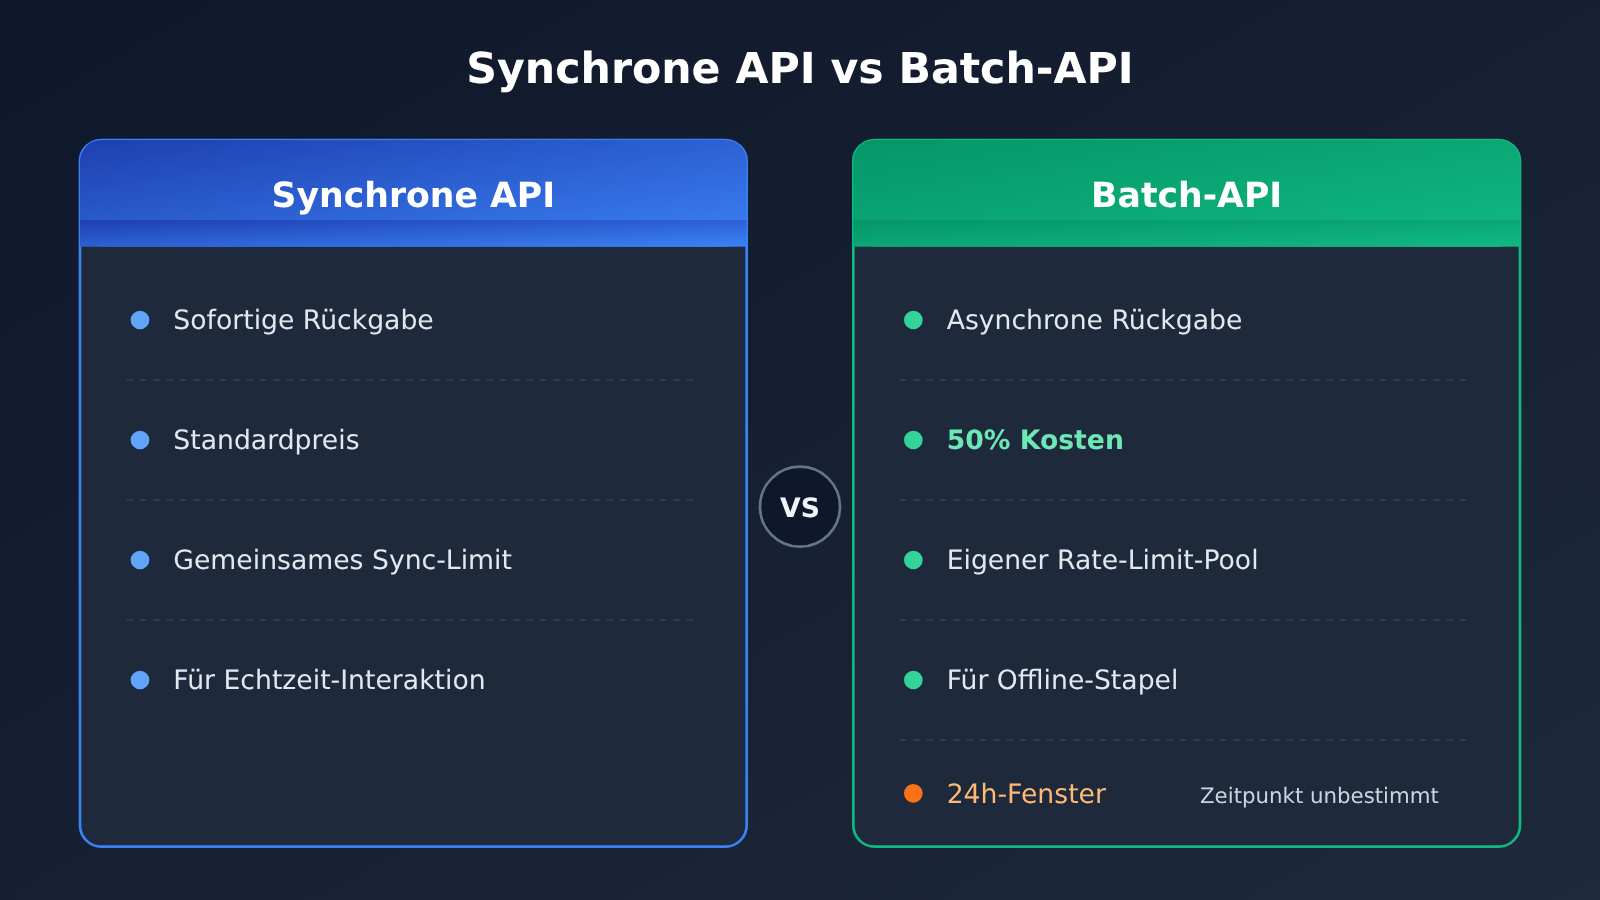
Kurze Antwort: Die OpenAI Batch API eignet sich für Aufgaben, bei denen die Ergebnisse ruhig etwas später eintreffen können, die voneinander unabhängig sind und bei denen das Volumen groß ist. Der Preis liegt bei der Hälfte der synchronen API, und es wird ein eigener Rate-Limit-Pool genutzt. Die Einschränkung ist das 24-Stunden-Verarbeitungsfenster – und dieses Fenster garantiert keine Lieferung zu einem bestimmten Zeitpunkt. Offline-Arbeiten wie die Klassifizierung nach festen Regeln, die Aufbereitung von Wissensdatenbanken oder Modell-Evaluierungen kommen für Batch vorrangig in Frage. Echtzeit-Kundensupport, Interaktionen, die eine sofortige Antwort brauchen, sowie abhängige Abläufe, bei denen das Ergebnis des vorherigen Schritts den Inhalt des nächsten bestimmt, sollten nicht an die Batch API gehen.
Was Sie nach dem Lesen dieses Artikels wissen?
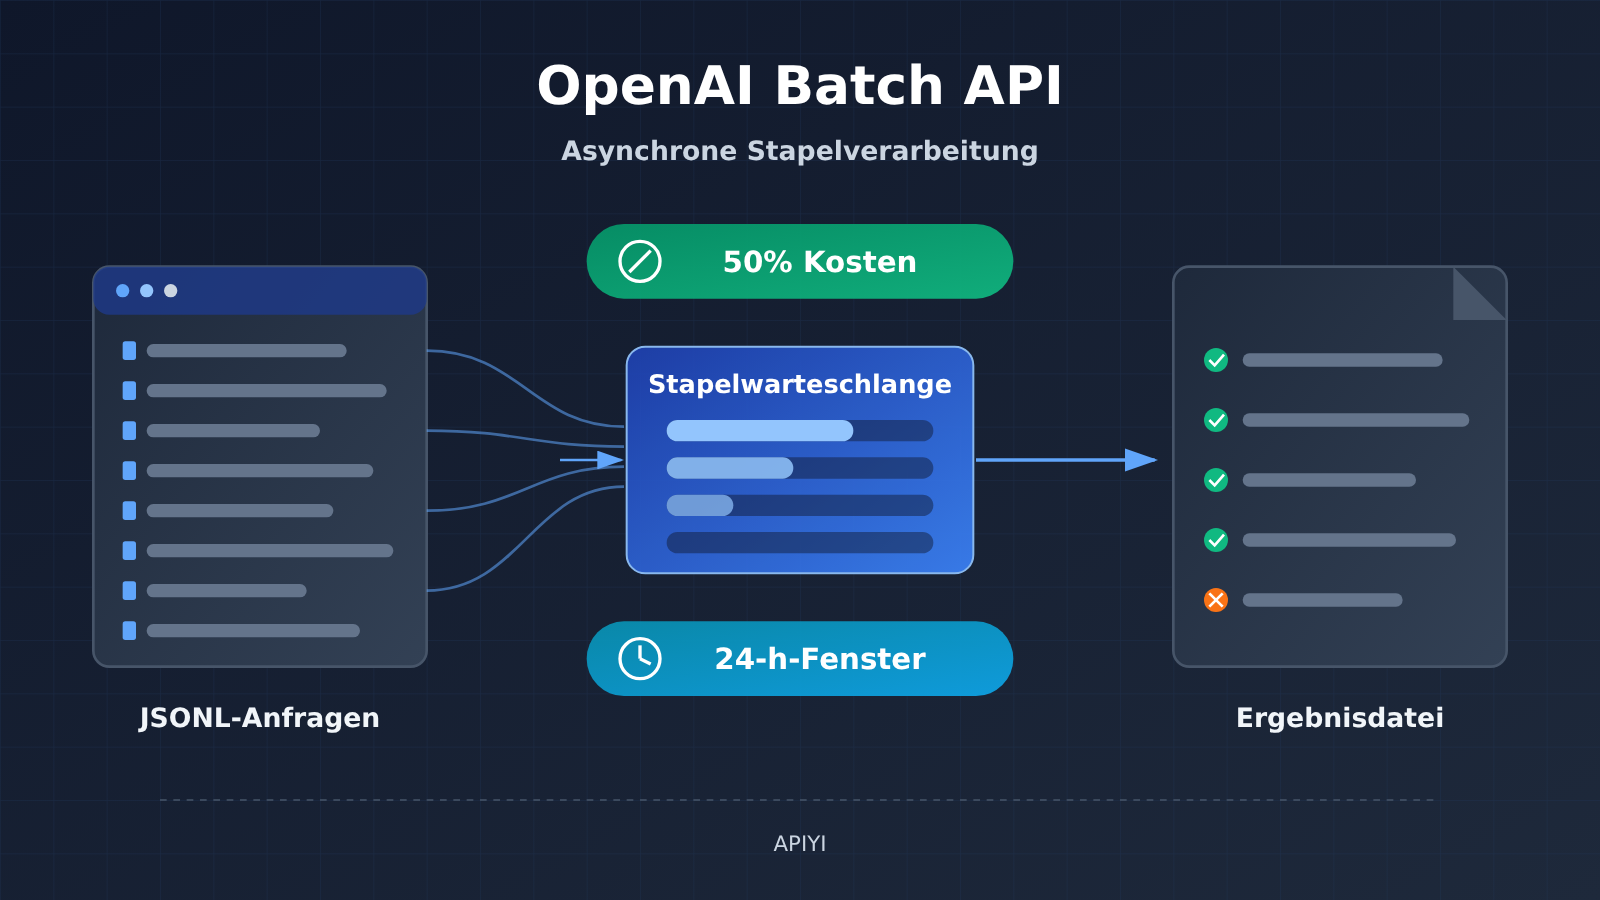
- Die Kernregeln der OpenAI Batch API: Rabatt, Rate-Limits, Fenster, Dateiformat und Mengenobergrenzen.
- Den Unterschied zwischen erfolgreicher Einreichung, erfolgreicher Erzeugung und pünktlicher Lieferung.
- Wie abgelaufene Batches abgerechnet werden und wie man nur die fehlgeschlagenen Anfragen erneut ausführt.
- Welcher Kostenanteil durch die 50 Prozent tatsächlich eingespart wird und welche Kosten nicht mit halbiert werden.
- Eine praktische Methode, um zu beurteilen, ob eine Aufgabe für Batch geeignet ist.
Übersicht: Bevor der Hauptteil beginnt, verschaffen Ihnen eine Konzepttabelle und ein Überblick über die Auswirkungen eine grundlegende Orientierung. Der Abschnitt „Objektive Fakten“ fasst die Regeln aus der offiziellen Dokumentation Punkt für Punkt zusammen; der Abschnitt „Analyse und Einschätzung“ diskutiert, was diese Regeln für Aufgabenauswahl, Kostenkalkulation und Engineering bedeuten, und nennt geeignete sowie ungeeignete Aufgabentypen.
Zur Klarstellung: Dieser Artikel stützt sich auf den von OpenAI offiziell fortlaufend gepflegten Batch-Leitfaden, geprüft am 17.11.2026. Dieses Dokument hat kein eindeutiges Erstveröffentlichungsdatum, daher wird es hier nicht als neu veröffentlichte Funktion am selben Tag behandelt, sondern als Regelerläuterung zu einer bestehenden Fähigkeit.
Zum Verständnis: Die zentralen Konzepte der OpenAI Batch API
| Konzept | Kurze Erklärung |
|---|---|
| Synchrone API | Der übliche Aufrufweg: Anfrage abschicken, sofort auf das Ergebnis warten und es direkt zurückbekommen |
| Batch API | Eine Schnittstelle, bei der man viele Anfragen auf einmal einreicht, sie asynchron verarbeiten lässt und die Ergebnisse später gesammelt abholt |
| JSONL | Ein Textformat, bei dem jede Zeile ein eigenständiges JSON-Objekt ist – im Batch entspricht jede Zeile einer Anfrage |
| custom_id | Eine eindeutige Kennung, die du pro Anfrage festlegst, um die Ausgabeergebnisse wieder den ursprünglichen Anfragen zuordnen zu können |
| Unabhängiger Ratenlimit-Pool | Die Ratenlimits von Batch-Anfragen werden getrennt von synchronen Anfragen berechnet und schmälern sich gegenseitig nicht |
| 24-Stunden-Verarbeitungsfenster | Die Bearbeitungsfrist eines Batches; Anfragen, die bis zum Ablauf nicht fertig sind, werden storniert |
| Abgelaufener Batch | Ein Batch, der auch nach Ablauf des Verarbeitungsfensters noch nicht vollständig abgeschlossen ist |
Die Auswirkungen der OpenAI Batch API im Überblick
- Entwickler: Die API-Kosten für Offline-Batch-Aufgaben lassen sich grob zur Hälfte des synchronen Preises ansetzen, und gleichzeitig wird das synchrone Ratenlimit für den Online-Dienst nicht belegt. Dafür musst du die Zuordnung über custom_id, das erneute Einreichen bei Fehlern und die Prüfung der Ergebnisse selbst implementieren.
- Content- und Datenteams: Massenklassifizierung, Zusammenfassungen, die Bereinigung von Wissensdatenbanken und Ähnliches lohnen sich hier eher. Der Preis dafür ist der Verzicht auf „Ergebnisse auf der Stelle“ – bei der Lieferzeit muss man Puffer einplanen.
- Evaluierungsteams und Forschende: Große Testläufe über ganze Benchmark-Sets eignen sich hervorragend für Batch. Allerdings gilt es zu beachten, dass eine einzelne Datei nur ein Modell verwenden kann; für einen Vergleich mehrerer Modelle muss man die Daten auf mehrere Dateien aufteilen.
- Produkt- und Betriebsverantwortliche: „24 Stunden“ darf man nicht als „morgen früh ist die Lieferung garantiert“ verstehen. Wenn man gegenüber Kunden Zeitpläne zusagt, sollte man Batch als einen Kanal nach dem Best-Effort-Prinzip behandeln.
OpenAI Batch API: die Fakten
Abrechnung und Rate Limits der Batch API
Laut der offiziellen Batch-Anleitung (OpenAI-Dokumentation: developers.openai.com/api/docs/guides/batch) hat die Batch API drei zentrale Eigenschaften:
- Kostenrabatt: 50 % günstiger als die synchrone API.
- Eigene Rate Limits: eigener Kontingent-Pool, der nicht mit synchronen Anfragen geteilt wird.
- Verarbeitungsfenster: Batches werden innerhalb eines 24-Stunden-Fensters abgearbeitet.
Welche Modelle und Endpunkte unterstützt werden, richtet sich nach der Liste in der offiziellen Dokumentation. Pauschal zu behaupten, „alle Modelle unterstützen Batch“, ist derzeit nicht korrekt.
Dateiformat und Mengengrenzen der Batch API
| Regelpunkt | Offizielle Vorgabe | Praktische Bedeutung |
|---|---|---|
| Dateiformat | JSONL, eine Anfrage pro Zeile | Eine Zeile ist ein eigenständiger Auftrag |
| Anfrage-ID | jede Anfrage hat eine eindeutige custom_id | Die Ergebniszuordnung hängt komplett daran |
| Modellbeschränkung | pro Datei nur ein Modell | Aufgaben mit mehreren Modellen müssen auf mehrere Dateien aufgeteilt werden |
| Mengenlimit | maximal 50.000 Anfragen pro Batch | darüber hinaus muss man in mehreren Batches einreichen |
| Größenlimit | maximal 200 MB pro Batch-Datei | Aufgaben mit langem Kontext stoßen womöglich zuerst an diese Grenze |
| Ausgabereihenfolge | nicht garantiert identisch mit der Eingabereihenfolge | Ergebnisse lassen sich nicht über die Zeilennummer zuordnen |
Unten steht die beispielhafte Struktur einer Anfragezeile, die zeigt, wo die custom_id sitzt. Welche Endpunkte und Parameter tatsächlich unterstützt werden, ergibt sich aus der Support-Liste in der offiziellen Dokumentation:
{"custom_id": "article-001", "method": "POST", "url": "/v1/chat/completions", "body": {"model": "MODEL_NAME", "messages": [{"role": "user", "content": "为以下主题写一段摘要:..."}]}}
Gültigkeit und Abrechnung bei der Batch API
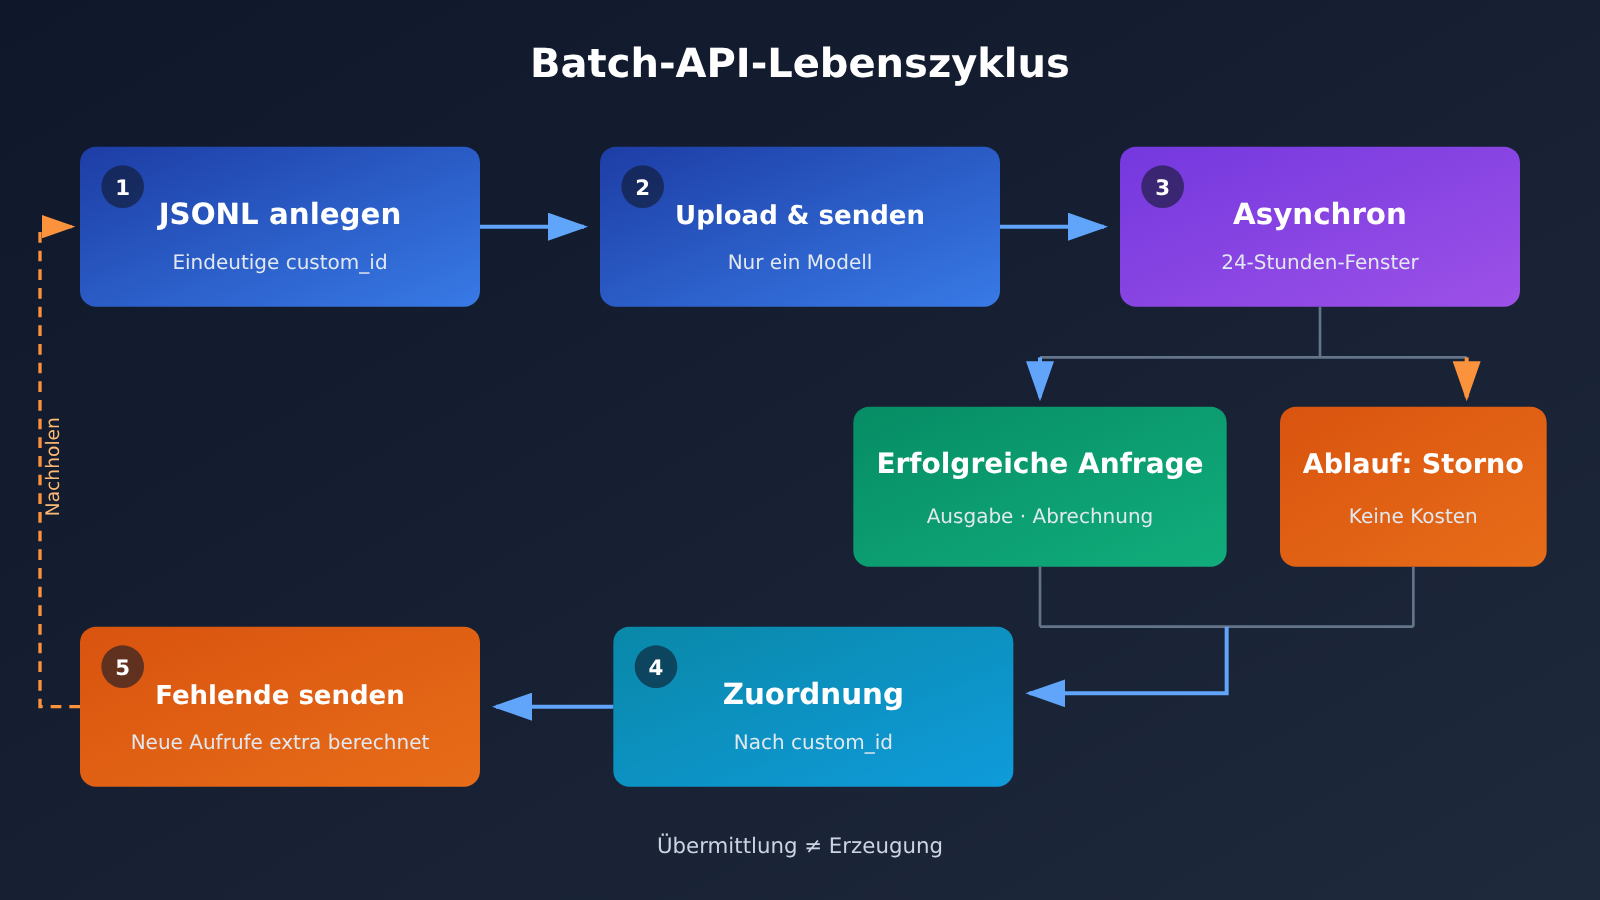
Läuft ein Batch über das Verarbeitungsfenster hinaus, werden die noch offenen Anfragen storniert. Bereits erfolgreich abgeschlossene Ergebnisse lassen sich weiterhin herunterladen, und abgerechnet wird nur für erfolgreiche Anfragen.
Die Dokumentation weist zudem auf einen Punkt hin: Eine erfolgreiche Einreichung heißt nicht, dass auch erfolgreich generiert wurde. Wird ein Batch angenommen, bedeutet das nur, dass er in die Verarbeitung gegangen ist – nicht, dass jede Zeile ein Ergebnis liefert. Auch das 24-Stunden-Fenster ist kein Versprechen im Sinne von „morgen früh um Punkt soundsoviel Uhr liegt die Lieferung vor“.
OpenAI Batch API: Analyse und Einschätzung
Welcher Teil der Kosten durch den 50%-Rabatt eingespart wird
Der „50%-Rabatt“ gilt für die Modellaufrufkosten der Batch-Verarbeitung selbst. Das folgende konstruierte Beispiel veranschaulicht das; die Zahlen sind keine Messwerte.
Angenommen, eine Aufgabe kostet bei synchronen Anfragen 100 Yuan. Dann liegen die illustrativen Kosten für dieselbe Anfrage über Batch bei 50 Yuan. Die Gesamtkosten des Projekts halbieren sich dadurch aber nicht zwangsläufig, weil einige Kostenarten nicht automatisch rabattiert werden:
| Kostenposition | Profitiert vom 50%-Batch-Rabatt? | Erläuterung |
|---|---|---|
| Modellaufrufkosten für Batch-Anfragen | Ja | Illustration: 100 Yuan synchron entsprechen 50 Yuan bei Batch |
| Tool-Aufrufe für vorgelagerte Recherche | Nein | Zum Beispiel erst recherchieren und untersuchen, bevor festgelegt wird, was geschrieben wird |
| Manuelle Prüfung | Nein | Personalkosten hängen nicht von der Abrechnungsmethode ab |
| Zusätzliche Wiederholungsversuche | Nein, separat zu berechnen | Nach Fehlern oder Ablauf entstehen durch das Nachholen neue Aufrufe |
| Engineering-Entwicklung und -Wartung | Nein | Dateigenerierung, Ergebniszuordnung und die Logik für erneutes Einreichen erfordern Aufwand |
Bei der Budgetplanung sollte man den 50%-Rabatt daher nur auf „den batchfähigen Teil der Aufrufe“ anwenden und nicht einfach das Gesamtbudget des Projekts halbieren. Wenn Recherche und Prüfung in einem Projekt einen hohen Anteil ausmachen, liegt die durch Batch erzielte Gesamtersparnis deutlich unter 50 %.
Wie Sie das 24-Stunden-Fenster verstehen sollten
Das 24-Stunden-Fenster beschreibt eine Bearbeitungsfrist, kein Lieferversprechen. Am sichersten fahren Sie damit, Batch-Ergebnisse als Ergebnisse zu behandeln, die innerhalb des Fensters mit hoher Wahrscheinlichkeit verfügbar sind, aber teilweise fehlen können – und im Zeitplan Puffer für Nachhol-Läufe vorzusehen.
Wenn der Fachbereich vorgibt: „Bis morgen 9 Uhr müssen alle Ergebnisse vorliegen“, ist es riskant, sich nur auf eine einmalige Batch-Einreichung zu verlassen. Bei Aufgaben mit harten Fristen können Sie früher einreichen, ein Zeitfenster für Nachhol-Läufe reservieren oder kritische Teile über synchrone Anfragen abwickeln.
custom_id ist das Herzstück des Batch-Designs
Da die Reihenfolge der Ausgabe nicht garantiert ist, muss die Abholung der Ergebnisse vollständig auf custom_id basieren. Das bedeutet, custom_id muss schon in der Designphase eine fachliche Bedeutung haben und global eindeutig sein, zum Beispiel „Aufgabentyp-Batch-Nummer-Sequenznummer“.
Auch das folgende Designbeispiel ist kein Praxistest: Um 20 unabhängige Artikel mit demselben Modell zu erzeugen, können Sie 20 JSONL-Zeilen schreiben. Wenn am Ende 18 Artikel erfolgreich sind und 2 wegen Ablauf des Fensters storniert wurden, müssen Sie anhand der custom_id nur die 2 fehlenden Artikel identifizieren und erneut einreichen, statt alle 20 erneut laufen zu lassen. Die 18 erfolgreichen Artikel werden als erfolgreiche Anfragen abgerechnet, die 2 stornierten nicht.
Die Kernpunkte dieses Ablaufs lassen sich so zusammenfassen:
- Vor dem Einreichen prüfen, ob jede Zeile eine eindeutige custom_id hat.
- Nach der Ergebnisabholung die Ausgabe-custom_id-Menge von der Eingabe-custom_id-Menge abziehen, um die Fehlliste zu erhalten.
- Nur für die Fehlliste eine neue JSONL erstellen und erneut einreichen.
- Nachhol-Läufe verursachen neue Aufrufkosten und müssen im Budget berücksichtigt werden.
Mehrere Modelle und abhängige Abläufe getrennt behandeln
Eine einzelne Datei kann nur ein Modell verwenden. Wenn dasselbe Projekt Modell A für die Klassifikation und Modell B für die Zusammenfassung nutzen möchte, muss man zwei separate Dateien vorbereiten, die jeweils einzeln eingereicht und einzeln abgeholt werden müssen.
Noch wichtiger ist die Frage der Abhängigkeiten. Wenn der Ablauf lautet „erst die Materialien recherchieren und dann anhand der Rechercheergebnisse entscheiden, was geschrieben wird“, hängt der zweite Schritt von der Ausgabe des ersten Schritts ab. Batch übernimmt diese Verkettung der beiden Schritte nicht automatisch für dich. Du musst nach dem Abholen der Ergebnisse der ersten Charge mit deinem eigenen Programm die Anfragen für die zweite Charge erzeugen und dann einreichen. Das bedeutet auch, dass sich die Gesamtdauer der gesamten Kette über mehrere Verarbeitungsfenster summieren kann.
Welche Aufgaben eignen sich für die OpenAI Batch API
| Aufgabentyp | Geeignet für Batch | Begründung |
|---|---|---|
| Batch-Klassifikation nach festen Regeln | Geeignet | Regeln fest, Einträge unabhängig, keine Echtzeit-Rückgabe nötig |
| Wissensdatenbank-Verarbeitung (Zusammenfassung, Bereinigung, Strukturierung) | Geeignet | Große Datenmenge, kann offline erledigt werden |
| Modellbewertung, Batch-Inferenz auf Testdatensätzen | Geeignet | Von Natur aus Batch, unempfindlich gegenüber Zeitvorgaben |
| Unabhängige Batch-Inhaltserzeugung mit demselben Modell | Geeignet | Jede Zeile unabhängig, bei Fehlern per custom_id nachholbar |
| Echtzeit-Kundenservice, Dialog-Interaktion | Nicht geeignet | Nutzer erwarten sofortige Antwort, synchrone Verfahren o. Ä. sollten verwendet werden |
| Aufgaben mit strengem Lieferzeitpunkt | Mit Vorsicht | Das 24-Stunden-Fenster garantiert keinen konkreten Zeitpunkt |
| Mehrstufige Abläufe, bei denen erst recherchiert und dann der Inhalt bestimmt wird | Eigene Orchestrierung nötig | Batch behandelt Abhängigkeiten zwischen Schritten nicht automatisch |
Eine einfache Faustregel ist, drei Fragen hintereinander zu stellen: Kann das Ergebnis etwas später kommen? Ist jede Anfrage unabhängig von den anderen? Ist die Menge groß genug, dass es sich lohnt, Datei- und Abhol-Logik zu schreiben? Wenn alle drei Antworten „Ja“ lauten, ist Batch in der Regel die günstigere Wahl. Sobald eine Antwort „Nein“ lautet, sollte man die Aufgabe aufteilen oder die synchrone Aufrufung beibehalten.
Entwicklungen, die künftig Beachtung verdienen
Da es sich um eine fortlaufend gepflegte offizielle Dokumentation handelt, können sich die unterstützten Modelle und Endpunkte sowie die Obergrenzen für Anzahl und Umfang ändern. Die folgenden Einschätzungen sind Prognosen: Je mehr Modelle und Endpunkte in Batch aufgenommen werden, desto häufiger werden Offline-Evaluierungs- und Datenverarbeitungs-Workflows standardmäßig auf Stapelverarbeitung setzen. Bei der tatsächlichen Integration sollte man sich weiterhin an die dann in der Dokumentation aufgeführten Regeln halten und nicht einfach die Werte aus diesem Artikel zum Prüfdatum übernehmen.
Der Wert der Batch API liegt darin, dass man sich klarmacht, welche Aufgaben warten können. Aufgaben, die warten dürfen, bekommen den halben Preis und ein ungestörtes Rate-Limit-Kontingent; Aufgaben, die sofort eine Antwort brauchen, gehen weiterhin als synchrone Anfrage raus.
„Keine Eile, kein Blick auf kleinen Nutzen. Wer es eilig hat, kommt nicht an; wer auf kleinen Nutzen schaut, vollbringt keine großen Dinge.“ — Analekten · Zilu


