
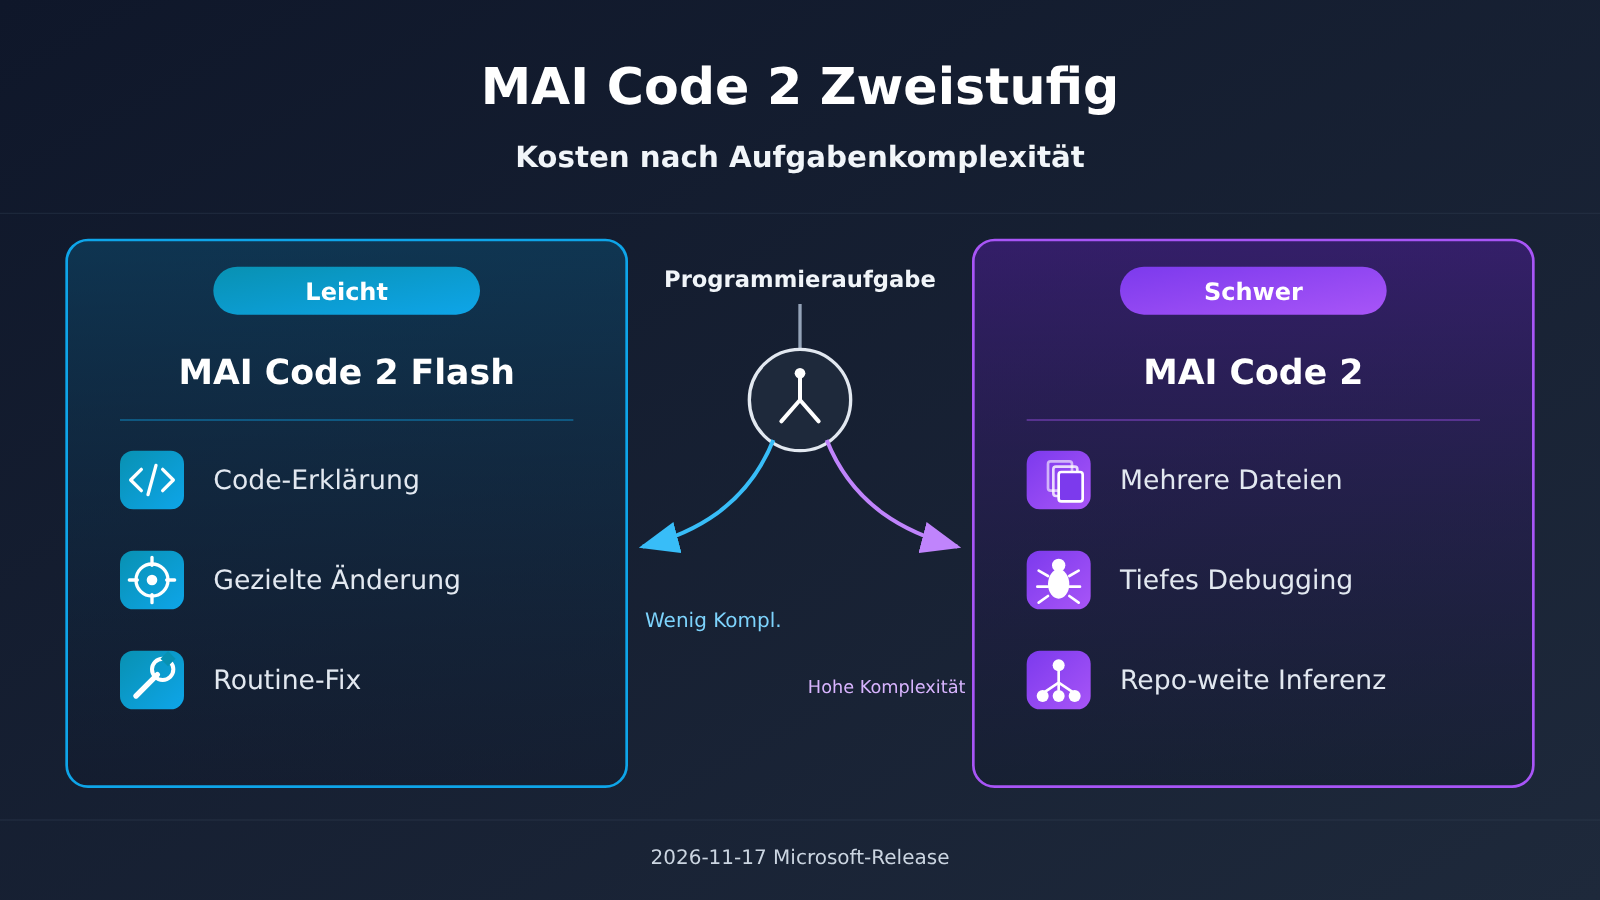
Microsoft bietet für komplexe Engineering-Aufgaben und für häufige Alltagsaufgaben jeweils eigene Modelle an. Die Einschätzung dieses Artikels: Das eröffnet Unternehmen eine neue Option, Kosten nach Aufgabenkomplexität zu verteilen. Am 17. November 2026 hat Microsoft MAI Code 2 und MAI Code 2 Flash veröffentlicht. Ersteres richtet sich an Multi-Datei-Änderungen, tiefgehendes Debugging und Reasoning auf Repository-Ebene, letzteres an Code-Erklärungen, punktuelle Änderungen, Routine-Fixes und hochfrequente Iterationen.
Die Kernaussage dieses Artikels lautet: Bei der Bewertung von Programmier-KI sollten Unternehmen nicht nur darauf schauen, welches Modell „am stärksten“ ist. Wichtiger ist die Frage, welche Aufgaben man der leichten Stufe überlassen kann, welche Aufgaben zwingend auf die schwere Stufe hochgestuft werden müssen – und wie viel Geld jeder erfolgreiche Merge tatsächlich gekostet hat. Zur Klarstellung: Der unten beschriebene Ablauf zur Aufgabenschichtung ist eine Empfehlung der Redaktion und keine automatische Routing-Garantie, die Microsoft bereits anbietet.
Was Sie nach dem Lesen dieses Artikels wissen
- Worin sich MAI Code 2 und MAI Code 2 Flash in ihrer Positionierung unterscheiden und über welche Kanäle sie derzeit verfügbar sind bzw. welche Kanäle noch den Status „demnächst verfügbar“ haben.
- Welche Spezifikationen die Model Card offenlegt und welche Angaben Herstellerangaben sind, die noch nicht unabhängig verifiziert wurden.
- Wie Unternehmen den „Zwei-Stufen“-Ansatz nutzen können, um einen eigenen Schichtungsprozess für Programmieraufgaben aufzubauen und die Wirkung an Erfolgsquote, Nacharbeitsquote und Kosten pro Merge zu messen.
- Was vor einem Pilotprojekt in puncto Datenresidenz und Berechtigungen geprüft werden muss und welche Fehlinterpretationen leicht entstehen.
Index zur Einordnung von MAI Code 2
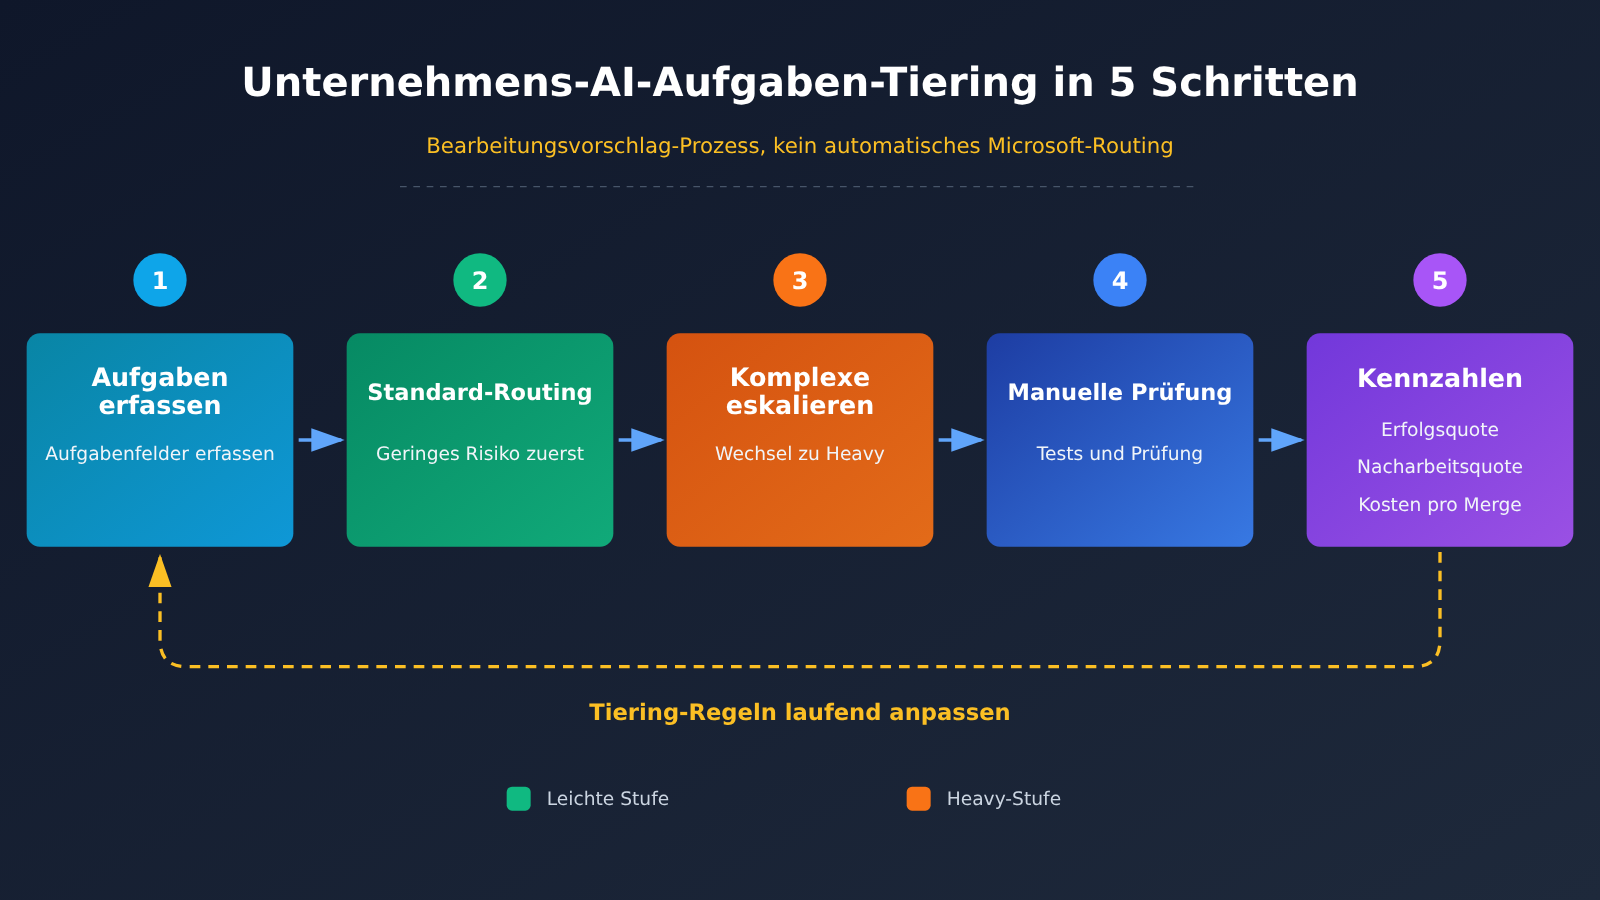
Teil eins, „Objektive Fakten“, ordnet nacheinander die Zwei-Stufen-Positionierung, die Verfügbarkeitskanäle, die Spezifikationen der Model Card, das Unternehmensbeispiel und das Verhältnis zu MAI Work Flash ein; Quellen sind Microsofts öffentliche Materialien und die GitHub-Preis-Dokumentation. Teil zwei, „Analyse und Einschätzung“, ist die Sicht der Redaktion: Zuerst wird die Geschäftslogik hinter den zwei Stufen erklärt, dann folgen fünf Schritte – Aufgabenregister anlegen, Standard-Routing, Eskalationsregeln, manuelle Abnahme und Kennzahlen-Berechnung –, und zum Schluss werden Prüfpunkte für das Pilotprojekt sowie zu vermeidende Fehlinterpretationen diskutiert.
Zum Verständnis: Die Schlüsselkonzepte der Dual-Track-Veröffentlichung von MAI Code 2
| Konzept | Kurze Erklärung |
|---|---|
| MAI Code 2 | Microsofts leistungsstarkes Programmiermodell, positioniert für dateiübergreifende Arbeit, tiefgehendes Debugging und Reasoning auf Repository-Ebene |
| MAI Code 2 Flash | Die leichte Variante derselben Serie, positioniert für Code-Erklärung, gezielte Korrekturen, Routine-Fehlerbehebungen und hochfrequente Iterationen |
| MAI Work Flash | Ein abgeleitetes Modell, das auf Basis von Code 2 Flash weiter optimiert wurde und Büro- sowie Datenszenarien wie M365 und FabricIQ bedient |
| Foundry | Microsofts Plattform für Unternehmen zur Entwicklung von Modellen und KI-Anwendungen; Flash wird hier als eingeschränkte Vorschau angeboten |
| Limited-access preview | Eingeschränkte Zugriffsvorschau – erfordert eine Bewerbung oder bestimmte Voraussetzungen und bedeutet nicht, dass das Modell allgemein verfügbar ist |
| Kontextfenster | Die Gesamtzahl der Token, die ein Modell in einem Durchgang verarbeiten kann; die Modellkarte gibt 1,05 Mio an |
| Repository-weites Reasoning | Die Struktur und Abhängigkeiten der gesamten Codebasis verstehen und erst dann ändern, statt nur eine einzelne Datei zu betrachten |
| Modell-Routing | Strategie, Anfragen nach Aufgabenmerkmalen verschiedenen Modellen zuzuweisen; umsetzbar über manuelle Regeln oder programmatisch |
| Nacharbeitsrate | Der Anteil an KI-Ergebnissen, der zurückgewiesen wird und erneut überarbeitet werden muss – ein entscheidender Indikator für tatsächliche Effizienz |
| Datenresidenz | Die geografische Region, in der Daten gespeichert und verarbeitet werden; relevant für Compliance-Anforderungen |
Auswirkungen der Dual-Tier-Veröffentlichung von MAI Code 2 im Überblick
- Technische Entscheider in Unternehmen: Bei Beschaffung und Bewertung verschiebt sich der Fokus von „das eine stärkste Modell auswählen“ hin zu „für unterschiedliche Aufgaben unterschiedliche Tiers zuordnen“. Dafür braucht es eine Aufgabenklassifizierung und eine einheitliche Grundlage für die Kostenkalkulation.
- Entwickler, die GitHub Copilot nutzen: Beide Modelle stehen in Copilot bereit. Im Alltag lässt sich je nach Aufgabengröße aktiv wechseln, wobei der konkrete Auswahlbereich von der Strategie der jeweiligen Organisation abhängt.
- Teams, die Anwendungen auf Foundry bauen: Derzeit ist nur Flash als eingeschränkte Vorschau verfügbar. Der Zugang muss zuerst geklärt werden; eine Planung auf Basis vollständiger Verfügbarkeit ist nicht ratsam.
- Entwickler, die auf Drittanbieter-Plattformen angewiesen sind: In der Pressemitteilung sind Kanäle wie OpenRouter, Vercel, Hermes, OpenCode und Kilo als „demnächst verfügbar“ gekennzeichnet. Bis zur tatsächlichen Freigabe sollten sie nicht in Produktionsplänen auftauchen.
- Compliance- und Sicherheitsteams: Ein zusätzliches Modell bedeutet eine zusätzliche Datenfluss- und Berechtigungsgrenze. Vor dem Pilotbetrieb muss die Prüfung abgeschlossen sein.
1. Objektive Fakten: Was MAI Code 2 und Flash veröffentlicht haben
Dieser Abschnitt fasst ausschließlich Informationen aus öffentlich zugänglichen Microsoft-Materialien zusammen. Inhalte zu Leistung und Fallbeispielen stammen aus Herstellerangaben oder Weiterverbreitungen und sind keine unabhängigen Tests. Unser Team hat diese beiden Modelle ebenfalls nicht selbst getestet.
1.1 Die duale Positionierung von MAI Code 2: Wofür Code 2 und Flash jeweils zuständig sind
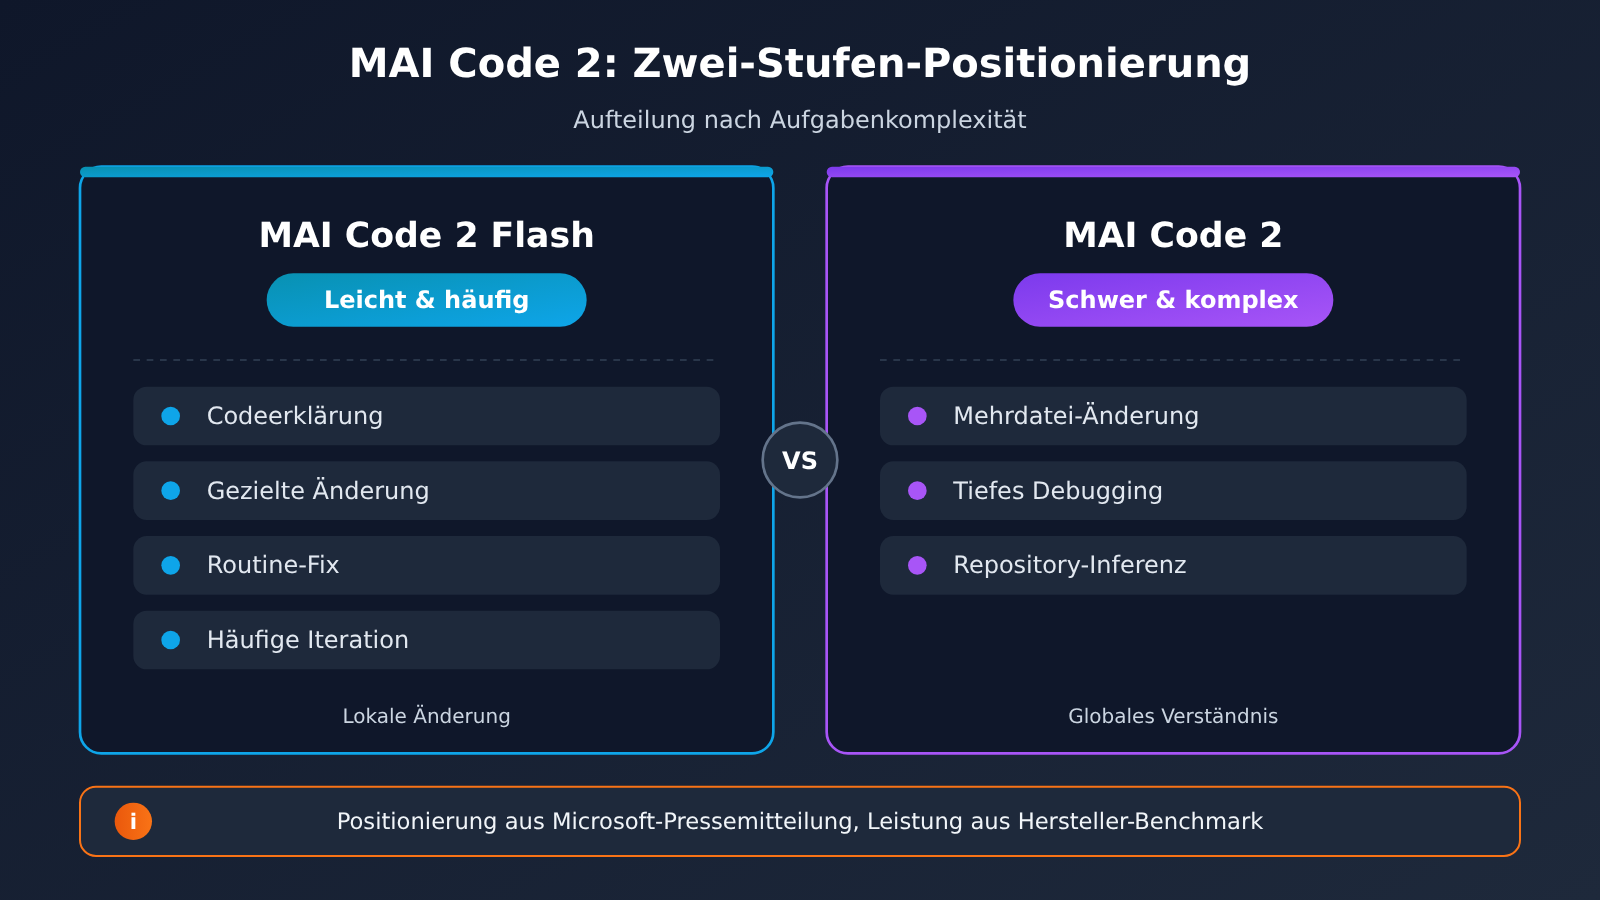
Microsoft hat in der Pressemitteilung die Arbeitsteilung der beiden Modelle recht klar beschrieben: Die schwere Variante übernimmt komplexe Engineering-Aufgaben, die ein globales Verständnis erfordern, während die leichte Variante für häufige, lokale und schnell getaktete Alltagsaufgaben zuständig ist.
| Dimension | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
| Offizielle Positionierung | Änderungen über mehrere Dateien, tiefgehendes Debugging, repositoryweite Inferenz | Code-Erklärung, gezielte Änderungen, Routine-Reparaturen, hochfrequente Iteration |
| Aufgabenmerkmale | Viele dateiübergreifende Abhängigkeiten, erfordert Verständnis der Gesamtstruktur | Klarer Umfang, Änderungen konzentrieren sich auf lokale Bereiche |
| Auswahlempfehlung (Einschätzung dieses Artikels) | Zuerst die dateiübergreifende Korrektheit bewerten | Zuerst die Qualität lokaler Aufgaben und die Reaktionsgeschwindigkeit bewerten |
| Art der Bewertung | Herstellerbewertung | Herstellerbewertung |
1.2 Vertriebskanäle und Verfügbarkeit von MAI Code 2
Die Verfügbarkeit ist der am häufigsten missverstandene Teil. Laut Microsofts Pressemitteilung und dem Azure AI Foundry Blog sieht der Status in den einzelnen Kanälen so aus:
| Kanal | MAI Code 2 | MAI Code 2 Flash | Statusbeschreibung |
|---|---|---|---|
| GitHub Copilot | Verfügbar | Verfügbar | Bereits ausgerollt |
| Microsoft Foundry | Nicht als verfügbar gelistet | Eingeschränkte Vorschau (Limited Access Preview) | Berechtigung muss beantragt werden |
| OpenRouter, Vercel, Hermes, OpenCode, Kilo | Bald verfügbar | Bald verfügbar | In der Pressemitteilung als „soon“ gekennzeichnet – das heißt nicht, dass der Zugang bereits für alle offen ist |
1.3 Spezifikationen der Modellkarten von MAI Code 2
Microsoft hat gleichzeitig die Modellkarten für beide Modelle veröffentlicht. Die derzeit bestätigten öffentlichen Spezifikationen sind:
- Die Eingabemodalität ist Text und Bild, die Ausgabemodalität ist Text.
- Das Kontextfenster des Modells beträgt 1,05 Mio. Token, wobei das Eingabelimit bei 922k und das Ausgabelimit bei 128k liegt.
- Dies sind Angaben aus der Modellkarte und keine Zusage für das Kontingent, das an jedem Produktzugang tatsächlich verfügbar ist. Beim Einsatz müssen die jeweiligen Produktbeschränkungen separat geprüft werden. So kann etwa der in einem bestimmten IDE-Plugin nutzbare Kontext kleiner sein als der Wert in der Modellkarte.
Zur Gesamtzahl der Parameter gibt es in den öffentlichen Materialien voneinander abweichende Versionen. Diese werden in diesem Artikel nicht übernommen und nicht zitiert.
1.4 MAI Code 2: maßgeschneiderte Unternehmensfälle und MAI Work Flash
Microsoft erwähnt auf der Modellseite von MAI Code 2 die maßgeschneiderten Modellszenarien der beiden Unternehmen AT&T und Woven by Toyota. Diese Inhalte sind Herstellerangaben und beschreiben die spezifischen, individuell angepassten Anwendungsfälle bestimmter Unternehmen. Sie lassen sich nicht verallgemeinern zu der Aussage, dass „alle Unternehmensaufgaben dieselben Ergebnisse erzielen können“.
Eine weitere Information, die eine gesonderte Erwähnung verdient, ist MAI Work Flash. Laut Pressemitteilung handelt es sich um ein auf Basis von Code 2 Flash weiter optimiertes abgeleitetes Modell, das M365 und FabricIQ bedient. Daher lassen sich die Ergebnisse von MAI Work Flash in Büroszenarien nicht ohne Weiteres als Ergebnisse der Basisversion Code 2 Flash zitieren.
1.5 Bei der Budgetplanung sind Aktionspreise und langfristige Kosten zu unterscheiden
Die in der GitHub Copilot-Preis dokumentation aufgeführten USD-Sätze pro Million Token lauten wie folgt, in der Reihenfolge Eingabe / zwischengespeicherte Eingabe / Ausgabe:
| Modell | Aktionspreis | Regulärer Preis ab 17. Mai 2027 |
|---|---|---|
| MAI Code 2 | 0.50/0.025/2.50 | 1.00/0.05/5.00 |
| MAI Code 2 Flash | 0.05/0.005/0.25 | 0.10/0.01/0.50 |
Die offizielle Angabe enthält keine Information zur konkreten Zeitzone dieses Datums. Hierbei handelt es sich um die Abrechnungsgrundlage von Copilot, die nicht direkt als Angebot von Foundry oder Drittanbieterplattformen übernommen werden kann. Die Werbung mit relativen Kosten in der Microsoft-Pressemitteilung verwendet den 50%-Aktionspreis und eine festgelegte Evaluierungskonfiguration; langfristige Unternehmensbudgets sollten sowohl den regulären Preis als auch fehlgeschlagene Wiederholungsversuche und manuelle Nacharbeit einkalkulieren.
2. Analyse und Einschätzung: Das Aufgaben-Tiering von Unternehmen hinter den zwei Stufen von MAI Code 2
Das Folgende ist die Analyse und Empfehlung der Redaktion und keine offizielle Position von Microsoft. Der Text ist keine Beschreibung der automatischen Routing-Funktion von Microsoft-Produkten; die hier vorgeschlagenen Regeln für Unternehmens-Routing, Eskalation und Abnahme müssen separat entworfen und validiert werden.
2.1 Warum MAI Code 2 in zwei Stufen aufgeteilt ist: Der Wettbewerbsfokus verschiebt sich vom Gesamtranking zur Kostenverteilung
Unternehmensanfragen können gleichzeitig Aufgaben wie „ein ganzes Modul refaktorieren“ und „eine Funktion erklären“ enthalten. Der Anteil sollte aus dem Aufgabenregister des Teams statistisch ermittelt werden; man darf nicht voraussetzen, dass die meisten davon einfache Aufgaben sind. Wenn auch einfache Aufgaben ausnahmslos mit dem großen Modell ausgeführt werden, können unnötige Kosten entstehen; die tatsächliche Latenz muss trotzdem gemessen werden. Wenn alles an das leichte Modell geht, scheitern komplexe Aufgaben eher und führen zu wiederholter Nacharbeit.
Die Veröffentlichung in zwei Stufen bringt diesen Kompromiss offen auf den Tisch: Hersteller betonen nicht mehr nur die Obergrenze eines einzelnen Modells, sondern bieten ein Paar mit klarer Aufgabenteilung an. Für Unternehmen entsteht der eigentliche Unterschied darin, ob sie passende Aufgaben der passenden Stufe zuweisen und die Ergebnisse kontinuierlich bilanzieren können. Diese Einschätzung stützt sich auf die offizielle Positionierung in Abschnitt 1.1; wie groß die tatsächliche Kostendifferenz ist, muss jedes Team mit eigenen Daten überprüfen.
2.2 Schritt 1: Aufgabenregister für zweistufige Modelle der Art MAI Code 2 anlegen
Bevor Sie Modelle anbinden, sollten Sie nicht sofort loslegen, sondern zwei bis vier Wochen damit verbringen, die Programmieraufgaben zu erfassen, die das Team tatsächlich an die KI übergibt. Das Register muss nicht kompliziert sein; entscheidend sind Felder, mit denen sich die Komplexität beurteilen lässt:
| Registerfeld | Erfasster Inhalt | Dient zur Beurteilung |
|---|---|---|
| Aufgabentyp | Erklären, Reparieren, neue Funktion, Refactoring, Debugging | Erste Einstufung |
| Anzahl beteiligter Dateien | Einzelne Datei oder mehrere Dateien | Ob repositoryweites Verständnis nötig ist |
| Reproduzierbarer Fehler vorhanden | Fehlerprotokoll oder Testfall vorhanden | Debugging-Tiefe |
| Abnahmemethode | Unit-Tests bestanden, manuelle Prüfung, Beobachtung im Produktivbetrieb | Abnahmekosten |
| Ergebnis | Beim ersten Versuch bestanden, mehrfache Nacharbeit, aufgegeben | Ob die Stufe richtig gewählt wurde |
Mit einem solchen Register haben die späteren Stufungsregeln eine Grundlage, statt Grenzen nach Gefühl zu ziehen.
2.3 Schritt 2: Kostengünstiges Standard-Routing festlegen
Wir empfehlen, nur Aufgaben mit geringem Risiko, klarem Umfang und ausreichenden Abnahmekriterien in der leichten Stufe beginnen zu lassen. Die Dateianzahl kann als Hinweis dienen, darf das Risiko aber nicht allein bestimmen: Änderungen an Authentifizierung, Zahlungsabwicklung oder Produktionskonfiguration in einer einzigen Datei können ebenfalls eine direkte Höherstufung und eine verstärkte manuelle Prüfung erfordern.
Man kann zunächst eine manuelle Triage-Tabelle erstellen, statt sofort einen automatischen Agenten anzubinden: Code-Erklärungen und Vorschlagsaufgaben ohne Nebenwirkungen laufen zuerst in der leichten Stufe; modulübergreifende Änderungen und Debugging mit unklarer Ursache gehen an die komplexe Stufe; Aufgaben, die geheime Informationen, Produktionsberechtigungen oder Sicherheitsgrenzen betreffen, werden zuerst von der verantwortlichen Person geprüft. Dieser Artikel enthält keine durchgeführten Integrationstests und garantiert auch nicht, dass ein Drittanbieter diese beiden Modelle bereits unterstützt.
2.4 Dritter Schritt: Eskalationsregeln für komplexe Aufgaben festlegen
Das Standard-Routing beantwortet nur die Frage, „welchen Weg man zuerst nimmt“. Zusätzlich muss klar sein, wann eskaliert wird. Zwei Arten von Auslösern bieten sich an:
- Eskalation im Vorfeld: Zeigt das Ledger, dass eine Aufgabe mehrere Dateien betrifft, Verständnis auf Repository-Ebene oder tiefgehendes Debugging erfordert, geht sie direkt an die schwere Stufe.
- Eskalation im Nachhinein: Fällt das Ergebnis der leichten Stufe bei den Tests durch oder wird dieselbe Aufgabe öfter als vereinbart überarbeitet, wird automatisch oder manuell auf die schwere Stufe umgeschaltet und ein neuer Versuch gestartet.
Für jeden Versuch sollten Aufgabenkennung, Modell, Verbrauch, Abnahmeergebnis und Eskalationsgrund protokolliert werden. Ein erneuter Anlauf sollte die Fehlerinformationen der vorherigen Runde mitführen, und es sollten Obergrenzen für die Anzahl der Versuche oder das Budget festgelegt werden; wird die Grenze überschritten, geht es an einen Menschen – keine Endlosschleife. Erfolg lässt sich nicht daran ablesen, dass die Ausgabe einen Funktionsnamen enthält oder irgendwo „Tests bestanden“ steht. Stattdessen sollten verlässliche Tests laufen und die tatsächlichen Änderungen geprüft werden.
2.5 Vierter Schritt: Auf die manuelle Abnahme kann man nicht verzichten
Unabhängig davon, welche Stufe das Modell belegt: Das Ergebnis muss vor dem Merge immer von einem Menschen geprüft werden. Je nach Aufgabenstufe sollte die Abnahme unterschiedlich streng ausfallen – bei gezielten Änderungen in der leichten Stufe reichen bestandene Tests plus eine schnelle Durchsicht; bei Änderungen an mehreren Dateien in der schweren Stufe sollte ein erfahrener Ingenieur Abhängigkeiten und mögliche Nebenwirkungen prüfen. So gut die Ergebnisse der Hersteller-Benchmarks auch sein mögen, die Abnahme in Ihrer eigenen Codebasis können sie nicht ersetzen.
2.6 Fünfter Schritt: Die Wirkung der MAI Code 2-Stufung an Erfolgsquote, Rework-Rate und Kosten pro Merge messen
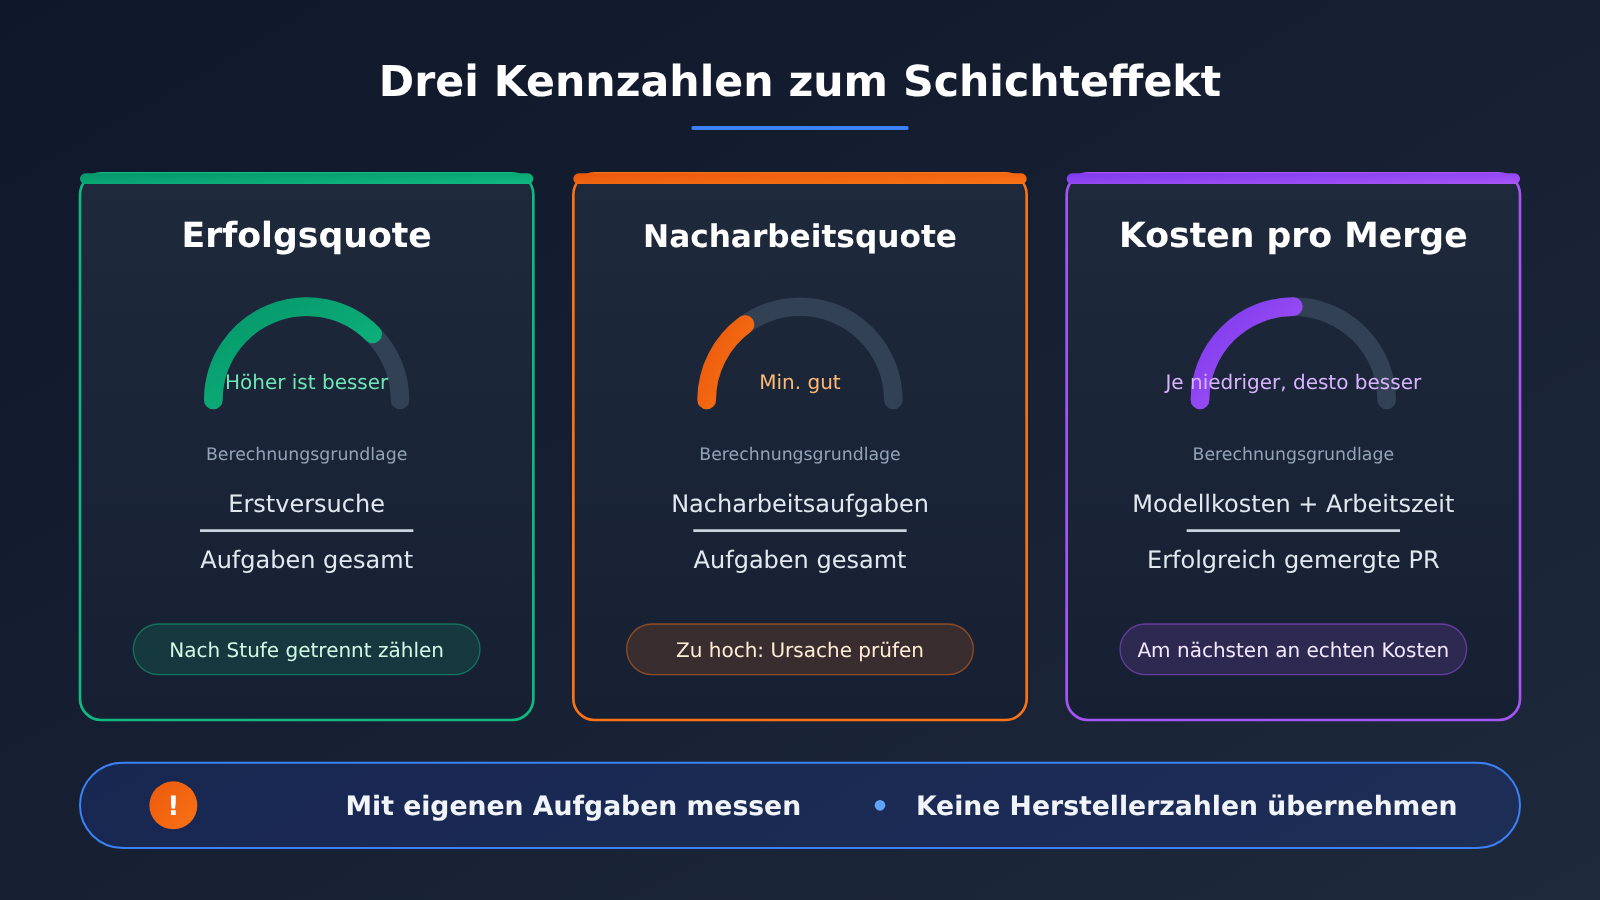
Wer nur den Token-Preis betrachtet, zieht schnell die falschen Schlüsse: Die leichte Stufe ist pro Durchlauf günstiger – muss aber dreimal nachgearbeitet werden, kann der Gesamtaufwand am Ende trotzdem höher liegen. Für die Kalkulation empfehlen sich die folgenden drei Kennzahlen:
| Kennzahl | Berechnung | Erläuterung |
|---|---|---|
| Erfolgsquote | Aufgaben, die die Abnahme im ersten Anlauf bestehen ÷ Gesamtzahl der Aufgaben | Getrennt nach Stufe und Aufgabentyp erfassen |
| Rework-Rate (Nacharbeitsquote) | Aufgaben, die zur Nacharbeit zurückgewiesen wurden ÷ Gesamtzahl der Aufgaben | Bei hoher Rework-Rate parallel die Stufenzuordnung, fehlende Unterlagen und die Definition der Abnahme prüfen |
| Kosten pro Merge | (Kosten der Modellaufrufe + in Arbeitsstunden umgerechneter Aufwand für manuelle Prüfung und Nacharbeit) ÷ Anzahl der erfolgreich gemergten PRs | Kommt den realen Geschäftskosten am nächsten |
Diese drei Kennzahlen sollten an den eigenen Aufgaben gemessen werden – man sollte nicht einfach die „Effizienzsteigerungs-Prozente“ von Herstellern oder Medien übernehmen. Je nach Codebasis, Programmiersprache und Abnahmekriterien können die Ergebnisse sehr unterschiedlich ausfallen.
2.7 Prüfung vor dem Pilotbetrieb: Datenresidenz und Berechtigungen bei MAI Code 2
Jede zusätzliche Modellstufe bedeutet einen weiteren Datenfluss. Vor dem Pilotbetrieb sollten mindestens die folgenden Punkte geprüft werden:
- Datenresidenz: Klären Sie, ob die Datenverarbeitungsregion des eingesetzten Kanals (Copilot, Foundry oder eine Drittanbieter-Plattform) den Compliance-Anforderungen Ihrer Branche und Region entspricht. Flash auf Foundry befindet sich in einer eingeschränkten Vorschauphase; die Bedingungen dieser Vorschau können sich von denen der finalen Version unterscheiden.
- Codezugriffsrechte: Inferenz auf Repository-Ebene bedeutet, dass das Modell potenziell einen größeren Codebereich lesen kann. Legen Sie fest, welche Repositories und Verzeichnisse zugänglich sein dürfen, und schließen Sie sensible Inhalte wie Schlüssel und Konfigurationsdateien aus.
- Organisationsrichtlinien: Ob und welche Modelle in Copilot gewechselt werden können, hängt von den Einstellungen der Organisationsadministratoren ab – das muss im Voraus geklärt werden.
- Audit-Logs: Stellen Sie sicher, dass bei jedem Aufruf das verwendete Modell, die aufrufende Person und der Eingabebereich nachvollziehbar sind, damit sich Vorfälle im Nachhinein aufarbeiten lassen.
2.8 Drei Dinge, die bei MAI Code 2 nicht überinterpretiert werden sollten
- Produkt-Routing ist nicht gleichbedeutend mit dem hier beschriebenen Unternehmens-Governance-Prozess. Selbst wenn das eingesetzte Produkt eine automatische Modellauswahl bietet, müssen Routing-Regeln, Abnahmeschwellen und Berechtigungen unabhängig verifiziert werden. Man darf nicht davon ausgehen, dass die in diesem Artikel beschriebene Fünf-Schritte-Methode dadurch automatisch umgesetzt ist.
- Das bedeutet nicht, dass Microsoft seine Zusammenarbeit mit OpenAI aufgibt. Die Einführung eines eigenen Programmier-Sprachmodells erlaubt keinen Rückschluss darauf, dass Microsoft OpenAI-Modelle aufgibt; auch die derzeit öffentlich verfügbaren Materialien stützen diese Schlussfolgerung nicht.
- Hersteller-Benchmarks lassen sich nicht einfach übernehmen. Die Leistungsdaten und Kundenbeispiele stammen alle von Microsoft. AT&T und Woven by Toyota sind spezifische, maßgeschneiderte Szenarien, und MAI Work Flash ist ein separat optimiertes Derivatmodell. Ihre Ergebnisse lassen sich nicht direkt auf Ihre eigenen Aufgaben übertragen.
2.9 MAI Code 2: Signale, die künftig Beachtung verdienen
Die folgenden Punkte sind prognostische Beobachtungen, die noch der Bestätigung durch spätere Fakten bedürfen. Erstens: Wann Kanäle wie OpenRouter tatsächlich öffnen und wie die Abrechnung nach der Öffnung aussieht. Zweitens: Wann die Flash-Version auf Foundry die eingeschränkte Vorschau beendet und ob auch die Heavy-Variante auf Foundry verfügbar sein wird. Drittens: Wie stark die Kontextbeschränkung auf Produktebene von den 1,05 M in der Model Card abweicht – das wirkt sich direkt darauf aus, ob Repository-weite Aufgaben in einem Durchgang in den Kontext passen.
Die Botschaft hinter der Zwei-Stufen-Veröffentlichung ist denkbar schlicht: Der Wert von Programmier-KI liegt nicht darin, jedes Mal das stärkste Modell aufzurufen, sondern für jede Aufgabenklasse den richtigen Balancepunkt zwischen Kosten und Qualität zu finden. Erst die Aufgaben sauber erfassen und dann die Trennlinie von den Daten bestimmen lassen – das ist verlässlicher, als jedem Platz auf irgendeinem Gesamtranking nachzujagen. Wie es im „Lunyu · Weiling Gong“ heißt: „Will man seine Arbeit gut verrichten, so muss man zuvor seine Geräte schärfen.“
Referenzen
- Microsoft AI: Ankündigung von MAI Code 2 und Flash
- Microsoft Foundry: Modellauswahl und individuelle Unternehmensanpassung
- Offizielle Model Card zu MAI Code 2 und Flash
- Microsoft AI: Fallbeispiele zur Unternehmensanpassung
- GitHub: Copilot-Modellpreise und Aktionszeitraum


