
Direkte Antwort: Unter idealen Bedingungen ist der standardmäßige 30-Minuten-Prompt-Cache von OpenAI ab der zweiten Nutzung günstiger als die Variante ohne Cache; der 12-Stunden-Cache lohnt sich erst ab der dritten Nutzung. Die idealen Bedingungen lauten: Derselbe feste Präfix wird einmal vollständig in den Cache geschrieben, alle nachfolgenden Anfragen treffen ihn, und dazwischen wird nichts erneut geschrieben. Nach den offiziellen Preisen für gpt-6-luna im Standard-Kurzkontext-Tarif spart ein fester Präfix von 10000 Token, der insgesamt 10 Mal verwendet wird, mit dem 30-Minuten-Cache rund 78,5 % gegenüber der Variante ohne Cache; mit dem 12-Stunden-Cache sind es rund 66 %. Das ist aber nur die Rechnung für den festen Präfix – es bedeutet nicht, dass die gesamte Anfrage rabattiert wird.
Was Sie nach dem Lesen mitnehmen:
- die tatsächlichen Bedingungen für einen Prompt-Cache-Treffer und den Unterschied zu „semantischer Ähnlichkeit“.
- wie die beiden Schreibraten für 30 Minuten und 12 Stunden abgerechnet werden und warum die normalen Eingabekosten nicht zusätzlich berechnet werden dürfen.
- eine nachvollziehbare Beispielrechnung für 1, 2, 3 und 10 Nutzungen sowie eine Break-even-Formel für beliebige Präfixlängen.
- was diese Regeln für Entwickler bedeuten, die Prompt-Strukturen entwerfen und Batch-Aufgaben planen.
Überblick: Zuerst helfen Ihnen eine Begriffstabelle und ein kurzer Überblick über die Auswirkungen dabei, Begriffe und betroffene Gruppen einzuordnen. Der Abschnitt „Objektive Fakten“ fasst die Cache-Regeln, Preise und Beispielzahlen aus der offiziellen Dokumentation zusammen. Der Abschnitt „Analyse und Einschätzung“ erklärt die Mathematik hinter der Break-even-Schwelle und diskutiert Prompt-Struktur, Batch-Planung und häufige Fehlannahmen.
OpenAI Prompt-Caching To Know: Konzepterklärung
| Konzept | Kurze Erklärung |
|---|---|
| Prompt-Caching | OpenAI cached wiederkehrende Prompt-Präfixe; treffen spätere Anfragen den Cache, wird zum günstigeren „Cache-Lese“-Preis abgerechnet |
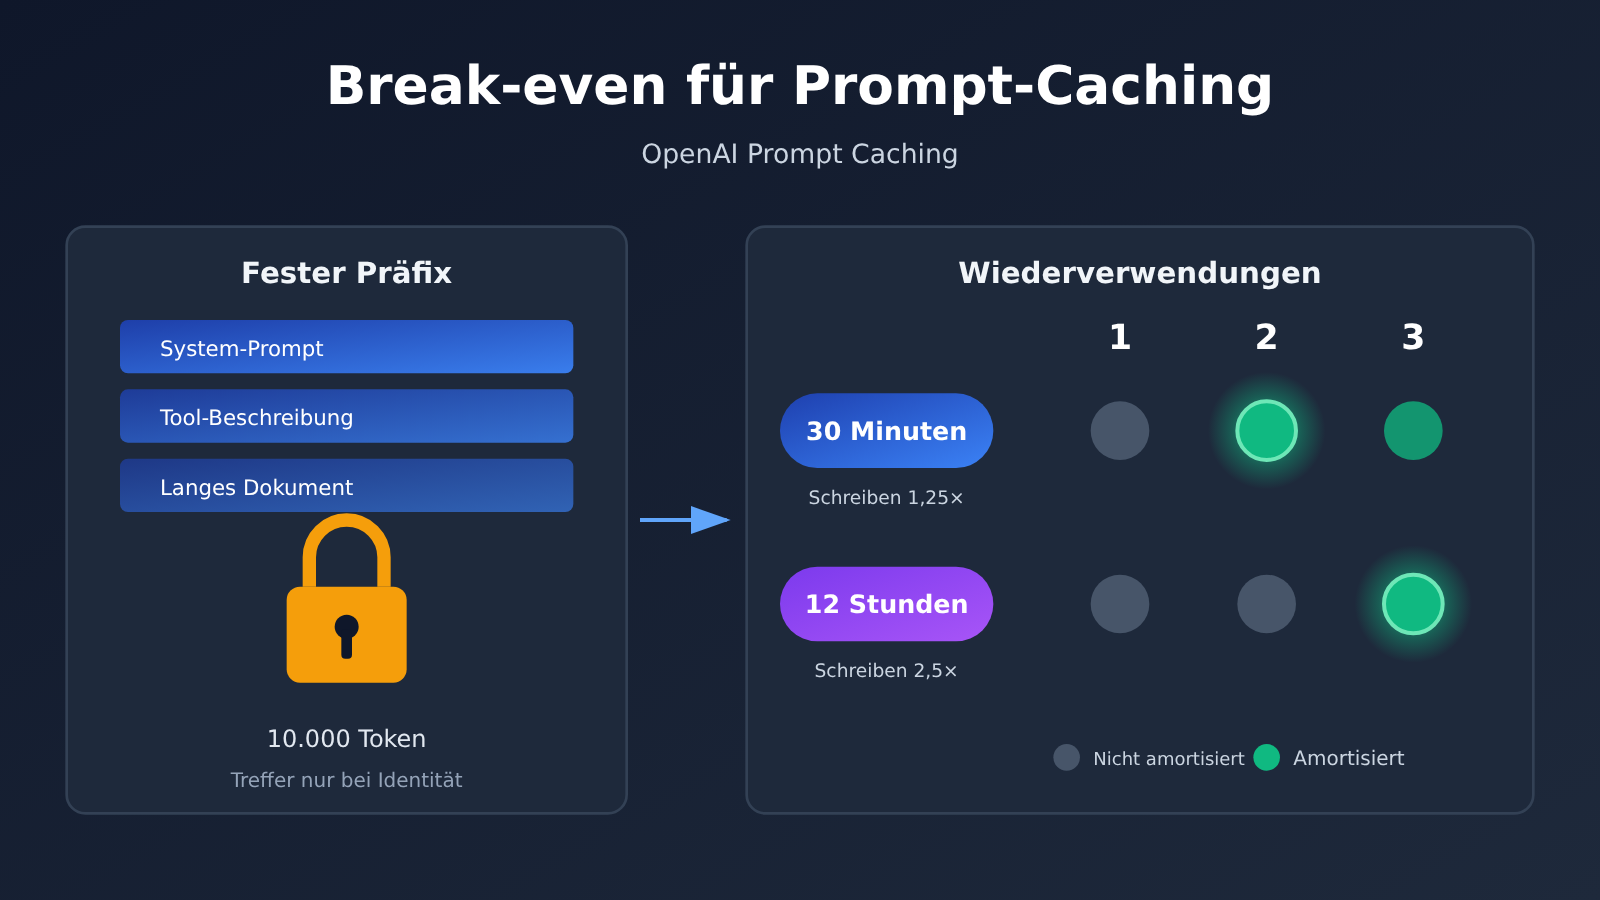
| Prompt-Präfix | Der zusammenhängende Inhalt ab dem Anfang der Eingabe einer Anfrage; der Cache gleicht genau identische Präfixe ab, nicht bloß inhaltlich ähnliche |
| Sichtbare Eingabe-Token | Eingabe-Token, die für die Cache-Schwelle zählen; Modelle ab GPT-5.6 verlangen mindestens 1024, damit der Cache genutzt werden kann |
| Cache-Schreiben | Die Abrechnung beim erstmaligen Ablegen des Präfixes im Cache, bemessen als Vielfaches des normalen Eingabepreises – ein Gesamt-Schreibsatz |
| Cache-Lesen | Die Abrechnung, wenn spätere Anfragen den Cache treffen; der Preis liegt deutlich unter dem normalen Eingabepreis |
| 30-Minuten-/12-Stunden-Cache | Zwei Gültigkeitsstufen für den Cache, standardmäßig 30 Minuten; die 12-Stunden-Stufe gibt es in der Responses API, das Schreiben ist dort teurer |
| Standard-Verarbeitungsstufe | Die Standardstufe in der offiziellen Preistabelle; verschiedene Verarbeitungsstufen haben unterschiedliche Preise und dürfen nicht vermischt werden |
| Short-Context-Stufe | Die offizielle Preistabelle unterscheidet Stufen nach Kontextlänge; dieser Artikel verwendet nur die Preise der kurzen Kontextstufe |
OpenAI Prompt-Caching: Auswirkungen auf einen Blick
- API-Entwickler: Ob Caching Geld spart, hängt von der Anzahl der Wiederverwendungen und der Trefferquote innerhalb der Gültigkeitsdauer ab – nicht davon, dass man es einfach „anschaltet“. Beim 30-Minuten-Tarif genügen insgesamt zwei Nutzungen (der erste Schreibvorgang plus ein Treffer), um günstiger zu fahren als ohne Caching. Der 12-Stunden-Tarif hat höhere Schreibkosten und braucht mehr Wiederverwendung, um sich zu amortisieren.
- Teams, die Agents oder lange System-Prompts bauen: Feste Regeln, Tool-Beschreibungen und lange Dokumente gehören nach vorne, veränderliche Inhalte nach hinten – nur so trifft der Präfix zuverlässig. Das ist eine Frage des Strukturdesigns, nicht der Parameter.
- Teams mit Batch-Verarbeitungsaufgaben: Bündelt man Anfragen mit demselben Präfix innerhalb der Cache-Gültigkeitsdauer, steigt die Trefferquote deutlich. Verteilen sich die Aufgaben über den ganzen Tag, sollte man prüfen, ob sich der 12-Stunden-Tarif lohnt.
- Wer für die Kostenkalkulation zuständig ist: Caching wirkt sich nur auf den Eingabekostenanteil des festen Präfixes aus – Output, neu hinzugefügte Inhalte, Tool-Aufrufe und Wiederholungsversuche sind nicht erfasst. In der Budgettabelle lässt sich die Cache-Ersparnis daher nicht einfach auf die Gesamtrechnung übertragen.
OpenAI Prompt-Caching: die objektiven Fakten
Informationsquelle und Aktualität
Die in diesem Artikel geprüften Informationen haben den Stand vom 17. November 2026. Sie stammen aus der offiziellen Dokumentation, die OpenAI fortlaufend pflegt: dem Leitfaden zum Prompt-Caching unter developers.openai.com/api/docs/guides/prompt-caching sowie der Preisseite unter developers.openai.com/api/docs/pricing.md. Diese Dokumente werden jederzeit aktualisiert. Wir haben nicht überprüft, wann die betreffenden Regeln erstmals veröffentlicht wurden. Der Artikel ist daher keine Nachricht des Tages, sondern eine Zusammenfassung und Berechnung der derzeit geltenden Regeln.
Trefferkriterien beim Prompt-Caching
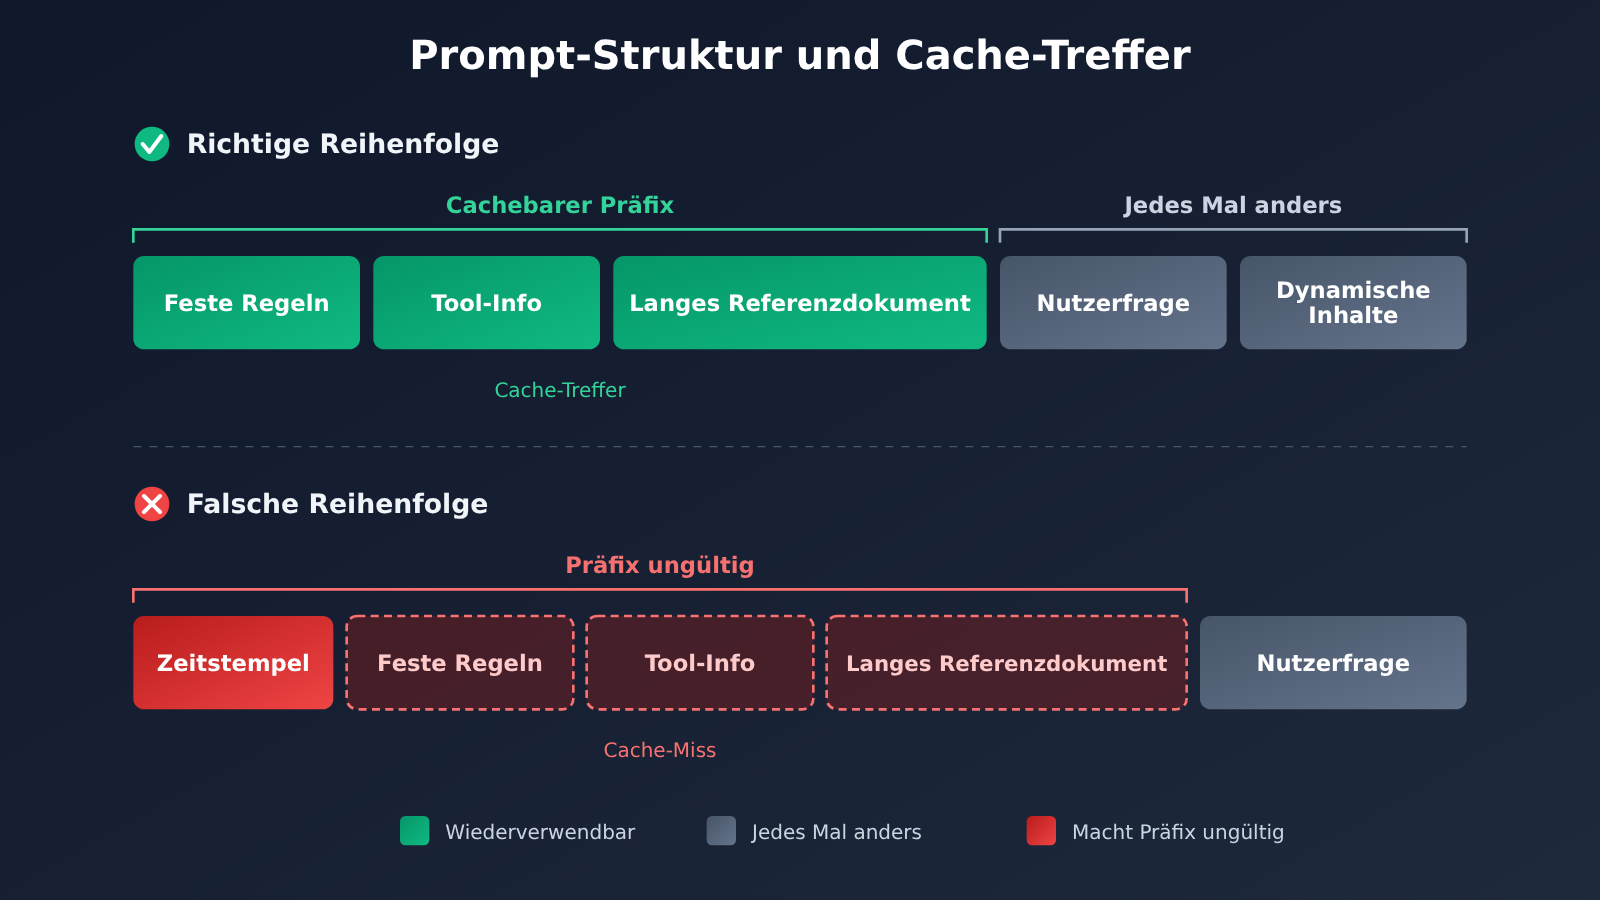
Beim Prompt-Caching von OpenAI werden identische Prompt-Präfixe abgeglichen. Zwei Prompts können inhaltlich nahezu gleich sein – solange sich der Anfang unterscheidet, gibt es keinen Treffer. Es handelt sich also nicht um eine Suche nach semantischer Ähnlichkeit. Das bedeutet: Jede einzelne Zeichenänderung im Präfix, etwa das Einfügen der aktuellen Uhrzeit am Anfang des System-Prompts, kann dazu führen, dass für die gesamte nachfolgende Eingabe kein Cache-Treffer mehr möglich ist.
Für GPT-5.6 und neuere Modelle liegt die Cache-Schwelle bei mindestens 1024 sichtbaren Eingabe-Token. Für ältere Modelle gelten andere Regeln. Die Aussagen zu Preisberechnung und Schwellenwert in diesem Artikel beziehen sich ausschließlich auf die in der offiziellen Dokumentation beschriebenen neuen Regeln und lassen sich nicht ohne Weiteres auf ältere Modelle übertragen.
Zwei Cache-Schreibtarife
| Cache-Stufe | Schreibtarif (relativ zur normalen Eingabe) | Anwendungshinweis |
|---|---|---|
| 30 Minuten (Standard) | 1,25-fach | Standard-Gültigkeitsdauer des Caches |
| 12 Stunden | 2,5-fach | Im Responses API verfügbar |
Die offizielle Dokumentation stellt klar, dass es sich bei beiden Faktoren um den Gesamtschreibtarif handelt: Die erste Schreiboperation wird zu diesem Tarif abgerechnet, ohne dass zusätzlich noch einmal die normale Eingabegebühr obendrauf kommt. Außerdem ist zu beachten: Die Angabe „12 Stunden“ bezieht sich auf die Gültigkeitsdauer des Caches und nicht auf eine Frist zur Datenlöschung – diese beiden Dinge dürfen nicht miteinander verwechselt werden.
Offizielle Preise für gpt-6-luna
Die folgenden Preise stammen aus der offiziellen Preisseite von OpenAI für gpt-6-luna in der Verarbeitungsstufe Standard und im Short-context-Bereich, angegeben pro Million Token. Diese Preise lassen sich nicht auf den Long-context-Bereich oder andere Verarbeitungsstufen übertragen und sind auch keine Preisangaben irgendeiner Drittanbieter-Plattform.
| Abrechnungsposten | Preis (USD / Million Token) |
|---|---|
| Normale Eingabe | $0.10 |
| Ausgabe | $0.50 |
| Cache-Lesen | $0.01 |
| 30-Minuten-Cache-Schreiben | $0.125 |
| 12-Stunden-Cache-Schreiben | $0.25 |
Wie man sieht, entspricht der 30-Minuten-Schreibpreis von $0.125 genau dem 1,25-Fachen der normalen Eingabe, und der 12-Stunden-Schreibpreis von $0.25 dem 2,5-Fachen – passend zu den Faktorregeln in der Dokumentation. Das Cache-Lesen kostet nur ein Zehntel der normalen Eingabe.
Berechnungsbeispiele für die Wiederverwendungshäufigkeit
Die folgenden Berechnungsbeispiele sind theoretische Berechnungen auf Basis der offiziellen Preise und keine tatsächlichen Messungen. Die Annahmen: ein fester Präfix von 10.000 abgerechneten Token, der beim ersten Einsatz vollständig in den Cache geschrieben wird und bei jedem weiteren Einsatz getroffen wird – ohne zwischenzeitliche erneute Schreibvorgänge.
| Gesamte Nutzungen | Ohne Cache | 30-Minuten-Cache | 12-Stunden-Cache |
|---|---|---|---|
| 1-mal | $0.001 | $0.00125 | $0.0025 |
| 2-mal | $0.002 | $0.00135 | $0.0026 |
| 3-mal | $0.003 | $0.00145 | $0.0027 |
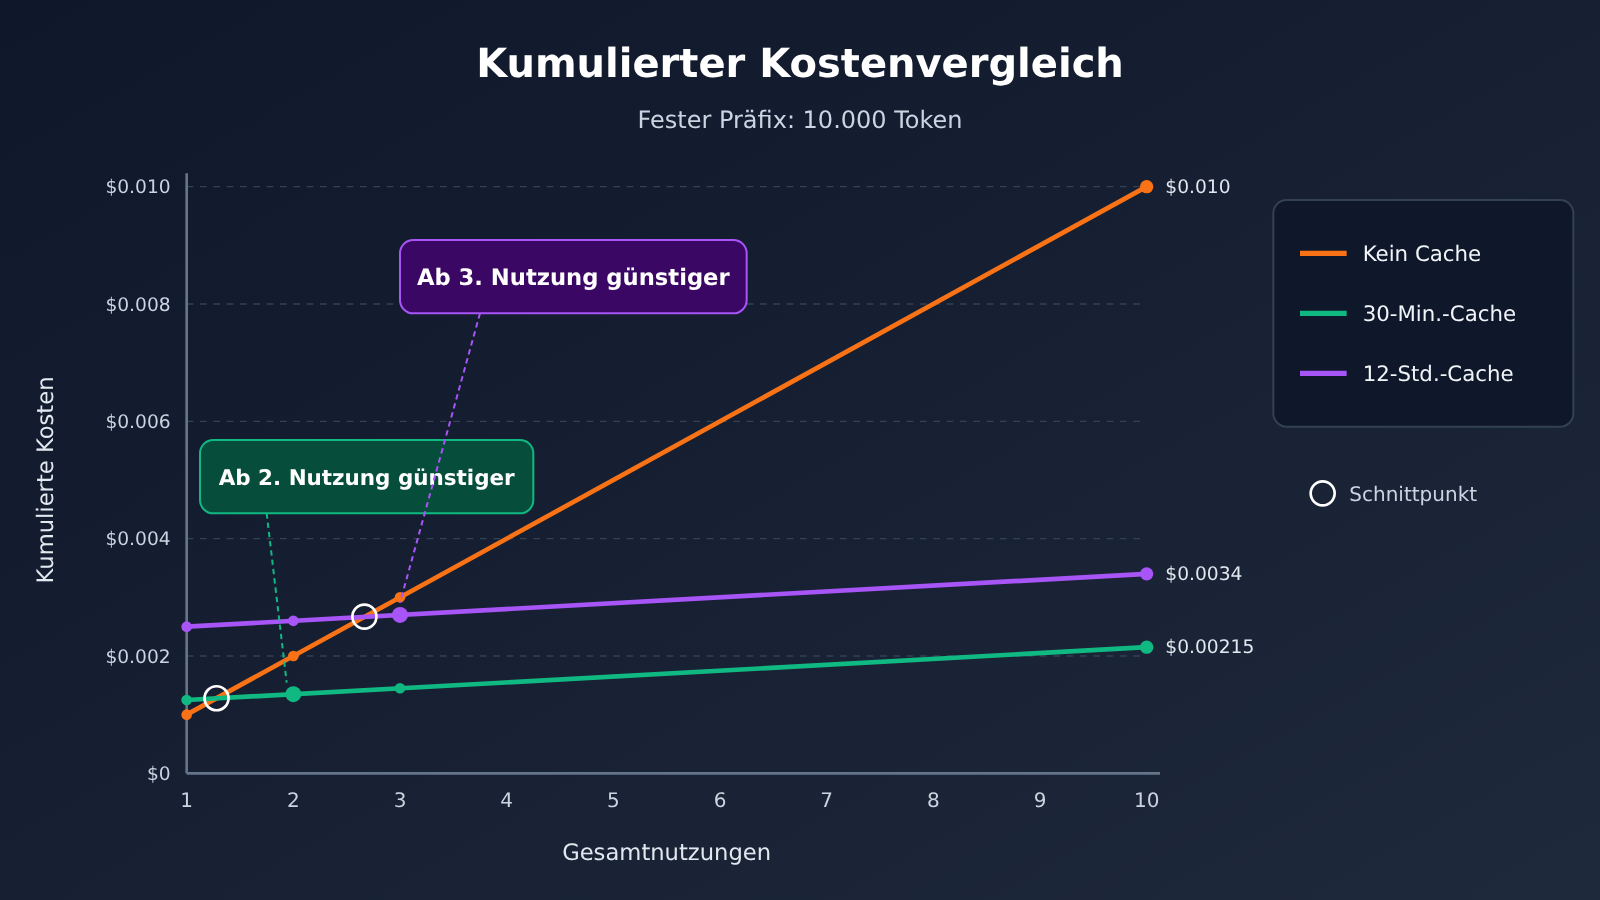
| 10-mal | $0.010 | $0.00215 | $0.0034 |
Unter diesen Annahmen ist der 30-Minuten-Cache ab der zweiten Gesamtnutzung günstiger als kein Cache, der 12-Stunden-Cache ab der dritten Nutzung. Bei nur einer Nutzung sind beide Cache-Varianten teurer als kein Cache, weil man den Schreibaufschlag zahlt, ohne den Leserabatt zu nutzen.
Geltungsbereich der Beispielrechnung
Diese Zahlen erfassen nur den festen Präfix-Teil. Neu hinzugefügtes Material, Modellausgaben, Tool-Aufrufe und fehlgeschlagene Wiederholungsversuche pro Anfrage bleiben außerhalb der Berechnung – es handelt sich also nicht um einen Rabatt auf die gesamte Anfrage. Liegt der Abstand zwischen zwei Nutzungen über der Gültigkeitsdauer des Caches, lassen sich nachfolgende Anfragen nicht mehr als „vollständig getroffen“ verbuchen; die Kosten für das erneute Schreiben müssen dann wieder hinzugerechnet werden.
OpenAI Prompt-Caching: Analyse und Einschätzung
Warum die Gewinnschwelle bei 2 und 3 Nutzungen liegt
Verallgemeinert man das Rechenbeispiel auf eine beliebige Anzahl von Nutzungen N, lassen sich drei Kostenlinien angeben (in US-Dollar pro Million Prefix-Token):
- Ohne Caching: 0,10 × N
- 30-Minuten-Cache: 0,125 + 0,01 × (N − 1)
- 12-Stunden-Cache: 0,25 + 0,01 × (N − 1)
Setzt man die Cache-Kosten kleiner als die Kosten ohne Caching, so muss N bei der 30-Minuten-Stufe größer als etwa 1,28 sein – sie lohnt sich also ab der 2. Nutzung. Bei der 12-Stunden-Stufe muss N größer als etwa 2,67 sein – sie lohnt sich ab der 3. Nutzung. Dieses Ergebnis hängt nicht von der Prefix-Länge ab, denn alle drei Kostenlinien sind proportional zur Token-Anzahl. Ändert sich das Prefix von 2000 auf 50000 Token, bleibt die Zahl der Nutzungen bis zur Gewinnschwelle gleich; es ändert sich nur der absolut eingesparte Betrag. Voraussetzung ist, dass das Prefix die Schwelle von 1024 Token erreicht und die Preissstufe dieselbe ist.
Strukturell betrachtet ist der Aufpreis für das Schreiben ein einmaliger Kostenposten. Die Einsparung pro Treffer ergibt sich aus der Differenz zwischen dem normalen Eingabepreis und dem Preis für das Lesen aus dem Cache, also 0,09 $ Ersparnis pro Million Token. Der Aufpreis der 30-Minuten-Stufe beträgt nur 0,025 $ und wird bereits durch einen einzigen Treffer gedeckt; der Aufpreis der 12-Stunden-Stufe liegt bei 0,15 $ und erfordert zwei Treffer zur Deckung. Genau deshalb unterscheiden sich die beiden Gewinnschwellen um eine Nutzung.
Ein wiederverwendbares Skript zur Break-even-Berechnung
Das folgende Skript reproduziert das Rechenbeispiel unter den Annahmen dieses Artikels. Sie können die Preise und die Nutzungshäufigkeit ersetzen, um schnell zu prüfen, wie es in Ihrem Szenario aussieht. Maßgeblich für die Preise sind die aktuellen Werte auf der offiziellen Preisseite.
# Nach offiziellen gpt-6-luna Standard / Short context Preisen (USD / Million Token)
INPUT = 0.10
CACHE_READ = 0.01
WRITE = {"30min": 0.125, "12h": 0.25}

def prefix_cost(prefix_tokens: int, uses: int, mode: str | None) -> float:
    """Berechnet nur die Kosten für den festen Präfix; Annahme: erster vollständiger Schreibvorgang, danach vollständige Cache-Treffer, keine wiederholten Schreibvorgänge"""
    m = prefix_tokens / 1_000_000
    if mode is None:
        return INPUT * uses * m
    return (WRITE[mode] + CACHE_READ * (uses - 1)) * m

for n in (1, 2, 3, 10):
    base = prefix_cost(10_000, n, None)
    c30 = prefix_cost(10_000, n, "30min")
    c12 = prefix_cost(10_000, n, "12h")
    print(f"{n:>2} Mal  ohne Cache ${base:.5f}  30 Minuten ${c30:.5f}  12 Stunden ${c12:.5f}")
Das Ergebnis stimmt mit der Berechnungstabelle oben überein. Wenn in Ihrem tatsächlichen Szenario einige Anfragen keinen Cache-Treffer erzielen, können Sie diese Fehlgriffe als „erneutes Schreiben“ behandeln; die Break-even-Schwelle verschiebt sich dann entsprechend nach hinten.
Die Struktur der Eingabeaufforderung ist wichtiger als der Schalter
Da der Cache nur exakt identische Präfixe erkennt, entscheidet die Reihenfolge der Eingabeaufforderung direkt über die Trefferrate. Ein relativ sicheres Vorgehen besteht darin, feste Systemregeln, Rollendefinitionen, Werkzeugdefinitionen und Referenzdokumente an den Anfang zu stellen und Benutzerfragen, Suchergebnisse, Zeitstempel sowie andere Materialien, die sich bei jedem Aufruf ändern, ans Ende zu setzen. Sobald ein veränderliches Feld in den Anfang des Präfixes gerät, lässt sich der noch so lange feste Inhalt dahinter nicht mehr wiederverwenden.
Ein weiterer häufiger Irrtum verdient eine gesonderte Erwähnung: Es lohnt sich nicht, die Eingabeaufforderung mit irrelevantem Inhalt aufzufüllen, nur um die Schwelle von 1024 Token zu erreichen. Die aufgefüllten Token werden beim ersten Mal zum Schreibpreis berechnet, danach jedes Mal zum Cache-Lesepreis, und sie können das Verständnis des Modells für die eigentlichen Anweisungen beeinträchtigen. Die Bedeutung der Schwelle liegt darin, zu zeigen, dass kurze Eingabeaufforderungen ohnehin keinen Cache brauchen – und nicht darin, dazu zu ermutigen, kurze Eingabeaufforderungen künstlich zu verlängern.
Die Batch-Planung entscheidet, ob „alle Anfragen einen Treffer erzielen“
Eine weitere zentrale Annahme der Beispielrechnung ist, dass alle nachfolgenden Anfragen einen Treffer erzielen. In der Praxis kann es passieren, dass bei einem gleichen Präfix, dessen Anfragen über den Tag verstreut eintreffen, die 30-Minuten-Stufe zwischen zwei Anfragen abläuft und jedes Mal neu geschrieben wird – das ist dann teurer als gar kein Caching. Dafür gibt es zwei Ansätze: Erstens, gleichartige Aufgaben zu Batches zusammenzufassen und innerhalb von 30 Minuten gebündelt zu senden; zweitens, die 12-Stunden-Stufe zu erwägen, bei der man mit einem höheren einmaligen Schreibaufwand eine längere Gültigkeit erkauft.
Die Wahl lässt sich auf eine Faustregel vereinfachen: Bei dichten Anfragen mit kurzen Abständen reicht die standardmäßige 30-Minuten-Stufe, und schon ab insgesamt 2 Nutzungen ist man günstiger dran als ohne Caching. Bei spärlichen Anfragen, aber wiederholter Nutzung desselben Präfixes am selben Tag und einer stabilen Gesamtnutzung von mindestens 3 Mal, ist die 12-Stunden-Stufe sinnvoll. Wird ein Präfix innerhalb der Gültigkeit wahrscheinlich nur einmal genutzt, ist kein Caching die günstigste Wahl.
Was bei der Kostenkalkulation leicht überschätzt wird
Die Zahl von etwa 78,5 % Ersparnis bei 10 Nutzungen ist auffällig, bezieht sich aber nur auf die Eingabekosten bei festem Präfix. In der Preisstruktur von gpt-6-luna kostet die Ausgabe das Fünffache der normalen Eingabe. Wenn eine Anwendung sehr lange Ausgaben hat oder jede Anfrage eine Menge neuer Recherchematerialien mitbringt, ist der Anteil der durch Präfix-Caching eingesparten Kosten an der Gesamtrechnung womöglich gar nicht so hoch. Für die Budgetierung ist es sinnvoller, die Anfrage in die Blöcke „festes Präfix“, „dynamische Eingabe“, „Ausgabe“ sowie „Tools und Wiederholungen“ aufzuteilen und getrennt zu schätzen und die Cache-Formel nur auf den ersten Block anzuwenden.
Außerdem gelten die hier beschriebenen Schreibfaktor-Regeln für GPT-5.6 und spätere Modelle; die konkreten Preise in der Beispielrechnung entsprechen ausschließlich der Standard-Verarbeitungsstufe und der Short-context-Stufe von gpt-6-luna. Bei älteren Modellen, langen Kontextfenstern oder anderen Verarbeitungsstufen muss man die Preise neu nachschlagen und neu rechnen – auch die Anzahl der Wiederholungen kann sich dadurch ändern. Die offizielle Dokumentation wird laufend gepflegt; sollten die Regeln später angepasst werden, sind die dann gültigen Dokumente maßgeblich. Das ist ein Punkt, den man kontinuierlich beobachten muss – keine bereits eingetretene Änderung.
Xunzi schrieb in „Ermahnung zum Lernen“: „Erde angehäuft wird zum Berg, und Wind und Regen entstehen darin; Wasser angestaut wird zum Abgrund, und Drachen entstehen darin.“ Bei der Buchführung über das Prompt-Caching ist es genauso: Ein einmaliges Schreiben ist nur ein Aufwand, die eigentliche Ersparnis kommt aus der stabilen Wiederverwendung innerhalb der Gültigkeitsperiode, wieder und wieder.


