
Anmerkung des Autors: Alle in diesem Artikel beschriebenen Fähigkeitsgrenzen wurden anhand der Modell-Dokumentation von APIYI zusammengestellt. Vor dem Schreiben wurde alles gegen die Version vom November 2026 abgeglichen – maßgeblich ist die Dokumentation.
Ein Porträtfoto, ein Audioclip – und die Person im Bild soll sprechen. Das ist die häufigste Anforderung bei der Bild-zu-Video-Generierung. Viele versuchen als Erstes, driving_audio zusammen mit ins Modell happyhorse-1.1-i2v zu schieben, stellen dann fest, dass die Audiosteuerung nicht greift, und fangen an, das Material, die Reihenfolge der Parameter oder sogar die eigene Aufrufmethode anzuzweifeln.
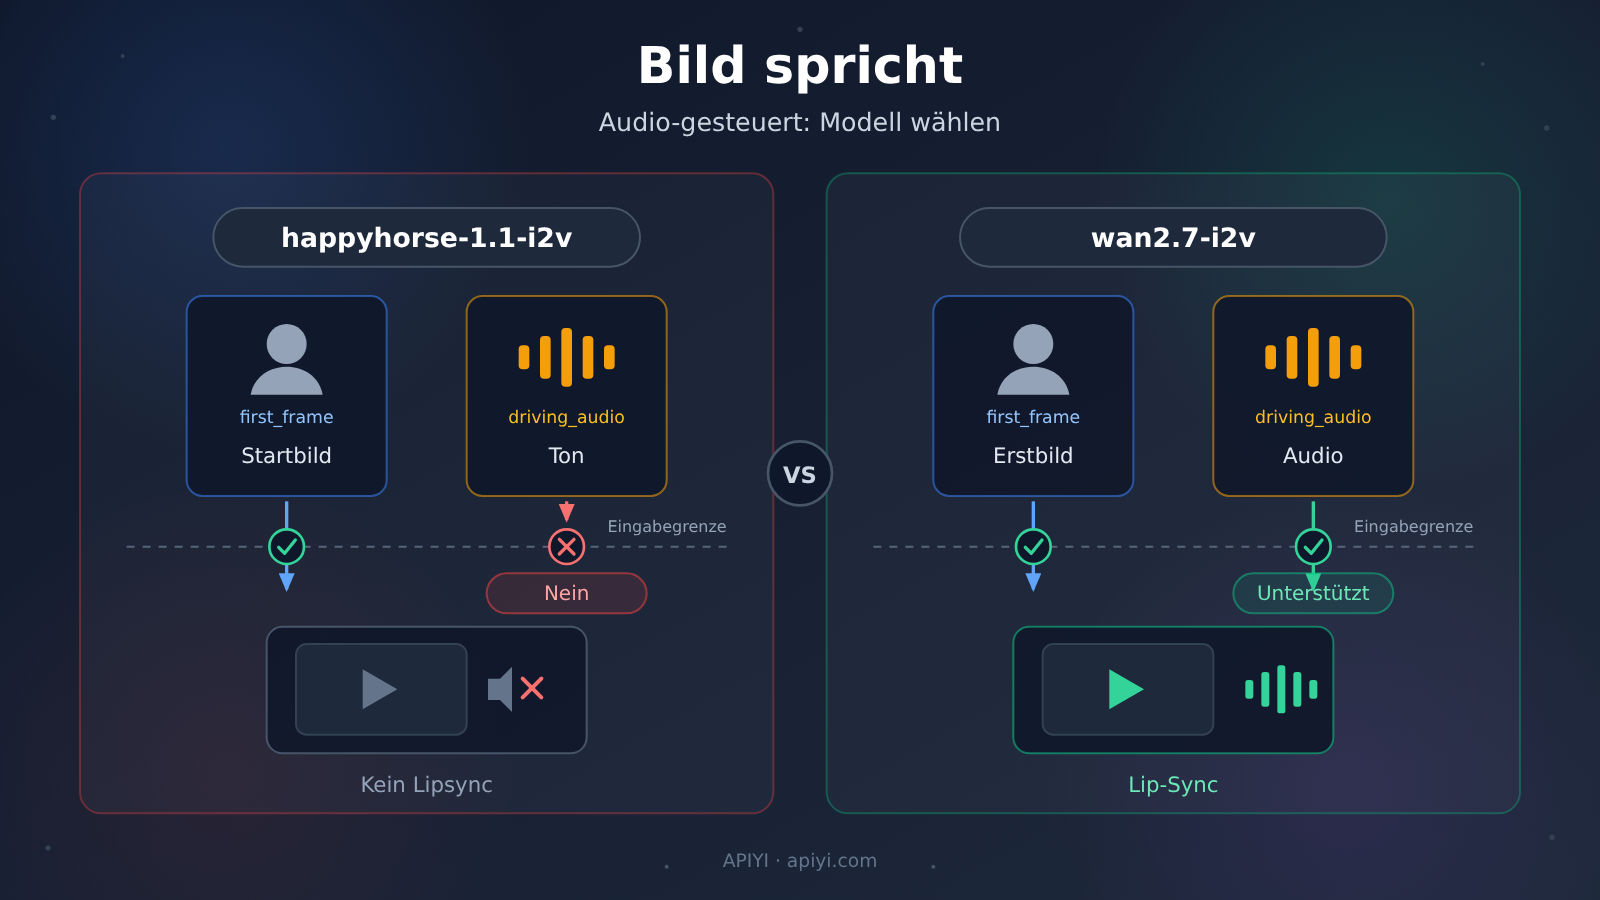
Das ist kein mysteriöser Fehler, und das Material ist auch nicht schlecht. Die Dokumentation ist an dieser Stelle sehr eindeutig: happyhorse-1.1-i2v akzeptiert nur first_frame und unterstützt driving_audio nicht; für Lippensynchronisation oder Sprechgesang verweist die Dokumentation auf wan2.7-i2v.
Der Kern der Sache: Nach dem Lesen dieses Artikels kennst du die klare Arbeitsteilung zwischen happyhorse-1.1-i2v und wan2.7-i2v, weißt, an welches Modell die Parameter gehören, wenn „das Bild sprechen soll“, und bringst es in einem Durchlauf zum Laufen.
happyhorse-1.1-i2v: Die Kernpunkte
Zuerst die Schlussfolgerung, die Details folgen weiter unten:
| Punkt | Dokumentation | Bedeutung für dich |
|---|---|---|
| Akzeptiert nur das erste Frame-Bild | happyhorse-1.1-i2v nimmt first_frame als Eingabe |
Das Bild ist der einzige Einstiegspunkt zur Steuerung |
| Keine Audio-Steuerung | Das Modell unterstützt driving_audio nicht |
Übergibst du es trotzdem, bleibt es wirkungslos – wiederholte Versuche sind unnötig |
| Lippensynchronisation gibt es woanders | Die Dokumentation empfiehlt für Lippensynchronisation den Wechsel zu wan2.7-i2v |
Ein Modellwechsel löst das Problem schneller als das Herumschrauben an Parametern |
Der erste Punkt ist derjenige, bei dem man sich am leichtesten vertut. driving_audio ist kein versteckter Parameter von happyhorse-1.1-i2v und auch keine Fähigkeit, die erst mit einer bestimmten Version freigeschaltet wird. Die Modell-Dokumentation markiert es ausdrücklich als nicht unterstützt, und auch der Bild-zu-Video-Eintrag auf der Übersichtsseite zieht dieselbe Schlussfolgerung. Anders gesagt: Das Problem liegt nicht an der Art deines Aufrufs, sondern daran, dass die Fähigkeitsgrenze des Modells nun einmal hier verläuft.
Der zweite Punkt betrifft die alternative Route. Laut Dokumentation ist die Audio-Steuerung eine exklusive Fähigkeit von wan2.7-i2v; das i2v-Modell von HappyHorse übernimmt solche Aufgaben nicht. Wenn eine Person also sprechen soll, ist die richtige Aktion nicht, weiter an den Parametern zu drehen, sondern direkt das Modell zu wechseln.
Kernunterschiede zwischen happyhorse-1.1-i2v und wan2.7-i2v
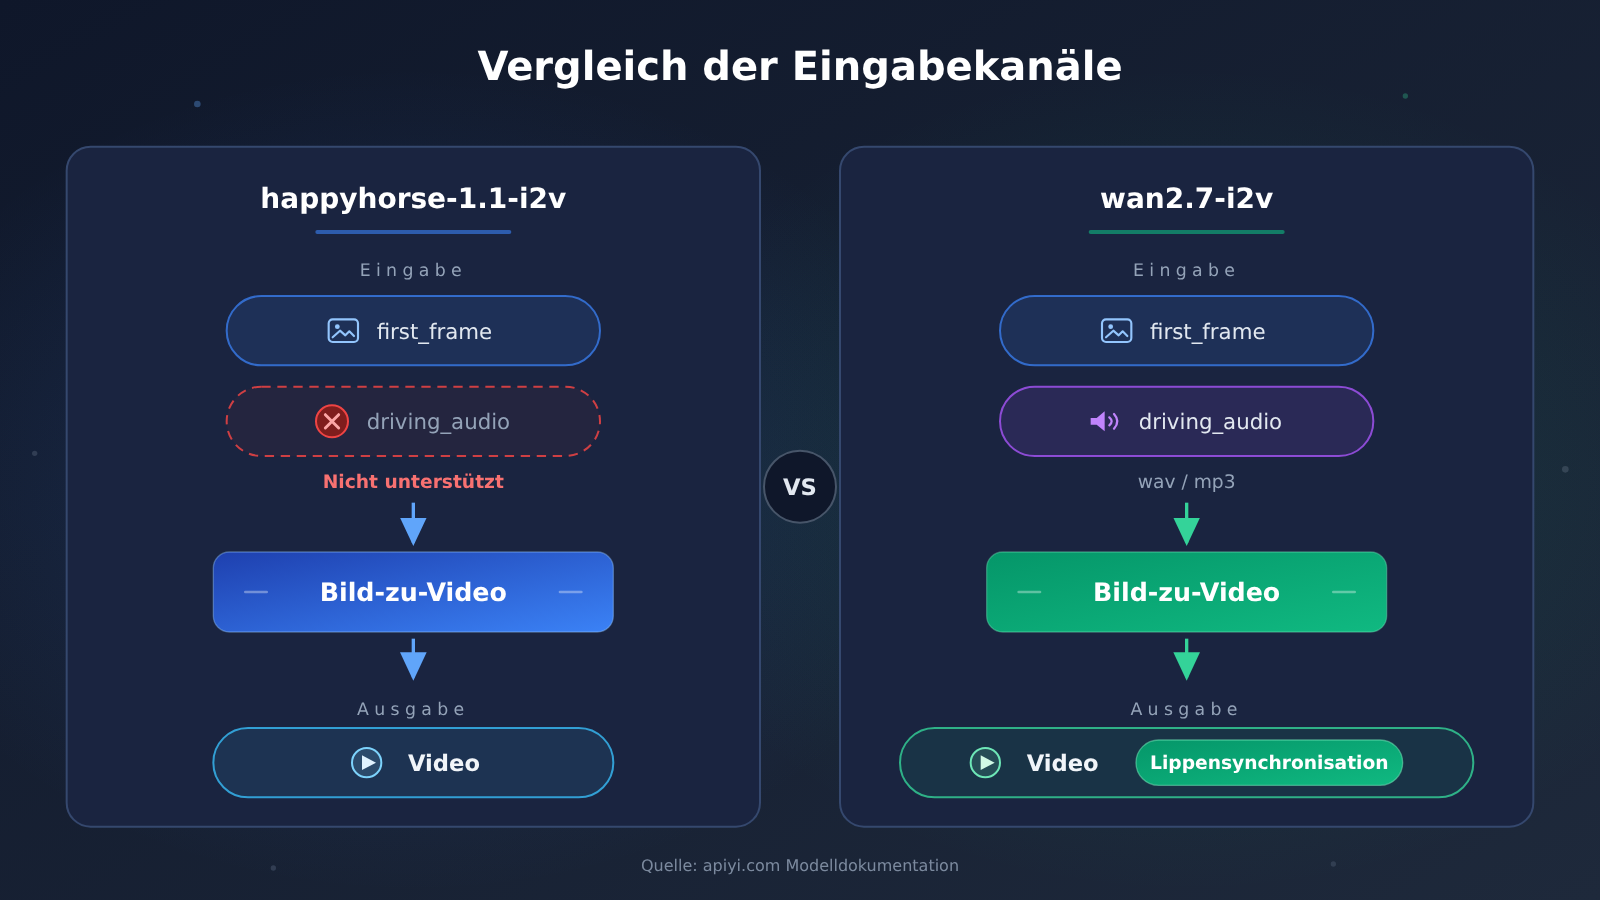
Beide Modelle erzeugen Video aus einem ersten Frame (First-Frame-Bild-zu-Video), ihre Positionierung überschneidet sich – den echten Unterschied macht die Zeile mit der Audio-Eingabe:
| Vergleichskriterium | happyhorse-1.1-i2v |
wan2.7-i2v |
Fazit zum Unterschied |
|---|---|---|---|
| Aufgabentyp | Videogenerierung aus dem ersten Frame | Videogenerierung aus dem ersten Frame | Positionierung überschneidet sich – nicht nach dem Namen urteilen |
first_frame |
wird akzeptiert | genau 1 erforderlich | Bild-Eingabe ist bei beiden unverzichtbar |
driving_audio |
nicht unterstützt | unterstützt, optional 1 | der entscheidende Punkt für Lippensynchronisation |
| Audioformat | nicht zutreffend | wav oder mp3 |
Format vor dem Übergeben der Parameter prüfen |
| Szenario Lippensynchronisation | Doku empfiehlt den Wechsel zu wan2.7-i2v |
Doku weist dieses Szenario explizit zu | für die Auswahl reicht diese Zeile |
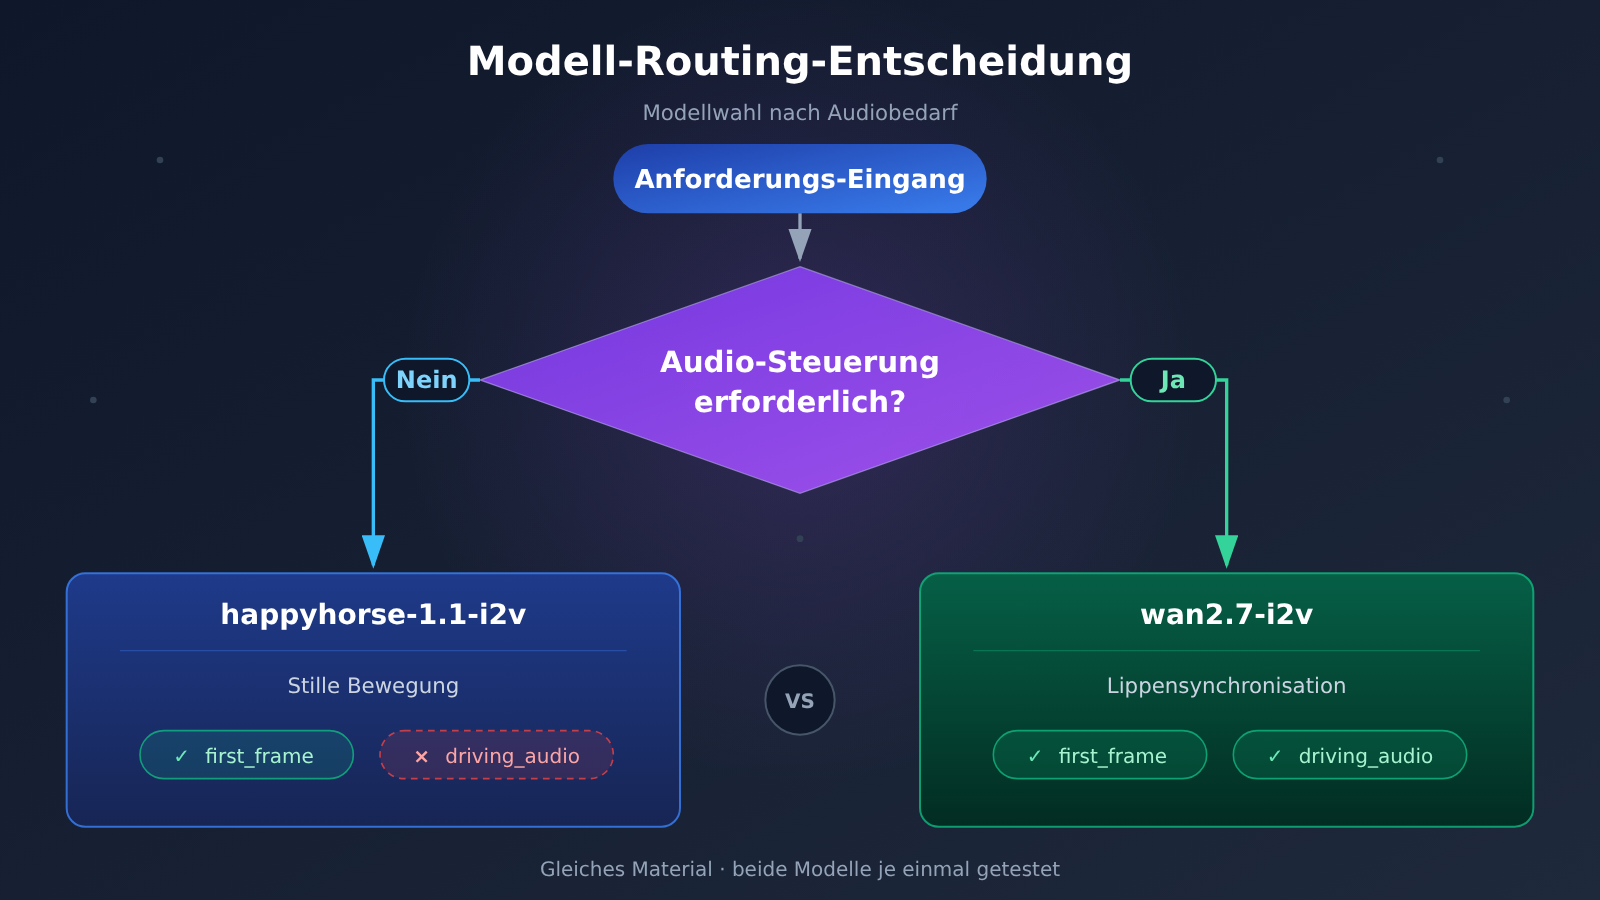
Die obige Tabelle und die Grafik basieren auf der Modelldokumentation von APIYI (apiyi.com) – keine Erfahrungsschätzungen.
happyhorse-1.1-i2v ist der richtige Weg, wenn es darum geht, „ein statisches erstes Frame in Bewegung zu bringen“: Man gibt ihm ein first_frame, und es führt die Szene weiter. Audio steht jedoch nicht auf seiner Eingabeliste; laut Dokumentation ist die Audiosteuerungsfunktion für HappyHorse i2v nicht freigegeben. Im Vergleich dazu öffnet wan2.7-i2v neben derselben First-Frame-Eingabe eine zusätzliche Tür: driving_audio – der Bewegungstakt der Personen kann dem Audio folgen.
Die Vorgaben von wan2.7-i2v sind ebenfalls konkreter: In den Medien muss genau 1 first_frame enthalten sein, driving_audio höchstens 1, und das Audioformat ist auf wav oder mp3 beschränkt. Diese Vorgaben sind strikt formuliert – der Vorteil ist, dass man sie einfach nach der Doku zusammensetzt und beim ersten Versuch durchläuft, ohne raten zu müssen.
Warum happyhorse-1.1-i2v kein driving_audio akzeptiert
Legt man die Hinweise in der Dokumentation offen, deuten mindestens vier Informationen auf dieselbe Schlussfolgerung hin:
- Auf der Modellseite steht:
happyhorse-1.1-i2vist ein Modell zur Videogenerierung aus einem ersten Frame und akzeptiert ausschließlichfirst_frame. - Auf derselben Seite ist ausdrücklich vermerkt:
driving_audiowird nicht unterstützt. - Auch der Eintrag zur Bild-zu-Video-Funktion auf der Übersichtsseite kennzeichnet, dass Audio-Steuerung nicht unterstützt wird.
- Für Anforderungen rund um Lip-Sync oder Rap gibt die Dokumentation direkt eine Migrationsempfehlung: Wechseln Sie zu
wan2.7-i2v.
Damit landen Sie wieder im klassischen Szenario: Sie haben driving_audio in die Anfrage aufgenommen, das Ergebnis entspricht nicht den Erwartungen, und Sie beginnen, Material und Parameter Punkt für Punkt zu prüfen. Unabhängig davon, in welcher Form die Schnittstelle letztlich Rückmeldung gibt, gibt es nur eine Ursache: Dieses Feld liegt für happyhorse-1.1-i2v außerhalb des Eingabebereichs. Die Dokumentation lässt keine Lücke im Sinne von „einfach anders schreiben“ offen; Wiederholungen und anderes Material ändern nichts an der Eingabegrenze.
Wenn Sie den Aufruf über APIYI (apiyi.com) gestartet haben, gleichen Sie bei der Fehlersuche zuerst die Modell-ID und die Feldnamen in der Anfrage Punkt für Punkt mit der Dokumentation ab und prüfen dann die übrigen Schritte. Die meisten Probleme der Art „Audio wird nicht wirksam“ lassen sich bereits an dieser Stelle lokalisieren, ohne Umwege.
确认改用 wan2.7-i2v 后,整个流程只剩四步,重点全在媒体组装上:
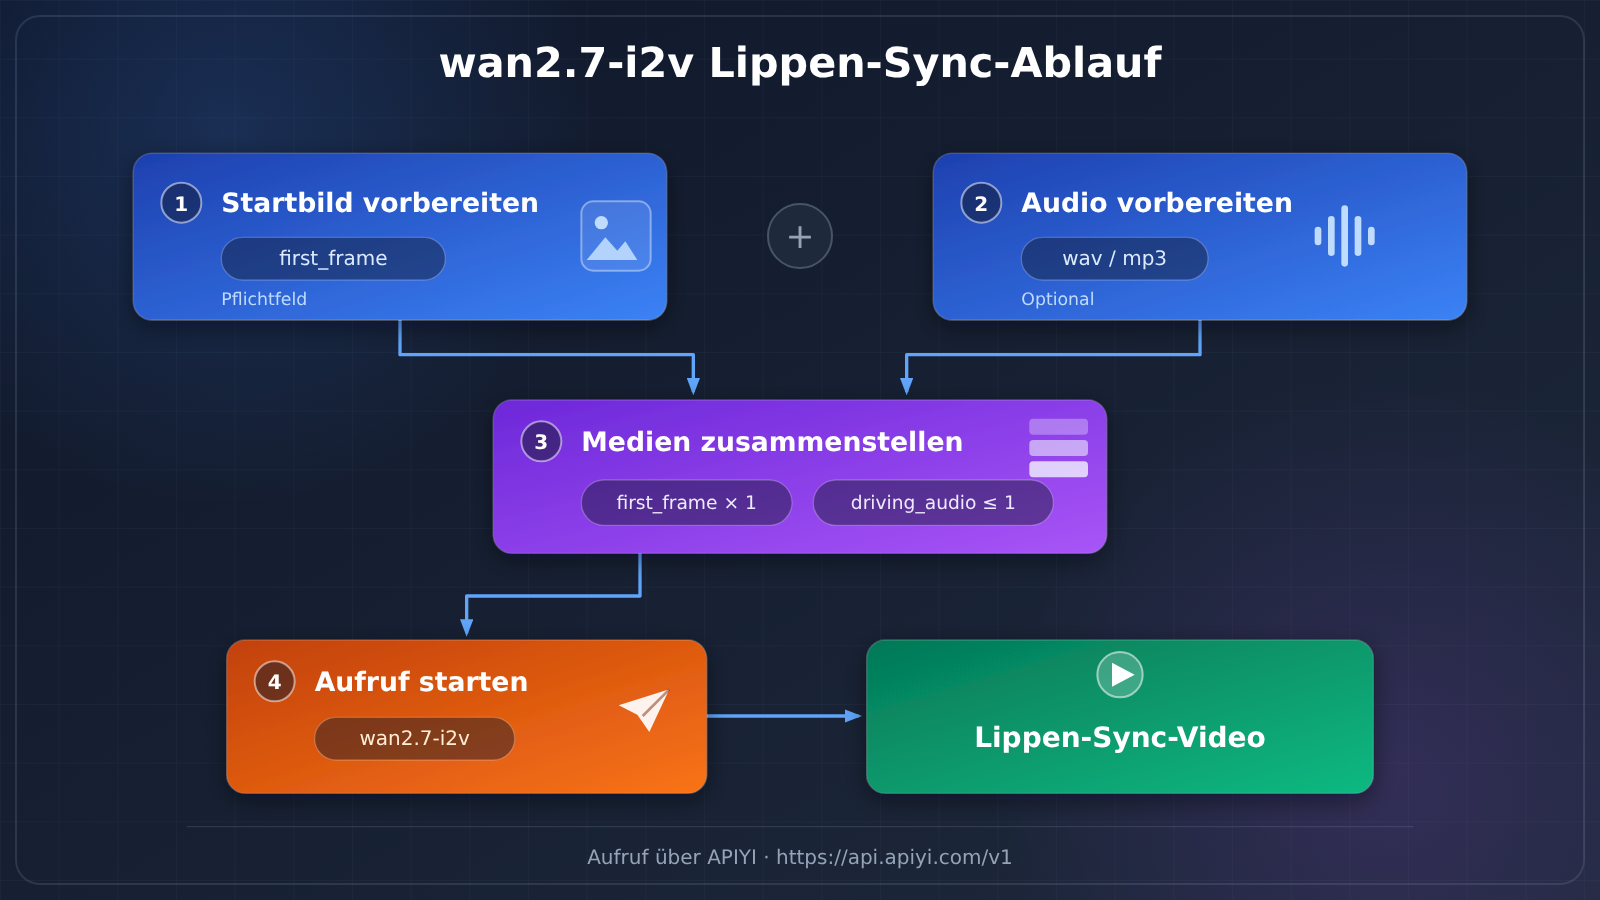
- 准备首帧图:一张人物清晰、构图稳定的图,作为
first_frame。 - 准备音频:
wav或mp3格式,作为driving_audio驱动口型与节奏。 - 组装媒体:恰好 1 个
first_frame,至多 1 个driving_audio,不要多塞。 - 发起调用:模型填
wan2.7-i2v;通过 APIYI 调用时,接口基础地址为https://api.apiyi.com/v1。
| 字段 | 是否必填 | 数量约束 | 格式要求 |
|---|---|---|---|
first_frame |
必填 | 恰好 1 个 | 首帧图 |
driving_audio |
可选 | 至多 1 个 | wav 或 mp3 |
前两步没有悬念,真正决定成败的是第 3 步。文档对数量的表述非常严格:first_frame 必须有且恰好 1 个,driving_audio 可选且至多 1 个。图或音频多传都可能让请求不符合约定,别把“多多益善”的直觉带进参数组装。
🚀 快速开始:推荐直接通过 APIYI apiyi.com 验证这套流程。平台聚合 OpenAI、Claude、Gemini 等主流模型 API,一个 Key 可调用多个模型,按量计费,新用户有免费测试额度,跑通
wan2.7-i2v的口型同步几乎零成本。
happyhorse-1.1-i2v oder wan2.7-i2v: Empfehlungen nach Szenario
| Dein Bedarf | Empfohlenes Modell | Wichtige Eingaben |
|---|---|---|
| Eine Person spricht, Lippen synchron zum Audio | wan2.7-i2v |
first_frame plus driving_audio |
| Rap, Dialoge und andere rhythmische Darbietungen | wan2.7-i2v |
first_frame plus driving_audio |
| Ein statisches Bild natürlich in Bewegung bringen, ohne Ton | happyhorse-1.1-i2v |
nur first_frame |
Wann du bei happyhorse-1.1-i2v bleibst
Für Dynamisierungsaufgaben ohne Ton bleibt happyhorse-1.1-i2v die richtige Wahl. Seine Aufgabe ist es, aus einem Startbild ein Video mit Bewegungsgefühl zu machen. Die Eingabe ist klar, es akzeptiert nur first_frame. Wenn du den Ton später in der Postproduktion hinzufügst oder gar keinen brauchst, ist es hier sogar einfacher.
- Bewegung durch das Startbild: Personen und Szenen natürlich aus dem Standbild in Bewegung bringen.
- Produktion ohne Ton: Ton später in der Postproduktion, oder für Präsentationsszenarien, die keinen Ton brauchen.
Wann du zu wan2.7-i2v wechselst
Sobald im fertigen Video eine Person „mit dem Ton mitgehen“ soll, ist wan2.7-i2v die Antwort. Dank der in der Dokumentation beschriebenen Audiosteuerung ist es unter diesen beiden Modellen die einzige Option, die driving_audio annimmt. Lippenbewegung und Rhythmus werden direkt vom Audio gesteuert.
- Lippensynchronisation: Ein Porträt plus eine Stimme erzeugen ein Video, in dem die Person spricht.
- Audiogesteuerte Darbietung: Rap, Dialoge und andere rhythmische Inhalte, bei denen die Bewegungen dem Audio folgen.
Wenn du beide Arten von Bedarf hast, kannst du dieselben Materialien auf APIYI jeweils einmal durchlaufen lassen. Ein Modellwechsel erfordert keinen neuen API-Schlüssel. Du kannst die Ergebnisse vergleichen und erst danach die Aufteilung festlegen.
happyhorse-1.1-i2v vs. wan2.7-i2v: Empfehlung zur Entscheidung
| Aktueller Zustand | Empfohlene Aktion |
|---|---|
| Lippensynchronisation ist eine harte Anforderung | Direkt wan2.7-i2v verwenden, mit driving_audio |
| Es soll sich nur das Bild bewegen | Bei happyhorse-1.1-i2v bleiben, nur first_frame übergeben |
Audio wurde an happyhorse-1.1-i2v übergeben, bleibt aber wirkungslos |
Wiederholte Versuche einstellen, zu wan2.7-i2v wechseln – das ist kein Parameterproblem |
Der Kern der Entscheidung lässt sich in einem Satz zusammenfassen: Frage zuerst, ob „in diesem Video gesprochen werden soll“. Wenn Stimme an der Performance beteiligt sein muss, lautet die Antwort wan2.7-i2v; wenn nicht, bleibt happyhorse-1.1-i2v für die Bild-zu-Bild-Videogenerierung aus dem ersten Frame zuständig. Das Audio dem richtigen Modell zu übergeben spart mehr Zeit, als bei irgendeinem Modell an den Parametern zu feilen.
💡 Auswahlempfehlung: Wenn Sie sich beim Ergebnis unsicher sind, bleiben Sie nicht bei Überlegungen auf Dokumentationsebene stehen, sondern führen Sie auf APIYI apiyi.com jeweils einen minimalen Testfall aus und entscheiden Sie anhand zweier echter Ergebnisse – das ist am zuverlässigsten.
Häufig gestellte Fragen (FAQ) zu driving_audio
F1: Was ist happyhorse-1.1-i2v?
Ein Video-Modell, das aus einem Startbild generiert – als Eingabe wird ausschließlich `first_frame` akzeptiert. Die Dokumentation weist ausdrücklich darauf hin, dass `driving_audio` nicht unterstützt wird; Audiotreiber gehört nicht zum Funktionsumfang dieses Modells.
F2: Worin unterscheiden sich happyhorse-1.1-i2v und wan2.7-i2v bei der Audiotreiber-Funktion?
Die Dokumentation kennzeichnet die Audiotreiber-Funktion als exklusive Fähigkeit von `wan2.7-i2v` und hält zugleich fest, dass die i2v-Variante von HappyHorse sie nicht unterstützt. Das heißt: `wan2.7-i2v` nimmt `driving_audio` entgegen, `happyhorse-1.1-i2v` nicht. Ob andere Modelle das unterstützen, entnehmen Sie bitte der jeweiligen Dokumentation – ziehen Sie keine Rückschlüsse aus dem Seriennamen.
F3: Was passiert, wenn man driving_audio an happyhorse-1.1-i2v übergibt?
Die Antwort der Dokumentation ist eindeutig: nicht unterstützt, es wird nur `first_frame` akzeptiert. Statt sich mit den Details möglicher Rückmeldungen zu befassen, ist es sinnvoller, dieses Material an `wan2.7-i2v` zu richten – mit demselben Bild und derselben Audiodatei wird es sofort nutzbar.
F4: Welche Anforderungen gibt es an Format und Anzahl von driving_audio?
Das Audioformat ist `wav` oder `mp3`; in den Medien muss sich genau 1 `first_frame` und höchstens 1 `driving_audio` befinden. Wenn Sie die Anfrage nach diesen Vorgaben zusammenstellen, ist die Erfolgsquote beim ersten Versuch am höchsten.
F5: Wie ruft man wan2.7-i2v schnell über die API auf?
Der Einstieg über eine Aggregator-Plattform ist empfehlenswert:
1. Registrieren Sie sich bei APIYI auf apiyi.com und holen Sie sich einen API-Schlüssel – neue Nutzer erhalten ein kostenloses Testkontingent;
2. Als Basisadresse der Schnittstelle verwenden Sie `https://api.apiyi.com/v1`;
3. Stellen Sie die Medien nach dem Muster „1 `first_frame` plus 1 `driving_audio`“ zusammen und tragen Sie als Modell `wan2.7-i2v` ein.
F6: Lässt sich Audio bei allen Modellen der Wan-Serie auf diese Weise übergeben?
So darf man nicht verallgemeinern. Die Dokumentation schreibt die Audiotreiber-Funktion ausschließlich `wan2.7-i2v` zu. Ob andere Modelle sie unterstützen, richtet sich nach der jeweiligen Dokumentation – raten Sie nicht anhand des Seriennamens auf Fähigkeiten.
F7: Wo kann man die Fähigkeitsbeschreibungen dieser beiden Modelle nachprüfen?
APIYI dokumentiert die Grenzen der Fähigkeiten in den Modelldokumentationen; unter docs.apiyi.com können Sie sie Punkt für Punkt abgleichen. Ein Blick in die Dokumentation vor der Auswahl ist deutlich günstiger, als erst nach einem Fehltritt zu recherchieren.
Kernaussagen zu happyhorse-1.1-i2v und driving_audio
- Fähigkeitsgrenzen:
happyhorse-1.1-i2vakzeptiert nurfirst_frame;driving_audiogehört nicht zu seinen Eingaben. - Exklusive Funktion: Die Audio-Steuerung ist Sache von
wan2.7-i2v– für Lip-Sync wenden Sie sich direkt dorthin. - Medienvorgaben: genau 1
first_frame, höchstens 1driving_audio, Audio nur alswavodermp3. - Migrationshinweis: Die Dokumentation empfiehlt, für Lip-Sync- oder Rap-Szenen von
happyhorse-1.1-i2vzuwan2.7-i2vzu wechseln. - So prüfen Sie: Führen Sie mit einem Materialsatz je einen minimalen Testfall für beide Modelle aus; die beiden Ergebnisse entscheiden dann über die Auswahl.
Zusammenfassung
Zum Thema „ein Bild sprechen lassen“ lohnen sich drei Erkenntnisse:
- Eingabegrenzen:
happyhorse-1.1-i2vakzeptiert keindriving_audio, sondern nurfirst_frame. Das ist die in der Dokumentation ausgewiesene Fähigkeitsgrenze. - Der richtige Anlaufpunkt: Lip-Sync und Audio-Steuerung sind exklusive Funktionen von
wan2.7-i2v. Ein Bild plus einewav– odermp3-Datei reichen aus, um zu starten. - Fehlerbehebung: Wenn Audio nicht wirkt, prüfen Sie zuerst, ob Modell und Feld zusammenpassen, statt es immer wieder zu versuchen.
Wenn Sie bei der Auswahl unsicher sind, führen Sie mit einem minimalen Testfall je einen Lauf pro Modell aus und entscheiden dann. Zur schnellen Validierung empfehlen wir APIYI apiyi.com: Die Plattform bietet ein kostenloses Testkontingent und einen einheitlichen Zugang zu mehreren Modellen. Ein Modellwechsel erfordert keinen neuen API-Schlüssel.
📚 Referenzmaterial
- APIYI-Dokumentation · HappyHorse Bild-zu-Video
- Link:
docs.apiyi.com/api-capabilities/happyhorse/image-to-video.md -
Beschreibung: Die Eingabedefinition für
happyhorse-1.1-i2vund die Originalquelle für den Hinweis „driving_audiowird nicht unterstützt“. -
APIYI-Dokumentation · Wan Bild-zu-Video
- Link:
docs.apiyi.com/api-capabilities/wan/image-to-video.md -
Beschreibung: Die Anzahl- und Formatbeschränkungen von
wan2.7-i2vfürfirst_frameunddriving_audio. -
APIYI-Dokumentation · HappyHorse Übersicht
- Link:
docs.apiyi.com/api-capabilities/happyhorse/overview.md - Beschreibung: Die Gesamtkennzeichnung der Bild-zu-Video-Einträge in Bezug auf die Audio-Steuerungsfähigkeit.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com


