
Anmerkung des Autors: Wir ordnen die 64,9 % von Claude Fable 5.2 auf RoboDojo Sim ein: Unter welchen Bedingungen wurde der Wert erzielt? Wie groß ist der Abstand zu Opus 5.5 und GPT-6 Astra? Was lässt sich daraus nicht ableiten? Und welche Kosten und Einschränkungen sollten Sie vor der Integration kennen?
Zuerst das Fazit: In einem internen Lauf von Anthropic auf RoboDojo Sim und mit der höchsten Aufwandsstufe erreichte Claude Fable 5.2 64,9 %, Opus 5.5 39,4 %, GPT-6 Astra 29,8 % und Fable 5.1 27,6 %. Diese Ergebnisse zeigen, wie die Modelle Kamerabilder auswerten und zwei simulierte Arme steuern – nicht, was sie in einer Fabrik leisten.
Das ist kein Werbetext nach dem Motto „Das Roboterzeitalter ist angebrochen“. Im Folgenden grenzen wir Simulationsergebnisse, Demo-Videos und den realen Einsatz voneinander ab. Wenn Sie gerade eine API-Integration planen und die Kosten kalkulieren, können Sie nach der Lektüre einschätzen, ob die 64,9 % Anlass genug sind, Ihre technische Strategie zu ändern.
Der zentrale Mehrwert: Sie erfahren, was die 64,9 % von Fable 5.2 belegen – und was nicht – und welches Modell Sie derzeit für erste Tests aufrufen können.
Was bedeuten die 64,9 % bei Claude Fable 5.2 wirklich?
Diese Zahl lässt sich in drei Sätzen erklären. RoboDojo ist ein öffentlicher Benchmark, der misst, ob ein Modell anhand von Kamerabildern einen zweihändigen Roboter in einer simulierten Umgebung steuern kann. In einer Fußnote zur Ankündigung steht, dass die 64,9 % aus einem internen Lauf von Anthropic mit der höchsten verfügbaren Effizienzstufe stammen. Bis zum 10.11.2026 konnten wir denselben Wert nicht auf der öffentlichen RoboDojo-Bestenliste verifizieren. Deshalb sollte man ihn weder als „Platz eins der öffentlichen Bestenliste“ bezeichnen noch behaupten, es handle sich um das „weltweit stärkste Robotikmodell“.
Hier der Vergleich zu RoboDojo Sim, den Anthropic in der Ankündigung vom 09.11.2026 veröffentlicht hat:
| Modell | RoboDojo Sim | Abstand zu Fable 5.2 | Hinweis |
|---|---|---|---|
| Claude Fable 5.2 | 64,9 % | — | Interner Lauf, höchste Effizienzstufe |
| Claude Opus 5.5 | 39,4 % | 25,5 Prozentpunkte weniger | In derselben Tabelle |
| GPT-6 Astra | 29,8 % | 35,1 Prozentpunkte weniger | Von Anthropic getestet, nicht von OpenAI selbst |
| Claude Fable 5.1 | 27,6 % | 37,3 Prozentpunkte weniger | Vorgängergeneration |
| Gemini 4 Carbon | Kein Wert in der Tabelle | Kein Vergleich möglich | Es gibt keinen Wert – das ist nicht mit 0 gleichzusetzen |
Der Sprung von 27,6 % auf 64,9 % bedeutet mehr als eine Verdopplung gegenüber der Vorgängergeneration und fällt in der gesamten Ergebnistabelle deutlich auf. Für diesen Wert gelten jedoch drei Voraussetzungen: simulierte Umgebung, interner Lauf und höchste Effizienzstufe. Ändert sich auch nur eine davon – etwa durch einen Test mit einem echten Roboter, eine unabhängige Wiederholungsmessung oder die Verwendung der Standardeinstellung –, lässt sich der Wert nicht ohne Weiteres übertragen.
In welchem Verhältnis stehen Fable 5.2 und Mythos 5.2?
Laut Ankündigung sind Claude Fable 5.2 und Claude Mythos 5.2 dasselbe Basismodell. Fable verfügt über stärkere Schutzmaßnahmen für Cybersicherheit und biologische Sicherheit und ist deshalb für alle Nutzer verfügbar. Mythos ist Organisationen vorbehalten, die ein Prüfverfahren für Biowissenschaften oder Cybersicherheit durchlaufen haben. Mythos ist also kein „anderes, leistungsfähigeres Modell“. Für die Bewertung im Bereich Robotik genügt es, sich Claude Fable 5.2 anzusehen.
Die offiziellen Modell-IDs lauten:
- Claude API, Google Cloud, Microsoft Foundry, Claude Platform auf AWS:
claude-fable-5-2 - Amazon Bedrock:
anthropic.claude-fable-5-2 - Die entsprechenden IDs für Mythos sind
claude-mythos-5-2undanthropic.claude-mythos-5-2
Die zentralen Funktionen von Fable 5.2 zur Robotersteuerung: Was die Demo zeigt
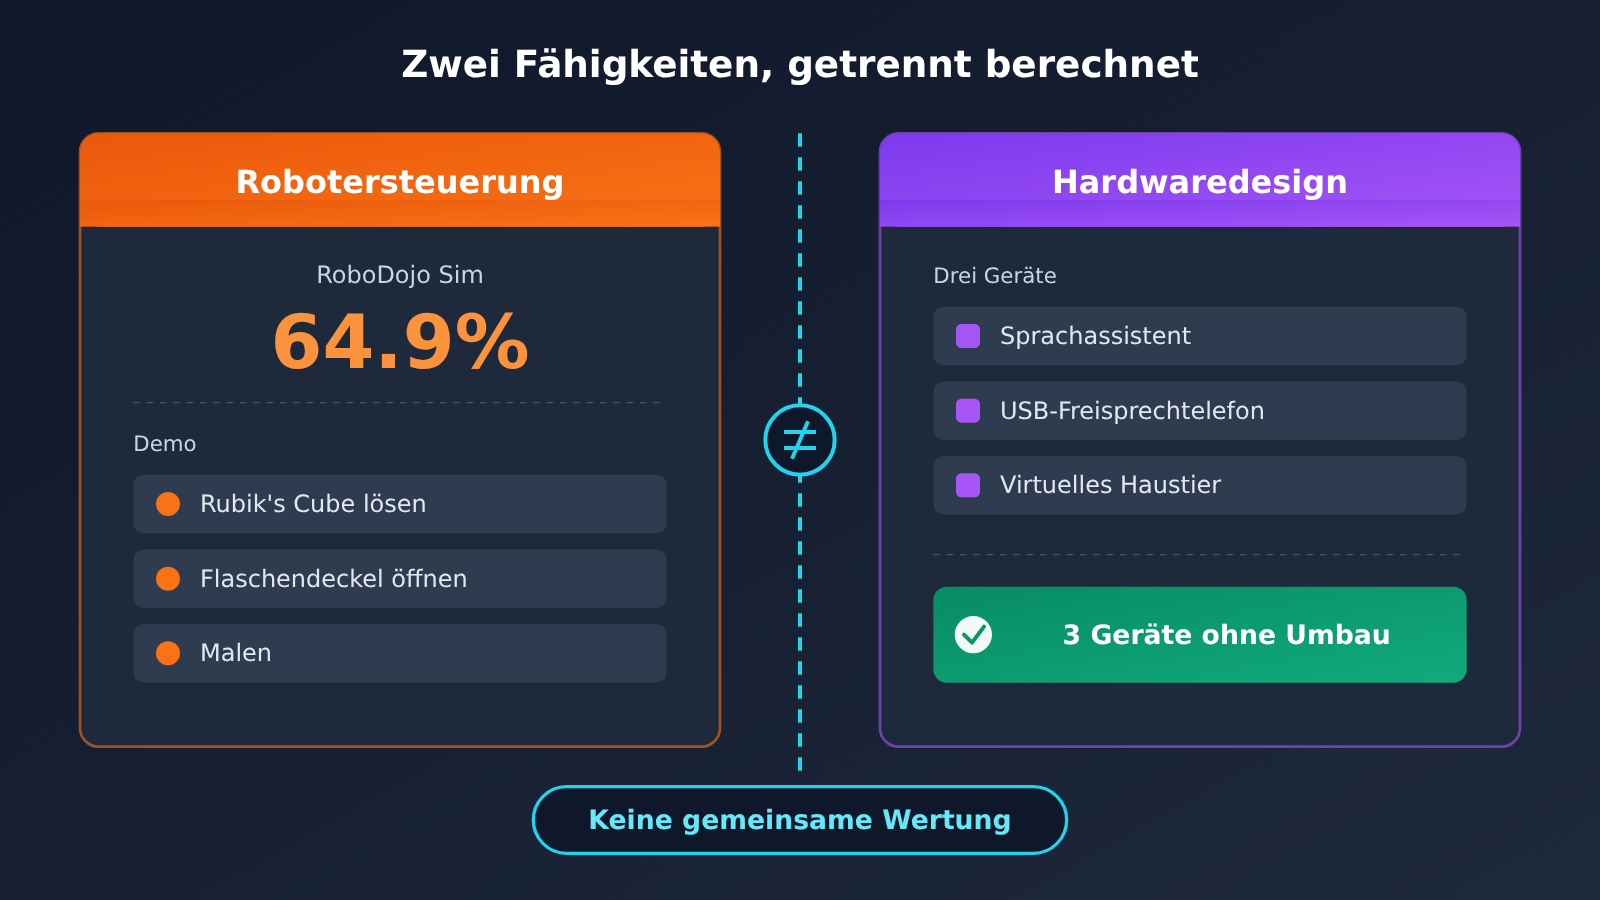
Laut Ankündigung kann Fable 5.2 physische Roboter deutlich besser steuern als frühere Claude-Modelle – auch bei Aufgaben, für die es nicht speziell trainiert wurde. Das zugehörige Demovideo zeigt drei Szenen: einen Zauberwürfel lösen, einen Flaschendeckel aufschrauben und einen Roboter zeichnen.
Diese Inhalte sollten als „Demos aus der Ankündigung“ verstanden werden. Sie zeigen, dass das Modell diese Aktionen unter bestimmten Bedingungen ausgeführt hat. Über Erfolgsquoten, Wiederholungsversuche oder Fehleranteile sagen sie jedoch nichts aus. Ebenso wenig bedeuten sie, dass Anthropic ein direkt installierbares Roboter-Skillpaket veröffentlicht hat. Die offizielle Aussage, dass einige Aufgaben ohne spezielles Training bewältigt wurden, ist bemerkenswert. Sie stammt jedoch vom Unternehmen selbst und wird nicht durch Daten aus unabhängigen Reproduktionen gestützt.
Laut Ankündigung übertrifft Fable 5.2 außerdem andere Spitzenmodelle sowie die meisten Systeme, die speziell für die Robotersteuerung entwickelt wurden, im selben Testsatz. Für die zweite Aussage wird allerdings keine Liste genannt. Daher lässt sich nicht nachvollziehen, welche Systeme und Versionen verglichen wurden. Die Aussage kann als Hinweis auf eine mögliche Entwicklung verstanden werden, aber nicht als gesicherte Schlussfolgerung.
Das Modell gibt Text aus, die Steuerung übernimmt ein externes System
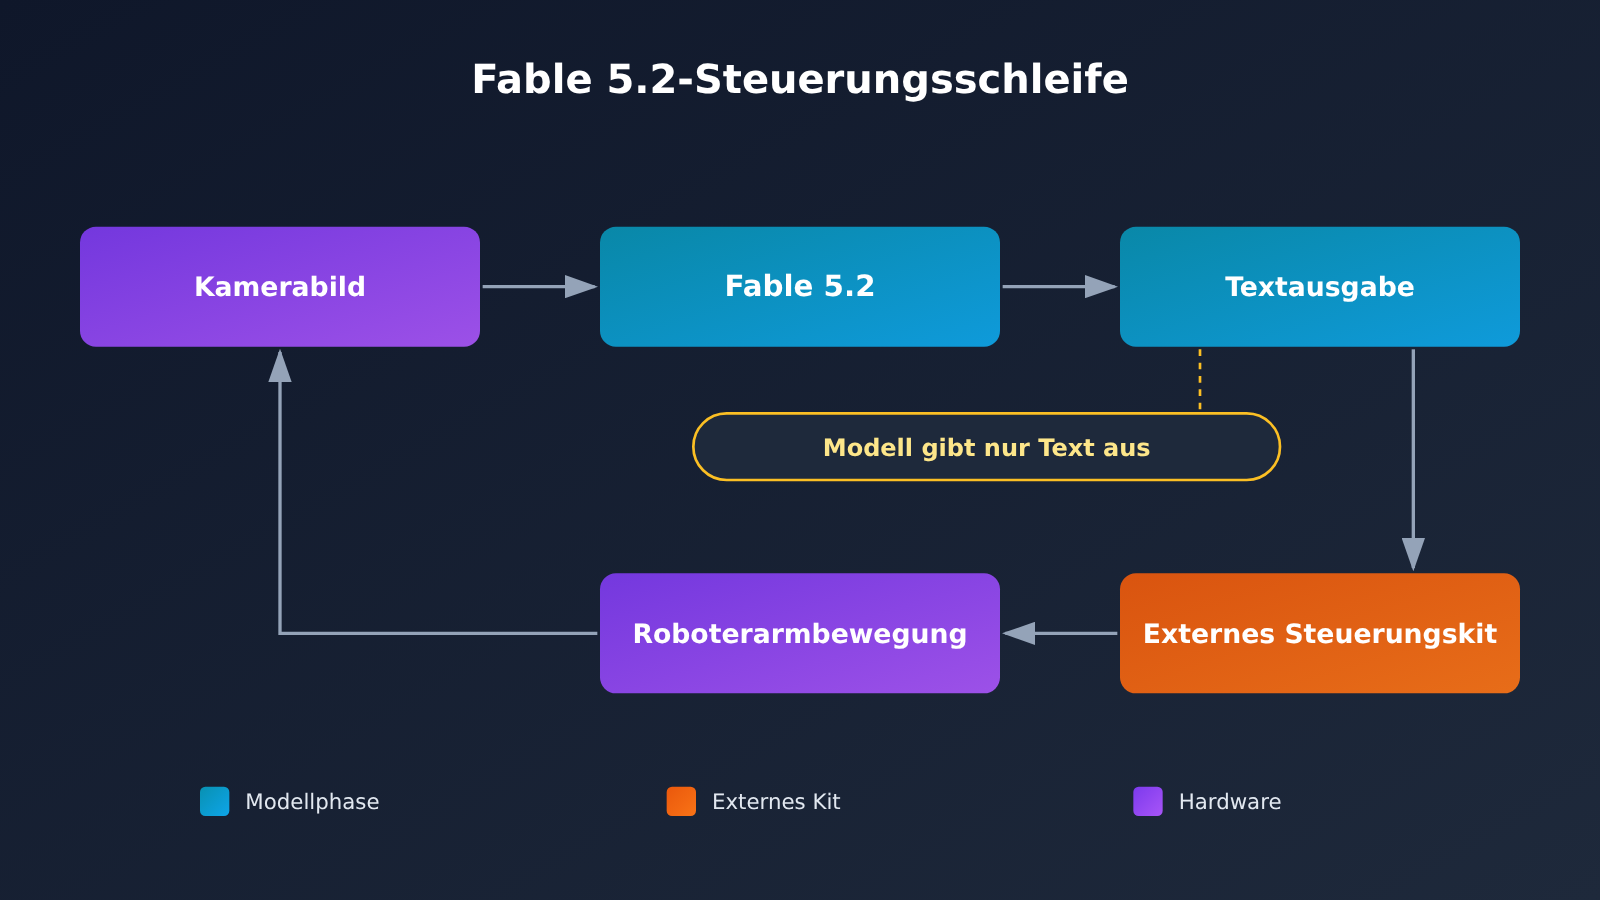
Dieser Punkt wird im Demovideo besonders leicht übersehen. Auf der Modellseite steht, dass Fable 5.2 Text und Bilder als Eingabe verarbeitet und ausschließlich Text ausgibt. Es sendet keine Motorbefehle direkt. Bei jedem Schritt muss ein externes System den Text in Aktionen umwandeln und anschließend ein neues Kamerabild an das Modell zurücksenden.
Wie gut die Steuerung in der Praxis funktioniert, hängt also zur Hälfte vom Modell und zur Hälfte von deinem System ab: Wie ist der Aktionsraum definiert? Was passiert, wenn die Interpretation fehlschlägt? Ist die Verzögerung pro Schritt akzeptabel? Die 64,9 % bei RoboDojo wurden mit dem eigenen System von Anthropic erzielt. Wie sich die Punktzahl mit einem anderen System verändern würde, ist derzeit nicht bekannt.
Fable 5.2 im Praxistest: Der Abstand bei Robotern ist nicht derselbe wie bei der Computerbedienung
Wer hört, dass „Fable 5.2 sehr leistungsfähig ist“, setzt die Roboterwerte schnell mit den Ergebnissen anderer Bereiche gleich. Die folgende Tabelle basiert vollständig auf der Ankündigung von Anthropic vom 09.11.2026 und vergleicht die Leistungsabstände bei mehreren Tests rund um die „Steuerung“:
| Test | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Vorsprung von Fable 5.2 gegenüber Opus 5.5 |
|---|---|---|---|---|
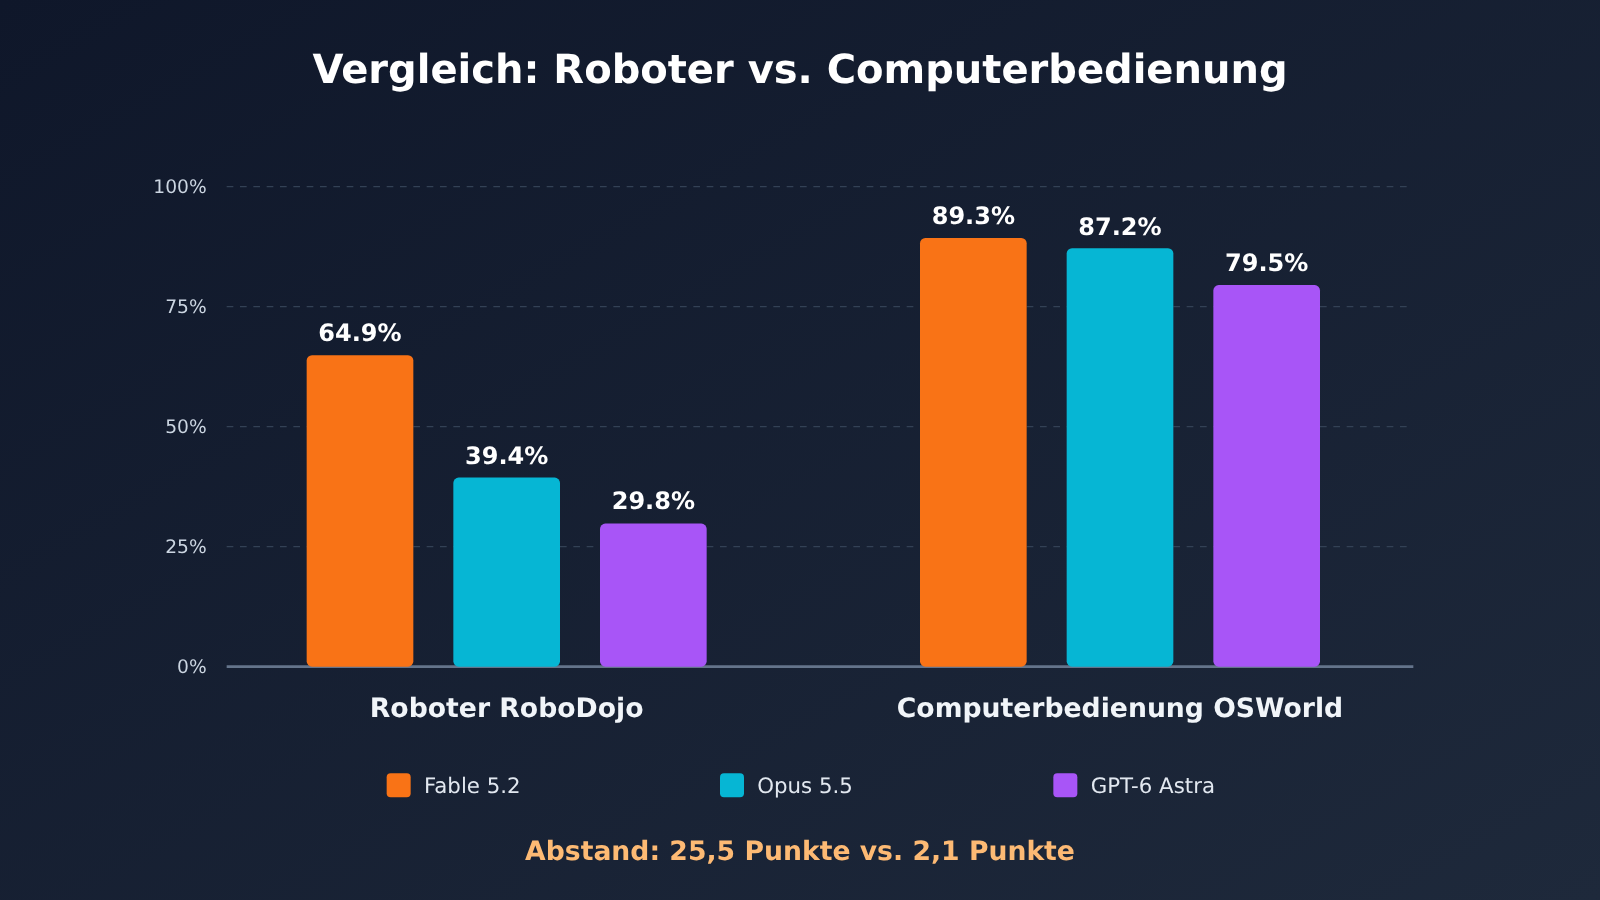
| RoboDojo Sim (Simulation mit zwei Armen) | 64,9 % | 39,4 % | 29,8 % | 25,5 Prozentpunkte |
| OSWorld 2.1 (Computerbedienung, Teil des Offline-Sets) | 89,3 % | 87,2 % | 79,5 % | 2,1 Prozentpunkte |
| AutomationBench | 51,4 % | 42,5 % | 41,4 % | 8,9 Prozentpunkte (Carbon liegt mit 53,9 % höher) |
| Remote Labor Index (Stufe „High“) | 41,3 % | 21,3 % | 20,8 % | 20,0 Prozentpunkte |
Bei OSWorld 2.1 liegt Fable 5.2 nur 2,1 Prozentpunkte vor Opus 5.5. Das ist eine ganz andere Größenordnung als der Abstand bei RoboDojo, wo die Werte von 39,4 % auf 64,9 % steigen. Wenn Sie einen Agenten für Aufgaben am Computer benötigen, ist der Unterschied zwischen Opus 5.5 und Fable 5.2 deutlich geringer als bei den Robotiktests.
Effort-Stufe: 64,9 % sind kein Ergebnis mit der Standardeinstellung
Sofern nicht anders angegeben, zeigt die Ergebnistabelle im Veröffentlichungsbeitrag jeweils die höchste Effort-Stufe, die für das Modell zum damaligen Zeitpunkt verfügbar war. In der Claude API ist die Standard-Effort-Stufe für Fable 5.2 „high“, in der Claude-App und in Claude Code dagegen „Medium“. Wenn du also den Modellaufruf mit den Standardeinstellungen ausführst, erhältst du nicht unbedingt die Konfiguration, mit der die 64,9 % erreicht wurden.
Die höchste Stufe bedeutet längeres Nachdenken und mehr Tokens. In einer Schleife wie der Robotersteuerung, die wiederholte Entscheidungen erfordert, erhöhen sich Latenz und Kosten, wenn bei jedem Schritt mit der höchsten Stufe gearbeitet wird. Wie stark die 64,9 % bei „high“ oder „medium“ sinken würden, geht aus dem Veröffentlichungsbeitrag nicht hervor.
Spezifikationen im Vergleich: Fable 5.2, Opus 5.5 und GPT-6 Astra
| Merkmal | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Kontextfenster | 1M | 1M | 1,050,000 |
| Maximale Ausgabe | 128K | 128K | 128,000 |
| Eingabe- / Ausgabemodalität | Text + Bilder / Text | Text + Bilder / Text | Text + Bilder / Text |
| Standard-Effort-Stufe in der API | high | medium | Unterstützt low bis max |
| Latenzstufe | Moderate | Moderate | Auf der offiziellen Seite nicht nach derselben Definition angegeben |
| Wissensstand bis | Juni 2026 | 2026-06 | 2026-04-30 |
Alle drei Modelle geben Text aus. Das ist eine gemeinsame Einschränkung, die sich bei der Robotersteuerung nicht umgehen lässt.
Dinge, die bei Fable 5.2 nicht in die Roboterwertung einfließen
Drei elektronische Geräte als Hardware-Design-Experiment
Im Ankündigungsbeitrag wird außerdem beschrieben, wie Fable 5.2 mit einer einzigen Eingabeaufforderung drei funktionsfähige elektronische Geräte entwarf: einen Sprachassistenten für zu Hause, ein USB-Lautsprechertelefon und ein tragbares virtuelles Haustier. Das Projekt entstand in Zusammenarbeit mit Diode. Jede Platine ließ sich in weniger als einem Tag fertigen, und alle drei Geräte funktionierten ohne Änderungen an der Schaltung.
Das zeigt die Fähigkeit zum Hardware-Design, hat aber nichts mit RoboDojo zu tun. Auch die Geräte selbst sind keine Roboter. Stellt man diese Leistung neben die 64,9 %, kann leicht der Eindruck entstehen, Fable 5.2 könne alles abdecken – vom Entwurf bis zur Steuerung. Zwischen den beiden Leistungen besteht jedoch kein Zusammenhang.
Die Grenzen von Fable 5.2: Einschränkungen, die sich auf den Regelkreis auswirken
Die folgenden Punkte stammen von der Modellseite und aus den Update-Hinweisen. Jeder davon wirkt sich direkt auf den Regelkreis aus, den Sie aufbauen:
- Erzwungene Tool-Aufrufe führen zu Fehlern: Wird
tool_choiceaufanyodertoolgesetzt, gibt die API den Fehler 400 zurück. Wenn Ihr System darauf angewiesen ist, dass zwingend ein Aktionstool aufgerufen wird, müssen Sie das Modell selbst wählen lassen und die Auswertung anschließend mit einem Fallback absichern. - Sampling-Parameter lassen sich nicht festlegen: Werden
temperature,top_podertop_kübergeben, gibt die API den Fehler 400 zurück. - Das Denken lässt sich nicht abschalten: Adaptives Denken ist immer aktiv. Die Menge lässt sich nur über
effortsteuern. Laut den Update-Hinweisen kann auch die Aufforderung „Nicht nachdenken, direkt antworten“ das Denken ab der Stufe „medium“ nicht unterbinden. - Bei langen Tool-Ketten sagt das Modell nur selten etwas: Bei aufeinanderfolgenden Tool-Aufrufen kann die Ausgabe für Nutzerinnen und Nutzer sehr knapp ausfallen oder das Modell ruft Tools ohne Erklärung direkt auf. Die Überwachungsoberfläche sollte sich daher nicht darauf verlassen, dass das Modell den Fortschritt von sich aus meldet.
- Das Modell kann vorzeitig stoppen: Manchmal endet eine Runde vorzeitig und hinterlässt eine To-do-Liste oder bleibt an einem gewöhnlichen Hindernis hängen. Bei der Stufe „low“ kommt das häufiger vor.
- Auch Ablehnungen verbrauchen Kontingent: Bei einer Ablehnung wird HTTP 200 zurückgegeben und
stop_reasonaufrefusalgesetzt. Trotzdem wird das Ratenlimit belastet. - Datenaufbewahrung: Die Daten werden 30 Tage lang aufbewahrt. Eine Aufbewahrung ohne Datenspeicherung ist nur mit ausdrücklicher Genehmigung von Anthropic möglich.
An einen Regelkreis für Roboter werden hohe Anforderungen gestellt: Jeder Schritt muss eine ausführbare Aktion liefern. Zusammengenommen bedeuten die oben genannten Punkte, dass Sie Zeitüberschreitungen, leere Aktionen, Ablehnungen und vorzeitige Abbrüche als Zustände behandeln müssen, von denen sich das System erholen kann, bevor Sie das Modell in den Regelkreis einbinden.
Preise für Fable 5.2: Vor der Anbindung genau nachrechnen
Die offiziellen Preise gelten pro Million Token und stammen von der Modellseite, aus den Versionshinweisen und von der Seite zum Schnellmodus:
| Abrechnungsposten | Fable 5.2 | Opus 5.5 | GPT-6 Astra (kurzer Kontext) |
|---|---|---|---|
| Standard-Eingabe / -Ausgabe | $8 / $40 | $4 / $20 | $10 / $50 |
| Cache-Lesezugriff | $0.20 | $0.20 | $1 (Cache-Eingabe) |
| Cache-Schreibzugriff | 5 Minuten $10, 1 Stunde $16 | Auf der offiziellen Seite aufgeführt, hier nicht angegeben | $12.5 |
| Batchverarbeitung | Zum halben Preis: $4 / $20 | Ebenfalls zum halben Preis | Hier nicht angegeben |
| Schnellmodus | $16 / $80 | $8 / $40 | — |
Ein paar weitere Punkte sind zu beachten: Fable 5.2 ist 20 % günstiger als Fable 5.1 ($10 / $50). Die Leistung im Schnellmodus bleibt unverändert; die Ausgabe ist bis zu 2.5-mal schneller als im Standardmodus. Die offiziellen Angaben nennen jedoch keine separaten Cache-Preise für den Schnellmodus. Ausgehend vom Preisfaktor ergeben sich ungefähr $0.40 für Cache-Lesezugriffe, $20 für einen 5-Minuten-Cache-Schreibzugriff und $32 für einen 1-Stunden-Cache-Schreibzugriff. Zwischen den Geschwindigkeitsmodi wird der Eingabeaufforderungs-Cache nicht geteilt. Beim Wechsel vom Schnell- in den Standardmodus kommt es daher zu einem Cache-Miss. Bei GPT-6 Astra wird der gesamte Auftrag mit dem 2-Fachen für die Eingabe und dem 1.5-Fachen für die Ausgabe berechnet, sobald die Eingabe 272K Token überschreitet.
In einer Roboterschleife wird bei jedem Schritt ein neues Bild übertragen, während die vorherige System-Eingabeaufforderung und die Aktionsbeschreibung im Wesentlichen unverändert bleiben. Diese Struktur eignet sich dazu, die Kosten durch Caching zu senken. Die Bildeingabe und die Denk-Token pro Schritt lassen sich dadurch jedoch nicht einsparen.
Kann man Fable 5.2 jetzt aufrufen? Verfügbarkeit bei APIYI
Stand: 10.11.2026. In der Gesamtmodellübersicht und der öffentlichen Preis-API von APIYI (apiyi.com) ist claude-fable-5-2 noch nicht enthalten. Auch ein Modell der Mythos-Reihe ist dort nicht aufgeführt. Wir werden dieses Modell so bald wie möglich bereitstellen. Maßgeblich sind die Modellliste und die dort angegebenen Preise. Bis dahin nennen wir in diesem Artikel keinen Preis für Fable 5.2 bei APIYI und rechnen den offiziellen Preis auch nicht anhand von Gruppenmultiplikatoren um.
Folgende verwandte Modelle waren an diesem Tag bereits über die Gesamtmodellübersicht von APIYI verfügbar (Listenpreise in US-Dollar pro Million Token):
| Modell-ID | Eingabe / Ausgabe | Cache-Lesezugriffe | Endpunkte | Geeignet für |
|---|---|---|---|---|
claude-opus-5-5、claude-opus-5-5-thinking |
$4 / $20 | $0.2 | chat、messages | Zunächst Tool-Aufrufe und den Ablauf für die Steuerung eines Computers einrichten |
claude-fable-5-1、claude-fable-5-1-thinking |
$10 / $50 | $0.25 | chat、messages | Als Vergleichsbasis für die Vorgängergeneration |
claude-fable-5、claude-fable-5-thinking |
$10 / $50 | $1 | chat、messages | Historische Versionsvergleiche |
gpt-6-astra |
$10 / $50 | $1 | responses (primär)、chat | Vergleich mit einem anderen Anbieter |
Die Preise in der Gesamtmodellübersicht sind Listenpreise. Die tatsächlichen Kosten richten sich nach dem Token-Gruppenmultiplikator; maßgeblich ist die Abrechnung. In der Fußnote zu gpt-6-astra ist nur die Preisstaffel für Eingaben angegeben: bis zu 272.000 Token kosten $10, von 272.001 bis 1.050.000 Token $20. Ein Preis für Ausgaben mit langem Kontextfenster ist nicht aufgeführt. Maßgeblich ist die Abrechnung in der Konsole. Für die Anbindung verwenden Sie die OpenAI-kompatible Schnittstelle und tragen https://api.apiyi.com/v1 als base_url ein.
Am sinnvollsten ist es, zunächst mit claude-opus-5-5 die Bildverarbeitung, die Interpretation von Aktionen und die Fehlerbehebung zu testen. Sobald Fable 5.2 bei APIYI verfügbar ist, können Sie die Modell-ID ersetzen und die Ergebnisse vergleichen. Der Abstand bei der Robotik (25,5 Punkte) ist deutlich größer als bei der Computersteuerung (2,1 Punkte). Es gibt also gute Gründe, auf Fable 5.2 zu warten – eine Entscheidung allein auf Grundlage eines Demo-Videos reicht jedoch nicht aus.
Analyse der Stärken und Schwächen von Fable 5.2 bei Robotikaufgaben
Stärken
- Großer Sprung gegenüber der Vorgängerversion: RoboDojo Sim steigt von 27,6 % auf 64,9 % – eine der deutlichsten Verbesserungen in der gesamten Ergebnistabelle.
- Deutlicher Vorsprung vor vergleichbaren Modellen: 25,5 Prozentpunkte vor Opus 5.5 und 35,1 Prozentpunkte vor GPT-6 Astra (laut dem Veröffentlichungsbeitrag von Anthropic).
- Niedrigerer Preis: Der Standardpreis liegt 20 % unter dem von 5.1, der Preis für das Lesen aus dem Cache beträgt 0,20 $.
- Konsistente Bildverarbeitung: Bildeingaben und ein Kontextfenster von 1M ermöglichen die Verarbeitung längerer visueller Abläufe mit mehreren Schritten.
Einschränkungen
- Begrenzte Beleglage: Die Ergebnisse stammen aus internen Tests mit der höchsten Aufwandsstufe. In öffentlichen Ranglisten ließ sich keine identische Zahl finden, und unabhängige Wiederholungstests fehlen.
- Nur Simulationsdaten: Die Demovideos enthalten keine Erfolgsquoten. Für die Behauptung, das Modell übertreffe „die meisten spezialisierten Robotersysteme“, wird keine Liste der verglichenen Systeme genannt.
- Viele Einschränkungen im Regelkreis: Das Modell gibt nur Text aus, kann nicht zum Aufruf von Tools gezwungen werden, das Denken lässt sich nicht abschalten, und bei längeren Abläufen gibt es nur selten von sich aus Erklärungen.
- Hohe Kosten bei maximaler Leistung: Die Punktzahl basiert auf der höchsten Aufwandsstufe. Latenz und Token-Verbrauch müssen im praktischen Einsatz selbst gemessen werden.
Wann Sie das Modell nicht allein auf dieser Grundlage wechseln sollten
Wenn Sie weder eine eigene Simulationsumgebung noch einen Regelkreis mit realen Robotern haben, lässt sich die Aussagekraft der 64,9 % für Sie nicht überprüfen. Sie können nicht feststellen, ob der Wert auch für Ihre Konfiguration gilt. Geht es Ihnen um Cybersicherheit, biologische Anwendungen oder alltägliche Programmieraufgaben, sagt diese Punktzahl ebenfalls nichts aus. Für solche Bereiche sollten Sie die jeweils passenden Tests heranziehen. Im Veröffentlichungsbeitrag empfiehlt Anthropic, bei den meisten Programmier- und Wissensaufgaben zunächst mit Opus 5.5 zu beginnen und das Modell je nach Schwierigkeitsgrad hoch- oder herabzustufen.
Häufige Fragen (FAQ)
F1: Sind die 64,9 % von Fable 5.2 ein Ergebnis aus einer öffentlichen Rangliste?
Nein. In einer Fußnote der Ankündigung steht, dass es sich um ein intern von Anthropic ermitteltes Ergebnis handelt. RoboDojo selbst ist ein öffentlicher Benchmark. Bis zum 10.11.2026 konnten wir auf der öffentlichen Ranglistenseite jedoch nicht denselben Wert finden.
F2: Wurden die 64,9 % mit der standardmäßig eingestellten Leistungsstufe erreicht?
Nein, sondern mit der höchsten verfügbaren Leistungsstufe. Bei der Claude API ist standardmäßig „high“ eingestellt, in der Claude-App und in Claude Code hingegen „Medium“. Wie viele Punkte mit der Standardeinstellung erreicht werden, geht aus der Ankündigung nicht hervor.
F3: Hat Fable 5.2 speziell entwickelte Robotersysteme übertroffen?
Laut Ankündigung hat das Modell „die meisten speziell für die Robotersteuerung entwickelten Systeme“ übertroffen. Eine Liste wurde jedoch nicht beigefügt. Welche konkreten Systeme gemeint sind, ist derzeit nicht bekannt.
F4: Warum hat Gemini 4 Carbon bei RoboDojo keine Punktzahl?
Das entsprechende Feld in der Tabelle der Ankündigung ist leer; eine Erklärung dafür gibt es nicht. Das bedeutet weder, dass das Modell null Punkte erzielt hat, noch lässt sich daraus auf seine Leistung schließen.
F5: Wie kann ich mich jetzt schon auf die API-Nutzung vorbereiten?
Stand 10.11.2026 ist `claude-fable-5-2` bei APIYI unter apiyi.com noch nicht verfügbar. Wir werden das Modell so bald wie möglich anbieten. Maßgeblich für Modellnamen und Preise ist die Modellliste auf der Plattform. Bis dahin können Sie mit dem bereits verfügbaren `claude-opus-5-5` die Eingabe von Bildern und den Ablauf von Tool-Aufrufen testen. Sobald Fable 5.2 verfügbar ist, können Sie das Modell wechseln und die Ergebnisse vergleichen.
F6: Belegen die drei elektronischen Geräte, dass das Modell Roboter steuern kann?
Nein. Der Sprachassistent, das USB-Lautsprechertelefon und das virtuelle Haustier sind Hardware-Designexperimente in Zusammenarbeit mit Diode. Sie zeigen Fähigkeiten im Schaltungsdesign und haben nichts mit dem Ergebnis bei der zweiarmigen Steuerung in RoboDojo zu tun.
F7: Sollten Agenten für die Computersteuerung auf Fable 5.2 warten?
Das ist kaum nötig. Bei OSWorld 2.1 erreicht Fable 5.2 89,3 %, Opus 5.5 kommt auf 87,2 % – ein Unterschied von nur 2,1 Prozentpunkten. Der Standardpreis von Opus 5.5 beträgt jedoch nur die Hälfte des Preises von Fable 5.2.
Fable 5.2: Wichtigste Erkenntnisse zu den Roboterfähigkeiten
- Bedeutung des Werts: 64,9 % ist das Ergebnis interner Tests mit zwei Roboterarmen in einer Simulation und der höchsten Effort-Stufe.
- Größe des Abstands: Der Wert liegt 25,5 Prozentpunkte über Opus 5.5 und 35,1 Prozentpunkte über GPT-6 Astra.
- Vergleichswert: Bei OSWorld beträgt der Vorsprung nur 2,1 Prozentpunkte. Diese beiden Abstände sind nicht vergleichbar.
- Einordnung der Demos: Rubik’s Cube lösen, Flaschenverschlüsse aufdrehen und malen sind Demos aus dem Ankündigungsartikel, keine produktionsreifen Fähigkeiten.
- Einschränkungen der Schleife: Das Modell gibt nur Text aus. Ein erzwungenes
tool_choiceführt zu einem 400-Fehler, und das Denken lässt sich nicht abschalten. - Verfügbarkeit: APIYI hatte das Modell zum 2026-11-10 noch nicht im Angebot. Für den Aufbau einer Schleife können Sie vorerst
claude-opus-5-5verwenden.
Zusammenfassung
Die Fortschritte von Claude Fable 5.2 bei der Robotersteuerung sind ein deutliches Signal: Der Wert in RoboDojo Sim ist von 27,6 % bei der Vorgängergeneration auf 64,9 % gestiegen. Im von Anthropic angeführten Vergleich liegt das Modell klar vorn. Die Aussagekraft dieses Werts ist jedoch begrenzt: Er gilt nur für eine Simulationsumgebung, interne Tests und die höchste Effort-Stufe. Er sagt weder etwas über die Erfolgsquote mit realen Robotern aus noch über die Einsatzfähigkeit in der Produktion.
Wenn Sie bereits eine eigene Simulations- oder Roboterschleife haben, lohnt sich ein Vergleich, sobald Fable 5.2 verfügbar ist. Planen Sie dabei von Anfang an ein, dass die Ausgabe geparst werden muss, Tool-Aufrufe nicht erzwungen werden können und sich das Denken nicht abschalten lässt. Wenn Sie keine solche Schleife haben oder Aufgaben wie Programmieren und die Bedienung eines Computers lösen möchten, gibt es keinen Grund, wegen der 64,9 % Ihre bestehende Lösung zu ändern.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI unter apiyi.com. Ob und wann ein Modell verfügbar ist, sehen Sie in der Modellliste der Plattform.


