
Anmerkung des Autors: Die Open-Weight-Modellgewichte von 文心5.5 Flash Base stehen zum Download bereit. Dieser Artikel hilft Ihnen anhand von vier Aspekten bei der Entscheidung, ob Sie das Basismodell selbst betreiben oder eine API nach Bedarf nutzen sollten: Architekturparameter, Hardwareanforderungen, Einsatzzweck und Kosten.
Am 5. November 2026 hat Baidu 文心5.5 Flash Base(ERNIE-5.5-Flash-Base) offiziell vorgestellt und die Modellgewichte veröffentlicht. Das sparsame MoE-Basismodell hat insgesamt 280 Milliarden Parameter, von denen 14 Milliarden pro Token aktiviert werden. In mehreren Benchmarks erreicht es für seine Modellgröße SOTA-Ergebnisse. Die Gewichte stehen auf Hugging Face in einer FP8- und einer BF16-Version bereit. Auch ein vLLM-Plugin und das SGLang Cookbook wurden veröffentlicht – diesmal gibt es also nicht nur ein Paper, sondern auch die Gewichte.
Dies ist keine weitere Zusammenfassung von Benchmark-Ergebnissen. Viele Teams sehen „Open Source + SOTA“ und wollen die Gewichte sofort herunterladen und in Betrieb nehmen. Dabei übersehen sie einen entscheidenden Punkt: Es handelt sich um ein Basismodell ohne Zwischen- und Nachtraining. Es eignet sich als Ausgangspunkt für das Training, aber nicht direkt als Chatbot.
Das nehmen Sie mit: Nach der Lektüre wissen Sie, für welche Einsatzszenarien 文心5.5 Flash Base geeignet ist, wie viel Grafikspeicher die Selbstbereitstellung ungefähr erfordert und wann ein API-Aufruf nach Bedarf günstiger ist.
ERNIE 5.5 Flash Base: Das Wichtigste im Überblick
Die folgende Tabelle fasst die wichtigsten Eigenschaften des Modells zusammen. Sie sind entscheidend für die spätere Frage, ob sich eine eigene Bereitstellung lohnt oder ein Modellaufruf besser passt.
| Merkmal | Beschreibung | Bedeutung für die Auswahl |
|---|---|---|
| Modelltyp | Checkpoint nach Abschluss des Vortrainings, ohne Intermediate Training und Post-Training | Nicht direkt für Dialoge geeignet, aber eine Grundlage für weiteres Training |
| Parameterumfang | 280B Parameter insgesamt, 14B pro Token aktiviert | Geringer Rechenaufwand bei der Inferenz, aber der Speicherbedarf für die Gewichte richtet sich nach 280B |
| Kontext | 128K Trainingskontext, bis zu 1M Tokens bei Feinabstimmung und Inferenz | Geeignet für die Anpassung an Fachgebiete mit langen Dokumenten oder Code auf Repository-Ebene |
| Gewichtsformat | FP8 und BF16 auf Hugging Face verfügbar | FP8 senkt die Hürden für die Bereitstellung deutlich |
| Ökosystem | vLLM-Plug-in, SGLang Cookbook | Lässt sich direkt in gängige Inferenz-Frameworks integrieren |
Was bedeutet „Base“ bei ERNIE 5.5 Flash Base?
Ein Base-Modell hat nur gelernt, „das nächste Token vorherzusagen“ – nicht aber, Anweisungen zu verstehen und Antworten zu geben. Stellt man ihm eine Frage, schreibt es daher möglicherweise weitere Fragen, statt eine Antwort zu liefern. Baidu beschreibt den Zweck klar: Entwickler können diesen gemeinsamen Ausgangspunkt nutzen, um das Modell an Fachgebiete anzupassen, auf Anweisungen feinabzustimmen, seine Reasoning-Fähigkeiten zu stärken und es für Agents zu trainieren.
Die erste Entscheidung ist also einfach: Wenn Sie ein Modell direkt nutzen möchten, ist Base nicht die richtige Wahl. Wenn Sie ein Modell trainieren möchten, bietet es dagegen einen guten Ausgangspunkt. Baidu hat außerdem angekündigt, dass die finale Version von ERNIE 5.5 Flash in Kürze erscheint. Teams, die das Modell direkt für Dialoge einsetzen möchten, können darauf warten.
Vergleichbare Modelle in derselben Größenklasse
In den von Baidu veröffentlichten Benchmarks wurde das Modell unter anderem mit DeepSeek-V4-Flash-Base (284B-A13B), Hy3-preview-Base (295B-A21B) und MiMo-V2.5-Base (310B-A15B) verglichen. ERNIE 5.5 Flash Base zeigte starke Ergebnisse bei Reasoning, Code, fachlichen Aufgaben und Aufgaben mit langem Kontext. Für Teams, die ein Modell beispielsweise für Code-Agents oder das Verständnis langer Dokumente feinabstimmen möchten, ist es ein Kandidat für die engere Auswahl.
So funktioniert Wenxin 5.5 Flash Base: drei Effizienzverbesserungen
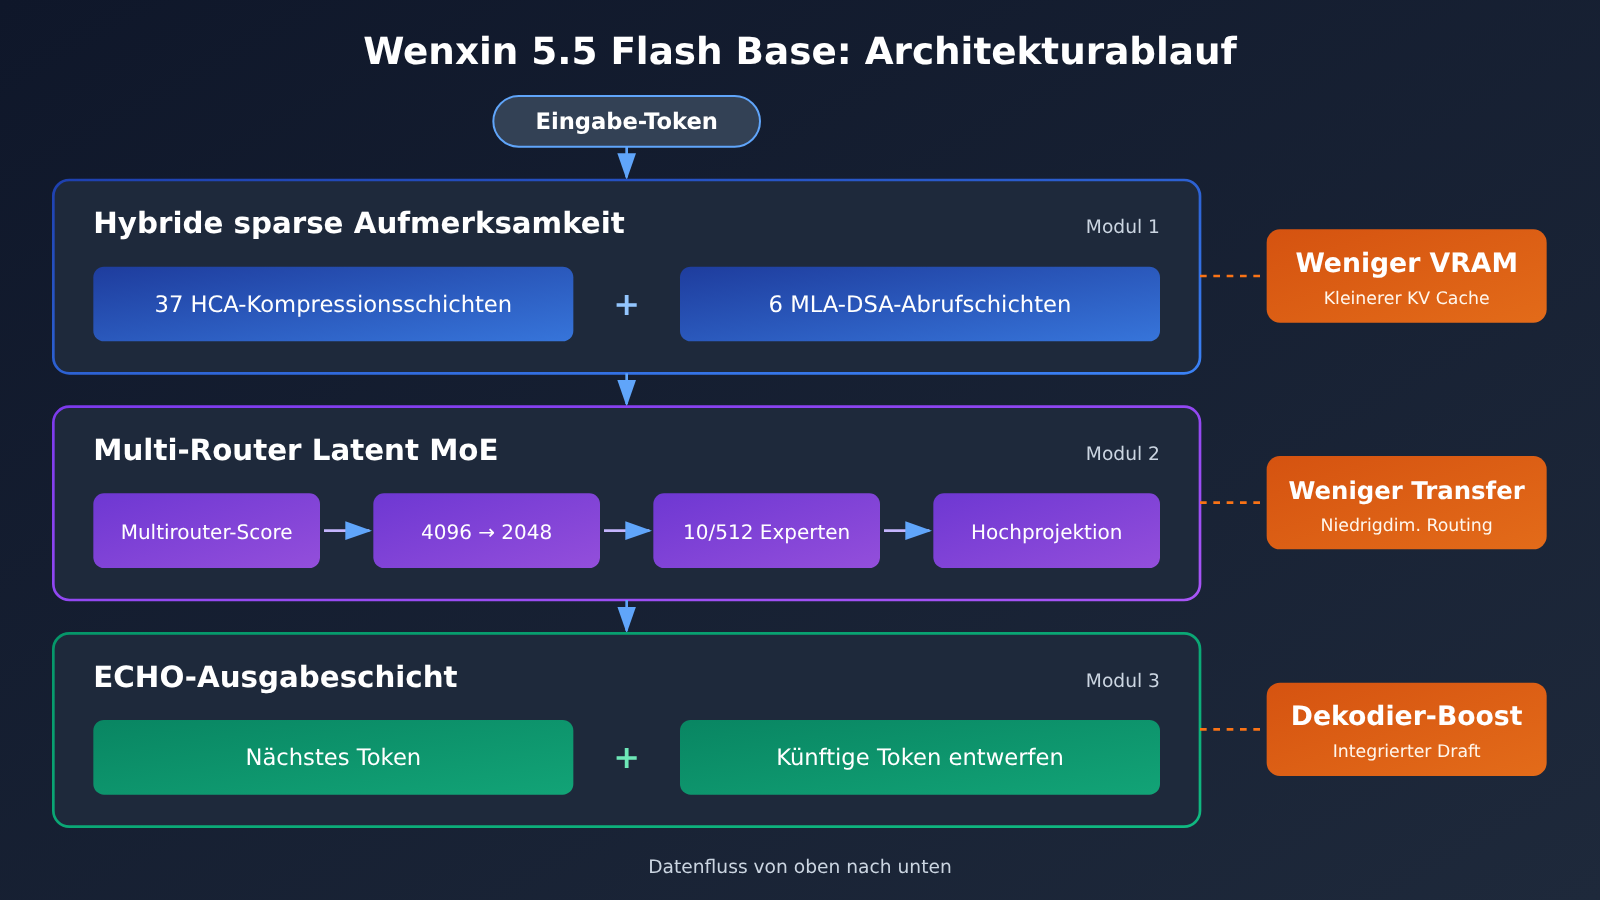
Wer die Architektur versteht, kann die Bereitstellungskosten besser einschätzen. Das Wenxin-Team hat Effizienz bereits beim Vortraining als Designfaktor berücksichtigt. Die wichtigsten Änderungen betreffen Attention, Experten-Routing und die Vorhersage zukünftiger Token.
| Modul | Zentrales Design | Vorteil bei der Bereitstellung |
|---|---|---|
| Hybride Sparse Attention | 37 der 43 Schichten nutzen HCA (je 128 Token werden zu einem Cache-Eintrag komprimiert), 6 Schichten nutzen MLA + DSA für die Sparse-Retrieval-Suche | Deutlich kleinerer KV Cache, geringerer Grafikspeicherbedarf bei langem Kontext |
| Multi-Router Latent MoE | Mehrere Sigmoid-Router bewerten gemeinsam; aus 512 Routing-Experten werden 10 ausgewählt, hinzu kommt 1 gemeinsam genutzter Experte. Die Experten rechnen in einem latenten Raum mit 2048 Dimensionen | Experten-FLOPs und Kommunikationsaufwand bei der Verteilung sinken etwa um die Hälfte |
| ECHO | Nutzt die letzte Schicht des Hauptmodells erneut, um zukünftige Token vorherzusagen | Kann ohne zusätzliche Parameter direkt als integriertes Draft-Modell für spekulatives Decoding dienen |
| Ergänzende Komponenten | MultiMax-Ausgabekopf, R2L-Tokenizer mit einem Vokabular von etwa 200.000 Einträgen | Zuverlässigere Verarbeitung von Zahlen und Rechenaufgaben |
Warum Wenxin 5.5 Flash Base beim KV Cache Speicher spart
Herkömmliche Modelle müssen in jeder Schicht den vollständigen KV Cache speichern. Je länger der Kontext, desto knapper wird der Grafikspeicher. Bei Wenxin 5.5 Flash Base greifen 37 Schichten nur auf komprimierte „Zusammenfassungen“ zu; lediglich 6 Schichten lesen den bisherigen Verlauf Token für Token. Diese 6 Schichten verwenden wiederum einen schlanken Indexer, um die Top-K-Positionen für genauere Berechnungen auszuwählen. Dadurch benötigt der KV Cache bei 128K oder noch längerem Kontext deutlich weniger Speicher als bei einem gleich großen Modell mit vollständiger Attention. Für Teams, die das Modell selbst betreiben, bedeutet das eine spürbare Einsparung beim Grafikspeicher.
Was ECHO zur Beschleunigung der Inferenz beiträgt
ECHO sagt beim Vortraining nur 1 zusätzliches Token voraus. Als Draft-Modell kann es dennoch mehrere Token nacheinander entwerfen und erreicht dabei eine höhere Akzeptanzrate als ein externes MTP-Modul, das auf dieselbe Weise trainiert wurde. Unterstützt das Inferenz-Framework bei der eigenen Bereitstellung diesen Weg des spekulativen Decodings, kann der Durchsatz deutlich steigen. Das ist auch ein Vorteil offener Modellgewichte gegenüber einer API: Solche Inferenzoptimierungen lassen sich vollständig selbst steuern.
Erste Schritte mit Wenxin 5.5 Flash Base: selbst hosten
Wenn Sie dieses Basismodell für Training oder private Inferenz einsetzen möchten, führt der folgende Weg zum Ziel. Der Artikel kommt ohne Code aus und erläutert die wichtigsten Parameter in Textform.
Schritt 1: Den GPU-Speicherbedarf abschätzen
Bei einem MoE-Modell richtet sich der Rechenaufwand nach den aktivierten Parametern. Die Gewichte müssen aber vollständig geladen werden, daher zählt für den Speicherbedarf die Gesamtzahl von 280 Milliarden Parametern. Die Tabelle zeigt eine grobe Schätzung nach „Bytes pro Parameter × Parameterzahl“. KV-Cache, Aktivierungswerte und Framework-Overhead sind nicht eingerechnet. Massgeblich sind die offizielle Dokumentation und eigene Tests.
| Gewichtsversion | Geschätzter GPU-Speicher für Gewichte | Deployment-Empfehlung (Schätzung) | Geeignet für |
|---|---|---|---|
| FP8 | ca. 280 GB | Ein Server mit 8 GPUs der 80-GB-Klasse; lässt Platz für den KV-Cache | Inferenz-Evaluierung, einfache Dienste |
| BF16 | ca. 560 GB | Ein Server mit 8 GPUs mit grossem Speicher oder Tensorparallelismus über mehrere Server | Präzisionskritische Evaluierung und Ausgangspunkt für Fine-Tuning |
| Fine-Tuning aller Parameter | Deutlich mehr als für Inferenz (zusätzlich Speicher für Optimizer-Zustände und Gradienten) | Cluster aus mehreren Servern, verteiltes Trainingsframework erforderlich | Umfassende Anpassung an eine Fachdomäne |
| LoRA-basiertes Fine-Tuning | Zwischen Inferenz und Fine-Tuning aller Parameter | Abhängig von Rang und Sequenzlänge | Domänenanpassung für kleine und mittlere Teams |
Schritt 2: Inferenz-Framework auswählen und Gewichte laden
Der Anbieter stellt ein vLLM-Plugin und ein SGLang Cookbook bereit. Am besten orientieren Sie sich zunächst an diesen beiden Ressourcen:
- Laden Sie die FP8- oder BF16-Gewichte von Hugging Face herunter. Reservieren Sie dafür ungefähr so viel Speicherplatz auf dem Datenträger, wie die Gewichte im GPU-Speicher benötigen.
- Installieren Sie vLLM und laden Sie das offizielle Plugin, oder konfigurieren Sie die Startparameter anhand des SGLang Cookbook.
- Stimmen Sie den Grad des Tensorparallelismus auf die Anzahl der GPUs ab (in vLLM über den Parameter
tensor-parallel-size). - Testen Sie zunächst eine Kontextlänge von etwa 32K und erhöhen Sie diese danach schrittweise. Beobachten Sie dabei die Belegung des KV-Cache.
- Führen Sie einen Smoke-Test mit einer Eingabeaufforderung zur Textfortsetzung durch: Geben Sie zum Beispiel den Anfang eines Codeabschnitts vor und lassen Sie ihn vervollständigen, statt direkt eine Frage zu stellen.
Schritt 3: Das Trainingsziel festlegen
Sobald die Base-Gewichte bereitstehen, beginnt die eigentliche Arbeit. Drei Ansätze sind verbreitet: fortgesetztes Pretraining mit domänenspezifischen Korpora, SFT mit Instruktionsdaten sowie darauf aufbauendes Training zur Stärkung der Reasoning-Fähigkeiten oder Training mit Agent-Trajektorien. In das Pretraining von Wenxin sind bereits Codedaten wie Commits, Issues, PRs und CI-Daten zur Validierung von Fehlerbehebungen eingeflossen, ebenso lange Texte für Fragen und Antworten mit mehrstufiger Schlussfolgerung. Besonders vielversprechend erscheint daher Fine-Tuning für Softwareentwicklung und lange Dokumente.
🎯 Technischer Tipp: Bevor Sie GPU-Ressourcen in Fine-Tuning investieren, testen Sie Ihren geschäftlichen Evaluierungsdatensatz zunächst mit einem vorhandenen Instruktionsmodell und ermitteln Sie einen Basiswert. APIYI apiyi.com bietet eine einheitliche Schnittstelle zu mehreren führenden Modellen. So erhalten Sie kostengünstig einen Vergleichswert und können besser entscheiden, ob sich das eigene Training des Basismodells lohnt.
文心5.5 Flash Base: Schnellstart und API-Zugriff nach Bedarf
Zunächst eine wichtige Information: APIYI bietet derzeit noch keine Modelle der 文心-ERNIE-Serie an. Das gilt auch für 文心5.5 Flash Base. Die Modelle sollen so bald wie möglich verfügbar sein. Ein Base-Modell eignet sich zudem nicht für den direkten Einsatz als Chat-API. Für die meisten Anwendungen ist eine Instruction- oder Reasoning-Version besser geeignet.
Wenn Sie die Funktionen sofort in Ihr Produkt integrieren möchten, können Sie zunächst mit einem bereits verfügbaren, etablierten Modell starten. Sobald die finale Version von 文心5.5 Flash verfügbar ist, können Sie das Modell austauschen und vergleichen. APIYI unterstützt sowohl das OpenAI- als auch das Anthropic-Schnittstellenformat. Für den Modellwechsel genügt es, den Parameter model zu ändern – die Aufruflogik müssen Sie nicht neu schreiben.
Preise verfügbarer Modellalternativen bei APIYI
Die folgenden Preise stammen von der APIYI-Preisseite docs.apiyi.com/models und sind in US-Dollar pro Million Tokens angegeben. Prüfen Sie vor dem Modellaufruf die aktuellen Angaben auf der Seite.
| Modell | Eingabe | Ausgabe | Cache | Geeignete Einsatzbereiche | Verfügbare Plattform |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Aufgaben mit vielen gleichzeitigen Anfragen und knappem Budget | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | Lange Kontexte und chinesischsprachige Anwendungen | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | Standardmodell für Programmierung und Agenten | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | Komplexes Reasoning und anspruchsvolle Aufgaben | APIYI apiyi.com |
| 文心5.5 Flash Base / finale Version | — | — | — | Das Modell ist bei APIYI derzeit noch nicht verfügbar | Soll bald verfügbar sein |
Darüber hinaus bietet APIYI weitere chinesische Modelle wie die qwen3.8-Serie sowie die Bildmodelle gpt-image-2.6-flare und gpt-image-2.6-sunburst an (Texteingabe $5, Bildeingabe $8, Ausgabe $30; auch hier gelten die Angaben auf der Preisseite). Beachten Sie: deepseek-v4.1-flash in der Tabelle ist ein direkt nutzbares Instruction-Modell und nicht identisch mit DeepSeek-V4-Flash-Base aus dem Evaluierungsvergleich.
Anbindung
Für das OpenAI-Format setzen Sie die base_url des SDK auf die in der APIYI-Dokumentation angegebene Schnittstellenadresse und tragen bei api_key den in der Konsole generierten API-Schlüssel ein. Auch Projekte mit dem Anthropic SDK lassen sich direkt anbinden. Die vollständigen Schnittstellenadressen, Parameterbeschreibungen und Beispiele finden Sie im APIYI-Dokumentationszentrum unter docs.apiyi.com.
🚀 Schnellstart: Erstellen Sie Ihren ersten Prototyp am besten mit deepseek-v4.1-flash oder claude-sonnet-5-5 auf APIYI apiyi.com. Sobald die finale Version von 文心5.5 Flash auf der Plattform verfügbar ist, können Sie für einen A/B-Vergleich einfach den Modellnamen ändern.
文心5.5 Flash Base selbst betreiben oder per API nutzen: Entscheidungstabelle
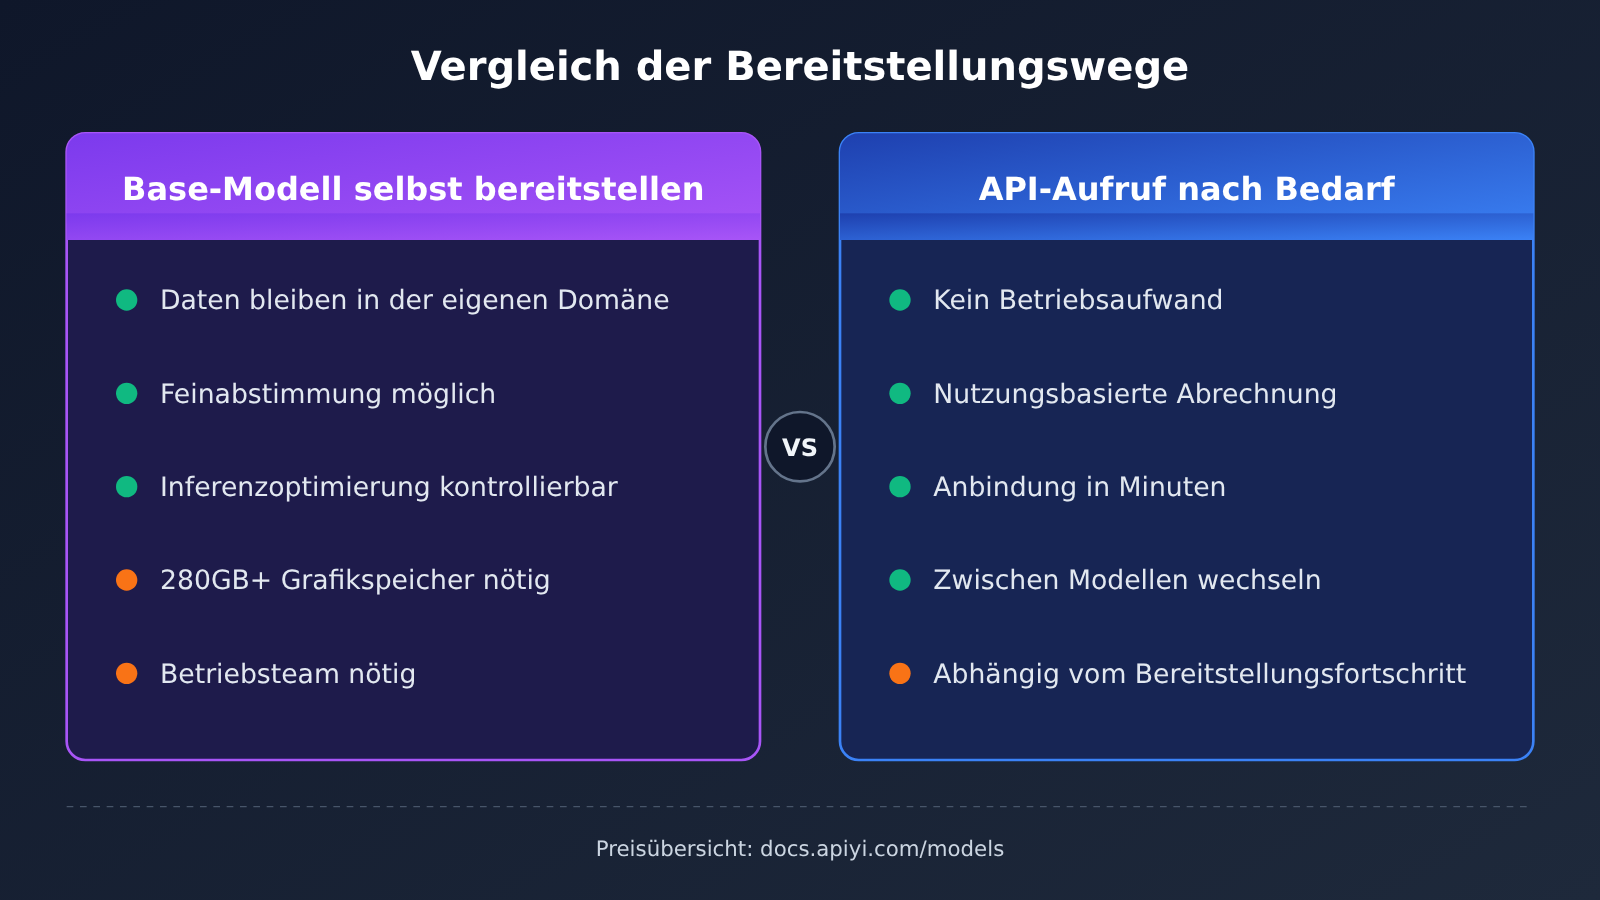
Die folgenden fünf Kriterien helfen dir einzuschätzen, welcher Weg für dein Team besser passt.
| Kriterium | Base selbst betreiben | API nach Bedarf nutzen |
|---|---|---|
| Einsatzzweck | Domänenspezifisches Weitertrainieren, SFT, RL oder wissenschaftliche Vergleichsexperimente | Anwendungen wie Frage-Antwort-Systeme, Schreib- oder Programmierassistenten direkt umsetzen |
| Daten-Compliance | Daten dürfen das interne Netzwerk nicht verlassen; privater Betrieb ist Pflicht | Daten dürfen in die Cloud; Compliance-Bedingungen des Anbieters sind akzeptabel |
| Aufrufvolumen | Dauerhaft hohe, stabile Last mit hoher GPU-Auslastung | Stark schwankender Traffic oder begrenzte tägliche Aufrufzahl |
| Teamkompetenz | Engineering-Team für Training, Inferenz und Betrieb vorhanden | Schwerpunkt auf Anwendungsentwicklung; kein eigener Clusterbetrieb gewünscht |
| Zeit bis zum Launch | Trainingsdauer von mehreren Wochen bis Monaten ist akzeptabel | Launch noch diese Woche erforderlich |
Zwei typische Nutzergruppen für 文心5.5 Flash Base
Teams, für die sich der Eigenbetrieb eignet: Dazu gehören etwa Teams aus Finanzwesen, Gesundheitswesen, Verwaltung und Unternehmen mit Anforderungen an den privaten Betrieb. Sie verfügen über umfangreiche Fachkorpora und möchten ein eigenes Modell trainieren. Für sie sind die Vortrainingsbasis von 文心5.5 Flash Base für Code und lange Kontexte sowie die KV-Cache-Einsparungen durch die HCA-Architektur interessant.
Teams, für die sich API-Aufrufe eignen: Dazu gehören etwa Anwendungsteams für SaaS, Content-Tools oder Kundenservice-Systeme. Sie benötigen vor allem einen stabilen, schnellen Dienst mit nutzungsabhängiger Abrechnung. Ein Base-Modell würde für sie zunächst den zusätzlichen Umweg über ein eigenes Training bedeuten. Sinnvoller ist es, mit einem ausgereiften Instruktionsmodell zu starten und sich auf das Produkt zu konzentrieren.
Beide Wege lassen sich parallel verfolgen
Viele Teams arbeiten im „Hybridmodus“: Im Produktivbetrieb nutzen sie eine API für stabile Ergebnisse und experimentieren intern mit den Base-Gewichten. Sobald das selbst trainierte Modell auf dem Evaluierungsdatensatz die API-Baseline übertrifft, leiten sie den Traffic schrittweise um. Das minimiert das Risiko und bietet zugleich einen klaren Vergleichsmaßstab für die eigene Entwicklung.
💡 Entscheidungshilfe: Wenn du noch unsicher bist, rechne zunächst nach: Multipliziere das geschätzte monatliche Aufrufvolumen mit den Stückpreisen auf der APIYI-Preisseite und vergleiche die monatlichen Kosten mit GPU-Miete oder Abschreibung. Ein einwöchiger Test im kleinen Rahmen über die einheitliche Schnittstelle von APIYI apiyi.com liefert den tatsächlichen Token-Verbrauch – und damit eine deutlich genauere Entscheidungsgrundlage als eine Schätzung nach Gefühl.
Häufige Fragen (FAQ)
F1: Was ist 文心5.5 Flash Base?
文心5.5 Flash Base ist ein Basismodell, das Baidu am 5. November 2026 als Open Source veröffentlicht hat. Es nutzt eine sparsame MoE-Architektur, verfügt über insgesamt 280B Parameter und aktiviert pro Token 14B Parameter. Das Modell wurde von Grund auf mit 33,5 Billionen Tokens vortrainiert. Veröffentlicht wurden die Gewichte am Ende des Vortrainings. Sie sind vor allem für das weitere Training gedacht, nicht für direkte Dialoge.
F2: Was unterscheidet 文心5.5 Flash Base von DeepSeek-V4-Flash-Base?
Beide Modelle sind ähnlich groß; DeepSeek-V4-Flash-Base hat 284B-A13B Parameter. Auch DeepSeek-V4-Flash-Base ist ein leistungsfähiges Basismodell. Laut den von Baidu veröffentlichten Tests liegt 文心5.5 Flash Base jedoch bei Reasoning, Code, Fachwissen und langen Kontexten vorn. Bei der Architektur setzt 文心 auf eine Kombination aus HCA und MLA für die Aufmerksamkeit sowie auf MoE mit mehreren Routern. Der Schwerpunkt liegt dabei auf der Komprimierung des KV-Cache und einer robusteren Weiterleitung.
F3: Wann erscheint die finale Version von 文心5.5 Flash?
Baidu zufolge soll die finale Version in Kürze erscheinen. Zum Zeitpunkt der Erstellung dieses Artikels am 6. November 2026 gab es jedoch noch kein konkretes Datum. Die finale Version soll auf dem Base-Modell aufbauen und ein nachgelagertes Training erhalten. Damit eignet sie sich besser für die direkte Integration in Anwendungen.
F4: Für welche Einsatzbereiche eignet sich 文心5.5 Flash Base besonders?
Das Modell eignet sich vor allem für folgende Szenarien:
– **Training von Code-Modellen für ganze Repositories**: Das Vortraining umfasst bereits technische Daten wie Commits, PRs und CI-Korrekturen.
– **Fachmodelle für lange Dokumente**: etwa für das Verständnis langer Kontexte in Rechtsakten oder Research-Berichten. Feinabstimmung und Inferenz unterstützen 1M Tokens.
– **Forschung zu Trainingsmethoden**: als einheitlicher Ausgangspunkt, um die Wirkung verschiedener SFT- und RL-Strategien zu vergleichen.
F5: Lässt sich 文心5.5 Flash Base bereits über eine API aufrufen?
APIYI bietet dieses Modell derzeit noch nicht an; auch die übrigen Modelle der ERNIE-Reihe sind noch nicht verfügbar. Wir werden sie so bald wie möglich bereitstellen. Aktuell lassen sich über APIYI auf apiyi.com bereits verfügbare Modelle wie deepseek-v4.1-flash, kimi-k3.1-pro und claude-sonnet-5-5 aufrufen. Die Plattform ist mit den Schnittstellenformaten von OpenAI und Anthropic kompatibel. Die aktuellen Preise finden Sie unter docs.apiyi.com/models.
F6: Welche Einschränkungen gibt es beim eigenen Betrieb von 文心5.5 Flash Base?
Erstens ist der Bedarf an GPU-Speicher hoch: Selbst bei Verwendung von FP8-Gewichten benötigen allein die Gewichte rund 280 GB. Zweitens ist das Base-Modell nicht sofort einsatzbereit, sondern muss weitertrainiert werden. Drittens muss bei der Inferenz mit langen Kontexten weiterhin Speicherplatz für den KV-Cache reserviert werden. Fehlt dem Team Erfahrung mit Training und Betrieb, empfiehlt sich zunächst der Weg über eine API.
F7: Was können kleine und mittlere Teams mit 文心5.5 Flash Base machen?
Sie können Cloud-GPUs mieten, um die Fähigkeiten des Modells per FP8-Inferenz zu testen, oder es mit Methoden wie LoRA leichtgewichtig an ein Fachgebiet anpassen. Für Produktivlasten empfiehlt sich weiterhin eine API. Die mit APIYI auf apiyi.com ermittelte Leistungsbasis kann dabei als Vergleichsmaßstab für das selbst trainierte Modell dienen.
文心5.5 Flash Base: Das Wichtigste auf einen Blick
- Als Ausgangspunkt für das Training gedacht: Base hat kein Post-Training durchlaufen, eignet sich für Fine-Tuning und Forschung, aber nicht für direkte Dialoge.
- Rechenleistung nach aktiven, VRAM nach gesamten Parametern: Nur 14B Parameter sind aktiv, die FP8-Gewichte benötigen aber weiterhin rund 280 GB VRAM.
- Langer Kontext braucht weniger Cache: 37 HCA-Schichten zur Komprimierung und 6 MLA-DSA-Schichten verkleinern den KV-Cache erheblich.
- Solide Grundlage für Code und lange Texte: Geeignet für domänenspezifische Modelle, die Code auf Repository-Ebene und lange Dokumente verarbeiten.
- Das Ökosystem steht bereit: Das vLLM-Plugin und das SGLang Cookbook wurden gleichzeitig veröffentlicht und erleichtern den Einstieg in die Inferenz.
- Noch nicht per API verfügbar: Die 文心-Modellreihe ist bei APIYI derzeit noch nicht verfügbar. Mit bereits verfügbaren Modellen lässt sich aber schon eine Baseline für die Anwendung aufbauen.
Fazit
Die wichtigsten Kriterien bei der Wahl von 文心5.5 Flash Base:
- Zuerst den Zweck klären: Wer ein Modell trainieren möchte, wählt das selbst gehostete Base-Modell. Wer ein Modell nutzen möchte, greift zu einer API oder wartet auf die offizielle Version.
- Dann die Anforderungen prüfen: Die Gewichte benötigen rund 280 GB VRAM in FP8 beziehungsweise 560 GB in BF16 – daran führt kein Weg vorbei.
- Zuletzt die Kosten vergleichen: Anhand des tatsächlichen Aufrufvolumens lassen sich die monatlichen API-Gebühren den GPU-Kosten gegenüberstellen. Ein hybrider Ansatz ist am wenigsten riskant.
Für die meisten Anwendungsteams ist es am sinnvollsten, die Anwendung zunächst über eine API zum Laufen zu bringen und parallel mit dem Open-Source-Base-Modell intern zu experimentieren. Über APIYI auf apiyi.com lässt sich mit bereits verfügbaren Modellen schnell eine Baseline aufbauen. Die Schnittstellendokumentation steht unter docs.apiyi.com, die aktuellen Preise unter docs.apiyi.com/models. Sobald die 文心-Modellreihe verfügbar ist, reicht eine Änderung des Modellnamens im selben Code für einen Vergleich.
📚 Referenzen
- QbitAI – Bericht zur Open-Source-Veröffentlichung von ERNIE 5.5 Flash Base durch Baidu: Überblick über die Veröffentlichung und Evaluation des Modells
- Link:
qbitai.com/2026/11/507787.html -
Hinweis: Enthält einen Vergleich mit Basismodellen gleicher Größe und eine Einführung in die Kerntechnologien
-
APIYI Dokumentationszentrum: Schnittstellenadressen und Anleitungen für OpenAI- und Anthropic-kompatible Aufrufe
- Link:
docs.apiyi.com -
Hinweis: Vor der Integration lesen; enthält Parameter und Beispiele
-
APIYI Modellpreisseite: Preise für Eingabe, Ausgabe und Cache der verfügbaren Modelle
- Link:
docs.apiyi.com/models - Hinweis: Für alle Preise in diesem Artikel gelten die aktuellen Angaben auf dieser Seite
Autor: APIYI Technikteam
Technischer Austausch: Kontaktieren Sie uns über die APIYI-Startseite apiyi.com. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.


