
Anmerkung des Autors: Ausgehend von der Aussage „Höhere persönliche Produktivität macht eine Organisation nicht automatisch stärker“ auf der Tencent Global Digital Ecosystem Conference beleuchtet dieser Beitrag fünf Mechanismen, die Teams für die Steuerung von Modellaufrufen brauchen.
Anfang November 2026 gab es auf der Tencent Global Digital Ecosystem Conference eine eigene Bühne für die Vorstellung von KI-Produkten. An zwei Tagen wurden dort mehr als 40 Produkte präsentiert. Eine Aussage verdient besondere Aufmerksamkeit: Höhere persönliche Produktivität macht eine Organisation nicht automatisch stärker. Dazwischen steht eine ganze Reihe organisatorischer Fähigkeiten. Sie stammt von Zhang Xiyao, stellvertretender Geschäftsführer von Tencent Cloud und verantwortlich für das Unternehmensprodukt WorkBuddy.
Dies ist keine weitere Nacherzählung einer Agent-Produktvorstellung. Stattdessen geht es um eine grundlegendere Frage: Wenn aus der individuellen KI-Nutzung eine Nutzung im Team wird, greifen alle auf dieselben Modellfunktionen zu. Wer welche Modelle aufrufen darf, wie viel jede Person nutzt und für welches Projekt Kosten anfallen – all das muss auf der Ebene der Modellaufrufe geregelt werden.
Das nehmen Sie mit: Eine Checkliste für die Einführung von KI im Team. Sie umfasst Modellanbindung, Schlüssel und Berechtigungen, Kostenzuordnung, Nachverfolgung von Aufrufen und die Weitergabe von Erfahrungen. Außerdem zeigt sie, welche Probleme ein einheitliches Gateway lösen kann – und welche nicht.
KI im Team: Die wichtigsten Fakten auf einen Blick
Zunächst zum Hintergrund der Diskussion. Alle Angaben in der folgenden Tabelle stammen aus der Berichterstattung von GeekPark über die Konferenz.
| Aspekt | Details |
|---|---|
| Veranstaltung | KI-Produktpräsentationen auf der Tencent Global Digital Ecosystem Conference: zwei Tage, sieben Themen und über 40 Produktvorstellungen |
| Zentrale Erkenntnis | Wenn Einzelne produktiver werden, wird nicht automatisch die Organisation stärker. Dafür braucht es eine Reihe organisatorischer Fähigkeiten. |
| Schwerpunkte des Enterprise-Upgrades | Eine offene Plattform verbindet Geschäftssysteme; Sicherheitslösungen für Unternehmen und ein Observability-Center helfen bei der Verwaltung von Berechtigungen, Ausführungsprozessen und Nutzungskosten; gehostete Agenten können rund um die Uhr laufen |
| Ergänzende Suite | Buddy One bietet ein einheitliches Konto, einen gemeinsamen Credit-Pool und zentrale Verwaltung. Ziel ist es, die Einrichtung und Einführung von KI im Unternehmen zu vereinfachen |
| Praxisbeispiel | Suning hat eine organisationsweite Agentenplattform aufgebaut. Sie umfasst 14 Abteilungen und 48 Zusammenarbeitsszenarien und stellt 36 wiederverwendbare Agenten bereit |
| Herausforderung bei der Skalierung | Benötigt jeder Agent eine eigene Ausführungsumgebung, könnten für 100.000 digitale Mitarbeitende auch 100.000 Sandboxen nötig sein |
Drei praktische Fragen zum KI-Einsatz im Team
Dem Bericht zufolge müssen Unternehmen bei der Einführung von Agenten drei Fragen beantworten: Können Agenten auf bestehende Systeme und die benötigten Daten zugreifen? Wie lassen sich die Berechtigungen verschiedener Mitarbeitender und Agenten verwalten? Und wie können andere eine gute Methode direkt nutzen, die eine Person erarbeitet hat? Diese Fragen betreffen alle Teams, die KI einführen möchten – unabhängig davon, wessen Produkte sie verwenden.
Bemerkenswert ist, dass beim Enterprise-Upgrade „Berechtigungen, Ausführungsprozesse und Nutzungskosten“ im selben Modul behandelt werden. Auch der gemeinsame Credit-Pool soll die Einführung vereinfachen. Das zeigt: Wenn KI vom persönlichen Werkzeug zur Teamressource wird, sind Zugriffskontrolle und Kostenzuordnung eine Frage der Infrastruktur – keine nachträgliche Ergänzung.
Warum die Modellaufruf-Schicht die erste Hürde für Teams beim KI-Einsatz ist
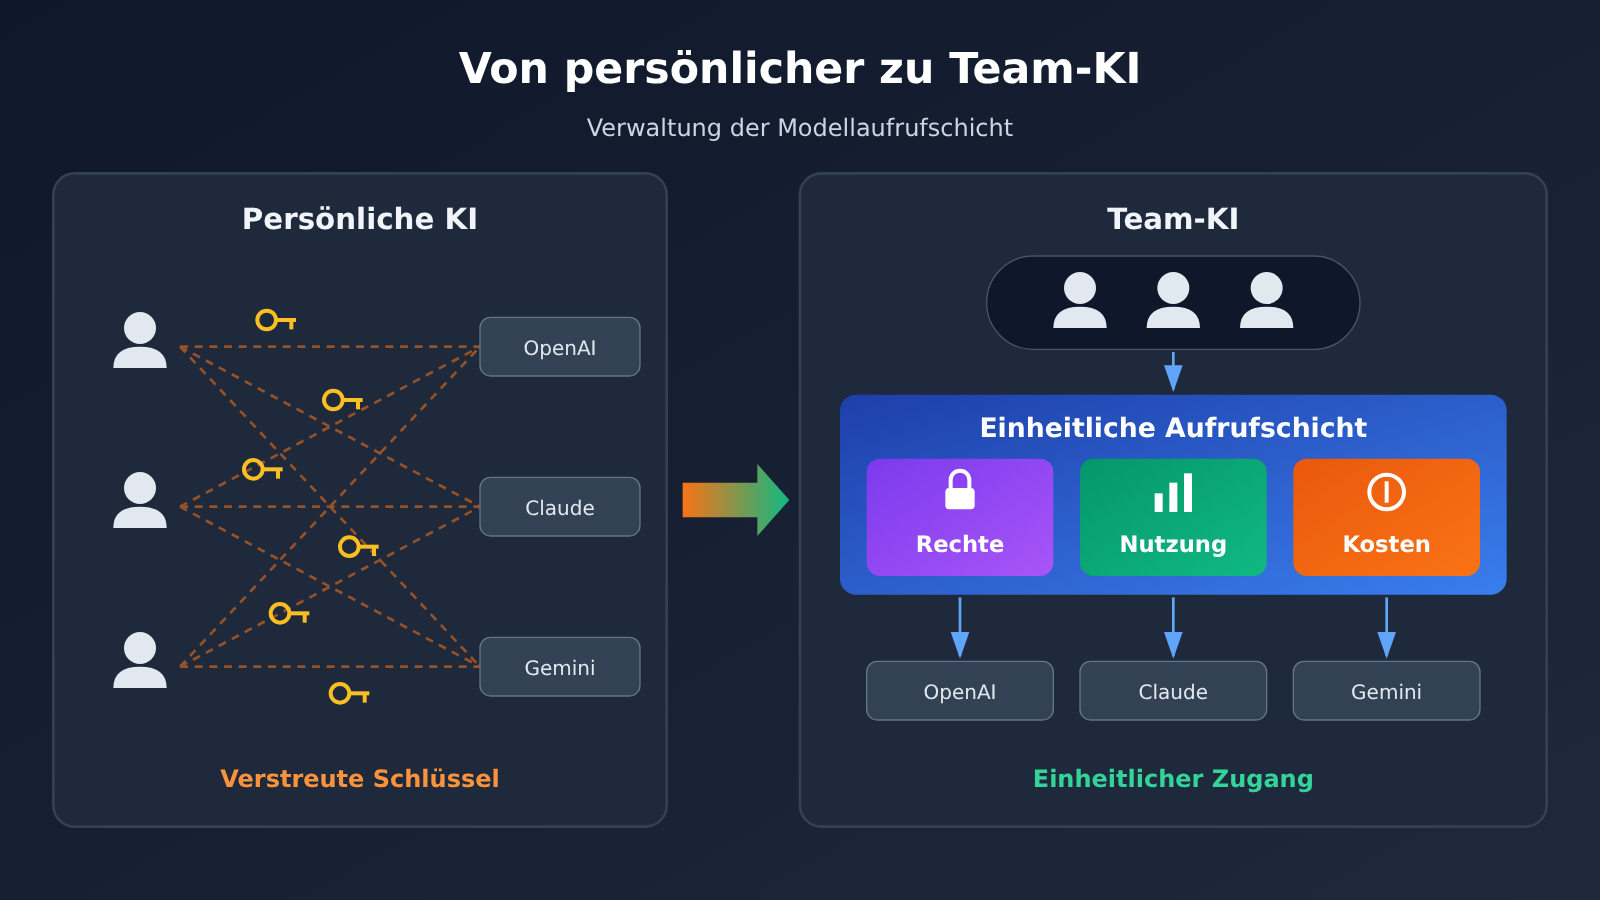
Wer KI allein nutzt, registriert sich typischerweise bei mehreren Modelldiensten, hinterlegt jeweils eine Kreditkarte, verwaltet die eigenen API-Schlüssel und schreibt die Aufrufadressen fest in Skripte oder Tools. Für die erste Erkundung ist das effizient. Sobald das Team wächst, häufen sich jedoch die Probleme.
API-Schlüssel liegen auf privaten Rechnern und in Chatverläufen verstreut. Wenn jemand das Unternehmen verlässt, weiß niemand genau, wie viele Schlüssel noch im Einsatz sind. Die Monatsrechnung zeigt nur den Gesamtbetrag – nicht, welches Projekt oder welche Person welche Kosten verursacht hat. Und wenn ein Modell plötzlich Fehler meldet oder teurer wird, müssen alle fest programmierten Aufrufe einzeln angepasst werden. Das hat nichts damit zu tun, wie leistungsfähig ein Agent ist. Das eigentliche Problem: Die Modellaufruf-Schicht wird nicht einheitlich verwaltet.
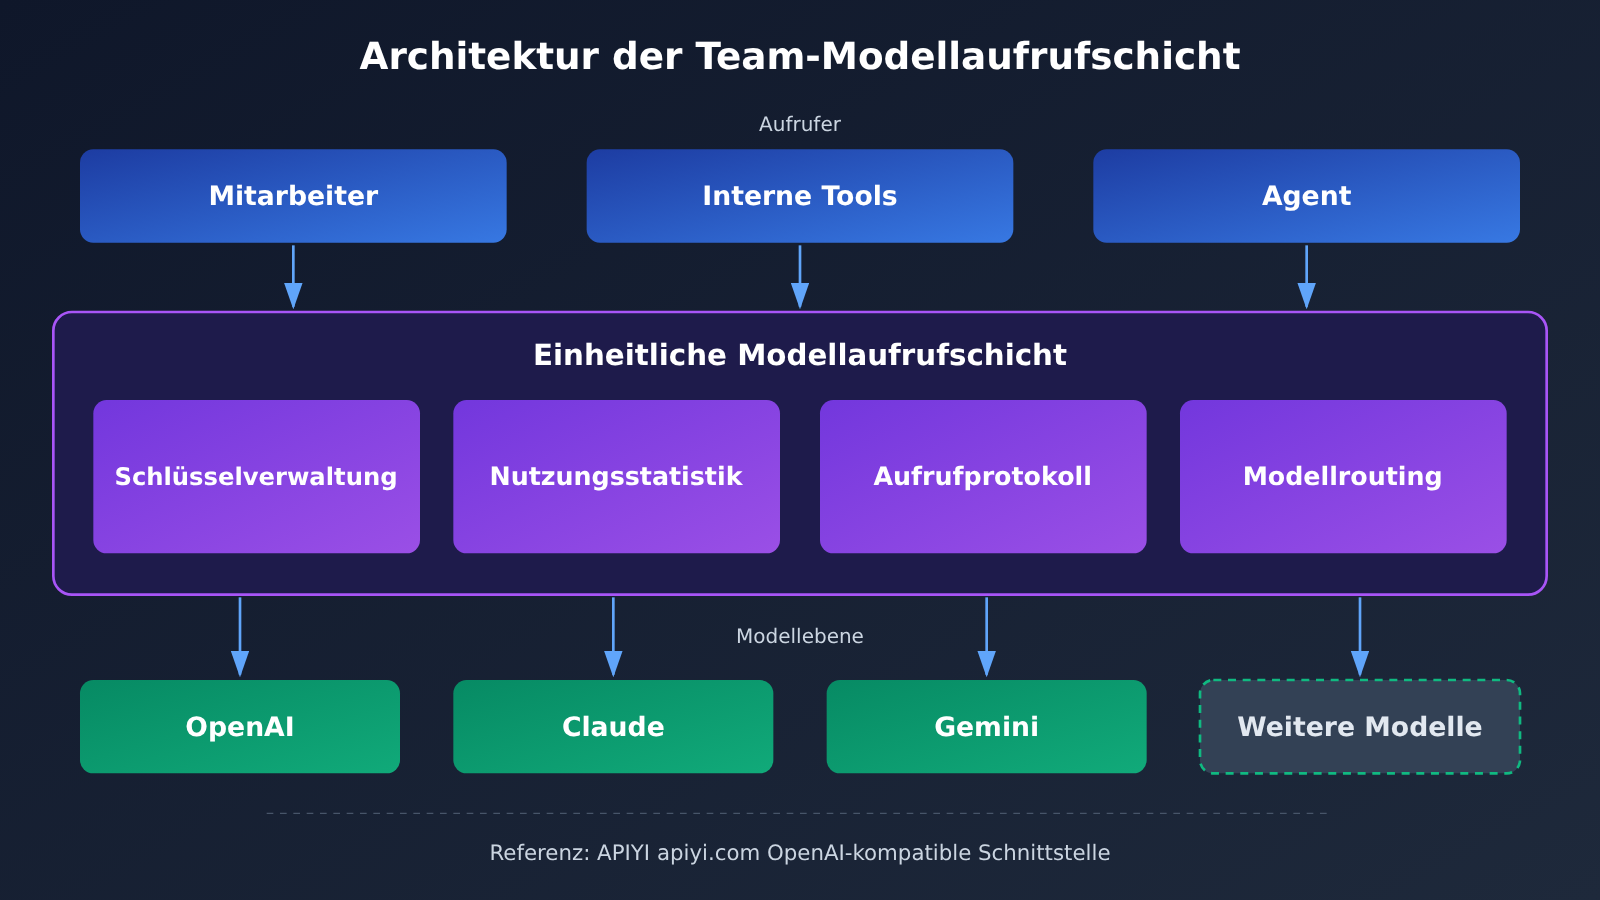
Erst wenn die Aufrufe über eine gemeinsame Schicht laufen, hat das Team eine zentrale Stelle, an der es Regeln durchsetzen kann. „Erst einmal richtig verwalten“ heißt dabei nicht, sofort komplexe Freigabeprozesse einzuführen. Entscheidend ist zunächst, dass alle Aufrufe denselben Eingang nutzen. Darauf lassen sich später die Verwaltung von Berechtigungen, Nutzung und Kosten aufbauen.
Fünf Punkte für die Modellaufruf-Ebene vor dem KI-Einsatz im Team
Diese Checkliste ist unabhängig von einzelnen Anbietern. Sie eignet sich zur Bewertung eines selbst betriebenen Gateways, einer Lösung vom Cloud-Anbieter oder einer Drittanbieter-Plattform zur Modellbündelung.
| Prüfpunkt | Zu beantwortende Frage | Mindestanforderung |
|---|---|---|
| 1. Modellanbindung | Welche Modelle braucht das Team? Wie viel Code muss bei einem Modellwechsel geändert werden? | Einheitlich eine OpenAI-kompatible Schnittstelle nutzen und den Modellnamen konfigurierbar machen |
| 2. Schlüssel und Berechtigungen | Wer besitzt die Schlüssel? Lassen sie sich bei einem Austritt oder einem Datenleck schnell widerrufen? | Schlüssel pro Projekt oder Dienst vergeben und persönliche Schlüssel im Produktionscode verbieten |
| 3. Kostenzuordnung | Wie viel gibt jedes Projekt und jedes Team aus? | Nutzung mindestens nach Schlüssel oder Projekt unterscheiden und monatlich eine detaillierte Abrechnung erstellen |
| 4. Nachverfolgung von Aufrufen | Lässt sich bei Problemen feststellen, welcher Aufruf und welches Modell betroffen waren? | Zeitpunkt der Anfrage, Modell, Token-Anzahl und Kennung des aufrufenden Dienstes protokollieren |
| 5. Wissen wiederverwenden | Können andere gute Eingabeaufforderungen und Abläufe direkt nutzen? | Erprobte Eingabeaufforderungen und Parameter als gemeinsame Vorlagen oder interne Dienste bereitstellen |
Prüfpunkte 1–2: Modellanbindung und Schlüsselberechtigungen
Bei der Modellanbindung kommt es auf Austauschbarkeit an. Verschiedene Modelle eignen sich für unterschiedliche Aufgaben, und auch Preise und Stabilität können sich ändern. Wenn der Anwendungscode nur von einer kompatiblen Schnittstelle abhängt und der Modellname in der Konfiguration steht, genügt für einen Modellwechsel eine Konfigurationsänderung. Eine Neuentwicklung ist nicht nötig.
Bei den Schlüsselberechtigungen ist entscheidend, dass sich Schlüssel widerrufen lassen. Eine sinnvolle Regel lautet: ein Schlüssel pro Dienst und ein Budget pro Projekt, statt eines gemeinsam genutzten Generalschlüssels für das ganze Team. Wird ein Schlüssel offengelegt, bleibt der Schaden auf diesen Dienst begrenzt. Nach dem Widerruf sind andere Anwendungen nicht betroffen.
Prüfpunkte 3–5: Kostenzuordnung, Aufrufverfolgung und Wissensweitergabe
Die Kostenzuordnung entscheidet mit darüber, ob die Fachbereiche die Investition in KI anerkennen. Ist nur die Gesamtrechnung sichtbar, lässt sich nicht beurteilen, welcher Anwendungsfall tatsächlich einen Mehrwert bringt. Auch ein Budgetantrag bei der Geschäftsleitung wird dadurch schwieriger. Die Aufrufverfolgung ist wiederum die Grundlage für die Fehlersuche: Meldet ein Nutzer, dass die KI falsch geantwortet hat, muss sich feststellen lassen, welches Modell bei diesem Aufruf verwendet wurde und welche Eingabe es erhalten hat.
Wissen wiederzuverwenden entspricht dem Ansatz im Beispiel von Suning: Der Ablauf für Produkteinführungen wurde als Vorlage aufbereitet und die im Prozess entstandenen Dateien wurden in eine Wissensdatenbank aufgenommen. Dadurch sank die Vorbereitungszeit von 3 Arbeitstagen auf 4 Stunden. Die Methode blieb erhalten und konnte beim nächsten Mal direkt genutzt werden. Für die Modellaufruf-Ebene bedeutet das, erprobte Eingabeaufforderungen, Modellauswahl und Parameterkombinationen gemeinsam bereitzustellen, statt sie nur im Kopf einzelner Personen zu behalten.
Beispiel für einheitliche KI-Aufrufe im Team
Hier ein Minimalbeispiel: Das Modell wird über eine OpenAI-kompatible Schnittstelle aufgerufen. Der Modellname kommt aus einer Umgebungsvariable, sodass das Team zentral zu einem anderen Modell wechseln kann.
import os
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),      # Projektspezifischer Schlüssel
    base_url="https://api.apiyi.com/v1"          # Einheitliche Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model=os.getenv("DEFAULT_MODEL", "gpt-4o-mini"),
    messages=[{"role": "user", "content": "总结本周项目进展"}]
)
print(resp.choices[0].message.content)
Team-Wrapper mit Aufrufprotokoll anzeigen
import os
import time
import json
import openai

client = openai.OpenAI(
    api_key=os.getenv("TEAM_PROJECT_KEY"),
    base_url="https://api.apiyi.com/v1"  # Modelle mehrerer Anbieter mit einem Schlüssel aufrufen
)

def team_chat(prompt: str, project: str, caller: str,
              model: str = None, max_tokens: int = 1000) -> str:
    """Einheitlicher Aufruf für das Team: Projekt, Aufrufer, Modell und Token-Verbrauch protokollieren"""
    model = model or os.getenv("DEFAULT_MODEL", "gpt-4o-mini")
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=max_tokens,
    )
    usage = resp.usage
    record = {
        "ts": int(start),
        "project": project,
        "caller": caller,
        "model": model,
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "latency_ms": int((time.time() - start) * 1000),
    }
    # In ein lokales Protokoll schreiben; später für Kostenberichte nach Projekt importieren
    with open("ai_usage.log", "a", encoding="utf-8") as f:
        f.write(json.dumps(record, ensure_ascii=False) + "\n")
    return resp.choices[0].message.content

print(team_chat("生成一份周报大纲", project="marketing", caller="alice"))
Dieser Wrapper ergänzt auf Anwendungsseite die beiden Angaben „Projekt“ und „Aufrufer“. Selbst wenn die Plattform bereits Nutzungsstatistiken bietet, sind eigene Aufrufprotokolle wertvoll: Nur Ihre Anwendung weiß, zu welchem Geschäftsszenario ein Aufruf gehört.
🚀 Schnellstart: Falls im Team noch jede Person eigene Schlüssel verwendet, können Sie über APIYI auf apiyi.com zunächst mit einem API-Schlüssel auf gängige Modelle wie OpenAI, Claude und Gemini zugreifen. Die Plattform bietet eine OpenAI-kompatible Schnittstelle und rechnet nach Verbrauch ab. Neue Nutzer erhalten ein kostenloses Testguthaben – ideal, um einen einheitlichen Aufruf zunächst auszuprobieren.
Was eine einheitliche Modellaufrufschicht lösen kann – und was nicht
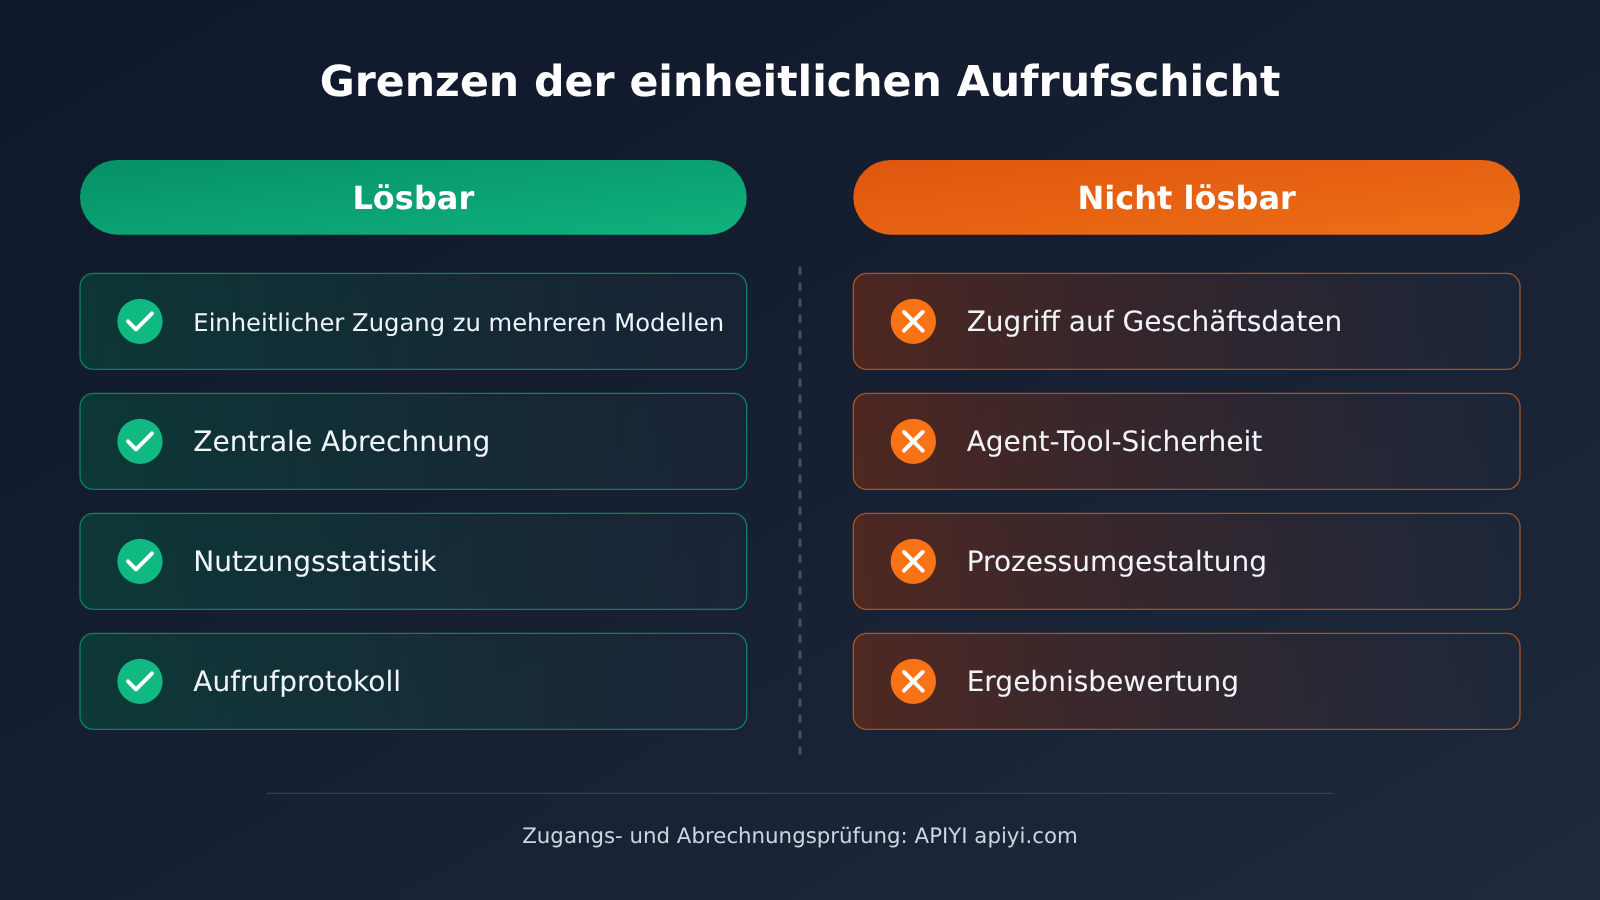
Viele Teams betrachten ein einheitliches Gateway als die „Gesamtlösung für die KI-Governance“. Tatsächlich deckt es nur die Ebene der Modellaufrufe ab. Die folgende Tabelle zeigt die Grenzen.
| Dimension | Was die einheitliche Aufrufschicht leisten kann | Wofür andere Komponenten zuständig bleiben |
|---|---|---|
| Modellzugang | Modelle verschiedener Anbieter über eine Schnittstelle aufrufen und mit geringem Aufwand wechseln | Entscheiden, welches Modell für welchen Anwendungsfall geeignet ist |
| Kosten | Guthaben und nutzungsabhängige Abrechnung zentral verwalten und zusammenfassen | Kosten mit dem Geschäftsergebnis verknüpfen und den ROI bewerten |
| Berechtigungen | Steuern, „wer Modelle aufrufen darf“ | Steuern, „welche Daten ein Agent lesen und welche Aktionen er ausführen darf“ |
| Nachverfolgung | Modell, Token und Zeit auf Aufrufebene protokollieren | Den gesamten Ausführungsablauf eines Agenten und die Qualität seiner Ergebnisse nachverfolgen |
| Wiederverwendung | Einen stabilen Zugang für Modellaufrufe bereitstellen | Eingabeaufforderungen, Prozessvorlagen und Wissensdatenbanken aufbauen und pflegen |
Das erklärt auch, warum Tencent auf der Konferenz gleichzeitig eine Sicherheitslösung, ein Observability Center, eine Agent Runtime und Wissensprodukte vorgestellt hat. Dem Bericht zufolge können Agenten eigenständig Tools aufrufen, auf Daten zugreifen und sogar Code ausführen. Daher ist es wichtig, ihren Handlungsspielraum zu begrenzen, sensible Informationen zu schützen und bei Problemen die Ursache zurückverfolgen zu können. Das sind Aufgaben der Agent-Laufzeit- und der Datenebene, die ein Modell-Gateway nicht übernimmt.
Eine sinnvolle Reihenfolge ist daher: Zuerst die Modellaufrufschicht vereinheitlichen, damit Zugriffe und Ausgaben sichtbar werden. Darauf aufbauend folgen Datenberechtigungen, Agent-Sicherheit und die Anpassung von Prozessen. Ohne Transparenz auf der Basisebene lässt sich die darüberliegende Governance kaum umsetzen.
Auswirkungen des KI-Einsatzes im Team
Auswirkungen auf technische Verantwortliche
- Einen einheitlichen Zugang in der Architektur vorsehen: Bei neuen Projekten mit großen Sprachmodellen sollten offizielle Anbieteradressen nicht mehr direkt im Code hinterlegt werden. Stattdessen laufen alle Anfragen über eine im Team vereinbarte kompatible Schnittstelle.
- Schlüsselmanagement in den Betrieb aufnehmen: API-Schlüssel gehören wie Datenbankpasswörter in einen geregelten Verwaltungsprozess. Ausgabe, Rotation und Widerruf sollten dokumentiert werden.
- Logfelder frühzeitig planen: Projekt, aufrufende Instanz, Modell und Token-Verbrauch sollten sich mindestens miteinander verknüpfen lassen. Sonst wird die Abrechnung am Monatsende schwierig.
Auswirkungen auf Geschäftsverantwortliche und Einkauf
Wenn Teams KI-Leistungen einkaufen, verschiebt sich der Fokus von „Welches Modell ist das stärkste?“ zu „Lässt es sich zuverlässig verwalten?“. Die folgende Tabelle zeigt, worauf es in den jeweiligen Teamphasen ankommt.
| Teamphase | Typische Situation | Priorität bei Modellaufrufen |
|---|---|---|
| Individuelles Erkunden | Wenige Personen testen auf eigene Kosten und besitzen jeweils eigene Schlüssel | Einheitliche Schnittstelle auswählen und verstreute Konten zusammenführen |
| Pilot im kleinen Team | Ein oder zwei Projekte beginnen, von KI abzuhängen | Schlüssel projektbezogen vergeben und grundlegende Nutzungsstatistiken einrichten |
| Einsatz in der Abteilung | Mehrere Geschäftsbereiche rufen gleichzeitig Modelle auf | Kosten nach Projekten zuordnen und Aufrufprotokolle durchsuchbar machen |
| Organisationsweiter Einsatz | Agenten übernehmen Aufgaben in zentralen Geschäftsprozessen | Datenberechtigungen, Agent-Sicherheit und Erfolgsmessung ergänzen |
Für den Einkauf ist außerdem wichtig, ob Zahlungs- und Belegprozesse den Finanzvorgaben des Unternehmens entsprechen. Auch die Granularität der Berechtigungen, Logfelder, Aufbewahrungsfristen und Exportmöglichkeiten spielen eine Rolle. Diese Details unterscheiden sich je nach Plattform deutlich. Daher empfiehlt es sich, sie vor Vertragsabschluss einzeln mit dem Anbieter zu klären und sich auf dessen offizielle Dokumentation zu stützen.
Auswirkungen auf die Branche
Auf der Konferenz stellte Buddy One einen gemeinsamen Credit-Pool und eine zentrale Verwaltung vor. Das zeigt, dass die einheitliche Verteilung von Modellkontingenten als gemeinsam genutzte Teamressource zunehmend zum Standard bei KI-Produkten für Unternehmen wird. Es ist absehbar, dass transparente Nutzung und zuordenbare Kosten für Geschäftskunden zur Grundanforderung werden – unabhängig davon, ob es sich um eine Suite eines großen Anbieters oder eine unabhängige Modellaggregationsplattform handelt.
💡 Empfehlung für die Auswahl: Vor dem breiten Einsatz lohnt sich ein kleiner Pilot mit echten Geschäftsdaten. Über APIYI apiyi.com kannst du Modelle verschiedener Anbieter aufrufen und ihre Ergebnisse sowie ihren Token-Verbrauch bei derselben Aufgabe vergleichen. Anschließend kannst du das Standardmodell für dein Team festlegen.
Häufig gestellte Fragen (FAQ)
Q1: Was bedeutet „Governance der Modellaufruf-Schicht“ beim Einsatz von KI im Team?
Damit ist die einheitliche Verwaltung des Zugriffs auf große Sprachmodelle gemeint: Welche Modelle werden genutzt, wer besitzt die API-Schlüssel, wie viel verbraucht jedes Projekt und lässt sich jeder Aufruf nachvollziehen? Die Schicht ist nicht für die Geschäftslogik der Agenten zuständig. Sie sorgt dafür, dass alle Aufrufe über einen verwaltbaren Zugang laufen.
Q2: Was unterscheidet eine einheitliche Modellaufruf-Schicht von einer Agentenplattform für Unternehmen?
Eine Agentenplattform für Unternehmen kümmert sich darum, wie Agenten Geschäftssysteme anbinden, auf Daten zugreifen, zusammenarbeiten und über längere Zeit laufen. Die Modellaufruf-Schicht konzentriert sich allein auf den Modellaufruf. Die Plattform deckt mehr ab, ist aber ebenfalls auf einen stabilen und kontrollierbaren Modellzugriff angewiesen. Beide ergänzen sich auf unterschiedlichen Ebenen, statt sich gegenseitig zu ersetzen.
Q3: Sollten sich kleine Teams schon jetzt darum kümmern?
Ja, allerdings reicht zunächst eine schlanke Lösung. Zwei Schritte lohnen sich besonders: eine einheitliche Schnittstelle für Modellaufrufe und keine persönlichen API-Schlüssel im Produktionscode. Beides lässt sich mit wenig Aufwand umsetzen. Nachträgliche Korrekturen sind deutlich mühsamer, wenn das Team erst einmal gewachsen ist.
Q4: Wie lässt sich schnell ein einheitlicher Zugang für Modellaufrufe im Team einrichten?
Eine einfache Möglichkeit ist eine OpenAI-kompatible Aggregationsplattform. Nach der Registrierung bei APIYI apiyi.com erhalten Sie beispielsweise einen API-Schlüssel. Ersetzen Sie im Code die base_url durch `https://api.apiyi.com/v1`, dann können Sie mit demselben Code Modelle von OpenAI, Claude, Gemini und anderen Anbietern aufrufen. Mit der in diesem Artikel vorgestellten Wrapper-Funktion lässt sich zusätzlich die Nutzung pro Projekt erfassen.
Q5: Kann eine Aggregationsplattform das Berechtigungssystem des Teams direkt ersetzen?
Nicht vollständig. Die Plattform kann den Modellzugriff und die Abrechnung verwalten. Wie detailliert sich Berechtigungen für Mitglieder und Projekte festlegen lassen und welche Obergrenzen und Aufbewahrungsrichtlinien für Logs gelten, unterscheidet sich jedoch je nach Plattform. Maßgeblich ist die jeweilige Dokumentation. Für Berechtigungen auf Geschäftsdaten und Agentenaktionen muss das Unternehmen selbst sorgen. Prüfen Sie die konkreten Funktionen vor der Planung im Dokumentationszentrum von APIYI apiyi.com.
Die wichtigsten Erkenntnisse zur Modellaufrufschicht für Teams
- Persönliche Produktivitätsgewinne machen noch keine stärkere Organisation: Wenn Teams Modellfähigkeiten gemeinsam nutzen, treten Managementfragen oft früher zutage als Grenzen der Modelle.
- Erst den Zugang vereinheitlichen, dann Regeln festlegen: Nur wenn alle Aufrufe über dieselbe Schicht laufen, lassen sich Berechtigungen und Kostenregeln einheitlich durchsetzen.
- Schlüssel projektbezogen vergeben: Ein Schlüssel pro Dienst lässt sich bei einem Datenleck oder dem Ausscheiden einer Person schnell widerrufen.
- Kosten Projekten zuordnen: Ergänzt die Anwendung Projekt und aufrufende Stelle, lassen sich die Kosten am Monatsende abrechnen.
- Das Gateway hat Grenzen: Für Datenberechtigungen, Agent-Sicherheit und Prozessanpassungen sind andere Komponenten zuständig.
- Kostengünstig starten: Mit APIYI apiyi.com lassen sich mehrere Modelle über einen einzigen Schlüssel einheitlich anbinden und zunächst in einem Pilotprojekt erproben.
Fazit
Bei den Diskussionen über Unternehmens-Agenten auf der Tencent-Konferenz ging es vor allem darum, wie Organisationen diese Fähigkeiten nutzen können – nicht darum, wie leistungsfähig ein einzelner Agent ist. Für Verantwortliche, die KI im Team einführen möchten, ist die Modellaufrufschicht ein guter erster Ansatzpunkt. Gleichzeitig wird sie leicht übersehen:
- Modellanbindung austauschbar halten: Eine einheitliche kompatible Schnittstelle nutzen und den Modellnamen konfigurierbar machen.
- Berechtigungen und Kosten sichtbar machen: Schlüssel projektbezogen vergeben und die Nutzung zuordnen, damit Kosten nachvollziehbar bleiben.
- Erfahrungen wiederverwendbar machen: Erprobte Eingabeaufforderungen und Abläufe als gemeinsames Teamwissen festhalten.
Der Hype wird vorübergehen, doch diese Checkliste hilft Teams jeder Größe bei der Einführung von KI. Starten Sie am besten mit ein oder zwei konkreten Anwendungsfällen, richten Sie einen einheitlichen Zugang und die Nutzungsaufzeichnung ein und erweitern Sie den Einsatz anschließend schrittweise. Mit APIYI apiyi.com lässt sich die einheitliche Anbindung mehrerer Modelle schnell erproben. Die Plattform bietet ein kostenloses Testguthaben und nutzungsabhängige Abrechnung.
📚 Quellen
- GeekPark – Warum kann eine Einzelperson KI gut nutzen, ein Unternehmen aber nicht?: Bericht über Ankündigungen zu Unternehmens-Agenten auf der Tencent Global Digital Ecosystem Conference
- Link:
geekpark.net/news/373541 -
Inhalt: Informationen zum Upgrade der WorkBuddy Enterprise Edition, zu Buddy One, zum Fallbeispiel Suning und zur Agent Runtime
-
OpenAI-API-Dokumentation: Erläuterungen zur Chat-Completions-Schnittstelle und zum Feld
usage - Link:
platform.openai.com/docs - Inhalt: Hilft beim Verständnis der Anfragestruktur kompatibler Schnittstellen und der Token-Zählung
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die Startseite der APIYI-Website apiyi.com. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.


