
الخلاصة: تكلفة API لمقال بالذكاء الاصطناعي — احسب الاستدعاء أولًا، ثم الناتج النهائي
وفقًا للقطة الأسعار في هذا المقال، مع إدخال 10,000 توكن وإخراج 3,000 توكن، تبلغ التكلفة النظرية للتوليد الواحد نحو 0.0066~0.10 دولار. أما إنجاز مقال قابل للنشر فيتطلب أيضًا جمع تكاليف التعديلات والتحقق واستدعاءات الأدوات والتحرير البشري.
ما يستحق المقارنة فعلًا هو “تكلفة المقال الواحد المقبول”. يقارن هذا المقال بين 7 نماذج بحجم إدخال وإخراج متطابق، ثم يشرح كيف تغيّر القناة والتخزين المؤقت والاستدلال وجولات التعديل من الفاتورة النهائية.
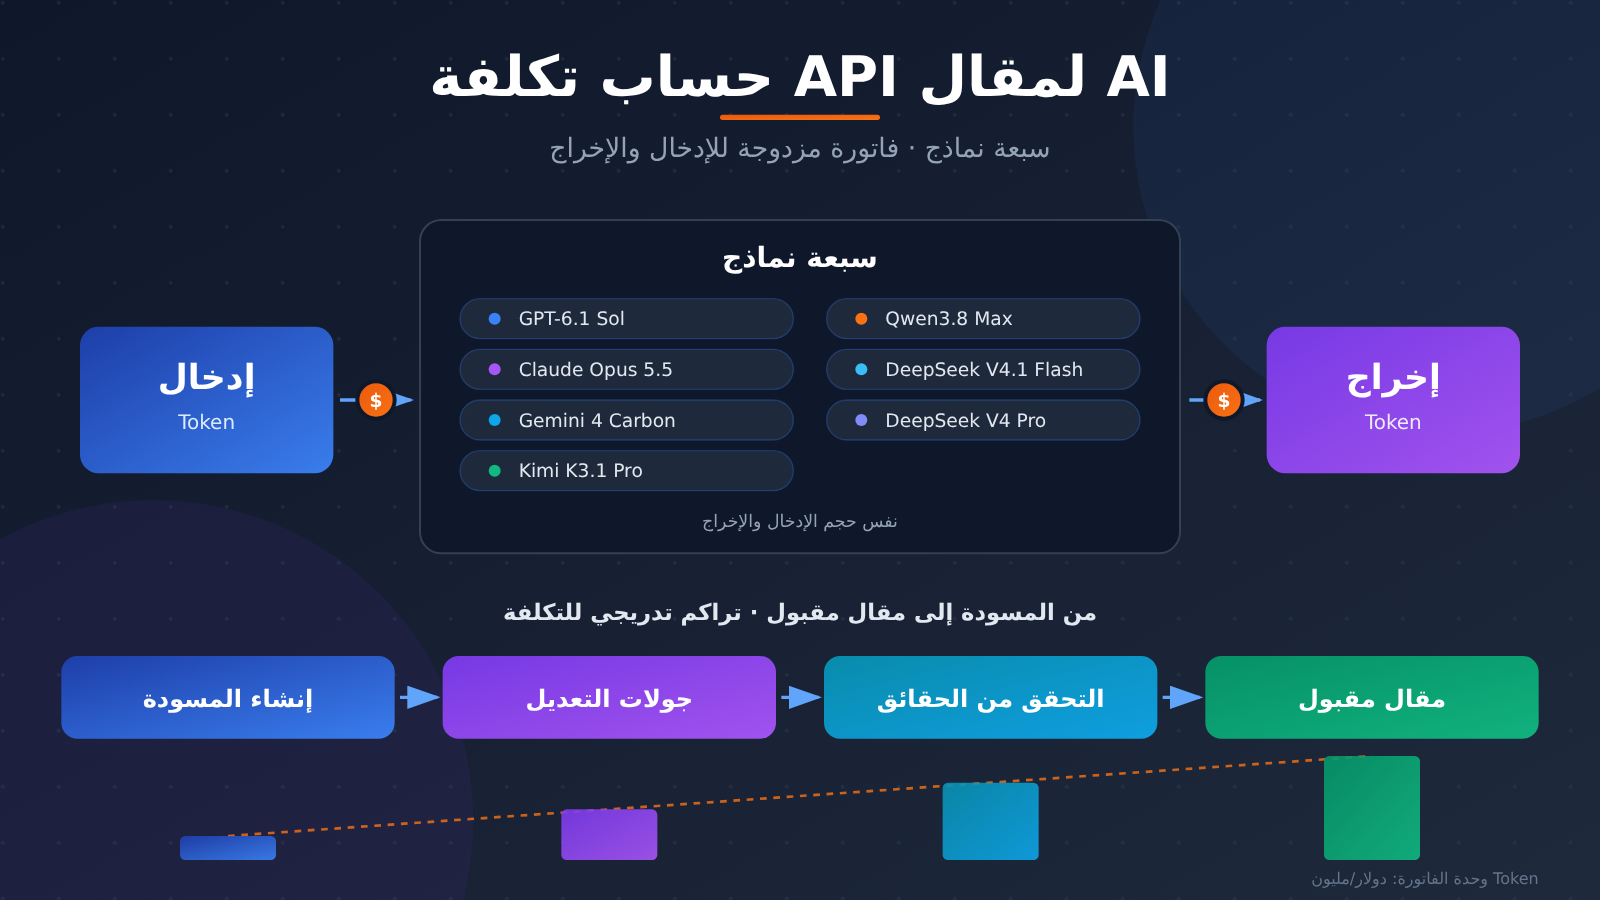
ما سيأتي لاحقًا: مسار حساب تكلفة API لمقال بالذكاء الاصطناعي
- فهم الإدخال والإخراج وصيغة الفوترة.
- مقارنة تكلفة 7 نماذج عبر ثلاثة أحجام مختلفة من المهام.
- التمييز بين سعر المنصة المعلن والسعر الرسمي حسب المنطقة وقواعد فترات الاستخدام.
- الاعتماد على سجلات الاستدعاء ووقت التحرير لتحديد خطة الإنتاج.
نصيحة للبدء السريع: يمكنك اختبار حزمة البيانات نفسها عبر الواجهة الموحدة لدى APIYI على apiyi.com. يحصل المستخدمون الجدد على رصيد تجريبي مجاني، وتُحدد الحصة الدقيقة وقواعد الاستخدام وفقًا للبيان الحالي للمنصة.
تكلفة API لمقالات الذكاء الاصطناعي: توحيد وحدة القياس أولاً
Token هي الوحدة التي تقيس بها واجهات API النص، وليست لها نسبة تحويل ثابتة مع عدد الأحرف الصينية. حزم المواد المرجعية، والموجهات، وتخطيط المقال، والمحادثات التاريخية التي تُرسلها، كلها تستهلك Tokens الإدخال.
عادةً ما تُعلَن أسعار الإدخال والإخراج بصيغة «دولار / مليون Token». جميع المحاكاة في هذا المقال تعتمد أسعار الوحدة العادية للإدخال والإخراج، مع استبعاد التخزين المؤقت والاستدلال الإضافي وخصومات الشراء بالحجم ورسوم الأدوات.
صيغة الحساب هي:
$$
C=\frac{T_{\text{الإدخال}}}{1{,}000{,}000}P_{\text{الإدخال}}
+\frac{T_{\text{الإخراج}}}{1{,}000{,}000}P_{\text{الإخراج}}
$$
وباستخدام GPT-6.1 Sol كمثال، مع إدخال 10,000 Token وإخراج 3,000 Token:
$$
C=0.01\times2+0.003\times10=0.05\text{دولار}
$$
هذا المبلغ يشتري لك عملية توليد واحدة. أما هل يمكن نشر المقال مباشرة، فيتوقف على مدى استيفائه للحقائق والبنية والأسلوب — فالفاتورة لن توقّع نيابة عن المحرر.
تكلفة API لمقالات الذكاء الاصطناعي: مقارنة أسعار الإدخال والإخراج لسبعة نماذج
يعتمد الجدول التالي على لمحة سعرية من APIYI على apiyi.com بتاريخ 12 نوفمبر 2026، الساعة 10:45 (UTC+8). جميع الوحدات بالدولار لكل مليون Token، ونمط الفوترة هو الدفع حسب عدد الـ Token المستخدمة.
| النموذج | سعر الإدخال | سعر الإخراج | نسبة سعر الإخراج إلى الإدخال |
|---|---|---|---|
| GPT-6.1 Sol | 2.00 | 10.00 | 5 أضعاف |
| Claude Opus 5.5 | 4.00 | 20.00 | 5 أضعاف |
| Gemini 4 Carbon | 2.00 | 10.00 | 5 أضعاف |
| Kimi K3.1 Pro | 2.00 | 10.00 | 5 أضعاف |
| Qwen3.8 Max | 1.65 | 4.95 | 3 أضعاف |
| DeepSeek V4.1 Flash | 0.30 | 1.20 | 4 أضعاف |
| DeepSeek V4 Pro | 1.32 | 3.96 | 3 أضعاف |
| بند المقارنة | ملاحظات الوصول |
|---|---|
| المنصات المتاحة | APIYI على apiyi.com؛ وواجهات API الرسمية للمزوّدين، مع الحاجة إلى التحقق من القواعد الإقليمية وقواعد الفوترة كلٌّ على حدة |
عادةً ما يكون سعر Token الإخراج أعلى، لكن عندما تكون حزمة المواد طويلة جدًا، تصبح تكلفة الإدخال أيضًا بندًا رئيسيًا في المصروفات. لذلك ينبغي عند اختيار النموذج النظر إلى عمودي السعر معًا، بدلًا من الاكتفاء بمراقبة طول المقال.
تكلفة API لمقالات الذكاء الاصطناعي: ما فروق الأسعار في الاتصال المباشر الرسمي؟
فيما يلي قواعد الاتصال المباشر الرسمية كما جرى الاستعلام عنها حتى 12 نوفمبر 2026، وهي للتحقق من فروق القنوات، ولا تُدرَج ضمن جدول أسعار المنصة أعلاه.
| النموذج / القناة | السعر أو القاعدة الرسمية |
|---|---|
| GPT-6.1 Sol، الفئة Standard | الإدخال 2، الإخراج 10 |
| Claude Opus 5.5، الاستدعاء القياسي | الإدخال 4، الإخراج 20 |
| Gemini 4 Carbon، الاستدعاء القياسي | من فترة التعريف حتى 30 نوفمبر: الإدخال 2، الإخراج 10؛ ومن 1 ديسمبر: الإدخال 4، الإخراج 20 |
| Qwen3.8 Max، بكين / فرجينيا الأمريكية Global | الإدخال 1.65، الإخراج 4.951 |
| Qwen3.8 Max، سنغافورة International | الإدخال 2، الإخراج 6 |
| Kimi K3.1 Pro، علي كلاود بكين / سنغافورة | 1.837/9.611 و2/10 على التوالي |
| DeepSeek، النموذجان | سعر وقت الذروة مطابق للأرقام في الجدول أعلاه، ويُنصَّف خارج وقت الذروة |
تعديل أسعار Gemini ينطبق على الاتصال المباشر الرسمي عبر Google، وينبغي للقنوات الخارجية مراجعة إعلاناتها الخاصة. كما ينبغي الحفاظ على سعر الإخراج 4.95 على منصة Qwen وسعر 4.951 في بعض المناطق الرسمية بشكل منفصل.
وقت الذروة الرسمي لدى DeepSeek هو أيام العمل بتوقيت بكين من 09:00 إلى 12:00 ومن 14:00 إلى 18:00، وتُعامَل بقية الأوقات وعطلة نهاية الأسبوع وفق قاعدة خارج وقت الذروة، وتُحسب العطلات الرسمية بشكل منفصل.
وبحسب سعر الوحدة الرسمي خارج وقت الذروة: يكون Flash عند الإدخال 0.15 والإخراج 0.60؛ وPro عند الإدخال 0.66 والإخراج 1.98. ويتوقف الربح من الجدولة على ما إذا كانت القناة الفعلية تطبق هذه القاعدة أم لا.
تكلفة API لمقالات الذكاء الاصطناعي: كيف تُحسب وفق حجم المواد والتعديلات على ثلاث جولات؟
لنقارن أولًا بين حجمي مواد. جميع الأرقام التالية محاكاة نظرية؛ إذ يمثل توكن الإخراج طول القياس لدى النموذج، لا عدد الأحرف الصينية.
| النموذج | إدخال 50 ألفًا + إخراج 5000 | إدخال 100 ألف + إخراج 10 آلاف | تراكم ثلاث جولات |
|---|---|---|---|
| GPT-6.1 Sol | 0.15000 | 0.30000 | 0.16200 |
| Claude Opus 5.5 | 0.30000 | 0.60000 | 0.32400 |
| Gemini 4 Carbon | 0.15000 | 0.30000 | 0.16200 |
| Kimi K3.1 Pro | 0.15000 | 0.30000 | 0.16200 |
| Qwen3.8 Max | 0.10725 | 0.21450 | 0.10395 |
| DeepSeek V4.1 Flash | 0.02100 | 0.04200 | 0.02160 |
| DeepSeek V4 Pro | 0.08580 | 0.17160 | 0.08316 |
الوحدة: دولار أمريكي. تستخدم الأعمدة الثلاثة لقطة أسعار المنصة المذكورة آنفًا، ولا تحتسب التخزين المؤقت أو أي رسوم أخرى.
لنأخذ مهمة GPT بإدخال 50 ألفًا وإخراج 5000 كمثال:
$$
C=0.05\times2+0.005\times10=0.15\text{دولار}
$$
حيث تبلغ تكلفة الإدخال 0.10 دولار، وتكلفة الإخراج 0.05 دولار. وفي المهام كثيفة المواد، غالبًا ما يستحق تنظيم مواد الإدخال أولوية أعلى من ضغط بضع فقرات من النص الأساسي.
تعتمد خانة «تراكم ثلاث جولات» على تدفق الاستدعاءات المستقل التالي:
- المسودة الأولى: إدخال 10000، إخراج 3000 توكن.
- التعديل: حزمة المواد + المسودة الأولى، إدخال 13000، إخراج 3000 توكن.
- النسخة النهائية: حزمة المواد + الإصدار السابق، إدخال 13000، إخراج 3000 توكن.
الإجمالي: إدخال 36000، إخراج 9000 توكن. والتكلفة المقابلة لدى GPT هي:
$$
C=0.036\times2+0.009\times10=0.162\text{دولار}
$$
وهي تعادل 3.24 ضعف تكلفة التوليد الأولى. يحتفظ هذا التدفق بالإصدار السابق فقط؛ وإذا أُرفق السجل الكامل في كل جولة، فستزداد كمية الإدخال أكثر.
الرسم التالي مناسب لعرض فروق التكلفة في المهمة نفسها؛ البيانات مستمدة من المعادلات أعلاه، وليست نتائج تقييم للجودة.
تكاليف API لمقالات الذكاء الاصطناعي: أربعة أنواع من النفقات التي يسهل تفويتها
تكاليف API لمقالات الذكاء الاصطناعي: رموز التفكير واستدعاء الأدوات
رموز التفكير هي محتوى الاستدلال الذي تنتجه بعض النماذج قبل توليد الإجابة. تصنّف Google رموز استدلال Gemini ضمن تكاليف الإخراج بشكل صريح، كما يضيف الاستدلال الإضافي في وضع Qwen Thinking تكلفة إضافية.
قد تُحتسب أدوات مثل البحث عبر الإنترنت واستخراج محتوى الصفحات رسومًا منفصلة. ينبغي تسجيل رموز النموذج وطلبات الأدوات كلًّا على حدة، مع الانتباه خصوصًا إلى أن طلب كتابة واحدًا قد يطلق عدة عمليات بحث.
تكاليف API لمقالات الذكاء الاصطناعي: التخزين المؤقت وBatch API
التخزين المؤقت للموجه يقلل جزءًا من تكاليف الإدخال عبر إعادة استخدام البادئة نفسها. وتحدد نسبة الإصابة ورسوم الكتابة ومدة الصلاحية مقدار ما يمكن توفيره في النهاية.
سعر الإدخال المخزّن مؤقتًا في GPT-6.1 Sol الرسمي هو 0.10؛ وفي Claude Opus 5.5 تبلغ قراءة التخزين المؤقت 0.20، بينما تبلغ كتابة التخزين المؤقت لمدة 5 دقائق ولمدة ساعة 5 و8 على الترتيب، وكل الوحدات بالدولار لكل مليون رمز.
يُستخدم Batch API للمعالجة غير المتزامنة بالدفعات. يحصل إدخال وإخراج Batch الرسمي في Claude على خصم 50%؛ كما تتغير أسعار Batch الرسمية في Gemini مع تعديل الأسعار القياسية في 1 ديسمبر.
يجب التحقق من هذه القواعد وفق قناة الوصول. فمثلًا لا يدعم Kimi K3.1 Pro على Alibaba Cloud خاصية Batch Inference؛ وفي Qwen Beijing تبلغ قيمة Batch File 0.825/2.475، بحد أقصى للسياق يبلغ 256K.
الطريقة الأساسية بسيطة: تُقيّم حزم المواد المستقرة وفق أولوية التخزين المؤقت، ثم تُقيّم المهام غير العاجلة التسليم عبر Batch، مع إدراج كتابة التخزين المؤقت في الحساب الإجمالي.
تكلفة API لمقالات الذكاء الاصطناعي: تسجيل Token الفعلي عبر الكود
تستخدم الأمثلة التالية واجهة متوافقة مع OpenAI. يُقرأ مفتاح API من متغير بيئة لتجنب كتابته مباشرة في الكود؛ ويعتمد توفر النموذج ودعم المعاملات على الوثائق الحالية.
استدعاء بسيط جدًا:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "解释输入和输出Token如何计费。"}],
)
print(response.choices[0].message.content)
مثال كامل لتقدير تكلفة Token العادية:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据提供的资料写作。"},
        {"role": "user", "content": "资料:输入输出分别计费。请写一段说明。"},
    ],
)

usage = response.usage
if usage is None:
    raise RuntimeError("响应未返回Token用量,请核对调用日志。")

input_tokens = usage.prompt_tokens
output_tokens = usage.completion_tokens
estimated_cost = (
    input_tokens * 2.0 + output_tokens * 10.0
) / 1_000_000

print(response.choices[0].message.content)
print(f"输入:{input_tokens},输出:{output_tokens}")
print(f"普通Token理论费用:${estimated_cost:.6f}")
يُستخدم هذا الكود لتقدير تكلفة Token العادية. أما تفاصيل التخزين المؤقت وقياس الاستدلال ورسوم الأدوات، فينبغي التحقق منها بالاشتراك مع حقول الاستخدام لدى مزود الخدمة وسجلات الفوترة.
تكلفة API لمقالات الذكاء الاصطناعي: توصيات حسب السيناريو ونصائح القرار
بالنسبة للمسودات الأولية العادية الحساسة للميزانية، يمكن البدء باختبار Flash وPro وQwen. أما المدونات المعقدة والمسودات المتعمقة، فيُدرج GPT وClaude وغيرهما ضمن المرشحين، ويُستخدم وقت التحرير للتحقق مما إذا كانت التكلفة الأعلى لكل وحدة تستحق ذلك.
في تصنيف AI Writing Benchmark الإنجليزي المحدث في 11 نوفمبر 2026، حصل GPT-6.1 Sol على درجة شاملة 95.3 ودرجة في فئة المقالات 98.5، وهما الدرجتان المعياريتان.
ويدعم التصنيف إدراج GPT في اختبار المدونات الإنجليزية. أما المسودات الصينية فلا تزال بحاجة إلى تحقق مستقل: اختبار المقالات المالية الطويلة في الفترة من 26 أكتوبر إلى 3 نوفمبر 2026 شمل 26 مقالًا فقط، وكانت العينة غير متوازنة، لذا يُناسب اعتباره مؤشرًا أوليًا لاختيار المرشحين.
يُنصح بتوحيد حزمة المواد والطول المستهدف وصلاحيات الأدوات، وإخفاء أسماء النماذج عند التقييم، وتسجيل الأخطاء الواقعية وعدد دورات التعديل ودقائق التحرير وحالة الاعتماد النهائية.
يمكن أن يعتمد الحساب النهائي على:
$$
C_{\text{مقال مقبول}}
=C_{\text{جميع استدعاءات API والتكاليف المرتبطة}}
+C_{\text{التحرير البشري}}
$$
يمكن حساب تكلفة العمالة بضرب تكلفة ساعة التحرير في الوقت الفعلي. وإذا تضمن التحقق استدعاءات API إضافية أو عملًا بشريًا، فينبغي إدراجه في البند المقابل لتجنب الحساب المزدوج.
الأسئلة الشائعة حول تكلفة API لمقالات الذكاء الاصطناعي: كيف نقارن 7 نماذج بإنصاف؟
عند تبديل النماذج عبر APIYI apiyi.com، حافظ على ثبات المواد ومتطلبات الكتابة وصلاحيات الأدوات. ومن خلال التوليد عدة مرات وتسجيل الاستخدام، يصبح من الأسهل ملاحظة الاستقرار وتكلفة التعديلات.
الأسئلة الشائعة حول تكلفة API لمقالات الذكاء الاصطناعي: هل يمكن للحصة المجانية أن تغني عن حساب التكلفة؟
الحصة المجانية للاختبار من APIYI apiyi.com مناسبة للتحقق من الواجهة وأسلوب الكتابة. أما الميزانية طويلة الأجل فينبغي أن تُحسب وفق السعر الحالي والاستهلاك الفعلي، وتُعامل الحصص المخفضة كبند منفصل.
ختام: تكلفة API لمقالات الذكاء الاصطناعي، نقطة الارتكاز هي كفاءة الإنتاج
جدول أسعار الوحدات يُستخدم للفرز والتصفية، وسجل الاستدعاءات يُستخدم للحساب، وسجل التحرير يُستخدم لاتخاذ القرار. وضغط المواد وإعادة استخدام ذاكرة التخزين المؤقت وتقليل إعادة العمل قد تكون كلها أكثر فاعلية من مطاردة أقل سعر للإخراج.
يُنصح بالتحقق من النماذج المرشّحة عبر APIYI (apiyi.com)، ثم اختيار الحل الذي يسلّم مقالات مقبولة بشكل مستقر وبتكلفة إجمالية معقولة، بحيث يحتفظ المحرر بوقته للتحرير والحكم.
مراجع عن تكلفة API لمقالات الذكاء الاصطناعي
- أسعار النماذج ووثائق الواجهات من APIYI: help.apiyi.com. لقطة أسعار المنصة في هذا المقال بتاريخ 12 نوفمبر 2026.
- أسعار نماذج Alibaba Cloud: alibabacloud.com/help/en/model-studio/model-pricing. تُستخدم للتحقق من الأسعار الإقليمية.
- الإعلان الرسمي من Google Gemini: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
- AI Writing Benchmark: aiwritingbenchmark.com. يعتمد هذا المقال معايير التصنيف الإنجليزي بتاريخ 11 نوفمبر 2026.
- اختبار المقالات الطويلة المتعمقة بالصينية: omnitools.ai/evals/longform-writing. العينات وقيود المهام موضحة في متن المقال.
المؤلف: فريق المحتوى التقني في APIYI. نرحب بالتواصل عبر apiyi.com لتبادل الخبرات حول استدعاء النماذج وحساب تكلفة المقالات.


