
الملخص: تجيب هذه المقالة عن سؤال واحد: هل يستطيع GPT-6.2 Sol أن يستوعب استفسارات البيانات الواردة من مستخدمي الواجهة الأمامية، وما الأسئلة التي ما زالت بحاجة إلى تدقيق إضافي.
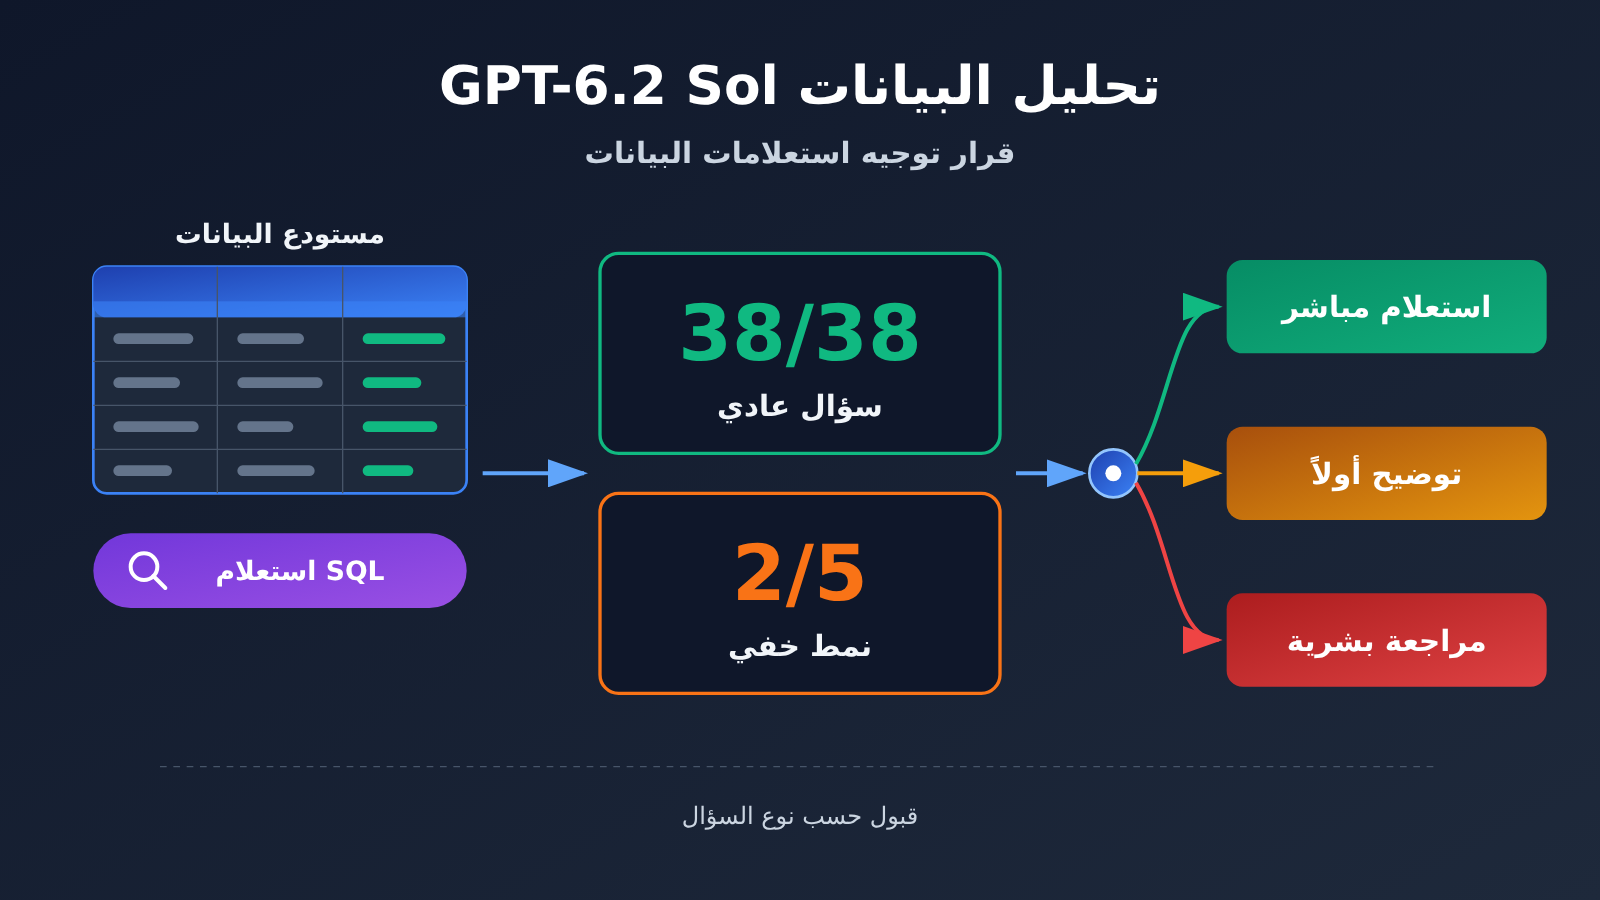
يمكن النظر إلى أداء GPT-6.2 Sol في تحليل البيانات على شقّين. في الاختبار التخصصي أحادي الجولة الذي نشرته Plotly في 17 نوفمبر 2026، أجاب إجابة صحيحة عن 38 سؤالًا من أصل 38 موزعة على خمس فئات: التحليل الاعتيادي، والحكم على الغموض، والأسئلة غير القابلة للإجابة من البيانات، وجودة البيانات، والمصائد الإحصائية، بمتوسط زمن بلغ نحو 10.5 ثانية للسؤال الواحد. وفي الجولة نفسها، لم يتجاوز سوى سؤالين من أصل 5 أسئلة تخصّ الأنماط الخفية.
بناءً على ذلك يمكن الوصول إلى الاستنتاج التالي: الاستفسارات التجميعية ذات التعريف الواضح والأثر المحدود يمكن تجريبها بإسناد الإجابة المباشرة فيها إلى Sol ضمن صلاحيات القراءة فقط؛ وعند غياب التعريف الواضح نبدأ بطلب التوضيح منه؛ أما الإسناد المفتوح والقرارات الموجهة للخارج فتُترك لمراجعة المحلل. ويستند هذا الاستنتاج إلى ثلاثة شروط: أن الاختبار جرى في جولة واحدة فقط، وأن بنك الأسئلة مكوّن من أسئلة إنجليزية تحاكي شركة طاقة رياح، وأن التكاليف مصدرها قناة OpenRouter. وبعد الانتقال إلى بياناتك وقناتك الخاصة، ستحتاج إلى إعادة التحقق من الصحة حسب نوع السؤال.
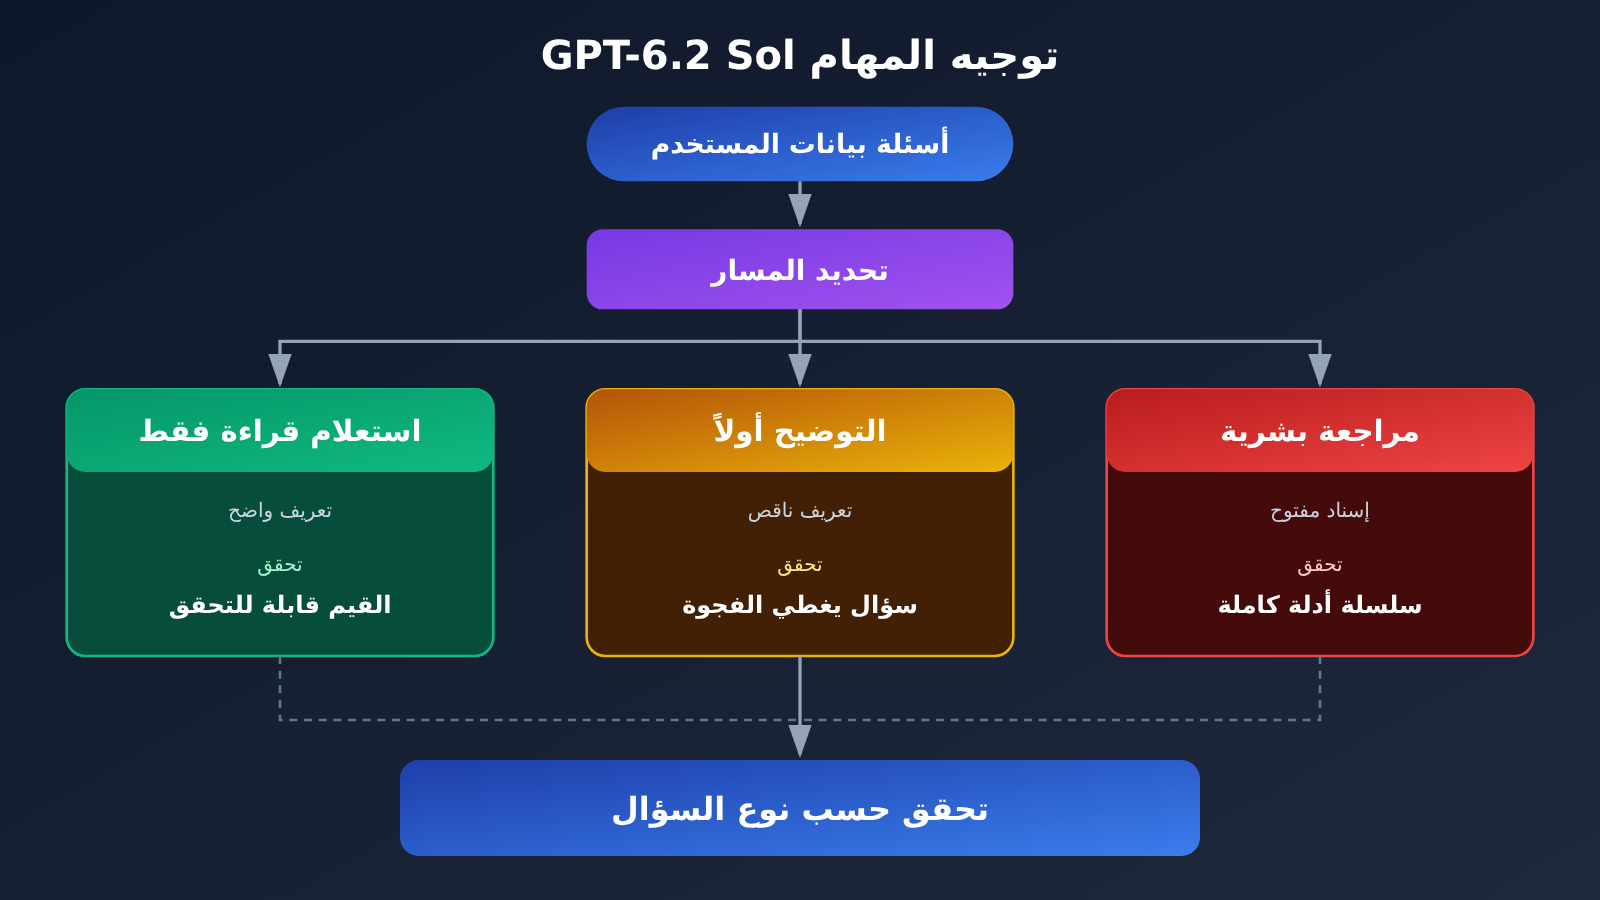
خريطة معرفة تحليل البيانات في GPT-6.2 Sol وفهرس القراءة
يوضح الشكل التالي منطق توزيع المهام في المقال بأكمله. لكل فرع شروط الإدخال، والمخرجات التي ينبغي أن يقدمها النموذج، ورقم هذا الفرع في المتن.
يطرح المستخدم سؤالًا متعلقًا بالبيانات
 │
 ├─ تعريف المقياس واضح + ملخص قليل الأثر ──→ [1] Sol استعلام بيانات للقراءة فقط
 │                              المخرجات: القيمة + البسط/المقام + النطاق الزمني والمنطقة الزمنية + جملة الاستعلام
 │
 ├─ تعريف المقياس مفقود / بيانات غير كافية ────→ [3.2] التوضيح أولًا
 │                              المخرجات: سؤال توضيحي محدد واحد + قائمة تعريفات مقياس بديلة
 │
 └─ إرجاع أسباب مفتوح / قرار موجه للخارج ──→ [3.3] إحالة إلى محلل للمراجعة
                                المخرجات: سجل فحص أولي + أدلة داعمة + فحص التفسيرات البديلة
            ↓
   [2] استخدام زمن الاستجابة وتكلفة السؤال الواحد لتقرير ما إذا كان يُعرض في الواجهة الأمامية
            ↓
   [4] التحقق على بياناتك الخاصة وفق نوع السؤال، وتسليم نتائج تحمل تاريخ البيانات وأدلة الاستعلام
يبين الجدول التالي ترتيب الأقسام والعلاقة بينها. القسم 3 يقع بالتوازي مع غيره ويمكن الرجوع إليه عند الحاجة، أما بقية الأقسام فيُستحسن قراءتها بالترتيب.
| رقم القسم | السؤال الذي يجيب عنه | ما يقدمه للقسم التالي | ما يمكنك فعله بعد قراءته |
|---|---|---|---|
| 1 | في أي أنواع الأسئلة يكون Sol مستقرًا | حدود أنواع الأسئلة: 38/38 و2/5 | تحديد النطاق الذي يمكن فيه طرح الأسئلة على البيانات مباشرة |
| 2 | هل يستحق عرضه في الواجهة الأمامية من حيث الجدوى | زمن الاستجابة وتكلفة السؤال الواحد وافتراضات التعميم | تقدير الميزانية وزمن الانتظار في السيناريوهات التفاعلية |
| 3 | ما المؤشرات التي تستدعي التوضيح أو الإحالة إلى شخص | ثلاث صور لفقدان الدرجات وثلاثة أمثلة للمخرجات | تصميم قواعد التوجيه |
| 4 | كيف تتحقق من النتائج على بياناتك الخاصة | مؤشرات وحدود مرتبطة بنوع السؤال | إنتاج مخرَج قابل للمراجعة |
للمعرفة: مصطلحات تحليل البيانات في GPT-6.2 Sol
| المصطلح | شرح موجز |
|---|---|
| مستودع البيانات | مجموعة بيانات تُجمَع فيها البيانات التاريخية المتناثرة من أنظمة الأعمال، وتُستخدم للاستعلام والتحليل |
| تعريف المؤشر | تعريف المؤشر وشروط التصفية والبسط والمقام وحدود الوقت |
| SQL للقراءة فقط | أسلوب استعلام يقوم بالبحث والتجميع فقط، مع بقاء صلاحية مصدر البيانات للقراءة فقط |
| سؤال النمط المخفي | تُزرع في البيانات اختلالات بنيوية مسبقًا، ولا يقدّم السؤال إلا أدلة، وعلى النموذج أن يجد النمط المحدد بنفسه |
| أدلة الاستعلام | عبارات الاستعلام وتعريف المؤشر والنتائج وتاريخ البيانات التي تتيح للآخرين مراجعة الاستنتاجات |
| زمن استجابة p50 / p95 | المدة التي يكتمل خلالها نصف الطلبات / المدة التي تكتمل خلالها 95% من الطلبات |
| المدخلات المخزنة مؤقتًا | مدخلات تعتبرها طبقة الفوترة الأعلى رموز إدخال قابلة لإعادة الاستخدام، وبسعر وحدة أقل بكثير من الإدخال العادي |
| التحقق حسب نوع السؤال | تقييم منفصل لأنواع أسئلة مثل الاستعلام عن البيانات وطلب التوضيح والامتناع عن الإجابة والاستكشاف، لتجنب أن يحجب مجموع الدرجات خطأً في نوع معين |
1. GPT-6.2 Sol لتحليل البيانات: لنبدأ بنتائج الاستعلام عن البيانات التي يمكن قبولها بثبات
1.1 ماذا اختبر Plotly؟
استخدم Plotly إطار اختبار Plotly Studio Embedded، واستدعى النموذج عبر OpenRouter، مع تفعيل أربع أدوات قراءة فقط: سرد مجموعات البيانات، وتنفيذ استعلامات SQL، والرسم البياني، وعرض الجداول. يحاكي مستودع الاختبار شركة طاقة رياح، ويضم نحو 19.90 مليون صف من البيانات و44 جدولًا و554 عمودًا. تم تقييم 43 سؤالًا بالإنجليزية سؤالًا بسؤال وفق مفتاح الإجابات وقواعد التقييم لتحديد النجاح أو الفشل. نموذج التقييم هو Claude Sonnet 5، وtemperature=0، وراجع الفريق يدويًا الأسئلة التي خسر فيها النقاط.
يقترب هذا الإعداد من الشكل الواقعي للاستعلام عن البيانات في BI المؤسسي: لا يرى النموذج البيانات كاملة، بل عليه أن يجد الجداول بنفسه، ويكتب SQL، ويقرأ النتائج ثم يجيب. تحتفظ Plotly بمجموعة الأسئلة ومفتاح الإجابات، ولا يمكن لجهة خارجية إعادة إنتاجها سؤالًا بسؤال، لذا ينبغي فهم الأرقام أدناه على أنها ملاحظة من جولة واحدة مع توضيح المنهج، لا كتصنيف مستقر.
| نوع السؤال | عدد الأسئلة | نتيجة GPT-6.2 Sol | الدلالة بالنسبة للأعمال |
|---|---|---|---|
| التحليل العادي | 20 | 20/20 | يمكن تجربة الإجابة المباشرة على التجميعات ذات المعايير الثابتة |
| اكتشاف الغموض | 5 | 5/5 | يستطيع إدراك أن السؤال نفسه قابل لأكثر من فهم |
| بيانات لا تدعم الإجابة | 5 | 5/5 | يرفض الإجابة عندما لا تدعم البيانات ذلك، بدلًا من اختراع الأرقام |
| جودة البيانات | 3 | 3/3 | يلاحظ مشكلات مثل القيم الناقصة والتكرار |
| المزالق الإحصائية | 5 | 5/5 | يتجنب القراءات الإحصائية الخاطئة الشائعة |
| الأنماط الخفية | 5 | 2/5 | ما زال العثور على الأنماط في الأسئلة المفتوحة يحتاج إلى تحقق بشري |
| الإجمالي | 43 | 40/43 | اجتاز الأسئلة الـ38 الأولى كلها، وكل النقاط المفقودة تركزت في أسئلة الاستكشاف |
ذكرت Plotly أيضًا أن نماذج أخرى شهدت عند إعادة التشغيل تذبذبًا يصل إلى ثلاثة أسئلة. الفرق بين 40/43 والدرجة الكاملة ثلاثة أسئلة فقط، وهو يقع تحديدًا ضمن نطاق هذا التذبذب. لذا فالأجدى بالاهتمام هو توزيع النقاط المفقودة: فقد تركزت كلها في أسئلة الأنماط الخفية، بينما لم يخطئ في أي سؤال من الفئات الخمس الأولى.
1.2 لماذا يمكن التحقق من الاستعلامات ذات المعايير الثابتة
لنأخذ تقرير ما بعد البيع مثالًا: يمكن قبول «معدل المرتجعات لكل مستودع خلال آخر 7 أيام» بثبات، بشرط أن تكون ثلاثة أمور قد حُددت مسبقًا: هل المقام هو الطلبات المستلمة أم كل الطلبات، وبأي منطقة زمنية يُقطع النطاق الزمني، وهل تستبعد شروط التصفية طلبات الاختبار والطلبات الداخلية. بمجرد كتابة هذه النقاط الثلاث في وثيقة المعايير، يمكن مقارنة SQL والنتائج التي يولّدها النموذج بندًا بندًا مع الاستعلام اليدوي.
يحوّل تثبيت المعايير سؤال «هل النموذج ذكي؟» إلى سؤال «هل الأرقام متطابقة؟»، وهذا الأخير قابل للمقارنة الآلية. وهذا أيضًا سبب اجتياز الأسئلة الـ38 كلها، وسبب أن هذا الاجتياز الكامل ذو معنى: فمعظم هذه الأسئلة لها إجابة معيارية وحيدة.
2. زمن الاستجابة والتكلفة في تحليل البيانات عبر GPT-6.2 Sol: هل نضعه في الواجهة الأمامية؟
2.1 مقارنة شاملة بين جيلي Sol
عندما يسأل المستخدم عن البيانات من الواجهة الأمامية، فإن زمن الانتظار يحدد تجربته مباشرة. يقدّم تقرير Plotly مقارنة بين GPT-6.2 Sol وGPT-6.1 Sol على المجموعة نفسها المكوّنة من 43 سؤالًا:
| المؤشر | GPT-6.1 Sol | GPT-6.2 Sol | التغيّر |
|---|---|---|---|
| تكلفة الدورة الكاملة | $2.61 | $1.22 | أقل بنحو 53.3% |
| الوسيط الزمني لكل سؤال | 17.6 ثانية | 10.5 ثانية | أقل بنحو 40.3% |
| عدد استدعاءات الأدوات | 258 | 158 | انخفاض واضح |
| عدد استدعاءات النموذج | 227 | 173 | انخفاض |
| حجم الإدخال | نحو 7.8 مليون tokens | نحو 4.6 مليون tokens | انخفاض |
| حجم الإخراج | نحو 70 ألف tokens | نحو 45 ألف tokens | انخفاض |
| نسبة الإدخال من الذاكرة المؤقتة | 94% | 97% | ارتفاع |
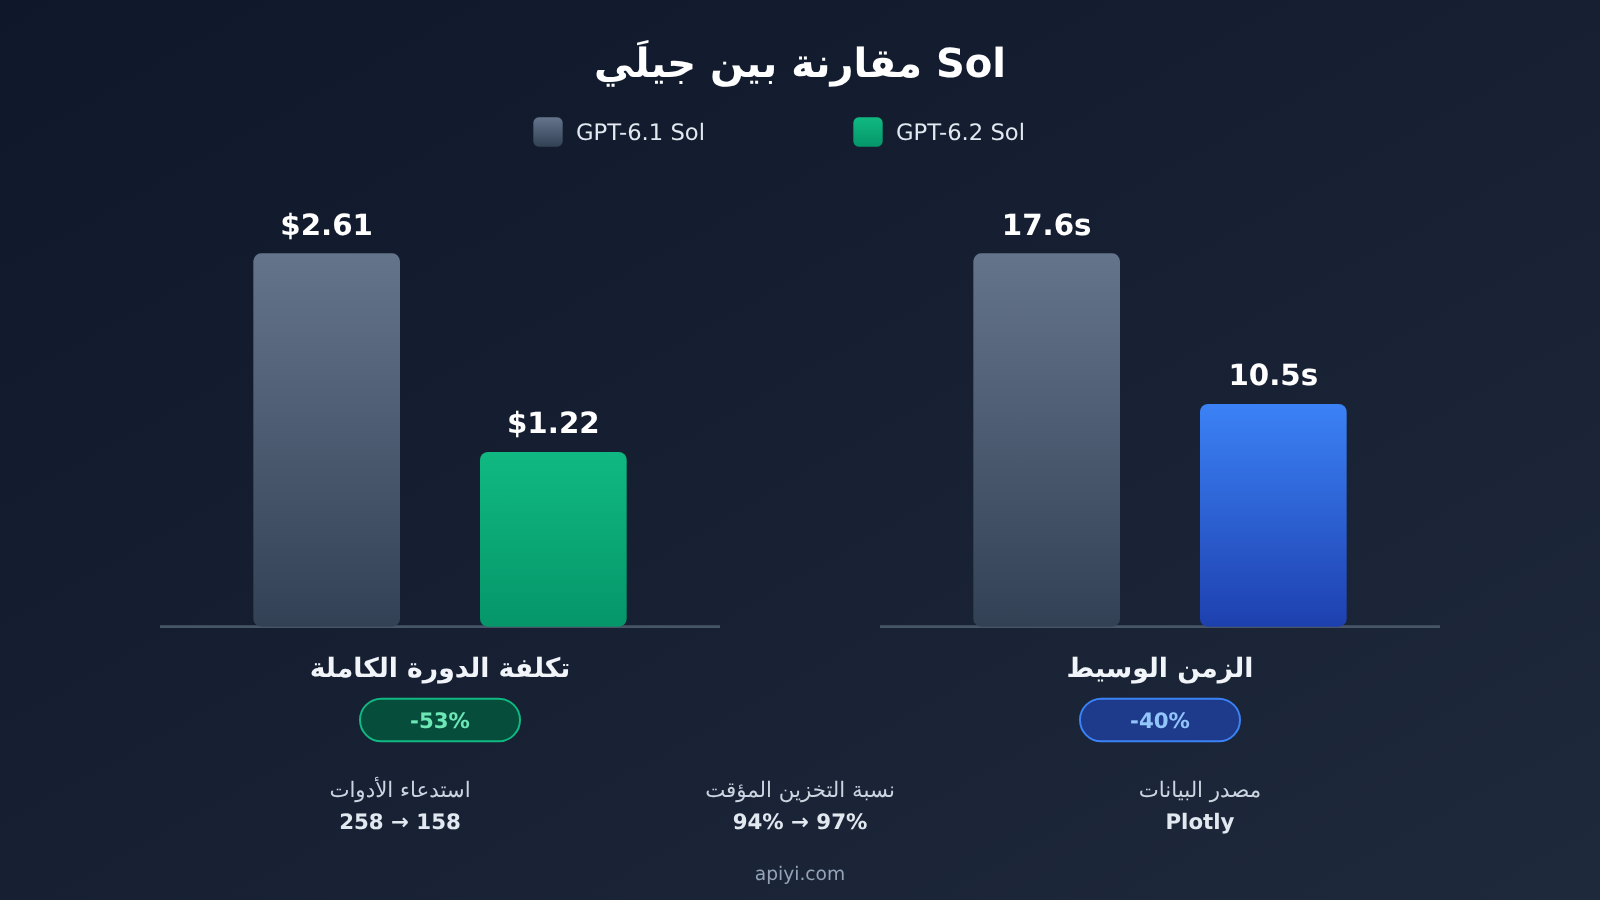
السعر الأساسي القياسي للسياق القصير متطابق بين جيلي Sol، لكن تكلفة الدورة الكاملة تقترب من النصف. الفرق ينبع من مسار المهمة نفسه: عدد أقل من دورات الاستدعاء، وحجم أقل من tokens القراءة والكتابة، ونسبة إصابة أعلى في الذاكرة المؤقتة. لذلك، عند تقييم تكلفة سيناريو تحليل البيانات، ينبغي أن تكون وحدة القياس هي «كم تكلّف إنجاز سؤال واحد»، أما سعر المليون token فليس إلا أحد العوامل.
2.2 الاستقراء والافتراضات: نحو 28.4 دولارًا لكل ألف سؤال
بقسمة التكلفة الإجمالية للجولة، وهي 1.22 دولار، على 43 سؤالًا، نحصل على متوسط يقارب 0.0284 دولار للسؤال، وبالاستقراء يصل إلى نحو 28.4 دولارًا لكل ألف سؤال. ولكي يكون هذا الرقم صحيحًا، يجب أن تتحقق الافتراضات التالية في الوقت نفسه:
- توزيع أنواع الأسئلة مطابق لتوزيع أسئلة Plotly الـ43، بحيث تشكّل الأسئلة الاستكشافية نحو 12% منها؛
- استخدام قناة OpenRouter نفسها وبأسعارها نفسها؛
- بقاء نسبة التخزين المؤقت عند نحو 97%، مع مشاركة الأسئلة نفسها لموجه النظام نفسه ووصف بنية الجدول نفسه؛
- تشغيل كل سؤال مرة واحدة فقط، دون أي إعادة محاولة.
وثمة رقم آخر على لوحة Plotly هو تكلفة السؤال الوسيطة البالغة 0.017 دولار، وهو إحصاء مختلف عن القيمة المتوسطة. فالأسئلة الاستكشافية تستدعي أدوات أكثر وتستغرق وقتًا أطول، ما يرفع المتوسط، بينما يكون الوسيط أقرب إلى تكلفة سؤال عادي عن البيانات. عند إعداد الميزانية، يمكن تقدير تكلفة الأسئلة اليومية باستخدام الوسيط، ثم إضافة جزء منفصل بحسب نسبة الأسئلة الاستكشافية.
أسعار OpenAI الرسمية لفئة السياق القصير Standard هي: الإدخال العادي 2.00 دولار، وقراءة التخزين المؤقت 0.10 دولار، والإخراج 10.00 دولارات (دولار أمريكي لكل مليون token، والإخراج يشمل tokens التفكير). وعندما يتجاوز إجمالي إدخال الطلب 272K، يُحوَّل الطلب بالكامل إلى فئة السياق الطويل. أما الأسعار المعلنة لواجهة APIYI apiyi.com فتتفق مع الأسعار الرسمية في الفئة القصيرة، وتكون في الفئة الطويلة: الإدخال 3 دولارات، وقراءة التخزين المؤقت 0.15 دولار، وكتابة التخزين المؤقت 3.75 دولار، والإخراج 11.25 دولار. وفي سيناريو الأسئلة عن البيانات، يكون الطلب الواحد عادةً أقل بكثير من 272K، ولا نحتاج إلى الانتباه إلى تبديل الفئة إلا عند إدخال كمية كبيرة من بنية الجداول أو النتائج التاريخية دفعة واحدة.
3. ثلاث فئات من المؤشرات في تحليل بيانات GPT-6.2 Sol: متى نطلب التوضيح ومتى نحوّل المهمة إلى إنسان
3.1 لماذا خسر النقاط في أسئلة الأنماط الخفية؟
في الأسئلة الـ38 التي لا تتضمن أنماطًا خفية، استدعى 6.2 Sol نحو 2.9 استدعاء أداة لكل سؤال في المتوسط، بينما استدعى 6.1 Sol نحو 4.3، وقد نجح كلاهما في جميع الأسئلة. أما في أسئلة الأنماط الخفية الخمسة، فيسجّل التقرير الخاص بـSol أن 6.2 Sol نفّذ نحو 9 استعلامات قاعدة بيانات في المتوسط، مقابل نحو 16 استعلامًا لـ6.1 Sol. (عند الاستشهاد في مقال لوحة Plotly العامة، استُخدم للإصدار السابق رقم نحو 18 استعلامًا، لكن هذا المقال يعتمد التقرير الخاص.)
بعد المراجعة اليدوية، كانت الأسئلة الثلاثة التي خسر فيها النقاط كالتالي:
- لم يفصل النمط المزروع في البيانات بشكل مستقل؛
- لم يحدد الكيانات المتأثرة تحديدًا؛
- لم يصل إلى الجزء من البيانات الذي يوجد فيه التأثير فعليًا.
تتشارك حالات الخسارة الثلاث في نقطة واحدة: توقّف الاستعلام عند المستوى السطحي. يمكن تدوين هذا كملاحظة: الإصدار الجديد يبحث بشكل أقل عمقًا في أسئلة الاستكشاف. أما علاقة السبب والنتيجة القائلة إن «قلة عدد الاستعلامات تؤدي إلى خسارة النقاط»، فتتطلب تجربة تتحكم في المتغيرات لتأكيدها. أما بالنسبة للأعمال، فالخلاصة واحدة: في أي سؤال إسناد يتطلب البحث النشط عن الأدلة، لا يمكن اعتبار الإجابة الأولى للنموذج نتيجة نهائية.
3.2 غياب تعريف المقياس: اسأل أولاً ثم أجب
في ما يلي نعرض ثلاثة أنواع من المخرجات باستخدام مجموعة بيانات افتراضية لتذاكر خدمة ما بعد البيع. تتكوّن مجموعة البيانات من أربعة جداول: الطلبات، والتذاكر، ودفعات المنتجات، والمستودعات. والمخرجات التالية أمثلة تصميمية وليست نتائج قياس فعلية.
الإجابة العادية (تعريف المقياس واضح). يسأل المستخدم: «اعرض معدل الإرجاع خلال آخر 7 أيام حسب المستودع». والمخرج المقبول لا يكتفي بقيمة كل مستودع، بل يحتفظ أيضاً بـ: البسط (عدد تذاكر الإرجاع الفعلي للبضائع)، والمقام (عدد الطلبات المستلمة في الفترة نفسها)، ونطاق التواريخ والمنطقة الزمنية (مثل توقيت بكين من 11-13 إلى 11-19)، وبُعد التجميع (المستودع)، مع إرفاق استعلام SQL الذي جرى تنفيذه.
السؤال عن تعريف المقياس أولاً (تعريف المقياس غائب). إذا اقتصر سؤال المستخدم على «كم بلغ معدل الإرجاع الأسبوع الماضي؟»، فعلى النموذج أن يستوضح أولاً: «هل يُحسب معدل الإرجاع على أساس طلبات استرداد المبلغ، أم على أساس البضائع المرتجعة فعلياً؟ فالفرق بينهما كبير في حالات استرداد المبلغ فقط.» ثم يعرض التعريفين ليختار المستخدم بينهما، ولا يُخرج أي رقم قبل أن يختار.
3.3 الإسناد المفتوح: التحويل إلى المحلّل
إذا سأل المستخدم: «تضاعف معدل الإرجاع في قناة معيّنة، ففي أي الدفعات يتركّز الشذوذ؟»، فقد دخلنا نطاق أسئلة الأنماط الخفية. يمكن للنموذج أن يجري فحصاً أولياً: التأكد من عدم وجود بيانات ناقصة، ومن كفاية حجم العينة الكلي، ثم التقسيم تباعاً حسب القناة والفئة والمستودع والدفعة. ويجب أن يحتفظ المخرج بدليل مؤيِّد واحد على الأقل، وفحص واحد لاستبعاد التفسيرات البديلة (مثل التأكد من أن حجم طلبات القناة في ذلك الأسبوع لم ينخفض انخفاضاً غير طبيعي، ما يستبعد أن يكون التضاعف ناتجاً عن صغر المقام).
وبعد إنجاز ذلك، ينبغي وسم المخرج بـ«بانتظار مراجعة المحلّل» لا بـ«استنتاج». ويمكن تلخيص قواعد التوجيه في جدول واحد:
| الدليل | الصيغة النموذجية للسؤال | المسار | مخرج النموذج | نقطة القبول |
|---|---|---|---|---|
| تعريف المقياس واضح والأثر منخفض | معدل الإرجاع خلال 7 أيام لكل مستودع | Sol للاستعلام عن البيانات للقراءة فقط | القيمة + تعريف المقياس + SQL | تطابق القيمة مع الاستعلام اليدوي |
| تعريف المقياس أو البيانات غير كافٍ | كم بلغ معدل الإرجاع الأسبوع الماضي؟ | الاستيضاح أولاً | سؤال استيضاح واحد + تعريفات مرشحة | أن يصيب السؤال موضع النقص |
| إسناد مفتوح وقرار موجّه للخارج | في أي الدفعات يتركّز الشذوذ؟ | التحويل إلى المحلّل للمراجعة | سجل الفحص + الأدلة المؤيدة + فحص التفسيرات البديلة | تغطية الأدلة، والإنذارات الكاذبة والحالات الفائتة |
4. التحقق من قدرات تحليل البيانات لدى GPT-6.2 Sol باستخدام بياناتك الخاصة
4.1 كود الاتصال والتوجيه
يمكن استدعاء gpt-6.2-sol عبر نقطتي النهاية Responses و Chat Completions، ويتم استدعاء الدوال والأدوات المدمجة عبر مسار Responses. لا تقبل أي من نقطتي النهاية مستوى الاستدلال none، لذا يجب التحقق من هذه المعلمة عند ترحيل الكود القديم. فيما يلي مثال بسيط لتصنيف التوجيه باستخدام Chat Completions:
import openai, json

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة OpenAI المتوافقة من APIYI
)

question = "上周退货率多少"
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[
        {"role": "system", "content": "把用户的数据问题分类为 direct / clarify / escalate,"
                                      "只返回 JSON:{\"route\":..., \"reason\":...}"},
        {"role": "user", "content": question},
    ],
)
print(json.loads(resp.choices[0].message.content))
عرض المثال الكامل لاستدعاء أداة SQL للقراءة فقط (Responses API)
import openai, json, sqlite3

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# افتح قاعدة البيانات في وضع القراءة فقط على مستوى قاعدة البيانات، وفحص التعبير النمطي هو مجرد ضمانة ثانية
conn = sqlite3.connect("file:aftersales.db?mode=ro", uri=True)

def run_readonly_sql(sql: str) -> str:
    head = sql.strip().lower()
    if not (head.startswith("select") or head.startswith("with")):
        return json.dumps({"error": "only read-only queries allowed"})
    rows = conn.execute(sql).fetchmany(200)
    return json.dumps({"rows": rows, "row_count": len(rows)}, default=str)

tools = [{
    "type": "function",
    "name": "run_readonly_sql",
    "description": "在售后数据仓库执行只读 SQL,返回最多 200 行",
    "parameters": {
        "type": "object",
        "properties": {"sql": {"type": "string"}},
        "required": ["sql"],
    },
}]

instructions = (
    "你是数据分析助手。回答必须包含:分子、分母、时间范围与时区、聚合维度、所执行的 SQL。"
    "口径不明确时先提问;涉及归因的结论标注为待分析师复核。"
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions=instructions,
    input="按仓库列过去 7 天的退货率",
    tools=tools,
)

# كرّر معالجة استدعاءات الأدوات حتى يقدم النموذج الإجابة النهائية
while True:
    calls = [o for o in resp.output if o.type == "function_call"]
    if not calls:
        break
    outputs = [{
        "type": "function_call_output",
        "call_id": c.call_id,
        "output": run_readonly_sql(json.loads(c.arguments)["sql"]),
    } for c in calls]
    resp = client.responses.create(
        model="gpt-6.2-sol",
        previous_response_id=resp.id,
        input=outputs,
        tools=tools,
    )

print(resp.output_text)
print("output_tokens:", resp.usage.output_tokens)
🚀 بداية سريعة: عند التحقق باستخدام عينات أعمالك الخاصة، يمكنك طلب حصة اختبار مجانية للمستخدمين الجدد عبر APIYI على apiyi.com. يمكن لمفتاح API واحد التبديل بين
gpt-6.2-solونماذج رئيسية أخرى، والمقارنة الأفقية على نفس مجموعة الأسئلة، مع الحفاظ على مصدر البيانات للقراءة فقط.
4.2 مؤشرات القبول حسب نوع السؤال
يُستحسن أن تغطي مجموعة أسئلة القبول المسارات الثلاثة الواردة في القسم 3، مع احتساب درجة منفصلة لكل نوع سؤال.
| نوع السؤال | المؤشر الرئيسي | طريقة الحكم | ما يُنصح بتسجيله |
|---|---|---|---|
| أسئلة عددية بتعريف ثابت | معدل صحة القيم الرقمية | مقارنة صفًا بصف مع نتائج SQL اليدوية | تكلفة السؤال الواحد، وزمن الاستجابة p50/p95 |
| تعريف المقياس مفقود | معدل ملاءمة الاستيضاح | هل يصيب سؤال المتابعة التعريف المفقود فعلاً | هل تحدث حالات «سؤال لا ينبغي طرحه» |
| أسئلة لا يمكن الإجابة عنها بالبيانات | معدل صحة الرفض | عدم اختلاق أرقام | عدد الإجابات الخاطئة |
| تحليل إسناد مفتوح | تغطية الأدلة، والإبلاغ الخاطئ والإغفال | هل الأدلة الداعمة + التفسيرات البديلة مكتملة | اتساق النتائج عند إعادة التشغيل عدة مرات |
لا يعرض تقرير Plotly سوى الوسيط الزمني، لذا يجب أن تضيف p95 في تقييمك الخاص. غالبًا ما تتأثر تجربة الواجهة بعدد قليل من الطلبات ذات الذيل الطويل، والأسئلة الاستكشافية أكثر عرضة للذيل الطويل. أما التكلفة، فاقرأ حجم الإخراج من usage.output_tokens؛ إذ تُدرج عادةً رموز الاستدلال في العنصر الفرعي output_tokens_details.reasoning_tokens، ثم اجمع ذلك مع حجم القراءة من الذاكرة المؤقتة لحساب التكلفة الفعلية لكل سؤال.
4.3 حدود العينات الصغيرة وإعادة التشغيل
الأنماط الخفية لدى Plotly لا تتجاوز 5 أسئلة، وفترة الثقة عند 2/5 واسعة جدًا؛ فإذا غيّرت دفعة الأسئلة فقد تصبح 1/5 أو 4/5. وعند إعادة تشغيل النماذج الأخرى ظهر تذبذب يصل إلى ثلاثة أسئلة كحد أقصى، لذا فإن اختلاف الدرجة الإجمالية في جولة واحدة لا يكفي لاتخاذ قرار اختيار النموذج. وعند التحقق بنفسك، أعد تشغيل أسئلة الاستكشاف لعدة جولات على الأقل، ووحّد خمسة متغيرات: لقطة البيانات، ومجموعة الأدوات، ومستوى استدلال النموذج، وقناة الاستدعاء، وجدول التقييم. وإذا تغيّر أي منها، فلا يمكن مقارنة النتائج قبل التغيير وبعده مباشرة.
💡 توصية للتحقق: القناة متغيّر يسهل إغفاله. تكلفة Plotly تأتي من OpenRouter، وقد تختلف قناة الإنتاج لديك في الفوترة وسياسة التخزين المؤقت. نوصي بإعادة التشغيل على APIYI apiyi.com باستخدام لقطة البيانات نفسها، وإعادة حساب تكلفة كل ألف سؤال بناءً على فاتورتك الفعلية، ثم تحديد حصة الواجهة الأمامية.
4.4 تسليم واحد قابل للتحقق
معيار اجتياز التحقق هو أن يتمكن شخص ثالث من مراجعة كل نتيجة استعلام بيانات بشكل مستقل. وفيما يلي شكل تسليم مؤهل (بيانات افتراضية):
question: 按仓库列过去 7 天的退货率
route: direct
data_snapshot: 2026-11-19 23:59 (Asia/Shanghai)
metric_definition:
  numerator: 实物退回工单数(status = returned)
  denominator: 同期已签收订单数(排除测试单、内部单)
  time_range: 2026-11-13 ~ 2026-11-19,北京时间
  group_by: warehouse_id
query: "SELECT w.warehouse_id, ... GROUP BY w.warehouse_id"
result: [{warehouse: 华东一仓, rate: 3.1%}, {warehouse: 华南二仓, rate: 2.4%}]
model: gpt-6.2-sol
cost_usd: 0.012
latency_s: 8.7
reviewer: 无需复核(固定口径问数)
يتضمن التسليم الواحد تاريخ البيانات وتعريف المقياس والاستعلام والنتيجة، وبذلك يمكن التحقق من GPT-6.2 Sol في مرحلة استعلام البيانات على الواجهة الأمامية. وأي مخرج يخلو من هذه العناصر لا ينبغي أن يدخل التقارير، حتى لو صادف أن الرقم صحيح. ولترسيخ هذه العملية على مستودعك الخاص، يمكنك البدء من واجهة APIYI apiyi.com المتوافقة مع OpenAI، وإطلاق استعلامات البيانات ذات التعريف الثابت أولاً، ثم التوسع تدريجيًا نحو التوضيح والإسناد.
المراجع
- Plotly – تقرير متخصص عن تحليل البيانات للنموذج GPT-6.2 Sol: النتائج التفصيلية للأسئلة الـ 43، ومقارنة التكلفة والوقت المستغرق
- الرابط:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- الرابط:
- Plotly – منهجية اختبار DataAnalyticsBench: تصميم أنواع الأسئلة، وقواعد التقييم، ومعايير إحصاء لوحة النتائج
- الرابط:
plotly.com/blog/introducing-dataanalyticsbench
- الرابط:
- OpenAI – بطاقة نموذج GPT-6.2 Sol: نافذة السياق، ونقاط النهاية المدعومة، وقواعد تسعير السياق الطويل
- الرابط:
developers.openai.com/api/docs/models/gpt-6.2-sol
- الرابط:
- OpenAI – تسعير API: أسعار الإدخال والذاكرة المؤقتة والإخراج في الفئة القياسية
- الرابط:
developers.openai.com/api/docs/pricing
- الرابط:
- واجهة التسعير العامة الخاصة بـ APIYI: تعبيرات التسعير للفئة القصيرة والفئة الطويلة للنموذج
gpt-6.2-sol- الرابط:
api.apiyi.com/api/pricing
- الرابط:
المؤلف: فريق APIYI التقني
التواصل التقني: مرحبًا بك للتواصل معنا عبر الصفحة الرئيسية لموقع APIYI الرسمي، والمزيد من مواد التكامل متاح في مركز التوثيق docs.apiyi.com


