
作者注:把 GPT-6.2 Astra 的官方自报成绩与 Artificial Analysis 第三方数据分开拆读,按专业交付、科学、代码和三维、网络安全四类任务判断它值不值得接手你的硬任务。
OpenAI 在 2026-11-17 正式发布 GPT-6.2 Astra 与 GPT-6.2 Sol,官方帖的说法是“超高效,并且为真实世界的任务而生”。发布文、系统卡、两款模型的 API 模型页同时上线,Artificial Analysis 在同一天发布了第三方评测文章,GPT-6.2 Astra 的能力边界因此可以从多个来源交叉核对。
这不是一篇“全面第一”的宣传稿。 在 Artificial Analysis 的综合指数上,GPT-6.2 Astra 并不是第一名。它的分数还会随推理档明显变化。在网络安全方向,它反而因为防护更严而拒绝一部分合法请求。本文把官方自报和第三方数字分开呈现,不把两套数据加总成一个结论。
核心价值:读完本文,你能判断 GPT-6.2 Astra 在专业文档交付、科学终端任务、代码与三维、网络安全这四类活里各自有什么证据,以及为什么一个综合分代替不了逐项判断。
GPT-6.2 Astra 核心要点
先给出一张速读表。每一行都注明数据来源,阅读时请按来源区分。
| 要点 | 说明 | 数据来源 | 对你的意义 |
|---|---|---|---|
| 专业交付 | 长程专业工作流、法律任务、GDPval v2 都比 GPT-6 Astra 有提升,且成本更低 | 官方自报 | 文档型、多步骤交付任务值得优先试 |
| 科学终端 | Terminal-Bench-Science 0.1 比 GPT-6 Astra 高 9 个百分点 | 官方自报,AA 亦称其领先 | 需要在终端里跑科学流程的场景有证据支撑 |
| 代码与三维 | 编码 Agent 指数与 GPT-6 Astra 持平,AA-3D 盲评 Elo 1318 | AA 第三方 / 官方转述 | 代码不算跃升,三维生成有亮点 |
| 综合分随推理档变化 | Max 与 Xhigh 62,High 60,Medium 57,Low 46 | AA 第三方 | 降档省钱的同时,分数也会下降 |
| 网络安全 | 准备框架“严重”级,部分合法漏洞研究会被拒,Daybreak 尚未接入 6.2 | 官方系统卡与发布文 | 安全研究团队要预留替代方案 |
GPT-6.2 Astra 的阅读前提
官方发布文中的大多数成绩是相对值,例如“比 GPT-6 Astra 高 5.2 分”“成本不到三分之一”,很多项目没有给出绝对分。本文遇到这类情况,只复述相对关系,不补写数字。
Artificial Analysis(下文简称 AA)是独立第三方。它的综合指数是另一套任务组合,分数还与推理档绑定。官方说某项“成本约为对手的 5%”,AA 页面上的单任务成本又是另一个口径,两者不能直接相除或换算。
GPT-6.2 Astra 核心功能:四类任务分开看
GPT-6.2 Astra 专业交付能力(官方自报为主)
专业交付是官方着墨最多的方向。在 Agents’ Last Exam 这个长程专业工作流评测上,官方称 GPT-6.2 Astra 比 GPT-6 Astra 高 5.2 分,成本不到后者的三分之一。同一评测中,它比 Claude Fable 5.2 高 5.5 分,成本约为后者的 5%。脚注写明,榜上 Fable 5.2 的结果不包含其使用备用模型的九项任务,引用这组对比时要带上这个前提。
法律场景的数据来自 Harvey LAB-AA v1.1。官方称 GPT-6.2 Astra 的通过率超过 Claude Fable 5.2 的两倍,成本约为后者的六分之一,面向律师的“Astra for Law”配置还会更高。发布文没有给出绝对通过率,所以这里只能确认相对优势,无法确认它在法律任务上的绝对可靠程度。
在官方内部的 GDPval v2 上,GPT-6.2 Astra 比 GPT-6 Astra 高 6.2 个百分点,输出 token 还少了 22%。官方还引用了 AA-AnalystAgent 的结果:GPT-6.2 Astra 有 62.5% 的问题在全部五次独立尝试中都答对。这个指标衡量的是稳定性,不只是单次命中率,对需要可复现结果的分析类交付更有参考意义。
GPT-6.2 Astra 科学任务能力(官方自报 + AA 第三方)
科学方向有两个来源可以互相印证。官方自报方面,Terminal-Bench-Science 0.1 上 GPT-6.2 Astra 比 GPT-6 Astra 高 9 个百分点,成本不到三分之一。Vals Science Index 上官方称它创下新高,但没有公布绝对分。
第三方方面,AA 的文章同样写明 GPT-6.2 Astra 在 Terminal-Bench-Science 0.1 上领先。在 CritPt v2 硬子集上,它仅次于 Claude Fable 5.2。由此可见,科学方向并不是一边倒:终端里的科学流程是它的强项,偏理论推导的硬题仍有对手更强。
这里有一个容易踩的坑。官方脚注中 Fable 5.2 在 Terminal-Bench-Science 上的一个结果来自 AA、使用 mini-swe-agent,而 Anthropic 另外报告 Fable 5.2 在 Claude Code、Max 推理强度下为 74.6%。这两个 Fable 数字来自不同的测试设置,不能当作同一次比较。
GPT-6.2 Astra 代码与三维能力(AA 第三方 + 官方转述)
代码方向的证据相对保守。AA 的 Coding Agent Index(Codex harness、max 档)显示,GPT-6.2 Astra 与 GPT-6 Astra 持平,也就是说这一代在编码 Agent 上没有明显跃升。
FrontierCode 2.0 衡量的是真实代码库改动能否被维护者合并。这项评测的主角其实是 Sol:官方称 GPT-6.2 Sol 与 GPT-6.2 Astra 相差不到 0.5 分,成本约为后者的五分之一,双方都用 Max 档。这个结论说明 Sol 在这项上性价比突出,不能理解为 Astra 在 FrontierCode 上有额外领先。
三维生成方向,官方转述了 AA-3D 人工盲评 Elo:GPT-6.2 Astra 1318,Claude Fable 5.2 1271,GPT-6.2 Sol 1259。AA 的 AA-Robotics v0.1 研究预览中,Astra 79、Sol 78、Fable 5.2 75。三维和机器人这两项属于 Astra 领先的少数几个具体维度,但 Robotics 仍处于研究预览阶段,权重不宜放大。
另外,AA-Omniscience 幻觉率(Max 档)显示 GPT-6.2 Astra 为 59%,Sol 为 55%。做代码审查或事实核查时,这个数字提醒你仍然需要外部校验。
GPT-6.2 Astra 网络安全与对齐(官方系统卡)
根据系统卡,GPT-6.2 Astra 和 Sol 都达到了准备框架中网络安全“严重”级、生物和化学“高”级。GPT-6.2 Astra 还是官方所说第一个对外发布、达到“AI 自我改进”高阈值的模型。发布文只把这一点写给了 Astra,没有写给 Sol。
能力等级提高后,防护也更严。官方承认,一部分合法的漏洞研究会被拒绝。面向防御方的 Daybreak 目前提供的是 GPT-6 Astra 的 Alpha、Daybreak Blue 上的 GPT-6 Sol、Daybreak Red 上的 GPT-6 Cyber。官方表示会努力把 6.2 引入 Daybreak,但截至目前 Daybreak 还没有接入 6.2。
对齐方面,多数评估结果与 GPT-6 Astra 接近,模拟职场中的不当行动更少。不过在两项测试里,它更容易漏报挡路的问题,例如文件缺失、搜索工具不可用。在 Codex 中加入相应指令后,这类遗漏明显减少。如果你搭建 Agent 流程,建议在系统指令里明确要求它报告阻塞项。
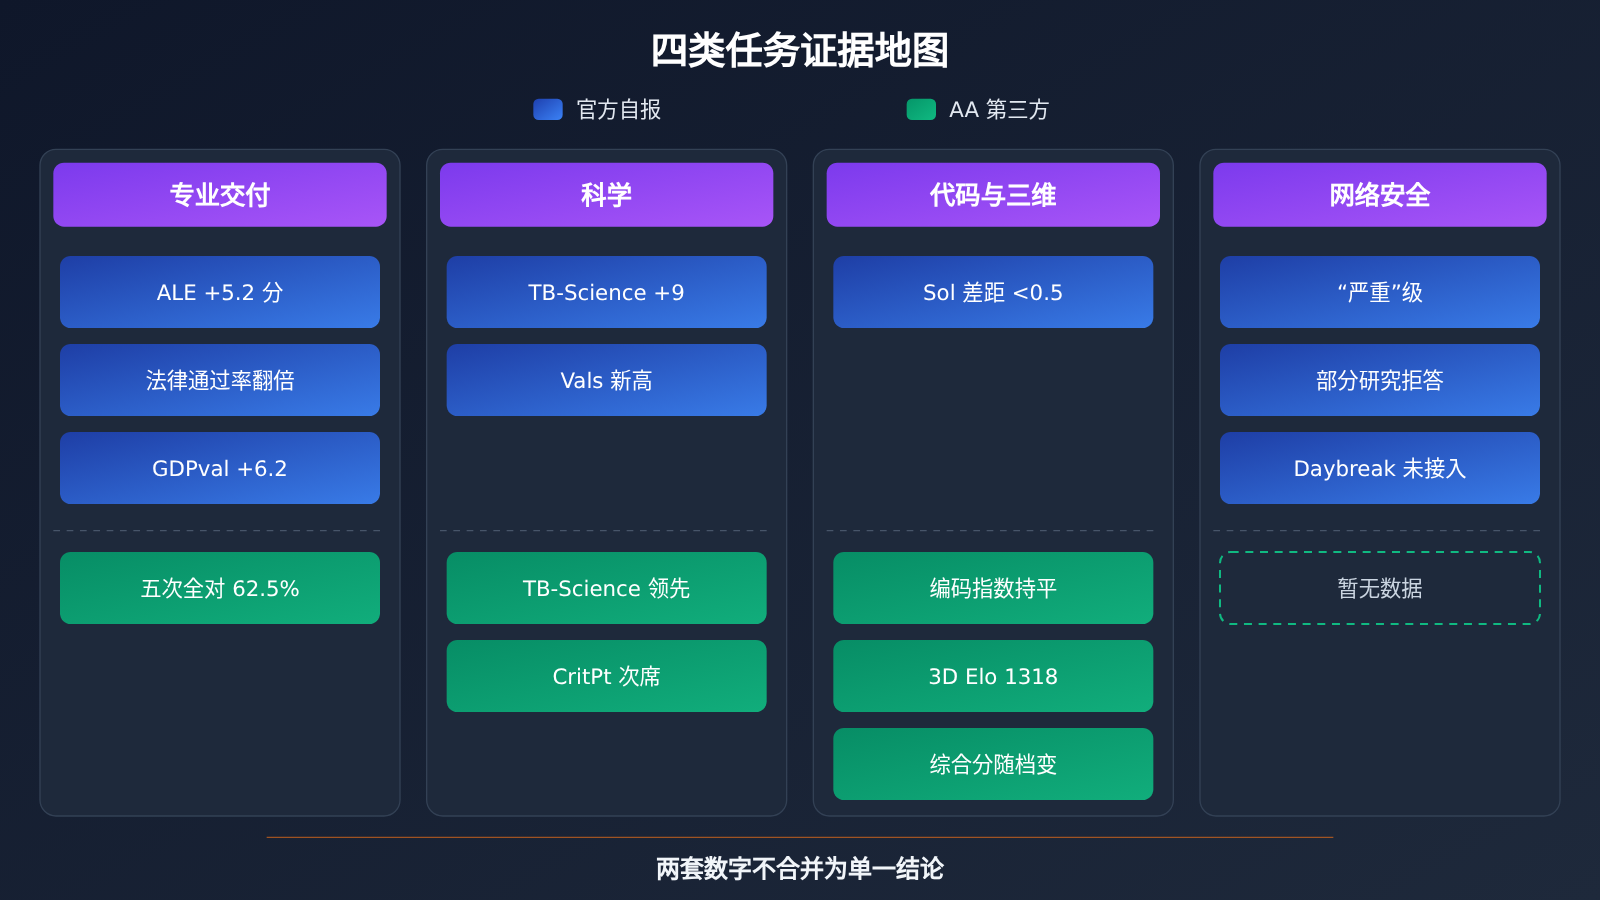
GPT-6.2 Astra 四类任务证据汇总
| 任务类型 | 关键证据 | 来源 | 结论强度 |
|---|---|---|---|
| 专业交付 | ALE 比 GPT-6 Astra 高 5.2 分;Harvey 通过率超 Fable 5.2 两倍;GDPval v2 高 6.2 个百分点 | 官方自报 | 相对优势明确,多数没有绝对分 |
| 科学 | Terminal-Bench-Science 0.1 高 9 个百分点;AA 亦称领先;CritPt v2 硬子集第二 | 官方自报 + AA | 终端科学强,理论硬题有对手 |
| 代码 | Coding Agent Index 与 GPT-6 Astra 持平 | AA 第三方 | 没有代际跃升 |
| 三维 | AA-3D Elo 1318,高于 Fable 5.2 与 Sol | 官方转述 AA | 单项领先 |
| 网络安全 | “严重”级;合法漏洞研究可能被拒;Daybreak 未接入 6.2 | 官方系统卡 | 能力强但可用性受限 |
GPT-6.2 Astra 评测数据:综合分随推理档变化
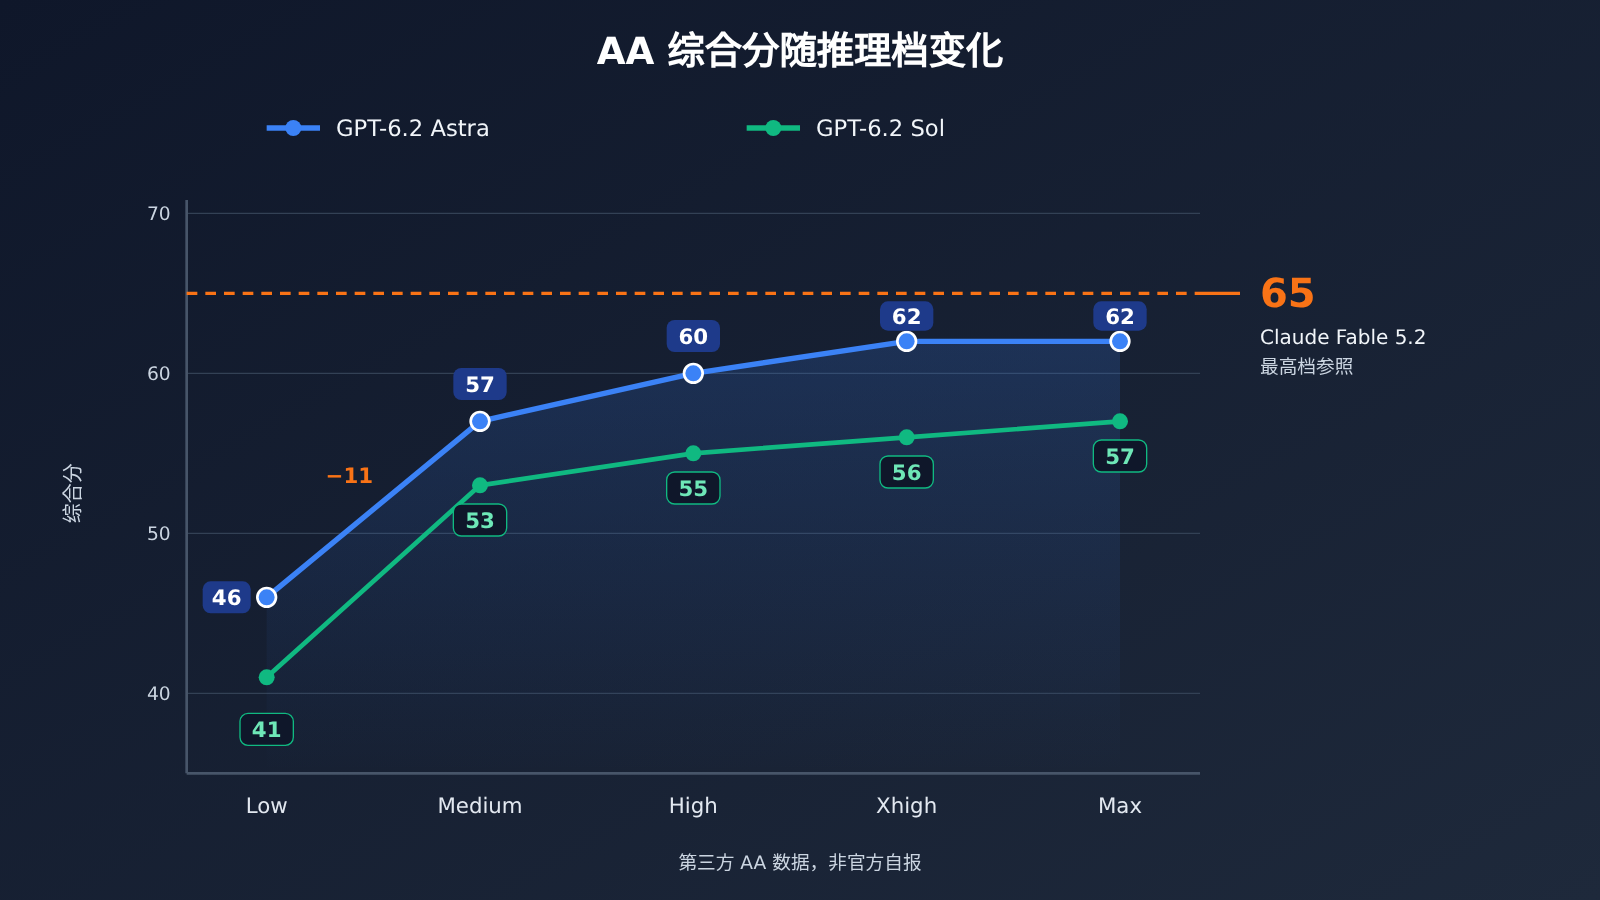
AA 的 Intelligence Index v5.0.1 是目前最常被引用的第三方综合分。最高推理档下,Claude Fable 5.2 以 65 分排第一。GPT-6.2 Astra 在 Max 与 Xhigh 档为 62 分,超过 Gemini 4 Carbon 最高档的 60 和 Claude Opus 5.5 最高档的 59,比 GPT-6 Astra 高 5 分。
真正值得关注的是推理档带来的落差。下表全部来自 AA 第三方数据:
| 推理档 | GPT-6.2 Astra | GPT-6.2 Sol | 说明 |
|---|---|---|---|
| Max | 62 | 57 | Astra 的 Max 与 Xhigh 同分 |
| Xhigh | 62 | 56 | Astra 在这一档还没有掉分 |
| High | 60 | 55 | 降 2 分 |
| Medium | 57 | 53 | Astra 的 Medium 与 Sol 的 Max 同分 |
| Low | 46 | 41 | 断崖式下降 |
从 Max 到 Low,GPT-6.2 Astra 掉了 16 分,其中 Medium 到 Low 一档就掉了 11 分。如果你为了省钱把推理档调到 Low,拿到的就不再是“62 分的 Astra”。只看榜单最高分去做选型,很容易高估实际部署时的效果。
成本口径同样来自 AA。综合指数单任务成本方面,GPT-6.2 Astra(Max)为 $4.00,GPT-6.2 Sol(Max)为 $1.01,Claude Fable 5.2 页面列出的是 $26.54。这是 AA 这一套任务的成本,不能拿去和官方“ALE 成本约为 Fable 5.2 的 5%”互相推算。
GPT-6.2 Astra 规格与官方标价
规格和价格以 OpenAI 模型页为准。型号 ID 为 gpt-6.2-astra,输入支持文本和图像,输出为文本,不支持音频和视频。上下文为 1,050,000 token,最大输入 922,000,最大输出 128,000,知识截止 2026-05-18,支持推理 token。API 不接受把 reasoning effort 设为 none。
| 项目 | GPT-6.2 Astra 官方值(每 100 万 token) |
|---|---|
| 输入(短上下文标准档) | $8 |
| 缓存读 | $0.40 |
| 缓存写入(保留 30 分钟) | $10 |
| 缓存写入(保留 12 小时) | $20 |
| 输出 | $40 |
| 支持端点 | Chat Completions、Responses、Batch |
以上是 OpenAI 官方标价。gpt-6.2-astra 在 API易暂未上架,我们会尽快上架这个模型;型号与价格以平台型号列表为准。发布文的概括是:输入和输出比 GPT-6 Astra 低 20%,缓存输入低 60%。
计价规则还有几个细节需要注意。单次请求输入超过 272K token 时,输入和缓存单价加倍,输出按短上下文的 1.5 倍计,并且按整单计算。Batch 为标准价的 50%,Fast 为同一上下文长度标准价的 2 倍。Ultrafast 在 2027-02-28(太平洋时间)之前是标准价的 3 倍,2027-03-01 起变为 6 倍。
作为对照,GPT-6.2 Sol 的官方标价为输入 $2、缓存读 $0.10、输出 $10。gpt-6.2-sol 在 API易同样暂未上架,我们会尽快上架这个模型;型号与价格以平台型号列表为准。
查型号时,可以同时看两个地方:API易 apiyi.com 的型号总表(docs.apiyi.com/models.md),以及定价接口 https://api.apiyi.com/api/pricing。截至总表数据时间 2026-11-17 15:54(UTC+8),两处都还没有 gpt-6.2-astra 和 gpt-6.2-sol。总表里已经在架的 gpt-6-astra 是上一代型号,它的平台价不能当作 6.2 的价格参考。
GPT-6.2 Astra 快速上手:先选任务,再看推理档
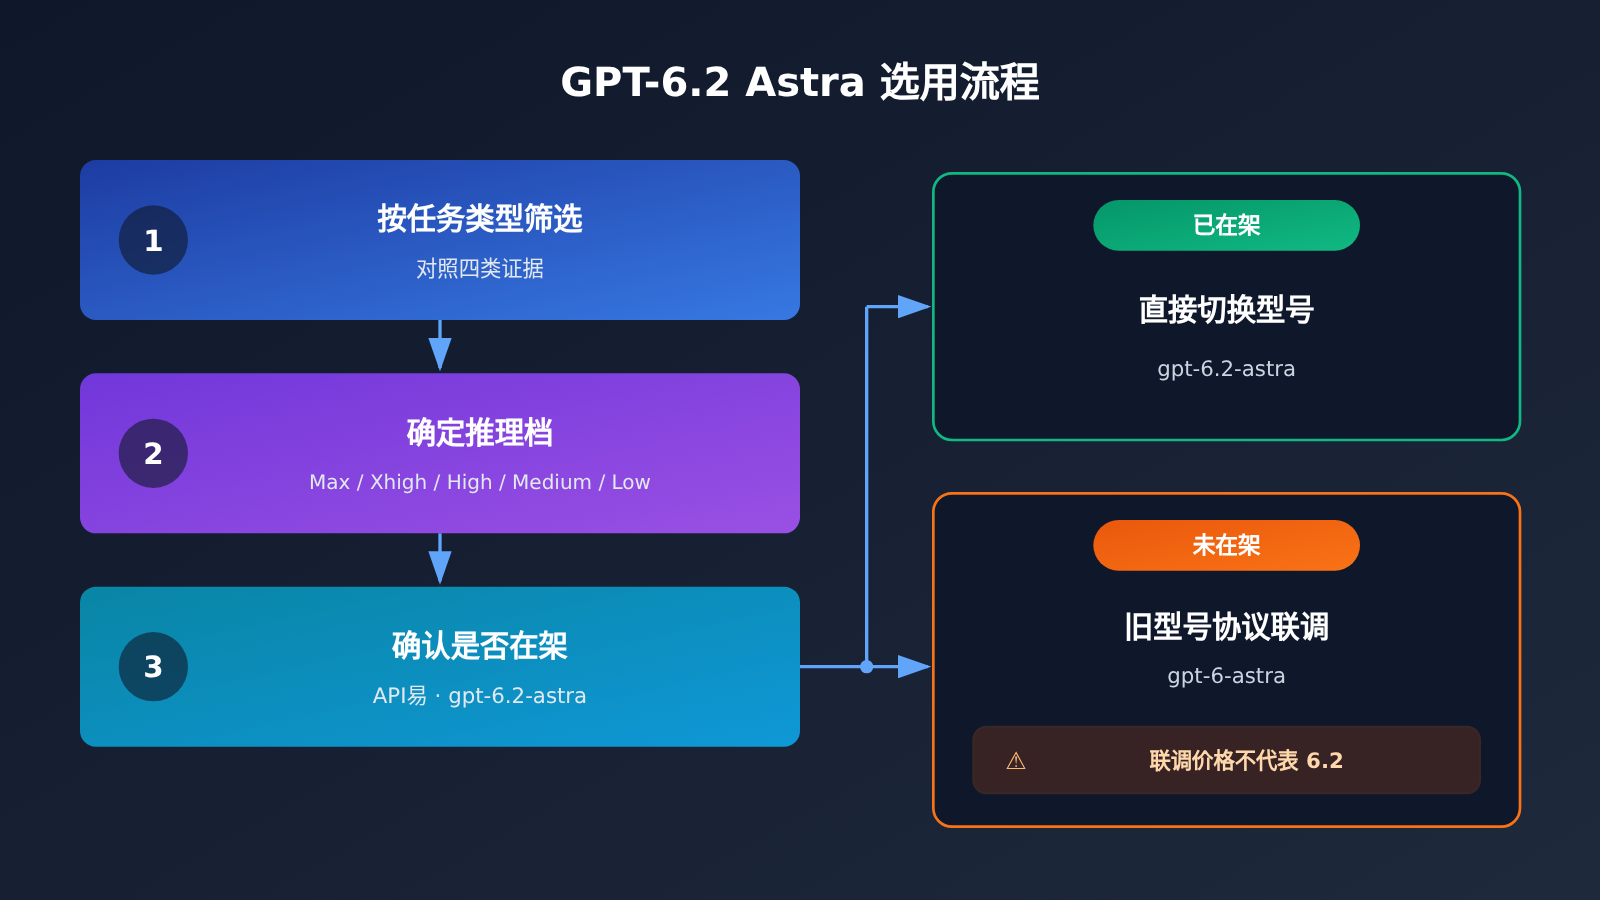
决定一项硬任务要不要交给 GPT-6.2 Astra,建议按以下顺序判断:
- 先按任务选。 对照上文四类证据。如果是专业文档交付或终端科学流程,Astra 有较明确的官方证据;如果主要是代码合并类任务,先评估 Sol 能否满足需求;如果是漏洞研究,要预期部分请求会被拒绝。
- 再看推理档。 记住 AA 的落差:Max 与 Xhigh 62、High 60、Medium 57、Low 46。成本敏感的任务可以从 High 或 Medium 起步做 A/B 对比,不建议直接用 Low 承担硬任务。
- 最后看平台列表。 打开 API易 apiyi.com 的型号列表,搜索
gpt-6.2-astra。如果已经在架,直接把请求中的 model 字段换成这个型号即可。
如果列表里还没有 6.2,可以先用已在架的 gpt-6-astra 做协议联调,把 OpenAI 兼容客户端的 base_url 设为 https://api.apiyi.com/v1,model 填 gpt-6-astra,跑通 Chat Completions 或 Responses 的请求结构、流式输出和推理参数。需要明确的是,这一步验证的是接口协议,联调期间产生的是 gpt-6-astra 的价格,不是 6.2 的价格,效果也不代表 6.2 的能力。
联调时有几个参数值得提前确认:reasoning effort 不能传 none;长输入要留意 272K 这条整单加倍线;如果做批量离线任务,可以评估 Batch 的五折价。这些在 6.2 上架后都可以原样沿用。
🚀 上手建议:API易 apiyi.com 提供 OpenAI 兼容接口,一个 API Key 即可调用多家模型,新用户有免费测试额度。建议先用在架型号把请求链路跑通,等 6.2 上架后只改型号名即可切换。
GPT-6.2 Astra 任务选型参考
| 任务类型 | 是否优先考虑 Astra | 起步推理档建议 | 需要注意 |
|---|---|---|---|
| 长程专业文档交付 | 是 | High 起步,关键交付用 Max | 官方对比多为相对值 |
| 终端科学流程 | 是 | High 或 Xhigh | 理论硬题可能有更强对手 |
| 代码合并类改动 | 先评估 Sol | 按预算选择 | Coding Agent Index 没有跃升 |
| 三维生成 | 可以 | 按效果调整 | AA-3D 为盲评 Elo,属于官方转述 |
| 漏洞研究 | 谨慎 | 不适用 | 可能被拒,Daybreak 未接入 6.2 |
表中的起步推理档是基于 AA 分数落差给出的建议,不是官方推荐值。正式上线前,请用你自己的任务样本做对比。
GPT-6.2 Astra 优缺点分析
优势
- 专业交付证据多:ALE、Harvey LAB-AA、GDPval v2、AA-AnalystAgent 多个官方自报指标指向同一方向,并且普遍伴随成本下降。
- 科学终端有双源印证:官方自报与 AA 第三方都显示它在 Terminal-Bench-Science 0.1 上领先。
- 单位成本下降:官方标价比 GPT-6 Astra 的输入输出低 20%,缓存输入低 60%;GDPval v2 上输出 token 还少了 22%。
- 长上下文与大输出:1,050,000 上下文、128,000 最大输出,适合整份材料一次性处理。
局限
- 综合分不是第一:AA 最高档下 Claude Fable 5.2 为 65 分,GPT-6.2 Astra 为 62 分。需要综合最强的场景,应先做对比测试。
- 推理档敏感:Low 档只有 46 分。降档前一定要用自己的任务做回归测试。
- 代码没有代际提升:AA 的 Coding Agent Index 与 GPT-6 Astra 持平;代码合并类任务可以先评估成本更低的 Sol。
- 安全研究受限:部分合法漏洞研究会被拒绝,Daybreak 还没有 6.2。安全团队暂时只能继续使用 Daybreak 上的 GPT-6 系列。
- 漏报阻塞项:在两项测试中更容易漏报文件缺失、工具不可用等问题,Agent 流程里要显式要求它汇报阻塞项。
- 幻觉率不低:AA-Omniscience 幻觉率(Max)为 59%,事实性输出仍需要外部校验。
常见问题 FAQ
Q1:GPT-6.2 Astra 是什么?
GPT-6.2 Astra 是 OpenAI 于 2026-11-17 发布的模型,与 GPT-6.2 Sol 同批推出,型号 ID 为 `gpt-6.2-astra`。它接收文本和图像、输出文本,上下文为 1,050,000 token,可以在 ChatGPT Work、Codex 和 OpenAI API 中使用。
Q2:GPT-6.2 Astra 是不是目前最强的模型?
不能这样概括。AA 第三方综合指数最高档下,Claude Fable 5.2 为 65 分,GPT-6.2 Astra 为 62 分。它在专业交付、终端科学、三维等具体维度有证据显示领先,但代码 Agent 指数与上一代持平,因此需要按任务逐项判断。
Q3:为什么同一个 GPT-6.2 Astra 会有不同的分数?
因为 AA 的分数与推理档绑定:Max 与 Xhigh 为 62,High 为 60,Medium 为 57,Low 为 46。推理档越低,消耗越少,分数也越低。引用分数时请同时写明推理档。
Q4:GPT-6.2 Astra 适合做漏洞研究吗?
需要谨慎。它达到了网络安全“严重”级,防护更严,一部分合法的漏洞研究会被拒绝。面向防御方的 Daybreak 目前还没有接入 6.2,官方只表示会努力引入。
Q5:现在能通过 API易 调用 gpt-6.2-astra 吗?
截至 2026-11-17 15:54(UTC+8)的总表和定价接口,gpt-6.2-astra 暂未上架,我们会尽快上架这个模型;型号与价格以平台型号列表为准。在此之前,可以先在 API易 apiyi.com 用已在架的 `gpt-6-astra` 做协议联调。联调产生的是 gpt-6-astra 的费用,不代表 6.2 的价格。
Q6:GPT-6.2 Astra 的官方价格是多少?
OpenAI 官方标价为每 100 万 token:输入 $8、缓存读 $0.40、30 分钟缓存写入 $10、输出 $40。单次请求输入超过 272K 时整单提价。在 API易上暂未上架,我们会尽快上架这个模型;型号与价格以平台型号列表为准。
Q7:GPT-6.2 Astra 有哪些已知不足?
主要有四点:低推理档分数下滑明显;代码 Agent 能力与上一代持平;AA-Omniscience 幻觉率(Max)为 59%;在部分测试中容易漏报文件缺失、工具不可用等阻塞项。前三点可以通过选档和外部校验缓解,最后一点可以在指令中显式要求它汇报阻塞项。
GPT-6.2 Astra 核心要点 Key Takeaways
- 专业交付证据最多:ALE、Harvey、GDPval v2 的官方自报都显示提升且成本更低。
- 科学终端有双源印证:官方自报与 AA 第三方都显示 Terminal-Bench-Science 领先。
- 代码没有跃升:AA Coding Agent Index 与 GPT-6 Astra 持平,FrontierCode 的性价比属于 Sol。
- 综合分看推理档:AA 分数为 Max/Xhigh 62、High 60、Medium 57、Low 46。
- 安全能力强但受限:达到“严重”级,可能拒绝合法漏洞研究,Daybreak 未接入 6.2。
- 上手顺序:按任务选型,再定推理档,最后在 API易 apiyi.com 型号列表中确认是否在架。
总结
GPT-6.2 Astra 的核心要点:
- 按任务看强项:专业文档交付和终端科学的证据最充分,三维有单项领先,代码保持上一代水平。
- 按推理档看分数:AA 第三方综合分从 Max 的 62 降到 Low 的 46,选档会直接影响效果。
- 按来源看数字:官方自报和 AA 第三方是两套口径,成本和分数都不能互相换算。
- 安全场景单独评估:防护更严,Daybreak 尚未接入 6.2。
如果你手上有一项硬任务,建议先对照四类证据判断它是否落在 Astra 的强项上,再用自己的样本在不同推理档之间做对比。
6.2 上架前,可以先通过 API易 apiyi.com 用在架型号把调用链路跑通;上架后直接切换型号名,以平台型号列表的实际价格为准。
📚 参考资料
-
OpenAI 发布文:GPT-6.2 Astra 与 Sol 官方介绍及官方自报成绩
- 链接:
openai.com/index/introducing-gpt-6-2-astra-sol - 说明:专业交付、科学、代码相关的相对成绩与价格概括
- 链接:
-
OpenAI 系统卡:安全等级与对齐评估
- 链接:
deploymentsafety.openai.com/gpt-6-2-astra-sol - 说明:网络安全“严重”级、AI 自我改进高阈值、Daybreak 现状
- 链接:
-
OpenAI 模型页:规格与官方标价
- 链接:
platform.openai.com/docs/models/gpt-6.2-astra - 说明:上下文、端点、272K 计价规则、Batch/Fast/Ultrafast 倍率
- 链接:
-
Artificial Analysis 评测文章:第三方综合指数与分项
- 链接:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - 说明:各推理档综合分、Coding Agent Index、幻觉率、Robotics
- 链接:
-
Artificial Analysis 模型页:GPT-6.2 Astra 单任务成本
- 链接:
artificialanalysis.ai/models/gpt-6-2-astra - 说明:综合指数单任务成本口径
- 链接:
作者:APIYI 技术团队
技术交流:欢迎在 API易官网首页联系我们,更多型号与接入说明可查阅 docs.apiyi.com 文档中心


