
作者注:多項目 Agent 需要獨立上下文、持久狀態、任務調度和恢復機制,並行工作才能做到可追蹤、互不干擾。
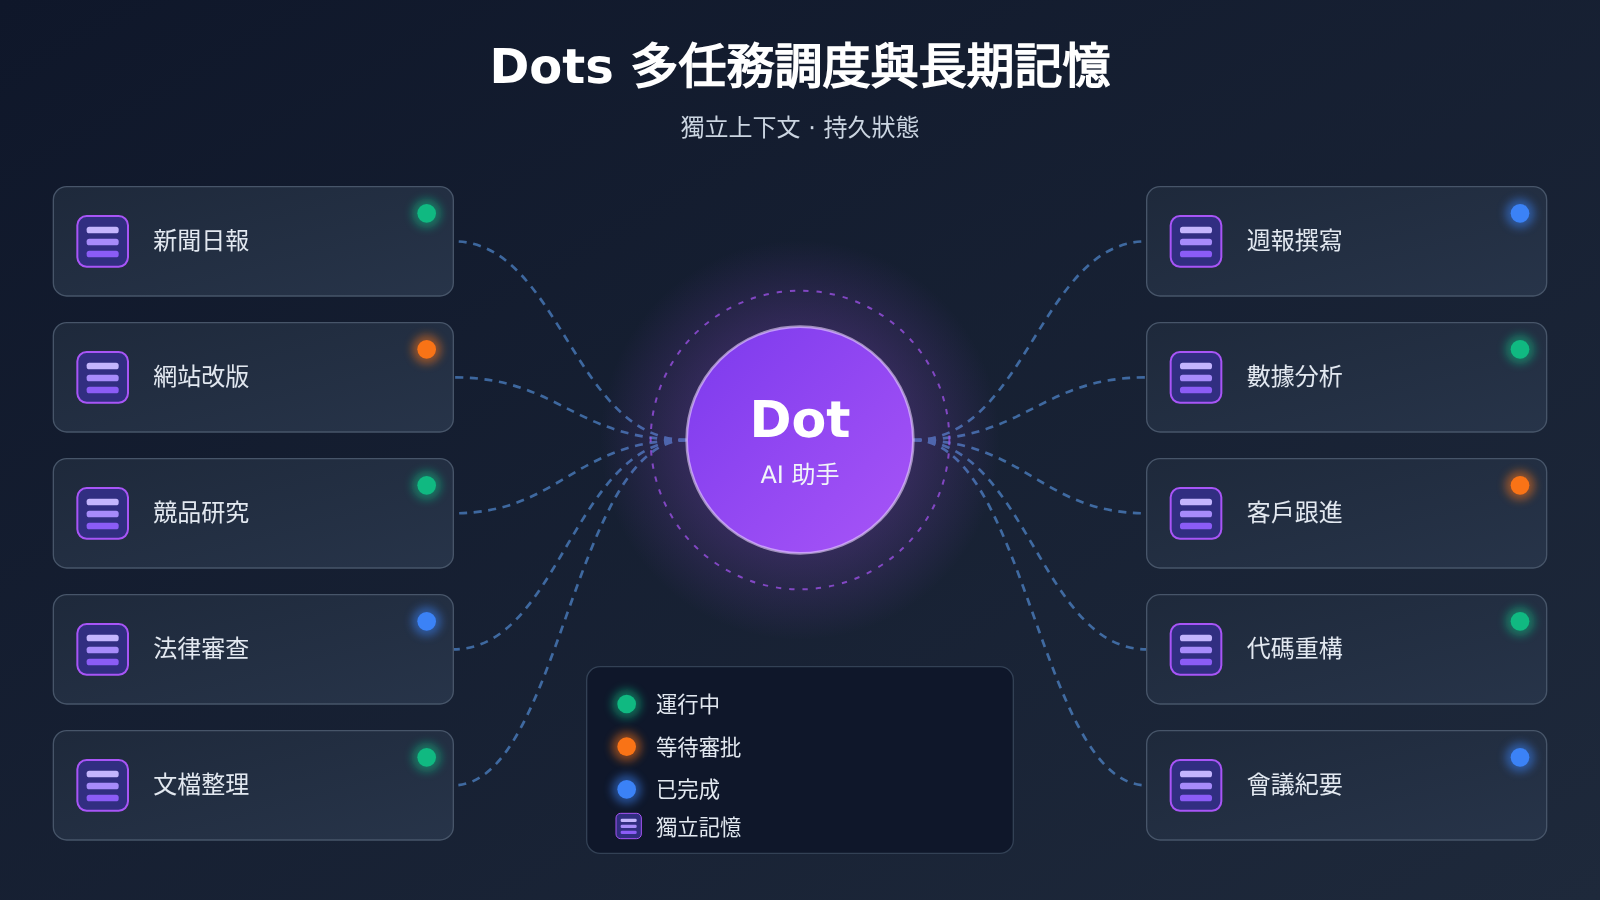
一個 AI 助手能否同時推進多個項目,關鍵在四件事:每項工作有獨立上下文,執行狀態持久保存,調度器統一安排優先級和併發,中斷後可以從檢查點恢復。同時調用多個模型並不難,難的是讓這些調用各自記得自己在做什麼。OpenAI 於 2026 年 9 月 29 日發佈的 Dots 採用了這套模式。官方文檔說明,一個 Dot 可以維護多個責任事項,把工作拆給後臺 Agent 並行處理。每個新任務擁有自己的對話上下文,不會自動獲得用戶與 Dot 的全部歷史對話。開發者可以用 Checkpointer、Store、任務隊列和狀態機搭建類似的多項目管理系統。
下文先根據官方資料拆解 Dots 的多任務和記憶機制,再用一個貫穿全文的項目管理示例,依次設計四層任務結構、並行調度、中斷恢復、執行追蹤和成本邊界。標題中的“十個項目”只是對工作模式的示例表達,Dots 和自建系統都沒有固定的十路併發,也不能無限並行。文中的自建 Agent 代碼屬於設計方案,沒有附帶虛構的運行結果。
To Know:Dots 多任務調度相關術語
| 術語 | 解釋 |
|---|---|
| Workspace | 組織項目與權限的工作空間,通常對應一個用戶或一個團隊。 |
| Project | 項目單元,包含目標、資料和相關任務。 |
| Task | 一項有明確目標的工作,例如“檢索今日 OpenAI 新聞”。 |
| Run | 任務的一次實際執行記錄,同一個 Task 可以執行很多次。 |
| 後臺 Agent | Dot 派出去並行處理子任務的執行者,完成後向 Dot 彙報。 |
| Checkpointer | 保存任務執行檢查點的組件,負責中斷後恢復。 |
| Store | 保存跨任務長期信息的存儲組件,負責延續項目背景。 |
| 狀態機 | 按規則管理任務各階段轉換的機制,如待執行、執行中、等待審批。 |
| 併發限制 | 同時執行任務的數量上限,受 API 額度、服務器資源和成本約束。 |
| Tracing | 記錄模型調用、工具調用和交接過程的追蹤能力。 |
| Proactive Research | Dots 在沒有新消息時對已授權資料源做的只讀後臺研究。 |
1 Dots 多任務調度:一個 Dot 爲什麼能同時承擔多個責任
1.1 Dots 官方披露的多項目能力
按照官方定位,Dots 是一個常駐型個人 Agent。它擁有自己的雲端計算機和瀏覽器,用戶離開後仍能繼續推進已委派的工作。在多任務方面,Tasks and memory 文檔列出了以下能力:
- 同時保留多個工作事項的狀態,並在同一對話中切換任務;
- 用戶可以隨時補充信息、調整優先級;
- 把複雜任務拆成若干部分,交給後臺 Agent 並行處理;
- 創建獨立的可見任務線程,再收集各任務結果並彙總;
- 工作出現阻塞時請求用戶介入,後臺任務運行期間用戶仍可繼續發消息。
這些能力合起來,讓 Dot 承擔的角色更接近項目協調者。它負責決定哪件事先做、哪件事拆出去、哪件事交還用戶,單個任務的具體執行可以由後臺 Agent、ChatGPT Work 任務或 Codex 任務完成。
1.2 多對話、多任務與多 Agent 的區別
這三個概念經常被混用,它們解決的問題各不相同。用統一的示例來看:假設用戶的工作空間裏有 AI Radar(AI 新聞日報)、Website(網站改版)、Research(競品研究)三個項目。
| 模式 | 運作方式 | 在示例中的表現 | 解決的問題 |
|---|---|---|---|
| 多對話 | 用戶爲每個項目開一個聊天窗口 | 用戶自己記住 Research 做到了哪一步 | 隔離聊天內容,進度仍由人管理 |
| 多任務 | 一個協調者維護多個任務的狀態 | Dot 記錄三個項目各自的進度和優先級 | 統一調度和狀態追蹤 |
| 多 Agent | 協調者把子任務派給多個執行者 | 後臺 Agent 收集資料,另一個執行者寫報告 | 並行執行與專業分工 |
Dots 把三者疊加在一起:用戶在一個入口與 Dot 溝通,Dot 維護多項任務,並按需派出後臺 Agent。自建系統要復刻這種效果,三層能力都要實現,只開多個聊天窗口遠遠不夠。
1.3 一位用戶自述的並行觀察
Reddit 上一位用戶自述了一天的測試。他把數百份 PDF、數千頁文檔交給 Dot 審查,同時運行法律研究任務。他觀察到三個執行過程同時存在:Dot 自己的雲端計算機處理任務 A,他連接的一臺 Linux 電腦處理任務 B,另一個後臺研究 Agent 處理任務 C。他還提到,啓動獨立法律研究任務時曾遇到執行環境不可用,連接本地電腦後纔派發成功。
這份個人觀察說明,Dot 的雲端計算機、本地電腦和 Work/Codex 環境是不同的執行資源。作者本人也指出,他沒有驗證這些路徑是否擁有獨立且無限的額度。所以這次測試只能說明 Dots 能把工作分派到不同環境,不能據此推斷每位 Pro 用戶都能獲得同樣的並行規模。
2 Dots 長期記憶:一個任務爲什麼需要獨立記憶
2.1 新任務的上下文邊界
官方文檔明確寫道:每個新任務有自己的對話上下文,不會自動獲得 Dot 與用戶之間的全部歷史對話。Dot 可以檢索過去的 ChatGPT 對話來尋找背景,檢索到的內容只作爲當前工作的上下文使用。
這個設計很實際。如果每個任務都載入全部歷史,Research 項目的競品報告就可能混入 Website 項目的改版討論,上下文也會越來越長、越來越貴。長期項目需要顯式管理“這個任務該知道什麼”,單靠一條越拉越長的聊天記錄做不到這一點。
2.2 Dots 記憶的四個數據層
根據官方資料,Dot 的上下文來自四個不同來源:
- ChatGPT Memory:Dot 可以讀取 ChatGPT 的相關記憶和近期對話;
- Dot 自身的筆記:積累用戶偏好、工作習慣、項目決策和長期責任事項;
- 當前任務上下文:本次對話中的指令、文件、檢索結果和工具執行結果;
- 已連接應用的數據:Dot 讀取已授權應用的數據,並可通過主動研究形成記憶。
這幾層的生命週期各不相同。ChatGPT Memory 和 Dot 筆記屬於不同的數據層,關閉 ChatGPT Memory 共享不會自動刪除 Dot 已獲取的信息,斷開插件也只會停止新的訪問。截至 2026 年 11 月 16 日,用戶還不能逐條查看、修改或刪除 Dot 的獨立記憶,刪除 Dot 會啓動對其自身上下文的刪除。自建系統設計記憶層時,可以參考這套分層思路,同時補上可查看、可刪除的管理界面。
3 Checkpointer 與 Store:多任務 Agent 的兩種記憶
LangGraph 的持久化文檔把 Agent 的記憶分成兩類,這個劃分正好對應 Dots 的“任務上下文”和“長期筆記”。下面仍以 Research 項目的月度競品報告爲例說明。
3.1 Checkpointer:記住工作做到哪一步
Checkpointer 保存單個任務線程的執行快照,內容包括當前步驟、已調用的工具、工具返回結果,以及哪一步在等待人工審批。在示例中,月度報告任務已經抓完 6 家競品的價格頁,正準備分析時服務重啓了。有了檢查點,任務可以從“分析”這一步繼續,已經抓取的資料不必重抓。
存儲介質決定了檢查點能否撐過重啓。內存型實現適合開發測試,進程重啓後狀態就會丟失;本地持久化可以用 SQLite,長期部署的服務更適合 PostgreSQL。檢查點會持續增長,生產系統還要制定舊狀態的清理策略。
3.2 Store:記住項目背景
Store 保存跨任務、跨會話的長期資料,例如用戶偏好、項目背景、歷史決策和多個任務共享的知識。在示例中,“報告讀者是產品團隊”“只跟蹤 API 價格和功能更新”“上月已決定不再跟蹤某家停更的競品”都屬於 Store 的內容。下個月新建報告任務時,它會讀取這些決策,用戶無需重新交代。
3.3 Checkpointer 與 Store 職責對比
| 維度 | Checkpointer | Store |
|---|---|---|
| 作用範圍 | 單個任務線程 | 多任務、跨線程 |
| 保存內容 | 執行狀態快照 | 長期資料與事實 |
| 核心價值 | 中斷後恢復工作 | 新任務延續項目背景 |
| 示例內容 | “已抓取 6 家價格頁,下一步分析” | “報告讀者是產品團隊” |
| 生命週期 | 跟隨任務狀態,完成後可清理 | 按長期記憶策略保留和更新 |
兩者分工明確,缺一不可。只有 Checkpointer,每個新任務都像新員工入職;只有 Store,任務一中斷就要從頭再來。
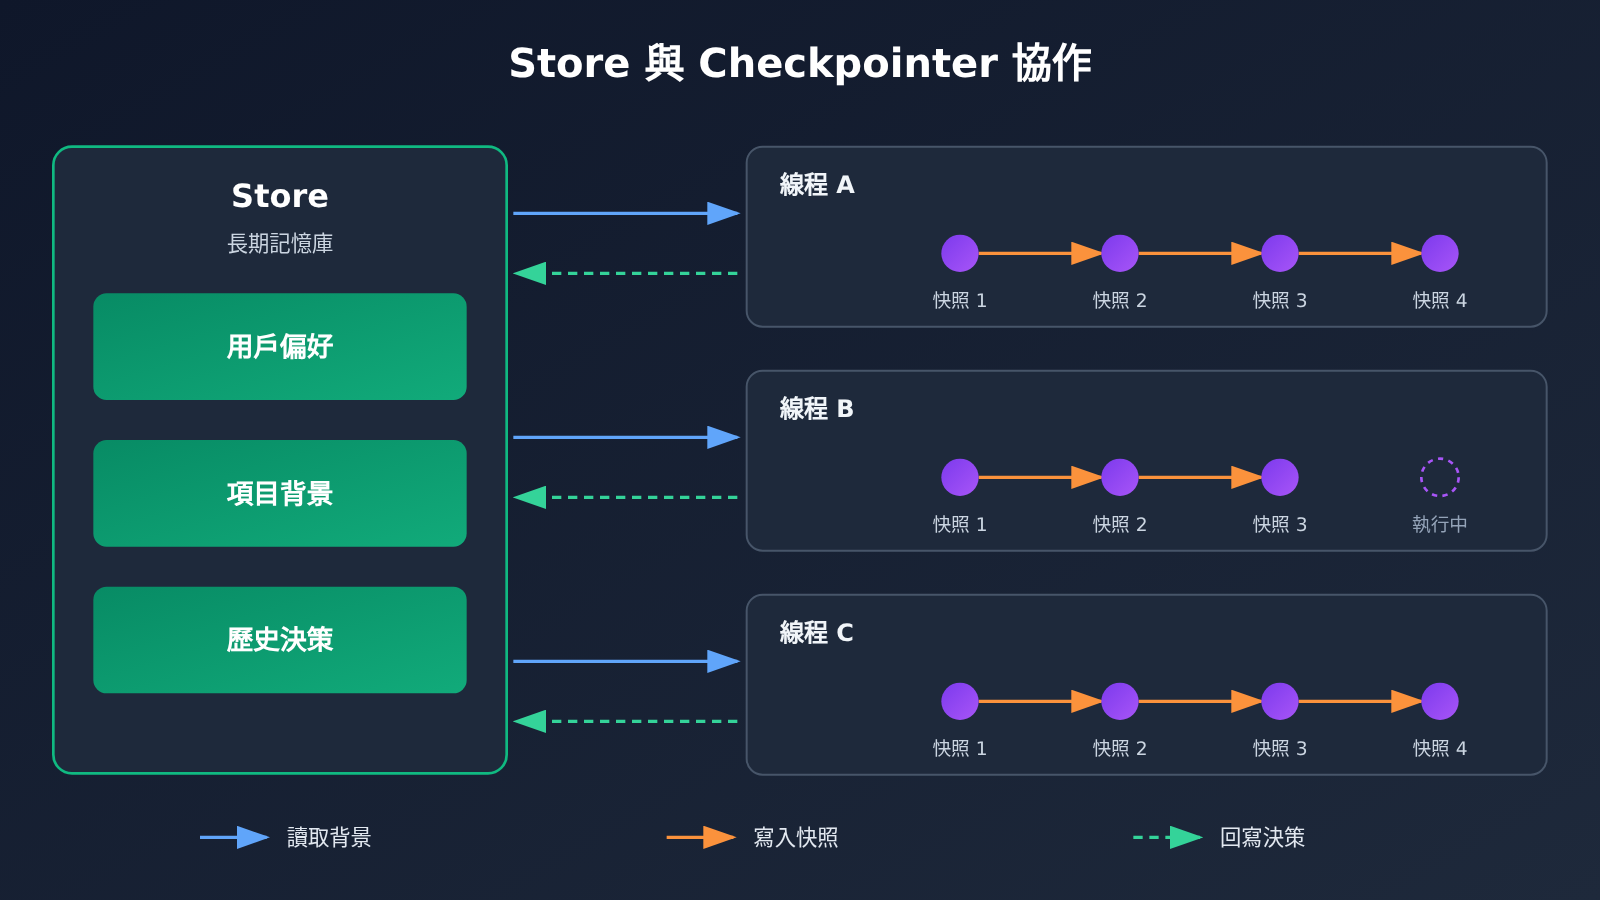
上圖中的“讀取背景—寫入快照—回寫決策”循環,可以直接映射到第 6 節的代碼。示例代碼通過 API易 apiyi.com 的 OpenAI 兼容接口調用模型,換模型時只需修改模型名。
4 多項目任務管理系統設計:Workspace、Project、Task、Run
4.1 四層結構與獨立 ID
自建多項目 Agent 建議採用四層結構,每一層都有獨立 ID:
| 層級 | 作用 | 示例 |
|---|---|---|
| Workspace | 管理一個用戶的工作空間和權限 | regulus |
| Project | 管理獨立項目的目標與資料 | AI Radar、Website、Research |
| Task | 管理具體任務 | Daily News、Monthly Report |
| Run | 記錄某次實際執行 | Daily News 在 2026-11-16 09:00 的執行 |
對應的樹形結構如下:
Workspace: regulus
├── Project: AI Radar
│   ├── Task: Daily News
│   │   ├── Run: 2026-11-16
│   │   └── Run: 2026-11-17
│   └── Task: Topic Discovery
├── Project: Website
│   ├── Task: UI Improvement
│   └── Task: Bug Fix
└── Project: Research
    ├── Task: Competitor Analysis
    └── Task: Monthly Report
Task 和 Run 分開記錄是關鍵。Daily News 每天運行一次,每次 Run 都有自己的輸入、輸出、耗時和狀態,出了問題可以精確定位到某一天的某一次執行。
4.2 記憶訪問範圍與項目隔離
一個 Agent 管理多個項目時,各項目的文件默認不能互相讀取。建議按層級劃分記憶的訪問範圍:
- 用戶通用偏好(如報告用中文、結論先行):所有授權項目可讀;
- 項目背景(如 Research 的讀者和跟蹤範圍):僅該項目的任務可讀;
- 單次任務記錄:僅當前任務和明確授權的關聯任務可讀;
- 企業客戶資料:僅指定客戶項目可讀;
- 敏感憑證:放在獨立的安全存儲中,永遠不進入模型上下文。
跨項目共享資料時,要記錄來源和授權範圍。這與 Dots 的做法一致:官方說明 Dot 的上下文不保留憑證、圖片和截圖,權限邊界由插件授權和 Custom Rules 共同控制。
5 多任務調度:如何讓任務並行又互不干擾
5.1 調度器與 Agent 推理分離
建議把“什麼時候做”和“怎麼做”交給兩個組件。調度器負責啓動時機、項目選擇、當前運行數、優先級、超時和重試;Agent 負責理解任務、制定步驟、選擇工具、分析結果和提交成果。這樣,調度規則可以確定性地執行,模型只處理需要推理的部分。
技術選型可以參考這套組合:APScheduler 管理週期性任務,Celery 做後臺任務隊列,Redis 負責消息和短期協調,PostgreSQL 保存項目與執行狀態,LangGraph 這類框架管理 Agent 流程與持久化狀態。小規模原型用 Python 的 asyncio 加 SQLite 也能跑通,第 6 節的代碼就是這樣設計的。
5.2 三種並行方式
多任務 Agent 至少有三種並行:
- 獨立任務並行:AI Radar 的每日新聞和 Research 的月度報告互不依賴,可以同時運行;
- 子任務並行:一個項目拆成資料收集、事實覈查等子任務分頭進行;
- 模型角色並行:不同模型負責不同專業工作,最後彙總。
決定能否並行的約束包括 API 併發額度、服務器資源、任務依賴、數據庫寫入競爭、模型成本、結果衝突和重複執行。
5.3 示例:資料收集、數據分析、報告生成
Research 項目的月度報告拆成三個子任務。資料收集可以和 AI Radar 的每日新聞並行;數據分析依賴資料收集的結果,必須等它完成;報告生成依賴分析結論,完成後進入等待審批狀態,由用戶確認後纔算交付。
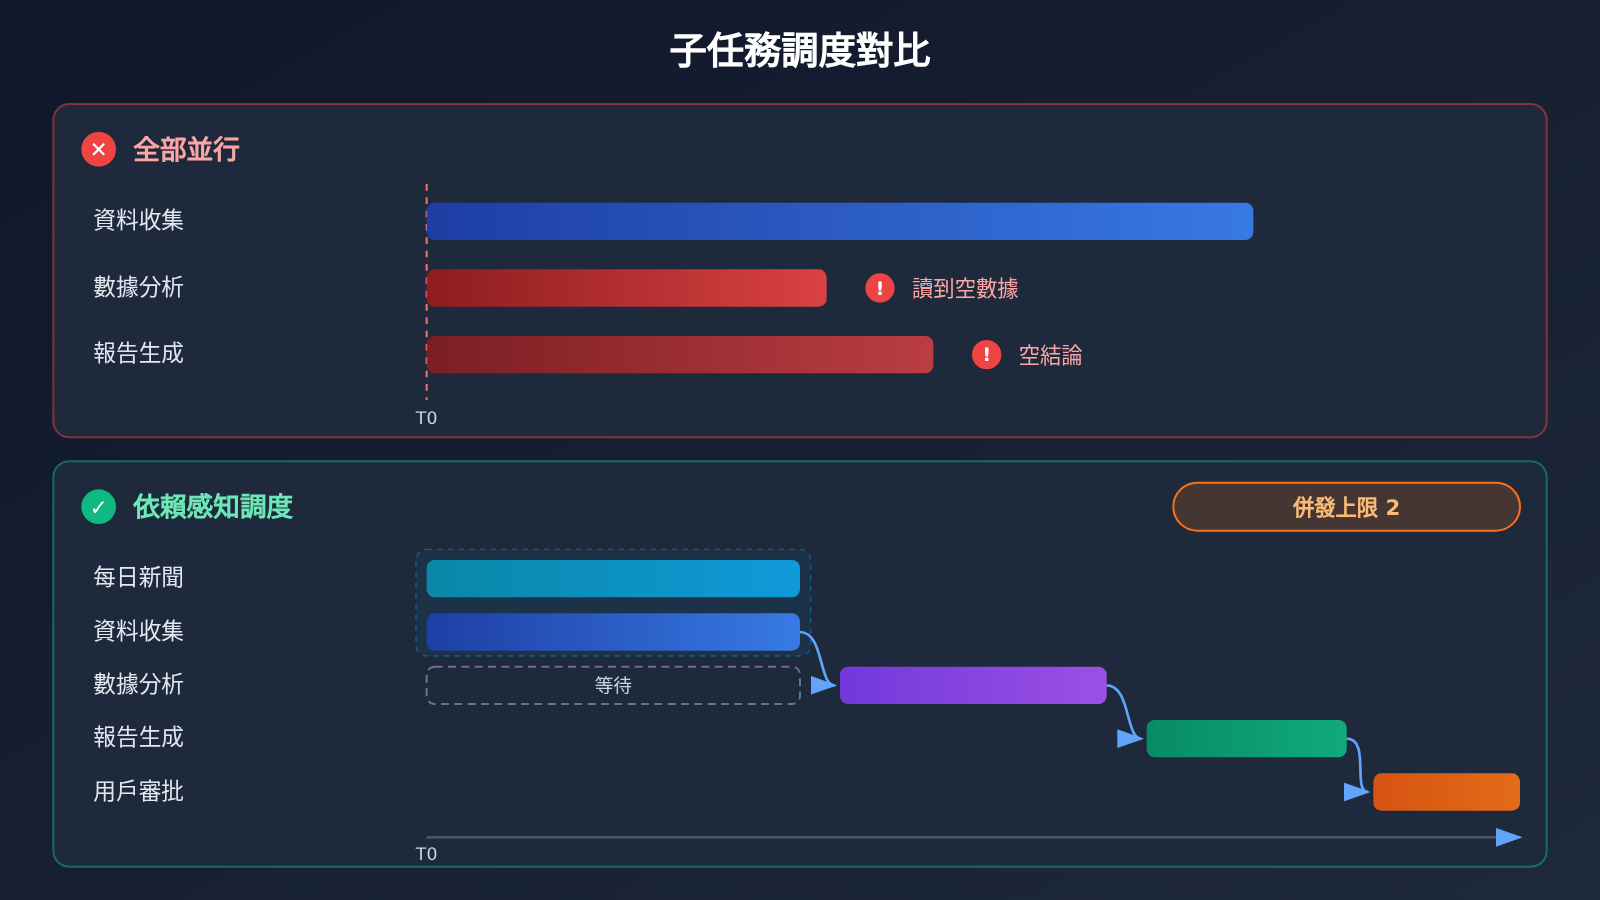
把三個子任務一起啓動看起來更快,數據分析卻會因爲拿不到資料而產生空結論,甚至自行編造數據。依賴關係決定了哪些任務必須串行,併發上限決定了能同時跑多少個,兩者都應寫進調度器,交給模型臨場判斷很容易出錯。
5.4 模型角色分工
| 子任務 | 推薦模型類型 | 選擇理由 | 可用平臺 |
|---|---|---|---|
| 資料收集與摘要 | 輕量快速模型 | 調用量大,對成本敏感 | API易 apiyi.com、官方 API |
| 數據分析 | 推理能力強的模型 | 需要多步比較和計算 | API易 apiyi.com、官方 API |
| 報告生成 | 長文寫作能力強的模型 | 結構與表達質量要求高 | API易 apiyi.com、官方 API |
| 事實覈查 | 與寫作模型不同的模型 | 交叉驗證,減少同源錯誤 | API易 apiyi.com、官方 API |
具體模型以平臺當前的模型列表爲準。一個 Key 對接多家模型時,角色分工可以通過配置調整,代碼結構無需改動。
6 快速上手:用統一接口搭建多任務 Agent 原型
6.1 極簡示例:給任務注入項目背景
下面的代碼演示最核心的一點:任務執行前,從長期記憶中只取出所屬項目的背景。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

# Store:按項目隔離的長期背景
project_memory = {
    "research": "讀者:產品團隊;只跟蹤 API 價格與功能更新;報告結論先行",
    "ai-radar": "每日 09:00 彙總 OpenAI、Anthropic、Google 官方動態",
}

def run_task(project_id: str, goal: str) -> str:
    resp = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[
            {"role": "system", "content": f"項目背景:{project_memory[project_id]}"},
            {"role": "user", "content": goal},
        ],
    )
    return resp.choices[0].message.content

print(run_task("research", "列出本月需要關注的競品更新清單"))
6.2 完整設計方案:狀態機、檢查點、依賴與併發
以下代碼是一個設計方案,覆蓋 Store、Checkpoint、狀態機、依賴調度、併發限制、重試、超時和執行記錄,用於說明各組件如何協作。它沒有經過生產環境驗證,文中也不提供虛構的運行結果。
查看完整設計方案代碼
import asyncio, json, sqlite3, time, uuid
from dataclasses import dataclass, field
from enum import Enum
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易統一接口,一個 Key 切換多家模型
)

class Status(str, Enum):
    PENDING = "pending"; RUNNING = "running"; WAITING = "waiting"
    APPROVAL = "approval"; COMPLETED = "completed"
    FAILED = "failed"; CANCELLED = "cancelled"; PAUSED = "paused"

db = sqlite3.connect("agent.db")
db.executescript("""
CREATE TABLE IF NOT EXISTS store(
  scope TEXT, key TEXT, value TEXT, source TEXT, PRIMARY KEY(scope, key));
CREATE TABLE IF NOT EXISTS checkpoint(
  run_id TEXT, task_id TEXT, step TEXT, state TEXT, ts REAL);
CREATE TABLE IF NOT EXISTS runs(
  run_id TEXT PRIMARY KEY, workspace_id TEXT, project_id TEXT, task_id TEXT,
  model_id TEXT, input_tokens INT, output_tokens INT,
  duration REAL, retry_count INT, final_status TEXT);
""")

def store_get(scopes: list[str]) -> str:
    """只讀取被授權的作用域:user 與 project:<id>"""
    marks = ",".join("?" * len(scopes))
    rows = db.execute(f"SELECT key, value FROM store WHERE scope IN ({marks})", scopes)
    return "\n".join(f"- {k}: {v}" for k, v in rows)

def save_checkpoint(run_id, task_id, step, state):
    db.execute("INSERT INTO checkpoint VALUES (?,?,?,?,?)",
               (run_id, task_id, step, json.dumps(state, ensure_ascii=False), time.time()))
    db.commit()

def log_run(run_id, task, usage, duration, retries, status):
    db.execute("INSERT OR REPLACE INTO runs VALUES (?,?,?,?,?,?,?,?,?,?)",
               (run_id, "regulus", task.project_id, task.task_id, task.model,
                getattr(usage, "prompt_tokens", 0), getattr(usage, "completion_tokens", 0),
                duration, retries, status.value))
    db.commit()

@dataclass
class Task:
    task_id: str
    project_id: str
    goal: str
    model: str
    depends_on: list[str] = field(default_factory=list)
    needs_approval: bool = False

async def run_task(task: Task, done: dict, sem: asyncio.Semaphore,
                   max_retry: int = 2, timeout: int = 120):
    run_id = f"run-{uuid.uuid4().hex[:8]}"
    background = store_get(["user", f"project:{task.project_id}"])
    upstream = "\n\n".join(done[d] for d in task.depends_on)
    messages = [
        {"role": "system", "content": f"長期背景:\n{background}"},
        {"role": "user", "content": f"{task.goal}\n\n上游結果:\n{upstream or '無'}"},
    ]
    async with sem:  # 併發限制
        for attempt in range(max_retry + 1):
            start = time.time()
            save_checkpoint(run_id, task.task_id, f"attempt-{attempt}", messages)
            try:
                resp = await asyncio.wait_for(
                    client.chat.completions.create(model=task.model, messages=messages),
                    timeout)
                output = resp.choices[0].message.content
                status = Status.APPROVAL if task.needs_approval else Status.COMPLETED
                log_run(run_id, task, resp.usage, time.time() - start, attempt, status)
                save_checkpoint(run_id, task.task_id, status.value, {"output": output})
                if status == Status.COMPLETED:
                    done[task.task_id] = output
                return
            except Exception as e:  # 超時或接口錯誤:指數退避後重試
                save_checkpoint(run_id, task.task_id, "error", {"error": str(e)})
                await asyncio.sleep(2 ** attempt)
        log_run(run_id, task, None, 0, max_retry, Status.FAILED)

async def schedule(tasks: list[Task], max_concurrency: int = 2) -> dict:
    sem = asyncio.Semaphore(max_concurrency)
    done: dict[str, str] = {}
    pending = {t.task_id: t for t in tasks}
    while pending:
        ready = [t for t in pending.values() if all(d in done for d in t.depends_on)]
        if not ready:  # 前置任務失敗、待審批或存在循環依賴
            print("阻塞任務:", list(pending))
            break
        await asyncio.gather(*(run_task(t, done, sem) for t in ready))
        for t in ready:
            pending.pop(t.task_id)
    return done

tasks = [
    Task("daily-news", "ai-radar", "彙總今日 AI 官方動態", "gpt-4.1-mini"),
    Task("collect", "research", "收集本月競品 API 價格與功能變更", "gpt-4.1-mini"),
    Task("analyze", "research", "對比變更並歸納趨勢", "gpt-4.1", depends_on=["collect"]),
    Task("report", "research", "生成月度競品報告", "gpt-4.1",
         depends_on=["analyze"], needs_approval=True),
]
asyncio.run(schedule(tasks))
代碼裏有幾處對應前文的設計。store_get 只讀取 user 和當前項目作用域,實現項目隔離;checkpoint 表按 run 記錄每一步,配合 runs 表記錄 Token 與最終狀態;schedule 用依賴關係決定串行,用信號量限制併發。真實系統還需要補上工具調用、審批迴調和恢復入口。
🚀 快速開始:搭建原型階段,推薦通過 API易 apiyi.com 獲取免費測試額度,用同一個 Key 分別給收集、分析、寫作三個角色配置不同模型,對比效果和成本後再確定分工。
7 多任務 Agent 如何處理中斷、失敗和人工審批
7.1 任務狀態機
任務進度應當由明確的狀態記錄,模型在聊天裏描述的進度只能作參考。推薦的主流程是 Pending(待執行)→ Running(執行中)→ Waiting(等待外部條件)或 Approval(等待審批)→ Completed(完成),另設 Failed、Cancelled、Paused 三個終止或暫停狀態。每次狀態轉換都寫入數據庫,調度器只依據數據庫裏的狀態做決策。
7.2 重試、超時與暫停恢復
- 重試:接口錯誤或超時後指數退避重試,並記錄 retry_count,便於發現經常失敗的步驟;
- 超時:每個 Run 設置執行時限,超時轉爲 Failed 並告警,防止一個卡死的任務長期佔用併發名額;
- 暫停恢復:暫停時保存檢查點,恢復時從最後一個檢查點繼續,已經完成的工具調用無需重複執行;
- 冪等性:發郵件、寫數據庫這類有副作用的步驟,重試前先檢查是否已執行,避免重複操作。
Dots 的官方資料裏有一個相關細節:停止正在運行的任務和取消已創建的週期計劃是兩件事,暫停 Dot 時,獨立的 Work、Codex 和計劃任務也可能繼續運行。自建系統應把“停止本次 Run”“暫停 Task”“取消週期計劃”設計成三個獨立操作。
7.3 人工審批:參考 Dots 的 Custom Rules
Dots 用 Custom Rules 把行爲分成四檔:無需詢問直接執行、預先授權後執行、執行前詢問、交還用戶。修改密碼、轉移資金等操作必須由用戶接管,永久刪除數據、安裝軟件可能要求每次批准。用戶批准也無法覆蓋核心安全限制。
自建系統可以照此給工具打標籤。只讀檢索直接執行;起草報告完成後進入 Approval;對外發送、付款、刪除一律交給人。示例中的報告任務設置了 needs_approval=True,生成後停在審批狀態,用戶確認後才寫入 Completed。
8 多任務 Agent 的執行追蹤:Tracing 與日誌
多項目並行時,用戶最常問的問題是“它到底做了什麼”。OpenAI Agents SDK 的 Tracing 可以記錄調用了哪個 Agent、使用了哪個模型、發生了哪些工具調用、哪裏進行了 handoff、觸發了哪些安全檢查,以及任務最終如何結束。
Tracing 擅長還原單次執行過程,項目級的統計還需要業務日誌補充。建議每個 Run 至少記錄 project_id、task_id、run_id、model_id、input_tokens、output_tokens、tool_calls、duration、retry_count 和 final_status。有了這些字段,就能回答“Research 項目本月花了多少 Token”“哪個步驟重試最多”“哪個模型的分析任務最常超時”這類管理問題。第 6 節的 runs 表就是這套字段的最小實現。
9 多任務 Agent 的成本和管理邊界
9.1 Dots 的費用結構
截至 2026 年 11 月 16 日,個人用戶可通過 ChatGPT Pro 100、Pro 200、Pro 500 三檔訂閱使用 Dots,月費分別爲 100、200、500 美元。官方沒有在個人 Pro 的 Dots 說明中列出單獨的 Dot 月費。Dot 委派出去的 ChatGPT Work 或 Codex 任務按對應產品的額度和規則計算,消耗取決於模型、上下文、推理、工具調用和檢索。個人 Pro 的使用還有年齡(18 歲以上)和地區限制,不包括歐洲經濟區、英國和瑞士。
企業工作區的計費方式不同。現行官方文檔說明,符合條件的企業工作區可以選擇按工作類型的固定費率,或者按用量計費;預覽期免費,2026 年 11 月 18 日起對已啓用的 Dots 開始計費;委派到 Work 或 Codex 的任務另行收費。具體金額以工作區實際適用的報價爲準。
9.2 自建系統的成本來源
自建多任務 Agent 的成本主要來自四處:
- 重複讀取上下文:每個任務都注入項目背景,背景越長,每次調用的輸入 Token 越多,Store 裏的內容需要定期精簡;
- 重試與失敗:一次失敗的分析任務會把上游資料重新送入模型一遍;
- 模型選擇:所有子任務都用最強模型,成本會成倍上升;
- 併發額度:API 的速率限制決定了實際可用的並行數。
9.3 並行數量與有效工作量
並行數量和有效工作量是兩回事。依賴未滿足的任務提前啓動只會產出廢結果,相互衝突的結論要花人工去合併,一個項目的錯誤數據經共享記憶傳到另一個項目,返工成本會更高。合理的做法是先保證項目隔離和依賴正確,再根據監控數據逐步調高併發上限。
10 常見問題 FAQ
Q1:Dots 的多任務調度是什麼?
一個 Dot 同時維護多個責任事項。用戶可以切換任務、調整優先級,Dot 把複雜工作拆給後臺 Agent 並行處理,彙總結果後在需要決策時交還用戶。
Q2:Dots 的長期記憶會記住所有歷史對話嗎?
不會全部載入。新任務有自己的對話上下文,Dot 依靠 ChatGPT Memory、自身筆記、當前任務上下文和已連接應用的數據工作,需要時再檢索過去的對話。
Q3:Checkpointer 和 Store 能互相替代嗎?
兩者職責不同。Checkpointer 保存單個任務的執行快照,用於中斷恢復;Store 保存跨任務的項目背景和決策,用於讓新任務延續上下文。長期項目兩者都需要。
Q4:Dots 能同時並行多少個任務?
官方資料沒有公佈固定的併發數。Dots 支持並行,執行環境和使用額度都有邊界。Reddit 用戶自述觀察到三個執行過程同時運行,這只是個人測試結果。
Q5:自建多項目 Agent 如何快速調用多種模型?
可以使用 OpenAI 兼容的聚合接口。在 API易 apiyi.com 註冊獲取 API Key 和免費測試額度後,把本文代碼的 base_url 設爲 `https://api.apiyi.com/v1`,即可用同一套代碼給不同子任務配置 GPT、Claude、Gemini 等模型。
Q6:如何控制多任務 Agent 的模型成本?
按角色分配模型:資料收集用輕量模型,分析和寫作再用強模型;精簡 Store 中的項目背景;用 runs 表統計每個項目的 Token。通過 API易 apiyi.com 按量計費調用,便於先小規模測試再決定配額。
Q7:Dots 和自建系統在安全上要注意什麼?
Agent 可能誤解任務、誤判資料或遭遇 Prompt Injection,官方也表示現有防護措施無法消除全部風險。涉及賬戶、資金、對外發送的操作應設置人工審批,敏感憑證不進入模型上下文。
11 Dots 多任務調度與長期記憶 Key Takeaways
- 核心難點:多任務 Agent 的關鍵在獨立上下文、持久狀態、調度與恢復。
- Dots 機制:一個 Dot 協調多個事項,後臺 Agent 並行執行,新任務上下文相互獨立。
- 兩種記憶:Checkpointer 負責恢復執行,Store 負責延續項目背景。
- 四層結構:Workspace、Project、Task、Run 各有獨立 ID,項目之間互相隔離。
- 調度原則:依賴決定串行,併發上限決定規模,規則寫進調度器。
- 可追蹤性:每個 Run 記錄模型、Token、耗時、重試次數和最終狀態。
- 上手方式:通過 API易 apiyi.com 統一接口給不同子任務配置不同模型。
12 總結
Dots 展示了個人 Agent 管理多個長期項目的產品形態:常駐運行,任務上下文相互獨立,記憶分層保存,後臺 Agent 並行執行,高風險操作交還用戶。它的多項目能力建立在狀態管理之上,單純增加並行數量做不到這一點。
自建類似系統時,可以按本文的順序落地:先用四層結構和作用域劃分實現項目隔離,再用 Store 與 Checkpointer 分別解決“記得背景”和“能夠恢復”,然後用調度器管理依賴與併發,最後用狀態機、審批和執行日誌讓每一步可控、可查。原型階段推薦通過 API易 apiyi.com 快速驗證不同模型在各個角色上的效果,再根據日誌數據調整分工和併發。
參考資料
- OpenAI:Introducing dots:產品發佈公告
- 鏈接:
openai.com/index/introducing-dots - 說明: 產品定位、雲端計算機與多項目執行
- ChatGPT Learn:Tasks and memory:Dots 任務與記憶文檔
- 鏈接:
learn.chatgpt.com/docs/dots/tasks-and-memory - 說明: 後臺 Agent、任務獨立上下文、主動研究
- OpenAI Help Center:Dots privacy, security, and safety FAQs:隱私與安全說明
- 鏈接:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - 說明: 權限、審批、記憶刪除與數據保留
- ChatGPT Learn:Dots admin guide:企業版管理與計費
- 鏈接:
learn.chatgpt.com/docs/enterprise/dots-admin-guide - 說明: 企業工作區計費方式與開始計費日期
- About ChatGPT Pro tiers:Pro 訂閱檔位說明
- 鏈接:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - 說明: Pro 100、200、500 的價格與額度規則
- LangGraph Persistence 文檔:Checkpointer 與 Store
- 鏈接:
github.com/langchain-ai/docs/blob/main/src/oss/langgraph/persistence.mdx - 說明: 短期執行狀態與長期記憶的劃分
- OpenAI Agents SDK:Tracing 與工作流
- 鏈接:
developers.openai.com/api/docs/guides/agents/sdk - 說明: Agent 執行過程的追蹤與調試
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心


