
作者注:拆解 Code Arena WebDev 榜第 6 名 Qwen4-Max:前六格局、國產內部差距、與頭部模型的分差、票數與單任務成本的正確讀法。
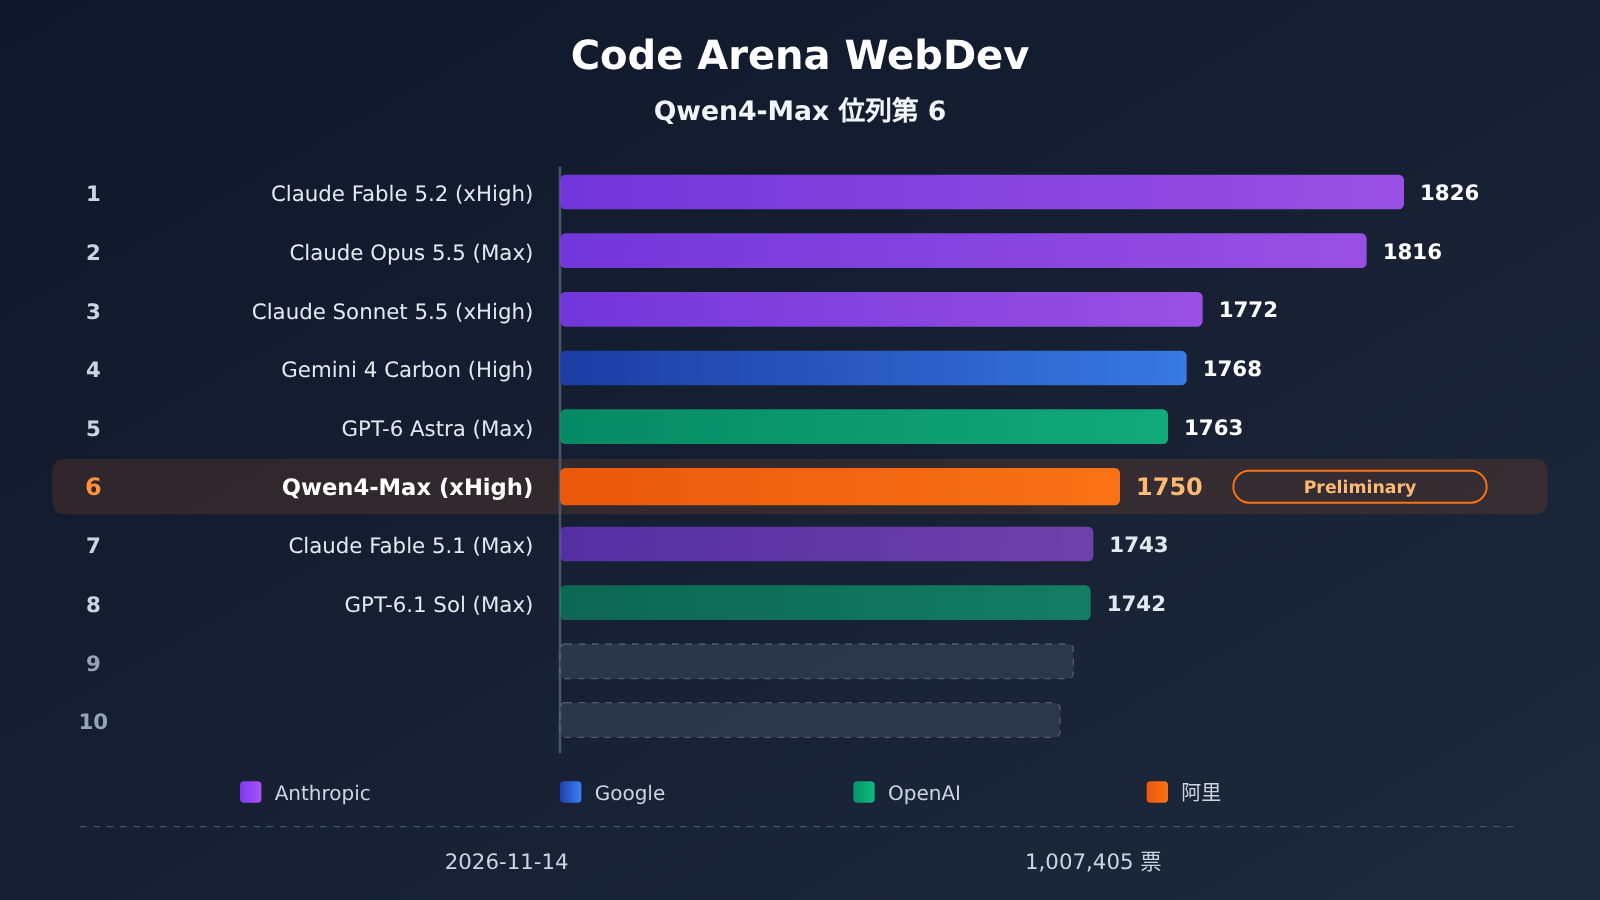
先說結論:在 arena.ai 的 Code Arena WebDev 榜(Overall 分類,頁面標註 2026-11-14)上,Qwen4-Max (xHigh) 以 1750 分排在第 6。這是國產模型第一次擠進這張榜的前六,也是前六里唯一一個非美國實驗室的模型。
這不是把第 6 包裝成第 1 的宣傳稿。 Qwen4-Max 在榜上帶有 Preliminary 標記,只有 1,814 票,名次還會動。阿里同一張官方圖裏,它在 Terminal-Bench 和 ProgramBench 上仍明顯落後 Opus 5.5 與 GPT-6 Astra。
核心價值:讀完本文,你會拿到一份可以自己點開覈對的榜單元數據,並明白 Qwen4-Max 的第 6 名該怎麼用、不該怎麼用。
Qwen4-Max Code Arena WebDev 第 6 核心要點
在討論名次之前,先把榜單的元數據擺出來。任何關於“第幾名”的說法,都應該先覈對日期、票數和參評模型數,否則很難判斷名次是否站得住。
| 要點 | 數據(同榜公開數據) | 怎麼讀 |
|---|---|---|
| 榜單與分類 | arena.ai Code Arena WebDev,Overall | 只代表網頁開發類盲測偏好 |
| 頁面日期 | 2026-11-14 | 名次隨投票持續變化 |
| 總票數 / 模型數 | 1,007,405 票 / 159 個模型 | 樣本量大,但單模型票數差異很大 |
| Qwen4-Max 名次與分數 | 第 6,1750 分 | 前六唯一非美國實驗室模型 |
| Qwen4-Max 票數與標記 | 1,814 票,Preliminary | 仍處於初步評估階段 |
| 單任務成本 P50 | $4.18 | 榜上統計的中位數,不是模型單價 |
Qwen4-Max 榜單口徑詳解
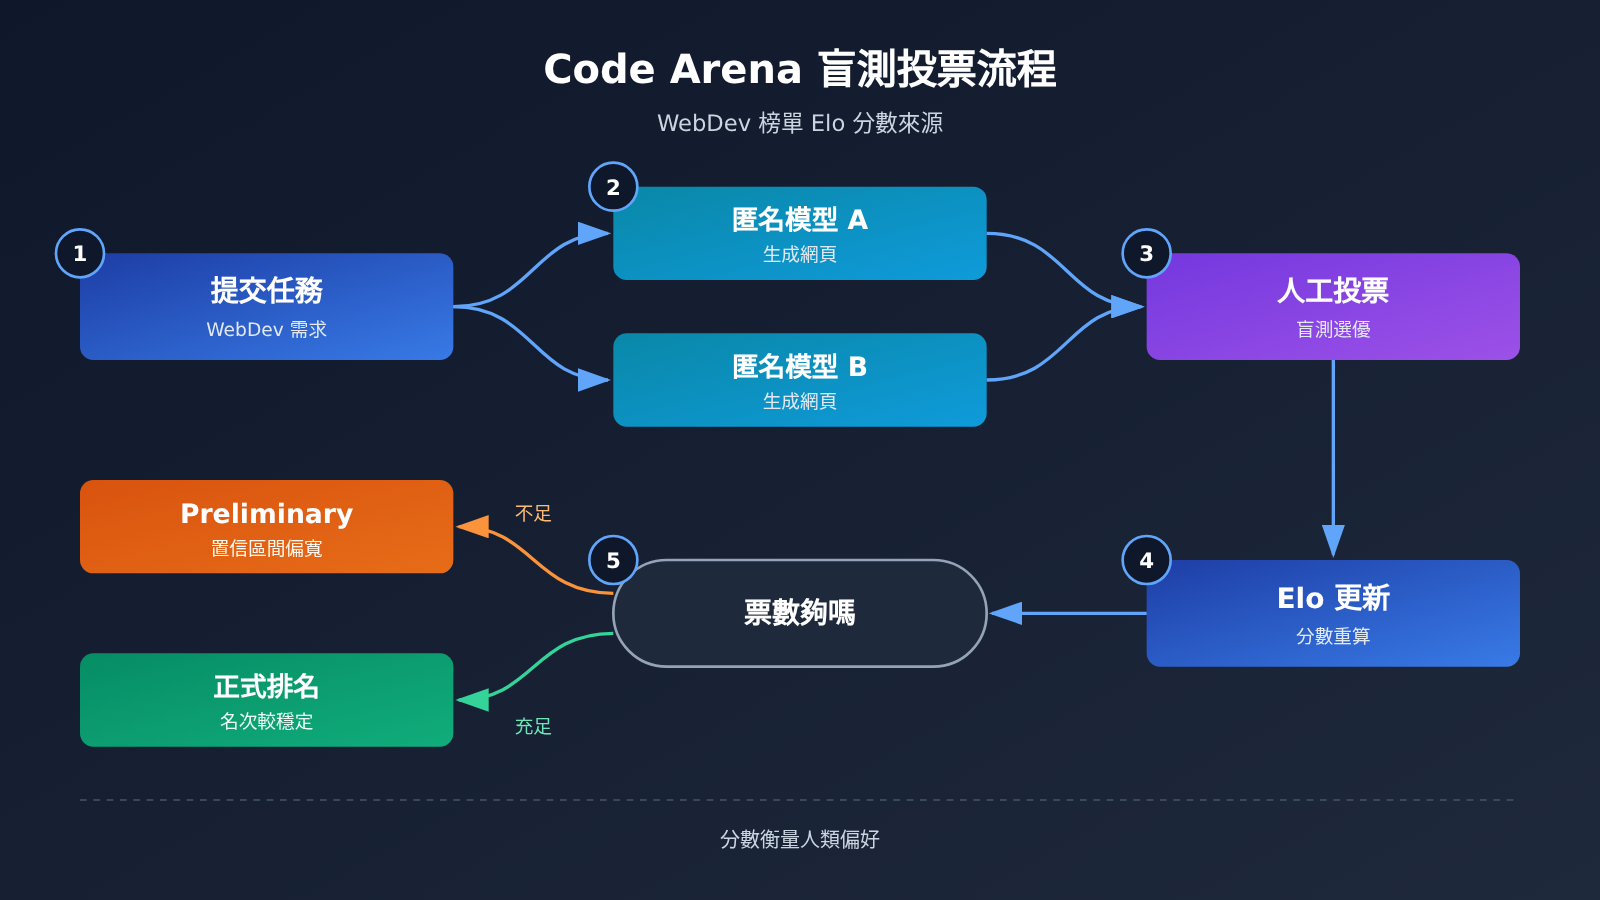
Code Arena 的 Elo 分數來自盲測人工投票:用戶給出同一個網頁開發任務,看兩個匿名模型的產出,再投票選更好的一方。分數反映的是“在人類評審眼裏誰做的網頁更好”,它衡量的是偏好,而不是一份綜合生產力總分。
Preliminary 標記的含義也要讀懂。它說明該模型參與對戰的次數還不夠多,置信區間偏寬。同榜第 4 名的 Gemini 4 Carbon (High) 也帶着這個標記,所以第 4 到第 6 這一段,未來幾周出現位置交換並不意外。
Code Arena WebDev 前六是誰:Qwen4-Max 的對手格局
把前十完整列出來,能更直觀地看到 Qwen4-Max 所處的位置。前五被三家美國實驗室佔滿,其中 Anthropic 一家就拿了三席。
| 排名 | 模型 | 分數 | 所屬實驗室 | 備註 |
|---|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 | Anthropic | 榜首 |
| 2 | Claude Opus 5.5 (Max) | 1816 | Anthropic | 單任務 P50 $8.99 |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 | Anthropic | — |
| 4 | Gemini 4 Carbon (High) | 1768 | Preliminary | |
| 5 | GPT-6 Astra (Max) | 1763 | OpenAI | 單任務 P50 $9.43 |
| 6 | Qwen4-Max (xHigh) | 1750 | 阿里 | Preliminary,1,814 票 |
| 7 | Claude Fable 5.1 (Max) | 1743 | Anthropic | — |
| 8 | GPT-6.1 Sol (Max) | 1742 | OpenAI | — |
| 9 | Muse Wonder Full (Max) | 1724 | — | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 | Anthropic | — |
前五格局對 Qwen4-Max 意味着什麼
前六中 Anthropic 佔 3 席(Fable 5.2、Opus 5.5、Sonnet 5.5),Google 和 OpenAI 各 1 席,阿里 1 席。換句話說,Qwen4-Max 是在三家頭部實驗室的旗艦之間“擠”出了一個位置,而不是在一個鬆散的榜上撿到名次。
另一個值得注意的細節是,第 6 到第 8 名非常密集:1750、1743、1742,三者相差不到 10 分。Qwen4-Max 領先 Claude Fable 5.1 和 GPT-6.1 Sol 的幅度,小於它落後 GPT-6 Astra 的 13 分。名次的穩定性,要等票數漲上去之後再看。
Qwen4-Max 在國產模型裏的位置
如果只看國產陣營,Qwen4-Max 的領先就比較明顯了。它是國產模型中唯一一個進入前十的,第二名要到第 13 位纔出現。
| 國產排名 | 模型 | 分數 | 榜單名次 | 與 Qwen4-Max 差距 |
|---|---|---|---|---|
| 1 | Qwen4-Max (xHigh) | 1750 | 第 6 | — |
| 2 | Kimi K3.1 Pro (Max) | 1686 | 第 13 | −64 |
| 3 | Qwen3.8-Max (0902) | 1676 | 第 16 | −74 |
| 4 | Qwen3.8-Max | 1670 | 第 18 | −80 |
| 5 | Ernie 5.5 Flash Preview | 1668 | 第 18 | −82 |
| 6 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 | 第 19 | −89 |
| 7 | Kimi K3 (Max) | 1658 | 第 20 | −92 |
| 8 | MiMo-V2.6-Flash | 1639 | 第 26 | −111 |
| 9 | Hy4 preview | 1632 | 第 27 | −118 |
| 10 | GLM-5.3 (Max) | 1622 | 第 31 | −128 |
| 11 | DeepSeek-V4.1-Flash-20260910 | 1621 | 第 33 | −129 |
國產內部差距的兩層含義
第一層是代際躍升。Qwen4-Max 比自家上一代 Qwen3.8-Max (0902) 高 74 分,名次從第 16 跳到第 6。在同一個榜、同一套投票機制下,這個提升幅度比較可觀。
第二層是與國產第二名的距離。Qwen4-Max 比 Kimi K3.1 Pro 高 64 分,這個差距接近它落後 Opus 5.5 的 66 分。也就是說,Qwen4-Max 目前站在國產陣營和全球頭部之間的中間位置:往下拉開了國產對手,往上離榜首還有一段路。
需要提醒的是,國產第 2 到第 7 名擠在 1686 到 1658 之間,分差很小。用這張榜給這幾家排先後,意義不大。
Qwen4-Max 跟全球頭部差多少
Code Arena WebDev 上的分差
把 Qwen4-Max 與頭部模型的分差列出來,並按通用 Elo 公式(400 分尺度)粗估“對戰勝率”,可以幫助理解這些分差的實際含義。arena 的具體統計方法可能與標準 Elo 有出入,下列勝率只作直覺參考:
- 對第 5 名 GPT-6 Astra:1750 vs 1763,差 13 分,粗估對戰勝率約 48%,基本屬於勢均力敵。
- 對第 2 名 Opus 5.5:差 66 分,粗估對戰勝率約 41%。
- 對第 1 名 Fable 5.2:差 76 分,粗估對戰勝率約 39%。
- 對國產第二 Kimi K3.1 Pro:領先 64 分,粗估對戰勝率約 59%。
整張榜的分數範圍是 1071 到 1826。在這個尺度上,Qwen4-Max 與榜首的 76 分差距不算大,但也說明在網頁開發偏好上,Anthropic 的頭部模型依然更受評審青睞。
同圖其他基準:Elo 高不等於終端任務強
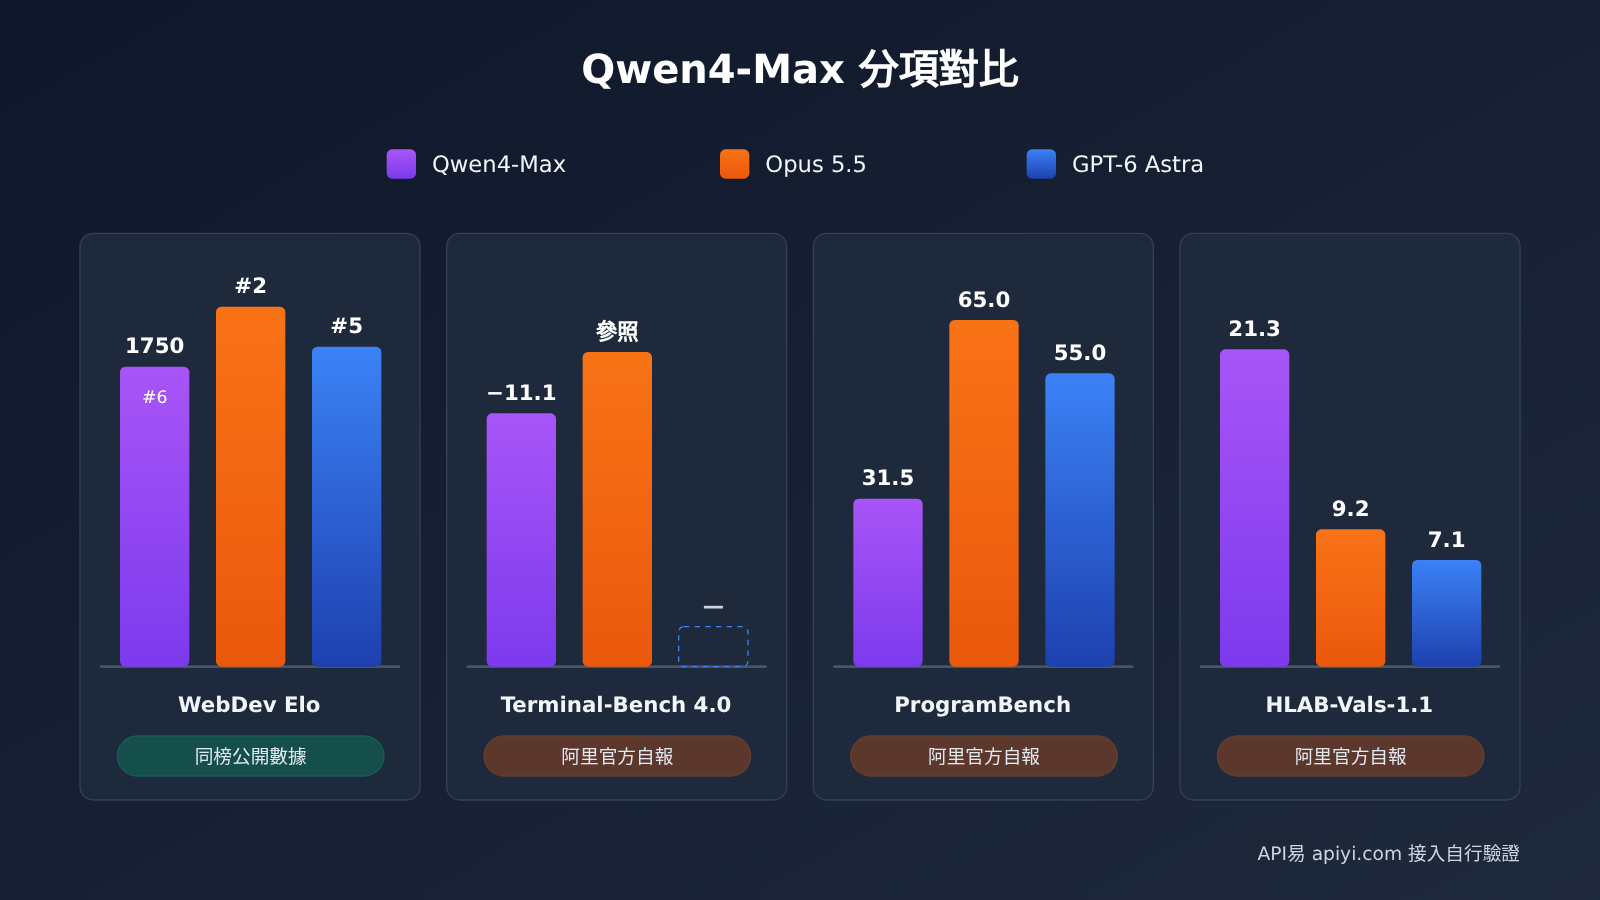
阿里發佈 Qwen4-Max 時用的是一張多基準同圖。以下數據均爲阿里官方自報,並非 arena 榜單數據,也不是第三方復現結果。
| 基準(官方自報) | Qwen4-Max | Opus 5.5 | GPT-6 Astra | 其他 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 48.5 | 59.6 | 59.1 | Kimi 67.2 |
| ProgramBench | 31.5 | 65.0 | 55.0 | — |
| JobBench | 68.5 | 75.4 | — | — |
| HLAB-Vals-1.1 | 21.3 | 9.2 | 7.1 | — |
| AA-Briefcase v1.1 Elo | 1686 | 1801 | 1569 | — |
這張表能說明一件關鍵的事:Qwen4-Max 在網頁開發盲測裏分數很高,但在終端操作類和工程編程類基準上差距仍然明顯。Terminal-Bench 4.0 上,它比 Opus 5.5 低 11.1 分,圖中 Kimi 模型的 67.2 甚至更高;ProgramBench 上,它的 31.5 還不到 Opus 5.5 的一半。
它也有明顯領先的項目。HLAB-Vals-1.1 上 Qwen4-Max 拿到 21.3,遠高於 Opus 5.5 的 9.2 和 GPT-6 Astra 的 7.1;AA-Briefcase 上它也高於 GPT-6 Astra。所以更準確的描述是:Qwen4-Max 的能力分佈與頭部模型不同,而不是“全面接近”。
Qwen4-Max 的票數與成本怎麼讀
票數:1,814 票意味着什麼
名次能不能站穩,很大程度取決於票數。Qwen4-Max 的 1,814 票,在約 100 萬總票數中佔比不到 0.2%,與同榜幾個國產模型相比也少很多。
| 模型 | 名次 | 票數 | 單任務成本 P50 | 狀態 |
|---|---|---|---|---|
| Qwen4-Max (xHigh) | 第 6 | 1,814 | $4.18 | Preliminary |
| Kimi K3.1 Pro (Max) | 第 13 | 5,215 | $0.89 | — |
| Qwen3.8-Max (0902) | 第 16 | 23,030 | $1.91 | — |
| Claude Opus 5.5 (Max) | 第 2 | 同榜公開數據 | $8.99 | — |
| GPT-6 Astra (Max) | 第 5 | 同榜公開數據 | $9.43 | — |
Qwen3.8-Max 的票數是 Qwen4-Max 的約 12.7 倍,它的分數更接近“穩定值”。Qwen4-Max 的 1750 分目前更像一個早期讀數,後續可能上調也可能下調。引用這個名次時,最好同時寫出“Preliminary、1,814 票、2026-11-14”這三個限定。
單任務成本 P50:不是模型單價
榜上的單任務成本 P50 是指在該榜任務上,單次任務花費的中位數。它受模型輸出長度、推理強度檔位(如 xHigh、Max)影響很大,不能當作模型的每百萬 tokens 單價來比較。
按這個口徑,Qwen4-Max 的 $4.18 約爲 Opus 5.5($8.99)的 46%、GPT-6 Astra($9.43)的 44%,但約是 Kimi K3.1 Pro($0.89)的 4.7 倍、上一代 Qwen3.8-Max($1.91)的 2.2 倍。如果你的場景對單次成本敏感,Kimi K3.1 Pro 用約五分之一的成本拿到了 1686 分,這同樣值得納入評估。
Qwen4-Max 官方價與 API易 現價
以下爲每 1M tokens 價格,取數日期爲 2026-11-16:
- Qwen4-Max 官方價:輸入 $1.5,輸出 $4.5,緩存讀 $0.075。
- API易 在售 Qwen 旗艦
qwen3.8-max:輸入 $1.65,輸出 $4.95,緩存讀 $0.20625。
需要說明,API易 目前尚未上架 qwen4-max,我們會盡快上架這個模型。兩者屬於不同型號,上面的價格不能直接橫向比較,實際可用型號與價格請以 API易 apiyi.com 平臺型號列表爲準。
複覈榜單、對價格、換接入點的三步
讀完一張榜,開發者通常會做三件事:覈對名次、覈對價格、把模型接進自己的項目試一試。建議按下面的順序來:
- 複覈榜單:打開 arena.ai 的 Code Arena WebDev 頁面,確認日期、票數和 Preliminary 標記是否有變化。
- 對價格:在 API易 apiyi.com 的型號列表中查看當前在售的 Qwen 型號與實時價格,確認
qwen4-max是否已上架。 - 換接入點:在現有 OpenAI 兼容 SDK 中,把 base_url 改爲
https://api.apiyi.com/v1,模型 ID 先填qwen3.8-max,待新型號上架後再切換爲qwen4-max做對照。
🚀 快速上手建議:如果你想在自己的 WebDev 任務上驗證 Qwen 系列與 Claude、GPT、Gemini 的差距,可以通過 API易 apiyi.com 用一個 API Key 統一調用多家模型,新用戶有免費測試額度,適合先跑一批小樣本再決定選型。
Qwen4-Max 優缺點分析
Qwen4-Max 的優勢
- 網頁開發偏好分領先國產陣營:1750 分,比國產第二高 64 分,比上一代高 74 分。
- 與頭部的部分差距已經很小:距第 5 名 GPT-6 Astra 僅 13 分,與第 7、8 名幾乎持平。
- 單任務成本低於頭部旗艦:P50 $4.18,不到 Opus 5.5 和 GPT-6 Astra 的一半。
- 部分基準有獨特優勢:HLAB-Vals-1.1 官方自報分數明顯領先 Opus 5.5 與 GPT-6 Astra。
Qwen4-Max 的侷限
- 名次尚未穩定:Preliminary 標記加 1,814 票,引用時需要註明限定條件。
- 終端與工程編程類基準落後:Terminal-Bench 4.0 與 ProgramBench 上明顯低於 Opus 5.5 和 GPT-6 Astra,做 Agent 或命令行自動化時需要單獨評估。
- 單任務成本高於部分國產模型:比 Kimi K3.1 Pro 和 Qwen3.8-Max 貴不少,成本敏感場景未必划算。
什麼時候不該只看 Code Arena WebDev 榜
如果你的主要場景是終端操作、長鏈路代碼修改或多步 Agent 任務,只看 WebDev Elo 就會高估 Qwen4-Max 的實際表現,此時 Terminal-Bench 一類的基準更貼近需求。同樣,如果預算是硬約束,應該把單任務成本與分數一起看,而不是隻追名次。這張榜最適合回答的問題是:“在人類評審眼裏,誰做出的網頁更好。”
常見問題 FAQ
Q1: Qwen4-Max 在 Code Arena WebDev 榜第 6 是真名次嗎?
是榜單頁面上顯示的真實名次(2026-11-14,Overall 分類,1750 分)。但它帶有 Preliminary 標記,只有 1,814 票,後續名次仍可能變化,引用時建議註明這些條件。
Q2: Qwen4-Max 和 GPT-6 Astra、Opus 5.5 差多少?
在 Code Arena WebDev 上,Qwen4-Max 比 GPT-6 Astra 低 13 分,比 Opus 5.5 低 66 分,比榜首 Fable 5.2 低 76 分。但在阿里官方自報的 Terminal-Bench 4.0 和 ProgramBench 上,它與這兩個模型的差距明顯更大。
Q3: Qwen4-Max 在國產模型裏領先多少?
它是唯一進入前十的國產模型,比國產第二 Kimi K3.1 Pro(第 13,1686 分)高 64 分,比自家上一代 Qwen3.8-Max (0902) 高 74 分。
Q4: Qwen4-Max 最適合哪些場景?
從這張榜的口徑看,它更適合網頁前端生成、落地頁與交互原型這類 WebDev 任務。終端自動化、大型工程級代碼修改等場景,建議參考終端類基準並自行跑樣本驗證。
Q5: 如何通過 API 調用 Qwen 系列模型做對比測試?
可以在 API易 apiyi.com 註冊並獲取 API Key,在 OpenAI 兼容 SDK 中將 base_url 設爲 `https://api.apiyi.com/v1`,模型 ID 填 `qwen3.8-max`。`qwen4-max` 目前暫未上架,我們會盡快上架,上架後改一個模型 ID 即可切換對照。
Q6: 單任務成本 $4.18 是 Qwen4-Max 的價格嗎?
不是。$4.18 是榜單統計的單任務成本中位數(P50),受輸出長度和推理檔位影響。模型單價應看每 1M tokens 的輸入、輸出和緩存讀價格,實時價格可在 API易 apiyi.com 型號列表中核對。
Qwen4-Max Code Arena WebDev 核心要點 Key Takeaways
- 名次:2026-11-14 榜單第 6,1750 分,國產首次進入前六。
- 格局:前五被 Anthropic 三席、Google 一席、OpenAI 一席佔滿。
- 穩定性:Preliminary 標記加 1,814 票,名次仍會變動。
- 國產差距:領先 Kimi K3.1 Pro 64 分,領先上一代 74 分。
- 能力邊界:Terminal-Bench 與 ProgramBench 官方自報仍落後頭部。
- 成本口徑:P50 $4.18 是單任務中位數,不是模型單價。
- 上手方式:可先在 API易 用
qwen3.8-max搭好對比流程,待新型號上架再切換。
總結
Qwen4-Max 在 Code Arena WebDev 榜上的表現可以概括爲三點:
- 第一次進前六:1750 分,前六中唯一非美國實驗室模型,離第 5 名只差 13 分。
- 名次尚是早期讀數:Preliminary、1,814 票,引用時要寫清日期和票數。
- Elo 不等於全面強:官方自報的終端類與工程編程基準上,仍落後 Opus 5.5 與 GPT-6 Astra。
如果你在做選型,建議把這張榜當作“網頁開發偏好”的一個參考維度,再結合自己的任務樣本和成本預算做判斷。推薦通過 API易 apiyi.com 用統一接口把候選模型放在同一批任務上對比,用自己的數據給出結論。
📚 參考資料
- arena.ai Code Arena WebDev 榜:本文名次、分數、票數與單任務成本的來源
- 鏈接:
arena.ai -
說明: 頁面標註 2026-11-14,Overall 分類,可自行覈對最新名次與 Preliminary 標記
-
阿里 Qwen4-Max 官方發佈圖:Terminal-Bench 4.0、ProgramBench 等基準分數來源
- 鏈接: 以 Qwen 官方發佈渠道爲準
- 說明: 文中相關數據均爲官方自報,非第三方復現
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 網站首頁聯繫我們,型號上架與接入說明可訪問 docs.apiyi.com 文檔中心


