
作者注:同爲 2.4T 級旗艦,Qwen4-Max 掛牌價降 25%、輸出上限約翻三倍、同任務 token 少兩到三成。本文拆解架構、官方自報跑分與兩代掛牌價,並給出從 qwen3.8-max 遷移的檢查清單。
2026-11-16,阿里發佈 Qwen4-Max。先說結論:相比 Qwen3.8-Max,新一代 輸入、輸出掛牌價各降 25%,最大輸出從 128K 提到 393K,約翻三倍,在官方的 Work360 評測裏 同任務 token 用量少兩到三成。對已經在生產裏跑 qwen3.8-max 的團隊,這次升級值得認真評估,但不需要推倒重來。
這不是一篇“新一代全面碾壓”的宣傳稿。下文跑分一律標註爲官方自報,第三方榜單標註爲公開榜快照(2026-11-14)。兩處容易被誇大的數字,即 62% 的單任務成本降幅和 Arena 第 6 名,會單獨拆開講。
核心價值:讀完你能判斷三件事:省下來的錢有幾成是真的,哪些基準漲得明顯、哪些幾乎沒動,以及遷移時除了換模型 ID 還要動什麼。另外,如果你通過 API易 apiyi.com 調用,截至 2026-11-16 11:00 平臺還沒有上架 qwen4-max,現階段繼續用 qwen3.8-max 即可,我們會盡快上架這個模型。
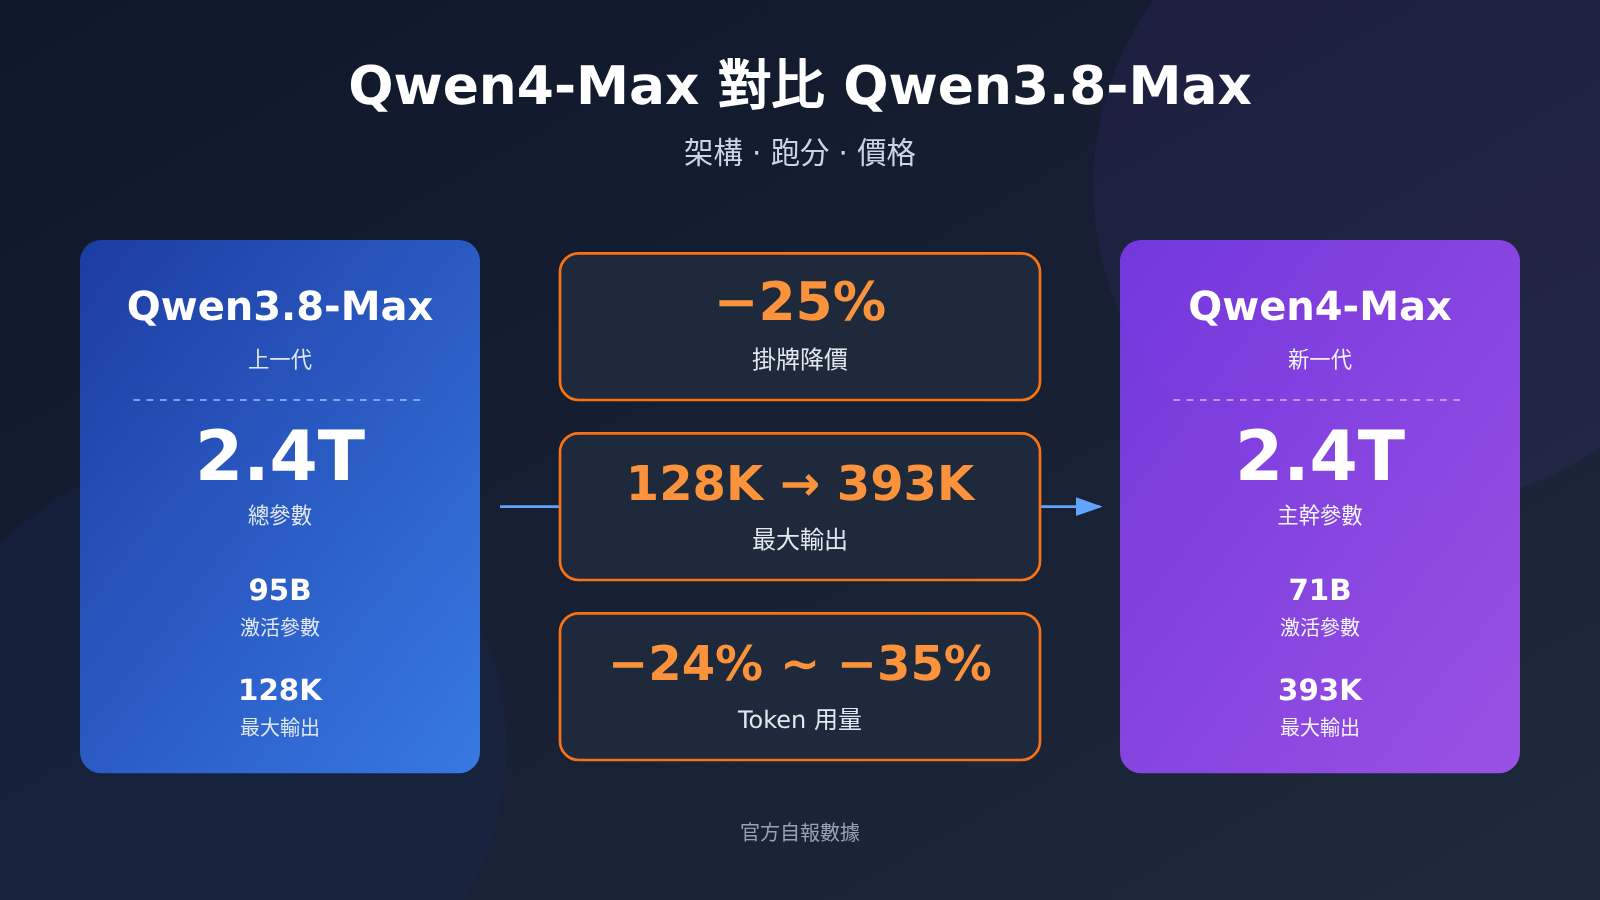
Qwen4-Max 對比 Qwen3.8-Max 核心差異速覽
兩代模型的總規模處在同一檔,但 Qwen4-Max 在激活參數、輸出上限和默認推理檔位上都做了調整。下表先把規格層面的差異擺在一起,價格單獨放在後面的成本章節。
| 對比維度 | Qwen3.8-Max | Qwen4-Max | 變化 |
|---|---|---|---|
| 參數規模 | 2.4T 總參數 | 2.4T 主幹 + 328B N-gram Embedding | 主幹同級,新增嵌入表 |
| 每次激活 | 95B | 71B | 約少 25% |
| 上下文 | 1M | 1M(最大輸入 991K,思考模式 983K) | 輸入上限略收緊 |
| 最大輸出 | 128K | 393K | 約 3 倍 |
| 最大思維鏈 | 官方未單列 | 262K | 新增明確上限 |
| 默認 reasoning_effort | xhigh | high | 默認檔下調一級 |
| 視覺能力 | 支持圖片輸入 | 原生視覺 | 視覺成爲原生能力 |
| 開放權重 | Qwen3.8-2.4T-A95B | 資料中未提及 | — |
從這張表能看出這次升級的思路:總規模不變,單次計算更省,輸出空間放大。激活參數從 95B 降到 71B,是掛牌價能下調的底層前提;最大輸出放到 393K,則直接改變了長報告、大段代碼生成這類任務的可行性。
需要提醒的是,默認 reasoning_effort 從 xhigh 變成 high。如果你的代碼沒有顯式設置這個參數,換模型 ID 後實際跑的推理檔位會變,這一點在遷移清單裏會再強調。
Qwen4-Max 架構改動:三項變化如何影響使用
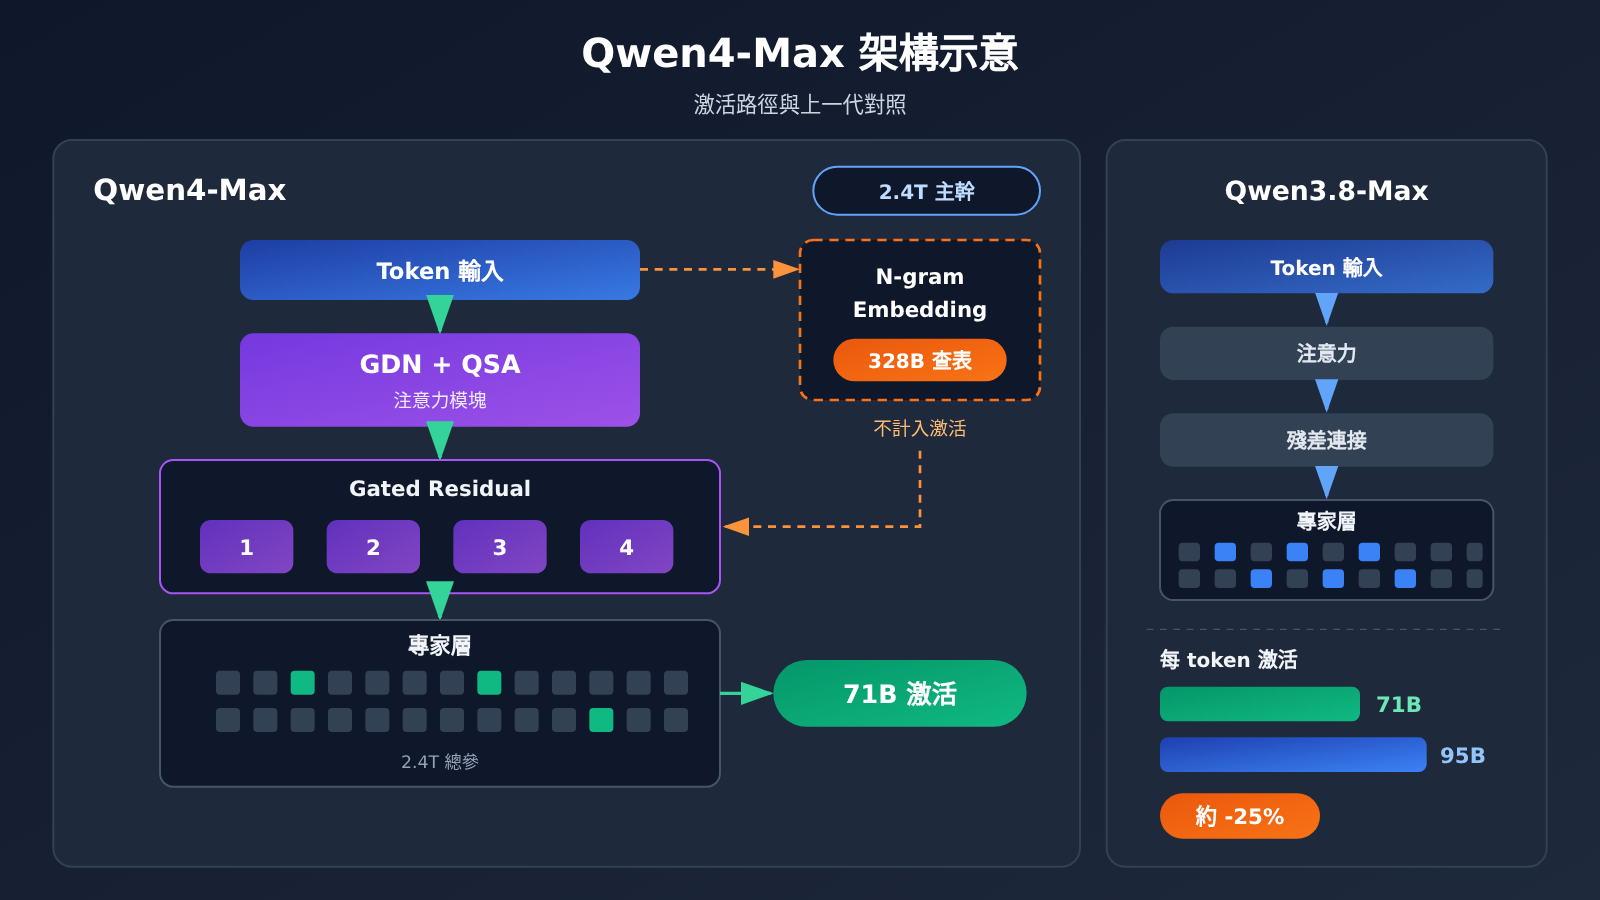
官方博客把 Qwen4-Max 的架構改動歸納爲三項:GDN + QSA、Gated Residual 四條分支、N-gram Embedding。對 API 使用者來說,沒必要逐層理解實現細節,但需要知道這三項改動分別影響什麼。
GDN + QSA:注意力層面的改動
這是注意力結構上的調整。官方將其與 1M 上下文、393K 最大輸出放在一起介紹,我們的理解是它主要服務於長序列場景下的計算效率。對調用方而言,可以直接感知到的結果是:同樣的 1M 上下文窗口,Qwen4-Max 能吐出更長的輸出,單價反而更低。
Gated Residual 四條分支
殘差連接被擴展爲帶門控的四條分支。這類改動通常影響訓練穩定性和不同能力之間的信息流動,最終體現在模型行爲上。實際影響是,即使 prompt 完全不變,Qwen4-Max 的輸出風格、推理步驟長短也可能與上一代不同,所以針對 Qwen3.8-Max 精調過的提示詞需要回歸測試。
N-gram Embedding:328B 參數不等於計算量
Qwen4-Max 的參數寫法是“2.4T 主幹 / 71B 激活 + 328B N-gram Embedding”。按常見設計,這類嵌入屬於查表式參數,不計入每個 token 的主幹激活計算,所以不能把 328B 直接加到激活量上比較。真正與推理成本相關的是 71B 對 95B,也就是每次激活少約 25%。
預訓練層面,官方給出 Qwen4-Max-Base 在知識、代碼、問答、STEM 四類內部評測上的 BPB(每字節比特數,越低越好)全部最低,比 Qwen3.8-Max-Base 低約 5–13%。這是官方內部評測,但它至少說明基座本身有提升,後面的跑分提升並非只靠後訓練。
Qwen4-Max 跑分對比:哪些漲得多,哪些幾乎沒動
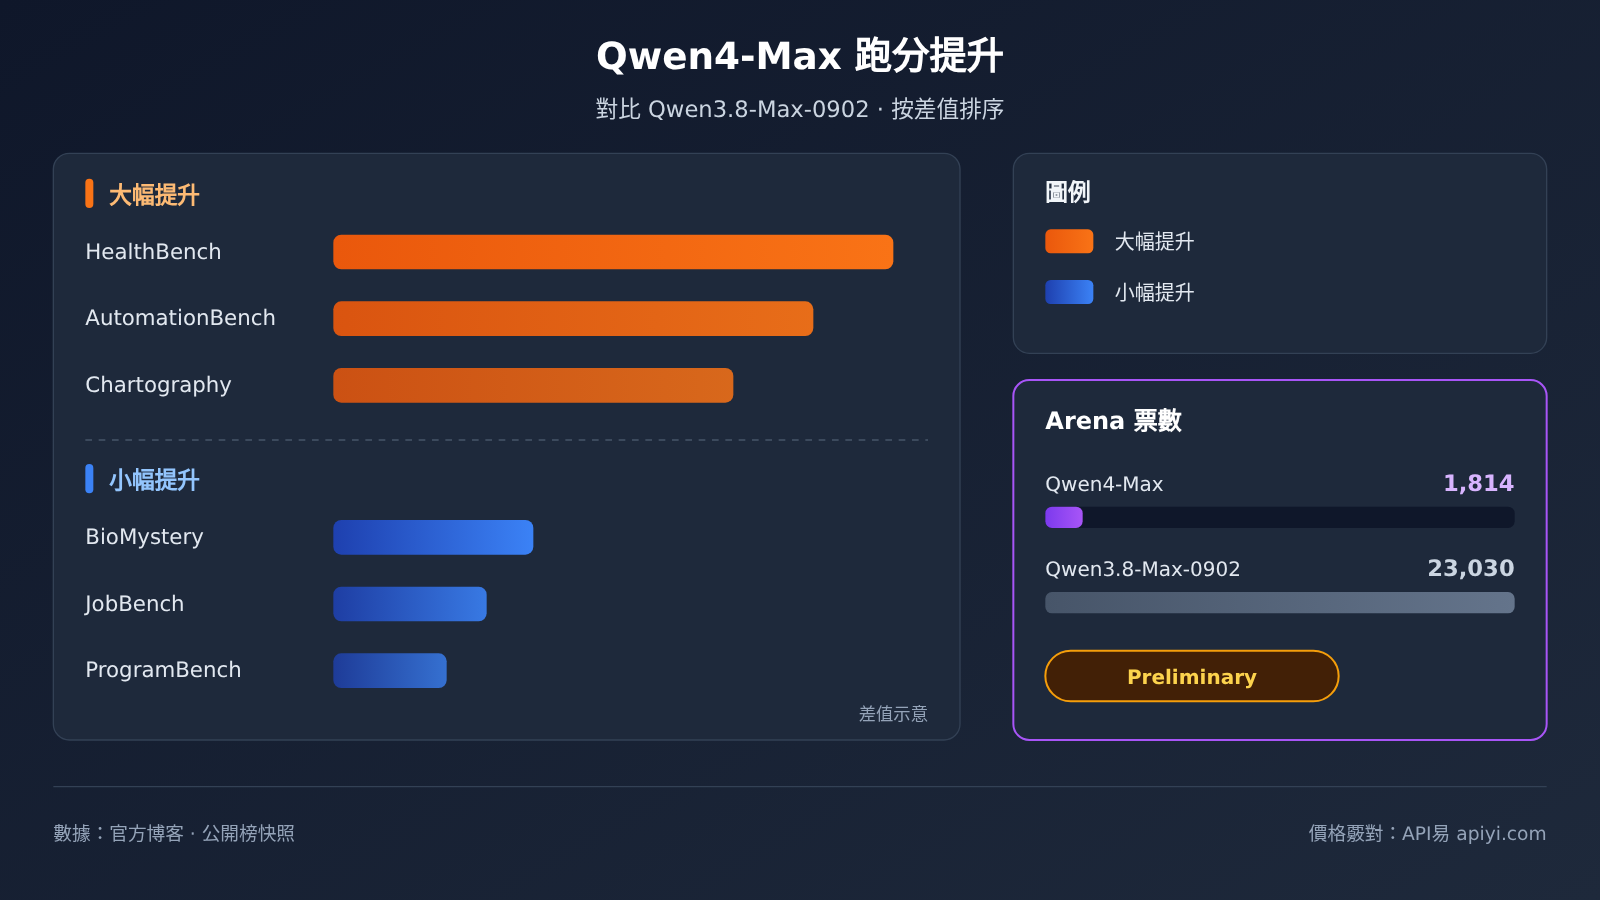
以下數據全部來自阿里同一張對照圖,爲官方自報,對比對象是 Qwen3.8-Max-0902(9 月刷新版)。我們按提升幅度從大到小排列,方便直接看出升級收益集中在哪裏。
| 基準(官方自報) | Qwen3.8-Max-0902 | Qwen4-Max | 差值 | 提升幅度判斷 |
|---|---|---|---|---|
| AA-Briefcase | 1605 | 1686 | +81 | 明顯 |
| CodeArena | 1676 | 1750 | +74 | 明顯 |
| HealthBench | 39.6 | 60.0 | +20.4 | 非常明顯 |
| AutomationBench | 56.2 | 72.5 | +16.3 | 非常明顯 |
| Chartography | 42.0 | 54.2 | +12.2 | 明顯 |
| Terminal-Bench | 38.9 | 48.5 | +9.6 | 明顯 |
| APEX-Agents | 63.3 | 72.1 | +8.8 | 明顯 |
| HLE | 43.9 | 51.7 | +7.8 | 明顯 |
| DeepSWE | 69.3 | 75.7 | +6.4 | 中等 |
| HLAB-Vals | 15.4 | 21.3 | +5.9 | 中等 |
| Video-Index | 63.2 | 68.1 | +4.9 | 中等 |
| ProgramBench | 28.0 | 31.5 | +3.5 | 較小 |
| JobBench | 65.3 | 68.5 | +3.2 | 較小 |
| BioMystery | 84.1 | 85.0 | +0.9 | 幾乎沒動 |
提升最集中的是智能體與工具調用類任務:AutomationBench +16.3、Terminal-Bench +9.6、APEX-Agents +8.8。如果你的業務是多輪工具調用、終端操作或自動化流程,這是升級收益最大的方向。HealthBench 從 39.6 漲到 60.0,Chartography 漲 12.2,說明醫療問答與圖表理解也是這一代的重點。
另一端,BioMystery 只漲 0.9,JobBench 和 ProgramBench 漲 3 個點出頭。這幾類任務上升級的邊際收益有限,如果你的主力場景恰好與之接近,單靠跑分不足以支撐升級決策,更應該看成本。官方另外給出的 Work360 爲 52.69 對 47.74,高 4.95,也屬於中等提升。
安全方面,官方給出 Last Secure Code Bench 的函數級雙通過率從 22.0% 提到 31.8%,三粒度同時安全從 8% 提到 14.7%。絕對值依然不高,生成代碼仍要做安全審查,但相對提升明顯。
Arena 第三方榜:1,814 票的 Preliminary 名次
官方的 CodeArena 1750 分,在第三方的 arena.ai Code Arena WebDev 榜上也能看到。以下爲公開榜快照,2026-11-14:
- Qwen4-Max(xHigh):1750 分,第 6 名,標註 Preliminary,1,814 票,$4.18/任務
- Qwen3.8-Max(0902):1676 分,第 16 名,23,030 票,$1.91/任務
- Qwen3.8-Max:1670 分,第 18 名
這裏第二處容易被誇大的地方是:Qwen4-Max 只有 1,814 票,上一代 0902 版有 23,030 票,相差約 12 倍。帶 Preliminary 標記意味着排名仍在收斂,第 6 名還會變動,現在引用時最好寫成“初步排名第 6”。
快照裏還有一個細節值得注意:Qwen4-Max 以 xHigh 檔參賽,每任務成本 $4.18,高於 Qwen3.8-Max 0902 的 $1.91。這與官方“單任務成本下降”的說法並不矛盾,因爲測的檔位和任務類型都不同,但它提醒我們:在最高推理檔位下,Qwen4-Max 不一定更省錢。
Qwen4-Max 價格與成本:省下來的錢有幾成是真的
升級說到底就是換模型,決定之前要先對價格。下表列出兩代官方掛牌價與 API易 當前在售的 qwen3.8-max 價格,單位均爲每 1M tokens,取數日期爲 2026-11-16。
| 計費項(每 1M tokens) | Qwen3.8-Max 官方(新加坡區) | Qwen4-Max 官方 | Qwen4-Max 官方人民幣 | API易 qwen3.8-max 現價 |
|---|---|---|---|---|
| 輸入 | $2 | $1.5 | ¥10 | $1.65 |
| 輸出 | $6 | $4.5 | ¥30 | $4.95 |
| 緩存讀 | $0.25 | $0.075 | ¥0.5 | $0.20625 |
| 緩存寫(5 分鐘) | 官方博客未列出 | $1.875 | ¥12.5 | 文檔未單列 |
| 緩存寫(1 小時) | 官方博客未列出 | $3 | ¥20 | 文檔未單列 |
輸入、輸出各降 25%,緩存讀從 $0.25 降到 $0.075,降幅約 70%,這是本次調價裏最大的一項。另一方面,Qwen4-Max 明確列出了 5 分鐘和 1 小時兩檔緩存寫入價格,高頻複用長前綴的應用需要把這部分寫入成本算進預算。
token 節省:兩到三成看 Work360,四到五成看 Terminal-Bench
官方給出的 token 節省有兩組數據。Work360 上,Xhigh 檔少 24%,High 檔少 35%,這就是“省兩到三成”的出處;Terminal-Bench 4.0 上更誇張,分別少 48% 和 49%。
終端類任務的節省幅度明顯更大,可能與這類任務中工具輪次減少有關。做預算時,通用辦公類任務按兩到三成估算更穩妥,四到五成只適用於與 Terminal-Bench 類似的終端操作場景。
62% 與 51% 對不上的那 11 個點
這是第一處容易被誇大的地方。官方給出單任務成本從 $4.43 降到 $1.67,按美元算約降 62%;中文口徑寫的是 ¥26.58 降到 ¥11.16,約降 58%,兩套口徑本身就有出入。
用官方自己的數據推算:token 少 35%、單價降 25%,兩者相乘只能得到約 51% 的降幅,即 0.65 × 0.75 ≈ 0.49。剩下約 11 個點官方沒有解釋。我們推斷可能來自緩存讀價格的大幅下調(約 −70%)帶來的緩存命中收益,以及工具調用輪次的減少,但這只是推斷,並非官方說明。
穩妥的做法是:把 51% 當作“同等緩存命中率下”的參考上限,62% 只在緩存命中率高、工具輪次多的場景下才可能接近。具體到你的業務,最可靠的依據是用真實流量跑一次單任務成本對比。
API易 現價與上架狀態
API易 當前在售 qwen3.8-max,輸入 $1.65、輸出 $4.95、緩存讀 $0.20625,文檔口徑比阿里雲的 $2 / $6 低 17.5%。同價的還有 qwen3.8-max-0902,開放權重版本 qwen3.8-2.4t-a95b 爲 $1.72 / $5.16 / $0.215。
2026-11-16 11:00 複覈時,qwen4-max 在 API易 模型文檔與價格列表(共 284 個型號)中都還沒有,暫未上架。我們會盡快上架這個模型,型號名稱與價格以 API易 apiyi.com 平臺型號列表爲準。坦白說,Qwen4-Max 的官方掛牌單價已經低於當前 qwen3.8-max 的平臺價,上架後值得重新對一遍賬。
從 Qwen3.8-Max 遷移到 Qwen4-Max:檢查清單
很多人以爲升級只是改一個模型 ID,實際上默認參數、上下文邊界和緩存計費都變了。下面這張清單按“不改就可能出問題”的優先級排列。
| 檢查項 | Qwen3.8-Max 現狀 | 遷移到 Qwen4-Max 後 | 建議動作 |
|---|---|---|---|
| 模型 ID | qwen3.8-max / qwen3.8-max-0902 |
以平臺型號列表爲準 | 上架後再切換,先灰度 |
| reasoning_effort 默認值 | xhigh | high | 顯式寫明檔位,避免行爲悄悄變化 |
| max_tokens 上限 | 128K | 393K | 檢查下游截斷、存儲與超時設置 |
| 最大輸入 | 1M | 991K(思考模式 983K) | 接近 1M 的超長輸入需要裁剪 |
| 緩存計費 | 緩存讀 $0.25 | 緩存讀 $0.075,另有 5 分鐘 / 1 小時寫入價 | 重新評估緩存前綴與 TTL 策略 |
| 視覺輸入 | 圖片輸入 | 原生視覺 | 圖像相關用例重新迴歸 |
| 提示詞與輸出格式 | 已針對上一代調優 | 架構改動,行爲可能不同 | 用固定評測集做迴歸 |
| 成本監控 | 按 token 計 | token 與單價同時下降 | 改看單任務成本而非單價 |
清單裏最容易被忽略的是 reasoning_effort。Qwen3.8-Max 默認 xhigh,Qwen4-Max 默認 high,如果代碼裏沒顯式設置,切換後既可能更省 token,也可能在複雜推理任務上效果不及預期。官方的 token 節省數據同時給了 Xhigh 和 High 兩檔,建議你也按這兩檔分別測,再決定線上用哪一檔。
第二個是輸出長度。393K 的上限意味着單次響應可能遠長於過去,日誌系統、數據庫字段、網關超時如果是按 128K 輸出設計的,需要提前放寬。最大輸入從 1M 收緊到 991K(思考模式 983K),平時用不滿的業務影響不大,但貼着上限塞文檔的場景會直接報錯。
通過 API易 調用的現階段做法
如果你現在通過 API易 接入,base_url 爲 https://api.apiyi.com/v1,使用 OpenAI 兼容協議,模型字段填 qwen3.8-max 即可繼續在生產中運行。需要鎖定 9 月刷新版行爲的,可以改用 qwen3.8-max-0902,價格相同。
等 qwen4-max 在平臺上架後,由於協議不變,遷移在代碼層面只需改動 model 字段,再按上面的清單補齊 reasoning_effort 和 max_tokens。建議先切 5%–10% 的流量做灰度,對比單任務成本和業務指標後再全量。
🚀 遷移建議:現在走 API易 apiyi.com 的項目,繼續用
qwen3.8-max,同時準備好評測集和灰度開關;qwen4-max上架後再換 ID,這樣不會出現“等新模型”導致業務空窗的情況。
Qwen4-Max 與 Qwen3.8-Max 場景推薦
優先評估升級 Qwen4-Max 的場景
- 多輪工具調用與自動化:AutomationBench、Terminal-Bench、APEX-Agents 都有明顯提升,token 節省在終端類任務上也最大。
- 超長輸出任務:需要單次生成超過 128K 的報告、代碼或文檔,只有 Qwen4-Max 的 393K 能滿足。
- 醫療問答與圖表理解:HealthBench +20.4、Chartography +12.2,是這一代提升最顯著的領域。
- 對代碼安全有要求:安全雙通過率從 22.0% 提到 31.8%,但仍需配合審查流程。
- 緩存複用率高的應用:緩存讀價格降約 70%,長系統提示、固定知識庫前綴的場景受益最大。
繼續使用 Qwen3.8-Max 的場景
- 線上已穩定、提示詞深度調優:Qwen3.8-Max 依然是可靠的生產模型,沒有必要爲升級而升級。
- 主力任務與 BioMystery、JobBench 類似:這些方向提升有限,遷移成本可能高於收益。
- 需要開放權重自部署:Qwen3.8-2.4T-A95B 有開放權重,資料中未提及 Qwen4-Max 的開放權重版本。
- 通過 API易 調用且需要立刻可用:
qwen4-max尚未上架期間,qwen3.8-max是現成選擇。
| 你的情況 | 建議 |
|---|---|
| 智能體、工具調用爲主,追求降本 | 優先評估 Qwen4-Max,按 High 檔實測成本 |
| 需要超過 128K 的單次輸出 | 只能選 Qwen4-Max |
| 線上穩定,主要是通用問答 | 保持 Qwen3.8-Max,空閒時做迴歸評測 |
| 需要自部署開放權重 | 繼續使用 Qwen3.8-2.4T-A95B |
| 當前走 API易 接入 | 繼續用 qwen3.8-max,上架後再灰度切換 |
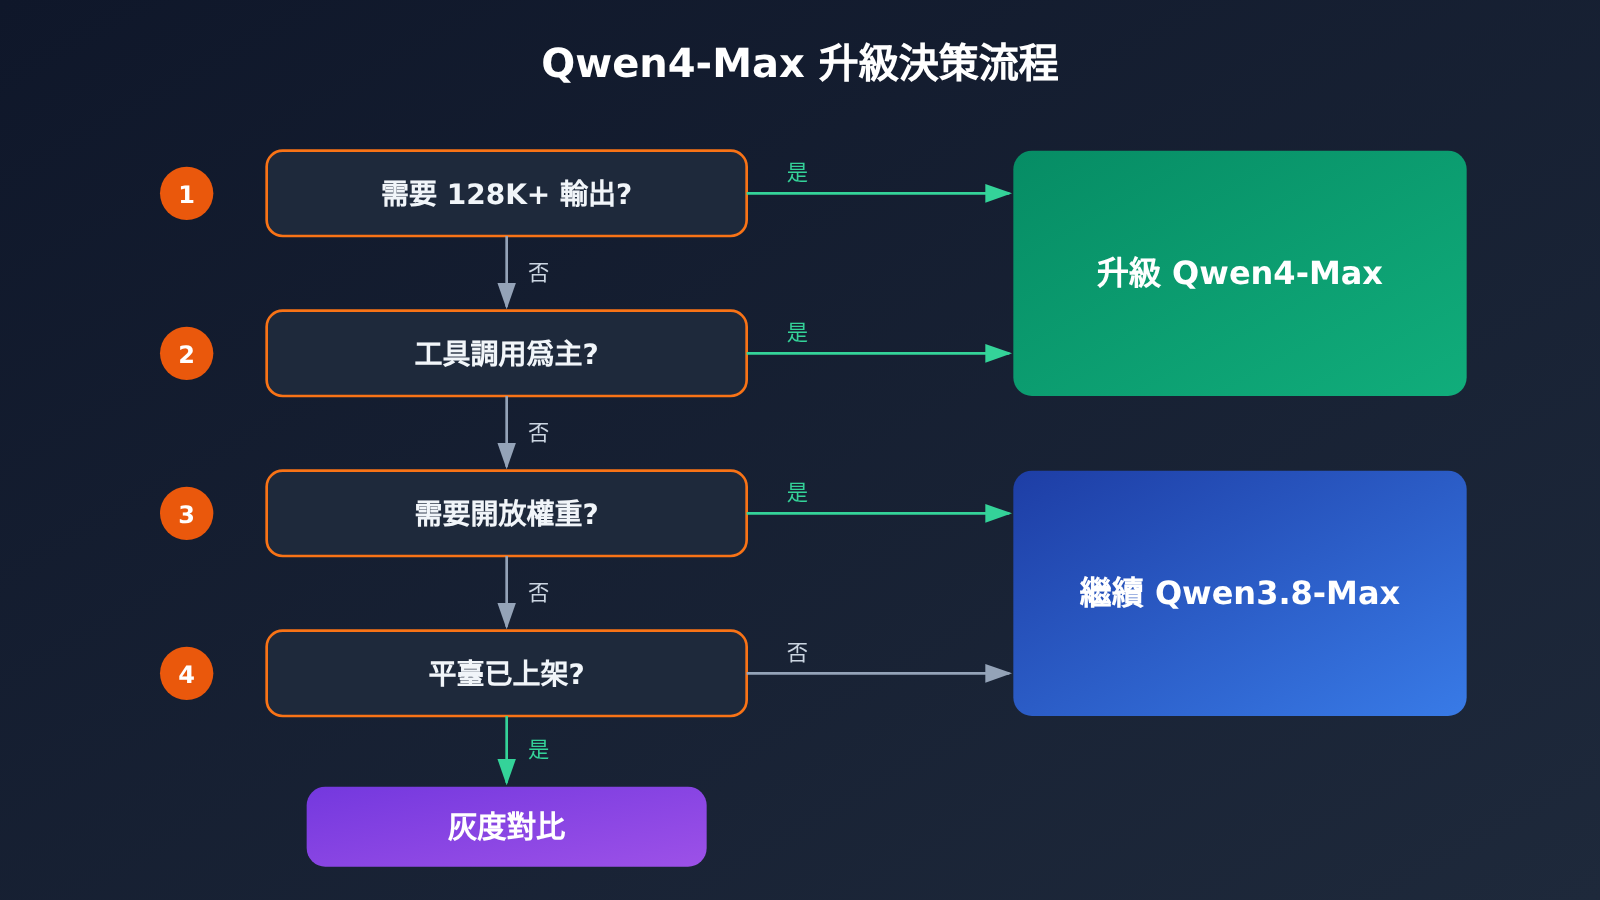
Qwen4-Max 對比 Qwen3.8-Max 決策建議
如果只看一句話:智能體、長輸出、緩存密集型業務值得升級,通用穩定業務可以不急。升級的三塊收益中,單價降 25% 是確定的,token 節省兩到三成是官方在特定評測上的數據,62% 的單任務降幅則需要你自己的緩存與工具輪次條件配合纔可能接近。
💡 選擇建議:決策之前,建議用自己的真實任務各跑一組,比較單任務成本和結果質量,而不是隻看跑分表。通過 API易 apiyi.com 可以用同一個 API Key 先跑
qwen3.8-max的基線,qwen4-max上架後直接在同一套代碼裏對比。
常見問題 FAQ
Q1:Qwen4-Max 和 Qwen3.8-Max 是什麼關係?
兩者都是通義千問的 2.4T 級旗艦。Qwen3.8-Max 於 2026-08-03 發佈,0902 是 9 月刷新版;Qwen4-Max 於 2026-11-16 發佈,換了架構,每次激活參數從 95B 降到 71B,輸出上限提到 393K,掛牌價下調 25%。
Q2:token 省兩到三成,賬單就能降兩到三成嗎?
不止,也不一定。單價本身降 25%,再疊加 token 減少,理論上同任務成本可降約 51%。但 token 節省數據來自官方 Work360 評測,你的業務能省多少要實測;如果使用 xhigh 檔,如 Arena 快照所示,單任務成本反而可能更高。
Q3:Qwen4-Max 在 Arena 排第 6,這個名次可靠嗎?
只能算初步結果。公開榜快照(2026-11-14)中 Qwen4-Max 僅有 1,814 票並標註 Preliminary,上一代 0902 有 23,030 票,相差約 12 倍。分數 1750 與官方自報一致,但名次在票數積累後還會變動。
Q4:現在能通過 API易 調用 qwen4-max 嗎?
截至 2026-11-16 11:00 還不能,`qwen4-max` 暫未上架,我們會盡快上架。目前可用 `qwen3.8-max`、`qwen3.8-max-0902` 和開放權重版 `qwen3.8-2.4t-a95b`,最新型號與價格請以 API易 apiyi.com 平臺型號列表爲準,新用戶可用免費測試額度先跑基線。
Q5:遷移時只改模型 ID 夠嗎?
不夠。至少還要顯式設置 reasoning_effort(默認值從 xhigh 變爲 high)、按需放寬 max_tokens 和下游存儲限制、檢查接近 1M 的超長輸入,並重新評估緩存寫入成本。協議層面,走 OpenAI 兼容接口 `https://api.apiyi.com/v1` 的話,代碼只需改 model 字段。
Q6:Qwen3.8-Max 還值得繼續用嗎?
值得。它仍是 2.4T 級旗艦,1M 上下文、128K 輸出、思考與非思考模式都齊全,還有開放權重版本。Qwen4-Max 在 BioMystery、JobBench 等基準上提升很小,對這類業務來說,穩定運行的 Qwen3.8-Max 完全可以繼續承擔生產流量。
Qwen4-Max 對比 Qwen3.8-Max 核心要點 Key Takeaways
- 規模同級、激活更少:2.4T 主幹不變,每次激活從 95B 降到 71B,約少 25%。
- 單價降 25%:輸入 $2→$1.5、輸出 $6→$4.5,緩存讀降約 70%,新增緩存寫計費。
- 輸出約翻三倍:最大輸出 128K→393K,最大輸入收緊到 991K。
- 漲幅集中在智能體:AutomationBench、Terminal-Bench、HealthBench 提升明顯,BioMystery 幾乎沒動。
- 兩處別誇大:62% 成本降幅只能推出約 51%,Arena 第 6 名僅 1,814 票且爲 Preliminary。
- 遷移不止換 ID:注意 reasoning_effort 默認值、max_tokens 上限與緩存策略。
- API易 現狀:
qwen4-max暫未上架,繼續用qwen3.8-max,上架後再灰度切換。
總結
Qwen4-Max 對比 Qwen3.8-Max 的核心結論:
- 成本:單價降 25% 是確定收益,token 節省兩到三成要以你的業務實測爲準,62% 降幅有約 11 個點來源未明。
- 能力:智能體、工具調用、醫療與圖表方向提升明顯,部分基準幾乎持平,跑分均爲官方自報。
- 遷移:協議不變,但默認推理檔位、輸出上限和緩存計費都變了,需要按清單逐項檢查。
Qwen3.8-Max 依然是可靠的生產模型,升級應該是一次有數據支撐的灰度決策,而不是看到新版本就全量切換。推薦先通過 API易 apiyi.com 用 qwen3.8-max 建好成本與質量基線,qwen4-max 上架後在同一接口下直接對比。
📚 參考資料
- Qwen3.8 官方博客:Qwen3.8-Max 發佈說明,含參數、上下文與官方定價
- 鏈接:
qwen.ai/blog?id=qwen3.8 -
說明:上一代規格與新加坡區價格的出處
-
Hugging Face – Qwen3.8-2.4T-A95B:Qwen3.8 開放權重版本
- 鏈接:
huggingface.co/Qwen/Qwen3.8-2.4T-A95B -
說明:需要自部署時的模型卡與權重下載
-
Qwen 官方博客:Qwen4-Max 發佈文與同圖跑分對照
- 鏈接:
qwen.ai/blog -
說明:架構改動、官方自報跑分、token 與單任務成本數據的出處
-
arena.ai Code Arena WebDev:第三方模型對戰榜
- 鏈接:
arena.ai - 說明:本文引用 2026-11-14 快照,名次隨投票數變化
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,型號與價格可在 docs.apiyi.com 文檔中心查詢


