
摘要:本文使用同一套工作負載,計算 Prompt Caching 在緩存寫入、緩存讀取、動態輸入和輸出四個部分的費用,並說明命中率、TTL 與調用節奏如何影響實際節省。
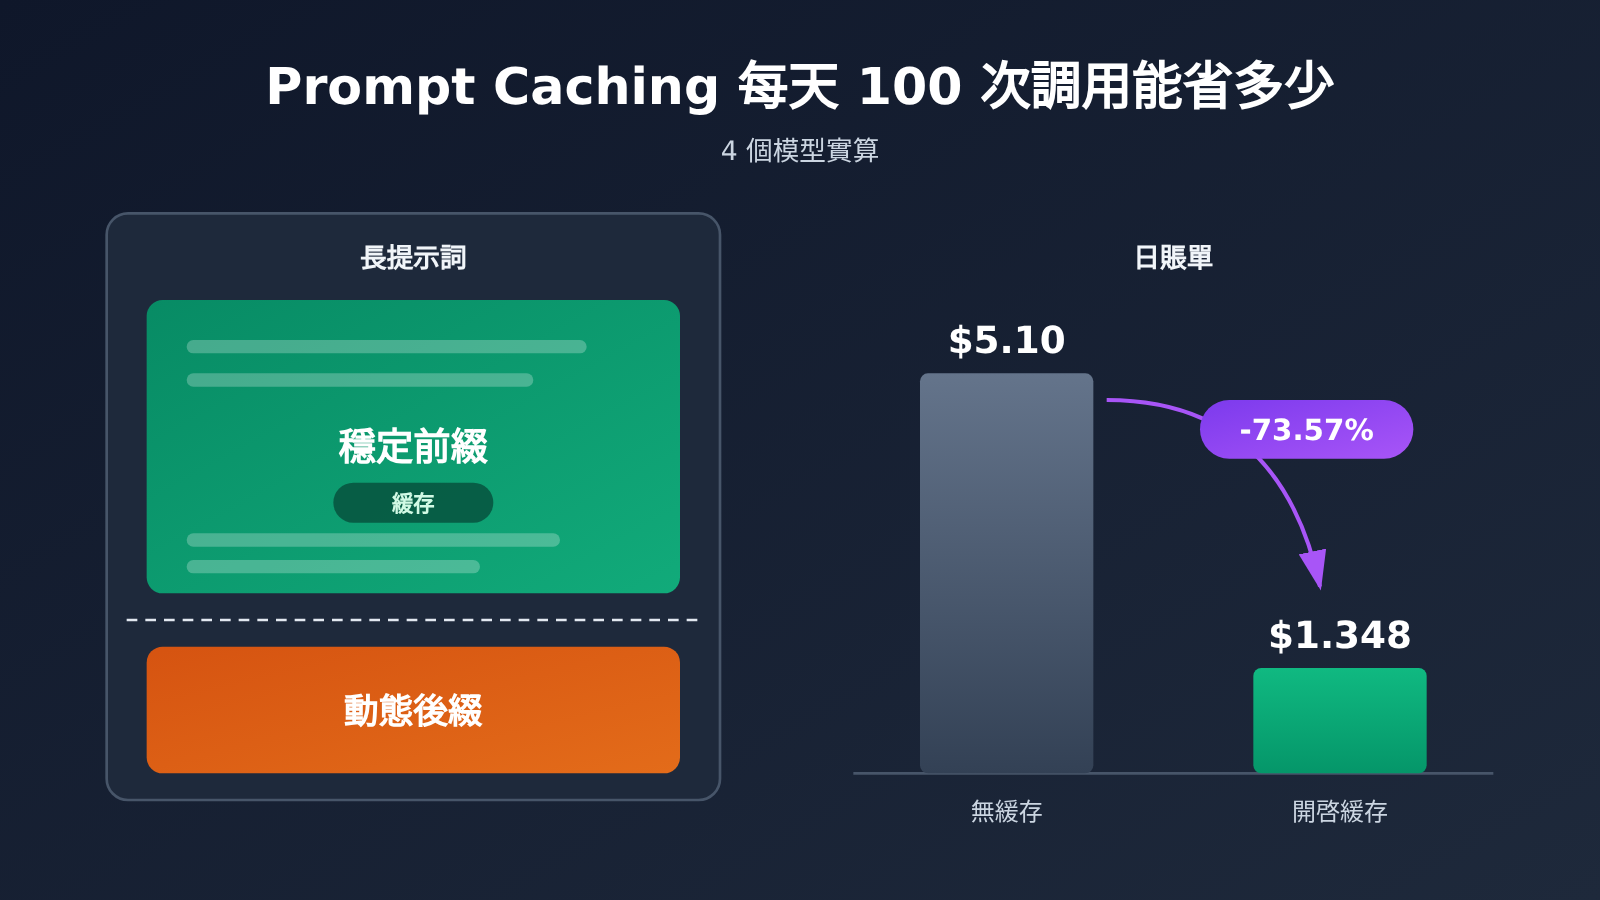
結論:本文設定的工作負載是每次固定前綴 20K Token、動態輸入 500 Token、輸出 1K Token,每天調用 100 次。在“首次寫入、後續 99 次全部命中”的理想條件下,GPT-6.1 Sol 的完整日賬單從 $5.10 降到 $1.348,降幅約 73.57%。Claude Sonnet 5.5 的結果與它相同,GPT-6 Astra 從 $25.50 降到 $7.73,降幅約 69.69%,Gemini 3.8 Flash 從 $1.9125 降到 $0.576,降幅約 69.88%。只看固定前綴這一項,節省比例在 88% 到 94% 之間。完整賬單的降幅更低,原因是輸出 Token 和動態輸入不享受緩存摺扣。以上數字是按官方單價做的預算演算,並非真實賬單。價格統一採用標準短上下文費率,覈對日期爲 2026-11-13。
內容預告:第 1 部分說明緩存複用的是請求中的哪一段,以及它影響賬單的哪一部分。第 2 部分對比 OpenAI、Claude、Gemini 三家的緩存規則。第 3 部分逐項列出四個模型的計算公式,讀者可以自行復算。第 4 部分用 TTL 與調用節奏的演算說明命中率爲什麼會下降。第 5 部分給出提示詞組織方式、TTL 選擇、代碼示例和命中率監控方法。第 6 部分討論批量 AI 生產場景下控制 Token 成本的判斷標準。
To Know:Prompt Caching 術語預備
| 術語 | 解釋 |
|---|---|
| Token | 模型計量文本的單位,API 按 Token 數量計費,單價通常以“美元 / 百萬 Token(MTok)”表示 |
| Prompt Caching | 把已經處理過的提示詞前綴緩存起來,後續請求遇到相同前綴時直接複用,從而降低重複處理的費用 |
| 穩定前綴 | 多次請求中逐字相同的提示詞開頭部分,例如角色說明、寫作規範、範文、知識庫 |
| 動態輸入 | 每次請求都會變化的內容,例如當天的新聞材料、文章標題、用戶要求 |
| 緩存寫入 | 第一次處理穩定前綴並存入緩存,單價通常高於普通輸入 |
| 緩存讀取 | 後續請求命中已有緩存,按遠低於普通輸入的單價計費 |
| 緩存命中 | 新請求的前綴與可用緩存逐 Token 匹配,複用成功 |
| TTL | 緩存的存活時間。OpenAI 將它定義爲最低存活時間,不承諾精確清除時間 |
| 緩存斷點 | 在提示詞中標出“可緩存前綴到此爲止”的位置 |
| 隱式 / 顯式緩存 | 隱式緩存由系統自動判斷並複用;顯式緩存由開發者主動聲明斷點或創建緩存對象 |
| 完整任務成本 | 一次調用的輸入、輸出及適用工具費用合計,是衡量節省比例的真實分母 |
1 Prompt Caching 能省錢,具體省在哪裏?
1.1 Prompt Caching 複用的是什麼
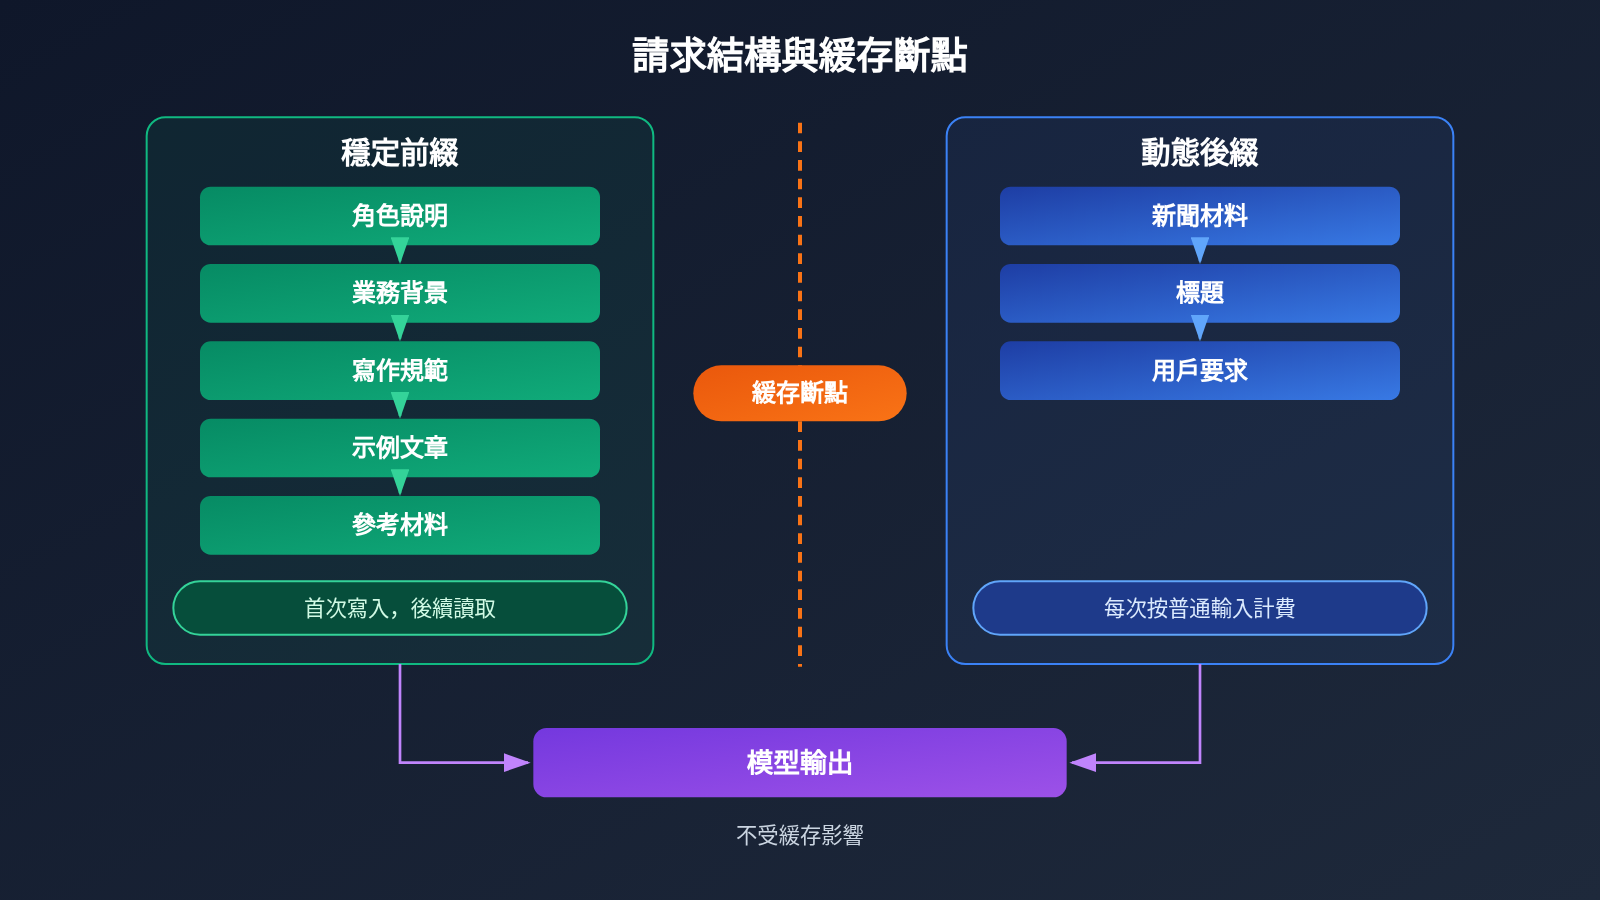
以一個 AI 寫作平臺爲例。每生成一篇文章,請求都由兩部分組成。第一部分是固定內容:角色說明、業務背景、寫作規範、示例文章、術語與參考材料。第二部分是動態內容:當天的新聞材料、文章標題和用戶的具體要求。
Prompt Caching 複用的是第一部分,也就是逐 Token 相同的前綴。緩存匹配要求 Token 序列完全一致,語義相近不算命中。改動一個措辭、調整段落順序、重新排列工具定義,都可能讓前綴變成新內容,緩存隨之失效。
所以緩存優化有一條基本原則:穩定內容放在最前面,變化的內容放在後面。
1.2 Prompt Caching 節省的是哪部分費用
一次調用的賬單可以拆成五項,其中只有固定前綴的費用會被緩存改變:
| 費用項 | 無緩存時 | 開啓緩存後 |
|---|---|---|
| 固定前綴 | 每次按普通輸入價計費 | 首次按寫入價,命中後按讀取價 |
| 動態輸入 | 普通輸入價 | 普通輸入價,不變 |
| 模型輸出 | 輸出價 | 輸出價,不變 |
| 工具費用 | 按工具規則 | 按工具規則,不變 |
| 顯式緩存存儲(Gemini) | 無 | 按存儲時長另計 |
這張表說明了一個關鍵區別:固定前綴節省率和完整賬單節省率是兩個指標。前者只衡量被緩存部分的降幅,後者衡量整張賬單的降幅。輸出越長,後者越低。
2 GPT、Claude、Gemini 的 Prompt Caching 規則有什麼區別?
2.1 OpenAI Prompt Caching:30m 與 12h
OpenAI 文檔對 GPT-5.6 及後續模型規定:緩存前綴最低長度通常爲 1,024 個可見輸入 Token,支持隱式(implicit)和顯式(explicit)兩種模式。顯式模式下,開發者在合適的消息內容塊中標記 prompt_cache_breakpoint,明確緩存前綴的邊界。
TTL 默認 30 分鐘,Responses API 可以通過 prompt_cache_options.ttl = "12h" 選擇最低 12 小時的存活時間。計費分爲寫入和讀取:
- 30 分鐘寫入:普通輸入的 1.25 倍
- 12 小時寫入:普通輸入的 2.5 倍
- 緩存讀取:大部分新模型爲普通輸入的 0.1 倍,GPT-6.1 Sol 與 GPT-6.1 Terra 爲 0.05 倍
prompt_cache_key 可用於區分不同用戶或工作空間的緩存賬務。在 GPT-5.6 及後續模型上,緩存路由已由官方自動管理。
2.2 Claude Prompt Caching:5m 與 1h
Claude 通過 cache_control 支持自動或顯式緩存。默認有效時間爲 5 分鐘,每次命中會刷新有效期。5 分鐘從緩存寫入或讀取請求開始計算,生成響應所用的時間也計入其中。所以在長輸出任務裏,實際可用的間隔比 5 分鐘更短。
計費倍數爲:5 分鐘寫入 1.25 倍,1 小時寫入 2 倍,普通讀取 0.1 倍。Claude Sonnet 5.5 和 Claude Opus 5.5 的讀取費率降到 0.05 倍。Sonnet 5.5 的標準單價是:輸入 $2、5 分鐘寫入 $2.50、1 小時寫入 $4、讀取 $0.10、輸出 $10(均爲美元 / 百萬 Token)。
2.3 Gemini Context Caching:隱式與顯式
Gemini 2.5 及更新模型默認啓用隱式緩存,無需額外配置。最低輸入要求因模型而異:Gemini 3.8 Flash 爲 4,096 Token,Gemini 2.5 Flash 和 2.5 Pro 爲 2,048 Token。Google 建議把共用內容放在提示詞前面,並在較短時間內複用相同前綴。
顯式緩存需要開發者主動創建緩存對象並設定存活時長。費用包括緩存內容、後續讀取和存儲時長三部分。Gemini Interactions API 目前只支持隱式緩存,需要顯式緩存對象時使用 generateContent API。
Gemini 3.8 Flash 截至 2026 年 12 月 31 日的價格爲:輸入 $0.75、輸出 $3.75、緩存讀取 $0.075、顯式緩存存儲 $0.50 / 百萬 Token / 小時。官方計劃從 2027 年 1 月 1 日起調整爲 $1.50、$7.50、$0.15、$1.00。四項價格同比例翻倍,因此下文算出的節省比例不變,絕對金額翻倍。
2.4 三家 Prompt Caching 規則對照
| 維度 | OpenAI | Claude | Gemini |
|---|---|---|---|
| 緩存方式 | 隱式 / 顯式斷點 | cache_control 自動 / 顯式 |
隱式(默認)/ 顯式緩存對象 |
| 默認 TTL | 30 分鐘(最低存活時間) | 5 分鐘,命中刷新 | 隱式由系統管理;顯式自設時長 |
| 長 TTL 選項 | 12 小時(Responses API) | 1 小時 | 顯式緩存自定義 |
| 寫入費率 | 30m:1.25 倍;12h:2.5 倍 | 5m:1.25 倍;1h:2 倍 | 隱式首次按普通輸入計 |
| 讀取費率 | 0.1 倍(Sol / Terra 爲 0.05 倍) | 0.1 倍(Sonnet / Opus 5.5 爲 0.05 倍) | 3.8 Flash:$0.075 / MTok |
| 額外費用 | 無存儲費 | 無存儲費 | 顯式緩存按小時收存儲費 |
| 最低前綴 | 通常 1,024 Token | 以官方文檔爲準 | 3.8 Flash:4,096 Token |
3 每天調用 100 次,Prompt Caching 究竟能省多少錢?
3.1 統一計算條件
以下是按官方單價做的理論演算,並非實際用戶賬單。統一假設如下:
- 每次固定前綴 20,000 Token,動態輸入 500 Token,輸出 1,000 Token
- 每天調用 100 次,始終使用同一個模型
- 動態內容全部位於穩定前綴之後
- 緩存場景:第 1 次寫入,後續 99 次完整命中;所有調用都在 TTL 內完成,或命中時持續刷新有效期
- 不考慮第三方加價、批量折扣和工具費用
- 20K 前綴不觸發 GPT-6 Astra 超過 272K Token 時的長上下文附加計費
計算公式統一爲:
單項費用 = Token 數 × 調用次數 ÷ 1,000,000 × 單價(美元 / MTok)
緩存後前綴費用 = 20,000 × 1 ÷ 1,000,000 × 寫入價 + 20,000 × 99 ÷ 1,000,000 × 讀取價
3.2 GPT-6 Astra 的完整公式
GPT-6 Astra 單價:普通輸入 $10,輸出 $50,30 分鐘寫入 $12.50,緩存讀取 $1。
無緩存:
- 固定前綴:20,000 × 100 ÷ 1,000,000 × $10 = $20
- 動態輸入:500 × 100 ÷ 1,000,000 × $10 = $0.50
- 輸出:1,000 × 100 ÷ 1,000,000 × $50 = $5
- 每日合計:$25.50
30 分鐘緩存:
- 首次寫入:20,000 ÷ 1,000,000 × $12.50 = $0.25
- 99 次讀取:20,000 × 99 ÷ 1,000,000 × $1 = $1.98
- 動態輸入:$0.50;輸出:$5
- 每日合計:$7.73
完整賬單節省 $17.77,約 69.69%。固定前綴從 $20 降到 $2.23,節省約 88.85%。
3.3 GPT-6.1 Sol、Claude Sonnet 5.5、Gemini 3.8 Flash
GPT-6.1 Sol(輸入 $2、輸出 $10、30 分鐘寫入 $2.50、讀取 $0.10):
- 無緩存:前綴 $4 + 動態輸入 $0.10 + 輸出 $1 = $5.10
- 緩存後:寫入 $0.05 + 讀取 $0.198 + 動態輸入 $0.10 + 輸出 $1 = $1.348
- 節省 $3.752,約 73.57%;前綴從 $4 降到 $0.248,節省約 93.8%
Claude Sonnet 5.5(5 分鐘緩存)的單價與 GPT-6.1 Sol 相同,計算過程和結果也一致:$5.10 降到 $1.348。前提是調用間隔能持續維持 5 分鐘有效期。
Gemini 3.8 Flash(隱式緩存,首次按普通輸入 $0.75 計):
- 無緩存:前綴 $1.50 + 動態輸入 $0.0375 + 輸出 $0.375 = $1.9125
- 緩存後:首次前綴 $0.015 + 99 次讀取 $0.1485 + 動態輸入 $0.0375 + 輸出 $0.375 = $0.576
- 節省 $1.3365,約 69.88%;前綴從 $1.50 降到 $0.1635,節省約 89.1%
- 此結果假設隱式緩存全部命中,不含顯式緩存存儲費
3.4 Prompt Caching 節省比例與絕對金額的區別
| 模型 | 無緩存 / 天 | 緩存後 / 天 | 每日節省 | 30 天節省(外推) | 前綴節省率 | 完整賬單節省率 |
|---|---|---|---|---|---|---|
| GPT-6 Astra | $25.50 | $7.73 | $17.77 | $533.10 | 88.85% | 69.69% |
| GPT-6.1 Sol | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Claude Sonnet 5.5 | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Gemini 3.8 Flash | $1.9125 | $0.576 | $1.3365 | $40.10 | 89.1% | 69.88% |
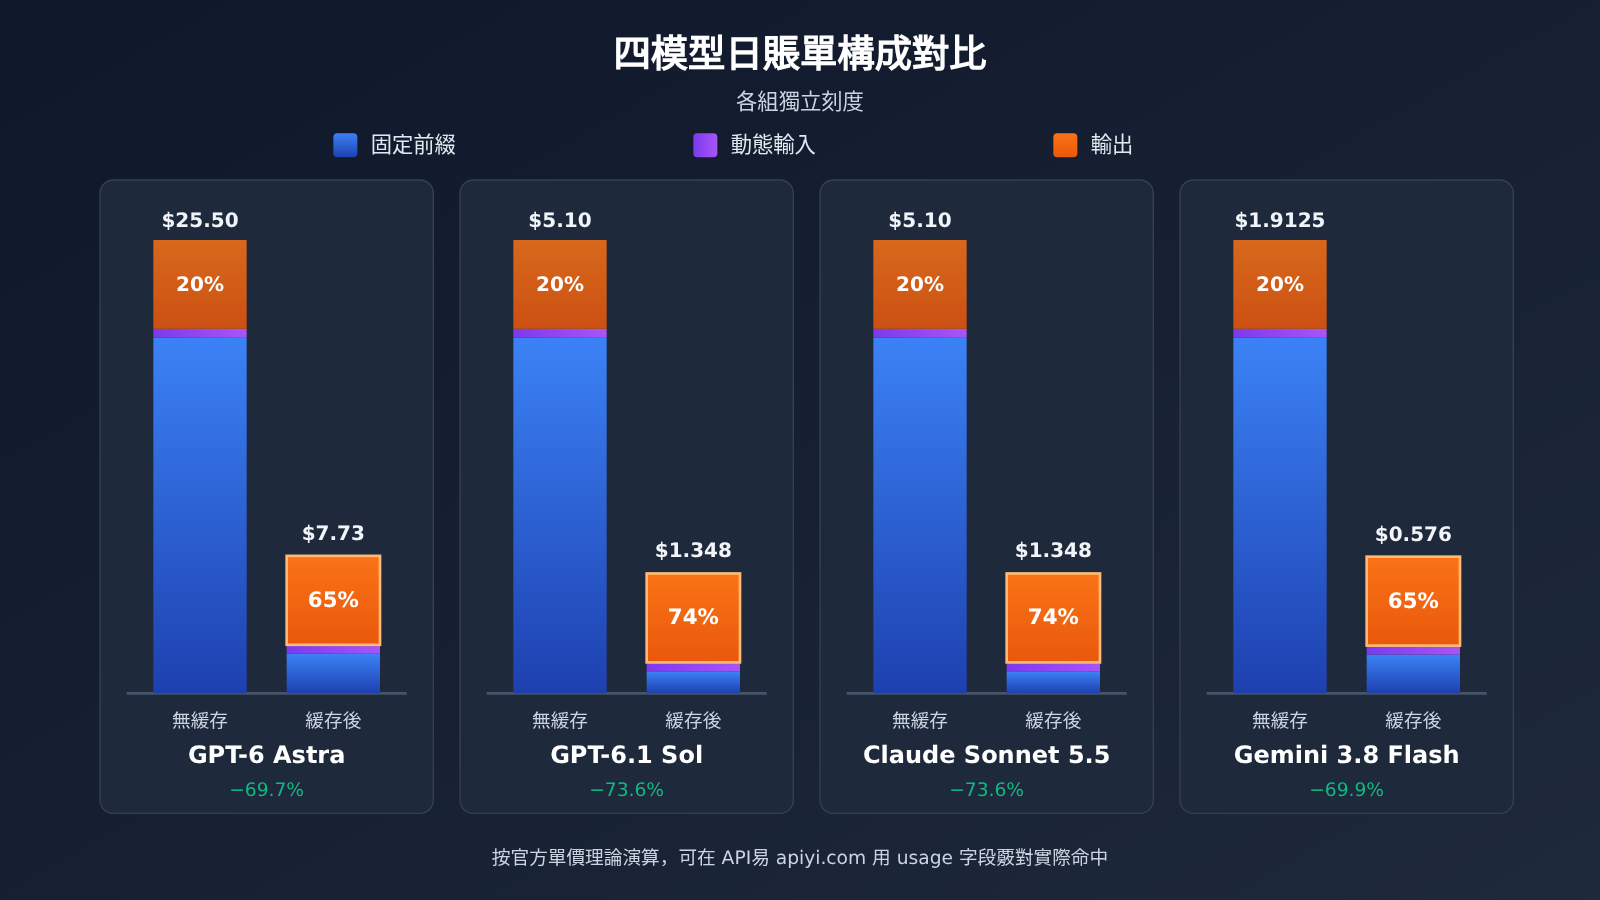
從表中可以讀出兩點:
- 比例看讀取折扣。GPT-6.1 Sol 和 Claude Sonnet 5.5 的讀取價是普通輸入的 0.05 倍,前綴節省率達到 93.8%,高於 0.1 倍讀取的 Astra 和 Gemini。
- 金額看單價基數。Astra 的節省比例最低,但每天節省 $17.77,是 Gemini 3.8 Flash 的 13 倍多。單價越高的模型,開啓緩存帶來的絕對收益越大。
緩存後,輸出在 GPT-6 Astra 賬單中的佔比從約 20% 升到約 65%($5 ÷ $7.73)。這時進一步降本的重點會轉向控制輸出長度。需要注意,四個模型使用相同 Token 數量只是爲了方便比較。完成同一任務時,各模型的實際輸出長度和正確率並不相同。
💡 選型建議:比例相近時,優先看每日絕對節省金額與任務質量的平衡。建議先在 API易 apiyi.com 用同一份模板分別調用幾個候選模型,記錄真實輸出長度和緩存 Token,再代入上面的公式估算月度預算。
4 爲什麼每天重複同一份 Prompt,Prompt Caching 賬單仍然可能很高?
4.1 TTL 和調用頻率決定命中率
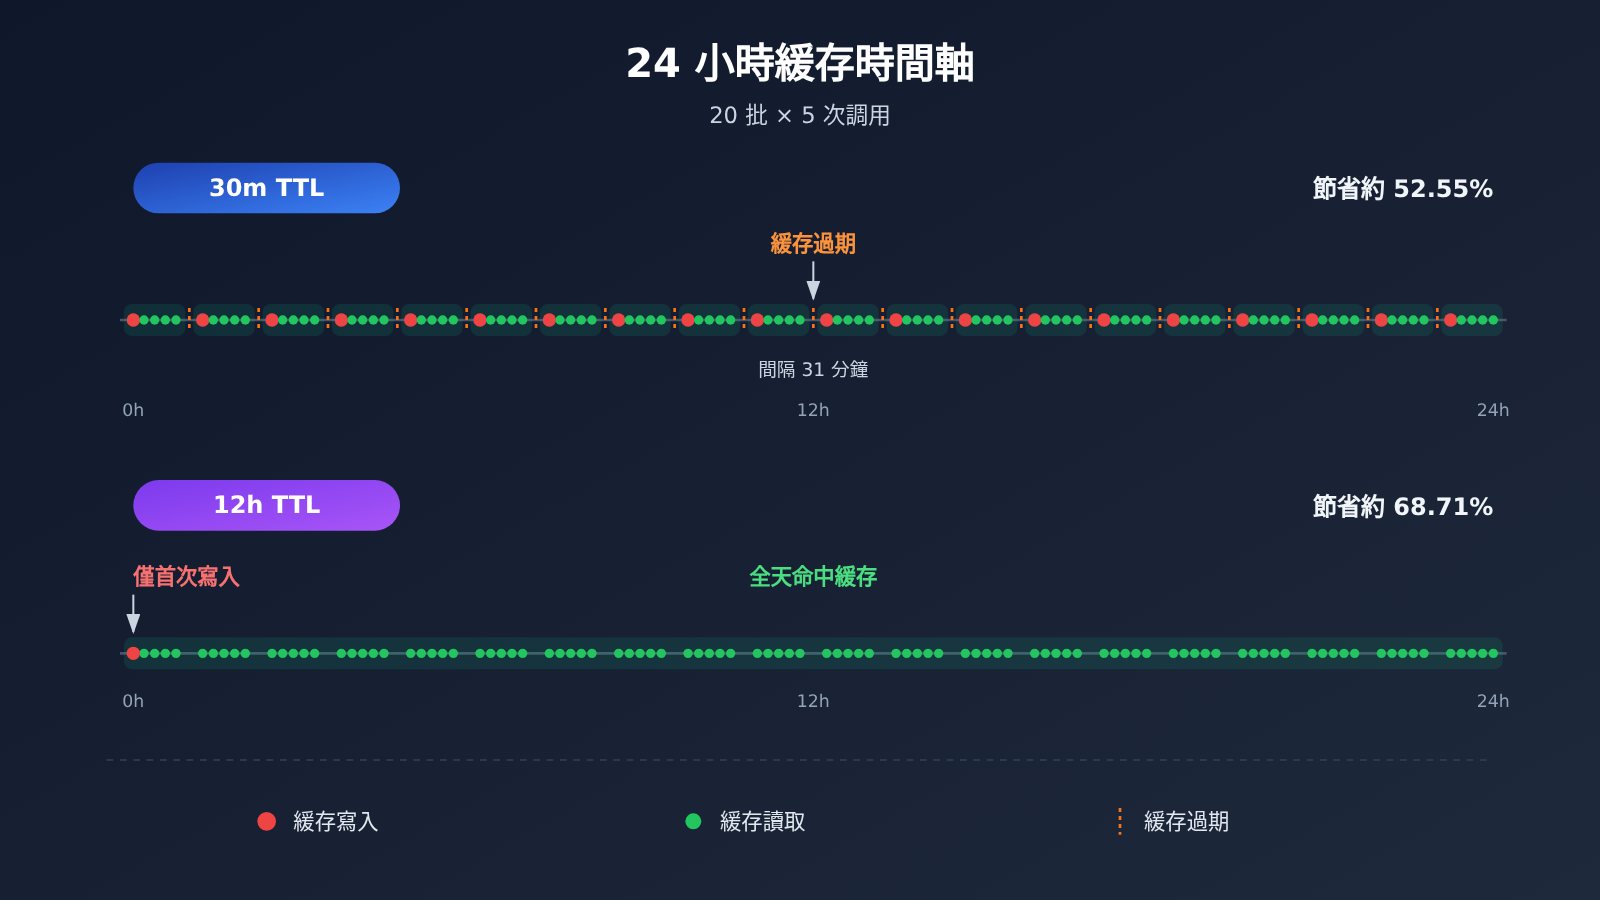
每天調用 100 次,不代表一次寫入就能覆蓋全天。下面以 GPT-6 Astra 爲例:每天分 20 批,每批連續調用 5 次,兩批之間間隔 31 分鐘。
| 場景 | 寫入次數與費用 | 讀取次數與費用 | 前綴費用 | 加動態輸入與輸出 | 每日總計 | 節省率 |
|---|---|---|---|---|---|---|
| 無緩存 | — | — | $20 | $5.50 | $25.50 | — |
| A:30m 緩存 | 20 × $0.25 = $5 | 80 × $0.02 = $1.60 | $6.60 | $5.50 | $12.10 | 約 52.55% |
| B:12h 緩存(同一窗口內) | 1 × $0.50 | 99 × $0.02 = $1.98 | $2.48 | $5.50 | $7.98 | 約 68.71% |
場景 A 中,批次間隔超過 30 分鐘,每批都要重新寫入,節省率從理想的 69.69% 降到 52.55%。場景 B 的單次寫入價是 30m 的兩倍,但全天只寫一次,所以對分散調用更划算。12h 方案只覆蓋同一窗口,隔天能否複用同一份緩存沒有保證。每天只調用一兩次的任務,單靠相同提示詞無法實現跨天緩存。
各類 TTL 的盈虧平衡點可以只看穩定前綴,以普通輸入爲 1 倍計算:
| 方案 | 寫入倍數 | 讀取倍數 | 寫 1 + 讀 1 vs 無緩存 2 次 | 寫 1 + 讀 2 vs 無緩存 3 次 | 回本所需有效讀取 |
|---|---|---|---|---|---|
| OpenAI 30m | 1.25 | 0.1 | 1.35 < 2 | — | 1 次 |
| OpenAI 12h | 2.5 | 0.1 | 2.6 > 2 | 2.7 < 3 | 2 次 |
| Claude Sonnet 5.5 · 5m | 1.25 | 0.05 | 1.30 < 2 | — | 1 次 |
| Claude Sonnet 5.5 · 1h | 2 | 0.05 | 2.05 > 2 | 2.10 < 3 | 2 次 |
結論很直接:短 TTL 只要命中一次就能回本;長 TTL 需要在有效期內至少命中兩次。
4.2 緩存斷點和提示詞順序
最常見的失效原因是穩定前綴被改動。把時間戳、用戶 ID、任務標題或實時材料放在提示詞開頭,每次請求的前綴都會變成新內容,緩存永遠無法命中。
在 OpenAI 隱式模式下,如果首次請求把動態內容也划進了緩存範圍,後續動態內容一變,就可能命中不到預期的穩定前綴。解決辦法是在穩定內容結束處設置顯式緩存斷點。
其他常見原因還有:
- 切換了模型、廠商、服務組織,或修改了部分參數
- Agent 做對話壓縮、重排工具定義、修改歷史消息,導致可複用前綴被改寫
- 第三方網關沒有傳遞緩存參數,或沒有把緩存摺扣計入賬單
4.3 輸出 Token 與工具費用的影響
緩存只作用於輸入前綴。在 3.2 的 Astra 算例中,即使前綴費用降到零,賬單也不會低於 $5.50(動態輸入加輸出)。輸出長、調用工具多的任務,完整賬單的降幅會明顯低於前綴節省率。所以開啓緩存之後,還需要配合控制輸出長度、精簡工具調用。
5 AI 應用如何配置和監控 Prompt Caching?
5.1 穩定前綴與動態後綴的組織方法
按“變化頻率從低到高”的順序排列內容:
- 工具定義:保持固定順序和固定描述,不要按請求動態增減
- 系統規則與寫作規範:角色說明、品牌規範、文風要求
- 範文與知識庫:大段參考文檔,版本更新時整體替換
- (緩存斷點)
- 動態材料:當天新聞、檢索結果、用戶輸入
- 當前任務指令:標題、字數、具體要求
以下示例通過 OpenAI 兼容接口發起調用,並讀取返回中的緩存 Token:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

STABLE_PREFIX = """你是一名技術博客作者……(寫作規範、範文、術語表,約 20K Token,內容逐字固定)"""

resp = client.chat.completions.create(
    model="gpt-6.1-sol",  # 以平臺模型列表中的實際名稱爲準
    messages=[
        {"role": "system", "content": STABLE_PREFIX},          # 穩定前綴放最前
        {"role": "user", "content": "今日材料:……\n標題:……"},  # 動態內容放後面
    ],
)
details = getattr(resp.usage, "prompt_tokens_details", None)
cached = getattr(details, "cached_tokens", 0) or 0
print(f"輸入 {resp.usage.prompt_tokens},命中緩存 {cached}")
查看完整代碼:成本演算器 + 命中率統計
from openai import OpenAI

M = 1_000_000

def daily_cost(prefix, dynamic, output, calls,
               p_in, p_out, p_write, p_read,
               writes=1, use_cache=True):
    """按官方單價演算每日費用(美元),返回 (前綴, 動態輸入, 輸出, 合計)"""
    dyn = dynamic * calls / M * p_in
    out = output * calls / M * p_out
    if use_cache:
        pre = prefix * writes / M * p_write + prefix * (calls - writes) / M * p_read
    else:
        pre = prefix * calls / M * p_in
    return round(pre, 4), round(dyn, 4), round(out, 4), round(pre + dyn + out, 4)

MODELS = {
    # 名稱: (輸入, 輸出, 寫入, 讀取)  美元 / 百萬 Token,覈對日期 2026-11-13
    "GPT-6 Astra (30m)":   (10,   50,   12.5, 1),
    "GPT-6.1 Sol (30m)":   (2,    10,   2.5,  0.10),
    "Claude Sonnet 5.5":   (2,    10,   2.5,  0.10),
    "Gemini 3.8 Flash":    (0.75, 3.75, 0.75, 0.075),  # 隱式緩存首次按普通輸入
}

for name, (p_in, p_out, p_w, p_r) in MODELS.items():
    base = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r, use_cache=False)[-1]
    cached = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r)[-1]
    print(f"{name}: ${base} -> ${cached},節省 {(base - cached) / base:.2%}")

# 場景 A:Astra 30m,20 批各需重新寫入
a = daily_cost(20000, 500, 1000, 100, 10, 50, 12.5, 1, writes=20)[-1]
print(f"Astra 分批 30m: ${a}")  # 12.1

# ---- 線上命中率統計 ----
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def run_and_track(stable_prefix, dynamic_inputs, model="gpt-6.1-sol"):
    total_in = total_cached = 0
    for text in dynamic_inputs:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": stable_prefix},
                      {"role": "user", "content": text}],
        )
        d = getattr(r.usage, "prompt_tokens_details", None)
        total_in += r.usage.prompt_tokens
        total_cached += (getattr(d, "cached_tokens", 0) or 0)
    hit = total_cached / total_in if total_in else 0
    print(f"實際緩存命中率:{hit:.2%}")
    return hit
🚀 快速上手建議:先用上面的演算器估算預算,再拿真實模板跑 10~20 次調用,看
cached_tokens是否從第二次開始穩定出現。新用戶可以在 API易 apiyi.com 領取免費測試額度完成這一步驗證,確認命中後再放量。
5.2 選擇 Prompt Caching TTL 和緩存模式
- 高頻連續調用(間隔穩定在幾分鐘內):用默認短 TTL,即 OpenAI 30m、Claude 5m。命中一次即可回本,寫入溢價最低。Claude 需要把響應生成時長計入 5 分鐘窗口。
- 全天分散調用(批次間隔超過 30 分鐘):評估 OpenAI 12h 或 Claude 1h。只要窗口內能命中兩次以上,長 TTL 就比反覆寫入更便宜,4.1 的場景 B 即爲例證。
- 前綴極長、需要跨較長時段複用的 Gemini 任務:評估顯式緩存,同時計入存儲費。以 Gemini 3.8 Flash 爲例,20K Token 存 12 小時的存儲費是 0.02 × $0.50 × 12 = $0.12。在本文工作負載下,這筆費用相對 $0.576 的日賬單已經比較顯著。如果隱式緩存命中良好,就保持默認。
- 前綴經常改動:先固定前綴,再考慮 TTL。前綴不穩定時,任何 TTL 都換不來命中。
5.3 查看 Prompt Caching 的真實命中率和賬單
三家的 usage 字段分別是:
- OpenAI(Responses API):
usage.input_tokens、usage.input_tokens_details.cached_tokens、usage.input_tokens_details.cache_write_tokens - Claude:
usage.input_tokens、usage.cache_creation_input_tokens、usage.cache_read_input_tokens - Gemini:對應 API 的 usage 字段,例如
total_cached_tokens;顯式緩存另計對象存儲費
建議持續跟蹤兩個指標:
實際緩存命中率 = 緩存讀取 Token ÷ 總輸入 Token
實際節省金額   = 未緩存基準成本 − 實際 API 賬單成本
未緩存基準成本要按相同模型、相同工作負載、相同輸出規模計算,否則節省金額沒有可比性。在 API易 apiyi.com 控制檯覈對賬單時,可以把同一時段的 usage 彙總與扣費明細逐項對照,確認緩存 Token 按緩存價計費。
6 API易 場景:固定模板與批量 AI 生產如何用 Prompt Caching 控制成本?
適合 Prompt Caching 的典型業務有:每天運行固定文章模板的 AI 寫作平臺、反覆加載同一份工具定義的 Agent、多次引用同一份大型參考文檔的資料分析系統,以及共用品牌規範和文風說明的批量內容生成。這類任務有一個共同點:前綴長、重複率高、調用量大,正好落在緩存收益最高的區間。
在這類場景中做成本決策,可以按三個標準判斷:
- 模型是否支持所需的緩存能力。包括最低前綴長度、可選 TTL、讀取折扣倍數。0.05 倍讀取的模型在長前綴任務上的前綴節省率更高。
- 提示詞與 TTL 是否匹配工作負載。連續批處理用短 TTL;按排班分散執行的任務評估長 TTL,並用 4.1 節的公式算出回本次數。
- API 供應商是否完整支持緩存並按實際緩存費用計價。上游支持緩存,只是降本的必要條件之一。網關還需要正確傳遞緩存參數、在 usage 中報告緩存 Token,並把緩存價體現在扣費上。
通過 API易 apiyi.com 調用時,建議把第 3 條落實爲固定的驗收步驟:用同一份 20K 模板連續調用若干次,檢查 usage 中的緩存字段,再與賬單扣費覈對。技術命中和計費落地兩項都確認之後,再把上面的演算結果作爲月度預算依據。
常見問題 FAQ
Q1:Prompt Caching 是什麼?
它把提示詞中已經處理過的相同前綴緩存下來,後續請求命中時按遠低於普通輸入的價格計費。匹配要求 Token 逐字一致,所以適合固定模板、固定知識庫、固定工具定義這類場景。
Q2:爲什麼前綴省了 90% 以上,整張賬單隻省 70% 左右?
緩存只作用於固定前綴,動態輸入和輸出仍按原價計費。以 GPT-6.1 Sol 爲例,緩存後 $1.348 的日賬單中,輸出佔 $1,動態輸入佔 $0.10。輸出越長,完整賬單的節省率越低。
Q3:每天只調用一兩次,值得開緩存嗎?
收益很小。OpenAI 12h 和 Claude 1h 都需要在有效期內命中至少兩次才能回本,跨天覆用沒有保證。更有效的做法是把同類任務集中到同一時段批量執行,提高窗口內的命中次數。
Q4:選 30m 還是 12h?
看調用間隔。間隔穩定在 30 分鐘以內,用 30m,命中一次即可回本;批次間隔較長、全天分散,用 12h。以 GPT-6 Astra 分 20 批調用爲例,12h 的日費用是 $7.98,30m 是 $12.10。
Q5:通過 API 聚合平臺調用,緩存還能生效嗎?
這取決於平臺對緩存參數的傳遞和計費實現。建議在 API易 apiyi.com 用免費測試額度連續調用同一模板,檢查 usage 中的 `cached_tokens` 等字段,並與扣費明細覈對。確認緩存既命中、又按緩存價計費後再批量使用。
Q6:緩存命中率突然下降,先查哪裏?
按以下順序排查:前綴裏是否混入了時間戳、ID 等動態內容;工具定義的順序是否變化;Agent 是否壓縮或改寫了歷史消息;模型或參數是否切換;調用間隔是否超出 TTL。用 5.3 節的命中率公式按小時統計,能較快定位變化發生的時間點。
Q7:Gemini 隱式緩存和顯式緩存怎麼選?
隱式緩存默認開啓,沒有存儲費,前綴超過模型最低長度(3.8 Flash 爲 4,096 Token)時優先使用。顯式緩存適合需要確定性複用的超長內容,但要按小時支付存儲費,並使用 generateContent API。Interactions API 目前只支持隱式緩存。
總結
Prompt Caching 的核心要點:
- 省在哪裏:只降低固定前綴的費用。本文工作負載下,前綴節省率爲 88.85%~93.8%,完整賬單節省率爲 69.69%~73.57%。
- 省多少:GPT-6.1 Sol 與 Claude Sonnet 5.5 每天從 $5.10 降到 $1.348,GPT-6 Astra 從 $25.50 降到 $7.73。單價越高,絕對節省越多。
- 什麼頻率最划算:高頻、連續、前綴長的調用。短 TTL 命中 1 次回本,長 TTL 需要命中 2 次。
- 如何落地:穩定內容在前、動態內容在後,在穩定內容末尾設斷點;按調用節奏選擇 TTL;用 usage 字段持續監控命中率。
- 成立前提:緩存既要技術上命中,也要在計費上按緩存價扣費。
建議先用文中的演算器算出預算,再在 API易 apiyi.com 用真實模板驗證命中率和扣費,兩項都確認後再放量。
📚 參考資料
- OpenAI Prompt Caching 指南:緩存模式、斷點、TTL 與計費倍數
- 鏈接:
developers.openai.com/api/docs/guides/prompt-caching -
說明:
prompt_cache_options、prompt_cache_breakpoint參數說明 -
OpenAI 模型與定價:GPT-6 Astra、GPT-6.1 Sol 單價
- 鏈接:
developers.openai.com/api/docs/pricing - 鏈接:
developers.openai.com/api/docs/models/gpt-6-astra - 鏈接:
developers.openai.com/api/docs/models/gpt-6.1-sol -
說明:標準短上下文費率,覈對日期 2026-11-13
-
Claude Prompt Caching 文檔:
cache_control、5m / 1h 寫入與讀取倍數 - 鏈接:
platform.claude.com/docs/en/build-with-claude/prompt-caching - 鏈接:
platform.claude.com/docs/en/models/sonnet-5-5/overview -
說明:Sonnet 5.5 緩存讀取 0.05 倍費率
-
Gemini Context Caching 與定價:隱式 / 顯式緩存、存儲費與 2027 年調價
- 鏈接:
ai.google.dev/gemini-api/docs/caching - 鏈接:
ai.google.dev/gemini-api/docs/pricing - 說明:各模型最低緩存長度與 API 支持範圍
作者:APIYI 技術團隊
技術交流:歡迎在 API易 官網首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心


