
把第三方大模型 API 接進生產環境,難點從來不在第一行代碼跑通的那一刻。真正決定項目能不能穩定交付的,是上線後第一個月裏那些沒法提前看見的問題:請求返回了但格式不對、客戶端超時了平臺卻已經扣費、主通道掛了兜底悄悄換了個更貴的模型、三個月後要覆盤卻發現日誌已經被清掉。
這不是又一篇“哪家 API 平臺更好用”的推薦文,本文不復述供應商宣傳頁上的形容詞,也不給出任何平臺排名。我們只討論一件可以操作的事:上線之前,你手上能拿出哪些可覈對的證據,來判斷一家大模型 API 中轉與網關是否靠得住。
核心價值:讀完本文,你會拿到一套包含 7 項驗收清單、1 張結論表的核對方法,把“感覺還行”變成“有據可查”。
術語先行:讀懂這 6 個詞再談上線
在討論驗收方法之前,先把反覆出現的幾個詞對齊。這幾個詞在供應商文檔和技術文章裏的用法經常不一致,而口徑不一致本身就是上線風險。
- API 網關:接收應用請求並轉交上游模型服務的入口。它通常同時承擔鑑權、計費、路由和日誌四件事,因此一次調用失敗可能發生在鏈路的任何一層,責任歸屬必須先分清。
- TTFT(首個有效輸出時間):從請求發起到第一個有效輸出 token 到達的時間。流式交互裏用戶感知的是這個值,而不是整段回覆的總耗時。
- p95:約 95% 的樣本不超過的指標值。平均值會掩蓋慢請求,p95 才能暴露“偶爾卡十幾秒”的那一小批調用。
- RPM 與併發:RPM 是每分鐘發起的請求數量,併發是同一時刻仍在執行的請求數量。請求執行得越久,低 RPM 也可能堆出很高的在途併發,所以兩者必須分別記錄。
- Fallback(兜底):主服務無法滿足請求時嘗試備用通道或模型的機制。驗收時要同時覈對最終模型、核心功能、費用上限和數據政策,而不能只看請求有沒有成功。
- SLA:服務級別協議,約定指標口徑、統計範圍、故障責任和補償條件。它是一份可執行的約定,不是一個可以單獨引用的百分比。
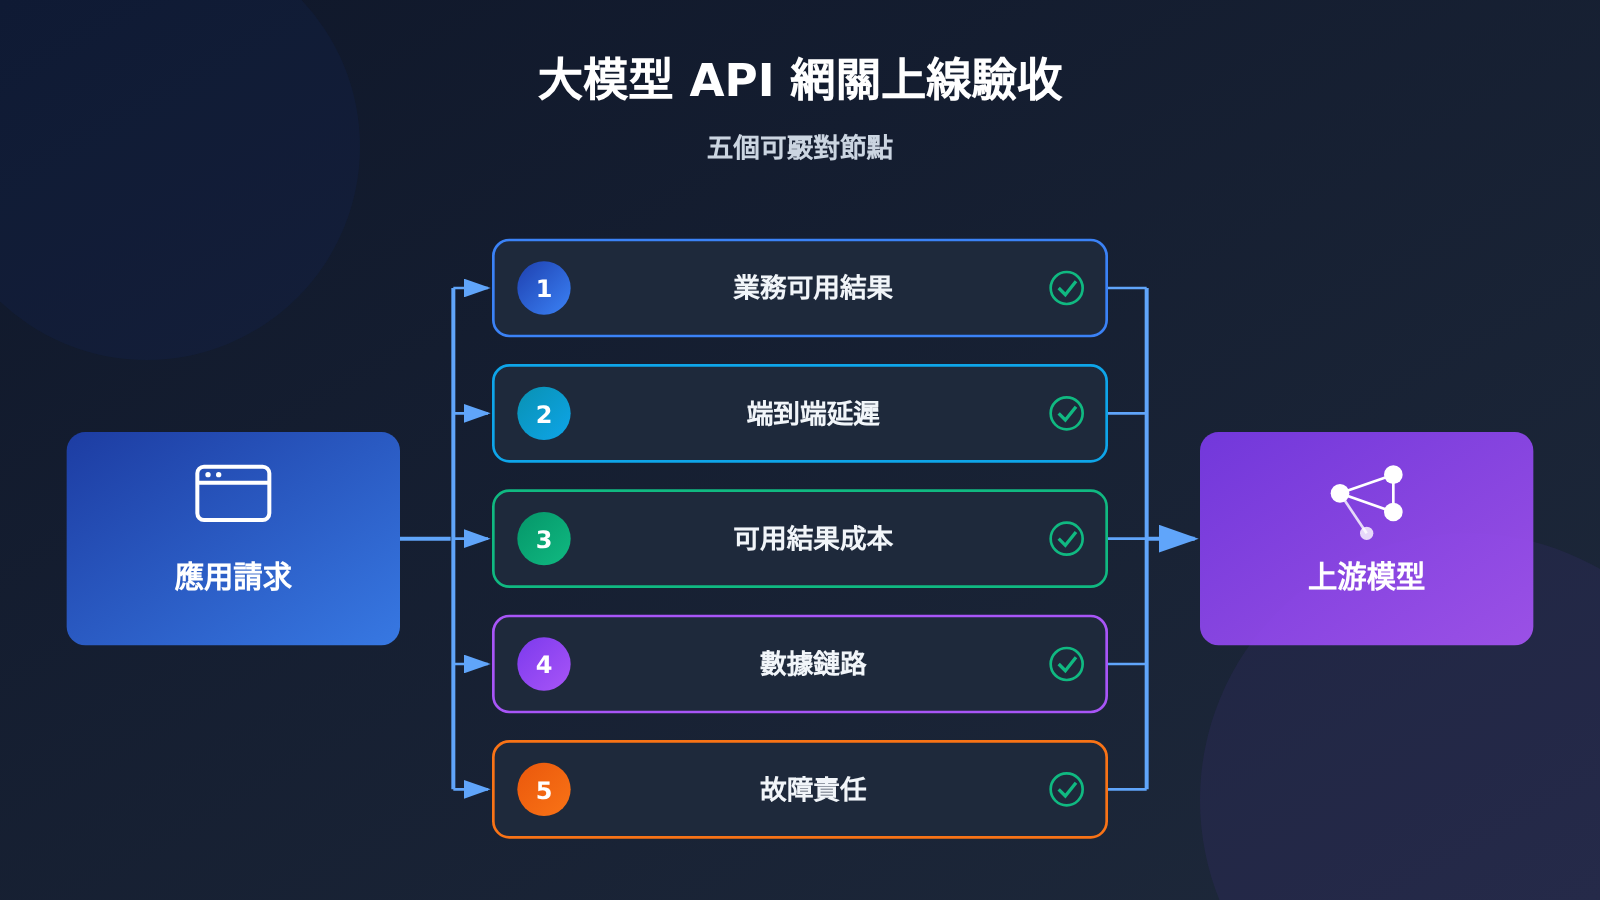
核心信息:網關可靠性要拆成 5 個核對層面
大模型 API 中轉與網關的價值在於統一接口,但統一接口帶來的便利恰好會掩蓋底層差異。一個 OpenAI 兼容的 base_url 後面,可能是完全不同的上游供應商、不同的限速策略、不同的日誌保留規則和不同的故障處理流程。
因此上線判斷不能只問“能不能調通”,而要同時觀察三件事:結果能不能用、等待能不能接受、異常能不能追溯。下面這張表把三件事展開成 5 個核對層面,也是本文後面五節的骨架。
| 覈對層面 | 要回答的問題 | 判斷依據 | 常見誤判 |
|---|---|---|---|
| 業務可用結果 | 返回的內容能不能直接進入業務流程 | 完整返回數、格式可用數、業務判定通過數 | 把 HTTP 200 當成成功 |
| 端到端延遲 | 用戶要等多久纔看到第一段有效輸出 | TTFT 與完成時間的 p50、p95,客戶端與平臺分別計時 | 只看平均耗時 |
| 可用結果成本 | 每個能用的結果實際花了多少錢 | 全部已結算支出除以業務可用結果數 | 只比單價,不比重試與兜底 |
| 數據鏈路 | 輸入輸出經過了誰、留存多久、誰能看 | 網關、上游、日誌、異步產物的分層政策 | 把傳輸加密當成內容不可讀 |
| 故障責任 | 出事之後按什麼口徑認定、怎麼補償 | SLA 的統計週期、排除項、申請流程與補償形式 | 把公開說明當成合同承諾 |
🎯 技術建議:把這張表複製成你團隊自己的驗收表,每一行都必須填上證據來源。需要先跑通調用鏈路的話,可以通過 API易 apiyi.com 獲取測試額度,用同一份腳本對多個模型做橫向記錄。
爲什麼要把可靠性定義成業務驗收條件
統一接口降低了接入成本,也把一批原本屬於基礎設施的判斷推到了應用團隊面前。過去你要自己維護重試邏輯和多個 SDK,現在只要換一個 base_url 就能調很多模型,代價是你對鏈路的可見度變低了。
所以驗收的第一步不是測性能,而是先把“可用”定義清楚。同一個請求,平臺計費成功、客戶端拿到 200、業務側解析通過,這是三件不同的事,必須分別計數。一份結構無效的 JSON 即使平臺正常完成了請求,對業務來說依然是零產出,而它照樣會產生費用。
第二步是按業務形態拆分測試集。交互式問答看首個有效輸出和完整回覆時限;工具調用看參數結構是否合法、字段是否齊全;批處理看交付截止時間前能產出多少可用結果。把這三類混成一個“平均耗時”,結論一定是失真的。
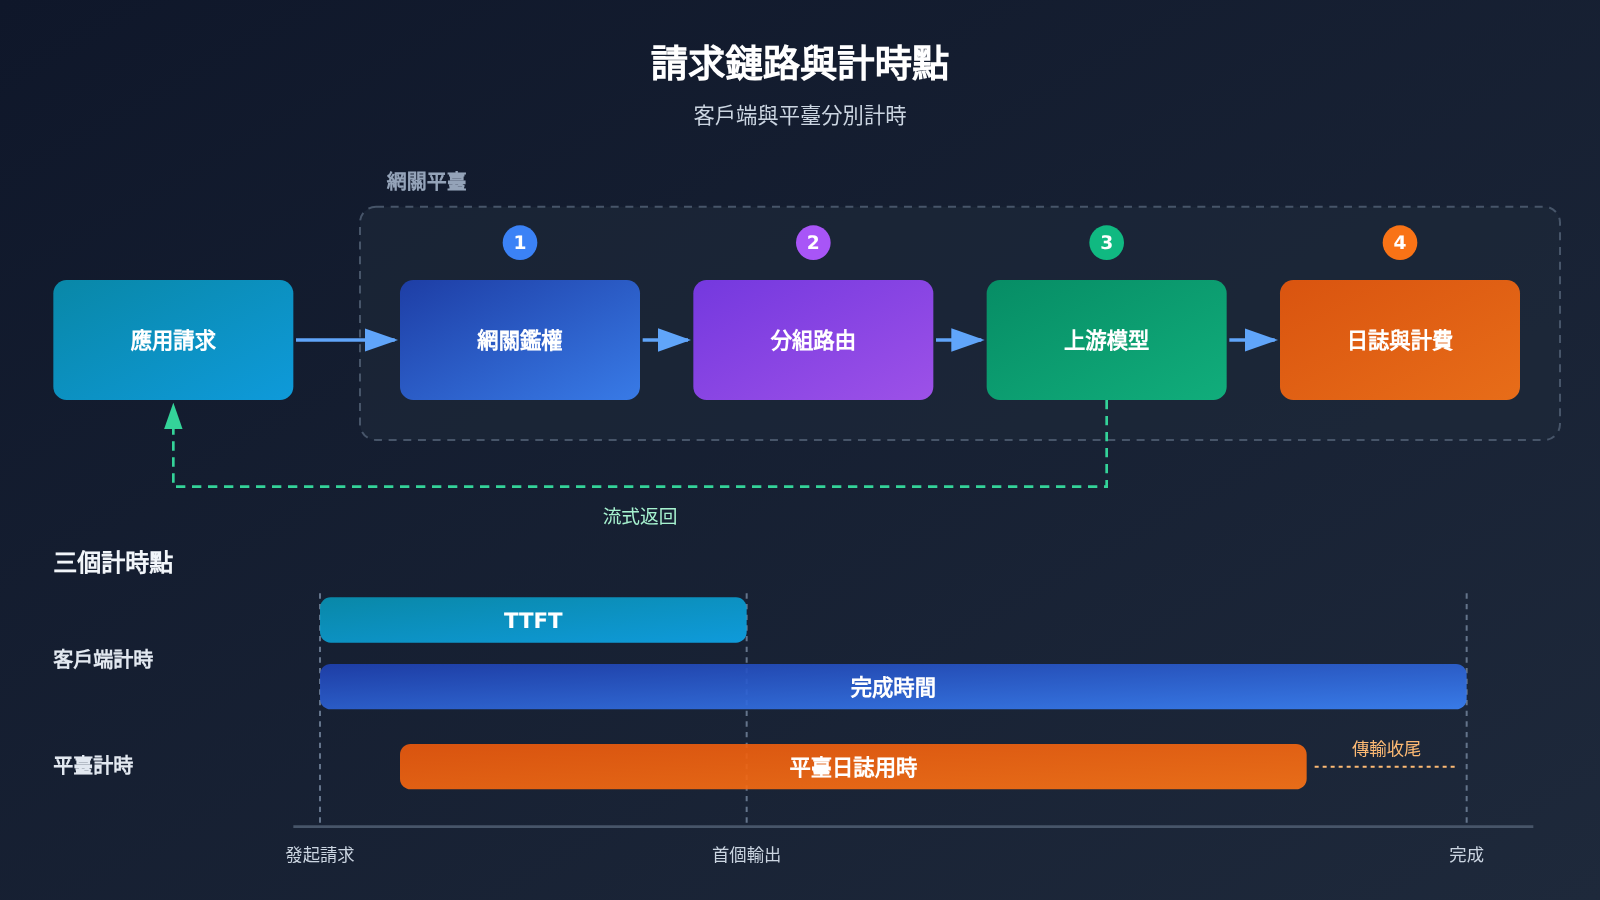
第三步是把計時口徑對齊。客戶端的等待時間與平臺日誌記錄的用時覆蓋的階段並不相同,官方文檔已經明確給出過“平臺記錄成功並計費、客戶端卻因響應傳輸或連接收尾而超時”的情形。後臺自動嘗試其他線路,也會讓整體等待變長。所以每次異常都要先用業務編號和 request_id 把客戶端記錄、平臺日誌、餘額變動三者對上,再決定要不要重試。
如何用固定任務測試網關能力和高峯負載
測試要可復現,就必須先固定變量:目標模型版本、通道或分組、調用接口、核心參數、網絡入口、輸入輸出規模、是否流式。任何一項變了,前後兩次數據就不能放在一起比較。樣本必須來自真實業務的脫敏數據,而不是“你好”這類玩具輸入。
下表是一份可以直接落地的驗收記錄模板,屬於方法建議,不含任何平臺實測結論。閾值由業務需求自己定,比如交互任務要求首個有效輸出在多少秒內、離線任務要求幾小時內交付多少可用結果。
| 維度 | 建議記錄 | 判斷方式 |
|---|---|---|
| 業務交付成功 | 請求總數、完整返回數、格式可用數、業務判定通過數 | 分母寫全,最終看業務可用結果比例 |
| 延遲 | 發起時間、首個有效輸出時間、完成時間、平臺日誌用時 | 客戶端與平臺分別計時,統計 p50 與 p95 |
| 核心能力 | 流式收尾、工具參數合法性、結構化輸出解析、長輸入處理 | 按本產品真實依賴的能力逐項通過 |
| 高峯負載 | 同時在途請求數、每分鐘請求數、429 比例、排隊與重試 | 保持請求規模一致,逐檔加壓並留觀察窗口 |
| 費用 | 每次扣費、退款、兜底費用、業務可用結果數 | 計算每個可用結果承擔的總成本 |
| 可排查性 | 業務編號、request_id、模型與分組、錯誤碼、工單答覆 | 能把異常訂單對應回平臺記錄 |
下面這段腳本只做一件事:在流式調用中同時記錄首個有效輸出時間和總耗時,方便你把客戶端計時和平臺日誌放在同一條時間線上比對。
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易統一接口
)

start = time.perf_counter()
stream = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "用一句話說明什麼是 API 網關"}],
    stream=True,
)
ttft = None
for chunk in stream:
    delta = chunk.choices[0].delta.content
    if delta and ttft is None:
        ttft = time.perf_counter() - start
total = time.perf_counter() - start
print(f"TTFT {ttft:.3f}s / total {total:.3f}s")
查看批量壓測與分位數統計代碼
import statistics
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易統一接口
)

def one_call(prompt: str) -> dict:
    start = time.perf_counter()
    ok, ttft = False, None
    try:
        stream = client.chat.completions.create(
            model="gpt-4o-mini",
            messages=[{"role": "user", "content": prompt}],
            stream=True,
        )
        for chunk in stream:
            delta = chunk.choices[0].delta.content
            if delta and ttft is None:
                ttft = time.perf_counter() - start
        ok = True
    except Exception as exc:
        return {"ok": False, "ttft": None,
                "total": time.perf_counter() - start, "err": type(exc).__name__}
    return {"ok": ok, "ttft": ttft,
            "total": time.perf_counter() - start, "err": None}

def summarize(rows: list) -> None:
    done = [r for r in rows if r["ok"]]
    totals = sorted(r["total"] for r in done)
    print(f"成功率 {len(done)}/{len(rows)}")
    if totals:
        print(f"p50 {statistics.median(totals):.3f}s")
        print(f"p95 {totals[int(len(totals) * 0.95) - 1]:.3f}s")

rows = [one_call("把下面這句話翻譯成英文:請檢查訂單狀態。") for _ in range(50)]
summarize(rows)
壓測時最常見的錯誤是把 RPM 和併發混爲一談。每分鐘請求數、每分鐘 token 數和同時在途請求數描述的是三種不同約束,互相不能替代。延遲上升之後重試還會放大系統壓力,所以腳本里必須帶上本地隊列、最大等待時間和有上限的退避重試。
這裏還有一個容易被忽略的細節:API易文檔中“併發”頁與“令牌與分組”頁對限速作用範圍的表述並不完全一致,前者提到多個令牌配額獨立,後者說明限速跟隨賬戶。驗收時的正確做法是用你自己的目標賬號和目標通道實測實際配額,分別記錄併發與 RPM,既不要套用別人截圖裏的固定數字,也不要靠多建 Key 試圖繞過限制。
每個可用結果的成本與兜底行爲怎麼覈對
比單價更值得比的是“每個業務可用結果的實際成本”。計算口徑很簡單:分子放全部已結算支出(含重試和兜底),分母放業務可用結果數,已確認的退款從分子裏減掉。
下面是一個純假設算例,只說明算法,不代表任何供應商價格。
| 方案 | 已結算淨支出 | 業務可用結果 | 每個可用結果成本 |
|---|---|---|---|
| 方案 A | 3.0 美元 | 90 個 | 約 0.0333 美元 |
| 方案 B | 3.2 美元 | 98 個 | 約 0.0327 美元 |
單看支出,方案 A 更便宜;按可用結果算,方案 B 反而更划算。這就是爲什麼“誰家便宜”這個問題在沒有業務分母的情況下沒有意義。還要注意兩件事:預扣但尚未結算的異步任務額度要單獨列出;只累計消費記錄可能高估淨支出,因爲異步任務退款會以負數記錄出現在賬單裏。
兜底部分要拆成兩種完全不同的變化。通道切換是在同一模型下換一條線路,模型能力和價格理論上不變;模型切換則是在主模型不可用時按列表嘗試別的模型,這在業界是一種常見機制,例如 OpenRouter 的 model fallbacks 就明確說明最終按實際使用模型的價格計費、並在響應的 model 字段中標明最終模型。這個例子只用來說明機制,字段含義不能移植到別的平臺。
因此驗收項至少覆蓋四點:兜底後的最終模型是誰、核心功能是否還成立、單次費用有沒有上限、最長等待時間是多少。如果某類業務不允許換模型,你還要確認兜底能否關閉。流式場景要單獨測:已經返回部分輸出之後再失敗,能不能無縫接上,無法從非流式的成功兜底裏推斷。
💡 選擇建議:把直連價格和兜底路徑放在同一張表裏對比,才看得出真實成本。想快速拿到多模型的實際扣費記錄做對比,可以通過 API易 apiyi.com 跑一組小樣本,再回到自己的驗收表裏覈算。
數據鏈路與故障責任怎麼覈對
這兩項最容易被“我們很安全”“我們很穩定”這類表述帶過,但它們恰恰是出事之後唯一能救你的東西。覈實的方法是把網關、上游模型服務商、詳細排障日誌和異步產物列在同一條數據鏈路上,逐層問清楚政策。
| 鏈路環節 | 需要覈對的政策 | 覈對方式 |
|---|---|---|
| 網關自身 | 默認是否保存輸入輸出、排障日誌誰能開、保留多久 | 讀取官方數據安全與日誌說明 |
| 上游模型服務商 | 訓練用途、保留期限、是否需要主動授權 | 分層閱讀各上游政策,不合併成一條 |
| 詳細排障日誌 | 記錄範圍、可見人員、默認保留期、關閉後的刪除時點 | 確認關閉開關不等於立即刪除既有記錄 |
| 異步任務產物 | 產物存儲位置、下載鏈接有效期 | 在業務側及時落盤,不依賴臨時鏈接 |
按公開文檔,API易 的常規策略是默認不保存客戶輸入輸出,詳細排障日誌可由管理員臨時開啓以記錄完整輸入、上下文和輸出,內容僅管理員可見,頁面給出的默認保留期爲 7—30 天;同時該頁面也說明關閉記錄開關的動作不能解釋成已立即刪除既有記錄。這類表述應當保留“官方文檔說明”的歸屬,它不等於合規認證,也不等於法律結論。
還有一個常被忽視的運維事實:日誌本身有生命週期。API易 的日誌保留專項說明寫明調用日誌滾動保留最近約兩個月,每月 5 日、15 日、25 日刪除距當日兩個月以前的記錄,清理不可恢復,長期對賬與審計所需明細需要自行導出保存。同步結果和異步產物的存儲期限又不一樣,頁面稱產物下載鏈接約一天有效。超過這個窗口再去覆盤,你手上就沒有證據了。
故障責任則要落到可執行的條款上。API易 的 SLA 專項頁介紹的是由平臺原因造成損失時的額度補發,以及企業可在合同中約定保障範圍、可用性指標、響應時效和賠償上限,該頁並沒有給所有客戶一個統一的固定可用率。對比供應商時應當記錄指標的統計週期、分母定義、故障排除項、申請流程和補償形式,並清楚區分服務額度補償與現金賠償在採購價值上的差異。
用一張驗收表決定上線範圍
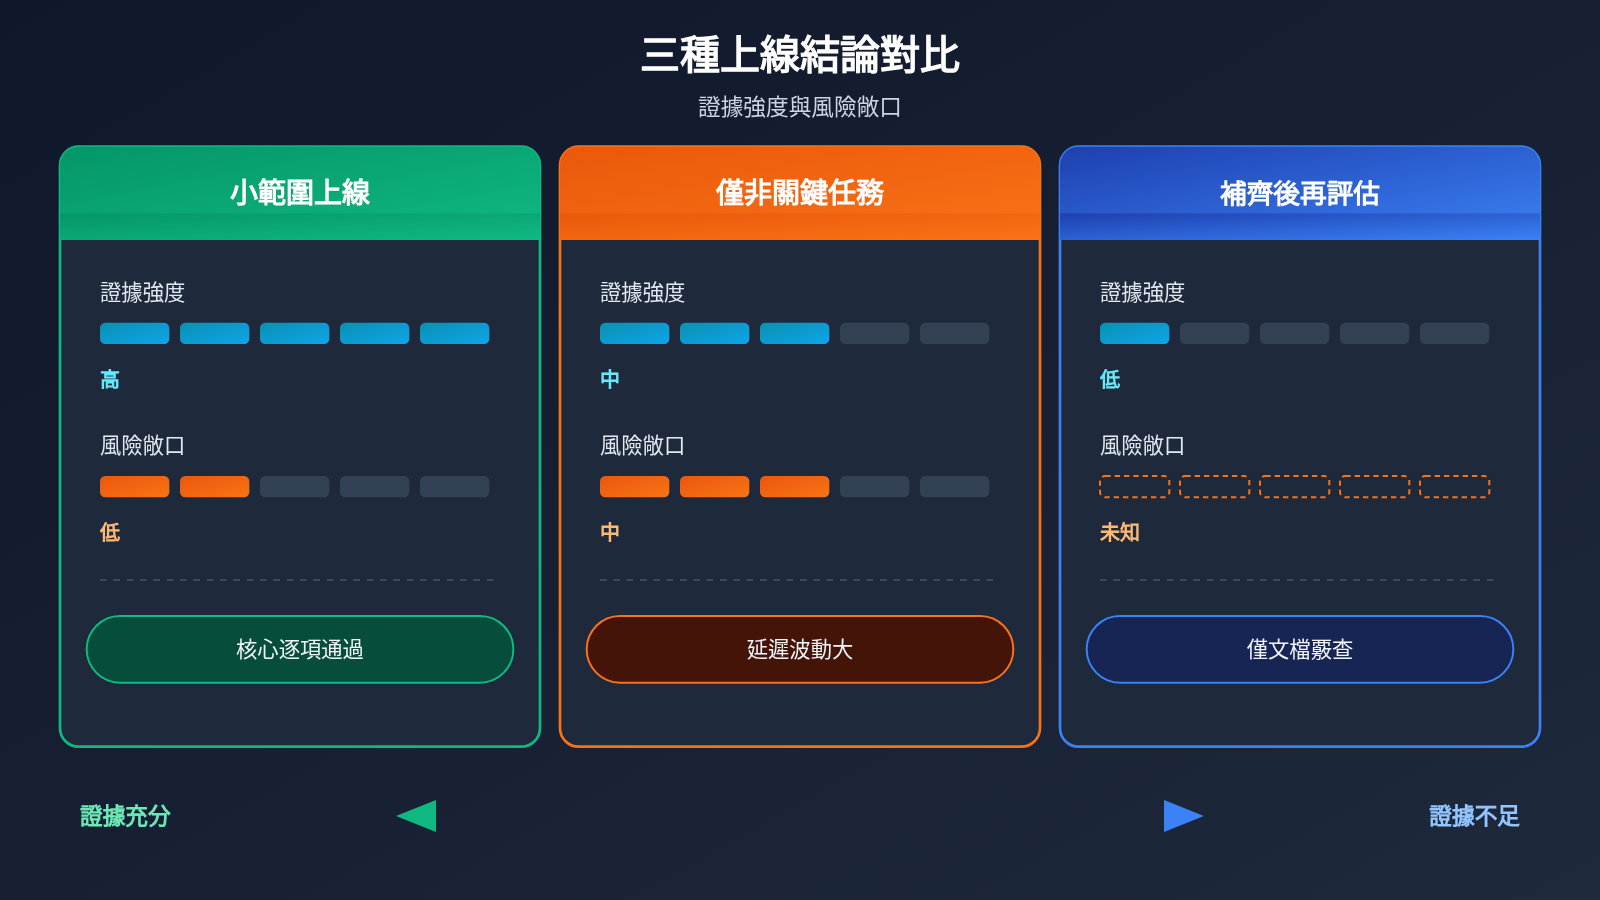
把所有記錄收束成結論時,不要給“可靠性排名”,要給範圍判斷。同一家供應商,在你的交互業務上可能只夠“非關鍵任務”,在你的離線批處理上卻完全夠用。
| 結論 | 需要拿出的證據 | 切換或停止的觸發條件 |
|---|---|---|
| 可以小範圍上線 | 核心能力逐項通過、p95 在業務閾值內、可用結果成本可接受、數據鏈路與 SLA 已覈對 | 連續出現業務可用率跌破閾值或計費異常無法對齊 |
| 僅用於非關鍵任務 | 能力通過但延遲波動大,或兜底會改變模型與費用 | 關鍵路徑切回自建或直連,兜底策略顯式關閉 |
| 條件補齊後再評估 | 只有文檔覈查、缺少本賬號實測,或 SLA 條款未落到合同 | 補齊實測數據與合同條款後重新出結論 |
如果暫時只能做文檔覈查,就把結論如實寫成“公開能力與採購條件已覈對”,把實際驗收留到下一輪。需要驗證故障處理行爲時,請使用供應商允許的測試配置或隔離環境,不要人爲干擾共享的生產服務;超時且結果不明時先覈對執行與計費,避免把同一個業務動作重複執行。
🚀 快速開始:如果不想從零搭測試腳本,可以先用 API易 apiyi.com 的免費測試額度把上面 7 項清單裏的“能力”和“延遲”兩欄跑一遍,再決定要不要進入更重的壓測階段。
常見問題 FAQ
Q1:大模型 API 中轉與網關到底是什麼?
它是應用和上游模型服務之間的入口層,接收請求後完成鑑權、計費、路由轉發和日誌記錄。所謂“中轉”,強調的是它把多家模型收斂成一個兼容接口,因此你換來的是接入便利,付出的是對底層鏈路的可見度。
Q2:直連官方 API 和用中轉網關,可靠性上差在哪?
差在鏈路的層數和責任邊界。直連時你只需判斷一個上游;走網關時,網關自身、分組通道和上游供應商三層都可能成爲故障點,但也多了一層兜底和統一日誌的可能。判斷方法不是比誰更快,而是按本文的 5 個層面分別取證。
Q3:爲什麼不能只看平均延遲?
因爲平均值會掩蓋少數極慢的請求,而這批請求往往就是用戶投訴的來源。流式交互還應把 TTFT 和完整完成時間分開統計,並寫清樣本數、時間窗以及是否包含失敗、排隊與重試,否則 p95 也沒有可比性。
Q4:請求成功了但內容不能用,算不算平臺的問題?
通常不算,但成本要算。平臺正常完成請求就會計費,輸出結構無效屬於業務側需要重試的部分,這筆重複支出應當計入“每個可用結果成本”的分子。所以驗收表裏必須把平臺執行成功和業務判定通過分成兩列。
Q5:怎麼快速驗證一家網關能不能支撐我的業務?
用你自己的脫敏樣本固定模型、通道、參數和輸入規模,跑一輪小樣本,記錄 TTFT、p95、業務可用結果比例和扣費明細。可以通過 API易 apiyi.com 領取測試額度完成這一輪,再把數據填回驗收表,而不是憑一次連通測試下結論。
Q6:這套方法有哪些已知侷限?
小樣本的 p95 波動很大,不能當作長期服務承諾;不同時間段的上游負載差異也會影響結論,需要多時段重複。此外,本文所有計算口徑都屬於方法建議,不含任何平臺的實測性能數據或實際賬單,最終判斷仍要結合你自己的業務閾值與合同條款。
大模型 API 中轉網關核心要點 Key Takeaways
- 可靠性要按業務驗收定義:平臺計費成功、客戶端拿到 200、業務解析通過,是三件需要分別計數的事。
- 延遲要分兩個計時點:TTFT 決定交互體驗,完整完成時間決定交付能力,兩者都要看 p95。
- RPM 與併發必須分開記:低 RPM 也可能堆出高在途併發,限速口徑以目標賬號實測爲準。
- 成本按可用結果算:全部已結算支出除以業務可用結果數,重試和兜底都要進分子。
- 兜底要區分通道切換與模型切換:最終模型、核心功能、費用上限、最長等待四項逐一驗收。
- 數據與責任要看可執行條款:日誌有保留窗口,SLA 要有統計口徑、排除項與補償形式。
- 上手路徑:先用 API易 apiyi.com 的小樣本跑通能力與延遲兩欄,再進入壓測與合同覈對。
總結
判斷一家大模型 API 中轉與網關是否靠得住,本質上是一道取證題,而不是一道印象題。把“能不能用”拆成業務可用結果、端到端延遲、可用結果成本、數據鏈路和故障責任五個層面,每一項都留下可覈對的記錄,你就能在上線前把大部分意外提前變成已知項。
落地時記住三條:結論只寫範圍,不寫排名;口徑只寫自己實測的,不寫別人截圖裏的;證據只寫到能複查的,因爲日誌會過期。這三點做到,選型討論就不再依賴誰的聲音更大。
推薦通過 API易 apiyi.com 先完成一輪小樣本驗收,平臺提供統一接口與免費測試額度,便於把多個模型放在同一張表裏對比。
參考資料
- API易令牌與分組:多 Key、額度、資源分組與兜底分組說明
- 鏈接:
docs.apiyi.com/faq/token-and-groups -
說明: 覈對 Key 分配、資源分組與主備通道機制
-
API易日誌保留與清理政策:日誌滾動保留與導出說明
- 鏈接:
docs.apiyi.com/faq/log-retention-policy -
說明: 確認對賬與審計所需明細的自存窗口
-
API易詳細日誌說明:排障日誌的開啓範圍與保留期
- 鏈接:
docs.apiyi.com/faq/user-logs-control -
說明: 覈對數據鏈路上的日誌層級
-
API易數據安全說明:默認不保存輸入輸出的策略說明
- 鏈接:
docs.apiyi.com/faq/data-security -
說明: 與上游政策分層對照閱讀
-
API易 SLA 保障:額度補發與合同約定範圍
- 鏈接:
docs.apiyi.com/faq/sla-guarantee -
說明: 瞭解故障責任的補償形式與邊界
-
怎麼看懂日誌裏的計費金額:賬單字段與倍率口徑
- 鏈接:
docs.apiyi.com/faq/log-billing-explained -
說明: 用於覈算每個可用結果的實際成本
-
日誌完成並扣費但客戶端收不到響應:客戶端超時與平臺計費的差異
- 鏈接:
docs.apiyi.com/faq/log-duration-vs-client-wait -
說明: 異常訂單排查的必讀材料
-
鏈接:
openrouter.ai/docs/guides/routing/provider-selection -
說明: 理解通道切換與模型切換的區別
-
OpenRouter Model Fallbacks:模型兜底與實際計費口徑
- 鏈接:
openrouter.ai/docs/guides/routing/model-fallbacks - 說明: 說明最終模型與計費歸屬的業界做法
作者: APIYI 技術團隊
技術交流: 歡迎在 API易 apiyi.com 首頁聯繫我們,更多文檔可訪問 docs.apiyi.com 文檔中心


