
Примечание автора: чтобы сделать видео, нужно расшифровать речь, разобрать кадры, подготовить обложку и поправить текст. Модели могут выполнять каждый свою часть, но платные шаги лучше свести к одному base_url — тогда счета будут сходиться.
Если вы делали полноценное длинное видео, то наверняка замечали такую картину: транскрибация — в одном сервисе, анализ кадров — в другом, обложка — в третьем, а для правки заголовка и текста открывается ещё одно окно. Каждый шаг по отдельности выглядит разумно, но в конце месяца при сверке получается четыре-пять счетов с разными принципами расчёта: где-то по токенам, где-то за вызов, а где-то ещё и подписка примешана. В этой статье речь пойдёт о сохранении разделения обязанностей и сведении счетов в одну точку: сначала разберёмся, какой шаг можно оставить локально, а какой действительно создаёт расходы, а затем переведём платные шаги на единую точку входа для вызовов.
Это не призыв использовать только одну модель. Для разных этапов и так подходят разные модели; объединять нужно точку тарификации и принципы сверки, а не сами модели.
Главная ценность: после прочтения вы получите таблицу разделения «локально / платно» для видеопайплайна, сверенную по состоянию на 2026-11-20 таблицу моделей и цен, а также способ перевести платные шаги на один base_url.
Главные моменты: одно видео, несколько моделей
Поводом для этого разговора стал навык для видеомонтажа, о котором MindStudio рассказала 2026-11-19. Автор утверждает, что на длинное видео с продвинутым мультимодальным пайплайном у него ушло около 2.71 доллара. Сразу уточним: это слова самого автора, он работал через OpenRouter — это не счёт APIYI и не результат измерений в этой статье. Ценность цифры в другом: стоимость моделей для одного видео можно удержать на очень низком уровне, если понимать, на каких шагах уходят деньги.
| Что важно | Что это значит | Зачем |
|---|---|---|
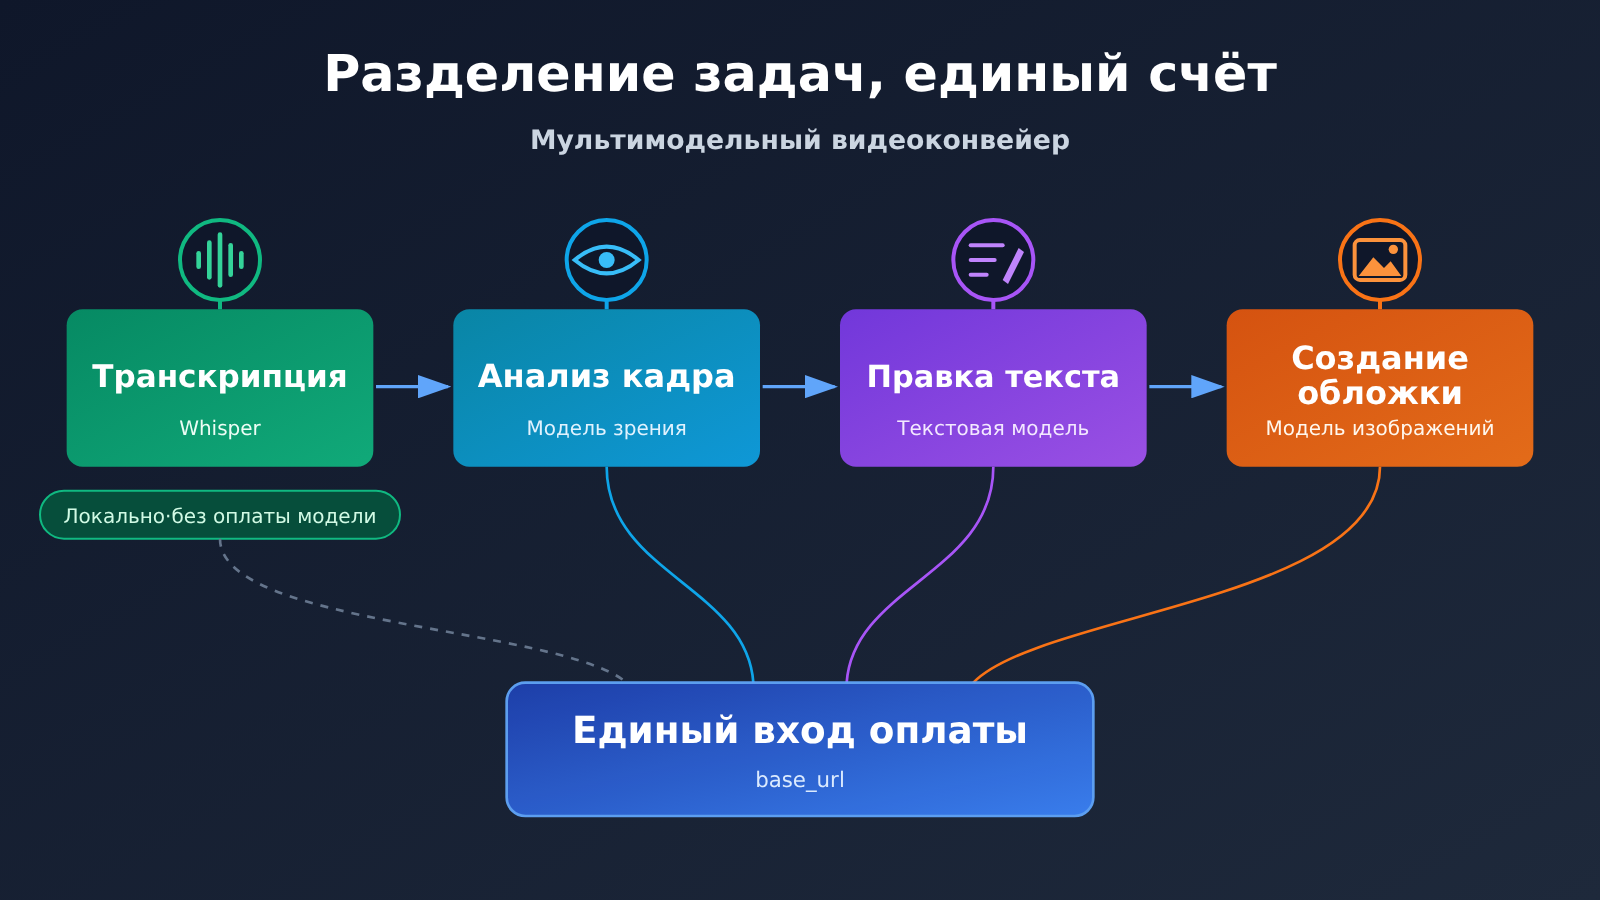
| Сначала разделить локальное и платное | Транскрипцию можно сделать локальным Whisper — без оплаты моделей | Меньше счетов и меньше данных уходит наружу |
| Платные шаги — в одно место | Анализ кадров, правка текста и создание обложки идут через один base_url | Все расходы видны в одной панели |
| Смена модели — только ID | Интерфейс совместим с OpenAI: при переключении меняется поле model |
Распределение задач можно менять когда угодно, не переписывая код |
| Плата за вызов и за токены считается отдельно | Обложка — за вызов, текст и визуальные задачи — по токенам | Понятно, как оценивать бюджет |
| Шаги вне каталога учитываем отдельно | Клонирование голоса недоступно в каталоге APIYI | При сверке расходов не ошибёшься |
Подробнее о разделении задач в видеопайплайне
Первый важный момент — само разделение задач. Чтобы смотреть кадры и понимать, что происходит в сцене, нужна модель с сильным мультимодальным пониманием и способностью работать с длинным контекстом. Для обложки нужна модель генерации изображений. А правка текста чувствительна к качеству письма и стоимости. Если пытаться впихнуть всё это в одну модель, обычно где-то падает качество или где-то раздувается цена. Так что разделение оправдано — проблема только в том, что у каждого сервиса приходится отдельно открывать аккаунт, отдельно пополнять баланс и отдельно получать счёт.
Второй важный момент — свести всё в одну точку. APIYI apiyi.com — агрегатор API для больших языковых моделей: один API-ключ даёт доступ к OpenAI, Claude, Gemini и другим популярным моделям, интерфейс совместим с OpenAI, оплата по факту использования. Для видеопайплайна это значит, что анализ кадров, правка текста и создание обложки могут работать через один ключ и один base_url, а расходы учитываются в одном месте. При смене модели вы меняете ID модели, а не поставщика и не SDK.
Быстрый старт: когда для одного видео нужно несколько моделей
Шаг 1: разделите видеоконвейер на локальную и платную части
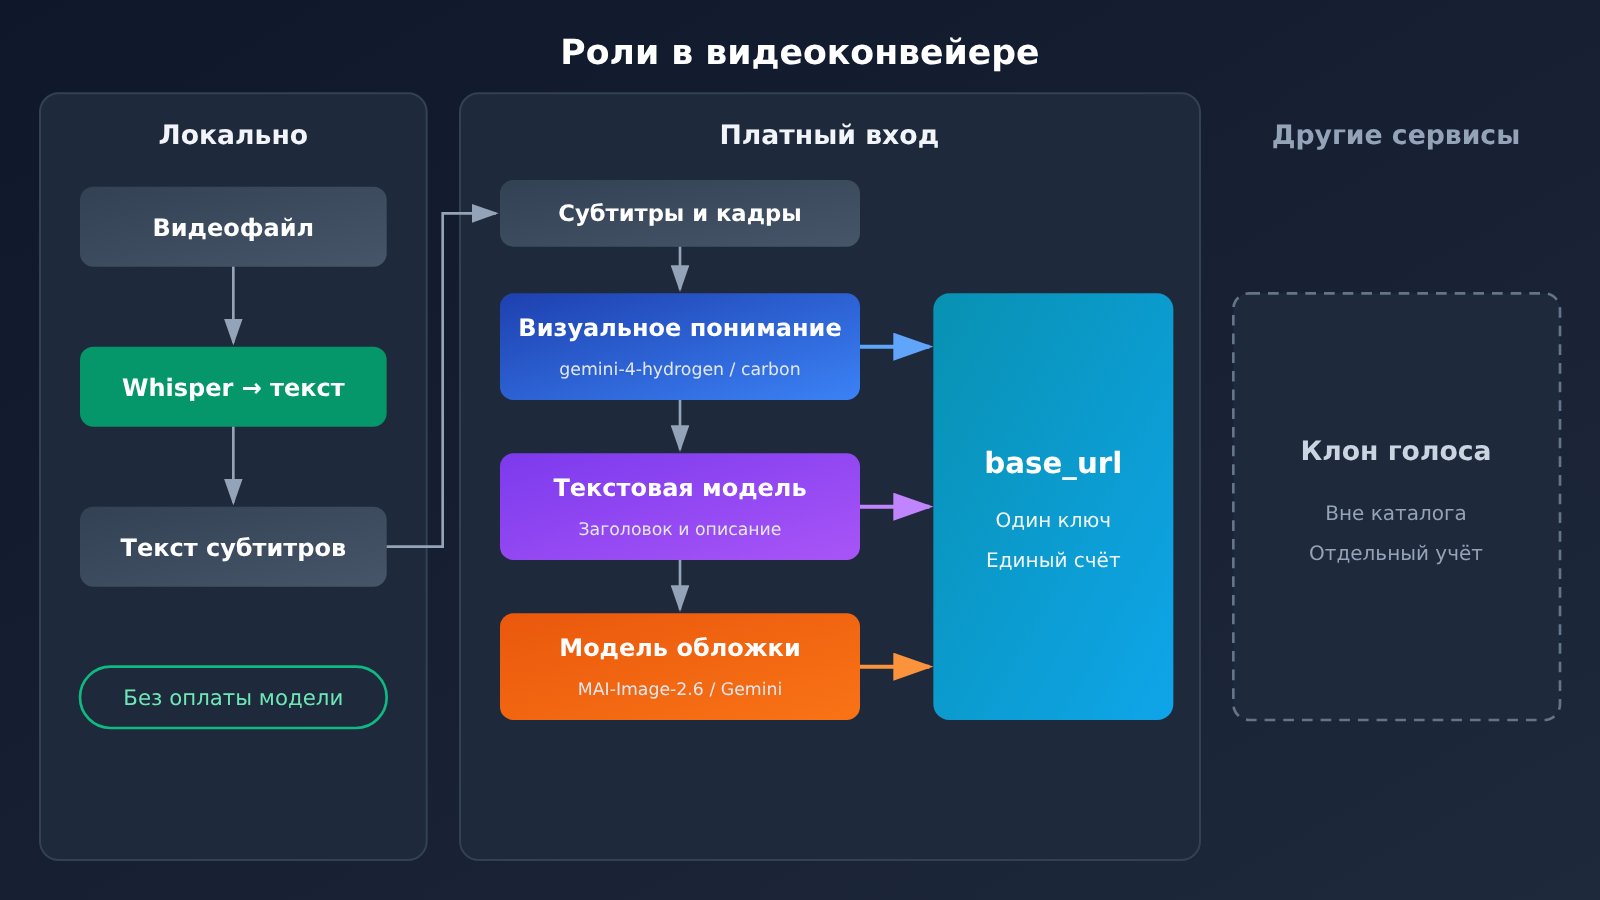
Перед подключением API сначала четко определите, какие шаги платные. В таблице ниже — типичный способ разбиения длинного видеоконвейера; можете добавлять или удалять строки под свой процесс.
| Этап | Где запускать | Есть ли плата за модель | Как считается |
|---|---|---|---|
| Транскрипция аудио | локальный Whisper | нет | только ресурсы машины |
| Монтаж, склейка, экспорт | локальный видеоредактор | нет | нет |
| Просмотр кадров, понимание сцен | единая точка входа API | да | по входным / выходным токенам |
| Правка заголовка, написание описания | единая точка входа API | да | по входным / выходным токенам |
| Создание обложки | единая точка входа API | да | за операцию |
| Клонирование голоса | другой сервис | да | не в каталоге APIYI, отдельный учет |
После такого разбиения к единой точке входа нужно свести только три платных этапа. Транскрипцию держим локально: и за модель не платим, и исходное аудио не нужно загружать. Если клонирование голоса действительно нужно, это будет отдельный счет — в бюджете на него нужно выделить место отдельно, а не включать в единую точку входа.
Шаг второй: определяем модель и цену
Дальше — смотрим модели и сверяем цены. Цены ниже проверены по состоянию на 2026-11-20, источник — сводная таблица моделей APIYI docs.apiyi.com/models.md (версия обновлена 2026-11-19 10:59, UTC+8) и интерфейс ценообразования api.apiyi.com/api/pricing (версия shell-api-modelmak-v1). В интерфейсе ценообразования model_ratio, равный 1, соответствует входу 2 доллара за миллион токенов — по этому коэффициенту можно пересчитывать самостоятельно.
| ID модели | Вход (долл./млн токенов) | Выход | Чтение кэша | Для какого этапа подходит |
|---|---|---|---|---|
gemini-4-hydrogen |
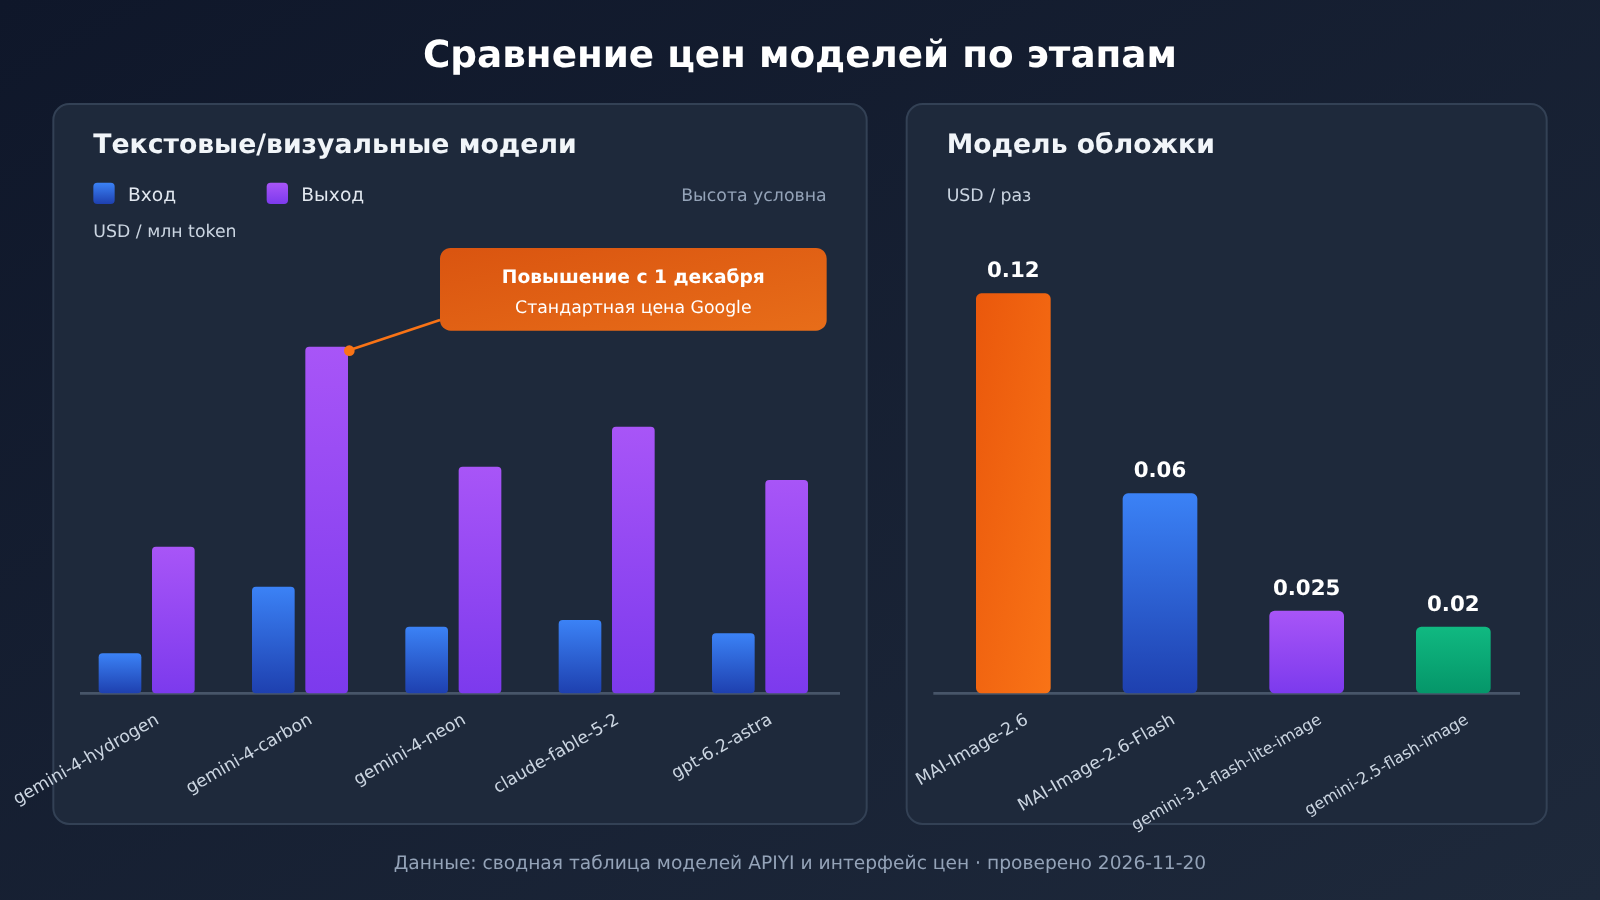
1.5 | 7.5 | 0.075 | Работа с изображением, правка текста, экономный вариант |
gemini-4-carbon |
2 | 10 | 0.1 | Работа с изображением, правка текста, вводная цена действует до 2026-11-30 |
gemini-4-argon |
2 | 10 | 0.1 | Текстовые задачи и задачи на понимание |
gemini-4-neon |
3 | 15 | 0.15 | Запасной вариант, когда нужна мощность побольше |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 40 | 0.2 | Долгая шлифовка текста, сложные переписывания |
gpt-6.2-astra |
8 (16 при превышении 272000 токенов) | 40 | 0.4 | Требовательные текстовые задачи |
На что стоит обратить внимание особо — на два момента. Цены gemini-4-carbon 2 / 10 / 0.1 совпадают с вводной ценой Google, действующей до 2026-11-30; с 1 декабря стандартная цена Google составит вход 4, выход 20 — стоимость тогда удвоится, и перед длинными пакетными запусками цену нужно перепроверять. У gpt-6.2-astra после превышения 272000 токенов сводная таблица указывает вход 16, а интерфейс ценообразования на этом тарифе даёт ещё и выход 60, чтение кэша 0.8 — при расхождении двух источников ориентируйтесь на фактическое списание в панели при вашем реальном вызове. Модель gemini-4-neon в этой версии сводной таблицы не указана, но в интерфейсе ценообразования запись есть, и результат пересчёта совпадает с ценой Google по прайс-листу.
Обложки тарифицируются за вызов, поэтому для них отдельная таблица:
| ID модели обложки | Цена за вызов (долл.) | Подходящий сценарий |
|---|---|---|
MAI-Image-2.6 |
0.12 | Основная обложка, когда нужно качество повыше |
MAI-Image-2.6-Flash |
0.06 | Много вариантов черновиков |
gemini-3.1-flash-lite-image |
0.025 | Массовые наброски |
gemini-2.5-flash-image |
0.02 | Дешёвая быстрая генерация |
Учтите: MAI-Image-2.7 пока не существует, не прописывайте её в скрипте как вызываемую модель. Kling, Muse и gemini-4-flash-lite тоже отсутствуют и в сводной таблице, и в интерфейсе ценообразования — при планировании пайплайна сразу их исключайте.
Шаг 3: переводим платные шаги на единый base_url
На этом шаге изменений совсем немного. Если вы уже используете официальный SDK OpenAI, достаточно поменять два места:
- заменить
api_keyна ключ, созданный в панели APIYI; - установить
base_urlвhttps://api.apiyi.com/v1.
Дальше в запросах для анализа кадров указывайте model = gemini-4-hydrogen, в запросах для правки текста — claude-fable-5-2 или продолжайте использовать Gemini, а для генерации обложки — MAI-Image-2.6-Flash. Все три этапа используют один объект клиента, разница только в ID модели. Диалоговые запросы идут через совместимый с OpenAI /chat/completions; конкретные параметры и формат ответа для графических моделей смотрите в документации модели.
Посмотреть чек-лист настроек по этапам
— **Клиент**: инициализируйте один раз, `base_url` не меняйте, ключ храните в переменной окружения, например `APIYI_API_KEY`.
— **Анализ кадров**: подайте на вход скриншоты ключевых кадров и локально расшифрованные субтитры, `model` укажите `gemini-4-hydrogen`; если бюджет позволяет или нужно более глубокое понимание, переключитесь на `gemini-4-carbon`.
— **Правка текста**: используйте как контекст сводку по сценам из предыдущего шага, в `model` выберите `claude-fable-5-2`; для длинных текстов, где нужно многошаговое рассуждение, подойдёт `claude-fable-5-2-thinking`.
— **Создание обложки**: сначала сделайте несколько черновиков с `gemini-2.5-flash-image`, после утверждения финального варианта создайте итоговую обложку с `MAI-Image-2.6`.
— **Кеш**: субтитры одного видео многократно читаются на разных этапах; старайтесь, чтобы общая часть имела одинаковый префикс — так вы попадёте в кеш и будете платить по цене за чтение из кеша.
— **Логи**: для каждого запроса записывайте ID модели и возвращённый расход токенов, а в конце месяца сверяйте по позициям с расходом в панели.
🚀 Совет для быстрого старта: сначала используйте бесплатный тестовый лимит для новых пользователей на APIYI apiyi.com, полностью прогоните один короткий ролик по трём шагам выше, запишите фактический расход токенов на каждом этапе — и только потом решайте, модель какого уровня брать для длинных видео.
Шаг четвёртый: оцениваем бюджет одного видео
При расчёте разделяйте оплату по токенам и по вызовам. Возьмём гипотетический пример: если просмотр кадров и правка текста вместе съедают 1 млн входных токенов и 100 тыс выходных, то при использовании gemini-4-hydrogen это 1,5 + 0,75, то есть примерно 2,25 доллара; обложка — 4 черновых варианта на Flash и 1 финальное изображение — это 4 × 0,06 + 0,12, то есть 0,36 доллара. Количество токенов здесь — лишь условные значения для демонстрации; ваш реальный расход зависит от длительности видео, плотности кадров и числа итераций текста.
Удобство такого метода оценки в том, что каждый пункт можно построчно сверить с детализацией счёта в панели управления. Для сравнения: если четыре этапа распределены между четырьмя разными сервисами, то курсы валют, единицы тарификации и моменты списания везде разные — и даже при небольшой итоговой сумме сверка занимает много времени.
Часто задаваемые вопросы (FAQ)
Q1: Одно видео и несколько моделей — какие именно шаги имеются в виду?
Обычно это четыре шага: транскрипция, анализ кадров, правка текста и создание обложки. В некоторых процессах добавляются ещё озвучка или клонирование голоса. Транскрипцию можно сделать локально через Whisper — за неё платить модели не нужно. А вот реальные расходы на модели обычно дают как раз анализ кадров, генерация обложки и правка текста.
Q2: Разделение задач и единая точка входа — это не противоречие? Может, проще использовать одну модель?
Никакого противоречия. Разделение задач нужно, чтобы совместить качество и стоимость, а единая точка входа — чтобы удобно было платить и сверять счета. С одной моделью, конечно, проще, но требования к анализу кадров, написанию текста и генерации изображений очень разные, и попытка всё унифицировать обычно обходится дороже, чем экономит. Разумнее выбирать модели под каждую задачу отдельно, а точку вызова держать одну.
Q3: Можно ли взять $2.71 за длинное видео как готовый бюджет?
Лучше не переносить эту цифру напрямую. Это число из пересказа автора в MindStudio, работа шла через OpenRouter, а не через счёт APIYI, и набор моделей, длина видео и количество извлечённых кадров у вас могут быть другими. Надёжнее пересчитать по шагу 4 этой статьи, подставив свой расход токенов и текущие цены.
Q4: Для анализа кадров брать gemini-4-hydrogen или gemini-4-carbon?
Если приоритет — бюджет, берите `gemini-4-hydrogen`: вход 1.5, выход 7.5, чтение из кэша 0.075 — самая низкая цена в этой группе. Если нужно более сильное понимание, выбирайте `gemini-4-carbon`, но учитывайте, что его 2 / 10 — это вводная цена, действующая до 2026-11-30. С 1 декабря Google устанавливает стандартную цену: вход 4, выход 20. Перед долгим использованием цены надо перепроверить.
Q5: Как перевести существующий скрипт на единую точку входа?
Зарегистрируйтесь на APIYI apiyi.com и создайте API-ключ, затем поменяйте `base_url` в SDK на адрес вызова платформы и поправьте поле `model` под каждый этап. Структуру запросов менять почти не придётся. Новым пользователям дают бесплатный тестовый лимит — можно сначала прогнать весь конвейер на одном коротком видео.
Q6: Клонирование голоса тоже можно пустить через эту точку входа?
Нет. Клонирования голоса сейчас нет в каталоге APIYI — если оно нужно, придётся использовать другой сервис и вести отдельный учёт. При планировании бюджета лучше вынести его отдельной строкой, чтобы не смешивать с расходами через единую точку входа.
Q7: Есть ли известные ограничения, которые стоит обходить заранее?
Есть несколько моментов: `MAI-Image-2.7` сейчас недоступна, а Kling, Muse и `gemini-4-flash-lite` не находятся ни в сводной таблице, ни в API цен — не вписывайте их в скрипты. У `gpt-6.2-astra` после 272000 токенов цена повышается, причём сводная таблица и API цен дают немного разные детали градаций — ориентируйтесь на фактическое списание. Цены меняются, так что перед прогоном лучше сверяться со сводной таблицей моделей на текущий день.
Ключевые моменты: несколько моделей на одну видео
- Сначала разобрать, потом собрать: транскрипцию и монтаж оставляем локально, к API подключаем только те этапы, которые генерируют расходы.
- Разделение труда сохраняем: для просмотра кадров, правки текста и обложки выбираем самую подходящую модель — необязательно всё делать на одной.
- Единая точка входа: платные шаги используют один Key и base_url, при смене модели меняется только ID модели.
- Учёт раздельный: текст и визуал считаются по токенам, обложка — поштучно; бюджет ведём по двум колонкам.
- Следите за сроками: вводная цена
gemini-4-carbonдействует до 2026-11-30, дальше стандартная цена повышается. - Что вне каталога — отдельной строкой: клонирование голоса не входит в единую точку входа, его нужно учитывать отдельно.
- Внешние цифры — только ориентир: 2.71 доллара — это собственные данные автора на OpenRouter, а не счёт от APIYI.
Итог
Запускать на одну видео несколько моделей — само по себе не проблема. Проблема в том, что счёт оказывается разбит так, что концы с концами не сходятся. Если собрать всё вместе, получается три пункта:
- Локально в первую очередь: транскрипция через локальный Whisper, монтаж на месте — эти два шага не создают расходов на модели.
- Платные шаги — в одну точку: просмотр кадров, правка текста и обложка идут через один base_url, а разделение — по ID модели.
- Считаем по ценам дня: оценки по токенам и поштучно ведём отдельно, перед прогоном заново сверяем цены и актуальные модели в каталоге.
Совет: сначала прогнать весь пайплайн на одном коротком видео, записать реальный расход на каждом этапе, и только потом масштабировать на длинные видео. Рекомендую пройти эту проверку в APIYI apiyi.com на бесплатном тестовом лимите — разделение труда прежнее, а счёт смотрим в одном месте.
📚 Справочные материалы
-
Сводная таблица моделей APIYI: обзор моделей и цен за единицу
- Ссылка:
docs.apiyi.com/models.md - Пояснение: основной источник цен в этой статье; версия обновлена 2026-11-19 10:59 (UTC+8)
- Ссылка:
-
Интерфейс цен APIYI: актуальные цены с пересчётом по коэффициентам
- Ссылка:
api.apiyi.com/api/pricing - Пояснение: версия
shell-api-modelmak-v1,model_ratioравный 1 соответствует входу 2 доллара за миллион токенов
- Ссылка:
-
Пересказ о навыке видеомонтажа MindStudio: опубликовано 2026-11-19
- Пояснение: утверждение о 2.71 доллара за одно длинное видео взято из слов самого автора, пересказанных в той статье; работа идёт через OpenRouter
Автор: техническая команда APIYI
Техническое общение: будем рады, если вы свяжетесь с нами на главной странице официального сайта APIYI; больше моделей и описаний вызова — в центре документации docs.apiyi.com


