
Примечание автора: в этой статье официальный верхний предел скорости GPT-6.2 Sol Ultrafast, акционная цена и цена по прайс-листу указаны отдельно, а также приведён алгоритм расчёта наценки за скорость, который можно применить к собственной задаче.
Стоит ли включать Ultrafast для GPT-6.2 Sol — зависит от того, сколько ожидания сэкономит конкретная задача. Официально указанная скорость — до 4,5 раза выше, чем в стандартном режиме той же модели, цена в акционный период — в 3 раза больше стандартной цены, а цена по прайс-листу с марта 2027 года — в 6 раз больше. Скорость — это верхний предел, цена — конкретное число; степень определённости у них разная, поэтому напрямую делить одно на другое нельзя.
Эта статья не даёт за вас ответ на вопрос «стоит ли покупать». Мы не делаем собственных выводов по скорости и не принимаем единичный замер из сообщества без контрольной группы за окончательный результат. Статья предлагает только алгоритм: сначала измерьте время выполнения своей задачи в стандартном режиме, затем по официальному «максимальному» коэффициенту рассчитайте верхнюю границу экономии времени и в конце сравните её с разницей в цене.
Главная ценность: прочитав статью, вы сможете для любой задачи рассчитать, «сколько нужно доплатить за каждую сэкономленную минуту», и уже по задаче решать, включать ли скоростной режим.
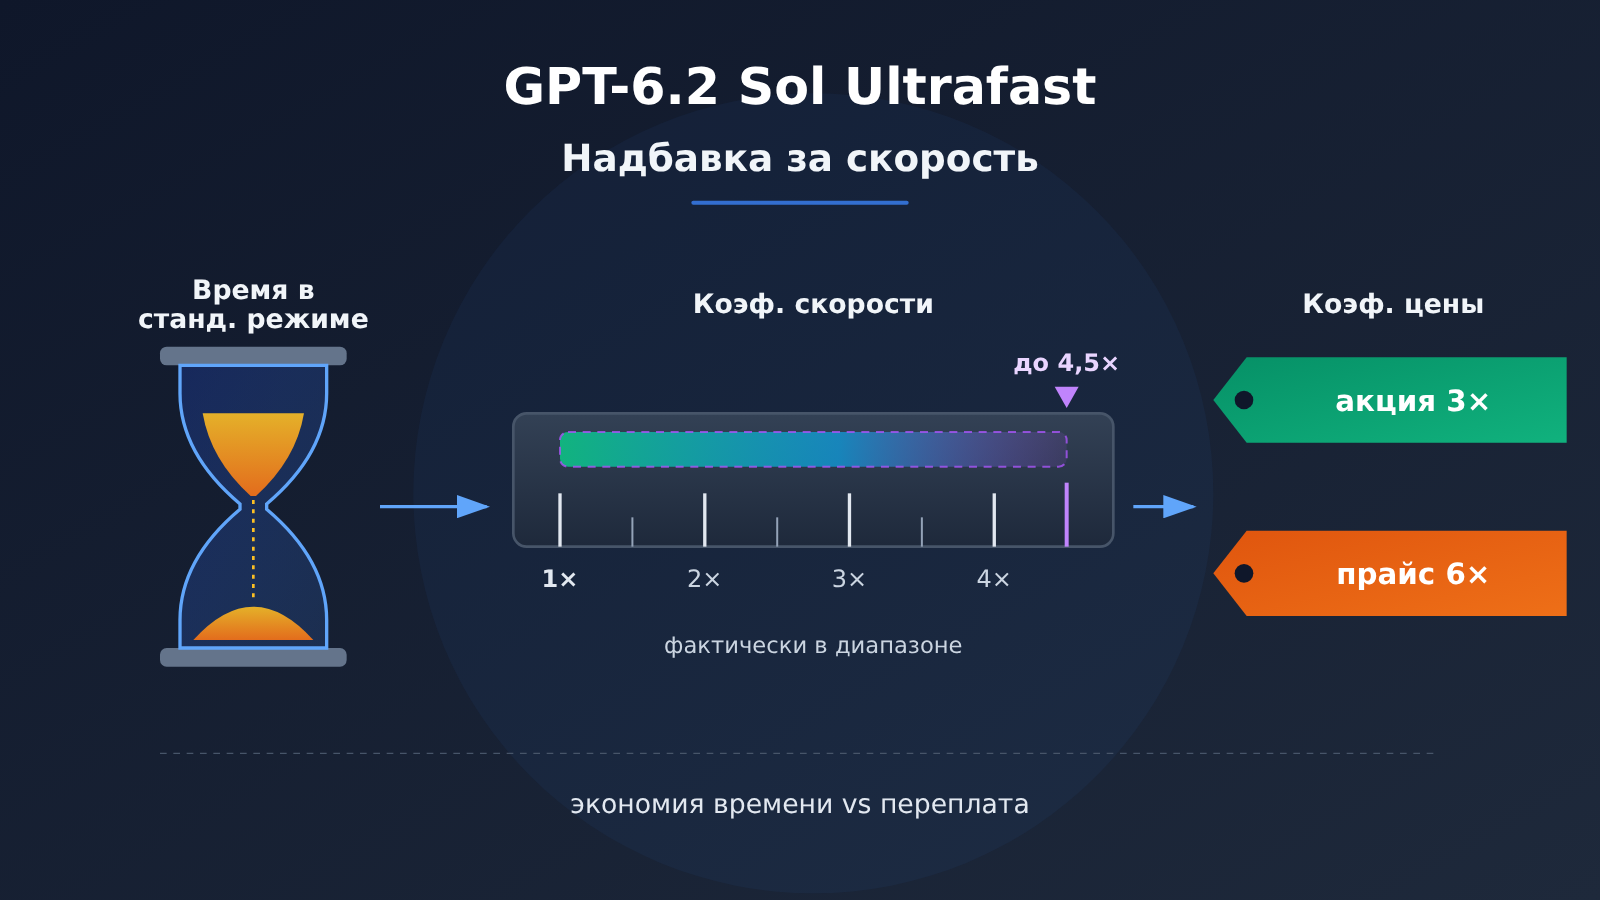
GPT-6.2 Sol Ultrafast: в чём ключевая разница в наценке за скорость
Сначала нужно прояснить один момент: Ultrafast — это уровень обслуживания, а не отдельная модель. Если следовать официальной документации API, в запросе параметр model по-прежнему остаётся gpt-6.2-sol, нужно лишь дополнительно указать service_tier со значением ultrafast. Сейчас этот уровень обслуживания поддерживают GPT-6.2 Astra, GPT-6.2 Sol, GPT-6 Astra и GPT-6.1 Sol.
Получается, вы сравниваете две скорости поставки одной и той же модели, а не разницу в возможностях двух моделей. Вопрос качества вывода можно оставить в стороне — здесь остаются всего две переменные: время и цена.
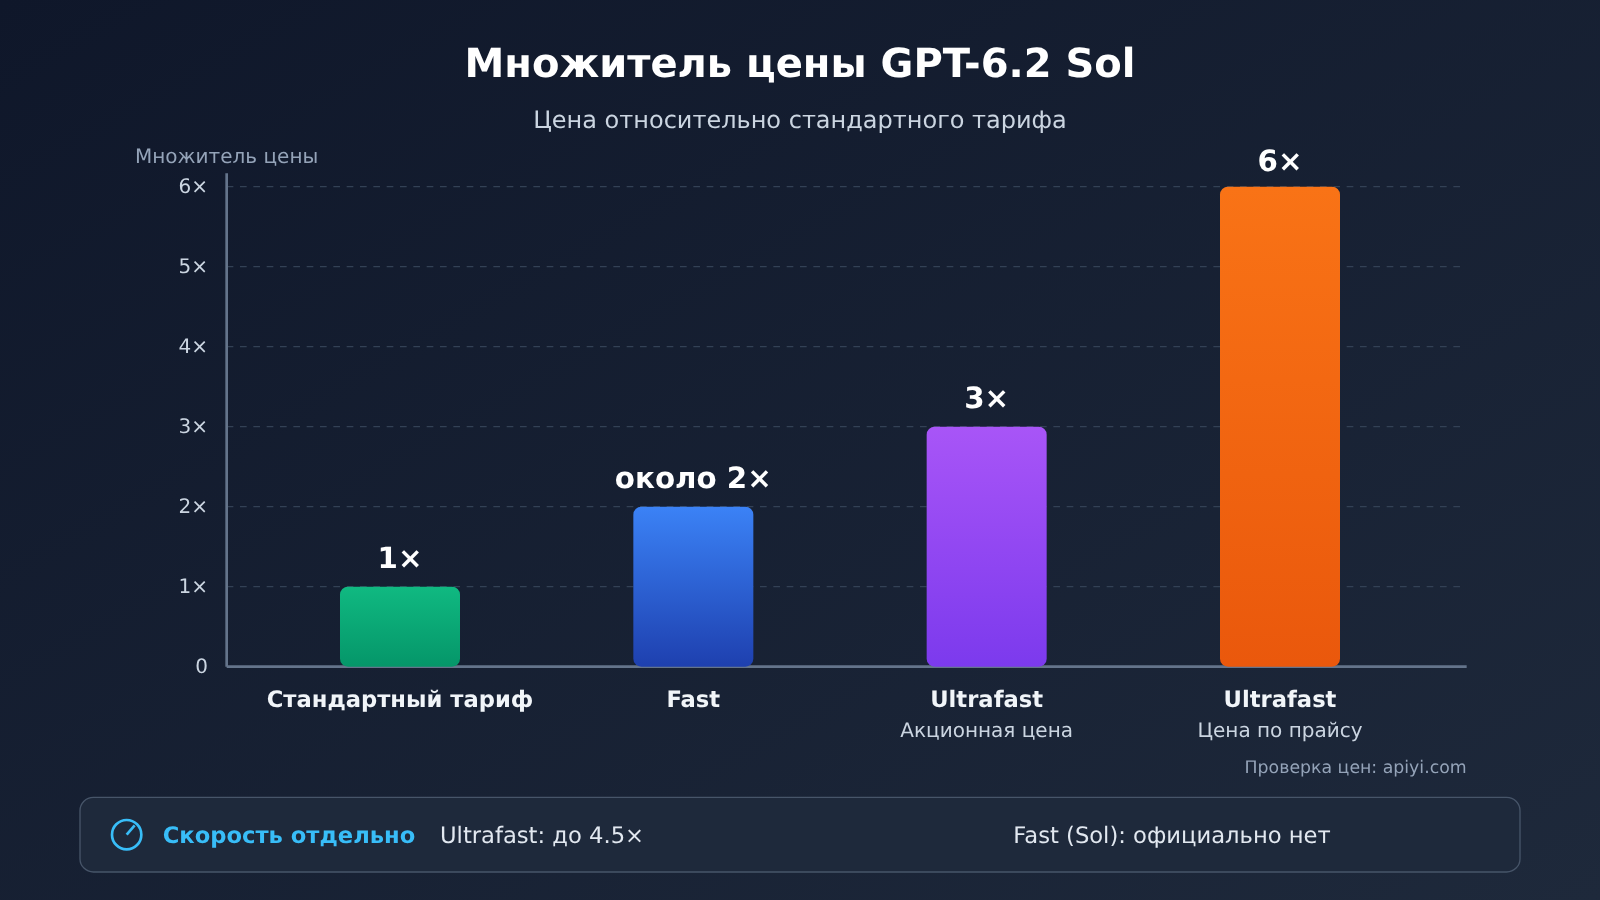
| Уровень (gpt-6.2-sol, короткий контекст) | Вход | Чтение кэша | Выход | Относительно стандартной цены | Официальное заявление о скорости |
|---|---|---|---|---|---|
| Стандартный уровень | 2 | 0.10 | 10 | 1× | Базовый |
| Fast | 4 | 0.20 | 20 | около 2× | В документации для Sol кратность скорости не указана |
| Ultrafast, промо (до 2027-02-28 по тихоокеанскому времени) | 6 | 0.30 | 30 | 3× | до 4,5× |
| Ultrafast по прайс-листу (с 2027-03-01) | 12 | 0.60 | 60 | 6× | до 4,5× |
Цены в таблице указаны в долларах США за миллион токенов; короткий контекст означает, что вход не превышает 272 тыс. токенов. По уровню Fast нужно отдельное предупреждение: формулировка «примерно в 1,5 раза быстрее» в официальной документации относится к GPT-6.2 Astra и GPT-5.6, а не к GPT-6.2 Sol, поэтому этот коэффициент нельзя переносить на Fast для Sol.
Цены GPT-6.2 Sol Ultrafast при длинном контексте
Если входной объём превышает 272 тыс. токенов, начинает действовать тарификация длинного контекста. У официального стандартного тарифа цена длинного контекста составляет 4 доллара за ввод, 0.20 — за чтение кэша и 15 — за вывод (за млн токенов). У Ultrafast промо-цена — 12 / 0.60 / 45, цена по прайс-листу — 24 / 1.20 / 90, то есть всё ещё в 3 и 6 раз выше стандартной цены.
| Позиция (длинный контекст, долл. США за млн токенов) | Ввод | Чтение кэша | Вывод |
|---|---|---|---|
| Официальный стандартный тариф | 4 | 0.20 | 15 |
| Ultrafast, промо | 12 | 0.60 | 45 |
| Ultrafast, прайс-лист | 24 | 1.20 | 90 |
Сводная таблица APIYI gpt-6.2-sol (при вводе свыше 272 000) |
3 | по прайс-листу платформы | по прайс-листу платформы |
Здесь есть одно расхождение в цифрах, которое нужно пояснить отдельно: в сводной таблице моделей APIYI apiyi.com диапазон указан так: от 0 до 272 000 токенов на входе — 2 доллара, свыше 272 000 — 3 доллара за ввод. А у официального стандартного тарифа цена ввода при длинном контексте — 4 доллара. Эти два числа не стоит смешивать: при вызове через APIYI расчёт идёт по 3 долларам из сводной таблицы, при прямом подключении к официальному сервису — по 4 долларам.
Откуда берётся скорость GPT-6.2 Sol Ultrafast: официальный потолок и пользовательские замеры
По части скорости есть два типа информации, и достоверность у них сильно разная. Лучше рассматривать их отдельно.
| Источник | Что сообщается | Статус | Можно ли считать это вашим множителем |
|---|---|---|---|
| Официальная документация Codex / API | Скорость генерации Ultrafast — до 4.5 раза выше, чем в стандартном режиме той же модели (up to 4.5 times) | Официально заявленный потолок | Только как верхняя граница |
| Artificial Analysis | Около 85 выходных токенов/с в стандартном режиме той же модели | Публичный сторонний бенчмарк | Только как ориентир |
| Пересказ OrcaRouter от 2026-11-18 | В среднем около 126 токенов/с на задачу, пик — около 252 | Единичный пересказ без сравнения со стандартным режимом | Нельзя |
В официальном тексте стоит формулировка «up to» — «до». То есть речь о верхней границе, а не об обещании, что каждый запрос будет быстрее в 4.5 раза. При расчётах это значение подходит только для колонки «лучший сценарий».
OrcaRouter 2026-11-18 пересказал опубликованный в X отчёт одного видеомонтажёра об одной задаче: у Ultrafast в среднем около 126 токенов в секунду, пик — около 252; фактическое время выполнения задачи (wall clock) — около 27 минут, из которых на ответ модели ушло около 14 минут. Автор пересказа сравнил это число с 85 токенами/с для стандартного режима, которые публикует Artificial Analysis, и получил примерно 1.5 раза. Но это всего один запуск, без повторов и без сравнения со стандартным режимом на той же задаче. Значит, перед нами одна точка данных, а не итоговый показатель всего скоростного режима.
Этот отчёт также высвечивает легко упускаемую деталь: из 27 минут общего времени на ответ модели приходится лишь около 14 минут. Скоростной режим ускоряет только саму генерацию модели; вызовы инструментов, чтение и запись файлов, ручное подтверждение и другие этапы быстрее не становятся.
Как рассчитать надбавку за скорость GPT-6.2 Sol Ultrafast: готовая формула, которую можно применять
Этот алгоритм намеренно не использует никаких «чужих измеренных коэффициентов». Единственные данные, которые вам нужно получить самостоятельно, — это время выполнения задачи в стандартном режиме.
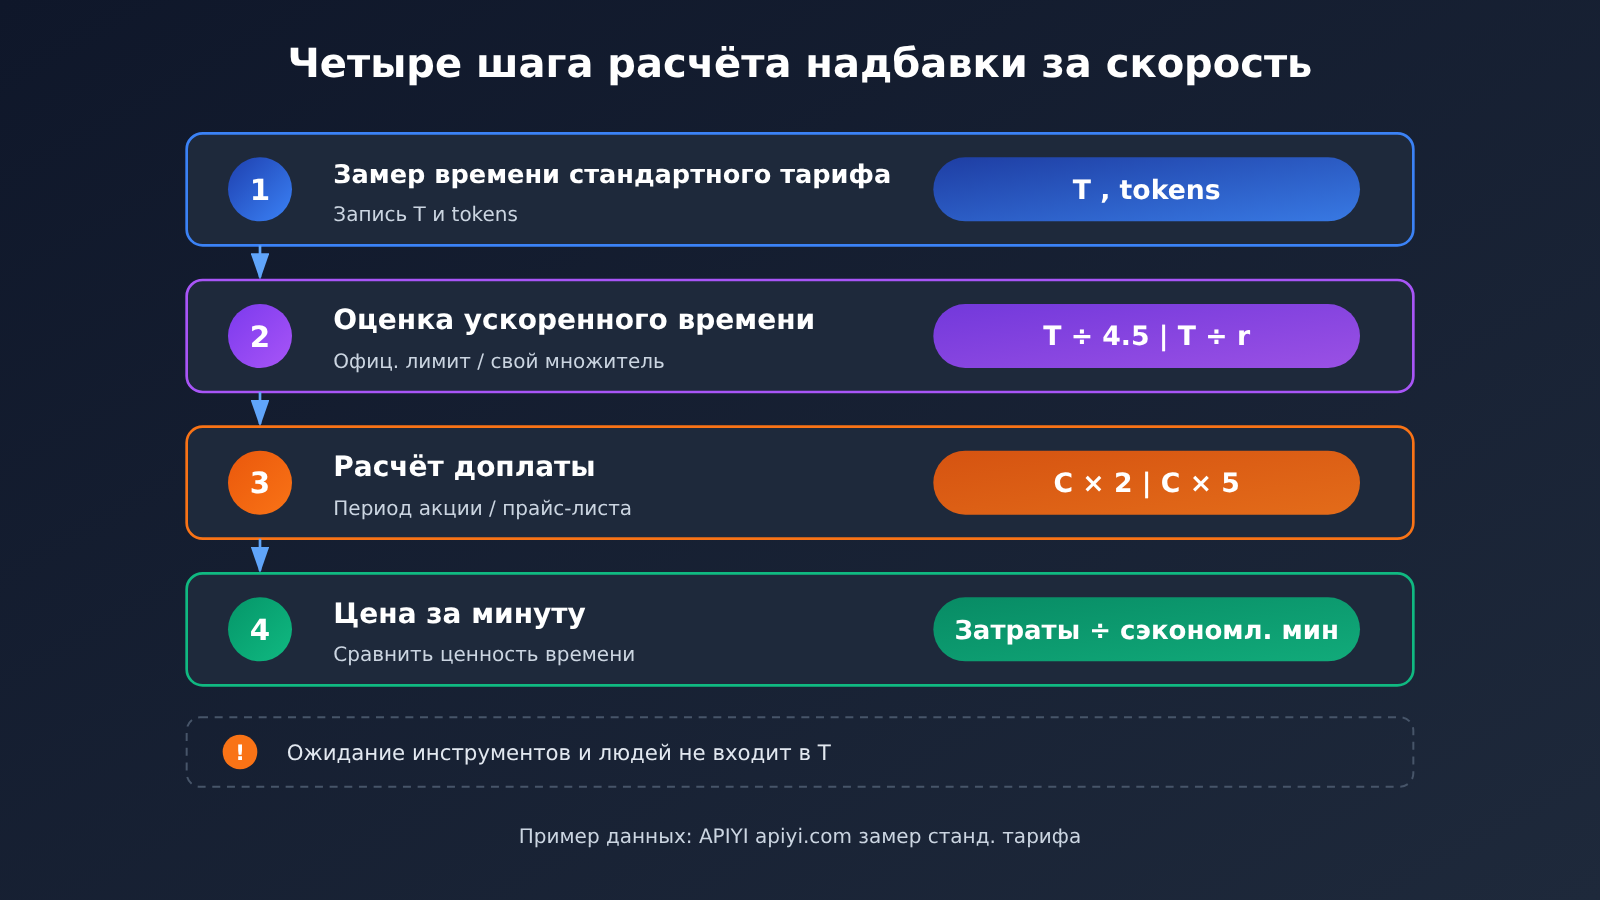
| Шаг | Параметр расчёта | Формула | Пояснение |
|---|---|---|---|
| ① | Время генерации в стандартном режиме T | Измеряете сами | Учитывается только генерация модели, время работы инструментов не учитывается |
| ② | Экономия времени в лучшем случае | T × (1 − 1/4.5) ≈ 0.78T | Используется официальный верхний предел |
| ②′ | Экономия времени в консервативном случае | T × (1 − 1/r) | r — задаваемый вами коэффициент, причём r ≤ 4.5 |
| ③ | Стоимость стандартного режима C | вход × цена + чтение кэша × цена + выход × цена | Ценовой тариф выбирается по длине контекста |
| ④ | Дополнительная плата в промо-период | C × 2 | Промо-цена Ultrafast составляет 3C |
| ④′ | Дополнительная плата в период по прайс-листу | C × 5 | Цена Ultrafast по прайс-листу составляет 6C |
| ⑤ | Цена за каждую сэкономленную минуту | дополнительная плата ÷ сэкономленные минуты | Сравните со стоимостью вашего времени |
Пример расчёта для GPT-6.2 Sol Ultrafast
Ниже — демонстрация алгоритма на наборе условных чисел; это не результаты замеров скорости. Предположим, одна задача: на входе 200 тыс. tokens (короткий контекст), на выходе 50 тыс. tokens, без попаданий в кэш; ваша собственная скорость вывода на стандартном тарифе — 80 token/сек.
- Стоимость на стандартном тарифе C = 0.2 × 2 + 0.05 × 10 = 0.9 доллара.
- Время генерации на стандартном тарифе T = 50000 ÷ 80 ≈ 625 секунд, около 10.4 минуты.
- Цена Ultrafast по акции — 2.7 доллара, доплата 1.8 доллара; по прайс-листу — 5.4 доллара, доплата 4.5 доллара.
| Предполагаемый коэффициент r | Время генерации | Экономия времени | Цена за минуту в акционный период | Цена за минуту по прайс-листу |
|---|---|---|---|---|
| 4.5 (официальный потолок) | около 2.3 минуты | около 8.1 минуты | около 0.22 доллара | около 0.56 доллара |
| 3 | около 3.5 минуты | около 6.9 минуты | около 0.26 доллара | около 0.65 доллара |
| 2 | около 5.2 минуты | около 5.2 минуты | около 0.35 доллара | около 0.87 доллара |
| 1.5 | около 6.9 минуты | около 3.5 минуты | около 0.51 доллара | около 1.29 доллара |
Из этой таблицы видно два момента. Во-первых, при снижении коэффициента с 4.5 до 1.5 цена за минуту примерно удваивается, поэтому допущение о коэффициенте важнее самой цены. Во-вторых, после вступления в силу прайс-листовых цен в марте 2027 года за ту же экономию в 1 минуту придётся платить примерно в 2.5 раза больше; выводы акционного периода нельзя механически переносить на следующий год.
💰 Совет по проверке затрат: цены стандартного тарифа из примера можно напрямую сверять с ценником
gpt-6.2-solв сводной таблице APIYI apiyi.com (вход 2, чтение кэша 0.1, выход 10) — этот набор цен совпадает с официальным стандартным тарифом для короткого контекста и подходит как источник значения C в алгоритме.
Измерьте собственное время работы GPT-6.2 Sol стандартного уровня с помощью кода
Первый шаг алгоритма требует реального значения T. Код ниже использует потоковый вывод: он фиксирует время до первого токена и общее время генерации, а также читает количество токенов из usage — это нужно, чтобы рассчитать скорость работы на стандартном уровне именно для ваших задач.
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Совместимый с OpenAI вход APIYI
)

start = time.time(); first = None; usage = None
stream = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "把你的真实任务提示词放在这里"}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content and first is None:
        first = time.time()
    if chunk.usage:
        usage = chunk.usage
end = time.time()
gen = end - (first or start)
print(f"首 token {first - start:.1f}s,生成 {gen:.1f}s,"
      f"输出 {usage.completion_tokens} tokens,约 {usage.completion_tokens / gen:.0f} tok/s")
Посмотреть полный скрипт сравнения с service_tier
import time, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

PRICE = {  # доллары за миллион токенов, короткий контекст
    "default":   {"in": 2,  "cache": 0.10, "out": 10},
    "promo":     {"in": 6,  "cache": 0.30, "out": 30},
    "list":      {"in": 12, "cache": 0.60, "out": 60},
}

def run(prompt: str, tier: str | None = None):
    kwargs = dict(
        model="gpt-6.2-sol",
        messages=[{"role": "user", "content": prompt}],
        stream=True,
        stream_options={"include_usage": True},
    )
    if tier:
        # официальный способ: тот же ID модели плюс service_tier
        kwargs["extra_body"] = {"service_tier": tier}
    start = time.time(); first = None; usage = None; served = None
    for chunk in client.chat.completions.create(**kwargs):
        if chunk.choices and chunk.choices[0].delta.content and first is None:
            first = time.time()
        if chunk.usage:
            usage = chunk.usage
        served = getattr(chunk, "service_tier", served)
    gen = time.time() - (first or start)
    return gen, usage, served

def cost(usage, p):
    cached = getattr(getattr(usage, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    fresh = usage.prompt_tokens - cached
    return (fresh * p["in"] + cached * p["cache"] + usage.completion_tokens * p["out"]) / 1e6

prompt = "把你的真实任务提示词放在这里"
t_std, u_std, s_std = run(prompt)
c_std = cost(u_std, PRICE["default"])
print(f"标准档:生成 {t_std:.1f}s,费用约 ${c_std:.3f},返回档位 {s_std}")

for name, r in [("官方上限", 4.5), ("保守假设", 2.0)]:
    saved_min = t_std * (1 - 1 / r) / 60
    print(f"{name} r={r}:省 {saved_min:.1f} 分钟,"
          f"促销每分钟 ${c_std * 2 / saved_min:.3f},刊例每分钟 ${c_std * 5 / saved_min:.3f}")

# чтобы замерить скоростной тариф вживую, раскомментируйте строки ниже и проверьте,
# что в ответе поле service_tier действительно равно ultrafast
# t_uf, u_uf, s_uf = run(prompt, tier="ultrafast")
# print(f"速度档:生成 {t_uf:.1f}s,实际倍数约 {t_std / t_uf:.2f},返回档位 {s_uf}")
Про service_tier нужно пояснить отдельно: в общей таблице моделей APIYI apiyi.com указан только gpt-6.2-sol — отдельной модели ultrafast там нет, и поле service_tier в ней не описано, а цены в списке соответствуют стандартному тарифу. В этой статье я сверялся только с документацией и прайсом, реальных запросов не отправлял, поэтому не могу сказать, как этот параметр ведёт себя при вызове через https://api.apiyi.com/v1. Если вам нужен скоростной тариф, ориентируйтесь на поле тарифа, возвращаемое в ответе, и на счёт, а модель и цену берите из списка моделей платформы.
🚀 Совет по началу работы: сначала прогоните свой реальный рабочий промпт два-три раза на стандартном тарифе
gpt-6.2-solв APIYI apiyi.com и возьмите медиану времени генерации как T. Этот шаг стоит по стандартной цене, но именно он определяет точность всех дальнейших расчётов.
Рекомендации по сценариям для GPT-6.2 Sol Ultrafast
Вывод стоит делать в зависимости от задачи. Один и тот же человек на разных задачах может прийти к противоположным ответам.
Сценарии, где Ultrafast уместно включать
- Интерактивные задачи, где человек ждёт результат у экрана: например, парное программирование в реальном времени или живая демонстрация. Ожидание — это прямая стоимость рабочего времени, и по формуле выше цена обычно окупается.
- Задачи, где генерация занимает большую долю фактического времени (wall clock): если T составляет большую часть времени выполнения задачи, экономия времени напрямую отражается на сроке сдачи.
- Задачи с коротким контекстом в период промо-акции: трёхкратная цена вместе с низкой ценой за короткий контекст даёт небольшую абсолютную доплату.
Сценарии, где лучше остаться на стандартном тарифе
- Фоновая пакетная обработка, ночные задачи: никто не ждёт, и сэкономленные минуты не несут соответствующей ценности времени.
- Агентские задачи с интенсивным вызовом инструментов: как в той стенограмме выше — из 27 минут фактического времени на ответ модели приходится около 14 минут, и скоростной режим сжимает лишь часть этого.
- Задачи с длинным контекстом и большим объёмом вывода: в период действия прайс-листа цена за вывод при длинном контексте достигает 90, и доплата растёт очень быстро.
| Особенности задачи | Доля времени генерации | Есть ожидающий | Склонность |
|---|---|---|---|
| Интерактивное программирование, живая демонстрация | Высокая | Да | Сначала посчитать по формуле — цена обычно окупается |
| Агент с интенсивным использованием инструментов | Средне-низкая | Зависит | Считать только по части генерации — выгода размывается |
| Ночная пакетная обработка | Высокая | Нет | Остаться на стандартном тарифе |
| Длинный контекст и большой вывод | Высокая | Зависит | В период действия прайс-листа считать осторожно |
💡 Совет по выбору: если в одном проекте есть задачи обоих типов, можно в коде решать, передавать ли
service_tierв зависимости от типа задачи, — не обязательно включать глобально. Прогоните базовую линию на стандартном тарифе через APIYI apiyi.com с тем же ключом, а затем решите, для каких задач стоит дополнительно тестировать скоростной режим.
GPT-6.2 Sol Ultrafast: как принимать решения
Свести всё вышесказанное в единый повторяемый процесс:
- Запустите реальную задачу в стандартном режиме и запишите время генерации T и расход токенов. Не опирайтесь на чужие цифры скорости.
- Посчитайте лучший случай при официальном потолке 4.5×, затем выберите разумный, на ваш взгляд, консервативный множитель r и рассчитайте оба сценария.
- Отдельно посчитайте дополнительные расходы по промо-тарифу 3× и по тарифу из прайс-листа 6× — получите две «цены за минуту».
- Сравните с ценностью вашего времени: запускать стоит только те задачи, которые остаются выгодными даже при консервативном множителе.
- До 2027-03-01, когда вступят в силу цены из прайс-листа, пересчитайте всё по новым ценам.
Ключевой здесь шаг 2. Официальный «максимум 4.5×» можно считать верхней границей, а упоминание от 2026-11-18 примерно 126 токенов/с — всего лишь единичная точка данных. Ни то, ни другое не равно фактическому множителю для вашей задачи. Реальный множитель можно узнать только с помощью сравнительного теста на собственной задаче.
Частые вопросы (FAQ)
Вопрос 1: GPT-6.2 Sol Ultrafast — это новая модель?
Нет. Согласно официальной документации API, Ultrafast — это уровень обслуживания (service tier): в запросе `model` по-прежнему остаётся `gpt-6.2-sol`, а дополнительно указывается `service_tier` со значением `ultrafast`. Сама модель не меняется.
Вопрос 2: Гарантирует ли включение Ultrafast ускорение в 4,5 раза?
Нет. В официальном тексте сказано «up to 4.5 times» — то есть это верхняя граница. При расчётах стоит одновременно держать в уме и более низкий, консервативный коэффициент, а ориентироваться прежде всего на собственные контрольные тесты.
Вопрос 3: Когда заканчивается действие промо-цены на GPT-6.2 Sol Ultrafast?
Официальная промо-цена действует до 2027-02-28 (по тихоокеанскому времени) и составляет 3× от стандартной цены; с 2027-03-01 применяется прайс-лист — 6× от стандартной цены. Это соотношение действует и для короткого, и для длинного контекста.
Вопрос 4: Можно ли опираться на тот результат, около 126 токенов/сек?
Как на отдельную точку данных — можно, но не как на вывод. Это была одна задача, пересказанная OrcaRouter 2026-11-18, без повторных прогонов и без сравнения со стандартным уровнем на той же задаче; упомянутое в тексте ускорение примерно в 1,5 раза получено сравнением с опубликованными Artificial Analysis 85 токенами/сек для стандартного уровня.
Вопрос 5: Какая цена gpt-6.2-sol указана на APIYI?
Стандартный уровень. В сводной таблице APIYI apiyi.com цена `gpt-6.2-sol` — 2 за вход, 0,1 за чтение кэша, 10 за выход, что совпадает с официальным стандартным уровнем для короткого контекста; поддерживаются эндпоинты responses и chat. Отдельной модели ultrafast в сводной таблице нет, и `service_tier` там не указан.
Вопрос 6: Как считаются стандартные тарифы при входе свыше 272 тыс. токенов?
Цифры из двух источников различаются, и считать нужно по отдельности: в сводной таблице APIYI при входе свыше 272 тыс. токенов указано 3 доллара, а в официальном стандартном уровне для длинного контекста вход стоит 4 доллара. При вызове через https://api.apiyi.com/v1 расчёт идёт по списку моделей платформы, при прямом обращении к официальному API — по 4 долларам.
GPT-6.2 Sol Ultrafast: главное о наценке за скорость
- Ultrafast — это уровень сервиса: тот же ID модели
gpt-6.2-solплюсservice_tier, возможности модели не меняются. - 4,5 раза — это официальный потолок: в оригинале сказано «up to», поэтому при расчётах нельзя воспринимать этот множитель как гарантированный для каждого запроса.
- Цена делится на два этапа: в промо-период — 3× от стандартной цены, с 2027-03-01 по прайс-листу — 6×.
- Ускоряется только время генерации: вызовы инструментов и прочие не-генерационные задержки в экономию не входят.
- Один замер ничего не доказывает: запись от 2026-11-18 примерно на 126 токенов/с не имеет сравнения со стандартным уровнем.
- Сначала измерьте свой стандартный уровень: можно взять стандартный
gpt-6.2-solв APIYI apiyi.com, получить T и подставить в формулу.
Итог
Расчёт наценки за скорость GPT-6.2 Sol Ultrafast сводится к трём пунктам:
- Скорость берём в двух вариантах — потолочном и консервативном: официальные 4,5× максимум ставим в лучший сценарий, собственный консервативный множитель — в отдельную колонку.
- Цену считаем раздельно: в промо-период переплата составляет 2× от стандартной стоимости, по прайс-листу — 5×; смешивать эти два вывода нельзя.
- Решение зависит от задачи: включить скоростной режим имеет смысл только тогда, когда цена за каждую сэкономленную минуту ниже стоимости вашего времени.
Ответ на вопрос из заголовка зависит от данных по вашим задачам. Рекомендую сначала измерить базовую линию стандартным уровнем в APIYI apiyi.com, а затем подставить цифры в таблицу расчёта из этой статьи.
📚 Справочные материалы
-
Скоростные уровни OpenAI Codex: официальное заявление о том, что Ultrafast даёт до 4,5 раза быстрее
- Ссылка:
developers.openai.com/codex/agent-configuration/speed - Пояснение: подтверждает оригинальную формулировку «up to 4.5 times» и модели, к которым она применима
- Ссылка:
-
Руководство по API режима Ultrafast от OpenAI: как использовать
service_tierи какие модели поддерживаются- Ссылка:
developers.openai.com/api/docs/guides/ultrafast-mode - Пояснение: подтверждает, что Ultrafast — это уровень обслуживания, а
modelпри этом не меняется
- Ссылка:
-
Страница тарифов OpenAI API: акционные и прайс-листовые цены для стандартного уровня, Fast и Ultrafast
- Ссылка:
developers.openai.com/api/docs/pricing - Пояснение: полные цены для короткого и длинного контекста
- Ссылка:
-
Запись пересказа OrcaRouter: данные одного задания Ultrafast от 2026-11-18
- Ссылка:
orcarouter.ai/blog/gpt-6-2-sol-ultrafast-tokens-per-second - Пояснение: единичный пересказ без контрольной группы — это всего одна точка данных
- Ссылка:
-
Сводная таблица моделей APIYI: цена
gpt-6.2-solна стандартном уровне и ступенчатая тарификация- Ссылка:
docs.apiyi.com/models.md - Пояснение: сверка цены за единицу на стандартном уровне и цены при вводе свыше 272 000 токенов
- Ссылка:
Автор: техническая команда APIYI
Техническая поддержка: если возникнут вопросы по расчётам или подключению — напишите нам через главную страницу сайта APIYI, а больше материалов найдёте в центре документации docs.apiyi.com


