
Примечание автора: разбираем четыре статьи расходов gpt-6.2-sol — вход, чтение кэша, запись в кэш и выход; подробно объясняем, как считается весь заказ при превышении 272K, разбираем коэффициенты Batch/Fast/Ultrafast и приводим два примера прикидки счёта — для короткого и сверхдлинного контекста.
17 ноября 2026 года OpenAI выпустила GPT-6.2 Astra и GPT-6.2 Sol. Первое, что делают многие команды, — прикидывают счёт за gpt-6.2-sol, но итоговая цифра часто не сходится с реальной. Дело в том, что тарификация GPT-6.2 Sol устроена не по принципу «одна цена за вход, одна цена за выход»: вход, чтение кэша, запись в кэш и выход считаются как четыре отдельные статьи расходов. А сверхдлинный контекст и режимы вроде Ultrafast ещё и меняют коэффициенты.
Это не пересказ прайс-листа. В статье мы опираемся на правила тарификации со страницы моделей OpenAI: приводим формулу расчёта для короткого контекста и алгоритм подсчёта всего заказа при превышении 272K, а затем считаем оба примера. Заодно покажем, при каких условиях OpenAI получила свою цифру о том, что Sol «обходится примерно в пять раз дешевле, чем Astra».
Главная ценность: прочитав статью, вы сможете сами составить для gpt-6.2-sol счёт из четырёх колонок, определить, выходит ли запрос за порог 272K, и увидеть, какой коэффициент способна удвоить расходы.
Ключевые моменты ценообразования GPT-6.2 Sol
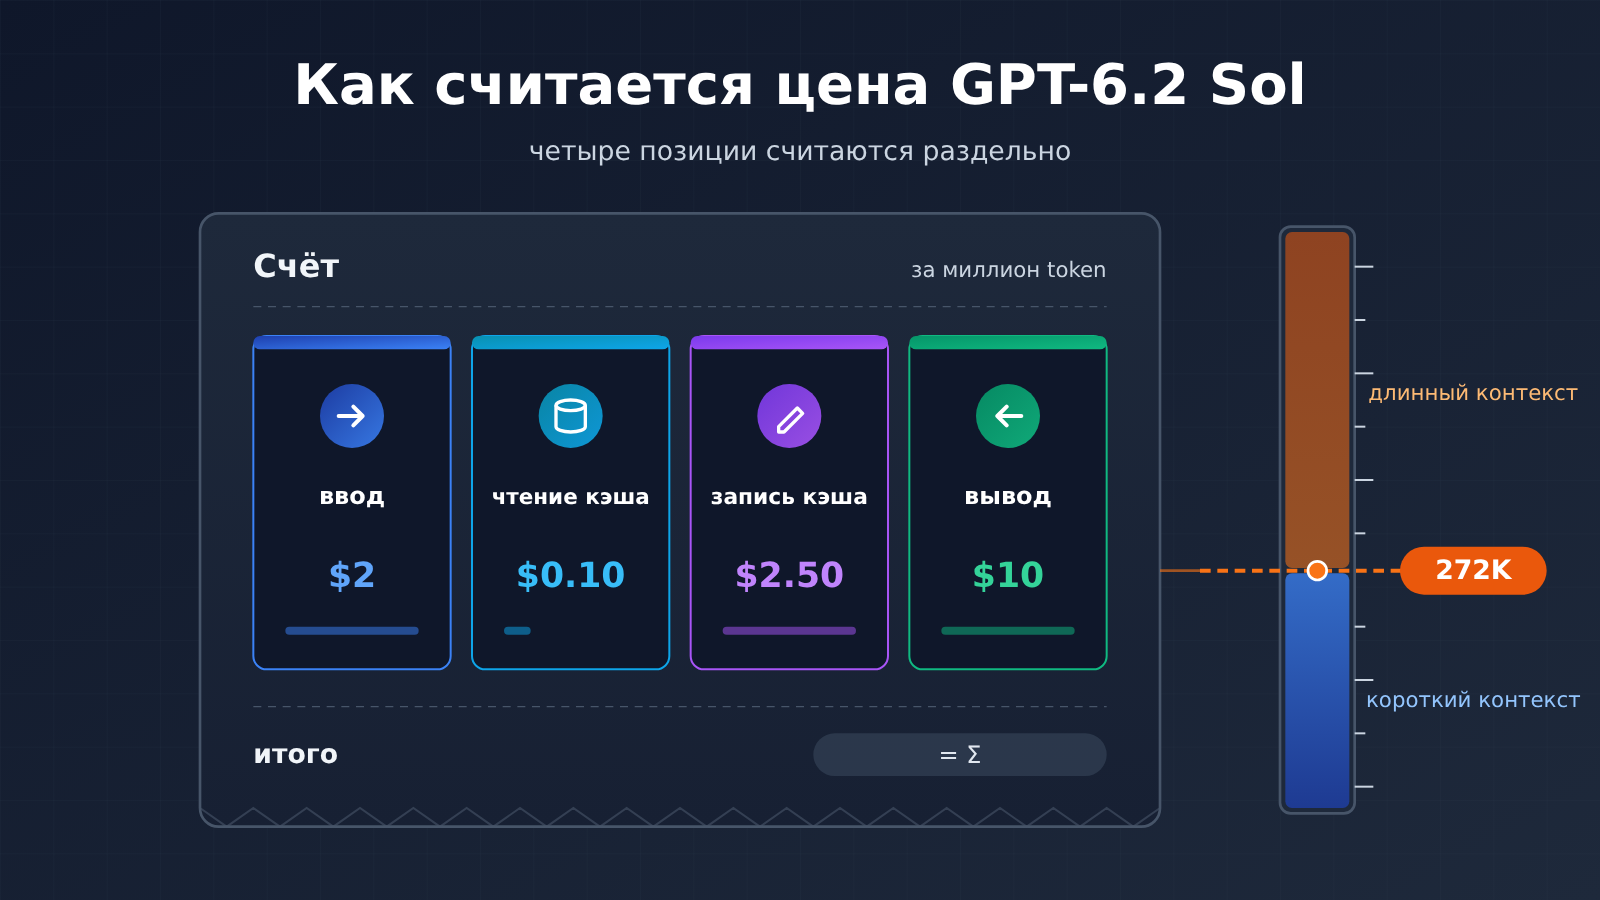
Сначала расставим всё по полочкам. Все цифры ниже взяты с официальной страницы моделей OpenAI, указаны за 1 миллион токенов и представляют собой официальные цены.
| Пункт | Описание | Влияние на счёт |
|---|---|---|
| Четыре статьи считаются отдельно | Вход, чтение из кэша, запись в кэш (два варианта: на 30 минут и на 12 часов) и выход имеют собственные тарифы | Если учитывать только цену входа и выхода, легко пропустить статью расходов на запись в кэш |
| Порог 272K | Когда вход запроса превышает 272K токенов, тарифы на вход и кэш удваиваются, а выход становится в 1,5 раза дороже | Повышенная цена применяется ко всему запросу целиком, а не только к превышающей части |
| Множители тарифов | Batch — 50% от стандартной цены, Fast — 2×, Ultrafast сейчас 3×, а с 2027-03-01 — 6× | При одинаковом количестве токенов счёт может отличаться в десятки раз |
| Рассуждения нельзя отключить | API не принимает значение none для reasoning effort |
Количество выходных токенов не снизится до уровня «нулевых рассуждений» |
| Лимиты спецификации | Контекстное окно — 1 050 000, максимальный вход — 922 000, максимальный выход — 128 000 | Очень длинные запросы неизбежно пересекут порог в 272K |
Подробный разбор четырёх статей расходов GPT-6.2 Sol
Вход — это обычные токены текущего запроса, которые не попали в кэш; при коротком контексте цена составляет $2. Чтение из кэша — это часть, попавшая в уже существующий кэшированный префикс, её цена всего $0.10 — одна двадцатая от обычного входа. Вот почему длинные системные промпты и фиксированные префиксы документов — идеальные кандидаты на переиспользование кэша.
Запись в кэш часто упускают из виду. Сама по себе запись содержимого в кэш платная: цена записи с хранением на 30 минут — $2.50, на 12 часов — $5, и обе дороже обычного входа. Поэтому запись в кэш ещё не гарантирует экономию. Только если позже кэш сработает достаточное количество раз, переплата за запись окупится за счёт низкой цены чтения из кэша.
Выход оценён в $10 и включает ответ, сгенерированный моделью. Поскольку интенсивность рассуждений нельзя установить в none, процесс рассуждений обычно тоже увеличивает количество токенов на выходе — точные значения смотрите в поле usage, которое возвращает API. Когда проверяете модель и сверяете цены, лучше ориентироваться на актуальные данные в списке моделей на платформе APIYI (apiyi.com), а не полагаться только на пересказы из вторых рук.
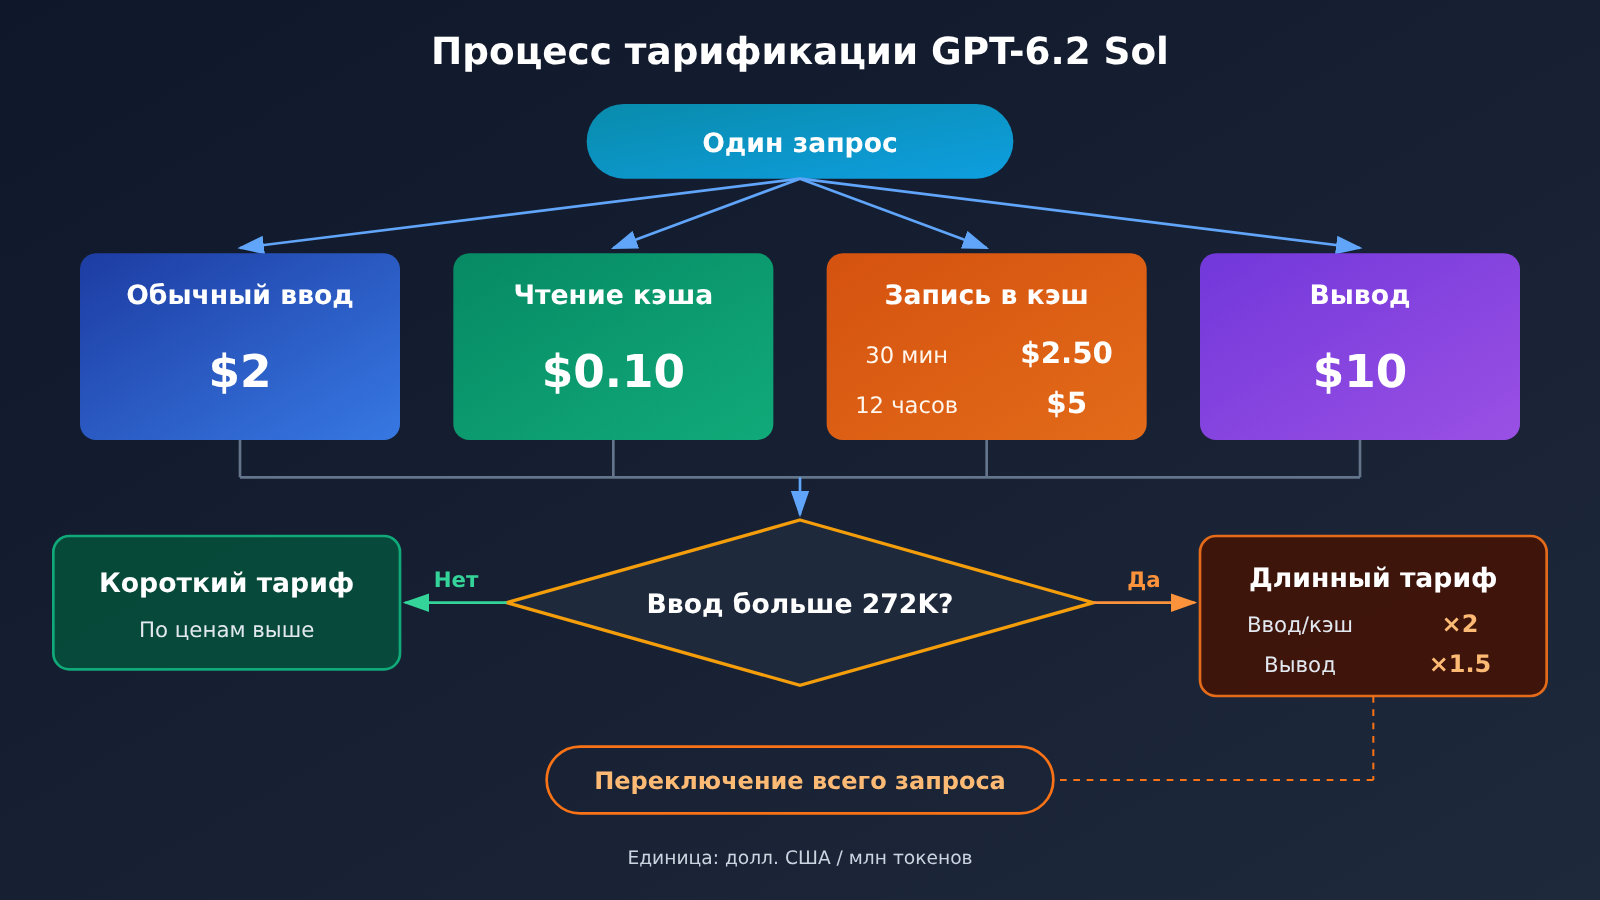
Таблица цен GPT-6.2 Sol: короткий контекст и свыше 272K
В таблице ниже собраны стандартные цены gpt-6.2-sol для двух диапазонов длины контекста. Колонка для длинного контекста рассчитана по правилам со страницы модели: цены входных токенов и кэша умножаются на 2, а цена вывода — на 1.5.
| Статья расходов (за 1 млн токенов) | Короткий контекст (≤272K) | Свыше 272K (весь запрос) | Источник правила |
|---|---|---|---|
| Вход | $2 | $4 | Страница модели: вход ×2 |
| Чтение из кэша | $0.10 | $0.20 | Страница модели: кэш ×2 |
| Запись в кэш (30 минут) | $2.50 | $5 | Страница модели: кэш ×2 |
| Запись в кэш (12 часов) | $5 | $10 | Страница модели: кэш ×2 |
| Вывод | $10 | $15 | Страница модели: вывод ×1.5 |
Это официальные цены OpenAI. Модель gpt-6.2-sol пока недоступна на APIYI — мы добавим её как можно скорее; актуальные названия моделей и цены смотрите в списке моделей платформы, свежий статус можно проверить на apiyi.com. По состоянию на время данных общей таблицы APIYI 2026-11-17 15:54 (UTC+8) в общей таблице и в API ценообразования ещё нет ни gpt-6.2-sol, ни gpt-6.2-astra.
Как понимать правило расчёта по всему запросу у GPT-6.2 Sol
«Расчёт по всему запросу» — то самое место, где легче всего ошибиться. Если во входе одного запроса 300K токенов, нельзя считать так: первые 272K по короткой цене, а остальные 28K по длинной. Как только вход запроса пересекает границу, все входные токены этого запроса, чтение кэша и запись в кэш идут по удвоенной цене, а вывод — с коэффициентом 1.5.
Поэтому разница в счёте между двумя запросами со входом в 270K и 280K куда больше, чем те лишние 10K токенов. Когда делаете RAG или анализ длинных документов, уложиться во вход в 272K обычно выгоднее, чем докинуть ещё немного контекста.
GPT-6.2 Sol в сравнении с предыдущей моделью gpt-6.1-sol
В анонсе сказано, что Sol сохраняет те же API-цены за токены, что у GPT-6.1 Sol. Для сравнения можно взять уже доступную gpt-6.1-sol: в общей таблице APIYI на apiyi.com у gpt-6.1-sol при коротком контексте вход стоит $2, вывод $10, чтение из кэша $0.1, при превышении 272 000 вход — $4, а эндпоинты поддерживают responses и chat.
Важно подчеркнуть: это цены платформы для предыдущей модели — это не значит, что gpt-6.2-sol уже доступна, и их нельзя напрямую считать ценами для 6.2. Кроме того, у gpt-6-sol в той же таблице чтение из кэша стоит $0.2 — не как у 6.1, так что при сравнении не перепутайте строки.
Как складываются множители тарифов GPT-6.2 Sol
Помимо длины контекста, на цену за единицу влияет и тариф обслуживания. Множители со страницы модели:
| Тариф | Множитель | Сроки и примечания |
|---|---|---|
| Стандартный | 1× | тариф по умолчанию |
| Batch | 0.5× | 50% от стандартной цены, подходит для несрочных офлайн-задач |
| Fast | 2× | базой служит стандартная цена при той же длине контекста |
| Ultrafast | 3× | до 2027-02-28 (тихоокеанское время) |
| Ultrafast | 6× | с 2027-03-01 |
Про Fast на странице модели сказано прямо: «2× от стандартной цены при той же длине контекста». То есть для запросов свыше 272K с включённым Fast к цене за длинный контекст придётся дополнительно применить множитель 2. В описаниях Batch и Ultrafast речь идёт о множителях к «стандартной цене», а как именно они применяются к сверхдлинным запросам на этих тарифах, лучше сверять с данными официального биллинга — для предварительной оценки можно пока просто умножать стандартную цену при той же длине контекста.
Даты перехода Ultrafast стоит записать отдельно: бюджет, который вы рассчитываете сейчас, к марту 2027 года может буквально удвоиться. Если ваш бизнес зависит от Ultrafast, лучше заранее заложить в бюджетную таблицу вариант с множителем 6×.
Быстрый старт с GPT-6.2 Sol: два примера расчёта стоимости
В обоих примерах ниже используются только сложение и умножение, а все числа вписаны прямо в текст — так что их легко подставить под собственный объём использования. Каждый токен учитывается лишь в одной строке расчёта; в какую именно категорию попадает та или иная часть токенов, смотрите по полю usage из ответа API.
Пример 1: запрос с коротким контекстом
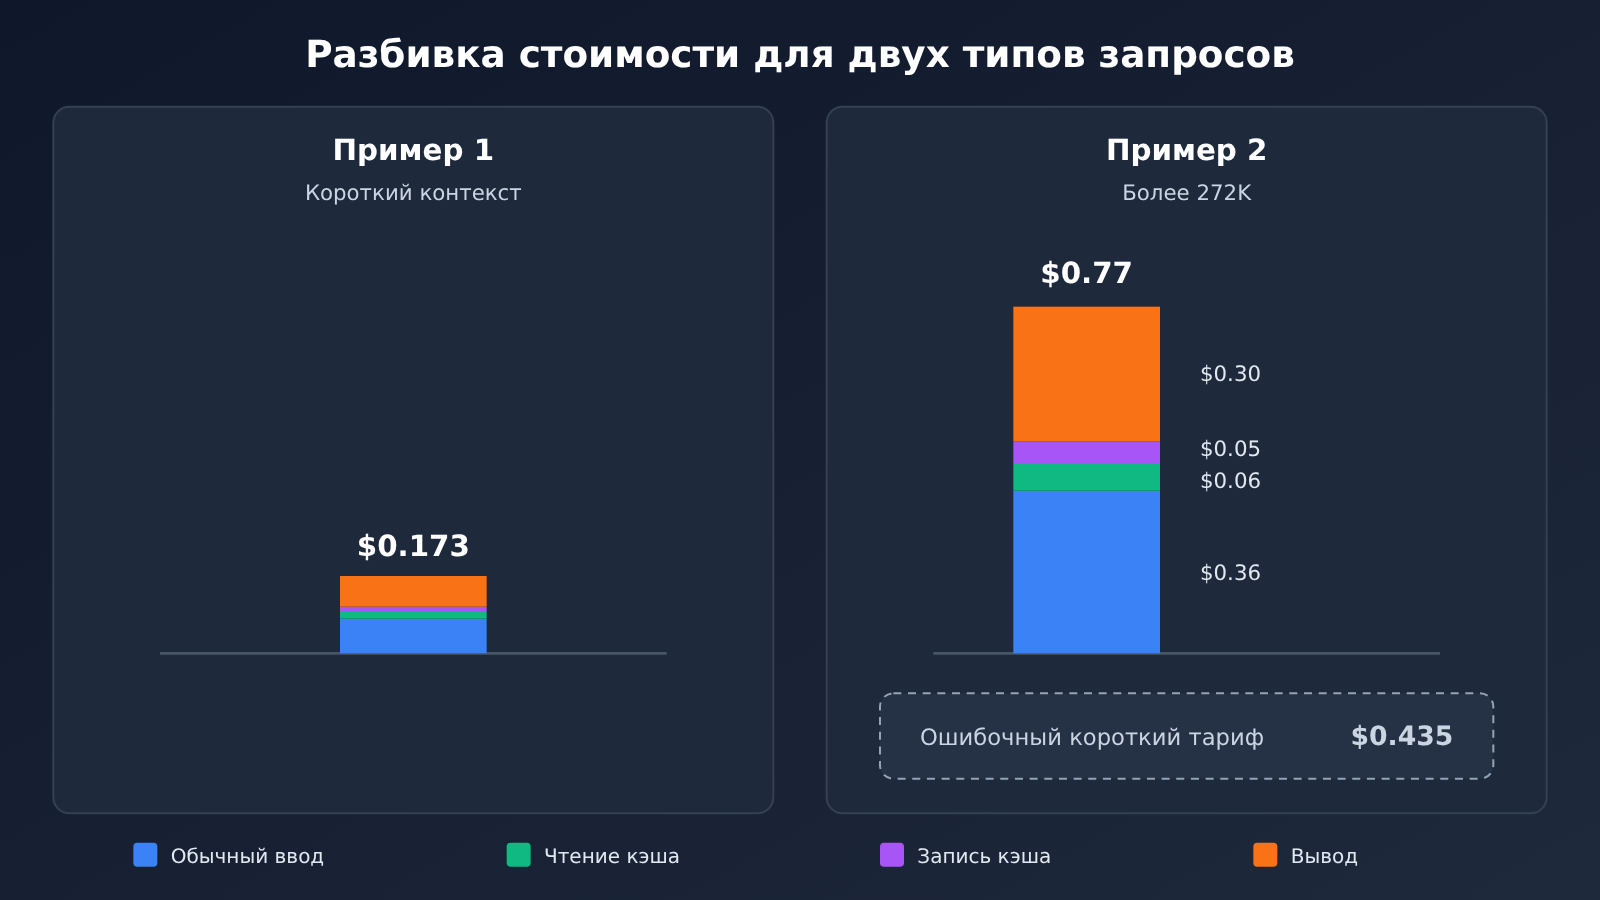
Допустим, на вход одного запроса приходится 120,000 токенов, из которых 80,000 берутся из кэша (чтение из кэша), 10,000 записываются в 30-минутный кэш, 30,000 — обычный ввод, а на выходе — 8,000 токенов.
- Обычный ввод: 30,000 × $2 ÷ 1,000,000 =
$0.06 - Чтение из кэша: 80,000 × $0.10 ÷ 1,000,000 =
$0.008 - Запись в кэш (30 минут): 10,000 × $2.50 ÷ 1,000,000 =
$0.025 - Вывод: 8,000 × $10 ÷ 1,000,000 =
$0.08
Итого за этот запрос — $0.173. Обратите внимание: 8,000 выходных токенов обходятся в десять раз дороже, чем 80,000 токенов чтения из кэша. Так что если при оценке исходить только из общего объёма ввода, результат может сильно искажаться.
Пример 2: весь заказ при вводе свыше 272K
Предположим, что на вход одного запроса подаётся 400,000 токенов: из них 300,000 — чтение из кэша, 10,000 записываются в 30-минутный кэш, 90,000 — обычный ввод, а на выходе — 20,000 токенов. Поскольку ввод превышает 272K, весь заказ тарифицируется по цене длинного контекста.
- Обычный ввод: 90,000 × $4 ÷ 1,000,000 =
$0.36 - Чтение из кэша: 300,000 × $0.20 ÷ 1,000,000 =
$0.06 - Запись в кэш (30 минут): 10,000 × $5 ÷ 1,000,000 =
$0.05 - Вывод: 20,000 × $15 ÷ 1,000,000 =
$0.30
Итого этот заказ обходится в $0.77. Если же по ошибке применить цену короткого контекста, получится лишь $0.435 — почти вдвое меньше реальной суммы.
| Тариф (на основе примера 2) | Расчёт | Стоимость одного запроса |
|---|---|---|
| Стандартный | обычная цена | $0.77 |
| Batch | × 0.5 | $0.385 |
| Fast | × 2 | $1.54 |
| Ultrafast (до 2027-02-28) | × 3 | $2.31 |
| Ultrafast (с 2027-03-01) | × 6 | $4.62 |
На одном и том же заказе разница между Batch и Ultrafast 2027 года составляет 12 раз. Выбор тарифа, как правило, влияет на итоговый счёт сильнее, чем корректировка длины промпта.
Проверка расхода токенов через OpenAI-совместимый протокол
Что касается интеграции: gpt-6.2-sol на стороне официального API поддерживает Chat Completions и Responses, а также Batch. Realtime, Assistants, дообучение (fine-tuning), генерация изображений, видео и голос не поддерживаются. Модель принимает на вход только текст и изображения, а на выходе отдаёт текст.
Если хотите сначала обкатать процесс оценки расходов на уже доступной модели gpt-6.1-sol, действуйте так:
- В OpenAI-совместимом клиенте укажите base URL
https://api.apiyi.com/v1, а в поле модели впишитеgpt-6.1-sol. - Выставьте интенсивность рассуждений в одно из допустимых значений —
low,mediumи т. п., но неnone. Обе модели 6.2 в официальном API просто отклонят значениеnone. - После каждого запроса сохраняйте блок usage из ответа и записывайте четыре числа: обычный ввод, чтение кэша, запись в кэш и вывод.
- Подставьте эти четыре числа в таблицу расценок выше и заодно проверьте, не превысил ли ввод отметку 272K.
Когда gpt-6.2-sol появится в листинге, достаточно будет заменить ID модели и обновить расценки.
Посмотреть полный чек-лист для оценки
— Шаг 1: Посчитайте суммарный объём ввода, определите, превышает ли он 272K, и решите, какой тариф действует на весь запрос — короткий или длинный.
— Шаг 2: Разбейте ввод на три колонки: обычный ввод, чтение кэша и запись в кэш (с разделением на 30 минут и 12 часов).
— Шаг 3: Подсчитайте выходные токены; если рассуждения включены, ориентируйтесь на usage из ответа.
— Шаг 4: Умножьте каждую из четырёх колонок на свою расценку и сложите — получите стоимость по стандартному тарифу.
— Шаг 5: Умножьте на коэффициент тарифного плана: Batch — 0.5, Fast — 2, Ultrafast — 3 или 6 в зависимости от даты.
— Шаг 6: Умножьте на среднее количество запросов в день — получите дневной бюджет; долю попаданий в кэш закладывайте консервативно.
🚀 Быстрый старт: советуем сначала получить бесплатный тестовый баланс на APIYI (apiyi.com) и прогнать несколько реальных запросов через уже доступный gpt-6.1-sol. Получив четыре колонки usage, подставьте их в формулы из этой статьи — такой бюджет окажется заметно ближе к реальности, чем чисто теоретический расчёт.
Как понимать «одну пятую» у GPT-6.2 Sol и Astra
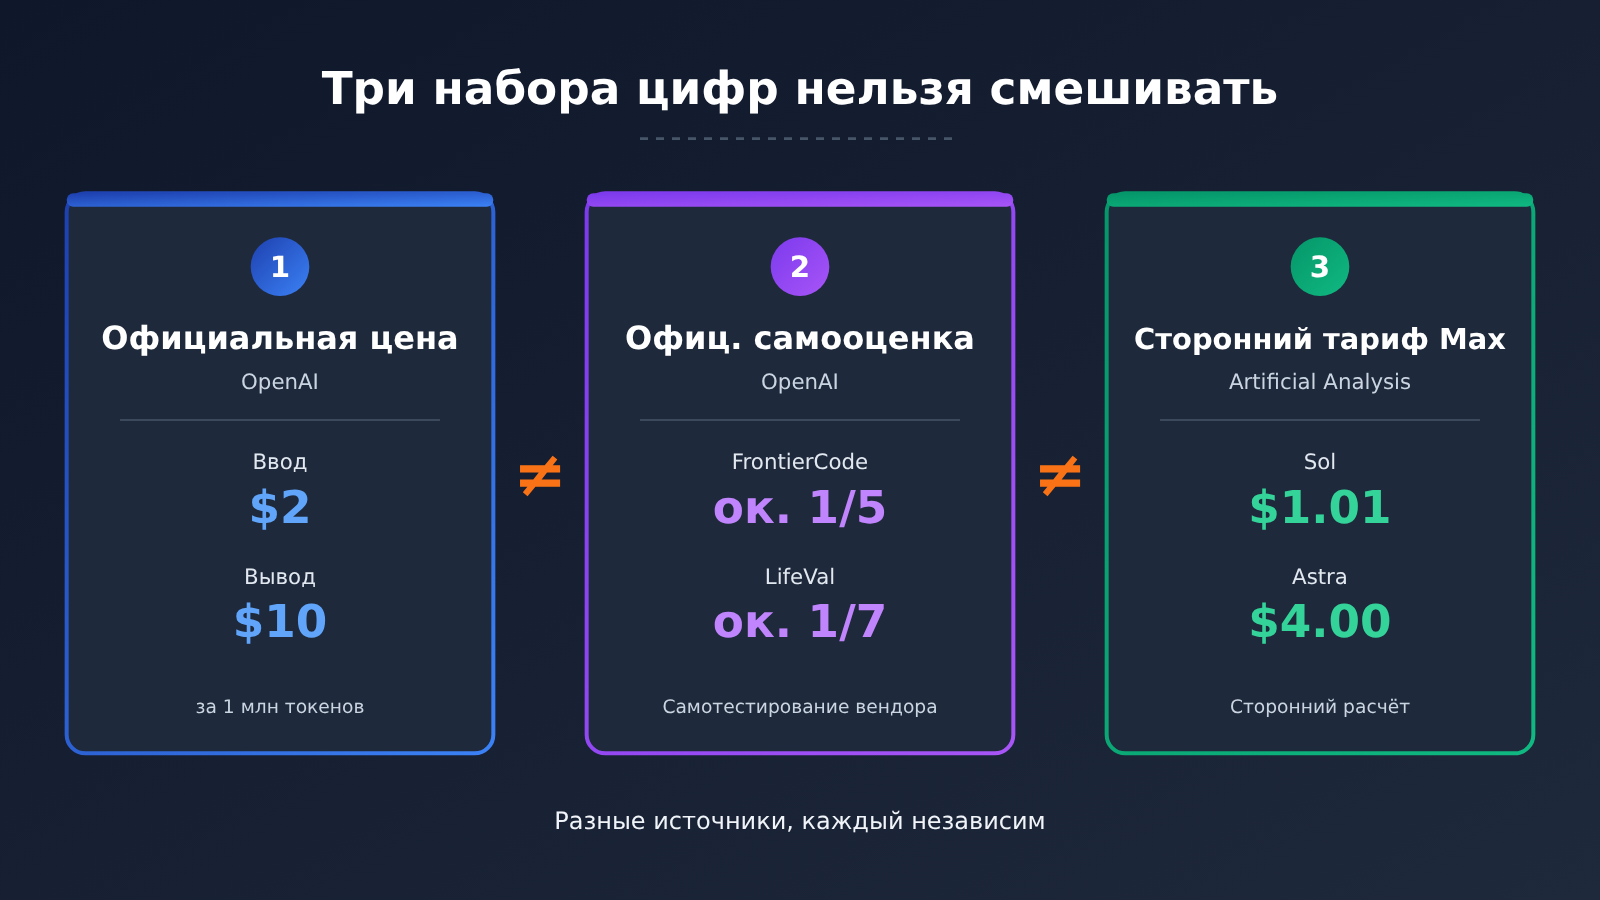
В анонсе есть одно утверждение, которое легко истолковать неверно: на бенчмарке FrontierCode 2.0 от Cognition (он проверяет, примет ли мейнтейнер изменения в реальной кодовой базе) GPT-6.2 Sol и GPT-6.2 Astra расходятся менее чем на 0.5 балла, при этом стоимость Sol — примерно одна пятая, а обе модели работают с режимом рассуждений Max. Это данные, которые OpenAI сообщила о себе сама, и относятся они только к этому одному тесту.
Это не значит, что каждый запрос к Sol обойдётся в одну пятую от цены Astra. Если смотреть на официальные тарифы, Sol стоит $2 за вход и $10 за выход, Astra — $8 и $40, то есть по цене за токен Sol дешевле в четыре раза. Реальное соотношение затрат на один запрос зависит ещё и от того, сколько токенов каждая модель потратит на одну и ту же задачу. Расход токенов сильно варьируется от задачи к задаче, поэтому и пропорция будет плавать. Ещё один самостоятельно опубликованный показатель OpenAI — LifeVal: Sol набирает больше баллов, чем GPT-6 Astra, при стоимости около одной седьмой, и это тоже касается только того набора задач.
Цифры стороннего Artificial Analysis — совсем другая система измерений. В Intelligence Index v5.0.1 Sol на режиме рассуждений Max набирает 57 баллов, а стоимость одной задачи в сводном индексе составляет $1.01; у Astra — 62 балла и $4.00 за задачу. Эти $1.01 относятся только к набору тестов сводного индекса: их нельзя умножать или делить на «одну пятую» из официального FrontierCode, и уж точно нельзя считать реальной ценой каждого запроса в вашем бизнесе.
Сравнение официальных цен GPT-6.2 Sol и других моделей
| Модель (официальная цена, за 1 млн токенов) | Вход | Выход | Чтение из кэша | Правила сверхдлинного контекста |
|---|---|---|---|---|
| GPT-6.2 Sol | $2 | $10 | $0.10 | Свыше 272K — наценка на весь заказ |
| GPT-6.2 Astra | $8 | $40 | $0.40 | Свыше 272K — наценка на весь заказ |
| Claude Fable 5.2 | $8 | $40 | $0.20 | В документации это правило не указано |
| Claude Opus 5.5 | $4 | $20 | $0.20 | В документации это правило не указано |
| Gemini 4 Carbon (до 11-30) | $2 | $10 | $0.10 | В прайс-листе Google нет удвоения за 272K |
| Gemini 4 Carbon (с 12-01) | $4 | $20 | $0.20 | То же |
В таблице приведены официальные цены самих вендоров, а не тарифы платформы APIYI. Официальная цена GPT-6.2 Astra: вход $8, чтение из кэша $0.40, запись 30-минутного кэша $10, выход $40. Как и gpt-6.2-sol, эта модель пока недоступна на APIYI — мы добавим её как можно скорее; актуальные модели и цены смотрите в списке моделей на платформе. Кроме того, Gemini 4 Carbon на странице описания APIYI указан по вводной цене: 2026-12-01 официально произойдёт повышение, с этого момента ориентируйтесь на список платформы.
💡 Совет по выбору: таблица цен отражает лишь разницу при одинаковом количестве токенов — по ней не понять, какая модель в целом обойдётся дешевле именно для ваших задач. Рекомендуем на APIYI apiyi.com сравнить уже доступные модели на одной и той же выборке реальных запросов, посмотреть на usage и качество результата, а потом принимать решение.
Частые вопросы (FAQ)
Q1: Как устроено ценообразование GPT-6.2 Sol и почему всё считают раздельно?
GPT-6.2 Sol тарифицируется отдельно по четырём ставкам за каждый миллион токенов: вход ($2), чтение из кэша ($0.10), запись в кэш ($2.50 за 30 минут, $5 за 12 часов) и выход ($10) — это официальные стандартные цены для короткого контекста. Разброс между этими ставками достигает сотен раз, поэтому если оценивать расходы только по общему числу токенов, цифры получатся сильно искажёнными.
Q2: После 272K наценка берётся только за превышение?
Нет. На странице модели прямо сказано, что расчёт ведётся по всему запросу целиком: как только вход запроса превышает 272K, ставки на вход и кэш удваиваются, а выход дорожает в полтора раза. Если ваш вход болтается прямо у этой границы, есть смысл попробовать ужать контекст до 272K.
Q3: Когда выйдет GPT-6.2 Sol и где её можно использовать?
OpenAI выпустила модель 2026-11-17. Согласно официальной информации, подписчики Plus, Pro, Enterprise и Edu могут работать с ней в ChatGPT Work и Codex, разработчики — через OpenAI API, причём Ultrafast поддерживается с самого релиза. В APIYI модель пока не добавлена, но мы добавим её в каталог как можно скорее; актуальные названия моделей и цены уточняйте в списке моделей на платформе.
Q4: Запись в кэш дороже обычного входа — стоит ли ей вообще пользоваться?
Зависит от частоты переиспользования. Запись на 30 минут обходится на $0.50 за миллион токенов дороже обычного входа, зато каждое последующее попадание в кэш экономит $1.90. Если префикс в течение 30 минут будет затребован больше одного раза, запись, как правило, окупается. Запись на 12 часов стоит $5 и подходит для фиксированных префиксов, которые весь день используются с высокой частотой.
Q5: Как отрепетировать расчёт расходов, пока 6.2 ещё не в каталоге?
Для этого подойдёт уже доступная модель gpt-6.1-sol: по официальным данным, 6.2 Sol наследует её цены за токены. Зарегистрируйтесь на APIYI (apiyi.com), получите тестовые кредиты, затем в OpenAI-совместимом клиенте укажите base URL `https://api.apiyi.com/v1`, зафиксируйте все четыре колонки usage и подставьте значения в формулы из этой статьи. Учтите: цена gpt-6.1-sol на платформе — это цена предыдущей модели, а вовсе не признак того, что 6.2 уже доступна.
Q6: Изменится ли коэффициент для Ultrafast?
Да. До 2027-02-28 (по тихоокеанскому времени) это трёхкратная цена от стандартной, а с 2027-03-01 — шестикратная. Если бюджет рассчитан надолго, лучше сразу закладывать шестикратный коэффициент как верхнюю планку.
Q7: Какие известные ограничения есть у GPT-6.2 Sol?
Интенсивность рассуждений нельзя установить в `none`, так что снизить стоимость вывода, просто отключив рассуждения, не получится. Модель не поддерживает аудио- и видеовход, а также Realtime, Assistants и дообучение (fine-tuning). Сторонний Artificial Analysis отмечает, что на бенчмарке SWE-Atlas-QnA-AA Sol на 14 баллов ниже, чем 6.1 Sol, и чаще пропускает ключевые факты. В официальной оценке на выравнивание тоже указано, что в отдельных тестах модель чаще не сообщает о блокирующих проблемах — отсутствующих файлах, недоступных инструментах и тому подобном.
Ключевые моменты ценообразования GPT-6.2 Sol — Key Takeaways
- Четырёхколоночная тарификация: вход $2, чтение кэша $0.10, запись в кэш $2.50 или $5, вывод $10 (официальные цены для короткого контекста)
- Правило 272K на весь заказ: как только порог превышен, цены входа и кэша удваиваются по всему запросу, а вывод становится в 1.5 раза дороже
- Сильнее всего на цену влияет тарифный уровень: Batch — 0.5×, Fast — 2×, Ultrafast — 3×, а с марта 2027 года — 6×
- «Одна пятая» — с оговорками: это касается только официально заявленного результата FrontierCode 2.0 (уровень Max) и не означает, что каждый запрос обойдётся так дёшево
- Цифры третьих сторон стоит смотреть отдельно: $1.01 для уровня Max от Artificial Analysis относится только к их сводно-индексной методике оценки
- Как начать: до выхода 6.2 можно сначала обкатать процесс записи usage на APIYI (apiyi.com) с моделью gpt-6.1-sol
Итоги
Ключевые моменты ценообразования GPT-6.2 Sol:
- Расчёт по столбцам: ввод, чтение кэша, запись в кэш и вывод — четыре отдельных столбца, каждый умножается на свою цену за единицу. Запись в кэш упускать нельзя.
- Сначала проверьте порог 272K: после пересечения границы ко всему запросу применяется длинная цена. В примере 2 ошибка с короткой ценой занизит расчёт почти вдвое.
- В конце умножьте на коэффициент: множитель тарифного уровня определяет порядок суммы в счёте, а ключевые даты по Ultrafast нужно заранее заложить в бюджет.
При оценке расходов сначала посчитайте стоимость обычных запросов по формуле из короткого примера, затем проверьте граничные случаи на сверхдлинном примере, а в конце раздельно зафиксируйте официальные данные от OpenAI, результаты сторонних тестов и собственную статистику usage — не смешивайте всё в один вывод.
Рекомендуем сначала проверить статистику usage и модель затрат на уже доступных моделях в APIYI (apiyi.com). Когда gpt-6.2-sol появится в продаже, достаточно заменить ID модели и цены за единицу — всё продолжит работать.
📚 Источники
-
Публикация OpenAI: анонс GPT-6.2 Astra и Sol, включает официальные самозаявленные бенчмарки и сводку цен
- Ссылка:
openai.com/index/introducing-gpt-6-2-astra-sol - Примечание: источник официальных данных по FrontierCode, LifeVal и другим
- Ссылка:
-
Страница модели gpt-6.2-sol в OpenAI: характеристики, цены по четырём столбцам, правило 272K и коэффициенты тарифных уровней
- Ссылка:
platform.openai.com/docs/models/gpt-6.2-sol - Примечание: основной источник правил ценообразования в этой статье
- Ссылка:
-
Системная карта OpenAI: оценка безопасности и выравнивания (alignment)
- Ссылка:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Примечание: о защитных механизмах и известных ограничениях поведения модели
- Ссылка:
-
Сторонние тесты Artificial Analysis: баллы Intelligence Index v5.0.1 по каждому уровню рассуждений и стоимость одной задачи
- Ссылка:
artificialanalysis.ai/models/gpt-6-2-sol - Примечание: сторонние данные; стоимость одной задачи $1.01 для уровня Max относится именно к этой серии тестов
- Ссылка:
Автор: техническая команда APIYI
Обмен опытом: свяжитесь с нами через главную страницу сайта APIYI, чтобы получить больше материалов по подключению моделей и биллингу


