
Примечание автора: мультипроектному агенту нужны независимые контексты, сохраняемое состояние, планировщик задач и механизм восстановления — только при этих условиях параллельная работа остаётся отслеживаемой и не мешает сама себе.
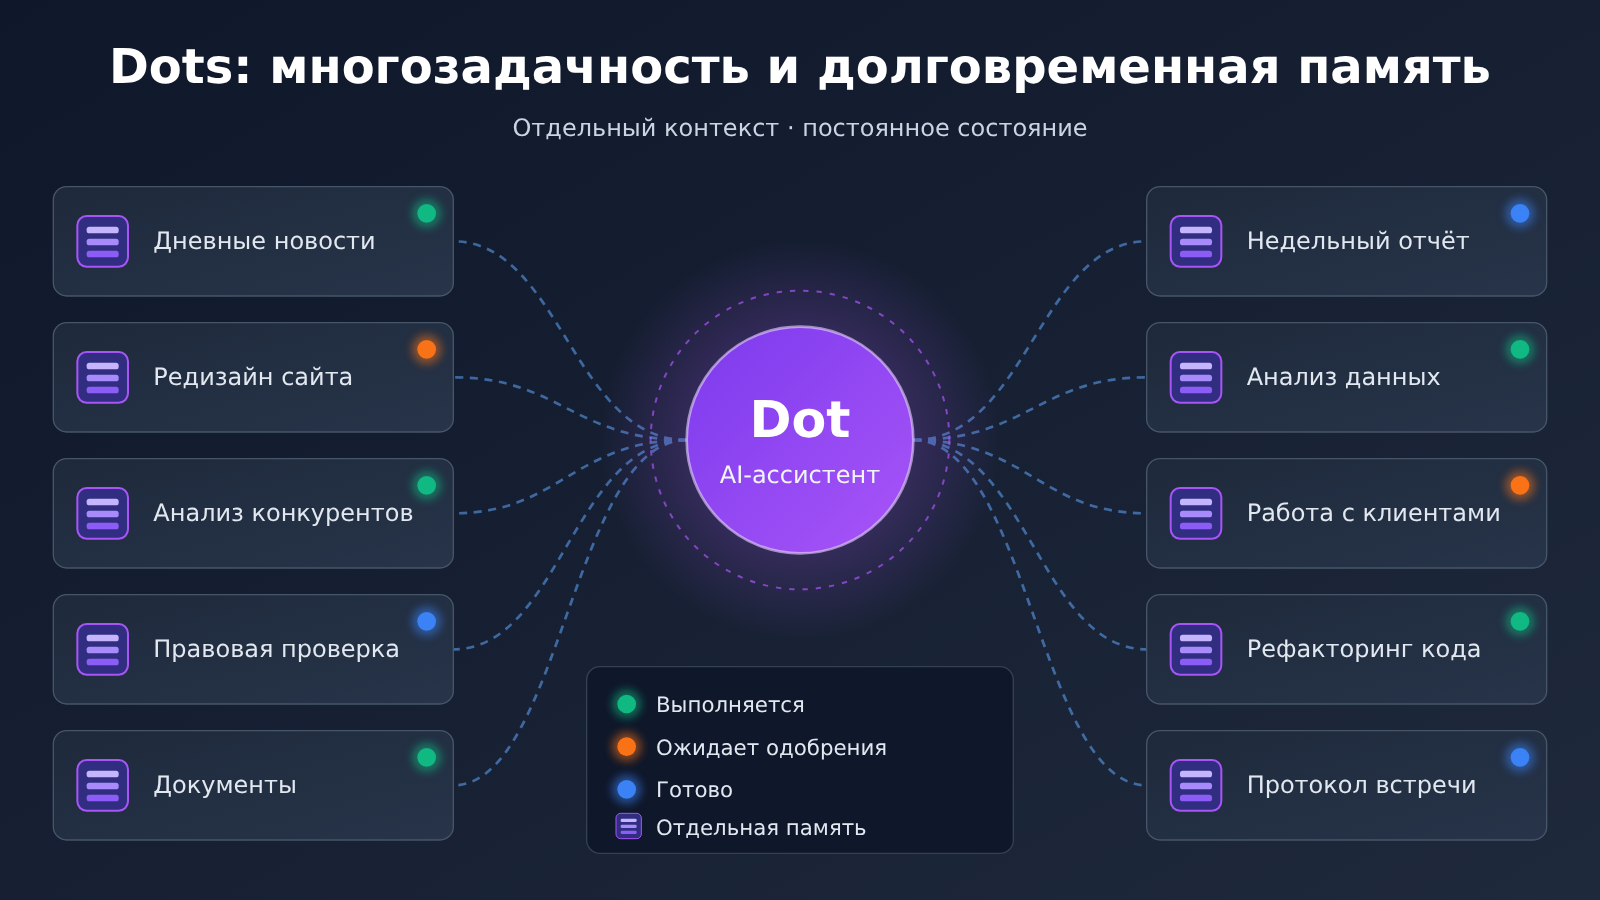
Может ли AI-ассистент вести несколько проектов одновременно — всё упирается в четыре вещи: у каждой работы собственный контекст, состояние выполнения сохраняется на диск, планировщик единообразно расставляет приоритеты и управляет параллелизмом, а после сбоя можно восстановиться с контрольной точки. Вызвать несколько моделей сразу — не сложно; сложно сделать так, чтобы каждый вызов помнил, чем именно он занят. Именно эту схему использует Dots, выпущенный OpenAI 29 сентября 2026 года. В официальной документации сказано: один Dot может вести несколько направлений ответственности и раздавать работу фоновым агентам для параллельной обработки. У каждой новой задачи свой контекст диалога, и она не получает автоматически всю историю переписки пользователя с Dot. Разработчик может собрать похожую систему управления несколькими проектами на Checkpointer, Store, очереди задач и машинах состояний.
Дальше сначала разберём по официальным материалам механизм многозадачности и памяти Dots, а затем на сквозном примере управления проектами последовательно проработаем четырёхуровневую структуру задач, параллельное планирование, восстановление после прерывания, трассировку выполнения и границы затрат. «Десять проектов» в заголовке — лишь образное описание режима работы; ни у Dots, ни у самодельной системы нет фиксированного параллелизма на десять веток, и бесконечным он быть не может. Код самодельного агента в статье — это проектное решение, без придуманных результатов запуска.
Что нужно знать: термины, связанные с многозадачным планированием в Dots
| Термин | Объяснение |
|---|---|
| Workspace | Рабочее пространство для организации проектов и прав доступа; обычно соответствует одному пользователю или одной команде. |
| Project | Единица проекта, включающая цели, материалы и связанные задачи. |
| Task | Работа с четкой целью, например «найти новости OpenAI за сегодня». |
| Run | Запись одного фактического выполнения задачи; одна и та же Task может выполняться много раз. |
| Фоновый агент | Исполнитель, которого Dot отправляет параллельно обрабатывать подзадачи; по завершении он докладывает Dot. |
| Checkpointer | Компонент, сохраняющий контрольные точки выполнения задачи и отвечающий за восстановление после прерывания. |
| Store | Компонент хранения, сохраняющий долгосрочную информацию между задачами и отвечающий за преемственность контекста проекта. |
| Машина состояний | Механизм, который по правилам управляет переходами задачи между этапами: ожидает выполнения, выполняется, ожидает утверждения. |
| Ограничение параллелизма | Верхний предел числа одновременно выполняемых задач, обусловленный квотой API, ресурсами сервера и затратами. |
| Трассировка | Возможность отслеживания, фиксирующая вызовы моделей, вызовы инструментов и процесс передачи задач. |
| Проактивное исследование | Фоновое исследование только для чтения, которое Dots выполняет по авторизованным источникам данных при отсутствии новых сообщений. |
1 Многозадачное планирование в Dots: почему один Dot справляется сразу с несколькими обязанностями
1.1 Мультипроектные возможности, которые Dots раскрывает официально
Согласно официальному позиционированию, Dots — это постоянно работающий персональный агент. У него есть собственный облачный компьютер и браузер, поэтому даже после того, как пользователь ушёл, он продолжает продвигать делегированные задачи. Что касается многозадачности, в документе Tasks and memory перечислены следующие возможности:
- одновременно хранить состояние нескольких рабочих задач и переключаться между ними в одном диалоге;
- пользователь может в любой момент добавить информацию и изменить приоритеты;
- разбивать сложную задачу на части и передавать их фоновому агенту для параллельной обработки;
- создавать отдельные видимые потоки задач, а затем собирать результаты по каждому из них и сводить воедино;
- запрашивать вмешательство пользователя, когда работа застопорилась, — при этом во время выполнения фоновых задач пользователь может продолжать отправлять сообщения.
В совокупности эти возможности делают роль Dot ближе к роли координатора проекта. Он решает, что делать первым, что выделить в отдельное русло, а что вернуть пользователю; конкретное исполнение отдельной задачи могут взять на себя фоновый агент, задача ChatGPT Work или задача Codex.
1.2 Разница между несколькими диалогами, несколькими задачами и мультиагентным режимом
Эти три понятия часто путают, хотя они решают разные задачи. Рассмотрим на одном примере: предположим, в рабочем пространстве пользователя есть три проекта — AI Radar (ежедневная сводка новостей об AI), Website (редизайн сайта) и Research (исследование конкурентов).
| Режим | Как работает | Как это выглядит в примере | Какую задачу решает |
|---|---|---|---|
| Несколько диалогов | Пользователь открывает отдельное окно чата для каждого проекта | Пользователь сам помнит, на каком шаге остановился Research | Изолирует содержимое чатов, но прогрессом по-прежнему управляет человек |
| Несколько задач | Один координатор ведёт состояние нескольких задач | Dot фиксирует прогресс и приоритет каждого из трёх проектов | Единая диспетчеризация и отслеживание статуса |
| Мультиагентный режим | Координатор передаёт подзадачи нескольким исполнителям | Фоновый агент собирает материалы, другой исполнитель пишет отчёт | Параллельное выполнение и разделение по специализациям |
Dots объединяет все три уровня: пользователь общается с Dot через единую точку входа, Dot ведёт несколько задач и по необходимости выделяет фоновых агентов. Чтобы воспроизвести такой эффект в собственной системе, нужно реализовать все три слоя — просто открыть несколько окон чата недостаточно.
1.3 Наблюдение пользователя за параллельным выполнением
Один пользователь на Reddit описал собственный тест, длившийся день. Он передал Dot на проверку сотни PDF-файлов и тысячи страниц документов, одновременно запустив задачи юридического исследования. Он заметил, что три процесса выполнялись параллельно: собственный облачный компьютер Dot обрабатывал задачу A, подключённый им компьютер с Linux — задачу B, а другой фоновый исследовательский агент — задачу C. Он также упомянул, что при запуске отдельной задачи юридического исследования столкнулся с недоступностью среды выполнения и смог успешно отправить задачу только после подключения локального компьютера.
Это личное наблюдение показывает, что облачный компьютер Dot, локальный компьютер и среды Work/Codex — разные вычислительные ресурсы. Автор также отметил, что не проверял, имеют ли эти пути независимые и неограниченные квоты. Поэтому этот тест говорит лишь о том, что Dots умеет распределять работу между разными средами; на его основании нельзя заключить, что каждый пользователь Pro получит такой же масштаб параллельной работы.
2 Долговременная память Dots: почему задаче нужна отдельная память
2.1 Границы контекста новой задачи
В официальной документации прямо сказано: у каждой новой задачи свой контекст диалога, и она не получает автоматически всю историю диалогов между Dot и пользователем. Dot может обращаться к прошлым диалогам ChatGPT, чтобы найти контекст, но найденное используется только как контекст текущей работы.
Это вполне практичное решение. Если каждая задача будет загружать всю историю, отчёт о конкурентах в проекте Research может смешаться с обсуждением редизайна проекта Website, а контекст будет становиться всё длиннее и дороже. Долгосрочным проектам нужно явно управлять тем, «что должна знать эта задача»; одной постоянно растущей перепиской этого не добиться.
2.2 Четыре слоя данных в памяти Dots
Согласно официальным материалам, контекст Dot поступает из четырёх разных источников:
- ChatGPT Memory: Dot может читать релевантные воспоминания ChatGPT и недавние диалоги;
- Собственные заметки Dot: накапливают предпочтения пользователя, рабочие привычки, решения по проектам и долгосрочные обязанности;
- Контекст текущей задачи: инструкции, файлы, результаты поиска и результаты выполнения инструментов в этом диалоге;
- Данные подключённых приложений: Dot читает данные авторизованных приложений и может формировать память через активное исследование.
У этих слоёв разный жизненный цикл. ChatGPT Memory и заметки Dot относятся к разным слоям данных: отключение совместного использования ChatGPT Memory не удаляет автоматически информацию, уже получённую Dot, а отключение плагина только останавливает новые обращения. По состоянию на 16 ноября 2026 года пользователи ещё не могут по отдельности просматривать, изменять или удалять независимую память Dot; удаление Dot запускает удаление её собственного контекста. При проектировании слоя памяти для собственной системы можно взять за основу эту идею разделения на слои и при этом добавить интерфейс управления с возможностью просмотра и удаления.
3 Checkpointer и Store: два вида памяти мультизадачного агента
В документации LangGraph по персистентности память агента делится на две категории. Это разделение как раз соответствует «контексту задачи» и «долговременным заметкам» в Dots. Ниже по-прежнему разбираем ежемесячный отчёт о конкурентах из проекта Research.
3.1 Checkpointer: запоминает, на каком шаге остановилась работа
Checkpointer сохраняет снимок выполнения отдельного потока задачи: текущий шаг, уже вызванные инструменты, результаты их работы и шаг, который ждёт ручного подтверждения. В нашем примере задача с ежемесячным отчётом уже собрала страницы с ценами шести конкурентов и как раз перед этапом анализа сервис перезапустился. Благодаря чекпоинту задачу можно продолжить с шага «анализ», а собранные материалы не нужно собирать заново.
От носителя хранения зависит, переживут ли чекпоинты перезапуск. Реализация в памяти подходит для разработки и тестов, но после перезапуска процесса состояние пропадёт. Для локального персистентного хранения можно использовать SQLite, а для сервисов с долгосрочным развёртыванием лучше подойдёт PostgreSQL. Чекпоинты постоянно растут, поэтому в продакшене нужно ещё продумать стратегию очистки устаревших состояний.
3.2 Store: запоминает контекст проекта
Store хранит долговременные данные между задачами и сессиями: предпочтения пользователя, контекст проекта, прошлые решения и знания, общие для нескольких задач. В нашем примере к содержимому Store относятся «читатели отчёта — продуктовая команда», «отслеживаем только цены и обновления функций API» и «в прошлом месяце решили больше не отслеживать конкурента, который перестал обновляться». Когда в следующем месяце создаётся новая задача отчёта, она читает эти решения, и пользователю не нужно повторно всё объяснять.
3.3 Сравнение ролей Checkpointer и Store
| Аспект | Checkpointer | Store |
|---|---|---|
| Область действия | Один поток задачи | Несколько задач, между потоками |
| Что хранит | Снимок состояния выполнения | Долговременные материалы и факты |
| Основная ценность | Возобновление работы после прерывания | Продолжение контекста проекта в новой задаче |
| Пример содержимого | «Собраны страницы с ценами 6 конкурентов, следующий шаг — анализ» | «Читатели отчёта — продуктовая команда» |
| Жизненный цикл | Следует за состоянием задачи, после завершения можно очистить | Хранится и обновляется по стратегии долговременной памяти |
У них чёткое разделение обязанностей, и оба нужны. Если есть только Checkpointer, каждая новая задача похожа на первый день нового сотрудника. Если есть только Store, после любого прерывания задачу приходится начинать с нуля.
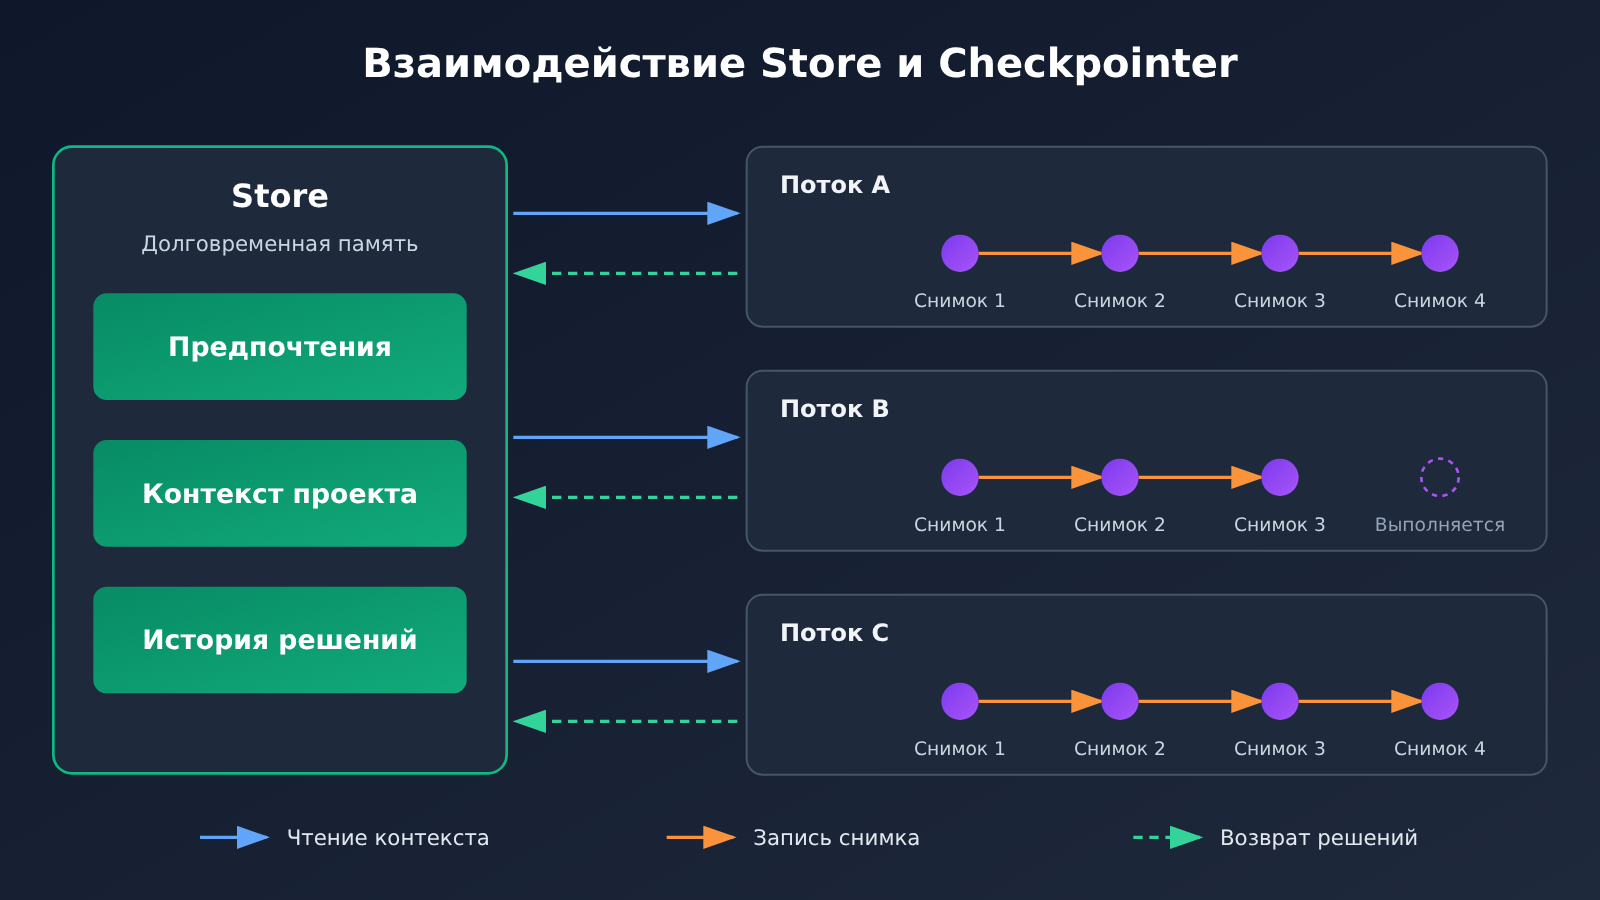
Цикл «читаем контекст — пишем снимок — возвращаем решения», показанный на схеме выше, напрямую отображается на код из раздела 6. В примере кода модель вызывается через OpenAI-совместимый интерфейс APIYI (apiyi.com); при смене модели достаточно изменить имя модели.
4 Проектирование системы управления задачами для нескольких проектов: Workspace, Project, Task, Run
4.1 Четырёхуровневая структура и независимые ID
Для собственного многопроектного агента лучше использовать четырёхуровневую структуру, где у каждого уровня есть независимый ID:
| Уровень | Назначение | Пример |
|---|---|---|
| Workspace | Управляет рабочим пространством пользователя и правами доступа | regulus |
| Project | Управляет целями и материалами отдельного проекта | AI Radar, Website, Research |
| Task | Управляет конкретной задачей | Daily News, Monthly Report |
| Run | Фиксирует один фактический запуск | запуск Daily News 2026-11-16 09:00 |
Соответствующая древовидная структура выглядит так:
Workspace: regulus
├── Project: AI Radar
│   ├── Task: Daily News
│   │   ├── Run: 2026-11-16
│   │   └── Run: 2026-11-17
│   └── Task: Topic Discovery
├── Project: Website
│   ├── Task: UI Improvement
│   └── Task: Bug Fix
└── Project: Research
    ├── Task: Competitor Analysis
    └── Task: Monthly Report
Хранить Task и Run отдельно — принципиально важно. Daily News запускается раз в день, и у каждого Run есть свои входные данные, результаты, длительность и статус. Если что-то пошло не так, можно точно определить, в какой день и при каком именно запуске возникла проблема.
4.2 Область доступа к памяти и изоляция проектов
Когда один агент ведёт несколько проектов, файлы разных проектов по умолчанию не должны быть доступны друг другу. Рекомендую разграничивать доступ к памяти по уровням:
- Общие пользовательские предпочтения (например, отчёты на китайском, сначала вывод): доступны всем авторизованным проектам;
- Контекст проекта (например, читатели Research и охват отслеживания): доступен только задачам этого проекта;
- Записи отдельной задачи: доступны только текущей задаче и явно авторизованным связанным задачам;
- Материалы корпоративных клиентов: доступны только указанным клиентским проектам;
- Конфиденциальные учётные данные: хранятся в отдельном защищённом хранилище и никогда не попадают в контекст модели.
При передаче материалов между проектами фиксируйте источник и область авторизации. Так же поступает Dots: в официальном описании контекст Dot не сохраняет учётные данные, изображения и скриншоты, а границы прав определяются сочетанием авторизации плагинов и Custom Rules.
5 Многозадачное планирование: как сделать задачи параллельными и не мешающими друг другу
5.1 Отделяем планировщик от рассуждений Agent
Советую разделить «когда делать» и «как делать» между двумя компонентами. Планировщик отвечает за момент запуска, выбор проекта, текущее количество запущенных задач, приоритеты, тайм-ауты и повторные попытки; Agent — за понимание задачи, составление шагов, выбор инструментов, анализ результатов и представление итогов. Так правила планирования выполняются детерминированно, а модель занимается только той частью, где действительно нужны рассуждения.
Для выбора технологий можно взять такую связку: APScheduler управляет периодическими задачами, Celery служит очередью фоновых задач, Redis отвечает за сообщения и краткосрочную координацию, PostgreSQL хранит проекты и состояние выполнения, а фреймворки вроде LangGraph управляют ходом работы Agent и персистентным состоянием. Для небольшого прототипа вполне хватит asyncio в Python плюс SQLite — код в разделе 6 построен именно так.
5.2 Три способа распараллеливания
У мультизадачного агента есть как минимум три варианта параллельной работы:
- Параллелизм независимых задач: ежедневные новости AI Radar и ежемесячные отчёты Research не зависят друг от друга — можно запускать одновременно;
- Параллелизм подзадач: проект разбивается на подзадачи — сбор материалов, фактчекинг — и они выполняются параллельно;
- Параллелизм модельных ролей: разные модели отвечают за разные профессиональные участки работы, а итог затем сводится воедино.
Ограничения, определяющие, можно ли запускать задачи параллельно, включают: лимит одновременных запросов к API, ресурсы сервера, зависимости между задачами, конкуренцию за запись в базу данных, стоимость моделей, конфликты результатов и повторное выполнение.
5.3 Пример: сбор материалов, анализ данных, генерация отчёта
Ежемесячный отчёт проекта Research разбит на три подзадачи. Сбор материалов может идти параллельно с ежедневными новостями AI Radar; анализ данных зависит от результатов сбора и должен ждать его завершения; генерация отчёта зависит от выводов анализа, после завершения переходит в состояние ожидания утверждения и считается сданным только после подтверждения пользователем.
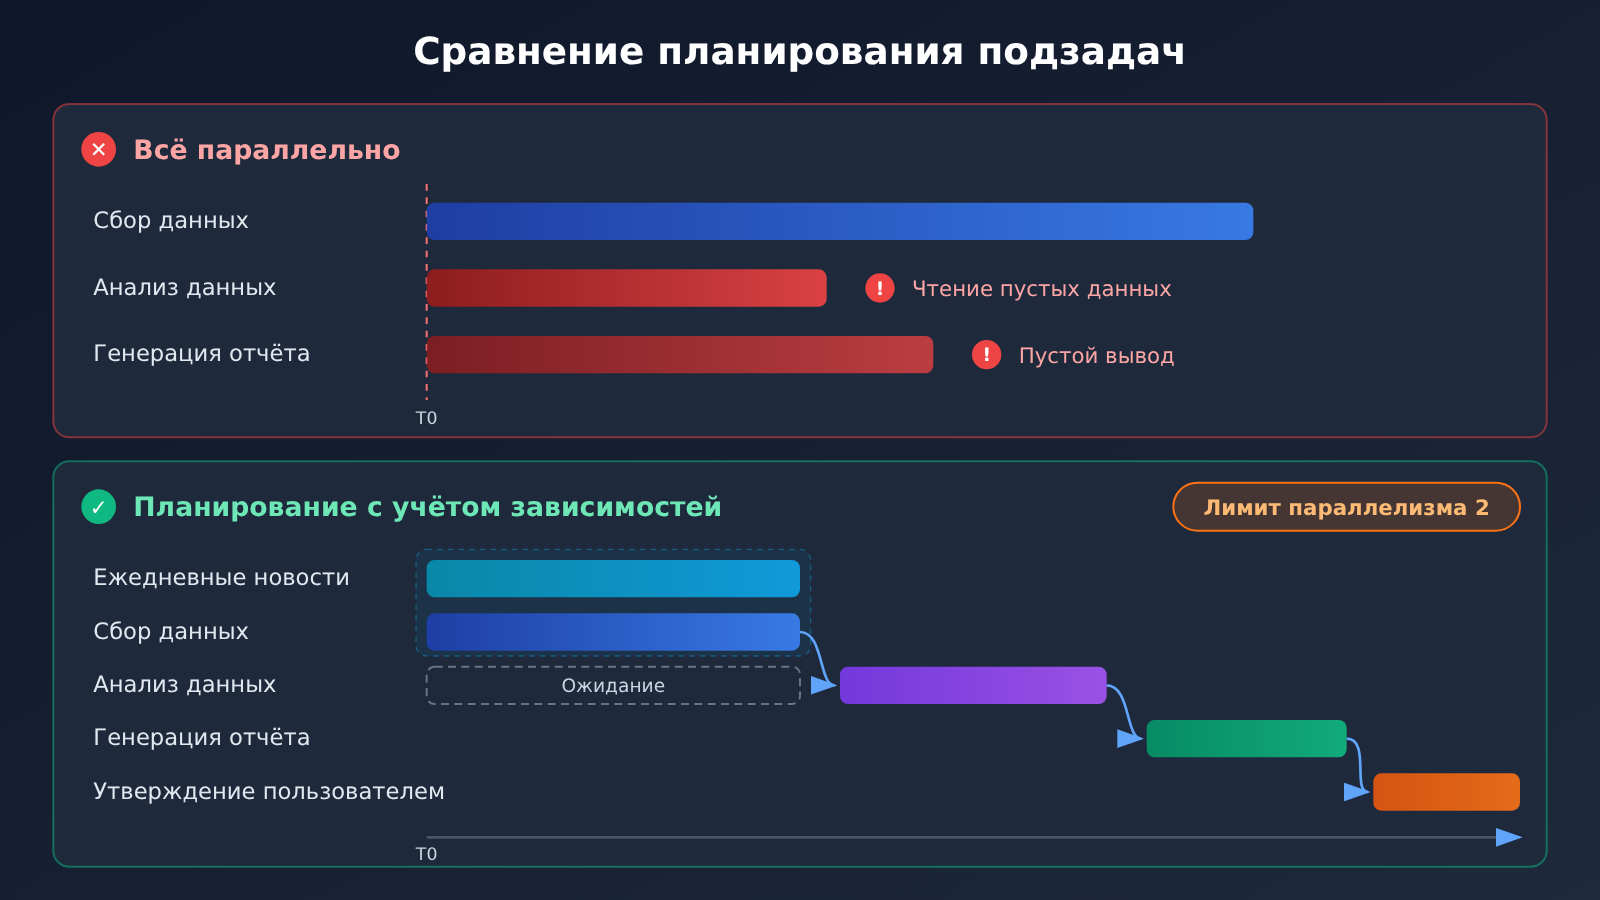
Запустить все три подзадачи сразу выглядит быстрее, но анализ данных из-за отсутствия материалов выдаст пустые выводы или даже выдумает данные. Зависимости определяют, какие задачи обязаны выполняться последовательно, а лимит одновременности — сколько задач может идти одновременно; и то и другое нужно прописать в планировщике, а не оставлять на импровизацию модели — так слишком легко ошибиться.
5.4 Распределение ролей моделей
| Подзадача | Рекомендуемый тип модели | Почему выбираем | Доступные платформы |
|---|---|---|---|
| Сбор и summarization материалов | Лёгкая быстрая модель | Большой объём вызовов, важна стоимость | APIYI apiyi.com, официальный API |
| Анализ данных | Модель с сильными способностями к рассуждению | Нужны многошаговые сравнения и вычисления | APIYI apiyi.com, официальный API |
| Генерация отчёта | Модель, хорошо пишущая длинные тексты | Высокие требования к структуре и качеству изложения | APIYI apiyi.com, официальный API |
| Проверка фактов | Модель, отличная от модели-писателя | Перекрёстная проверка снижает вероятность ошибок из одного источника | APIYI apiyi.com, официальный API |
Конкретные модели — по актуальному списку моделей на платформе. Когда один Key даёт доступ к нескольким моделям, роли можно перенастроить через конфигурацию, а структуру кода менять не нужно.
6 Быстрый старт: собираем прототип мультизадачного агента на едином интерфейсе
6.1 Минимальный пример: передача контекста проекта в задачу
Приведённый ниже код демонстрирует самую главную идею: перед выполнением задачи из долговременной памяти извлекается только контекст соответствующего проекта.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

# Store: долговременный контекст, изолированный по проектам
project_memory = {
    "research": "读者:产品团队;只跟踪 API 价格与功能更新;报告结论先行",
    "ai-radar": "每日 09:00 汇总 OpenAI、Anthropic、Google 官方动态",
}

def run_task(project_id: str, goal: str) -> str:
    resp = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[
            {"role": "system", "content": f"项目背景:{project_memory[project_id]}"},
            {"role": "user", "content": goal},
        ],
    )
    return resp.choices[0].message.content

print(run_task("research", "列出本月需要关注的竞品更新清单"))
6.2 Полный проект решения: конечный автомат, контрольные точки, зависимости и параллелизм
Код ниже — это проект решения, который охватывает Store, Checkpoint, конечный автомат, планирование зависимостей, ограничение параллелизма, повторные попытки, тайм-ауты и журнал выполнения и показывает, как все эти компоненты взаимодействуют между собой. Он не прошёл проверку в реальной эксплуатации, и в статье также не приводятся выдуманные результаты работы.
Посмотреть полный код проекта решения
import asyncio, json, sqlite3, time, uuid
from dataclasses import dataclass, field
from enum import Enum
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Единый интерфейс APIYI: один ключ для переключения между моделями
)

class Status(str, Enum):
    PENDING = "pending"; RUNNING = "running"; WAITING = "waiting"
    APPROVAL = "approval"; COMPLETED = "completed"
    FAILED = "failed"; CANCELLED = "cancelled"; PAUSED = "paused"

db = sqlite3.connect("agent.db")
db.executescript("""
CREATE TABLE IF NOT EXISTS store(
  scope TEXT, key TEXT, value TEXT, source TEXT, PRIMARY KEY(scope, key));
CREATE TABLE IF NOT EXISTS checkpoint(
  run_id TEXT, task_id TEXT, step TEXT, state TEXT, ts REAL);
CREATE TABLE IF NOT EXISTS runs(
  run_id TEXT PRIMARY KEY, workspace_id TEXT, project_id TEXT, task_id TEXT,
  model_id TEXT, input_tokens INT, output_tokens INT,
  duration REAL, retry_count INT, final_status TEXT);
""")

def store_get(scopes: list[str]) -> str:
    """Читает только авторизованные области: user и project:<id>"""
    marks = ",".join("?" * len(scopes))
    rows = db.execute(f"SELECT key, value FROM store WHERE scope IN ({marks})", scopes)
    return "\n".join(f"- {k}: {v}" for k, v in rows)

def save_checkpoint(run_id, task_id, step, state):
    db.execute("INSERT INTO checkpoint VALUES (?,?,?,?,?)",
               (run_id, task_id, step, json.dumps(state, ensure_ascii=False), time.time()))
    db.commit()

def log_run(run_id, task, usage, duration, retries, status):
    db.execute("INSERT OR REPLACE INTO runs VALUES (?,?,?,?,?,?,?,?,?,?)",
               (run_id, "regulus", task.project_id, task.task_id, task.model,
                getattr(usage, "prompt_tokens", 0), getattr(usage, "completion_tokens", 0),
                duration, retries, status.value))
    db.commit()

@dataclass
class Task:
    task_id: str
    project_id: str
    goal: str
    model: str
    depends_on: list[str] = field(default_factory=list)
    needs_approval: bool = False

async def run_task(task: Task, done: dict, sem: asyncio.Semaphore,
                   max_retry: int = 2, timeout: int = 120):
    run_id = f"run-{uuid.uuid4().hex[:8]}"
    background = store_get(["user", f"project:{task.project_id}"])
    upstream = "\n\n".join(done[d] for d in task.depends_on)
    messages = [
        {"role": "system", "content": f"长期背景:\n{background}"},
        {"role": "user", "content": f"{task.goal}\n\n上游结果:\n{upstream or '无'}"},
    ]
    async with sem:  # ограничение параллелизма
        for attempt in range(max_retry + 1):
            start = time.time()
            save_checkpoint(run_id, task.task_id, f"attempt-{attempt}", messages)
            try:
                resp = await asyncio.wait_for(
                    client.chat.completions.create(model=task.model, messages=messages),
                    timeout)
                output = resp.choices[0].message.content
                status = Status.APPROVAL if task.needs_approval else Status.COMPLETED
                log_run(run_id, task, resp.usage, time.time() - start, attempt, status)
                save_checkpoint(run_id, task.task_id, status.value, {"output": output})
                if status == Status.COMPLETED:
                    done[task.task_id] = output
                return
            except Exception as e:  # таймаут или ошибка API: повтор с экспоненциальной задержкой
                save_checkpoint(run_id, task.task_id, "error", {"error": str(e)})
                await asyncio.sleep(2 ** attempt)
        log_run(run_id, task, None, 0, max_retry, Status.FAILED)

async def schedule(tasks: list[Task], max_concurrency: int = 2) -> dict:
    sem = asyncio.Semaphore(max_concurrency)
    done: dict[str, str] = {}
    pending = {t.task_id: t for t in tasks}
    while pending:
        ready = [t for t in pending.values() if all(d in done for d in t.depends_on)]
        if not ready:  # предварительные задачи не выполнены, ожидают подтверждения или есть циклическая зависимость
            print("阻塞任务:", list(pending))
            break
        await asyncio.gather(*(run_task(t, done, sem) for t in ready))
        for t in ready:
            pending.pop(t.task_id)
    return done

tasks = [
    Task("daily-news", "ai-radar", "汇总今日 AI 官方动态", "gpt-4.1-mini"),
    Task("collect", "research", "收集本月竞品 API 价格与功能变更", "gpt-4.1-mini"),
    Task("analyze", "research", "对比变更并归纳趋势", "gpt-4.1", depends_on=["collect"]),
    Task("report", "research", "生成月度竞品报告", "gpt-4.1",
         depends_on=["analyze"], needs_approval=True),
]
asyncio.run(schedule(tasks))
В коде есть несколько мест, перекликающихся с дизайном из предыдущей части. store_get читает только user и текущую область проекта, обеспечивая изоляцию проектов; таблица checkpoint записывает каждый шаг по run, а вместе с таблицей runs фиксирует Token и итоговый статус; schedule определяет последовательность по зависимостям и ограничивает параллелизм семафором. В реальной системе ещё нужно добавить вызов инструментов, callback для утверждений и точку входа для восстановления.
🚀 Быстрый старт: на этапе прототипа советую получить бесплатную тестовую квоту через APIYI apiyi.com, настроить одним и тем же ключом разные модели для трёх ролей — сборщика, аналитика и автора — а затем, сравнив результаты и затраты, определить разделение труда.
7. Как многозадачный агент обрабатывает прерывания, сбои и ручное утверждение
7.1. Машина состояний задачи
Прогресс задачи должен фиксироваться явными статусами: описание прогресса, которое модель даёт в чате, может служить лишь ориентиром. Рекомендуемый основной поток — Pending (ожидает выполнения) → Running (выполняется) → Waiting (ожидает внешних условий) или Approval (ожидает утверждения) → Completed (завершено); дополнительно есть три статуса остановки или паузы: Failed, Cancelled, Paused. Каждый переход статуса записывается в базу, и планировщик принимает решения, опираясь только на статусы в базе.
7.2. Повторы, тайм-ауты, пауза и возобновление
- Повторы: при ошибке интерфейса или тайм-ауте — повтор с экспоненциальной задержкой и записью retry_count, чтобы выявлять шаги, которые часто сбоят;
- Тайм-аут: каждому Run задаётся лимит выполнения; по его истечении Run переходит в Failed с оповещением — чтобы зависшая задача не занимала надолго место в пуле параллелизма;
- Пауза и возобновление: при паузе сохраняется контрольная точка, при возобновлении работа продолжается с последней контрольной точки, а уже выполненные вызовы инструментов повторять не нужно;
- Идемпотентность: для шагов с побочными эффектами (отправка писем, запись в базу) перед повтором проверяется, не выполнены ли они уже, — чтобы не сделать лишнего.
В официальных материалах Dots есть любопытная деталь: остановить выполняющуюся задачу и отменить уже созданный периодический план — разные вещи; при паузе Dot независимые Work, Codex и плановые задачи тоже могут продолжать работать. В собственной системе стоит развести «остановить текущий Run», «приостановить Task» и «отменить периодический план» на три отдельные операции.
7.3. Ручное утверждение: на примере Custom Rules из Dots
Dots с помощью Custom Rules делит поведение на четыре уровня: выполнять сразу без вопросов; выполнять после предварительного разрешения; спрашивать перед выполнением; передавать пользователю. Такие операции, как смена пароля или перевод денег, должны обязательно переходить к пользователю; для безвозвратного удаления данных или установки программного обеспечения может требоваться подтверждение каждый раз. Даже одобрение пользователя не может обойти базовые ограничения безопасности.
В собственной системе можно по этому же принципу помечать инструменты. Только чтение и поиск выполняются сразу; после того как черновик отчёта готов, задача переходит в Approval; всё, что связано с отправкой вовне, платежами и удалением, передаётся человеку. В примере для задачи с отчётом установлен needs_approval=True: после генерации она останавливается в статусе утверждения и только после подтверждения пользователем переходит в Completed.
8 Трассировка выполнения многозадачного агента: Tracing и логи
Когда несколько проектов идут параллельно, пользователи чаще всего спрашивают: «А что он вообще сделал?» Tracing в OpenAI Agents SDK позволяет записать, какой агент был вызван, какая модель использовалась, какие вызовы инструментов произошли, где выполнялся handoff, какие проверки безопасности сработали и как в итоге завершилась задача.
Tracing хорошо восстанавливает ход одного запуска, но проектную статистику всё равно приходится дополнять бизнес-логами. Советую для каждого Run записывать как минимум project_id, task_id, run_id, model_id, input_tokens, output_tokens, tool_calls, duration, retry_count и final_status. С этими полями можно отвечать на управленческие вопросы вроде «сколько токенов потратил проект Research за этот месяц», «на каком шаге было больше всего повторов» и «аналитические задачи какой модели чаще всего упираются в таймаут». Таблица runs из раздела 6 — это минимальная реализация этого набора полей.
9 Стоимость и границы управления многозадачным агентом
9.1 Структура расходов Dots
По состоянию на 16 ноября 2026 года частные пользователи могут работать с Dots через три подписки ChatGPT Pro 100, Pro 200 и Pro 500 с месячной платой 100, 200 и 500 долларов соответственно. В официальном описании Dots для личной подписки Pro отдельная месячная плата за Dot не указана. Задачи ChatGPT Work или Codex, которые делегирует Dot, считаются по квотам и правилам соответствующего продукта; расход зависит от модели, контекста, рассуждений, вызовов инструментов и поиска. Для личного Pro также действуют возрастные ограничения (18 лет и старше) и региональные ограничения; Европейская экономическая зона, Великобритания и Швейцария в него не входят.
В корпоративных рабочих пространствах схема оплаты другая. В актуальной официальной документации сказано, что подходящие корпоративные рабочие пространства могут выбрать фиксированную ставку по типу работы или оплату по фактическому использованию; в период предварительного просмотра — бесплатно, а с 18 ноября 2026 года для уже активированных Dots начнётся взимание платы; задачи, делегированные в Work или Codex, оплачиваются отдельно. Конкретные суммы определяются тарифами, которые фактически применяются к рабочему пространству.
9.2 Источники затрат при собственной сборке
Затраты на собственного многозадачного агента складываются в основном из четырёх вещей:
- Повторное чтение контекста: в каждую задачу добавляется контекст проекта; чем длиннее этот контекст, тем больше входных токенов в каждом вызове, поэтому содержимое Store нужно регулярно сокращать;
- Повторы и неудачи: одна неудачная аналитическая задача снова отправляет исходные материалы в модель;
- Выбор модели: если все подзадачи выполнять на самой сильной модели, расходы вырастут в разы;
- Лимиты параллелизма: ограничения скорости API определяют, сколько задач реально можно выполнять параллельно.
9.3 Количество параллельных задач и полезная работа
Количество параллельных задач и полезная работа — не одно и то же. Если запускать задачи до того, как выполнены их зависимости, получится только мусор; противоречащие друг другу выводы придётся объединять вручную; ошибочные данные одного проекта через общую память могут попасть в другой, и тогда переделывать придётся ещё дороже. Разумный подход — сначала обеспечить изоляцию проектов и корректные зависимости, а затем постепенно повышать лимит параллелизма по данным мониторинга.
10 Частые вопросы (FAQ)
Вопрос 1: Что такое многозадачная диспетчеризация в Dots?
Один Dot одновременно ведёт несколько направлений ответственности. Пользователь может переключаться между задачами и менять приоритеты, а Dot разбивает сложную работу на части и передаёт их фоновым Agent’ам для параллельной обработки, после чего собирает результаты и возвращает их пользователю в момент, когда нужно принимать решение.
Вопрос 2: Долговременная память Dots запоминает все прошлые диалоги?
Не всё загружается целиком. У новой задачи свой контекст диалога, и Dot опирается на ChatGPT Memory, собственные заметки, контекст текущей задачи и данные подключённых приложений, а к прошлым диалогам обращается только при необходимости.
Вопрос 3: Могут ли Checkpointer и Store заменять друг друга?
У них разные зоны ответственности. Checkpointer сохраняет снимок выполнения отдельной задачи и служит для восстановления после прерывания; Store хранит проектный контекст и решения, общие для разных задач, чтобы новая задача продолжала с того места, где остановились. Для долгосрочных проектов нужны оба.
Вопрос 4: Сколько задач Dots может выполнять параллельно?
В официальных материалах фиксированное число параллельных задач не опубликовано. Dots поддерживает параллельную работу, но среда выполнения и лимиты использования имеют границы. Пользователь на Reddit рассказывал, что наблюдал три одновременно выполняющихся процесса — это лишь результат его личного теста.
Вопрос 5: Как в собственном мультипроектном Agent быстро подключать разные модели?
Можно использовать агрегирующий интерфейс, совместимый с OpenAI. Зарегистрируйтесь в APIYI apiyi.com, получите API-ключ и бесплатную тестовую квоту, задайте `base_url` в коде из этой статьи как `https://api.apiyi.com/v1` — и один и тот же код позволит настраивать GPT, Claude, Gemini и другие модели для разных подзадач.
Вопрос 6: Как контролировать затраты на модели в многозадачном Agent?
Распределяйте модели по ролям: для сбора материалов — лёгкие модели, для анализа и написания — сильные; сокращайте проектный контекст в Store; считайте токены по каждому проекту через таблицу runs. Через APIYI apiyi.com оплата идёт по факту использования, так что удобно сначала провести небольшой тест, а потом определять квоты.
Вопрос 7: На что обращать внимание в вопросах безопасности у Dots и собственных систем?
Agent может неверно понять задачу, ошибиться в оценке материалов или столкнуться с Prompt Injection; официально также признают, что существующие меры защиты не устраняют все риски. Для операций, связанных с аккаунтами, деньгами и внешними отправками, стоит настраивать ручное подтверждение, а чувствительные учётные данные не должны попадать в контекст модели.
11 Dots: многозадачная оркестрация и долговременная память — ключевые выводы
- Главная сложность: для многозадачного агента важнее всего независимые контексты, устойчивое состояние, планирование и восстановление.
- Механика Dots: один Dot координирует несколько задач, фоновые агенты выполняются параллельно, а контексты новых задач не зависят друг от друга.
- Две разновидности памяти: Checkpointer отвечает за восстановление выполнения, Store — за преемственность контекста проекта.
- Четыре уровня структуры: у Workspace, Project, Task и Run свои независимые ID, а проекты изолированы друг от друга.
- Принципы планирования: зависимости определяют последовательность, лимит параллелизма — масштаб, а правила зашиты в планировщик.
- Отслеживаемость: каждый Run фиксирует модель, токены, время выполнения, число повторов и итоговый статус.
- Как начать: через единый интерфейс APIYI apiyi.com можно назначить разные модели разным подзадачам.
12 Итоги
Dots показывает продуктовую модель, в которой персональный агент управляет несколькими долгосрочными проектами: работает постоянно, контексты задач независимы, память хранится послойно, фоновые агенты выполняются параллельно, а операции с высоким риском передаются пользователю. Его способность работать с несколькими проектами строится на управлении состоянием — одним лишь увеличением числа параллельных задач этого не добиться.
Если строите похожую систему самостоятельно, можно внедрять её в том же порядке, что и в статье: сначала реализовать изоляцию проектов через четырёхуровневую структуру и разделение по областям (scope), затем с помощью Store и Checkpointer отдельно решить задачи «помнить контекст» и «уметь восстанавливаться», после этого настроить планировщик для управления зависимостями и параллелизмом и, наконец, с помощью машины состояний, согласования и журналов выполнения сделать каждый шаг управляемым и проверяемым. На этапе прототипа стоит через APIYI apiyi.com быстро проверить, как разные модели справляются с отдельными ролями, а затем по данным журналов уточнить распределение ролей и уровень параллелизма.
Справочные материалы
- OpenAI: Introducing dots — анонс продукта
- Ссылка:
openai.com/index/introducing-dots - Описание: позиционирование продукта, облачный компьютер и выполнение нескольких проектов
- ChatGPT Learn: Tasks and memory — документация Dots по задачам и памяти
- Ссылка:
learn.chatgpt.com/docs/dots/tasks-and-memory - Описание: фоновый агент, отдельный контекст для каждой задачи, проактивные исследования
- OpenAI Help Center: Dots privacy, security, and safety FAQs — пояснения по конфиденциальности и безопасности
- Ссылка:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - Описание: права доступа, согласования, удаление памяти и хранение данных
- ChatGPT Learn: Dots admin guide — администрирование и биллинг корпоративной версии
- Ссылка:
learn.chatgpt.com/docs/enterprise/dots-admin-guide - Описание: модель тарификации корпоративных рабочих пространств и дата начала списаний
- About ChatGPT Pro tiers — описание уровней подписки Pro
- Ссылка:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - Описание: правила цен и квот для Pro 100, 200 и 500
- Документация LangGraph Persistence: Checkpointer и Store
- Ссылка:
github.com/langchain-ai/docs/blob/main/src/oss/langgraph/persistence.mdx - Описание: разделение краткосрочного состояния выполнения и долговременной памяти
- OpenAI Agents SDK: Tracing и рабочие процессы
- Ссылка:
developers.openai.com/api/docs/guides/agents/sdk - Описание: трассировка и отладка процесса выполнения агента
Автор: техническая команда APIYI
Обсуждение технических вопросов: будем рады обратной связи — свяжитесь с нами на главной странице APIYI apiyi.com; больше материалов по подключению — в центре документации docs.apiyi.com.


