
Кратко: В этой статье мы прогоняем одну и ту же рабочую нагрузку и считаем стоимость Prompt Caching по четырём частям: запись в кэш, чтение из кэша, динамический ввод и вывод. А ещё разбираем, как на реальной экономии сказываются доля попаданий, TTL и частота вызовов.
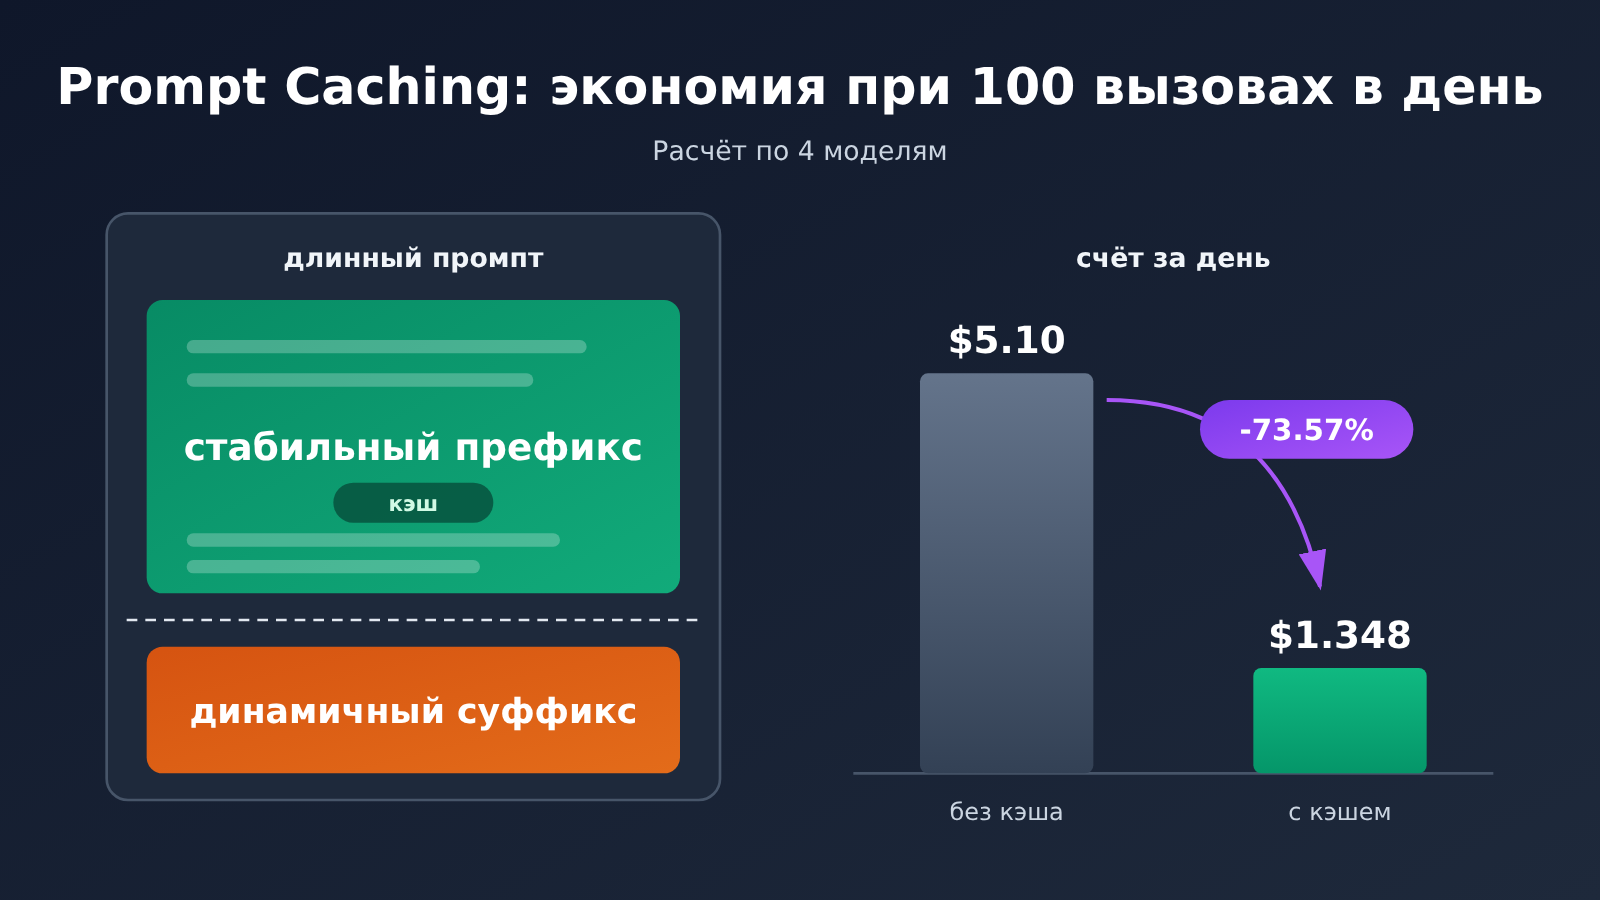
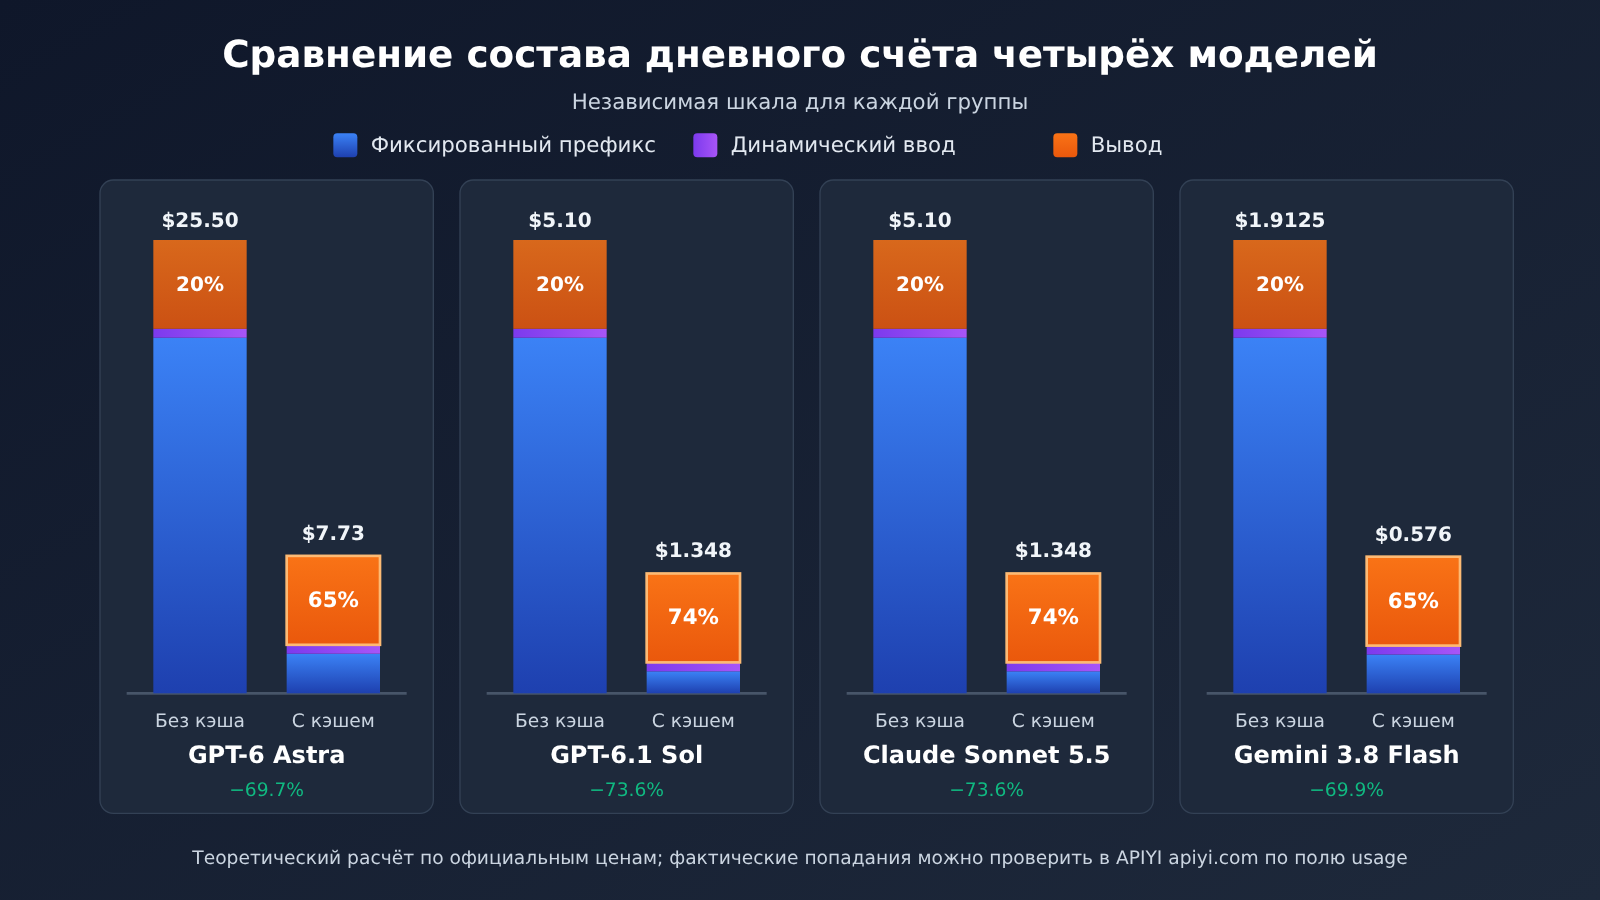
Вывод: В нашем сценарии рабочая нагрузка такая: фиксированный префикс 20K токенов на каждый вызов, динамический ввод 500 токенов, вывод 1K токенов, 100 вызовов в день. В идеальных условиях «первый вызов пишет в кэш, остальные 99 попадают в него» полный дневной счёт GPT-6.1 Sol падает с $5.10 до $1.348 — примерно на 73.57%. У Claude Sonnet 5.5 результат такой же, GPT-6 Astra снижается с $25.50 до $7.73 (примерно на 69.69%), а Gemini 3.8 Flash — с $1.9125 до $0.576 (примерно на 69.88%). Если смотреть только на фиксированный префикс, экономия составляет от 88% до 94%. По полному счёту процент ниже, потому что на выходные токены и динамический ввод скидка за кэш не распространяется. Все цифры — это расчётный бюджет по официальным тарифам, а не реальные счета. Цены взяты по стандартному тарифу для короткого контекста, дата сверки — 2026-11-13.
Что дальше: В части 1 разбираемся, какой именно фрагмент запроса переиспользуется из кэша и на какую часть счёта это влияет. В части 2 сравниваем правила кэширования у OpenAI, Claude и Gemini. В части 3 приводим формулы расчёта по всем четырём моделям — можете пересчитать сами. В части 4 на примере TTL и частоты вызовов показываем, почему доля попаданий падает. В части 5 — как организовывать промпт, как выбирать TTL, примеры кода и мониторинг доли попаданий. В части 6 обсуждаем критерии контроля затрат на токены в сценариях массового AI-производства.
To Know:подготовка терминов Prompt Caching
| Термин | Объяснение |
|---|---|
| Token | Единица измерения текста моделью; API тарифицируется по количеству токенов, цена обычно указывается в «долларах за миллион токенов (MTok)» |
| Prompt Caching | Кэширование уже обработанного префикса промпта, чтобы последующие запросы с тем же префиксом могли напрямую его переиспользовать и тем самым снизить затраты на повторную обработку |
| Стабильный префикс | Начальная часть промпта, дословно совпадающая в нескольких запросах, например описание роли, правила написания, образцы текстов, база знаний |
| Динамический ввод | Содержимое, которое меняется при каждом запросе, например новостные материалы дня, заголовок статьи, требования пользователя |
| Запись в кэш | Первая обработка стабильного префикса и сохранение его в кэше; цена обычно выше, чем у обычного ввода |
| Чтение из кэша | Последующий запрос попадает в существующий кэш и тарифицируется по цене, значительно меньшей, чем обычный ввод |
| Попадание в кэш | Префикс нового запроса совпадает с доступным кэшем по каждому токену, и переиспользование проходит успешно |
| TTL | Время жизни кэша. OpenAI определяет его как минимальное время жизни и не гарантирует точное время очистки |
| Точка остановки кэша | Место в промпте, помечающее «кэшируемый префикс заканчивается здесь» |
| Неявное / явное кэширование | Неявное кэширование: система сама определяет и переиспользует кэш; явное кэширование: разработчик сам объявляет точку остановки или создаёт объект кэша |
| Стоимость полной задачи | Сумма затрат на ввод, вывод и применимые инструменты для одного вызова — это истинный знаменатель при измерении доли экономии |
1 Prompt Caching экономит деньги — где именно?
1.1 Что именно переиспользует Prompt Caching
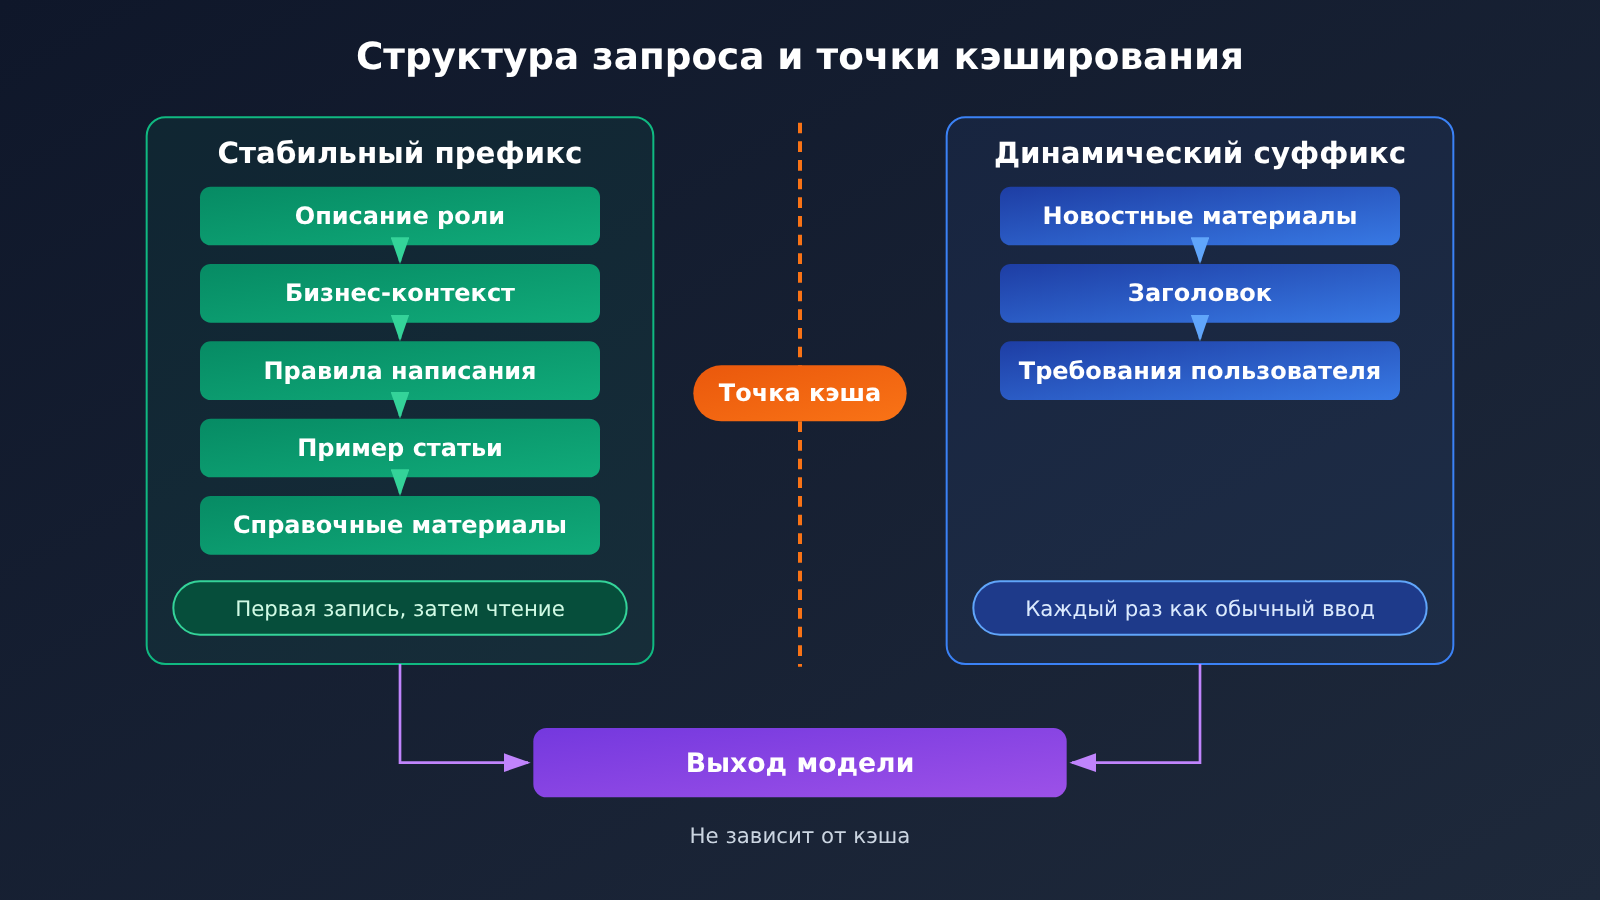
Возьмём для примера платформу для AI-писательства. При каждой генерации статьи запрос состоит из двух частей. Первая часть — фиксированное содержимое: описание роли, бизнес-контекст, правила написания, примеры статей, термины и справочные материалы. Вторая часть — динамическое содержимое: новостные материалы за текущий день, заголовок статьи и конкретные требования пользователя.
Prompt Caching переиспользует первую часть — то есть посимвольно (по токенам) совпадающий префикс. Для попадания в кеш последовательность токенов должна совпадать полностью; близкий по смыслу текст попаданием не считается. Измените одну формулировку, поменяйте порядок абзацев или переставьте определения инструментов — и префикс станет новым содержимым, а кеш перестанет действовать.
Поэтому у оптимизации кеша есть базовый принцип: стабильное содержимое — в начало, изменяющееся — в конец.
1.2 Какие именно расходы экономит Prompt Caching
Счёт за один вызов можно разбить на пять статей, и только стоимость фиксированного префикса кеш меняет:
| Статья расходов | Без кеша | С включённым кешем |
|---|---|---|
| Фиксированный префикс | Каждый раз по цене обычного ввода | Первый раз по цене записи, при попадании — по цене чтения |
| Динамический ввод | Цена обычного ввода | Цена обычного ввода, без изменений |
| Вывод модели | Цена вывода | Цена вывода, без изменений |
| Расходы на инструменты | По правилам инструментов | По правилам инструментов, без изменений |
| Явное кеш-хранилище (Gemini) | Нет | Отдельно по времени хранения |
Эта таблица показывает ключевое различие: процент экономии на фиксированном префиксе и процент экономии по всему счёту — два разных показателя. Первый измеряет снижение только по кешируемой части, второй — по всему счёту. Чем длиннее вывод, тем ниже второй показатель.
2. Чем различаются правила Prompt Caching у GPT, Claude и Gemini?
2.1 OpenAI Prompt Caching: 30 минут и 12 часов
В документации OpenAI для GPT-5.6 и последующих моделей указано: минимальная длина кэшируемого префикса обычно составляет 1 024 видимых входных токена, поддерживаются два режима — неявный (implicit) и явный (explicit). В явном режиме разработчик помечает prompt_cache_breakpoint в подходящем блоке содержимого сообщения, явно задавая границу кэшируемого префикса.
По умолчанию TTL составляет 30 минут; в Responses API можно выбрать время жизни минимум 12 часов через prompt_cache_options.ttl = "12h". Тарификация делится на запись и чтение:
- Запись на 30 минут: 1,25× от обычного ввода
- Запись на 12 часов: 2,5× от обычного ввода
- Чтение из кэша: для большинства новых моделей 0,1× от обычного ввода, а для GPT-6.1 Sol и GPT-6.1 Terra — 0,05×
prompt_cache_key позволяет разделять биллинг кэша по разным пользователям или рабочим пространствам. В GPT-5.6 и последующих моделях маршрутизацией кэша уже автоматически управляет сам провайдер.
2.2 Кэширование промптов Claude: 5 минут и 1 час
Claude поддерживает автоматическое или явное кэширование через cache_control. По умолчанию срок действия — 5 минут, и каждое попадание в кэш продлевает этот срок. Отсчёт 5 минут начинается с момента записи в кэш или запроса на чтение, причём время генерации ответа тоже входит в этот интервал. Поэтому в задачах с длинным выводом реальный доступный промежуток получается короче 5 минут.
Коэффициенты тарификации: запись на 5 минут — 1.25×, запись на 1 час — 2×, обычное чтение — 0.1×. У Claude Sonnet 5.5 и Claude Opus 5.5 ставка за чтение снижена до 0.05×. Стандартная цена Sonnet 5.5: ввод — $2, запись на 5 минут — $2.50, запись на 1 час — $4, чтение — $0.10, вывод — $10 (все цены указаны в долларах за миллион токенов).
2.3 Кэширование контекста Gemini: неявное и явное
Gemini 2.5 и более новые модели по умолчанию используют неявное кэширование, дополнительная настройка не нужна. Минимальные требования к входным данным зависят от модели: для Gemini 3.8 Flash — 4 096 токенов, для Gemini 2.5 Flash и 2.5 Pro — 2 048 токенов. Google рекомендует помещать общий контент в начало промпта и в течение короткого времени повторно использовать один и тот же префикс.
Явное кэширование требует, чтобы разработчик сам создал объект кэша и задал время его жизни. Стоимость складывается из трёх частей: содержимого кэша, последующих чтений и времени хранения. Gemini Interactions API сейчас поддерживает только неявное кэширование; если нужен объект явного кэша, используйте generateContent API.
Цены Gemini 3.8 Flash по состоянию на 31 декабря 2026 года: ввод — $0.75, вывод — $3.75, чтение кэша — $0.075, хранение явного кэша — $0.50 за миллион токенов в час. Официально планируется с 1 января 2027 года установить цены на уровне $1.50, $7.50, $0.15 и $1.00. Все четыре цены увеличиваются вдвое, поэтому рассчитанные ниже пропорции экономии не меняются, а абсолютные суммы удваиваются.
2.4 Сравнение правил Prompt Caching у трёх провайдеров
| Критерий | OpenAI | Claude | Gemini |
|---|---|---|---|
| Способ кэширования | Неявное / явные контрольные точки | cache_control — автоматически / явно |
Неявное (по умолчанию) / явный объект кэша |
| TTL по умолчанию | 30 минут (минимальное время жизни) | 5 минут, продлевается при попадании в кэш | Неявное управляется системой; для явного задаётся вручную |
| Опция длинного TTL | 12 часов (Responses API) | 1 час | Настраивается для явного кэша |
| Тариф записи | 30 мин: ×1.25; 12 ч: ×2.5 | 5 мин: ×1.25; 1 ч: ×2 | При неявном кэшировании первое обращение считается как обычный ввод |
| Тариф чтения | ×0.1 (для Sol / Terra — ×0.05) | ×0.1 (для Sonnet / Opus 5.5 — ×0.05) | 3.8 Flash: $0.075 / MTok |
| Дополнительные расходы | Платы за хранение нет | Платы за хранение нет | За явный кэш взимается почасовая плата за хранение |
| Минимальный префикс | Обычно 1 024 токена | По официальной документации | 3.8 Flash: 4 096 токенов |
3. Сто вызовов в день — сколько на самом деле экономит Prompt Caching?
3.1. Единые условия расчёта
Ниже — теоретический расчёт по официальным ценам, а не реальные счета пользователей. Допущения везде одинаковые:
- Фиксированный префикс — 20,000 токенов на каждый вызов, динамический ввод — 500 токенов, вывод — 1,000 токенов
- 100 вызовов в день, всегда одна и та же модель
- Весь динамический контент идёт после стабильного префикса
- Сценарий с кэшем: первый вызов записывает, следующие 99 полностью попадают в кэш; все вызовы выполняются в пределах TTL, либо при попадании срок действия постоянно продлевается
- Сторонние наценки, пакетные скидки и плату за инструменты не учитываем
- Префикс в 20K не запускает дополнительную плату за длинный контекст GPT-6 Astra при превышении 272K токенов
Формула расчёта везде одна:
Стоимость одной позиции = количество токенов × число вызовов ÷ 1,000,000 × цена за единицу (USD / MTok)
Стоимость префикса после кэширования = 20,000 × 1 ÷ 1,000,000 × цена записи + 20,000 × 99 ÷ 1,000,000 × цена чтения
3.2 Полная формула для GPT-6 Astra
Цена GPT-6 Astra: обычный ввод — $10, вывод — $50, запись в 30-минутный кеш — $12.50, чтение из кеша — $1.
Без кеша:
- Фиксированный префикс: 20,000 × 100 ÷ 1,000,000 × $10 = $20
- Динамический ввод: 500 × 100 ÷ 1,000,000 × $10 = $0.50
- Вывод: 1,000 × 100 ÷ 1,000,000 × $50 = $5
- Итого за день: $25.50
30-минутный кеш:
- Первая запись: 20,000 ÷ 1,000,000 × $12.50 = $0.25
- 99 чтений: 20,000 × 99 ÷ 1,000,000 × $1 = $1.98
- Динамический ввод: $0.50; вывод: $5
- Итого за день: $7.73
Экономия по полному счёту — $17.77, около 69.69%. Фиксированный префикс снижается с $20 до $2.23, экономия около 88.85%.
3.3 GPT-6.1 Sol, Claude Sonnet 5.5 и Gemini 3.8 Flash
GPT-6.1 Sol (ввод $2, вывод $10, запись в 30-минутный кеш $2.50, чтение $0.10):
- Без кеша: префикс $4 + динамический ввод $0.10 + вывод $1 = $5.10
- С кешем: запись $0.05 + чтение $0.198 + динамический ввод $0.10 + вывод $1 = $1.348
- Экономия $3.752, около 73.57%; префикс снижается с $4 до $0.248, экономия около 93.8%
У Claude Sonnet 5.5 (5-минутный кеш) цена за единицу такая же, как у GPT-6.1 Sol, а расчёт и результат совпадают: $5.10 снижается до $1.348. Условие — вызовы должны идти с интервалами, не превышающими 5 минут, чтобы кеш оставался действительным.
Gemini 3.8 Flash (неявный кеш; первая запись считается по обычному вводу $0.75):
- Без кеша: префикс $1.50 + динамический ввод $0.0375 + вывод $0.375 = $1.9125
- С кешем: первая запись префикса $0.015 + 99 чтений $0.1485 + динамический ввод $0.0375 + вывод $0.375 = $0.576
- Экономия $1.3365, около 69.88%; префикс снижается с $1.50 до $0.1635, экономия около 89.1%
- Этот результат предполагает, что все запросы попадают в неявный кеш; плата за хранение явного кеша не учитывается
3.4 Prompt Caching: разница между долей экономии и абсолютной суммой
| Модель | Без кэша / день | С кэшем / день | Экономия в день | Экономия за 30 дней (экстраполяция) | Доля экономии на префиксе | Доля экономии по всему счёту |
|---|---|---|---|---|---|---|
| GPT-6 Astra | $25.50 | $7.73 | $17.77 | $533.10 | 88.85% | 69.69% |
| GPT-6.1 Sol | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Claude Sonnet 5.5 | $5.10 | $1.348 | $3.752 | $112.56 | 93.8% | 73.57% |
| Gemini 3.8 Flash | $1.9125 | $0.576 | $1.3365 | $40.10 | 89.1% | 69.88% |
Из таблицы видны два момента:
- Проценты отражают скидку на чтение. У GPT-6.1 Sol и Claude Sonnet 5.5 цена чтения составляет 0,05 от цены обычного ввода, доля экономии на префиксе достигает 93,8% — выше, чем у Astra и Gemini, где чтение стоит 0,1 от обычного ввода.
- Сумма зависит от базовой цены. У Astra доля экономии самая низкая, но экономия составляет $17.77 в день — более чем в 13 раз больше, чем у Gemini 3.8 Flash. Чем выше цена модели, тем больше абсолютная выгода от включения кэширования.
После включения кэширования доля вывода в счёте GPT-6 Astra выросла примерно с 20% до 65% ($5 ÷ $7.73). Теперь дальнейшее снижение затрат смещается к контролю длины вывода. Обратите внимание: одинаковое количество токенов у четырёх моделей используется только для удобства сравнения. При выполнении одной и той же задачи реальная длина вывода и точность у моделей различаются.
💡 Рекомендация по выбору: при близких процентах в первую очередь смотрите на баланс между абсолютной ежедневной экономией и качеством выполнения задачи. Советую сначала в APIYI apiyi.com вызвать несколько моделей-кандидатов с одним и тем же шаблоном, записать реальную длину вывода и токены из кэша, а затем подставить их в формулу выше и оценить месячный бюджет.
4. Почему при ежедневном повторении одного и того же промпта счёт за кэширование промптов всё равно может быть высоким?
4.1 TTL и частота вызовов определяют долю попаданий в кэш
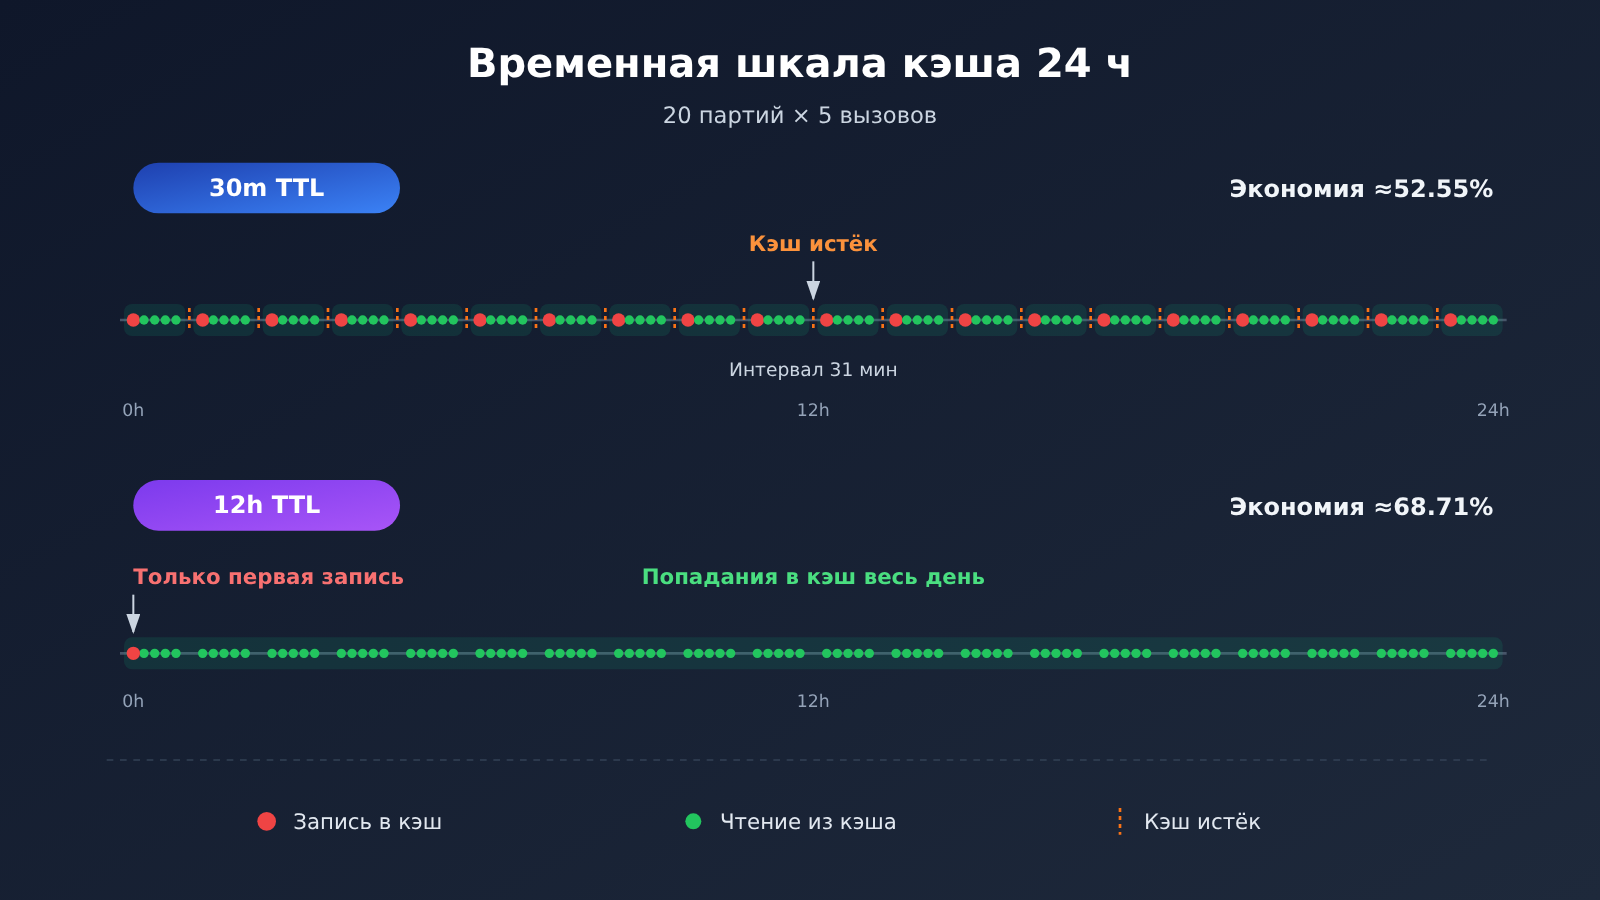
100 вызовов в день не означают, что одна запись покроет весь день. Ниже пример с GPT-6 Astra: 20 партий в день, по 5 последовательных вызовов в каждой, интервал между партиями — 31 минута.
| Сценарий | Количество записей и стоимость | Количество чтений и стоимость | Стоимость префикса | Плюс динамический ввод и вывод | Итого в день | Экономия |
|---|---|---|---|---|---|---|
| Без кэша | — | — | $20 | $5.50 | $25.50 | — |
| A: кэш 30m | 20 × $0.25 = $5 | 80 × $0.02 = $1.60 | $6.60 | $5.50 | $12.10 | ок. 52.55% |
| B: кэш 12h (в пределах одного окна) | 1 × $0.50 | 99 × $0.02 = $1.98 | $2.48 | $5.50 | $7.98 | ок. 68.71% |
В сценарии A интервал между партиями превышает 30 минут, поэтому каждую партию приходится записывать заново, и экономия падает с идеальных 69.69% до 52.55%. В сценарии B одна запись стоит вдвое дороже, чем при 30m, но за весь день выполняется только одна запись, поэтому для разрозненных вызовов это выгоднее. Схема 12h покрывает только одно окно; гарантии, что на следующий день можно будет повторно использовать тот же кэш, нет. В задачах с одним-двумя вызовами в день один и тот же промпт сам по себе не обеспечивает межсуточное кэширование.
Точку безубыточности для разных TTL можно считать только по стабильному префиксу, принимая обычный ввод за 1×:
| Схема | Множитель записи | Множитель чтения | Запись 1 + чтение 1 против 2 вызовов без кэша | Запись 1 + чтение 2 против 3 вызовов без кэша | Сколько эффективных чтений нужно для окупаемости |
|---|---|---|---|---|---|
| OpenAI 30m | 1.25 | 0.1 | 1.35 < 2 | — | 1 раз |
| OpenAI 12h | 2.5 | 0.1 | 2.6 > 2 | 2.7 < 3 | 2 раза |
| Claude Sonnet 5.5 · 5m | 1.25 | 0.05 | 1.30 < 2 | — | 1 раз |
| Claude Sonnet 5.5 · 1h | 2 | 0.05 | 2.05 > 2 | 2.10 < 3 | 2 раза |
Вывод простой: при коротком TTL достаточно одного попадания, чтобы окупиться; длинному TTL нужно как минимум два попадания в течение срока действия.
4.2 Точки останова кэша и порядок промптов
Самая частая причина промаха кэша — изменение стабильного префикса. Если ставить метку времени, ID пользователя, заголовок задачи или актуальные материалы в начало промпта, префикс каждого запроса будет становиться новым содержимым, и кэш никогда не сработает.
В неявном режиме OpenAI, если первый запрос захватывает динамическое содержимое в область кэширования, то при последующем изменении динамического содержимого можно не попасть в нужный стабильный префикс. Решение — установить явную точку останова кэша в конце стабильного содержимого.
Другие частые причины:
- переключили модель, провайдера, организацию обслуживания или изменили часть параметров
- агент сжимает диалог, переупорядочивает определения инструментов, изменяет историю сообщений — и переиспользуемый префикс переписывается
- сторонний шлюз не передаёт параметры кэширования или не учитывает скидку за кэш в счёте
4.3 Влияние выходных токенов и расходов на инструменты
Кэш действует только на входной префикс. В примере расчёта Astra из 3.2, даже если стоимость префикса упадёт до нуля, счёт не будет ниже $5.50 (динамический ввод плюс вывод). У задач с длинным выводом и большим числом вызовов инструментов снижение полного счёта будет заметно меньше, чем процент экономии на префиксе. Поэтому после включения кэширования нужно ещё контролировать длину вывода и сокращать вызовы инструментов.
5 Как в AI-приложениях настраивать Prompt Caching и отслеживать его?
5.1 Как организовать стабильный префикс и динамический суффикс
Располагайте содержимое в порядке «от низкой частоты изменений к высокой»:
- Определения инструментов: фиксированный порядок и фиксированные описания, не добавляйте и не удаляйте их динамически от запроса к запросу
- Системные правила и стандарты написания: описание роли, брендовые правила, требования к стилю
- Образцы текстов и база знаний: большие справочные документы, при обновлении версии заменяются целиком
- (Точка разрыва кэша)
- Динамические материалы: новости за сегодня, результаты поиска, пользовательский ввод
- Текущие инструкции задачи: заголовок, объём в словах, конкретные требования
В примере ниже вызов выполняется через OpenAI-совместимый интерфейс, а из ответа читается количество кэшированных токенов:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

STABLE_PREFIX = """你是一名技术博客作者……(写作规范、范文、术语表,约 20K Token,内容逐字固定)"""

resp = client.chat.completions.create(
    model="gpt-6.1-sol",  # ориентируйтесь на фактическое название в списке моделей платформы
    messages=[
        {"role": "system", "content": STABLE_PREFIX},          # стабильный префикс помещаем в самое начало
        {"role": "user", "content": "今日材料:……\n标题:……"},  # динамический контент — после него
    ],
)
details = getattr(resp.usage, "prompt_tokens_details", None)
cached = getattr(details, "cached_tokens", 0) or 0
print(f"输入 {resp.usage.prompt_tokens},命中缓存 {cached}")
Посмотреть полный код: калькулятор затрат + статистика попаданий в кэш
from openai import OpenAI

M = 1_000_000

def daily_cost(prefix, dynamic, output, calls,
               p_in, p_out, p_write, p_read,
               writes=1, use_cache=True):
    """Считает дневную стоимость по официальным ценам за единицу (в долларах), возвращает (префикс, динамический вход, выход, итого)"""
    dyn = dynamic * calls / M * p_in
    out = output * calls / M * p_out
    if use_cache:
        pre = prefix * writes / M * p_write + prefix * (calls - writes) / M * p_read
    else:
        pre = prefix * calls / M * p_in
    return round(pre, 4), round(dyn, 4), round(out, 4), round(pre + dyn + out, 4)

MODELS = {
    # Название: (вход, выход, запись, чтение)  доллары / миллион токенов, дата проверки 2026-11-13
    "GPT-6 Astra (30m)":   (10,   50,   12.5, 1),
    "GPT-6.1 Sol (30m)":   (2,    10,   2.5,  0.10),
    "Claude Sonnet 5.5":   (2,    10,   2.5,  0.10),
    "Gemini 3.8 Flash":    (0.75, 3.75, 0.75, 0.075),  # при неявном кэше первый раз считается как обычный вход
}

for name, (p_in, p_out, p_w, p_r) in MODELS.items():
    base = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r, use_cache=False)[-1]
    cached = daily_cost(20000, 500, 1000, 100, p_in, p_out, p_w, p_r)[-1]
    print(f"{name}: ${base} -> ${cached},节省 {(base - cached) / base:.2%}")

# Сценарий A: Astra 30m, 20 пакетов, каждый требует повторной записи
a = daily_cost(20000, 500, 1000, 100, 10, 50, 12.5, 1, writes=20)[-1]
print(f"Astra 分批 30m: ${a}")  # 12.1

# ---- Статистика попаданий в кэш в реальной работе ----
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

def run_and_track(stable_prefix, dynamic_inputs, model="gpt-6.1-sol"):
    total_in = total_cached = 0
    for text in dynamic_inputs:
        r = client.chat.completions.create(
            model=model,
            messages=[{"role": "system", "content": stable_prefix},
                      {"role": "user", "content": text}],
        )
        d = getattr(r.usage, "prompt_tokens_details", None)
        total_in += r.usage.prompt_tokens
        total_cached += (getattr(d, "cached_tokens", 0) or 0)
    hit = total_cached / total_in if total_in else 0
    print(f"实际缓存命中率:{hit:.2%}")
    return hit
🚀 Совет для быстрого старта: сначала прикиньте бюджет с помощью калькулятора выше, а потом прогоните реальный шаблон на 10–20 вызовах и посмотрите, начинает ли
cached_tokensстабильно появляться со второго раза. Новички могут получить бесплатный тестовый лимит на APIYI apiyi.com и пройти эту проверку — а когда попадания подтвердятся, можно запускать в большом объёме.
5.2 Выбор TTL и режима кэширования Prompt Caching
- Частые последовательные вызовы (со стабильным интервалом в несколько минут): используйте короткий TTL по умолчанию — 30m у OpenAI, 5m у Claude. Одного попадания в кэш достаточно, чтобы окупить затраты, а надбавка за запись при этом минимальна. У Claude нужно учитывать длительность генерации ответа в 5-минутном окне.
- Вызовы, распределённые по всему дню (интервал между пакетами больше 30 минут): присмотритесь к 12h у OpenAI или 1h у Claude. Если в пределах окна удаётся попасть в кэш дважды и больше, длинный TTL выходит дешевле повторных записей — как раз сценарий B из раздела 4.1.
- Задачи Gemini с очень длинным префиксом, которые нужно переиспользовать на протяжении длительного времени: оцените явное кэширование, учитывая при этом плату за хранение. Для примера возьмём Gemini 3.8 Flash: хранение 20K Token в течение 12 часов стоит 0.02 × $0.50 × 12 = $0.12. При рабочей нагрузке из этой статьи такая сумма уже довольно заметна на фоне дневного счёта в $0.576. Если неявное кэширование срабатывает хорошо, оставьте настройки по умолчанию.
- Префикс часто меняется: сначала стабилизируйте префикс, а уже потом думайте о TTL. Пока префикс нестабилен, никакой TTL не обеспечит попаданий.
5.3 Как проверить реальную долю попаданий в кэш и биллинг Prompt Caching
Поля usage у трёх провайдеров выглядят так:
- OpenAI (Responses API):
usage.input_tokens,usage.input_tokens_details.cached_tokens,usage.input_tokens_details.cache_write_tokens - Claude:
usage.input_tokens,usage.cache_creation_input_tokens,usage.cache_read_input_tokens - Gemini: соответствующие поля usage в API, например
total_cached_tokens; явное кэширование оплачивается отдельно по стоимости объектного хранилища
Рекомендую постоянно отслеживать два показателя:
Фактическая доля попаданий в кэш = Токены чтения кэша ÷ Всего входных токенов
Фактическая экономия             = Базовая стоимость без кэша − Фактическая стоимость по счёту API
Базовую стоимость без кэша нужно считать для той же модели, той же рабочей нагрузки и того же объёма вывода, иначе сумма экономии будет несопоставимой. Когда проверяете счёт в консоли APIYI apiyi.com, можно построчно сопоставить сводку usage за тот же период с детализацией списаний и убедиться, что токены кэша тарифицируются по цене кэша.
6 Сценарии APIYI: как с помощью Prompt Caching контролировать расходы при фиксированных шаблонах и массовом AI-производстве?
Типичные задачи, для которых подходит Prompt Caching: AI-платформы для написания текстов, каждый день работающие с одним и тем же шаблоном статьи; агенты, многократно загружающие одно и то же определение инструментов; системы анализа документов, которые много раз ссылаются на один и тот же большой справочный документ; массовая генерация контента с общими бренд-гайдлайнами и описанием стиля. У всех таких задач есть общее: длинный префикс, высокая повторяемость, большой объём вызовов — то есть именно та зона, где выгода от кэша максимальна.
При принятии решений о затратах в таких сценариях можно опираться на три критерия:
- Поддерживает ли модель нужные возможности кэширования. Включая минимальную длину префикса, допустимый TTL и кратность скидки на чтение. Модели с коэффициентом чтения 0.05 дают более высокую экономию на префиксе в задачах с длинным префиксом.
- Соответствуют ли промпты и TTL рабочей нагрузке. Для непрерывной пакетной обработки — короткий TTL; для задач, распределённых по расписанию, оцените длинный TTL и рассчитайте по формуле из раздела 4.1, через сколько использований затраты окупятся.
- Полностью ли поставщик API поддерживает кэширование и тарифицирует по фактической стоимости кэша. Поддержка кэша у провайдера — лишь одно из необходимых условий снижения затрат. Шлюзу ещё нужно корректно передавать параметры кэширования, отражать токены кэша в usage и показывать цену кэша в списаниях.
При вызове через APIYI apiyi.com рекомендую закрепить пункт 3 как обязательный шаг приёмки: несколько раз подряд вызвать модель с одним и тем же 20K-шаблоном, проверить поля кэша в usage, а затем сверять со списаниями в счёте. После того как подтверждены и технические попадания, и фактическое начисление в биллинге, можно использовать результаты расчётов выше как основу для месячного бюджета.
Частые вопросы (FAQ)
Вопрос 1: Что такое Prompt Caching?
Эта технология кэширует уже обработанный одинаковый префикс промпта, и при попадании в кэш последующие запросы тарифицируются намного дешевле обычного ввода. Для совпадения требуется побайтовое (по токенам) равенство — поэтому подход хорошо подходит для сценариев с фиксированным шаблоном, фиксированной базой знаний и фиксированным описанием инструментов.
Вопрос 2: Почему префикс экономит более 90%, а весь счёт — только около 70%?
Кэш действует только на фиксированный префикс, а динамический ввод и вывод по-прежнему тарифицируются по полной цене. На примере GPT-6.1 Sol: в дневном счёте $1.348 после кэширования вывод занимает $1, а динамический ввод — $0.10. Чем длиннее вывод, тем ниже доля экономии по всему счёту.
Вопрос 3: Если вызывать всего раз-два в день, стоит ли включать кэш?
Выгода минимальна. И OpenAI с TTL 12h, и Claude с TTL 1h требуют как минимум двух попаданий в течение срока действия, чтобы окупиться, а гарантий повторного использования на следующий день нет. Полезнее собрать однотипные задачи в один временной интервал и выполнять их пакетно — так вы увеличите число попаданий внутри окна.
Вопрос 4: Выбрать 30m или 12h?
Смотрите на интервал между вызовами. Если интервал стабильно укладывается в 30 минут — используйте 30m, достаточно одного попадания для окупаемости. Если пачки вызовов разделены более длинными промежутками и распределены по всему дню — используйте 12h. На примере GPT-6 Astra с 20 пакетами вызовов: дневная стоимость с 12h — $7.98, с 30m — $12.10.
Вопрос 5: Если вызывать через агрегатор API, кэш всё ещё работает?
Это зависит от того, как платформа передаёт параметры кэширования и как реализует тарификацию. Рекомендую в APIYI apiyi.com с бесплатным тестовым лимитом несколько раз подряд вызвать один и тот же шаблон, проверить поля вроде `cached_tokens` в usage и сверять их с детализацией списаний. Убедившись, что кэш и попадает, и тарифицируется по цене кэша, переходите к пакетному использованию.
Вопрос 6: Резко упал процент попаданий в кэш — с чего начать проверку?
Проверяйте по порядку: не попали ли в префикс динамические данные вроде временных меток и ID; не изменился ли порядок описания инструментов; не сжимал ли или не переписывал ли историю сообщений агент; не сменилась ли модель или параметры; не превысил ли интервал между вызовами TTL. Если считать процент попаданий по формуле из раздела 5.3 по часам, можно быстро определить момент, когда произошло изменение.
Вопрос 7: Как выбрать между неявным и явным кэшированием Gemini?
Неявное кэширование включено по умолчанию, платы за хранение нет, и оно используется в первую очередь, когда префикс превышает минимальную длину для модели (для 3.8 Flash — 4 096 токенов). Явное кэширование подходит для очень длинного контента, который нужно детерминированно переиспользовать, но требует почасовой платы за хранение и использования generateContent API. Interactions API сейчас поддерживает только неявное кэширование.
Итоги
Ключевые моменты Prompt Caching:
- Где экономия: снижается только стоимость фиксированного префикса. При нагрузке из этой статьи экономия на префиксе составила 88,85%–93,8%, а по полному счёту — 69,69%–73,57%.
- Сколько экономится: GPT-6.1 Sol и Claude Sonnet 5.5 — с $5.10 до $1.348 в день, GPT-6 Astra — с $25.50 до $7.73. Чем выше цена за токен, тем больше абсолютная экономия.
- Какая частота выгоднее всего: частые, последовательные вызовы с длинным префиксом. При коротком TTL достаточно одного попадания в кэш, чтобы окупиться, при длинном нужно два.
- Как внедрить: стабильный контент — в начале, динамический — в конце, а точку разрыва ставьте на границе стабильной части; выбирайте TTL под ритм вызовов; постоянно отслеживайте долю попаданий в кэш через поле usage.
- Когда это работает: кэш должен не только технически срабатывать, но и тарифицироваться по цене кэша.
Рекомендую сначала посчитать бюджет в калькуляторе из статьи, затем на APIYI apiyi.com проверить на реальном шаблоне долю попаданий и списание средств — и только когда оба пункта подтвердятся, масштабировать.
📚 Справочные материалы
- Руководство OpenAI по кэшированию промптов: режимы кэширования, контрольные точки, TTL и коэффициенты оплаты
- Ссылка:
developers.openai.com/api/docs/guides/prompt-caching -
Описание: параметры
prompt_cache_optionsиprompt_cache_breakpoint -
Модели и тарифы OpenAI: стоимость GPT-6 Astra и GPT-6.1 Sol
- Ссылка:
developers.openai.com/api/docs/pricing - Ссылка:
developers.openai.com/api/docs/models/gpt-6-astra - Ссылка:
developers.openai.com/api/docs/models/gpt-6.1-sol -
Описание: стандартные тарифы для короткого контекста, дата проверки — 2026-11-13
-
Документация Claude Prompt Caching:
cache_control, множители записи и чтения для 5m / 1h - Ссылка:
platform.claude.com/docs/en/build-with-claude/prompt-caching - Ссылка:
platform.claude.com/docs/en/models/sonnet-5-5/overview -
Описание: чтение кэша Sonnet 5.5 по коэффициенту 0.05 от тарифа
-
Контекстное кэширование и тарифы Gemini: неявное / явное кэширование, плата за хранение и пересмотр цен в 2027 году
- Ссылка:
ai.google.dev/gemini-api/docs/caching - Ссылка:
ai.google.dev/gemini-api/docs/pricing - Описание: минимальная длина кэша для каждой модели и поддерживаемые API
Автор: техническая команда APIYI
По техническим вопросам: пишите нам — контакты есть на главной странице официального сайта APIYI. Больше материалов по интеграции ищите в центре документации docs.apiyi.com


