
Вывод: сколько стоит API для статьи, написанной с помощью AI, — сначала вызовы, потом готовый материал
По ценовому срезу из этой статьи при вводе 10 000 и выводе 3 000 токенов теоретическая стоимость одной генерации составляет примерно 0.0066–0.10 доллара США. Чтобы получить готовую к публикации статью, нужно ещё сложить расходы на правки, проверку, вызовы инструментов и ручную редактуру.
По-настоящему сравнивать стоит «стоимость одной качественной статьи». В этой статье 7 моделей сравниваются при одинаковом объёме ввода и вывода, а затем объясняется, как канал доступа, кеширование, рассуждения и число раундов правок меняют счёт.
Что будет дальше: как считать стоимость API для статьи с помощью AI
- Разберёмся, как работают ввод, вывод и формула тарификации.
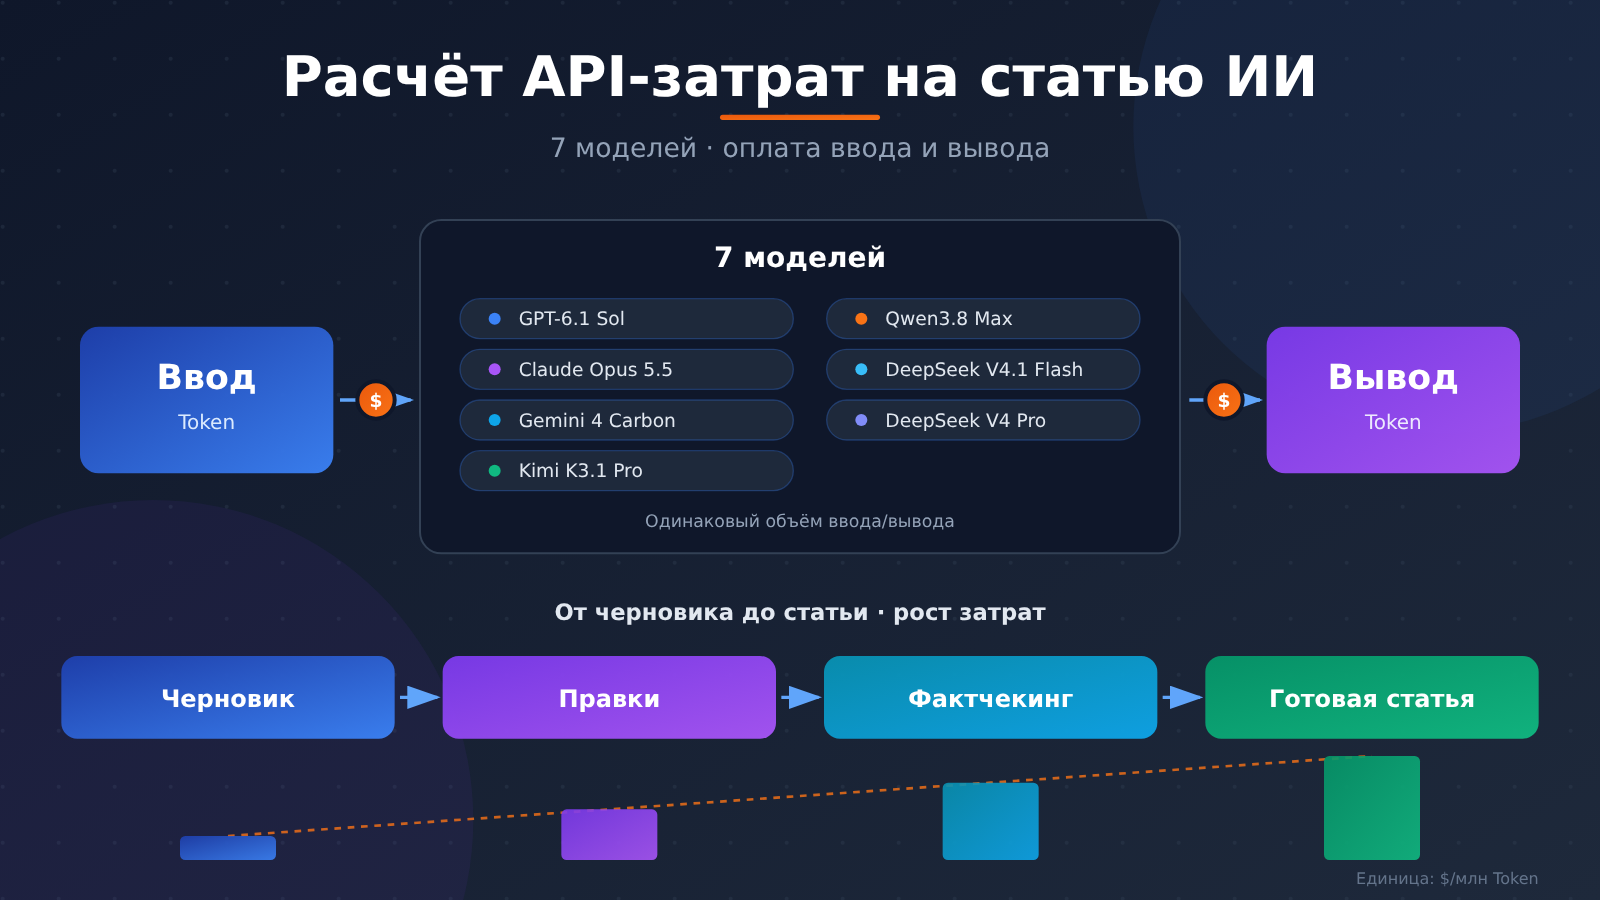
- Сравним расходы 7 моделей при трёх объёмах задачи.
- Отделим цену на платформе от официальной региональной цены и правил тарификации по времени.
- По журналу вызовов и времени на редактуру выберем схему производства.
Совет для быстрого старта: тот же пакет материалов можно проверить через единый интерфейс APIYI на apiyi.com. У новых пользователей есть бесплатный тестовый лимит; конкретный размер и правила применения — по актуальному описанию платформы.
Затраты на API в статье об AI: сначала определимся с единицами измерения
Token — это единица измерения текста в API, и фиксированного соотношения с количеством китайских символов у неё нет. Пакет материалов, промпты, план статьи и отправленная история диалога — всё это занимает входные токены.
Цены на входные и выходные токены обычно указывают в формате «долларов за миллион токенов». Во всех расчётах ниже используются обычные цены за вход и выход — без кэширования, дополнительных рассуждений, скидок за объём и платы за инструменты.
Формула расчёта:
$$
C=\frac{T_{\text{входные}}}{1{,}000{,}000}P_{\text{входные}}
+\frac{T_{\text{выходные}}}{1{,}000{,}000}P_{\text{выходные}}
$$
Возьмём GPT-6.1 Sol: 10 000 токенов на входе и 3000 на выходе:
$$
C=0.01\times2+0.003\times10=0.05\text{ долл. США}
$$
Эти деньги оплачивают одну генерацию. Можно ли публиковать статью сразу — зависит от того, соответствуют ли факты, структура и стиль требованиям. Счёт за API не подпишет решение за редактора.
Затраты на API для ИИ-статей: сравнение цен ввода и вывода у 7 моделей
В таблице ниже — снимок цен APIYI apiyi.com на 12 ноября 2026 года, 10:45 (UTC+8). Единицы — доллары за миллион токенов, режим тарификации — по объёму токенов.
| Модель | Цена ввода | Цена вывода | Отношение цены вывода к вводу |
|---|---|---|---|
| GPT-6.1 Sol | 2.00 | 10.00 | ×5 |
| Claude Opus 5.5 | 4.00 | 20.00 | ×5 |
| Gemini 4 Carbon | 2.00 | 10.00 | ×5 |
| Kimi K3.1 Pro | 2.00 | 10.00 | ×5 |
| Qwen3.8 Max | 1.65 | 4.95 | ×3 |
| DeepSeek V4.1 Flash | 0.30 | 1.20 | ×4 |
| DeepSeek V4 Pro | 1.32 | 3.96 | ×3 |
| Параметр сравнения | Как подключиться |
|---|---|
| Доступные платформы | APIYI apiyi.com; официальные API вендоров — регион и правила тарификации нужно проверять отдельно |
Выходные токены обычно дороже, но когда пакет материалов очень длинный, расходы на ввод тоже становятся основной статьёй. Поэтому при выборе модели смотрите на обе колонки цен, а не только на длину статьи.
Затраты на API для ИИ-статей: в чём разница цен при прямом подключении к официальным API?
Ниже — правила прямого подключения к официальным API, проверенные по состоянию на 12 ноября 2026 года. Они нужны, чтобы сверять различия между каналами, и не подставляются в таблицу цен платформы выше.
| Модель / канал | Официальная цена или правило |
|---|---|
| GPT-6.1 Sol, Standard | ввод 2, вывод 10 |
| Claude Opus 5.5, стандартный вызов | ввод 4, вывод 20 |
| Gemini 4 Carbon, стандартный вызов | в период ознакомительных цен до 30 ноября — ввод 2, вывод 10; с 1 декабря — ввод 4, вывод 20 |
| Qwen3.8 Max, Пекин / Global в Вирджинии, США | ввод 1.65, вывод 4.951 |
| Qwen3.8 Max, Сингапур / International | ввод 2, вывод 6 |
| Kimi K3.1 Pro, Alibaba Cloud Пекин / Сингапур | соответственно 1.837 / 9.611 и 2 / 10 |
| DeepSeek, обе модели | цены в часы пик совпадают со значениями из таблицы выше, вне часов пик — вдвое ниже |
Изменение цен Gemini действует для прямого подключения к официальному API Google, а сторонним каналам стоит искать собственные объявления. Цену вывода Qwen на платформе — 4.95 — и официальную цену в части регионов — 4.951 — тоже лучше держать раздельно.
Официальные часы пик у DeepSeek — по рабочим дням с 09:00 до 12:00 и с 14:00 до 18:00 по пекинскому времени; в остальные часы и по выходным действуют правила непикового периода, а официальные праздники считаются отдельно.
По официальным непиковым ценам: Flash — ввод 0.15, вывод 0.60; Pro — ввод 0.66, вывод 1.98. Выгода от планирования зависит от того, применяет ли эти правила ваш фактический канал.
Стоимость API для статьи об ИИ: как рассчитать по объёму материалов и трём раундам правок?
Сначала сравним два масштаба исходников. Все расчёты ниже — теоретическая симуляция; выходные токены отражают длину в единицах измерения модели, а не количество китайских символов.
| Модель | 50 000 на входе + 5 000 на выходе | 100 000 на входе + 10 000 на выходе | Три раунда суммарно |
|---|---|---|---|
| GPT-6.1 Sol | 0.15000 | 0.30000 | 0.16200 |
| Claude Opus 5.5 | 0.30000 | 0.60000 | 0.32400 |
| Gemini 4 Carbon | 0.15000 | 0.30000 | 0.16200 |
| Kimi K3.1 Pro | 0.15000 | 0.30000 | 0.16200 |
| Qwen3.8 Max | 0.10725 | 0.21450 | 0.10395 |
| DeepSeek V4.1 Flash | 0.02100 | 0.04200 | 0.02160 |
| DeepSeek V4 Pro | 0.08580 | 0.17160 | 0.08316 |
Единица: доллары США. Во всех трёх столбцах использован снимок цен указанной платформы; кэш и прочие расходы не учтены.
Возьмём пример задачи для GPT с 50 000 входных и 5 000 выходных токенов:
$$
C=0.05\times2+0.005\times10=0.15\text{долл. США}
$$
Из них 0.10 долл. США — за вход, 0.05 долл. США — за выход. В задачах с большим объёмом материалов навести порядок во входных данных часто полезнее, чем сжимать пару абзацев текста.
«Три раунда суммарно» считаются по такой схеме отдельных вызовов:
- Черновик: вход 10 000, выход 3 000 токенов.
- Правка: пакет материалов плюс черновик; вход 13 000, выход 3 000 токенов.
- Финальная версия: пакет материалов плюс предыдущая версия; вход 13 000, выход 3 000 токенов.
Итого: 36 000 на входе и 9 000 на выходе. Для GPT стоимость составит:
$$
C=0.036\times2+0.009\times10=0.162\text{долл. США}
$$
Это в 3.24 раза больше стоимости первой генерации. В такой схеме сохраняется только предыдущая версия; если каждый раунд тащить всю историю, входной объём будет расти и дальше.
Следующий график показывает разницу в стоимости на одной и той же задаче. Данные получены по формулам выше; это не результат оценки качества.
API-затраты на AI-статьи: четыре категории расходов, которые легко пропустить
API-затраты на AI-статьи, токены рассуждений и вызовы инструментов
Токены рассуждений — это推理-содержимое, которое некоторые модели генерируют перед ответом. Google явно включает токены推理 Gemini в стоимость вывода, а дополнительные推理 в режиме Qwen Thinking тоже увеличивают затраты.
Инструменты вроде веб-поиска и извлечения страниц могут тарифицироваться отдельно. Нужно отдельно учитывать токены модели и запросы к инструментам, особенно потому что один запрос на написание статьи может запустить несколько поисков.
API-затраты на AI-статьи, кэширование и Batch API
Кэширование промптов снижает часть затрат на ввод за счёт повторного использования одинакового префикса. Объём попаданий, стоимость записи и срок действия определяют, сколько в итоге удастся сэкономить.
Официальная цена кэшированного ввода для GPT-6.1 Sol — 0.10; для Claude Opus 5.5 чтение из кэша — 0.20, запись в кэш на 5 минут и 1 час — 5 и 8 соответственно; единица везде — доллары за миллион токенов.
Batch API используется для асинхронной пакетной обработки. В официальном Batch от Claude и ввод, и вывод получают скидку 50%; официальная цена Batch у Gemini также меняется вслед за корректировкой стандартных цен 1 декабря.
Эти правила нужно сверять по каналу подключения. Например, Kimi K3.1 Pro в Alibaba Cloud не поддерживает Batch Inference; для Qwen Beijing Batch File — 0.825/2.475, максимум контекста 256K.
Главный подход прост: для стабильных наборов материалов сначала оценивайте кэширование, для задач без срочной сдачи — Batch, и учитывайте запись в кэш в общем бюджете.
Стоимость API для статьи об ИИ: фиксируем фактические токены кодом
В примерах ниже используется интерфейс, совместимый с OpenAI. Ключ читается из переменной окружения, чтобы не записывать его прямо в код; доступность моделей и поддержку параметров сверяйте с актуальной документацией.
Минимальный вызов:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)
response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "解释输入和输出Token如何计费。"}],
)
print(response.choices[0].message.content)
Полный пример оценки стоимости обычных токенов:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

response = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[
        {"role": "system", "content": "仅依据提供的资料写作。"},
        {"role": "user", "content": "资料:输入输出分别计费。请写一段说明。"},
    ],
)

usage = response.usage
if usage is None:
    raise RuntimeError("响应未返回Token用量,请核对调用日志。")

input_tokens = usage.prompt_tokens
output_tokens = usage.completion_tokens
estimated_cost = (
    input_tokens * 2.0 + output_tokens * 10.0
) / 1_000_000

print(response.choices[0].message.content)
print(f"输入:{input_tokens},输出:{output_tokens}")
print(f"普通Token理论费用:${estimated_cost:.6f}")
Этот код нужен для оценки стоимости обычных токенов. Детализацию кэша, учёт токенов рассуждений и расходы на инструменты стоит сверять с полями использования у провайдера и логами биллинга.
API-затраты на ИИ-статьи: рекомендации по сценариям и советы по решениям
Если бюджет ограничен, для обычных первых черновиков можно сначала проверить Flash, Pro и Qwen. Для сложных блогов и глубоких материалов добавьте в список кандидатов GPT, Claude и другие, а с помощью времени на редактирование проверьте, оправдывает ли себя более высокая цена.
В англоязычном рейтинге AI Writing Benchmark, обновлённом 11 ноября 2026 года, GPT-6.1 Sol получил общий балл 95.3 и балл в категории статей 98.5 — оба показателя являются базовыми.
Этот бенчмарк позволяет включить GPT в тестирование англоязычных блогов. Китайскоязычные тексты всё ещё нужно проверять отдельно: тест длинных финансовых статей с 26 октября по 3 ноября 2026 года включал всего 26 материалов, а выборка была несбалансированной, поэтому результаты подходят лишь как ориентир для отбора кандидатов.
Рекомендуется стандартизировать пакет материалов, целевой объём и права доступа к инструментам, проводить оценку вслепую — без названий моделей — и фиксировать фактические ошибки, число раундов правок, минуты редактирования и итоговое решение о принятии статьи.
Итоговый расчёт можно вести по формуле:
$$
C_{\text{качественная статья}}
=C_{\text{все вызовы API и сопутствующие расходы}}
+C_{\text{ручная редактура}}
$$
Стоимость ручной работы можно рассчитать как стоимость часа редактирования, умноженную на фактически затраченное время. Если проверка требует дополнительных вызовов API или ручной работы, их также включают в соответствующие статьи затрат, чтобы избежать двойного учёта.
FAQ по API-затратам на ИИ-статьи: как объективно сравнить 7 моделей?
При переключении моделей через APIYI apiyi.com сохраняйте одинаковые материалы, требования к тексту и права доступа к инструментам. Если генерировать несколько раз и фиксировать использование, легче увидеть стабильность и стоимость правок.
FAQ по API-затратам на ИИ-статьи: может ли бесплатный лимит заменить расчёт затрат?
Бесплатный тестовый лимит APIYI apiyi.com подходит для проверки интерфейса и стиля письма. Долгосрочный бюджет всё равно нужно рассчитывать по текущей цене за единицу и фактическому расходу, а скидочные квоты учитывать отдельно.
Заключение: затраты на API при создании статей с ИИ — главное в эффективности производства
Таблица цен нужна для отсева, журналы вызовов — для расчётов, записи о правках — для решений. Сжатие материалов, повторное использование кэша и меньшее число переделок могут оказаться эффективнее, чем погоня за самой низкой ценой за выход.
Рекомендуем проверять подходящие модели через APIYI apiyi.com и в итоге выбирать решение, которое стабильно выдаёт достойные статьи при разумных общих затратах — чтобы у редактора оставалось время на оценку.
Справочные материалы по затратам на API при создании статей с ИИ
- Цены моделей и документация API на APIYI: help.apiyi.com. Снимок цен платформы в этой статье — 12 ноября 2026 г.
- Цены моделей Alibaba Cloud: alibabacloud.com/help/en/model-studio/model-pricing. Используется для сверки региональных цен.
- Официальный анонс Google Gemini: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/.
- AI Writing Benchmark: aiwritingbenchmark.com. В статье используется англоязычный рейтинг по состоянию на 11 ноября 2026 г.
- Тест на длинные аналитические статьи на китайском: omnitools.ai/evals/longform-writing. Ограничения выборки и задач — в основном тексте.
Автор: команда технического контента APIYI. Будем рады обменяться опытом по вызову моделей и расчёту затрат на статьи через apiyi.com.


