
Nota do autor: se o desempenho do modelo que você usa está pior do que o do ranking oficial, não tire conclusões precipitadas. Muitas vezes o nível de raciocínio, a janela de entrada ou o ID do modelo não correspondem ao que foi usado no teste do ranking. Este artigo apresenta a ordem de verificação dessas três coisas; só depois de conferir isso decida se vale trocar de modelo.
Muitos desenvolvedores encontram o mesmo tipo de diferença. O anúncio oficial diz que determinado modelo obteve uma pontuação alta no ranking, mas, ao testá-lo com questões semelhantes, o resultado fica claramente abaixo do esperado. Aí surge a dúvida de que o modelo “ficou mais burro” ou teve a configuração rebaixada. Este artigo traz uma abordagem de diagnóstico mais prática: primeiro alinhe o nível de raciocínio, a janela de entrada e o mesmo ID do modelo, e só então julgue se a diferença realmente existe.
Isto não é uma receita mágica para “ajustar três botões e empatar com o ranking oficial”. As diferenças abaixo vêm inteiramente da documentação pública. Elas só ajudam a confirmar se você está comparando a mesma coisa; não garantem que, após os ajustes, você vai obter a pontuação do ranking, nem significam que a APIYI tenha reproduzido o ranking oficial.
Valor principal: depois de ler este artigo, você saberá a ordem de verificação dessas três coisas e qual documento consultar em cada etapa. Também saberá quais preços e endpoints conferir antes de trocar de modelo, caso a diferença continue existindo após a verificação.
Os pontos centrais quando os benchmarks oficiais não batem
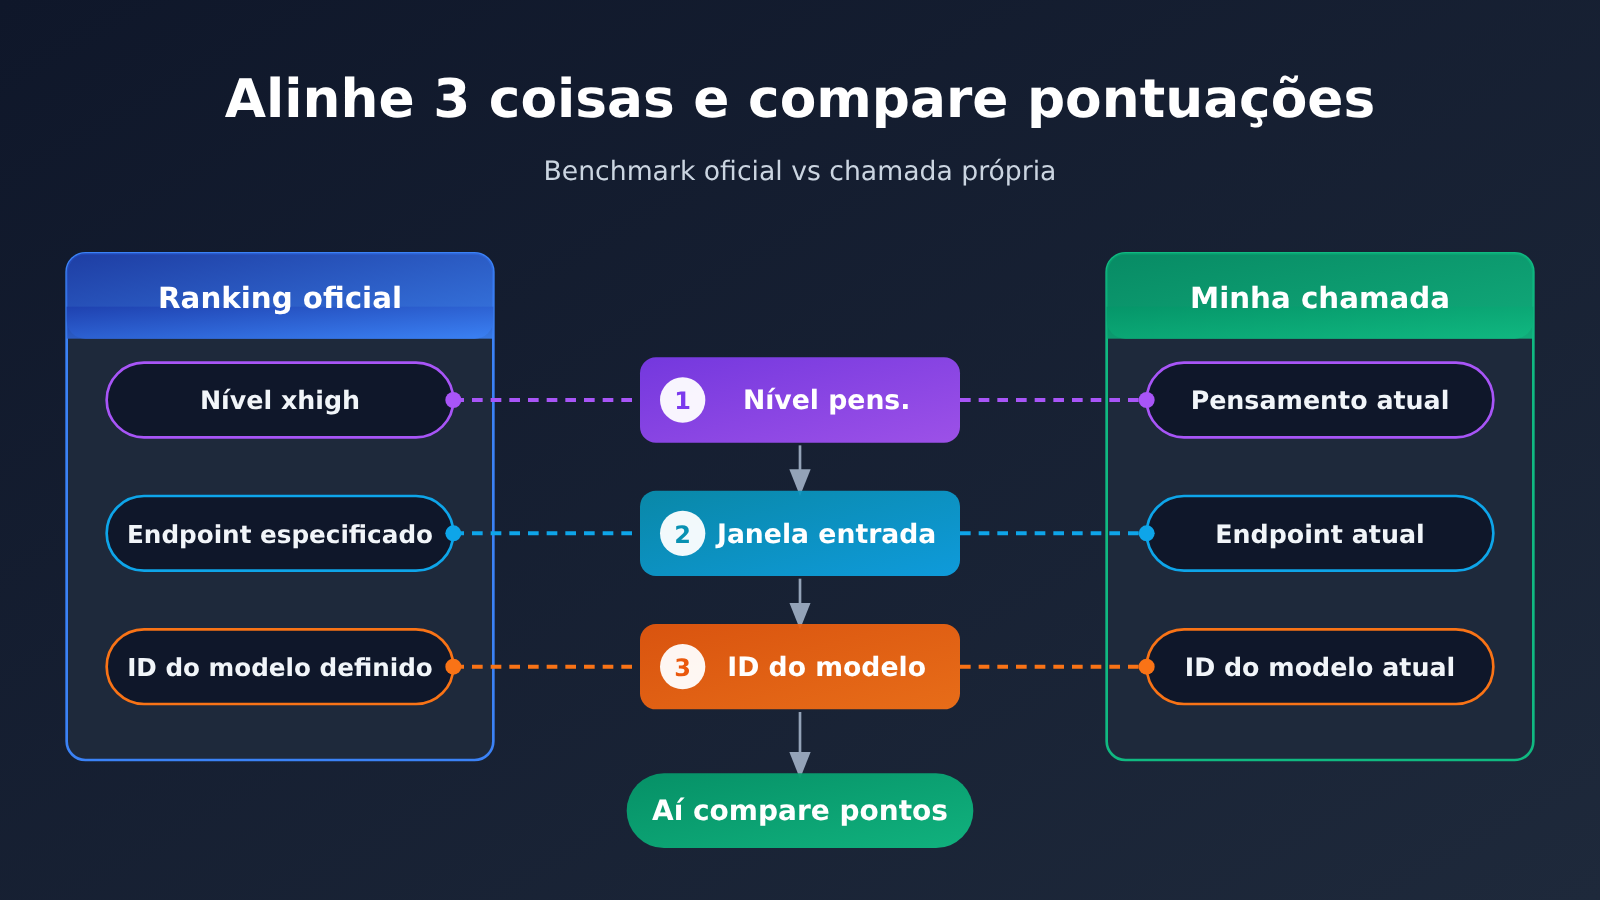
Primeiro, a conclusão. A pontuação de um ranking nunca é a pontuação do “nome do modelo”, e sim a pontuação de “determinado ID de modelo + determinado nível de raciocínio + determinada condição de entrada”. Se qualquer um dos três for diferente, o resultado que você obtém não pode ser comparado diretamente com o ranking.
| Item de verificação | Diferença típica (de documentos públicos) | O que acontece se não bater | Prioridade |
|---|---|---|---|
| Nível de raciocínio | O Neon na API tem high como padrão, além de low, medium, xhigh; o Carbon tem medium como padrão e não tem xhigh |
O comprimento da saída e a profundidade de raciocínio são diferentes, então o resultado naturalmente difere | Primeiro passo |
| Janela de entrada | A janela da API do Neon é 1,048,576 tokens, enquanto a documentação do Antigravity diz no máximo 512K |
A capacidade de contexto longo do ranking pode não caber na sua entrada | Segundo passo |
| ID do modelo | O Gemini 4 tem pelo menos quatro IDs: argon, carbon, hydrogen e neon, com níveis de raciocínio e preços diferentes |
Comparar o resultado de A com o ranking de B não é comparar a mesma coisa | Terceiro passo |
Por que o nível de raciocínio é o primeiro item na verificação dos benchmarks oficiais
O nível de raciocínio é a variável mais fácil de ignorar, porque muitas vezes tem valor padrão e você consegue chamar normalmente sem configurá-lo. O problema é que os valores padrão diferem entre modelos. No caso do Gemini 4, o Neon na API tem high como padrão e o Carbon tem medium. Com o mesmo comando, níveis diferentes produzem comprimentos de saída e resultados finais diferentes.
Os rankings normalmente especificam o nível testado. As pontuações citadas em anúncios oficiais, como os 61 pontos do Neon no Artificial Analysis no nível xhigh, devem ser lidas junto com o nível. Se você comparar o high padrão com uma pontuação de xhigh, já não é a mesma condição. Mais importante ainda: o Carbon não tem nível xhigh de jeito nenhum, então “ajustar o Carbon ao máximo” também não equivale ao xhigh do Neon.
Entradas diferentes também podem dar nomes diferentes ao mesmo nível. No Antigravity, o nível mais alto do Neon aparece na interface como Extra, diferente do xhigh na documentação da API. Na verificação, procure pela correspondência na documentação, não apenas pelo texto literal.
Por que a janela de entrada e o ID do modelo também são igualmente cruciais
A janela de entrada determina quanto contexto você pode fornecer ao modelo. Ao chamar o Neon pela API, a janela é 1,048,576 tokens, enquanto a documentação do Antigravity diz no máximo 512K. Se o ranking testa recuperação em documentos longos ou compreensão de grandes bases de código, mesmo trocando para o mesmo modelo em uma entrada com janela menor, você pode obter resultados piores porque o conteúdo é truncado.
O ID do modelo é o item mais “duro”. A geração Gemini 4 tem pelo menos quatro IDs: argon, carbon, hydrogen e neon, e suas configurações de nível de raciocínio e preços são diferentes. Pegar o resultado do Hydrogen para comparar com o ranking do Neon no nível xhigh — a diferença é mais do que normal. Antes de chamar, recomendo confirmar na tabela geral de modelos do APIYI apiyi.com qual é exatamente o ID que você colocou na requisição; não preencha de memória ou com base no print de outra pessoa.
Passos rápidos para alinhar com o benchmark oficial
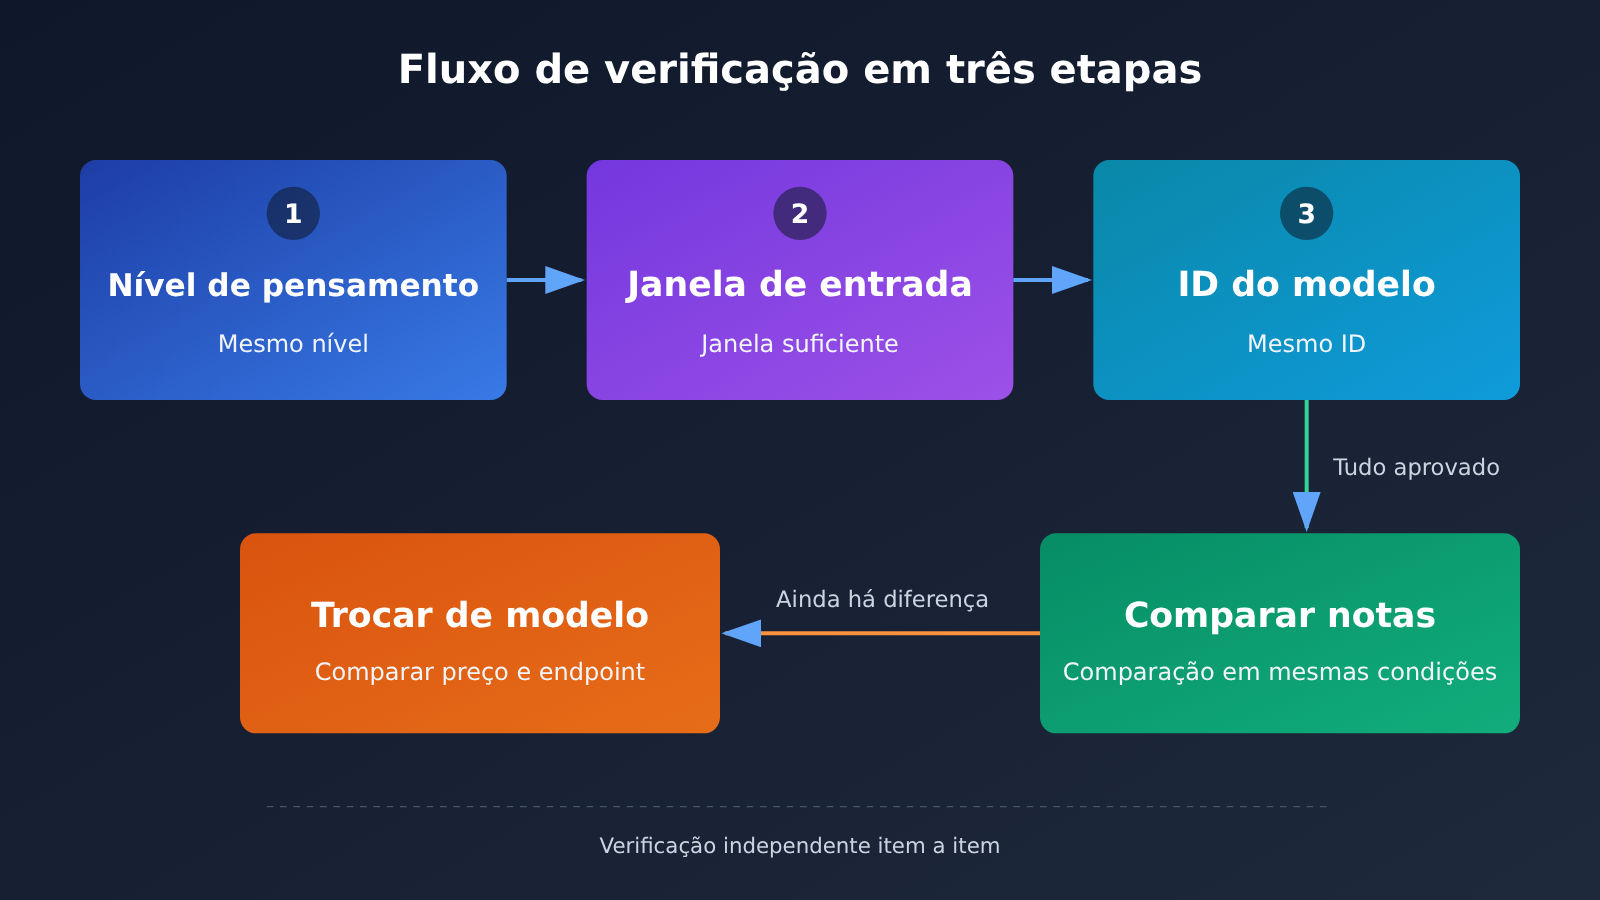
Esta seção transforma as três verificações em operações concretas. Para facilitar a cópia, os nomes dos parâmetros, os IDs dos modelos e os endereços estão em código inline, e você pode conferir item por item nas suas próprias requisições.
Passo 1: confirme a entrada de invocação e o endpoint
Primeiro, deixe claro por qual entrada você está usando o modelo: interface web, plugin de IDE ou chamada direta à API. O limite da janela e a nomenclatura dos níveis podem variar entre entradas diferentes. Se você usar a interface compatível com OpenAI, defina base_url como https://api.apiyi.com/v1 e preencha api_key com a chave gerada no console do APIYI. Assim, ao trocar de modelo mais adiante, você só altera o campo model, mantém as condições de entrada iguais, e a comparação passa a fazer sentido.
Passo 2: escreva o ID do modelo na forma completa
Na requisição, escreva o model como o ID completo, por exemplo gemini-4-neon ou gemini-4-carbon, e não use o vago “Gemini 4”. Depois de escrever, volte à tabela geral de modelos e confira uma vez, confirmando que esse ID é exatamente o que foi testado no ranking. Se o ranking testou o Neon e você está invocando o gemini-4-hydrogen, então todas as comparações seguintes não precisam ser feitas — primeiro corrija o ID.
Passo 3: defina explicitamente o nível de raciocínio
Não dependa do valor padrão; especifique explicitamente o nível de raciocínio na requisição. Para o nome exato do campo, consulte a documentação oficial do modelo correspondente. Ao configurar, observe três pontos:
- Alinhe com o nível testado no ranking: se o ranking diz
xhigh, definaxhigh; se dizhigh, definahigh. - Confirme que o nível existe: o Carbon não tem
xhigh, então forçar uma comparação com o rankingxhighdo Neon não faz sentido. - Atenção ao mapeamento de nomes: o
Extrana interface do Antigravity corresponde ao nível mais alto do Neon; ao migrar para a API, troque pelo nome do nível indicado na documentação.
Passo 4: verifique se o contexto ultrapassa a janela da entrada
Se o conteúdo do seu teste for muito longo, primeiro estime o número de tokens e compare com o limite da entrada. Ao chamar o Neon pela API, o limite é 1,048,576 tokens; na documentação do Antigravity, o valor escrito é de no máximo 512K. Conteúdo que ultrapassa o limite é truncado ou gera erro — nesse caso, o “resultado ruim” na verdade é uma entrada incompleta.
🚀 Início rápido: se quiser comparar vários IDs de modelos sob as mesmas condições de entrada, você pode, pelo APIYI apiyi.com, invocar Gemini, Claude, GPT e outros modelos com uma única chave. Novos usuários têm cota gratuita de teste, o que é ideal para primeiro alinhar os níveis e os IDs e depois fazer comparações em pequena escala.
Lista de verificação das três conferências
| Item de verificação | Campo a observar na requisição | Critério de aprovação | Erro comum |
|---|---|---|---|
| Entrada | base_url |
Fixar uma única entrada, como https://api.apiyi.com/v1 |
Testar uma vez no site e uma vez na API, comparando misturado |
| ID do modelo | model |
ID completo e consistente com o ranking | Usar hydrogen para comparar com o ranking do neon |
| Nível de raciocínio | Parâmetro do nível de raciocínio (nome do campo conforme a documentação) | Consistente com o nível testado no ranking e com esse nível existindo | Depender do valor padrão; definir xhigh para o Carbon |
| Contexto | Número de tokens de entrada | Não ultrapassar o limite da janela da entrada | Enfiar conteúdo de nível de milhão em uma entrada 512K |
Ainda há diferença depois de conferir os benchmarks oficiais: preço e endpoint antes de trocar de modelo
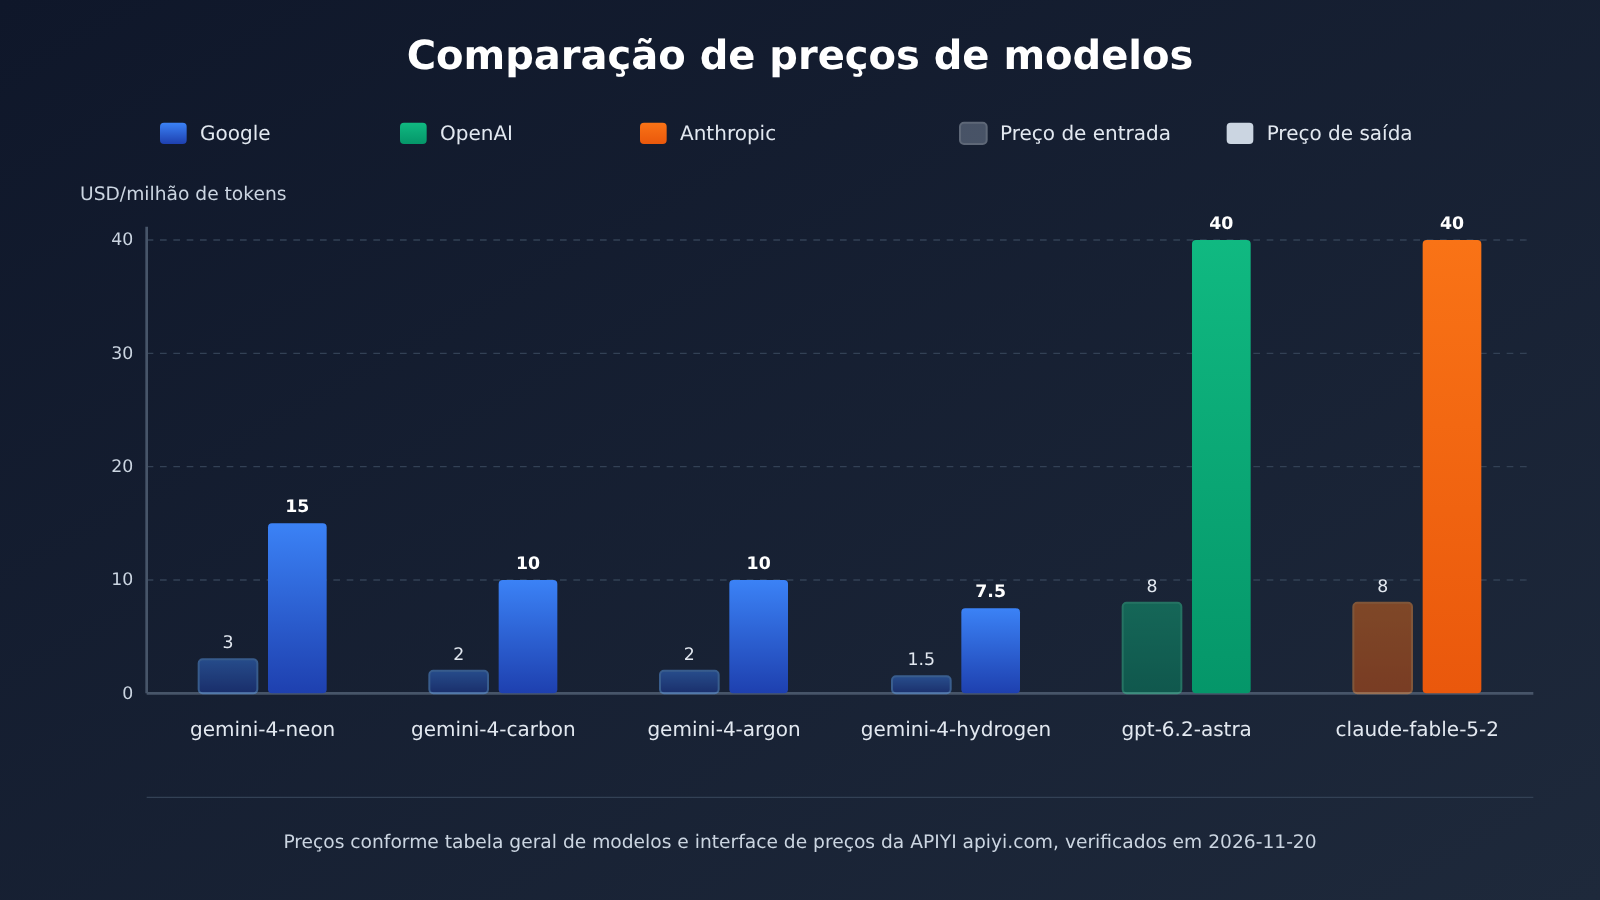
Se os três itens conferem e a diferença continua evidente, aí sim vale a pena considerar trocar de modelo. Trocar de modelo não é só mudar um nome: é preciso olhar ao mesmo tempo para o nível de capacidade e o custo, porque os preços das várias IDs do Gemini 4 variam bastante. Abaixo estão os preços de prateleira da APIYI conferidos em 2026-11-20, todos em dólares por milhão de tokens.
| ID do modelo | Entrada | Leitura de cache | Saída | Observações |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
Vale a interface de preços; igual ao preço do Google |
gemini-4-carbon |
2 |
0.1 |
10 |
Corresponde ao preço promocional do Google até 2026-11-30 |
gemini-4-argon |
2 |
0.1 |
10 |
Vem da tabela geral de modelos |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
Menor preço unitário entre as quatro |
gpt-6.2-astra |
8 |
0.4 |
40 |
Acima de 272000 tokens, a entrada passa a 16; detalhes abaixo |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 |
0.2 |
40 |
As duas IDs têm o mesmo preço |
Há alguns pontos nesta tabela que precisam de explicação à parte, senão é fácil errar o cálculo de custo:
- A origem do gemini-4-neon: a versão da tabela geral de modelos atualizada em 2026-11-19 10:59 (UTC+8) não o inclui, mas a interface de preços inclui. A interface de preços informa
model_ratioigual a1.5,completion_ratioigual a5ecache_ratioigual a0.05. Convertendo com a base de quemodel_ratioigual a1corresponde a entrada de2dólares por milhão de tokens, chegamos a entrada3, saída15e leitura de cache0.15. - A vigência do preço do gemini-4-carbon: o preço atual corresponde ao preço promocional do Google até 2026-11-30. A partir de 1º de dezembro, o preço padrão do Google passa a ser entrada
4e saída20; para orçamentos de longo prazo, é preciso levar essa mudança em conta. - As faixas do gpt-6.2-astra: a tabela geral de modelos indica, na primeira faixa, entrada
8, leitura de cache0.4e saída40, com entrada16acima de272000tokens. A interface de preços, quando passa de272000tokens, calcula saída com base em60e leitura de cache em0.8. Vale consultar as duas fontes juntas.
💡 Sugestão de escolha: ao trocar de modelo, coloque as IDs candidatas sob o mesmo
base_urle compare com o mesmo nível de raciocínio e a mesma entrada; só assim a conclusão se sustenta. A tabela geral de modelos e a interface de preços da APIYI apiyi.com permitem consultar o preço atual dessas IDs; recomendo confirmar mais uma vez antes da chamada, em vez de depender só desta tabela do artigo.
Lista de verificação de endpoint e cobrança ao trocar de modelo
| Ponto de verificação | Onde consultar | Por que verificar |
|---|---|---|
| O ID do modelo existe | Tabela geral de modelos docs.apiyi.com/models.md |
A versão da tabela geral pode estar desatualizada, e IDs específicos precisam ser verificados novamente na interface de preços |
| Preço unitário atual e multiplicador | Interface de preços api.apiyi.com/api/pricing |
O multiplicador pode ser convertido em preço unitário em dólares; o número da versão é shell-api-modelmak-v1 |
| Faixas de contexto longo | Comparar nos dois lugares: tabela geral e interface de preços | Por exemplo, o preço unitário do gpt-6.2-astra muda após ultrapassar 272000 tokens |
| Endpoint de invocação | https://api.apiyi.com/v1 |
Formato compatível com OpenAI; ao trocar de modelo, basta alterar model |
| Mudança de preço upstream | Anúncio oficial de preços | Por exemplo, o preço de lançamento do Carbon termina em 2026-11-30 |
Perguntas frequentes (FAQ)
Q1: A que condições correspondem, afinal, as pontuações de referência oficiais?
A pontuação do ranking corresponde à combinação de “determinado ID de modelo + determinado nível de raciocínio + determinada condição de entrada”, e não a um nome de modelo genérico. Os 61 pontos do Neon, por exemplo, são o resultado do Artificial Analysis no nível `xhigh`. Citar esse número isoladamente, fora do contexto do nível, gera mal-entendidos com facilidade.
Q2: Nível de raciocínio, janela de entrada e ID de modelo — o que devo verificar primeiro?
A ordem sugerida é: primeiro o nível de raciocínio, depois a janela de entrada e, por fim, conferir o ID do modelo — só compare as pontuações depois que os três itens estiverem alinhados. Na prática, também dá para dar uma olhada rápida no ID logo de cara, porque, se o ID estiver errado, nem vale a pena olhar os outros dois. O sentido da ordem está em eliminar item por item, não em seguir um passo a passo fixo mecanicamente.
Q3: Se eu colocar o nível de raciocínio no máximo, chego ao benchmark oficial?
Não dá para prometer isso. Alinhar o nível garante apenas que você está comparando sob a mesma condição do ranking; a distribuição das questões, a forma como os comandos são escritos, o método de amostragem e outros fatores ainda podem gerar diferenças. Além disso, nem todo ID tem o nível máximo: o Carbon, por exemplo, não tem `xhigh`, e ajustá-lo para o seu nível mais alto não equivale ao `xhigh` do Neon.
Q4: Por que o mesmo Neon tem resultados diferentes na IDE e chamando a API diretamente?
As condições de entrada podem ser diferentes. Quando o Neon é acessado via API, a janela é de `1,048,576` tokens; a documentação do Antigravity fala em no máximo `512K`. Os nomes dos níveis também diferem nas duas pontas: na interface do Antigravity, o nível máximo se chama `Extra`. O fato de tarefas de contexto longo irem pior em uma entrada com janela menor é consequência da diferença de condições, e não indica que o modelo em si piorou.
Q5: Como comparar vários IDs de modelo sob a mesma entrada?
Você pode seguir estes três passos:
1. Registre-se no APIYI apiyi.com e gere uma chave API; novos usuários podem resgatar uma cota gratuita de teste.
2. Defina `base_url` para `https://api.apiyi.com/v1` em todos os casos e altere apenas o campo `model` para trocar de ID.
3. Para cada ID, defina explicitamente o mesmo nível de raciocínio e compare com o mesmo lote de entradas.
Assim, entrada e nível ficam fixos, e as diferenças vêm principalmente do próprio modelo.
Q6: Não encontro o gemini-4-neon na tabela geral de modelos. Ainda posso chamá-lo?
A versão da tabela geral atualizada em 2026-11-19 não inclui o `gemini-4-neon`, mas a interface de preços traz o multiplicador dele: convertendo, dá `3` na entrada, `15` na saída e `0.15` na leitura de cache, em dólares por milhão de tokens — o mesmo que o preço de tabela do Google. A recomendação é usar como referência o resultado em tempo real da interface de preços do APIYI apiyi.com e confirmar mais uma vez antes de chamar.
Q7: Ao trocar de modelo, qual item é mais fácil de calcular errado?
O mais fácil de errar são as faixas de contexto longo e a validade dos preços. No `gpt-6.2-astra`, acima de `272000` tokens o preço unitário de entrada passa de `8` para `16`, e a interface de preços ainda indica que, nesse caso, a saída é cobrada a `60` e a leitura de cache a `0.8`. O Carbon está com preço de lançamento; a partir de 1º de dezembro, o preço padrão do Google será `4` na entrada e `20` na saída.
Principais conclusões da verificação dos benchmarks oficiais
- A pontuação do ranking traz condições: a pontuação de referência corresponde à combinação “ID do modelo + nível de raciocínio + canal de acesso”, e não à pontuação do nome do modelo em si.
- Confira primeiro o nível de raciocínio: o Neon usa
highpor padrão e o Carbon usamediumpor padrão e não temxhigh; não confie nos valores padrão. - Depois confira a janela do canal de acesso: o Neon na API tem
1,048,576tokens, enquanto a documentação do Antigravity indica no máximo512K. - O ID precisa ser o mesmo: o Gemini 4 tem pelo menos quatro IDs; usar o resultado do Hydrogen para comparar com o ranking do Neon não faz sentido.
- Ajustar não garante igualar: alinhar as condições só torna a comparação válida; não promete que a pontuação vai alcançar o ranking.
- Trocar de modelo exige conferir o preço de lista: no APIYI apiyi.com, compare vários IDs usando o endpoint unificado e, ao mesmo tempo, confira os preços na tabela geral e na interface de preços.
Resumo
Quando o desempenho do modelo fica abaixo do benchmark oficial, a ordem para verificar estas três coisas é:
- Alinhe o nível de raciocínio: defina explicitamente o nível usado no teste do ranking e confirme que esse ID realmente possui esse nível.
- Alinhe a janela do canal de acesso: confirme que seu canal de acesso comporta o conteúdo do teste e fique atento à nomenclatura de níveis em canais diferentes.
- Alinhe o ID do modelo: escreva o ID completo na requisição e volte à tabela geral de modelos para conferir palavra por palavra.
Depois de alinhar os três pontos, se a diferença ainda existir, aí sim vale considerar trocar de modelo. Ao trocar, compare ao mesmo tempo o nível de capacidade, o preço unitário, as faixas de contexto longo e a vigência dos preços. Nesse momento, a base para a decisão deve ser o resultado da comparação sob as mesmas condições, e não um número de ranking citado fora de contexto.
Recomenda-se validar vários IDs de modelo no APIYI apiyi.com, usando o mesmo endpoint https://api.apiyi.com/v1. Depois de fixar o canal de acesso e o nível, as conclusões da comparação ficam muito mais confiáveis.
📚 Materiais de Referência
-
Tabela geral de modelos da APIYI – resumo dos IDs de modelo e preços de catálogo
- Link:
docs.apiyi.com/models.md - Descrição: este artigo cita a versão atualizada em 2026-11-19 10:59 (UTC+8), que pode ser usada para verificar se um ID de modelo existe
- Link:
-
Interface de preços da APIYI – multiplicador e preço unitário em tempo real
- Link:
api.apiyi.com/api/pricing - Descrição: versão
shell-api-modelmak-v1; quandomodel_ratioé1, equivale a2dólares por milhão de tokens de entrada, permitindo converter o preço unitário de cada modelo
- Link:
-
Documentação oficial e informações de preços do Google Gemini 4 – nível de raciocínio, janela de contexto e preço de catálogo
- Link:
ai.google.dev - Descrição: consulte o nível de raciocínio padrão, os níveis opcionais, o limite de janela da API e a data de alteração de preço de cada ID
- Link:
Autor: Equipe técnica da APIYI
Troca técnica: fique à vontade para entrar em contato pela página inicial do site oficial da APIYI; mais materiais sobre modelos e interfaces estão disponíveis no centro de documentação da APIYI


