
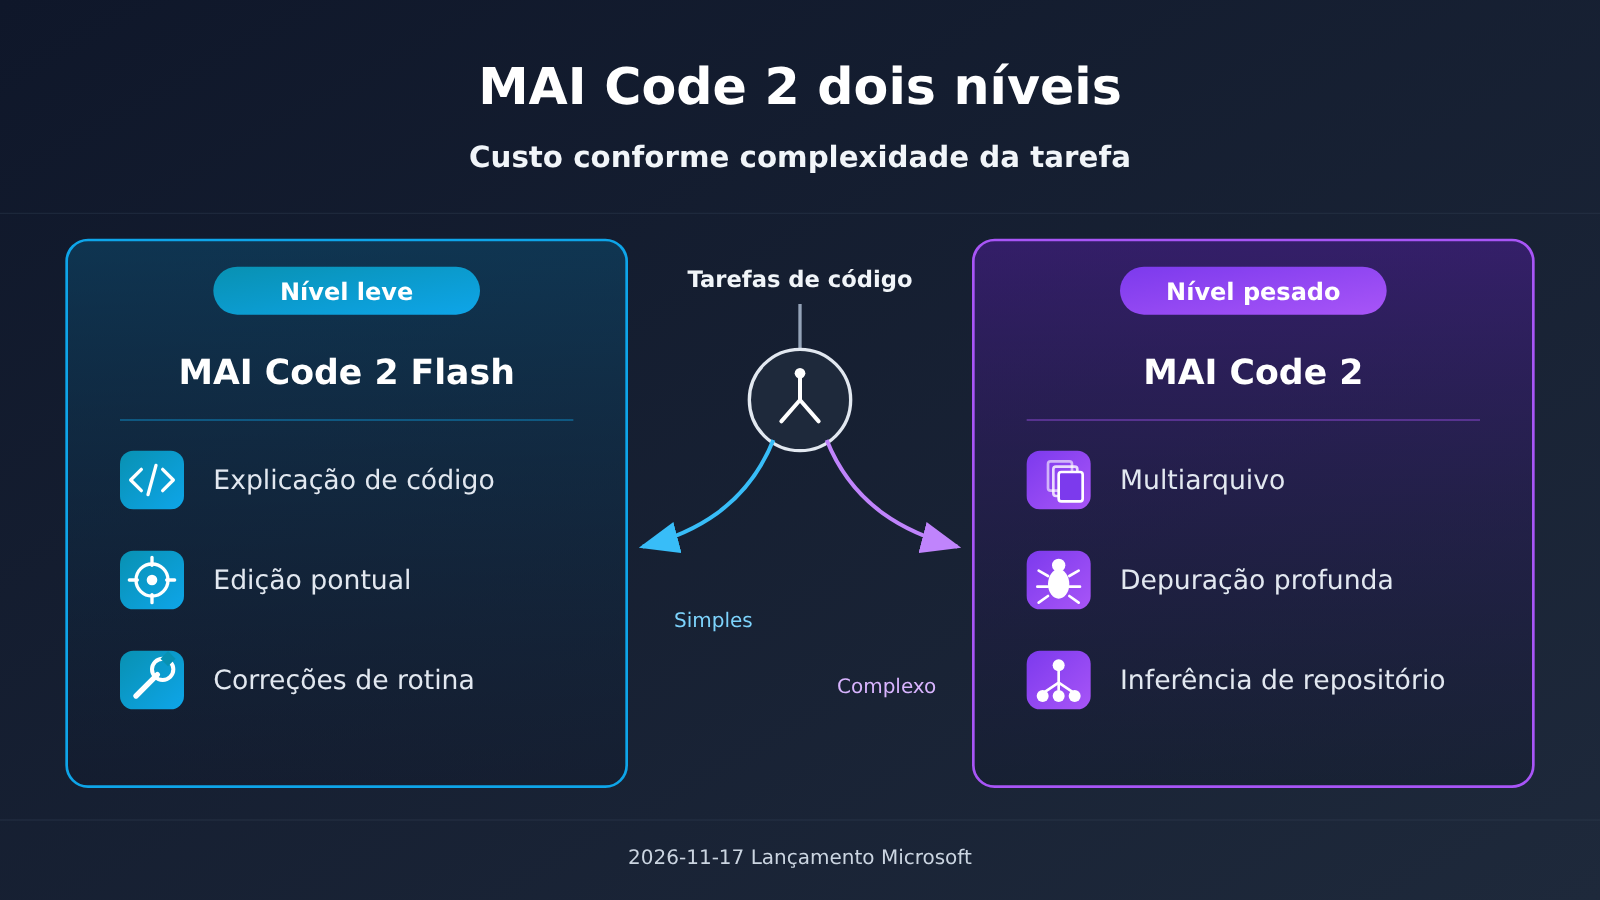
A Microsoft oferece modelos distintos para engenharia complexa e tarefas rotineiras de alta frequência. A avaliação deste artigo é que isso dá às empresas uma nova opção para alocar custos conforme a complexidade da tarefa. Em 17 de novembro de 2026, a Microsoft lançou o MAI Code 2 e o MAI Code 2 Flash. O primeiro é voltado para modificações em múltiplos arquivos, depuração profunda e raciocínio no nível de repositório; o segundo, para explicação de código, modificações pontuais, correções de rotina e iteração de alta frequência.
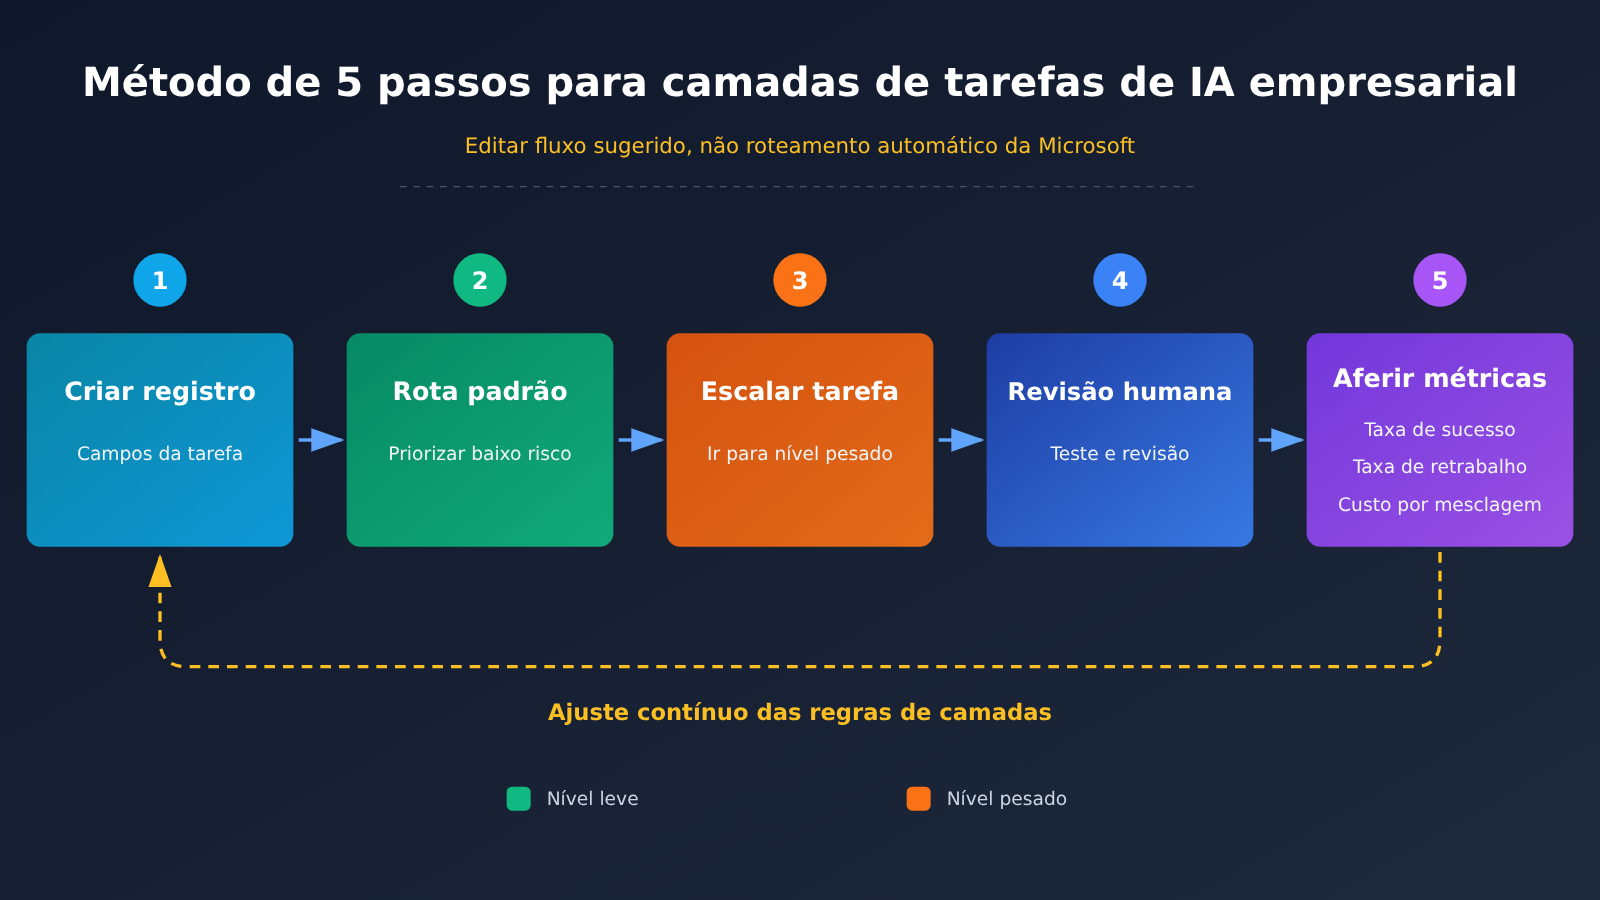
A conclusão central deste artigo é: ao avaliar IA de programação, as empresas não devem olhar apenas para qual modelo é “o mais forte”. A pergunta mais importante é quais tarefas podem ser entregues à versão leve, quais precisam ser escaladas para a versão pesada e quanto realmente custou cada merge bem-sucedido. É preciso deixar claro que o fluxo de estratificação de tarefas descrito abaixo é uma sugestão da redação, não uma garantia de roteamento automático já oferecida pela Microsoft.
O que você vai aprender ao ler este artigo
- A diferença de posicionamento entre o MAI Code 2 e o MAI Code 2 Flash, e em quais canais eles estão disponíveis hoje e quais ainda estão com status “em breve”.
- Quais especificações o model card revela e quais informações são declarações do fornecedor ainda não verificadas de forma independente.
- Como as empresas podem usar a ideia das “duas versões” para montar seu próprio fluxo de estratificação de tarefas de programação e medir os resultados com taxa de sucesso, taxa de retrabalho e custo por merge.
- Itens que precisam ser verificados em relação à residência de dados e permissões antes de um piloto, além de várias formas comuns de interpretação exagerada.
Índice de leitura do MAI Code 2
A primeira parte, “Fatos objetivos”, organiza em ordem o posicionamento das duas versões, os canais de lançamento, as especificações do model card, o caso empresarial e a relação com o MAI Work Flash, com base em materiais públicos da Microsoft e na documentação de preços do GitHub. A segunda parte, “Análise e julgamento”, traz a visão da redação: primeiro explica a lógica de negócios por trás das duas versões, depois apresenta cinco etapas — criar o registro de tarefas, definir o roteamento padrão, estabelecer regras de escalonamento, fazer a aceitação humana e calcular as métricas — e, por fim, discute os itens de verificação do piloto e as interpretações equivocadas a evitar.
Para saber: conceitos-chave para entender o lançamento em duas versões do MAI Code 2
| Conceito | Explicação breve |
|---|---|
| MAI Code 2 | Modelo de programação de grande porte da Microsoft, voltado para múltiplos arquivos, depuração profunda e raciocínio em nível de repositório |
| MAI Code 2 Flash | A versão leve da mesma família, voltada para explicação de código, alterações pontuais, correções de rotina e iterações de alta frequência |
| MAI Work Flash | Modelo derivado e mais otimizado a partir do Code 2 Flash, para cenários de produtividade e dados como M365 e FabricIQ |
| Foundry | Plataforma da Microsoft para desenvolvimento de modelos e aplicações de IA para empresas; o Flash é oferecido ali como prévia de acesso limitado |
| Prévia de acesso limitado (Limited-access preview) | Prévia que exige solicitação de acesso ou o cumprimento de certos requisitos; não equivale a disponibilidade aberta a todos |
| Janela de contexto | Quantidade total de tokens que o modelo consegue processar em uma única vez; a ficha do modelo informa 1.05M |
| Raciocínio em nível de repositório | Entender a estrutura e as dependências do repositório inteiro antes de fazer alterações, em vez de olhar apenas para um arquivo isolado |
| Roteamento de modelos | Estratégia de encaminhar requisições para modelos diferentes conforme as características da tarefa, seja por regras manuais ou por implementação em software |
| Taxa de retrabalho | Proporção de resultados de IA que são devolvidos e precisam ser alterados novamente; é um indicador-chave da eficiência real |
| Residência de dados | Região geográfica onde os dados são armazenados e processados, o que está ligado a exigências de conformidade |
Visão rápida do impacto do lançamento em duas versões do MAI Code 2
- Líderes técnicos de empresas: A dimensão de compra e avaliação passou de “escolher o modelo mais forte” para “configurar versões diferentes para tarefas diferentes”, sendo necessário preparar a categorização de tarefas e os critérios de apuração de custos.
- Desenvolvedores que usam GitHub Copilot: Os dois modelos já estão disponíveis no Copilot, e no dia a dia é possível alternar ativamente conforme o tamanho da tarefa, mas o escopo específico disponível depende da política da organização.
- Equipes que constroem aplicações no Foundry: No momento, apenas o Flash está disponível em formato de prévia restrita, sendo necessário confirmar primeiro a elegibilidade de acesso, não sendo adequado programar com base em disponibilidade total.
- Desenvolvedores que dependem de plataformas de terceiros: No comunicado de lançamento, canais como OpenRouter, Vercel, Hermes, OpenCode e Kilo estão marcados como “em breve”, e não devem ser incluídos em planos de produção antes da abertura efetiva.
- Equipes de conformidade e segurança: Um modelo adicional significa mais um conjunto de fluxos de dados e limites de permissão, sendo necessário concluir a verificação antes do piloto.
1. Fatos objetivos: o que o MAI Code 2 e o Flash lançaram
Esta seção organiza apenas informações de materiais públicos da Microsoft. O conteúdo relacionado a desempenho e casos é do lançamento do fabricante ou repassado, não sendo avaliação independente, e nossa equipe também não realizou testes práticos nestes dois modelos.
1.1 O posicionamento em duas versões do MAI Code 2: o que cada um faz — Code 2 e Flash
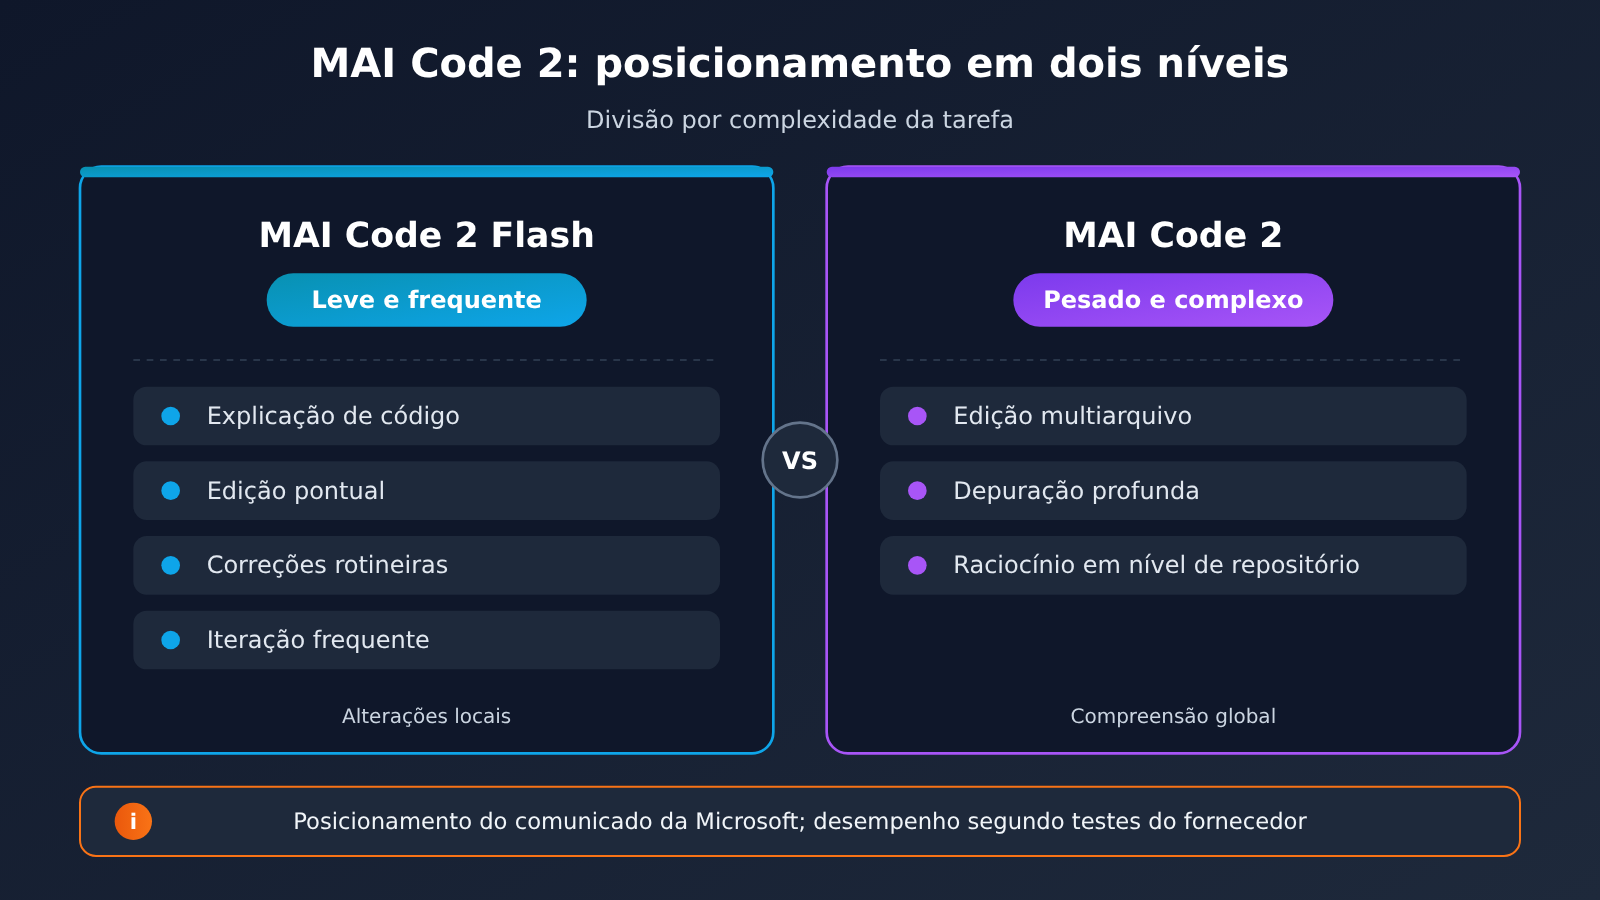
No comunicado de lançamento, a Microsoft deixou bem clara a divisão de trabalho entre os dois modelos: a versão pesada fica responsável por tarefas de engenharia complexas que exigem compreensão global, enquanto a versão leve cuida das tarefas do dia a dia — de alta frequência, escopo local e ritmo acelerado.
| Dimensão | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
| Posicionamento oficial | Modificação de múltiplos arquivos, depuração profunda, raciocínio em nível de repositório | Explicação de código, modificação pontual, correções de rotina, iteração de alta frequência |
| Características da tarefa | Muitas dependências entre arquivos, exige entender a estrutura como um todo | Escopo bem definido, mudanças concentradas em pontos locais |
| Recomendação de escolha (avaliação deste artigo) | Avaliar primeiro a correção entre arquivos | Avaliar primeiro a qualidade da tarefa local e a velocidade de resposta |
| Natureza da avaliação | Avaliação do fabricante | Avaliação do fabricante |
1.2 Canais de lançamento e disponibilidade do MAI Code 2
A disponibilidade é a parte mais sujeita a interpretação errada. De acordo com o comunicado da Microsoft e o blog do Azure AI Foundry, a situação de cada canal é esta:
| Canal | MAI Code 2 | MAI Code 2 Flash | Status |
|---|---|---|---|
| GitHub Copilot | Disponível | Disponível | Já lançado |
| Microsoft Foundry | Não listado como disponível | Prévia com acesso restrito | Requer solicitação de qualificação |
| OpenRouter, Vercel, Hermes, OpenCode, Kilo | Em breve | Em breve | O comunicado de lançamento indica “soon”, o que não significa liberação geral |
1.3 Especificações do model card do MAI Code 2
A Microsoft também publicou os model cards dos dois modelos. As especificações públicas confirmadas até agora são:
- Modalidade de entrada: texto e imagem; modalidade de saída: texto.
- A janela de contexto do modelo é de 1.05M tokens, com limite de entrada de 922k e limite de saída de 128k.
- Essas são especificações do model card, não uma garantia de capacidade disponível em cada ponto de entrada do produto. Ao usar, é preciso verificar também as restrições específicas de cada produto. Por exemplo, a janela de contexto disponível em um plugin de IDE pode ser menor que o valor do model card.
Sobre o número total de parâmetros, há versões inconsistentes nos materiais públicos; este artigo não as considera confiáveis nem as cita.
1.4 Estudo de caso de personalização empresarial do MAI Code 2 e MAI Work Flash
Na página do modelo MAI Code 2, a Microsoft menciona os cenários de modelos personalizados de duas empresas: AT&T e Woven by Toyota. Essas informações são relatos repassados pelo fornecedor, que descrevem usos personalizados específicos de empresas específicas, e não podem ser generalizadas como “todas as tarefas empresariais obterão o mesmo resultado”.
Outra informação que vale destacar separadamente é o MAI Work Flash. O comunicado de lançamento afirma que se trata de um modelo derivado, otimizado a partir do Code 2 Flash, que atende ao M365 e ao FabricIQ. Portanto, os resultados do MAI Work Flash em cenários de escritório não podem ser citados diretamente como os resultados do Code 2 Flash básico.
1.5 Ao fazer orçamento, é preciso distinguir taxas promocionais de custos de longo prazo
A documentação de preços do GitHub Copilot lista as seguintes tarifas em dólares por milhão de tokens, na ordem entrada / entrada em cache / saída:
| Modelo | Taxa promocional | Taxa regular a partir de 17 de maio de 2027 |
|---|---|---|
| MAI Code 2 | 0.50/0.025/2.50 | 1.00/0.05/5.00 |
| MAI Code 2 Flash | 0.05/0.005/0.25 | 0.10/0.01/0.50 |
A documentação oficial não especifica o fuso horário dessa data. Esse é o critério de cobrança do Copilot e não pode ser usado diretamente como cotação do Foundry ou de plataformas de terceiros. A divulgação de custo relativo no comunicado da Microsoft usa o preço promocional de 50% e uma configuração de avaliação específica; o orçamento empresarial de longo prazo deve considerar também o preço regular, as novas tentativas em caso de falha e o retrabalho manual.
2. Análise e julgamento: a estratificação de tarefas corporativas por trás das duas variantes do MAI Code 2
A seguir estão a análise e as recomendações da redação; elas não representam a posição oficial da Microsoft. O texto abaixo não descreve o recurso de roteamento automático dos produtos da Microsoft; as regras de triagem, escalonamento e aceitação para empresas propostas aqui precisam ser projetadas e validadas separadamente.
2.1 Por que o MAI Code 2 foi dividido em duas variantes: o diferencial competitivo deixa o ranking geral e passa para a alocação de custos
As solicitações corporativas podem incluir, ao mesmo tempo, tarefas como “refatorar o módulo inteiro” e “explicar uma função”; a proporção deve ser levantada a partir do registro de tarefas da equipe, sem presumir que a maioria seja de tarefas simples. Se tarefas simples também forem sempre enviadas a modelos grandes, isso pode aumentar custos desnecessários; a latência real ainda precisa ser medida. Já se tudo for entregue a modelos leves, tarefas complexas tendem a falhar e gerar retrabalho repetido.
O lançamento em duas variantes, na prática, coloca essa escolha sobre a mesa: o fornecedor deixa de destacar apenas o limite máximo de um único modelo e passa a oferecer um par de modelos com papéis bem definidos. Para as empresas, o que realmente cria diferença é conseguir encaminhar a tarefa certa ao nível certo e acompanhar os resultados de forma contínua. Essa avaliação parte do posicionamento oficial da seção 1.1; quanto à magnitude real da diferença de custos, cada equipe precisa verificá-la com seus próprios dados.
2.2 Primeiro passo: criar um registro de tarefas para modelos de duas faixas como o MAI Code 2
Não tenha pressa em conectar o modelo. Em vez disso, use de duas a quatro semanas para registrar as tarefas de programação que a equipe realmente entrega à IA. O registro não precisa ser elaborado; o importante é anotar os campos que permitem avaliar a complexidade:
| Campo do registro | O que registrar | Serve para avaliar |
|---|---|---|
| Tipo de tarefa | Explicação, correção, nova funcionalidade, refatoração, depuração | Classificação inicial |
| Número de arquivos envolvidos | Arquivo único ou múltiplos arquivos | Se é preciso entendimento em nível de repositório |
| Há erro reproduzível | Existe log de erro ou caso de teste | Profundidade da depuração |
| Forma de aceitação | Teste unitário passa, revisão manual, observação em produção | Custo da aceitação |
| Resultado | Passou de primeira, retrabalho algumas vezes, desistência | Se a faixa foi escolhida corretamente |
Com o registro em mãos, as regras de estratificação que vêm depois passam a ter base, em vez de serem linhas traçadas por intuição.
2.3 Segundo passo: definir um roteamento padrão de baixo custo
A recomendação é começar pela faixa leve apenas para tarefas de baixo risco, escopo bem definido e critérios de aceitação suficientes. O número de arquivos pode servir como pista, mas não determina o risco sozinho: mexer na autenticação, no pagamento ou na configuração de produção dentro de um único arquivo também pode exigir upgrade direto e reforço da revisão humana.
Talvez valha mais a pena escrever uma tabela de triagem manual antes de conectar um agente automático: explicações de código e tarefas de sugestão sem efeitos colaterais podem usar a faixa leve primeiro; mudanças entre módulos e depurações com causa raiz desconhecida vão para a faixa complexa; tarefas que envolvem informações sigilosas, permissões de produção ou fronteiras de segurança passam primeiro pela revisão do responsável. Este artigo não executou testes de integração e não garante que qualquer terceiro já suporte esses dois modelos.
2.4 Etapa 3: Definir regras de escalonamento para tarefas complexas
O roteamento padrão só resolve a questão de “qual caminho seguir primeiro”; ainda é preciso definir quando escalonar. Recomenda-se adotar dois tipos de gatilho:
- Escalonamento antes da execução: quando o registro mostra que a tarefa envolve vários arquivos, exige entendimento em nível de repositório ou depuração profunda, encaminhe-a diretamente para o nível pesado.
- Escalonamento depois da execução: se a saída do nível leve não passar nos testes, ou se a mesma tarefa exigir retrabalho além do número combinado de vezes, mude automática ou manualmente para o nível pesado e tente novamente.
Para cada tentativa, registre o identificador da tarefa, o modelo, o uso, o resultado da aceitação e o motivo do escalonamento. As novas tentativas devem incluir as informações de falha da rodada anterior e ter um limite de tentativas ou de orçamento; ao ultrapassar o limite, encaminhe para tratamento humano, sem entrar em loop infinito. Não determine sucesso apenas porque a saída contém nomes de funções ou o texto “testes aprovados”; execute testes confiáveis e verifique as mudanças reais.
2.5 Etapa 4: A revisão humana é indispensável
Independentemente do nível do modelo, a saída sempre precisa passar por revisão humana antes da mesclagem. Recomenda-se definir intensidades de aceitação diferentes conforme o nível da tarefa: no nível leve, alterações pontuais devem se basear principalmente em testes aprovados mais uma revisão rápida; no nível pesado, mudanças em vários arquivos exigem que engenheiros experientes revisem dependências e possíveis efeitos colaterais. Por melhores que sejam os resultados de avaliação dos fornecedores, eles não substituem a aceitação no seu próprio repositório.
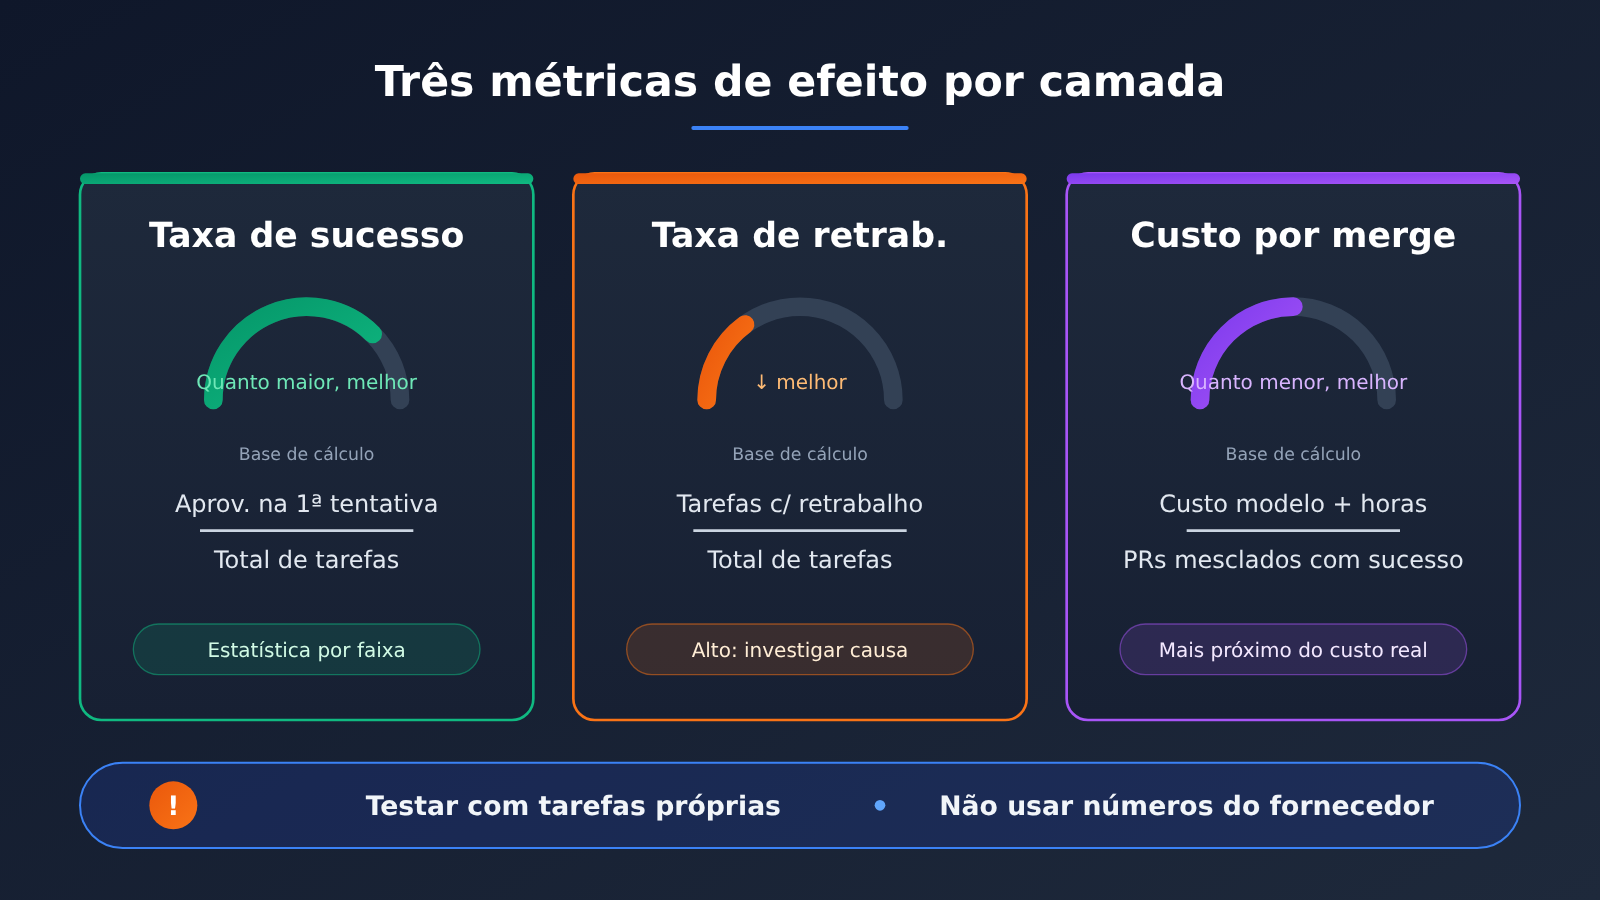
2.6 Quinto passo: medir o efeito da estratificação do MAI Code 2 com taxa de sucesso, taxa de retrabalho e custo por merge
Olhar apenas para o preço unitário do token pode levar a conclusões erradas: o nível mais leve é mais barato por chamada, mas, se for preciso refazer três vezes, o custo total pode acabar sendo maior. A recomendação é usar os três indicadores abaixo para fazer as contas:
| Indicador | Critério de cálculo | Descrição |
|---|---|---|
| Taxa de sucesso | Número de tarefas aprovadas de primeira ÷ número total de tarefas | Estatize separadamente por nível e por tipo de tarefa |
| Taxa de retrabalho | Número de tarefas devolvidas para refazer ÷ número total de tarefas | Quando a taxa de retrabalho estiver alta, investigue ao mesmo tempo a alocação nos níveis, a falta de informações e a definição de critérios de aceite |
| Custo por merge | (custo de invocação do modelo + horas de revisão humana e retrabalho convertidas em custo) ÷ número de PRs mesclados com sucesso | O que mais se aproxima do custo real de negócio |
Esses três indicadores devem ser medidos nas suas próprias tarefas, e não vale simplesmente copiar o “percentual de ganho de eficiência” divulgado por fornecedores ou pela mídia. Em bases de código, linguagens e critérios de aceite diferentes, os resultados podem variar bastante.
2.7 Verificação antes do piloto: residência de dados e permissões do MAI Code 2
Cada vez que você adiciona um novo nível de modelo, surge também um novo conjunto de fluxos de dados. Antes do piloto, vale a pena verificar pelo menos os pontos a seguir:
- Residência de dados: confirme se a região de processamento de dados do canal utilizado (Copilot, Foundry ou plataformas de terceiros) atende aos requisitos de conformidade do seu setor e da sua localidade. O Flash no Foundry está em fase de preview restrito, e os termos desse período de preview podem ser diferentes dos da versão oficial.
- Permissões de acesso ao código: a inferência em nível de repositório significa que o modelo pode ler uma faixa maior de código. Restrinja os repositórios e diretórios acessíveis e exclua conteúdos sensíveis, como chaves e arquivos de configuração.
- Políticas organizacionais: a possibilidade de trocar de modelo no Copilot — e quais modelos podem ser trocados — depende das configurações do administrador da organização, então é preciso confirmar isso com antecedência.
- Registros de auditoria: garanta que o modelo, o solicitante e o escopo de entrada de cada invocação sejam rastreáveis, para facilitar a revisão posterior.
2.8 Três coisas que não se deve interpretar demais sobre o MAI Code 2
- O roteamento do produto não equivale ao fluxo de governança corporativa descrito neste artigo. Mesmo que o produto utilizado ofereça seleção automática de modelo, é preciso verificar de forma independente as regras de roteamento, os critérios de aceitação e as permissões. Não se pode considerar que o método de cinco etapas deste artigo já esteja implementado automaticamente.
- Isso não significa que a Microsoft tenha abandonado a parceria com a OpenAI. Lançar um modelo de programação próprio não permite concluir que a Microsoft descartou os modelos da OpenAI, e os materiais públicos disponíveis também não sustentam essa inferência.
- Isso não significa que as avaliações do fornecedor possam ser reutilizadas diretamente. Os dados de desempenho e os casos empresariais vêm todos da Microsoft. AT&T e Woven by Toyota são cenários de customização específicos, e o MAI Work Flash é um modelo derivado otimizado à parte; os resultados de nenhum deles podem ser transferidos diretamente para as suas tarefas.
2.9 Sinais que merecem atenção futura no MAI Code 2
As observações a seguir são de natureza preditiva e aguardam verificação factual posterior. Primeiro, quando canais como o OpenRouter realmente serão abertos e qual será o modelo de cobrança após a abertura. Segundo, quando o Flash no Foundry sairá da pré-visualização restrita e se o nível pesado também entrará no Foundry. Terceiro, quanto a limitação de contexto no nível do produto difere do 1,05M indicado no model card — isso afeta diretamente se tarefas em nível de repositório conseguirão caber no contexto de uma só vez.
O sinal emitido pelo lançamento em duas variantes é bem simples: o valor da IA de programação não está em invocar o modelo mais forte todas as vezes, mas em encontrar o ponto de equilíbrio entre custo e qualidade para cada tipo de tarefa. Registrar bem as tarefas primeiro e depois deixar os dados definirem a linha divisória é mais confiável do que correr atrás de qualquer posição em um ranking geral. Como diz o Lunyu (Analects), no capítulo Wei Ling Gong: “Para fazer bem o seu trabalho, é preciso primeiro afiar as ferramentas.”
Referências
- Microsoft AI: comunicado de lançamento do MAI Code 2 e do MAI Code 2 Flash
- Microsoft Foundry: escolha de modelo e personalização corporativa
- Model card oficial do MAI Code 2 e do MAI Code 2 Flash
- Microsoft AI: casos de personalização corporativa
- GitHub: preços dos modelos do Copilot e datas de promoção


