
Nota do autor: todos os limites de capacidade deste artigo foram compilados com base na documentação de modelos do APIYI, conferidos contra a versão de novembro de 2026 antes da escrita — as conclusões seguem a documentação.
Uma imagem de retrato e um trecho de áudio, com a vontade de fazer a pessoa na tela abrir a boca e falar: essa é a demanda mais comum em vídeo a partir de imagem. A primeira reação de muita gente é enfiar o driving_audio junto no happyhorse-1.1-i2v, o resultado é que a condução por áudio não funciona, e aí começa a dúvida sobre o material, sobre a ordem dos parâmetros e até sobre a própria forma de chamar a API.
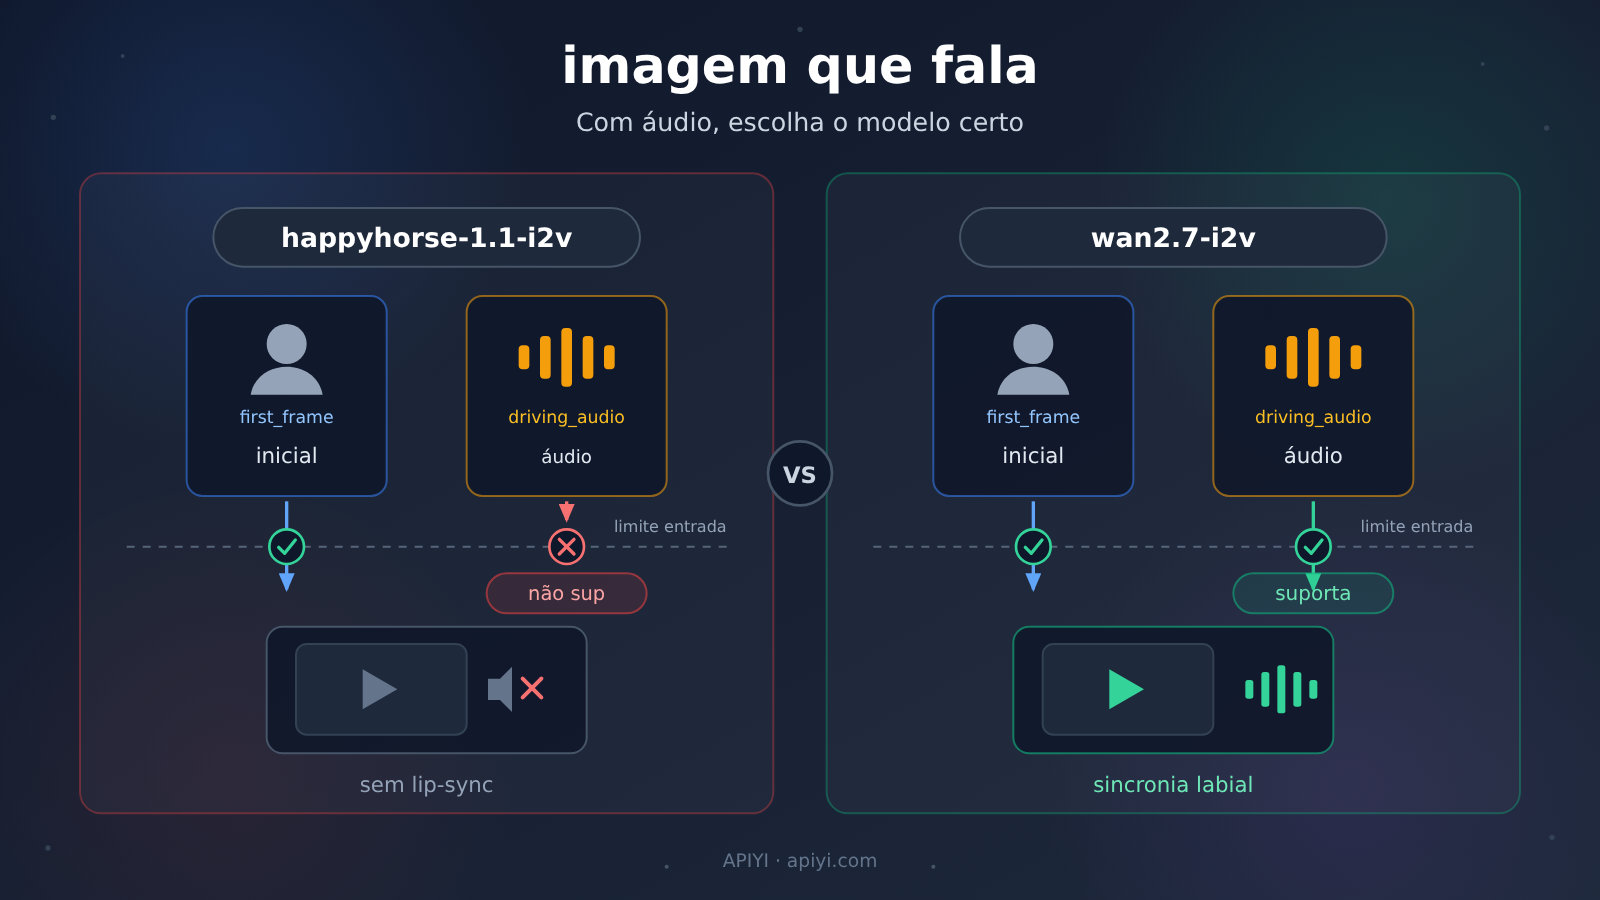
Não é um bug misterioso, nem material ruim. A documentação é bem direta nesse ponto: o happyhorse-1.1-i2v aceita apenas first_frame e não aceita driving_audio; para fazer sincronização labial ou rap, a direção indicada pela documentação é trocar para o wan2.7-i2v.
Valor central: depois de ler este artigo, você vai ter clara a fronteira de divisão de trabalho entre happyhorse-1.1-i2v e wan2.7-i2v, vai saber para quem passar os parâmetros quando quiser “fazer a imagem falar”, e vai conseguir rodar de primeira.
Pontos-chave do happyhorse-1.1-i2v
Vamos direto à conclusão e depois detalhamos:
| Ponto | Registro na documentação | O que significa para você |
|---|---|---|
| Só aceita a imagem do primeiro frame | happyhorse-1.1-i2v aceita a entrada first_frame |
A imagem é o único ponto de entrada de condução |
| Não suporta condução por áudio | O modelo não suporta driving_audio |
Passar não tem efeito, então não vale a pena ficar tentando de novo |
| Sincronização labial tem outro caminho | A documentação recomenda usar wan2.7-i2v para cenários de sincronização labial |
Trocar de modelo resolve o problema mais rápido do que trocar parâmetros |
O primeiro ponto é onde é mais fácil errar o julgamento. driving_audio não é um parâmetro oculto do happyhorse-1.1-i2v, nem uma capacidade que só será liberada em alguma versão futura. A documentação do modelo o marca explicitamente como não suportado, e até o item de imagem para vídeo na página de visão geral traz a mesma conclusão. Em outras palavras, o problema não está na forma como você faz a chamada, mas no fato de que a fronteira de capacidade do modelo já é essa aqui.
O segundo ponto é sobre a rota alternativa. A documentação registra que a condução por áudio é uma capacidade exclusiva do wan2.7-i2v, e o i2v do HappyHorse não assume esse tipo de tarefa. Por isso, quando a pessoa precisa abrir a boca para falar, a ação correta não é continuar ajustando parâmetros, mas sim trocar de modelo diretamente.
Diferenças centrais entre happyhorse-1.1-i2v e wan2.7-i2v
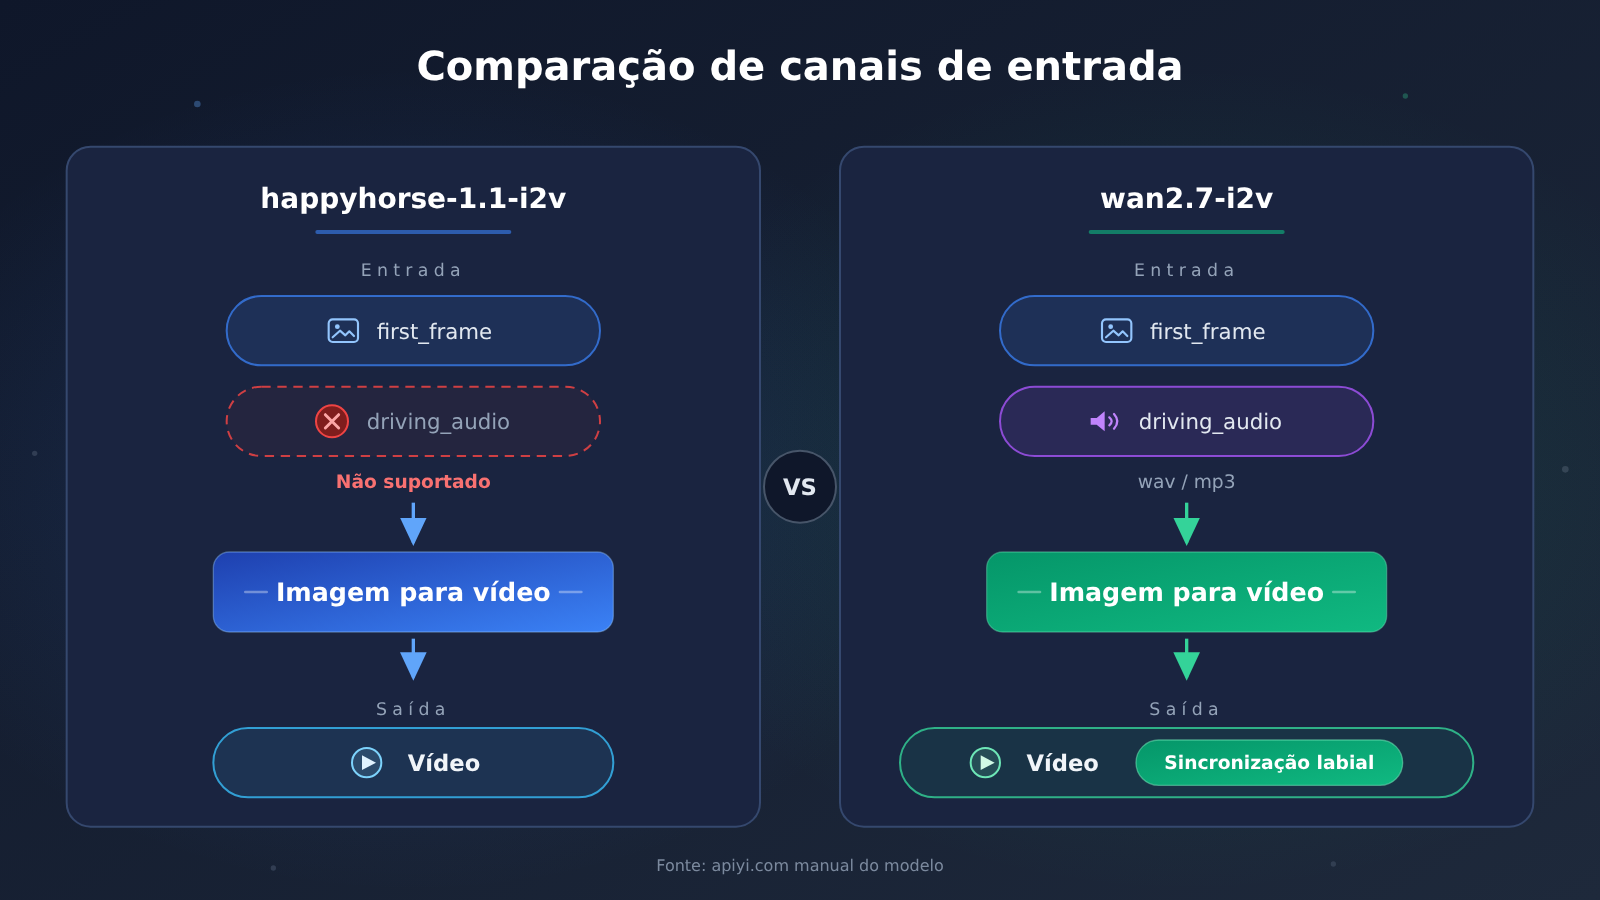
Os dois modelos são imagem para vídeo a partir do primeiro frame, com posicionamento sobreposto. O que realmente os separa é a linha da entrada de áudio:
| Dimensão de comparação | happyhorse-1.1-i2v |
wan2.7-i2v |
Conclusão da diferença |
|---|---|---|---|
| Tipo de tarefa | Vídeo gerado a partir do primeiro frame | Vídeo gerado a partir do primeiro frame | Posicionamento sobreposto, não decida quem é melhor pelo nome |
first_frame |
Aceita | Deve haver exatamente 1 | A entrada de imagem é indispensável nos dois |
driving_audio |
Não suportado | Suportado, opcional, 1 | A linha divisória da sincronização labial |
| Formato de áudio | Não aplicável | wav ou mp3 |
Confirme o formato antes de enviar os parâmetros |
| Cenário de sincronização labial | A documentação recomenda usar wan2.7-i2v |
A documentação designa esse modelo para o cenário | Basta esta linha para decidir a escolha |
A tabela acima e a imagem comparativa foram organizadas com base na documentação dos modelos da APIYI (apiyi.com), não são inferências empíricas.
O happyhorse-1.1-i2v é o caminho certo para “fazer um primeiro frame estático se mexer”: você entrega um first_frame e ele se encarrega de fazer a cena seguir adiante. Só que áudio não está na lista de entradas dele — a documentação registra que o recurso de direção por áudio não foi liberado para o i2v do HappyHorse. Em contrapartida, o wan2.7-i2v, além da mesma entrada de primeiro frame, abre uma porta a mais: driving_audio, permitindo que o ritmo dos movimentos da pessoa acompanhe o áudio.
As restrições do wan2.7-i2v também são mais específicas: na mídia deve haver exatamente 1 first_frame, no máximo 1 driving_audio, e o formato de áudio fica limitado a wav ou mp3. Essas restrições são bem rígidas; a vantagem é que, montando tudo conforme a documentação, você roda de primeira, sem precisar adivinhar.
Por que o happyhorse-1.1-i2v não aceita driving_audio
Se colocarmos as pistas da documentação na mesa, há pelo menos quatro camadas de informação que apontam para a mesma conclusão:
- A página do modelo afirma:
happyhorse-1.1-i2vé um modelo de geração de vídeo a partir do primeiro frame, que aceita apenasfirst_frame. - A mesma página marca explicitamente: não suporta
driving_audio. - A entrada de imagem para vídeo na página de visão geral também indica que não há suporte a áudio de condução.
- Para necessidades de sincronia labial ou rap, a documentação traz diretamente a recomendação de migração: use
wan2.7-i2v.
Aí voltamos àquele cenário clássico: você colocou driving_audio na requisição, o resultado não bateu com o esperado e começou a verificar item por item os materiais e os parâmetros. Independentemente da forma como a interface acabe respondendo, a causa raiz é uma só — esse campo não está no escopo de entrada do happyhorse-1.1-i2v. A documentação não deixou nenhuma brecha do tipo “basta mudar a forma de escrever”, e nem tentar de novo nem trocar os materiais altera os limites de entrada.
Se você fez a chamada na APIYI (apiyi.com), na hora de investigar compare primeiro, item por item, o ID do modelo e os nomes dos campos da requisição com a documentação, e só depois verifique os outros pontos. A maioria dos problemas de “o áudio não fez efeito” se resolve já nessa etapa, sem precisar dar voltas.
Sincronização labial com o driving_audio do wan2.7-i2v: guia de início rápido
Depois de confirmar a troca para o wan2.7-i2v, todo o fluxo se resume a quatro passos — e o foco está inteiramente na montagem da mídia:
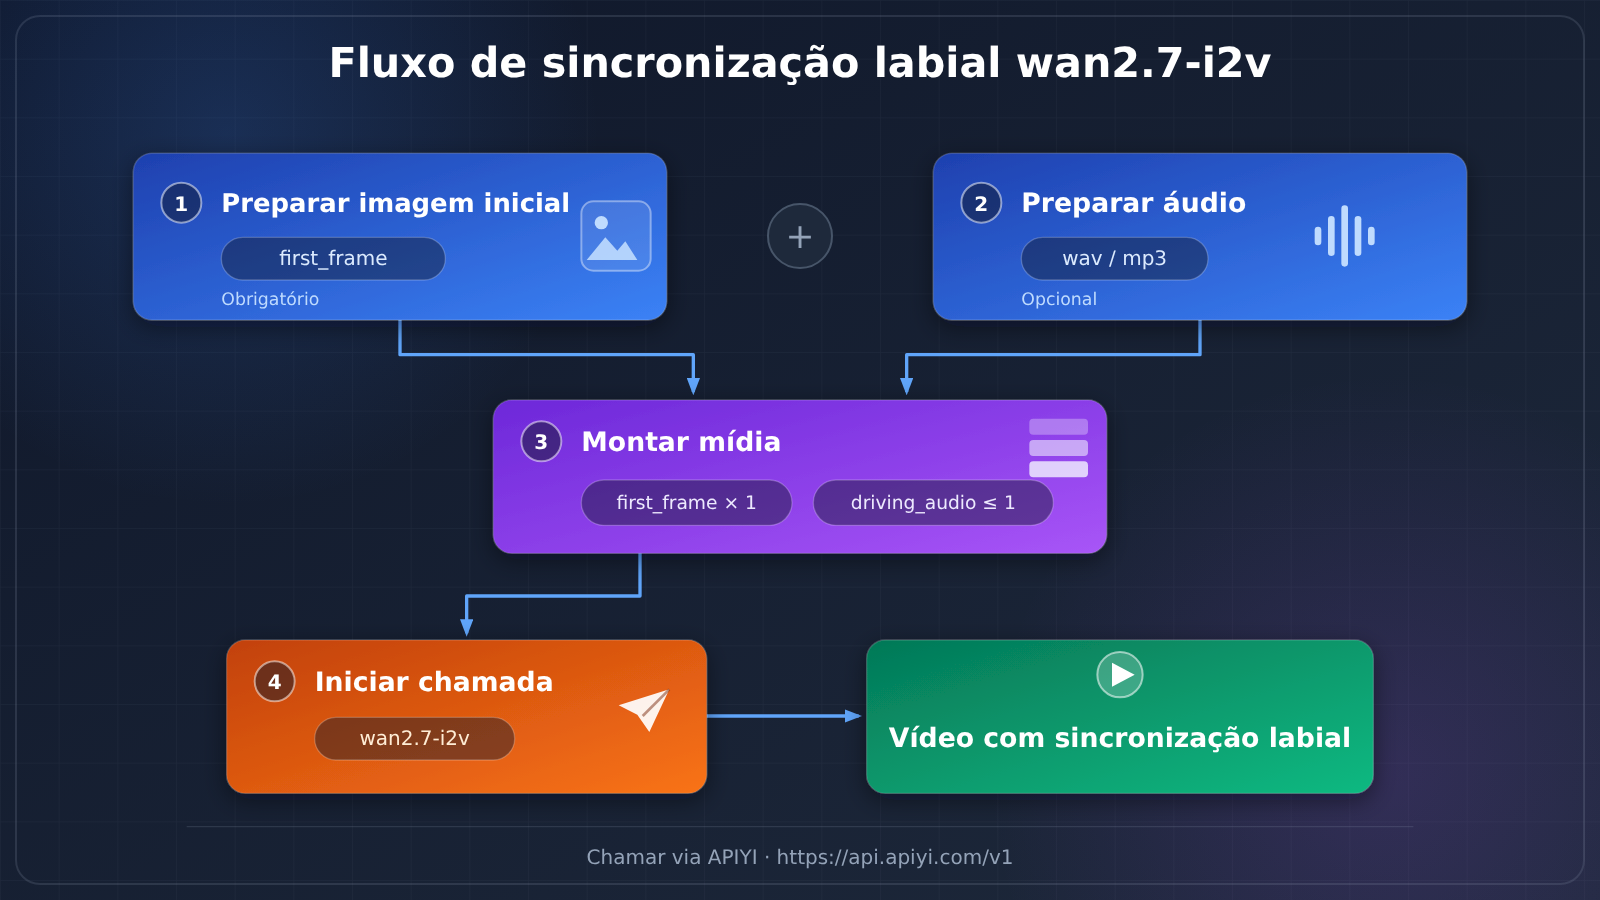
- Preparar a imagem do primeiro quadro: uma imagem com pessoa nítida e composição estável, usada como
first_frame. - Preparar o áudio: no formato
wavoump3, usado comodriving_audiopara conduzir a sincronização labial e o ritmo. - Montar a mídia: exatamente 1
first_framee no máximo 1driving_audio. Não coloque nada além disso. - Disparar a chamada: preencha o modelo com
wan2.7-i2v; ao chamar pela APIYI, o endereço base da interface éhttps://api.apiyi.com/v1.
| Campo | Obrigatório? | Restrição de quantidade | Requisito de formato |
|---|---|---|---|
first_frame |
Obrigatório | Exatamente 1 | imagem do primeiro quadro |
driving_audio |
Opcional | No máximo 1 | wav ou mp3 |
Os dois primeiros passos não têm mistério. O que realmente decide o sucesso é o passo 3. A documentação é bem rígida quanto à quantidade: first_frame precisa existir e ser exatamente 1, enquanto driving_audio é opcional e no máximo 1. Enviar imagens ou áudios a mais pode fazer a requisição sair do que foi combinado — não leve a intuição de “quanto mais, melhor” para a montagem dos parâmetros.
🚀 Início rápido: recomendo validar esse fluxo direto pela APIYI, em apiyi.com. A plataforma reúne as APIs de modelos populares como OpenAI, Claude e Gemini: uma única chave API dá acesso a vários modelos, com cobrança por uso e cota gratuita de teste para novos usuários. Rodar a sincronização labial com o
wan2.7-i2vsai praticamente de graça.
happyhorse-1.1-i2v ou wan2.7-i2v: recomendações por cenário
| Sua necessidade | Modelo recomendado | Entrada principal |
|---|---|---|
| Pessoa falando, sincronização labial com o áudio | wan2.7-i2v |
first_frame mais driving_audio |
| Rap, falas e outras performances rítmicas | wan2.7-i2v |
first_frame mais driving_audio |
| Fazer uma imagem estática se mover naturalmente, sem som | happyhorse-1.1-i2v |
apenas first_frame |
Cenários para continuar com happyhorse-1.1-i2v
Para tarefas de dinamização que não envolvem som, o happyhorse-1.1-i2v continua sendo a escolha certa. A função dele é transformar uma imagem de primeiro quadro em um vídeo com sensação de movimento, com uma entrada limpa que aceita apenas first_frame. Se o vídeo final vai receber dublagem ou simplesmente não precisa de áudio, ficar aqui é mais prático.
- Movimento guiado pelo primeiro quadro: fazer pessoas e cenários ganharem movimento natural a partir de uma imagem estática.
- Produção de conteúdo sem som: vídeo final com dublagem posterior, ou para exibições que não precisam de áudio.
Cenários para mudar para wan2.7-i2v
Sempre que o vídeo final precisar que a pessoa “se mova junto com o som”, a resposta é o wan2.7-i2v. A capacidade de condução por áudio documentada faz dele a única opção entre os dois modelos que aceita driving_audio, com sincronização labial e ritmo guiados diretamente pelo áudio.
- Sincronização labial: um retrato mais uma faixa de voz para gerar um vídeo de alguém falando.
- Performance guiada por áudio: conteúdos rítmicos como rap e falas, com os movimentos acompanhando o áudio.
Se você tem os dois tipos de necessidade, pode rodar o mesmo conjunto de materiais uma vez em cada modelo no APIYI — trocar de modelo não exige trocar a chave — e só depois de comparar definir qual usar para cada caso.
happyhorse-1.1-i2v e wan2.7-i2v: recomendações de decisão
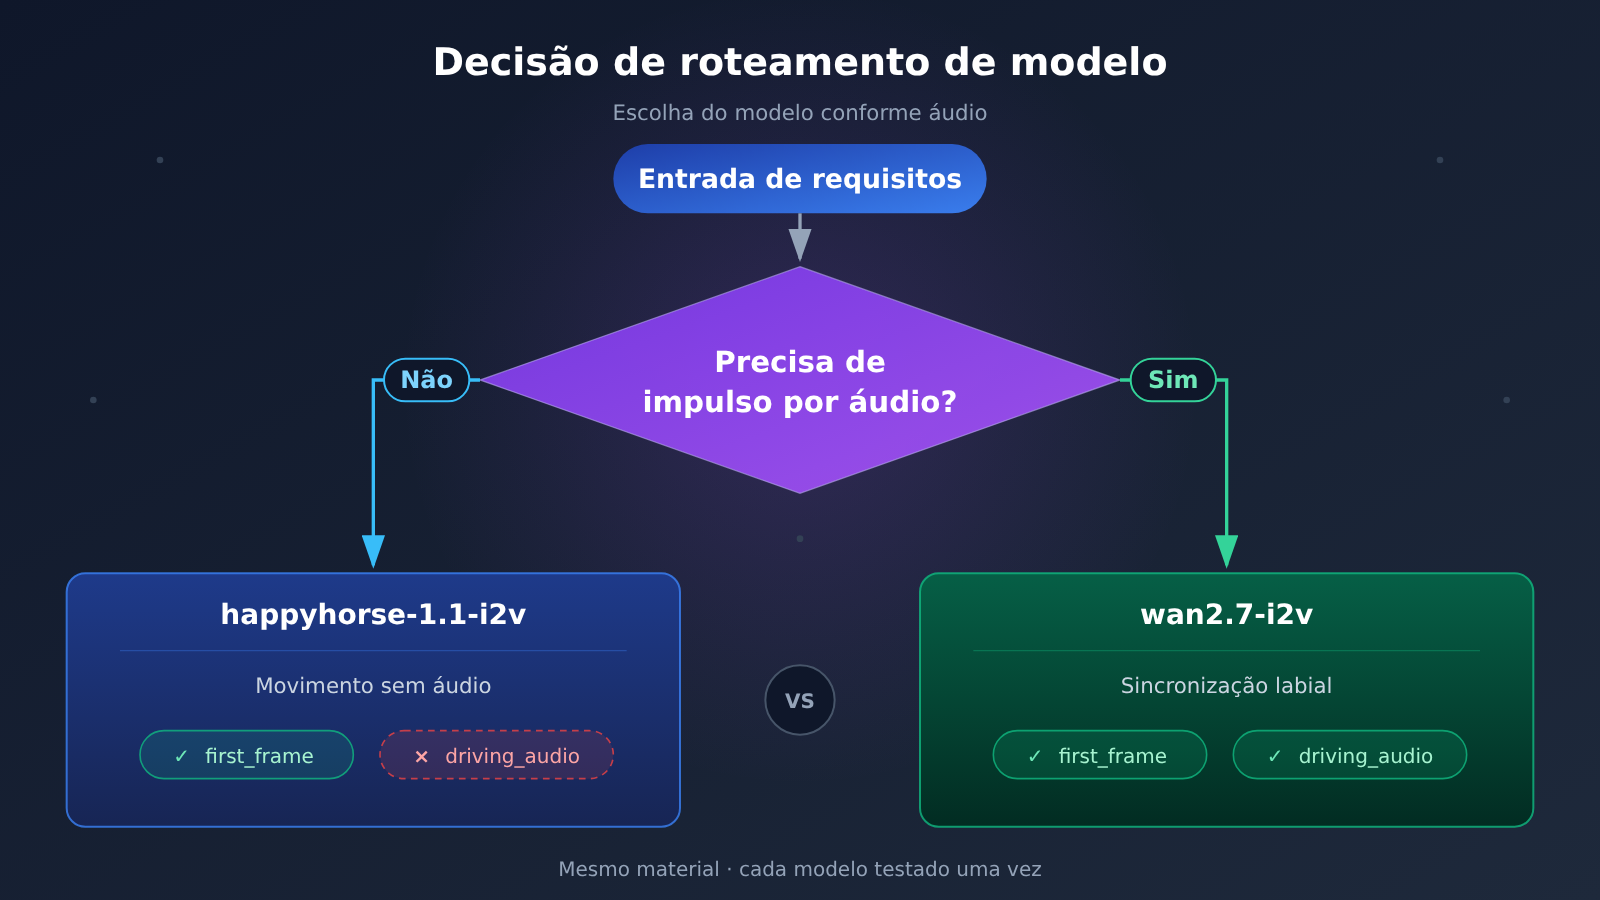
| Situação atual | Ação recomendada |
|---|---|
| A sincronização labial é requisito obrigatório | Use wan2.7-i2v diretamente, com driving_audio |
| Só precisa que a imagem se movimente | Fique com happyhorse-1.1-i2v e passe apenas first_frame |
Já passou o áudio para happyhorse-1.1-i2v, mas não funciona |
Pare de tentar de novo e troque para wan2.7-i2v; isso não é questão de parâmetro |
O cerne da decisão cabe em uma frase: pergunte primeiro “esta cena precisa que alguém fale?”. Se o som precisa participar da atuação, a resposta é wan2.7-i2v; se não, happyhorse-1.1-i2v continua dando conta do texto para imagem a partir do primeiro quadro. Entregar o áudio ao modelo certo economiza muito mais tempo do que insistir em parâmetros em qualquer modelo.
💡 Sugestão de escolha: quando estiver em dúvida sobre o resultado, não fique só na dedução em cima da documentação. Rode um caso mínimo de cada um direto na APIYI apiyi.com e decida com base em dois resultados reais — é o caminho mais confiável.
Perguntas frequentes sobre driving_audio
Q1: O que é o happyhorse-1.1-i2v?
É um modelo de geração de vídeo a partir do primeiro quadro: a entrada aceita apenas `first_frame`. A documentação deixa explícito que ele não suporta `driving_audio` — o áudio como driver está fora do seu escopo de capacidade.
Q2: Qual é a diferença entre happyhorse-1.1-i2v e wan2.7-i2v no quesito áudio como driver?
A documentação marca o áudio como driver como capacidade exclusiva do `wan2.7-i2v` e, ao mesmo tempo, registra que o i2v do HappyHorse não suporta. Ou seja: `wan2.7-i2v` recebe `driving_audio`, `happyhorse-1.1-i2v` não recebe. Para saber se outros modelos suportam, vale a documentação de cada um — não presuma pelo nome da série.
Q3: O que acontece se eu passar `driving_audio` para o happyhorse-1.1-i2v?
A resposta da documentação é direta: não suporta, aceita apenas `first_frame`. Em vez de ficar estudando os detalhes de cada resposta de erro, é melhor mandar esse conjunto de materiais para o `wan2.7-i2v` — a mesma imagem e o mesmo áudio passam a ter utilidade imediatamente.
Q4: Quais são os requisitos de formato e quantidade do `driving_audio`?
O formato de áudio deve ser `wav` ou `mp3`; na mídia é preciso haver exatamente 1 `first_frame` e no máximo 1 `driving_audio`. Monte a requisição seguindo essas restrições e a chance de acertar de primeira é maior.
Q5: Como chamar o wan2.7-i2v rapidamente via API?
A recomendação é começar por uma plataforma agregadora:
1. Cadastre-se em APIYI apiyi.com e obtenha a chave API; novos usuários têm cota gratuita de teste;
2. Use `https://api.apiyi.com/v1` como endereço base da interface;
3. Monte a mídia com “1 `first_frame` + 1 `driving_audio`” e preencha o modelo com `wan2.7-i2v`.
Q6: Todos os modelos da série Wanxiang aceitam áudio desse jeito?
Não dá para generalizar assim. A documentação atribui o áudio como driver apenas ao `wan2.7-i2v`; para outros modelos, consulte a documentação correspondente — não tente adivinhar capacidades pelo nome da série.
Q7: Onde conferir as descrições de capacidade desses dois modelos?
A APIYI documenta os limites de capacidade na documentação dos modelos: acesse docs.apiyi.com e confira item por item. Dar uma olhada na documentação antes de escolher o modelo custa muito menos do que investigar depois de tropeçar.
happyhorse-1.1-i2v e driving_audio: principais pontos (Key Takeaways)
- Limite de capacidade: o
happyhorse-1.1-i2vaceita apenasfirst_frame;driving_audionão está entre suas entradas. - Capacidade exclusiva: a condução por áudio é do
wan2.7-i2v— para sincronia labial, é nele que você deve ir. - Restrições de mídia: exatamente 1
first_frame, no máximo 1driving_audio, e o áudio deve serwavoump3. - Guia de migração: a documentação recomenda trocar o
happyhorse-1.1-i2vpelowan2.7-i2vem cenários de sincronia labial ou rap. - Como validar: rode um caso mínimo com o mesmo conjunto de materiais em cada modelo; com os dois resultados na mão, a escolha fica definida.
Conclusão
Sobre a ideia de “fazer a imagem falar”, três conclusões valem levar para casa:
- Limite de entrada: o
happyhorse-1.1-i2vnão aceitadriving_audio, só reconhecefirst_frame— esse é o limite de capacidade documentado. - O lugar certo: sincronia labial e condução por áudio são capacidades exclusivas do
wan2.7-i2v; basta uma imagem mais um trecho emwavoump3para começar. - Como diagnosticar: se o áudio não surtir efeito, primeiro verifique a correspondência entre o modelo e os campos, em vez de tentar repetidamente.
Se estiver em dúvida na escolha, rode um caso mínimo em cada modelo e então decida. Recomendamos validar rapidamente pela APIYI apiyi.com: a plataforma oferece cota de teste gratuita e acesso unificado a vários modelos, e trocar de modelo não exige trocar a chave.
📚 Referências
- Documentação APIYI · HappyHorse imagem para vídeo
- Link:
docs.apiyi.com/api-capabilities/happyhorse/image-to-video.md -
Descrição: definição de entrada do
happyhorse-1.1-i2ve a fonte original do trecho que diz quedriving_audionão é suportado. -
Documentação APIYI · Wan imagem para vídeo
- Link:
docs.apiyi.com/api-capabilities/wan/image-to-video.md -
Descrição: restrições de quantidade e formato de
first_frameedriving_audionowan2.7-i2v. -
Documentação APIYI · Visão geral do HappyHorse
- Link:
docs.apiyi.com/api-capabilities/happyhorse/overview.md - Descrição: anotação geral sobre a capacidade de condução por áudio no item de imagem para vídeo.
Autor: Equipe técnica da APIYI
Contato técnico: Fale conosco pela página inicial do site APIYI; mais materiais estão disponíveis no centro de documentação docs.apiyi.com


