
Nota do autor: este texto interpreta o mecanismo Claude Dreaming, revelado no blog de engenharia da Anthropic. Ele cobre a estrutura de memória em 4 camadas, os dados dos experimentos CL-Bench e Wiki, casos de correção de erros e riscos de engenharia. Também mostra como você pode se inspirar na ideia de “organizar a memória entre sessões” para montar o seu próprio sistema de memória para Agents.
Em 6 de novembro de 2026, a Anthropic publicou no blog de engenharia o artigo The components of agent memory. Pela primeira vez, ele explica de forma sistemática como o Claude Dreaming corrige erros, organiza a memória e constrói uma base de conhecimento entre uma sessão e outra. A conta oficial no X publicou o artigo ao mesmo tempo, e a documentação do Claude Managed Agents já traz uma interface de prévia de pesquisa para os Dreams.
Isto não é mais um conceito de “colocar um banco vetorial no Agent”. A Anthropic usa vários grupos de experimentos para mostrar que, para um Agent de longa execução, guardar o histórico não basta. É preciso verificar, corrigir, integrar e organizar a memória continuamente, para que a informação antiga realmente ajude na próxima tarefa.
Valor central: ao terminar a leitura, você vai conhecer a estrutura de memória em 4 camadas do Claude Dreaming e os principais dados experimentais. Também vai saber em que situações ele funciona, em quais ele atrapalha e como aproveitar a ideia no seu próprio Agent.
Claude Dreaming: visão geral rápida
| Item | Detalhes |
|---|---|
| Data de publicação | 06/11/2026, blog de engenharia da Anthropic (Anthropic Engineering) |
| Conceito central | Dreaming: um processo em segundo plano que usa o histórico para reorganizar e manter a memória entre sessões |
| Camadas de memória | 4 camadas: Transcripts, Memory notes, Memory representations e Injected context |
| Formato do produto | Dreams no Claude Managed Agents, atualmente em Research Preview, com acesso mediante solicitação |
| Material complementar | Cookbook oficial “Dreaming with a dynamic workflow”, publicado em 02/11/2026 |
| Quem é afetado | Agents de longa duração, tarefas que atravessam várias sessões e a construção de bases de conhecimento internas em empresas |
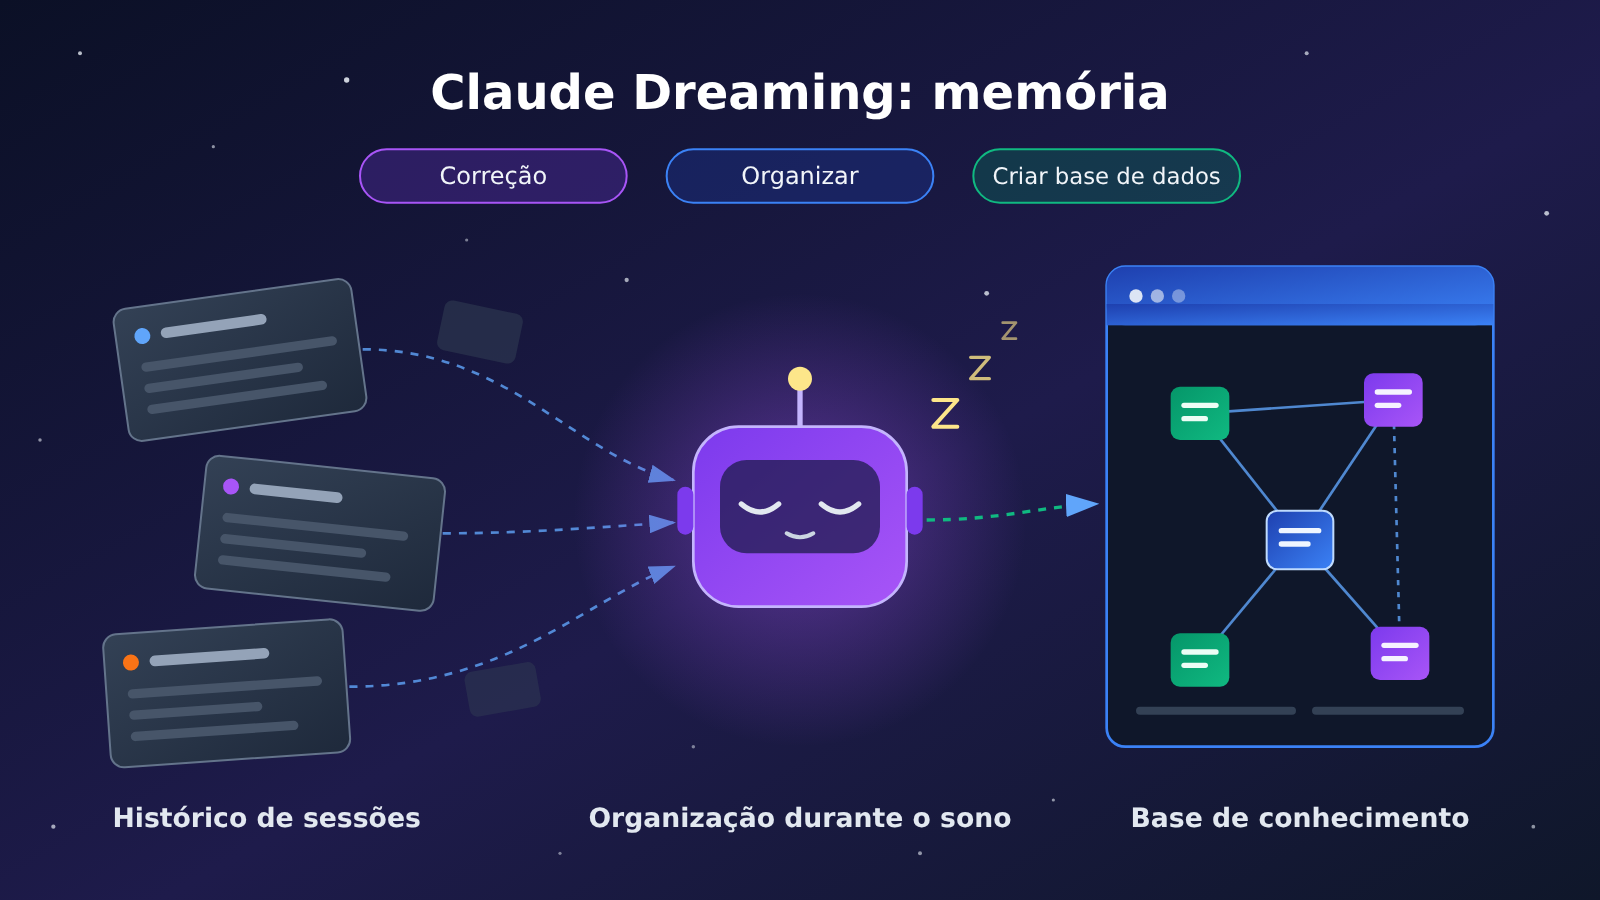
Antes de entender o Dreaming, vale esclarecer alguns termos. Transcript é o registro completo de uma sessão, incluindo as entradas do usuário, as saídas do Agent, as chamadas de ferramentas e seus resultados. Memory Note é o conjunto de fatos, regras e experiências persistentes extraídos do histórico. Memory Store é o espaço de armazenamento persistente que guarda os arquivos de memória entre sessões. A ideia do Dreaming é parecida com o Sleep-time Compute: usar poder de processamento ocioso, fora das interações principais, para trabalhar com o contexto que já existe.
Por que a memória de um Agent não pode se resumir a guardar conversas antigas
A primeira reação de muitas equipes ao construir memória para Agents é salvar todas as conversas e buscar quando precisar. O problema é que logs do histórico, resumos de sessão e conhecimento pesquisável são três coisas diferentes. O log é só um amontoado de eventos brutos, o resumo pode perder detalhes importantes, e apenas o conhecimento verificado e organizado consegue ajudar de forma consistente na próxima tarefa.
Guardar todas as conversas diretamente traz três tipos de risco: informação duplicada, estados antigos que ficam desatualizados e erros que se acumulam. Um registro errado é lido repetidamente pelas sessões seguintes, e o erro passa a ser tratado como fato e continua sendo executado. A conclusão da Anthropic é direta: memória não é melhor só porque é maior; ela precisa ser selecionada, verificada e organizada.
O experimento com Pokémon Red mostra bem essa diferença. Por volta dos 10.000 passos, o Sonnet 3.7 tinha criado 413 arquivos e 225 pastas, e conseguiu apenas 1 insígnia. O Fable 5 criou só 9 arquivos de memória comuns, 2 pastas e um global.md, e conseguiu 4 insígnias.
A diferença está em “o que lembrar”. O Sonnet 3.7 salvou muito estado de jogo em constante mudança, e esses registros ficaram obsoletos rapidamente. O Fable 5 deu mais atenção a estratégias, regras já verificadas e planos de ação. Disso sai um princípio de design: a memória de longo prazo deve priorizar o conhecimento difícil de recuperar a partir do ambiente atual, e o estado em tempo real, que pode ser lido diretamente a cada vez, não precisa ser guardado.
Os 4 níveis do sistema de memória do Claude
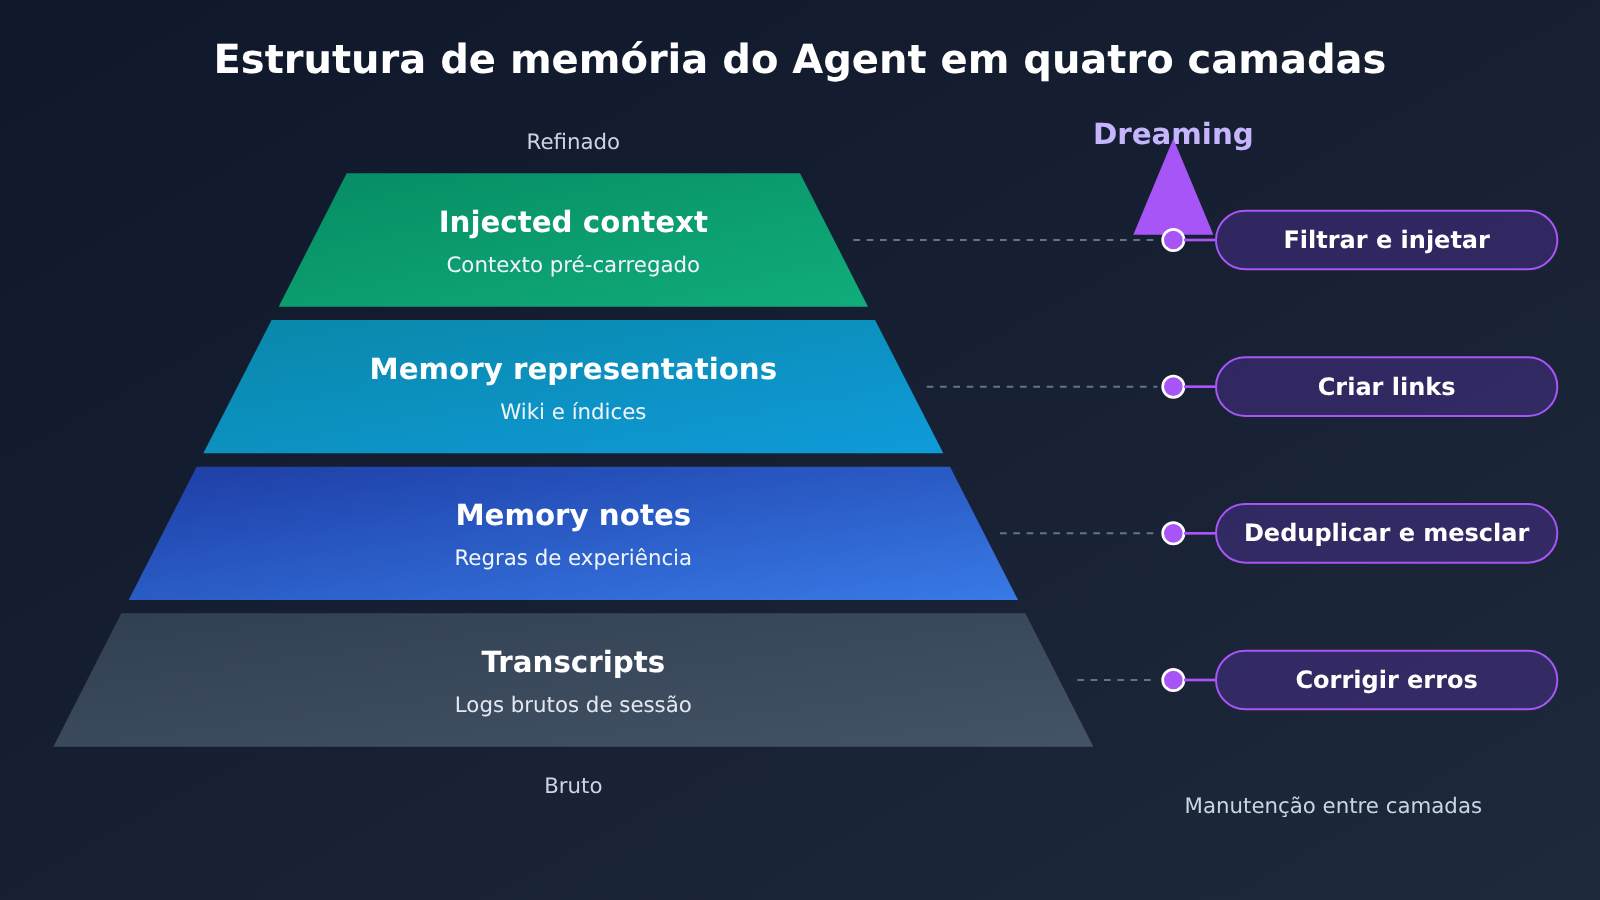
A Anthropic divide a memória do Agent em 4 camadas. Cada uma tem uma responsabilidade, uma frequência de escrita e um custo de leitura diferentes.
| Camada | Conteúdo | Função | Forma de leitura |
|---|---|---|---|
| Transcripts | Registro completo das sessões | Log de eventos pesquisável, a evidência bruta para rastrear fatos | Busca sob demanda |
| Memory notes | Fatos importantes, experiências e regras anotados durante as tarefas | Acumula experiência reutilizável | Leitura sob demanda |
| Memory representations | Representações estruturadas, como wiki, índices e links | Organiza as relações entre os conhecimentos e permite busca entre documentos | Navegação e busca |
| Injected context | Um pequeno conjunto de memórias de alto valor | Carregado antecipadamente quando uma nova sessão começa | Injeção automática |
Essas 4 camadas formam um caminho que vai do “bruto” ao “refinado”. O Transcript tem a informação mais completa, mas é volumoso e cheio de ruído. O Injected context é o mais enxuto, só que cada item dele ocupa espaço na janela de contexto da nova sessão, então ele fica reservado para as informações com maior saliência (Salience).
O papel do Dreaming é a manutenção entre camadas. Ele volta aos Transcripts para corrigir registros antigos, mescla informações duplicadas nas Memory notes, constrói a wiki e os índices, e decide quais conteúdos merecem ser injetados previamente no início de uma nova sessão (Context Injection).
Como o Claude Dreaming corrige erros, organiza e constrói bases de conhecimento
Correção de erros no Dreaming: o caso da navegação em Mt. Moon
A Anthropic documentou um erro de navegação. O Agent anotou errado a posição do Pokémon Center perto de Mt. Moon, e as sessões seguintes continuaram tentando a mesma rota errada, de novo e de novo.
Depois que o Dreaming revisou os Transcripts do histórico, ele encontrou o registro original com o erro e corrigiu o arquivo de memória. O Agent que passou a usar a memória corrigida chegou a Cerulean City na operação de número 1.935. A versão sem correção falhou várias vezes seguidas e acabou não cumprindo o objetivo.
Esse caso mostra que o Dreaming faz mais do que resumir. Ele consegue voltar à experiência original e verificar se a memória ainda se sustenta. Com isso, os Transcripts salvos ganham um novo uso: viram uma base de evidências que pode ser consultada e revisada quantas vezes for preciso.
Efeito da memória no Claude: dados do experimento CL-Bench
A Anthropic testou o efeito da memória usando tarefas de banco de dados do CL-Bench 1.0. A tabela abaixo traz o mean reward divulgado oficialmente.
| Modelo | Sem memória | Com memória | Ganho |
|---|---|---|---|
| Opus 5.5 | 0.655 | 0.838 | +0.183 |
| Sonnet 5.5 | 0.644 | 0.833 | +0.189 |
| Opus 5 | 0.564 | 0.828 | +0.264 |
| Opus 4.7 | 0.383 | 0.700 | +0.317 |
| Sonnet 5 | 0.306 | 0.610 | +0.304 |
| Sonnet 4.6 | 0.330 | 0.364 | +0.034 |
Vale lembrar que esses números valem só para essa tarefa e não são uma nota geral da capacidade de memória de um Agent. O que mais chama atenção é outro fenômeno: quanto mais forte o modelo, mais ele tende a registrar regras já verificadas, causas de erros e armadilhas que podem aparecer no futuro, em vez de copiar o histórico da conversa. O ganho do Sonnet 4.6 foi bem pequeno, o que indica que o efeito de um sistema de memória está muito ligado à “qualidade de registro” do próprio modelo.
Resultado do Dreaming na construção de uma base de conhecimento Wiki
O maior experimento usou cerca de 350.000 arquivos internos, somando aproximadamente 420M de Tokens. A Anthropic construiu um Wiki de conhecimento aos poucos, ao longo de 128 sessões de Dreaming, e depois avaliou o resultado com tarefas de perguntas e respostas.
| Método de recuperação | Nota | Observação |
|---|---|---|
| Wiki sozinho (antes → depois da construção) | 13% → 48% | Efeito claro conforme o Wiki foi tomando forma |
| Search sozinho | 53% | Linha de base |
| Search + Wiki (antes → depois da construção) | 54% → 61% | Economia média de cerca de 20.000 Tokens por pergunta |
| Tarefas de síntese entre arquivos (fusões e aquisições) | Wiki 87% vs Search puro 73% | Maior vantagem na síntese entre documentos |
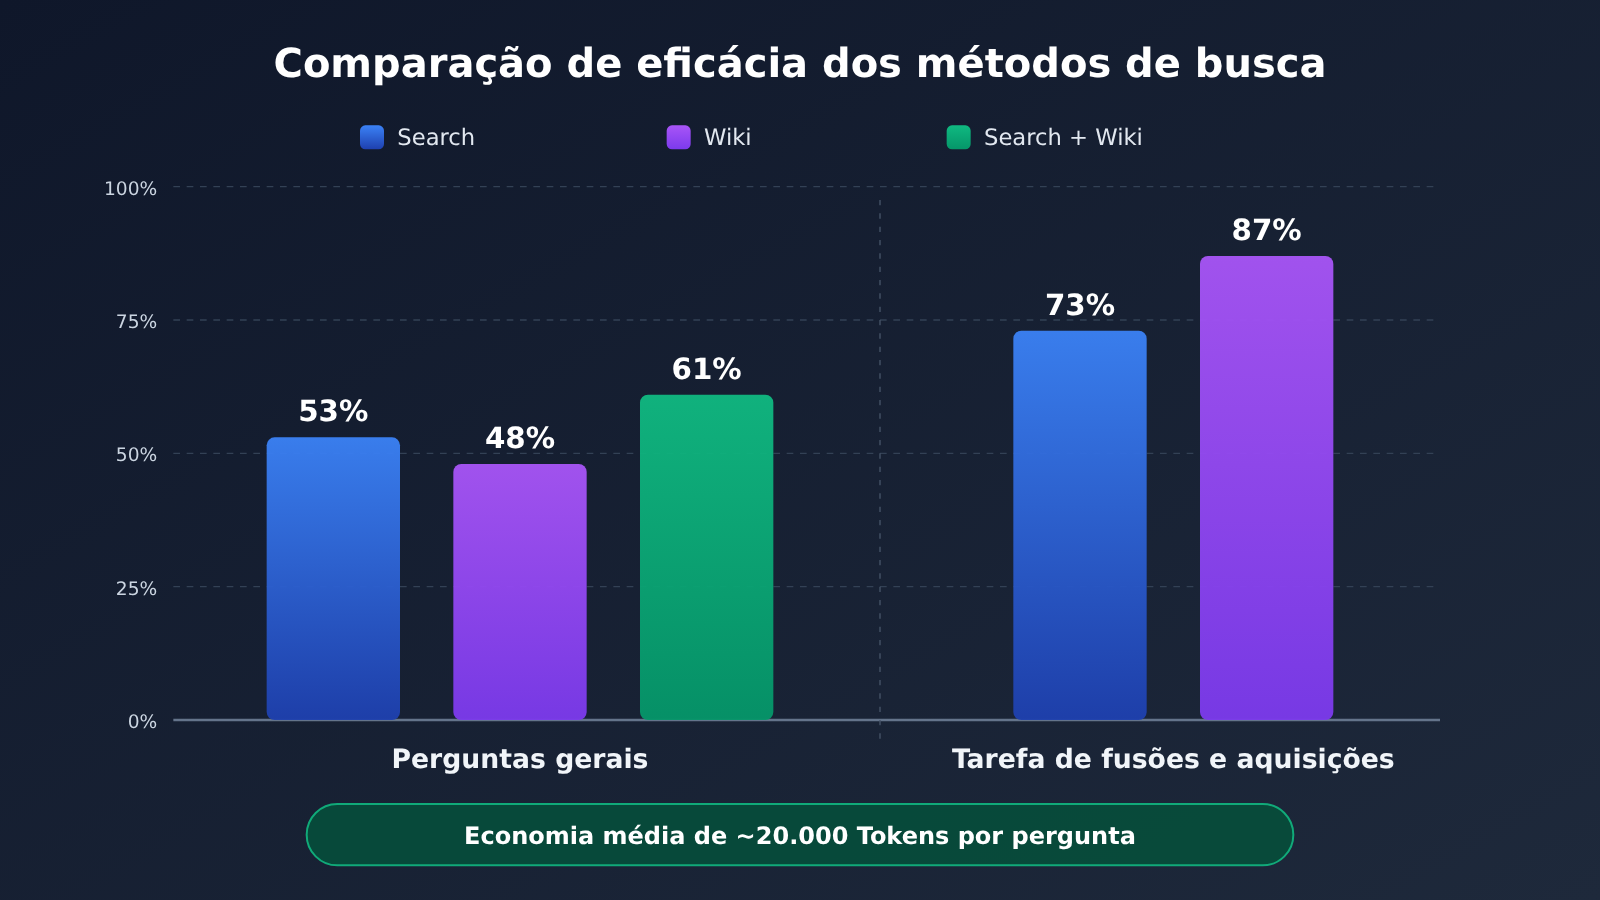
📊 Sobre o gráfico: todos os dados acima vêm de experimentos públicos do blog de engenharia da Anthropic. Se quiser fazer uma validação em pequena escala no seu próprio corpus, dá para invocar modelos Claude pelo APIYI (apiyi.com) e comparar duas abordagens, “só recuperação” e “recuperação + Wiki organizado”, tanto em resultado quanto em consumo de Tokens.
O valor da memória estruturada aparece principalmente em dois pontos. Primeiro, ela cria links e índices, o que permite sintetizar informações espalhadas por vários arquivos. Segundo, reduz o volume de texto original que precisa ser relido a cada recuperação, e isso derruba o custo em Tokens.
Análise de impacto: por que a organização de memória do Claude Dreaming às vezes ajuda e às vezes atrapalha
A Anthropic não vende o Dreaming como solução universal, e o texto traz vários contraexemplos. Para a prática de engenharia, essa parte talvez valha mais do que os dados positivos.
5 tipos de risco de engenharia na organização de memória
- Registro em excesso: modelos como o Sonnet 3.7 guardam muito estado volátil. A memória incha rápido e fica obsoleta rápido também.
- Informação desatualizada: o ambiente mudou, mas a memória continua presa à versão antiga. Sem checagem da fonte, ela segue enganando o Agent.
- Sobrescrita em escrita compartilhada: num experimento de organização de contratos, vários Agents escreviam ao mesmo tempo na mesma tabela de resumo, e dos 57 fatos-chave só 41 foram preservados, cerca de 72%. Depois que cada contrato passou a ter uma página própria, com escrita feita por um único Agent e preservação das cláusulas originais, os 57 fatos foram mantidos.
- Inchaço do Wiki: em um dos testes, os arquivos originais somavam apenas 115 KB, mas o Wiki gerado chegou a 203 KB. A organização acabou aumentando a quantidade de informação.
- Nenhum ganho em tarefas simples: quando um único arquivo já permite encontrar a resposta diretamente, o Wiki não trouxe melhora perceptível e só aumentou o custo de manutenção.
O que isso muda para quem desenvolve
- A memória precisa de camadas: logs brutos, regras de experiência, conhecimento estruturado e contexto pré-injetado ficam separados, cada um com sua própria estratégia de escrita e leitura.
- A origem precisa ser rastreável: toda memória deve poder ser ligada de volta ao Transcript correspondente. Isso é pré-requisito para corrigir erros.
- A escrita deve ser serializada ou particionada: evite que vários Agents escrevam ao mesmo tempo no mesmo arquivo e dê preferência à estrutura “uma entidade, uma página”.
- Limpeza periódica: o Wiki e as Memory notes também precisam de deduplicação, fusão e descarte. Do contrário, o volume só cresce.
O que isso muda para o setor
- O foco das pesquisas sobre memória de Agents está saindo de “recuperar com precisão” e indo para “a memória em si está correta e está sendo mantida?”.
- O Sleep-time Compute tem potencial para virar arquitetura comum: o custo da organização vai para horários ociosos, aliviando a carga de contexto durante a interação principal.
- A memória estruturada combina melhor com tarefas que envolvem vários arquivos, várias rodadas e acúmulo de longo prazo. Para perguntas simples e pontuais, a recuperação pura continua sendo a opção mais econômica.
Como desenvolvedores podem aplicar a ideia do Claude Dreaming nos próprios agentes
Requisitos para usar o Dreams (pré-visualização de pesquisa oficial)
De acordo com a documentação atual da Anthropic, o Dreams é um recurso do Claude Managed Agents. Ele está em Research Preview, então é preciso solicitar acesso. Nas chamadas, você precisa enviar dois Beta Headers: managed-agents-2026-04-01 e dreaming-2026-04-21.
A entrada é um Memory Store já existente mais de 1 a 100 sessões históricas. A saída é um novo Memory Store, e o original não é modificado. A tarefa roda de forma assíncrona e costuma levar de alguns minutos a algumas horas. A cobrança segue o preço padrão por token do modelo escolhido. Os modelos suportados são principalmente o Opus 5.5 e o Sonnet 5.5. Além disso, o recurso ainda não tem qualificação para Zero Data Retention nem HIPAA, então avalie bem os riscos antes de processar dados sensíveis.
Design do workflow dinâmico no Cookbook
O Cookbook oficial traz um workflow multi-Agent que você mesmo pode montar. Por padrão, o Lead Agent orquestra o fluxo, cada Analyzer Agent cuida de uma Transcript, e o Organizer Agent fica responsável por remover duplicatas, corrigir links e manter o índice. O Memory Store já organizado é montado na Session seguinte, normalmente em modo somente leitura. Também dá para disparar tudo com Cron, por exemplo organizando todas as noites as Sessions do dia anterior.
O Cookbook também traz exemplos de custo. Com 11 Transcripts de exemplo, somando 283 KB, a execução leva cerca de 2,5 minutos e custa aproximadamente US$ 0,36. Com 50 Transcripts longas, cerca de 12 MB, usando as configurações de otimização de custo, o gasto fica em torno de US$ 8, com duração de aproximadamente 10 minutos. Esses números vêm de experimentos específicos e não são um preço fixo.
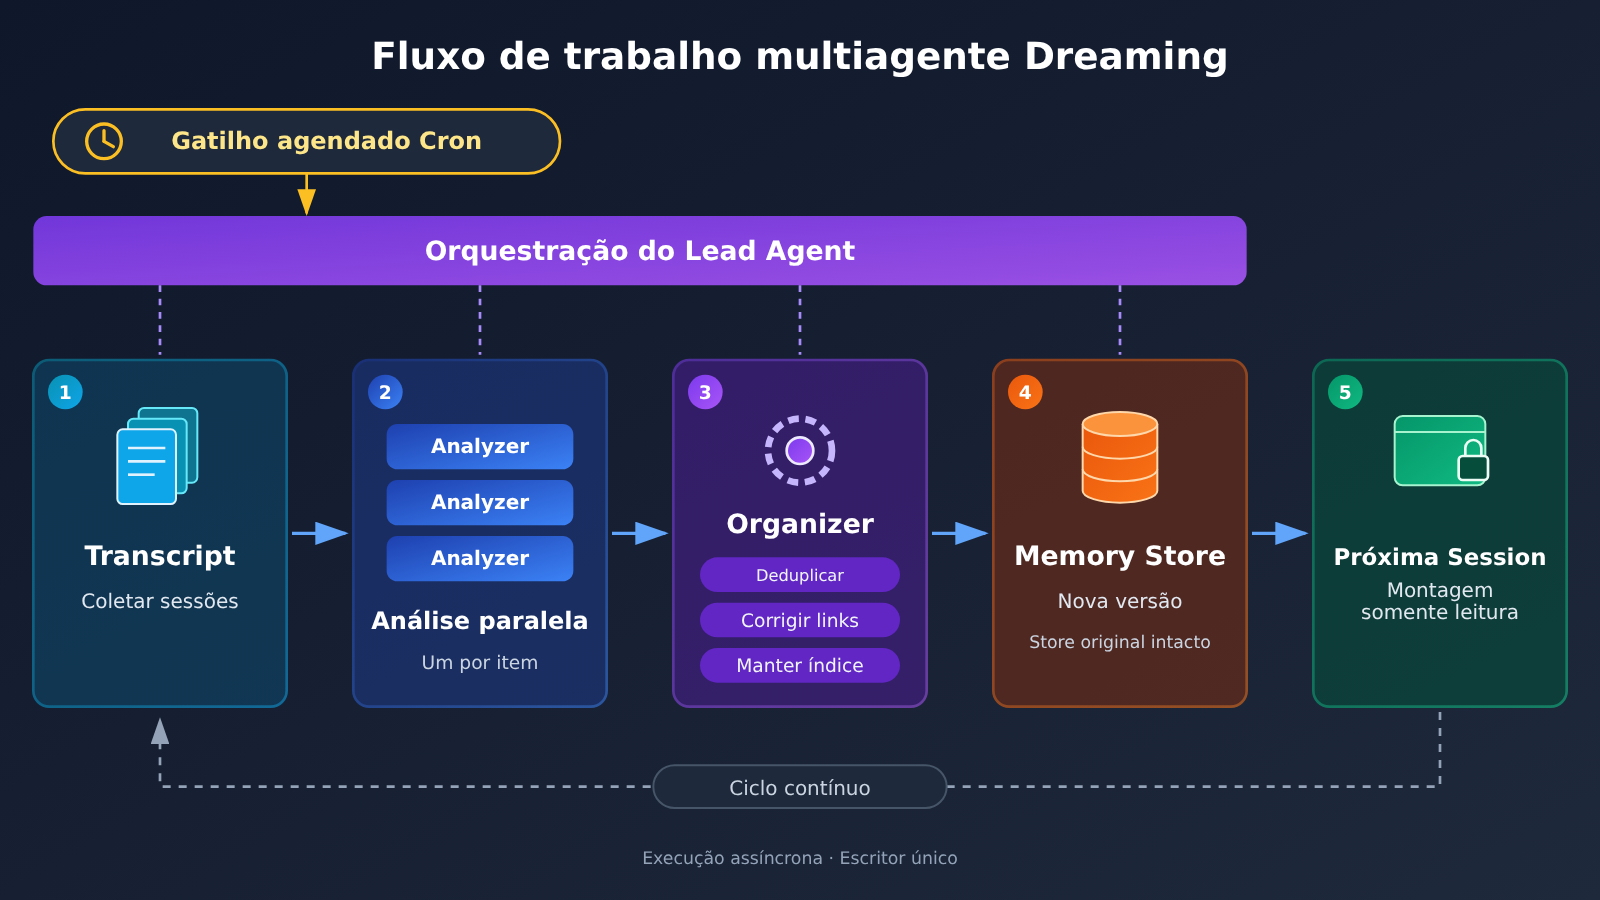
Criando um fluxo próprio de consolidação de memória entre sessões com modelos Claude
Um esclarecimento antes de começar: a APIYI oferece a interface de invocação dos modelos da série Claude, o que não significa que ela ofereça Managed Agents, Memory Stores ou a API de Dreams. Mesmo assim, a ideia central do Dreaming (ler o Transcript em segundo plano, extrair regras já validadas e entregar tudo a um único escritor para organizar) dá para implementar sozinho, só com chamadas normais ao modelo. Abaixo, um exemplo mínimo em que o Claude analisa o registro de uma sessão e devolve memórias candidatas.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

transcript = open("session_001.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="YOUR_CLAUDE_MODEL",  # Substitua por um modelo Claude disponível na lista de modelos
    messages=[
        {"role": "system", "content": "只提炼经过验证的规则、错误原因和未来陷阱,忽略易变状态,每条注明来源行号。"},
        {"role": "user", "content": transcript},
    ],
)
print(resp.choices[0].message.content)
Ver o código completo (Analyzer + Organizer com escritor único)
import json
import pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)
MODEL = "YOUR_CLAUDE_MODEL"
MEMORY_DIR = pathlib.Path("memory_store")
MEMORY_DIR.mkdir(exist_ok=True)

ANALYZER_PROMPT = """你是记忆分析器。阅读会话记录,输出 JSON 数组,每项包含:
topic(实体或主题名), rule(经过验证的规则/错误原因/陷阱), evidence(原文出处)。
不要记录每次都能直接从环境读取的实时状态。"""

ORGANIZER_PROMPT = """你是记忆整理器。给定某个主题的旧记忆页面和新候选条目:
1. 与旧记录冲突时,以 evidence 更可靠者为准,并注明修正原因;
2. 合并重复条目;
3. 保留原始证据引用;
输出更新后的 Markdown 页面全文。"""

def analyze(transcript: str) -> list:
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ANALYZER_PROMPT},
            {"role": "user", "content": transcript},
        ],
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return []

def organize(topic: str, items: list) -> None:
    # Uma página por tópico, escrita em série por um único fluxo, evitando sobrescritas concorrentes
    page = MEMORY_DIR / f"{topic}.md"
    old = page.read_text(encoding="utf-8") if page.exists() else ""
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ORGANIZER_PROMPT},
            {"role": "user", "content": f"旧页面:\n{old}\n\n新条目:\n{json.dumps(items, ensure_ascii=False)}"},
        ],
    )
    page.write_text(resp.choices[0].message.content, encoding="utf-8")

def nightly_dream(transcript_files: list) -> None:
    grouped = {}
    for f in transcript_files:
        for item in analyze(pathlib.Path(f).read_text(encoding="utf-8")):
            grouped.setdefault(item.get("topic", "misc"), []).append(item)
    for topic, items in grouped.items():
        organize(topic, items)

# Pode ser disparado todas as noites pelo Cron; na próxima sessão, carregue em modo somente leitura a página de índice em memory_store
nightly_dream(["session_001.txt", "session_002.txt"])
🚀 Dica para começar rápido: ao montar o protótipo, você pode usar a mesma chave API na APIYI (apiyi.com) para testar diferentes modelos Claude nos papéis de Analyzer e Organizer. Compare qual combinação extrai regras mais precisas e gasta menos Tokens antes de decidir a configuração de produção.
A diferença entre as duas abordagens pode ser resumida na tabela abaixo:
| Comparação | Anthropic Managed Agents Dreams | Memória própria montada sobre a API de modelos |
|---|---|---|
| Como obter | Prévia de pesquisa, exige pedido de acesso e Beta Header | Chamada direta à interface dos modelos Claude |
| Armazenamento da memória | Memory Store oficial, gera um novo Store como saída | Você implementa com arquivos, banco de dados ou Wiki |
| Agendamento e concorrência | Tarefas assíncronas oficiais | Você implementa Cron, filas e controle de escrita única |
| Correção de erros e permissões | Já vêm embutidos no fluxo oficial | Você precisa projetar a verificação de fontes e as permissões |
| Plataformas disponíveis | Anthropic oficial | APIYI apiyi.com (invocação do modelo), API oficial |
Perguntas frequentes (FAQ) sobre o Claude Dreaming
P1: O que é o Claude Dreaming?
O Dreaming é um processo de manutenção de memória em segundo plano, proposto pela Anthropic, que roda entre uma sessão e outra. Ele usa os Transcripts do histórico para corrigir registros antigos, juntar informações duplicadas, montar Wikis e índices, e selecionar o contexto de maior valor para ser injetado de antemão nas novas sessões.
P2: Qual é a diferença entre o Dreaming e um resumo de sessão ou uma busca vetorial comuns?
O resumo só comprime informação, e a busca só se encarrega de encontrá-la. O Dreaming volta ao Transcript original para verificar se a memória ainda se sustenta — no caso do Mt. Moon, por exemplo, ele corrigiu uma direção que estava errada. Ele também cria links entre documentos: em tarefas de síntese entre arquivos, o Wiki fez 87% dos pontos, contra 73% da busca pura.
P3: Já dá para usar o Claude Dreaming?
O blog de engenharia sobre o tema foi publicado em 6 de novembro de 2026. Por enquanto, o Dreams aparece no Claude Managed Agents como Research Preview: é preciso pedir acesso e enviar dois Beta Headers para fazer a chamada.
P4: Sem acesso ao Managed Agents, dá para aproveitar a ideia do Dreaming?
Dá, sim. Seguindo o fluxo “coletar Transcripts, analisar em segundo plano, consolidar com escrita única, montar em somente leitura e fazer manutenção periódica”, você consegue montar uma versão simplificada só com chamadas comuns ao modelo. Pelo APIYI (apiyi.com), é possível invocar os modelos Claude por uma interface compatível com a da OpenAI para fazer a análise e a consolidação. Armazenamento, agendamento e permissões ficam por sua conta.
P5: O APIYI oferece diretamente o recurso Claude Dreaming?
Não. O APIYI (apiyi.com) oferece interfaces de invocação de modelos como o Claude, mas não inclui as APIs de Managed Agents, Memory Stores ou Dreams da Anthropic. Ele serve bem para invocar o modelo e montar seu próprio fluxo de consolidação de memória, e quem é novo na plataforma pode validar a ideia primeiro com a cota gratuita de teste.
P6: Quais são as limitações conhecidas do Dreaming?
Para perguntas simples, que um único arquivo já responde, o Wiki não traz ganho visível. A consolidação também pode inchar o volume: 115 KB de texto original, por exemplo, geraram um Wiki de 203 KB. Quando vários Agents compartilham a escrita, fatos se perdem. Além disso, o Dreams oficial ainda não tem qualificação ZDR nem HIPAA, e as tarefas levam de alguns minutos a várias horas.
Claude Dreaming: principais pontos (Key Takeaways)
- Memória não é só armazenamento: guardar todas as conversas acumula informação duplicada, desatualizada e errada. É preciso verificar e organizar.
- Estrutura de memória em 4 camadas: Transcripts, Memory notes, Memory representations e Injected context, cada uma com a sua função.
- A correção de erros depende do registro original: o Dreaming volta ao Transcript para conferir os fatos e corrigiu uma orientação errada que causava falhas repetidas.
- Wiki é melhor em tarefas que cruzam vários documentos: na tarefa de fusões e aquisições, o Wiki marcou 87%, contra 73% da recuperação pura, e economizou em média cerca de 20 mil tokens por pergunta.
- Organizar também tem efeitos colaterais: gravações simultâneas podem perder fatos, o Wiki tende a inchar e tarefas simples não precisam disso.
- Dá para montar o seu próprio: chamando modelos Claude pelo APIYI (apiyi.com), você consegue implementar uma versão simplificada de consolidação de memória entre sessões.
Conclusão
O Claude Dreaming deixa três lições principais:
- O núcleo da memória de longo prazo é a manutenção: só uma memória verificada, sem duplicatas e bem organizada ajuda de forma consistente na próxima tarefa.
- O que lembrar importa mais do que quanto lembrar: priorize regras, causas de erros e armadilhas que são difíceis de recuperar a partir do ambiente, e evite registrar estados que mudam o tempo todo.
- Memória estruturada depende do cenário: tarefas que cruzam vários arquivos, têm muitas rodadas e acumulam informação ao longo do tempo justificam o uso de um Wiki. Em tarefas simples de recuperação, não vale a pena arcar com o custo de manutenção.
Se o seu Agent já roda em várias sessões, comece pelo ciclo mínimo: “guardar o Transcript, consolidar uma vez por noite de forma serial e montar a página de índice somente para leitura”. Para validar esse fluxo rapidamente, recomendo chamar os modelos Claude pelo APIYI (apiyi.com), que oferece uma interface compatível com a OpenAI e crédito de teste gratuito para novos usuários.
📚 Referências
- The components of agent memory: texto original do blog de engenharia da Anthropic, que apresenta a estrutura de memória em 4 camadas e o experimento Dreaming
- Link:
anthropic.com/research/components-of-agent-memory -
Observação: fonte original dos dados dos experimentos CL-Bench, Pokémon, Wiki e organização de contratos
-
Dreaming with a dynamic workflow: Cookbook oficial do Claude
- Link:
platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow -
Observação: exemplo de workflow multiagente com Lead, Analyzer e Organizer, além de referências de custo
-
Publicação oficial da Anthropic no X: nota de lançamento do blog de engenharia sobre o Dreaming
- Link:
x.com/AnthropicAI/status/2118814753154064501 - Observação: confirma a data de lançamento e o posicionamento oficial
Autor: Equipe técnica da APIYI
Troca de experiências: fale com a gente na página inicial do site da APIYI. Mais materiais disponíveis na central de documentação em docs.apiyi.com


