
Nota do autor: os pesos abertos do 文心5.5 Flash Base já estão disponíveis para download. Neste artigo, analisamos arquitetura e parâmetros, requisitos de hardware, objetivos de uso e custos para ajudar você a decidir entre implantar o modelo base por conta própria ou acessar uma API sob demanda.
Em 5 de novembro de 2026, a Baidu lançou oficialmente e disponibilizou os pesos do 文心5.5 Flash Base(ERNIE-5.5-Flash-Base). Trata-se de um modelo base MoE esparso, com 280B de parâmetros totais e 14B ativados por token, que alcançou resultados SOTA entre modelos de tamanho semelhante em vários benchmarks. Os pesos estão disponíveis no Hugging Face nas versões FP8 e BF16, e o plugin do vLLM e o Cookbook do SGLang também foram publicados. Desta vez, não foi só “publicar o artigo sem liberar os pesos”.
Este não é apenas mais um resumo de benchmarks. Muitas equipes veem “pesos abertos + SOTA” e já se preparam para baixar os pesos e colocar o modelo em produção, mas deixam passar um detalhe fundamental: este é um modelo Base que não passou por treinamento intermediário nem por pós-treinamento. Ele funciona bem como ponto de partida para treinamento, mas não deve ser usado diretamente como chatbot.
O que você vai descobrir: ao final deste artigo, você saberá para quais cenários o 文心5.5 Flash Base é indicado, quanta memória de GPU é necessária aproximadamente para implantá-lo por conta própria e em quais condições vale mais a pena acessar uma API sob demanda.
Pontos principais do Wenxin 5.5 Flash Base
A tabela abaixo resume as informações essenciais do modelo. Elas ajudam a decidir entre implantá-lo ou acessá-lo por uma API.
| Ponto | Descrição | Impacto na escolha |
|---|---|---|
| Posicionamento | Checkpoint ao final do pré-treinamento, sem treinamento intermediário ou pós-treinamento | Não serve diretamente para conversas; é adequado para continuar o treinamento |
| Número de parâmetros | 280B de parâmetros no total, com 14B ativados por token | O custo computacional de inferência é menor, mas a memória de GPU necessária para os pesos corresponde a 280B |
| Contexto | Contexto de treinamento de 128K; suporte a 1M tokens no ajuste fino e na inferência | Adequado para adaptação a domínios como documentos longos e código em repositórios inteiros |
| Formato dos pesos | FP8 e BF16 disponíveis no Hugging Face | FP8 reduz bastante os requisitos de implantação |
| Suporte no ecossistema | Plugin para vLLM e Cookbook para SGLang | Pode ser integrado aos principais frameworks de inferência |
O que significa “Base” em Wenxin 5.5 Flash Base
Um modelo Base aprendeu apenas a “prever o próximo token”, não a “entender instruções e responder”. Se você fizer uma pergunta, é bem possível que ele continue gerando outras perguntas em vez de dar uma resposta. A Baidu também deixa claro que os desenvolvedores podem usar esse ponto de partida comum para fazer adaptação a domínios, ajuste fino para instruções, reforço de raciocínio e treinamento de agentes.
Então, o primeiro critério é simples: se o objetivo é “usar o modelo”, o Base não é o que você procura; se o objetivo é “treinar o modelo”, ele é um bom ponto de partida. A Baidu também informou que a versão final do Wenxin 5.5 Flash será lançada em breve. Equipes que querem usá-lo diretamente para conversas podem esperar por ela.
Concorrentes de tamanho semelhante ao Wenxin 5.5 Flash Base
Na avaliação publicada pela Baidu, os modelos comparados incluem DeepSeek-V4-Flash-Base (284B-A13B), Hy3-preview-Base (295B-A21B) e MiMo-V2.5-Base (310B-A15B). O Wenxin 5.5 Flash Base se destacou em tarefas de raciocínio, código, conhecimento em diferentes disciplinas e contexto longo. Para equipes que pretendem fazer ajuste fino para agentes de código ou compreensão de documentos longos, essa base merece entrar na lista de candidatos.
Como o 文心5.5 Flash Base funciona: três melhorias de eficiência
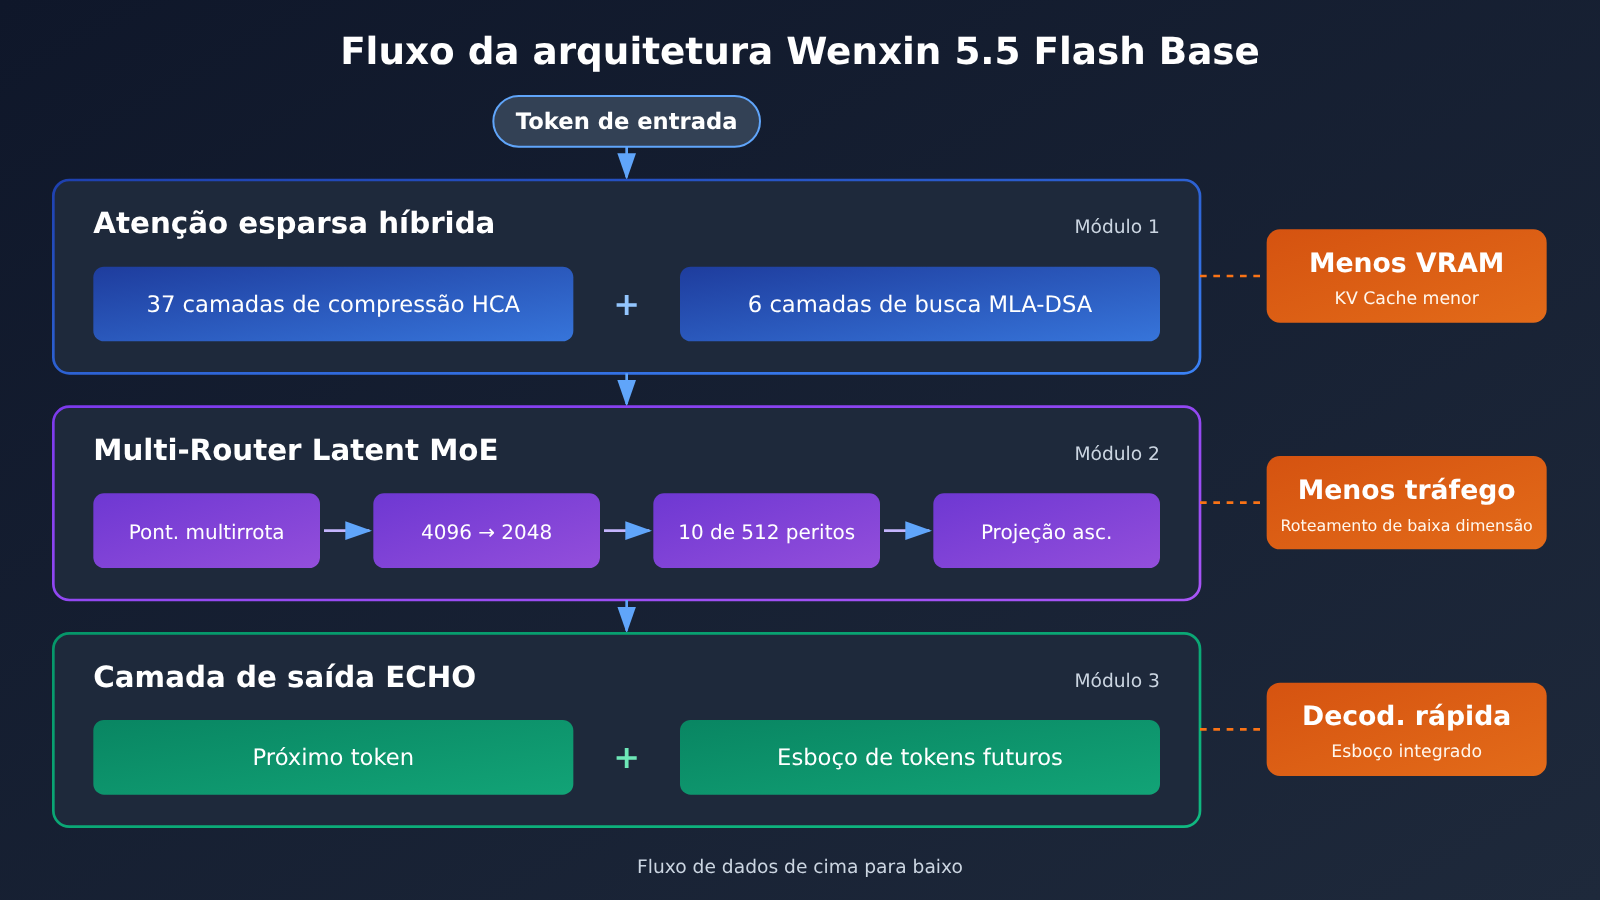
Entender a arquitetura ajuda a estimar os custos de implantação. A equipe do 文心 tratou a eficiência como uma variável de projeto no pré-treinamento, concentrando as melhorias em três etapas: atenção, roteamento de especialistas e previsão de tokens futuros.
| Módulo | Projeto principal | Benefícios na implantação |
|---|---|---|
| Atenção esparsa híbrida | Das 43 camadas, 37 usam HCA (cada 128 tokens são comprimidos em uma entrada de cache) e 6 usam MLA + busca esparsa DSA | KV Cache muito menor e menos uso de memória de GPU em contextos longos |
| Multi-Router Latent MoE | Vários roteadores Sigmoid atribuem pontuações em conjunto; 10 dos 512 especialistas roteados são selecionados, além de 1 especialista compartilhado; os especialistas calculam em um espaço latente de 2048 dimensões | Redução de cerca de metade nos FLOPs dos especialistas e no volume de comunicação para distribuição |
| ECHO | Reutiliza a última camada do modelo principal para prever tokens futuros | Pode funcionar diretamente como modelo draft integrado para decodificação especulativa, sem adicionar parâmetros |
| Projetos complementares | Cabeça de saída MultiMax e tokenizador R2L com vocabulário de aproximadamente 200 mil tokens | Processamento mais estável de números e operações aritméticas |
Por que o 文心5.5 Flash Base economiza KV Cache
Em modelos tradicionais, cada camada precisa armazenar um KV Cache completo. Quanto maior o contexto, maior a pressão sobre a memória da GPU. No 文心5.5 Flash Base, 37 camadas acessam apenas um “resumo” comprimido, enquanto outras 6 acessam o histórico token por token. Essas 6 camadas usam um Indexer leve para selecionar as posições Top-K e fazer cálculos mais detalhados. Isso significa que, em contextos de 128K ou até maiores, o KV Cache ocupa bem menos espaço do que em modelos de tamanho semelhante com atenção completa. Para equipes que fazem a própria implantação, essa economia de memória é concreta.
O papel do ECHO na aceleração da inferência
Durante o pré-treinamento, o ECHO prevê apenas 1 token adicional. Mas, como modelo draft, ele consegue gerar vários tokens futuros em sequência, com uma taxa de aceitação maior do que a de um módulo MTP externo treinado da mesma forma. Na implantação própria, se o framework de inferência oferecer suporte a esse fluxo de decodificação especulativa, o throughput pode aumentar consideravelmente. Essa também é uma vantagem dos pesos abertos em relação à API: você tem controle total sobre esse tipo de otimização de inferência.
Primeiros passos com o Wenxin 5.5 Flash Base: implantação própria
Se você já decidiu usar esse modelo-base para treinamento ou inferência privada, este é o caminho mais curto. Não há código neste guia; os principais parâmetros são explicados em texto.
Primeiro passo: estime a memória de GPU necessária
Em modelos MoE, o volume de computação depende dos parâmetros ativados, mas todos os pesos precisam ser carregados. Por isso, a memória de GPU necessária é calculada com base no total de 280B de parâmetros. A tabela abaixo traz estimativas aproximadas, calculadas como “bytes por parâmetro × número de parâmetros”. Ela não inclui KV Cache, ativações nem a sobrecarga do framework; consulte a documentação oficial e faça seus próprios testes para obter valores reais.
| Versão dos pesos | Estimativa de memória para os pesos | Sugestão de implantação (estimativa) | Usos indicados |
|---|---|---|---|
| FP8 | Cerca de 280 GB | Uma máquina com 8 GPUs de 80 GB, com espaço para KV Cache | Avaliação de inferência e serviços leves |
| BF16 | Cerca de 560 GB | Uma máquina com 8 GPUs de alta capacidade de memória ou paralelismo de tensores em várias máquinas | Avaliações sensíveis à precisão e ponto de partida para fine-tuning |
| Fine-tuning de todos os parâmetros | Muito maior que na inferência, pois também exige estados do otimizador e gradientes | Cluster com várias máquinas e framework de treinamento distribuído | Adaptação aprofundada a domínios específicos |
| Fine-tuning do tipo LoRA | Entre a inferência e o fine-tuning de todos os parâmetros | Depende do rank e do comprimento das sequências | Adaptação a domínios específicos por equipes pequenas e médias |
Segundo passo: escolha o framework de inferência e carregue os pesos
A equipe oficial também disponibilizou um plugin para vLLM e o SGLang Cookbook. A recomendação é começar por esses dois materiais. Os passos são:
- Baixe os pesos FP8 ou BF16 do Hugging Face e reserve em disco um espaço semelhante ao necessário para carregá-los na memória de GPU.
- Instale o vLLM e carregue o plugin oficial, ou configure os parâmetros de inicialização conforme o SGLang Cookbook.
- Mantenha o grau de paralelismo de tensores igual ao número de GPUs (no vLLM, isso corresponde ao parâmetro
tensor-parallel-size). - Comece com um comprimento de contexto de cerca de 32K e aumente gradualmente, observando o uso do KV Cache.
- Faça um teste básico com um comando de continuação. Por exemplo, forneça o início de um trecho de código para que o modelo o complete, em vez de fazer uma pergunta direta.
Terceiro passo: defina o objetivo do treinamento
Depois que os pesos Base são disponibilizados, o trabalho de verdade começa. Há três caminhos comuns: continuar o pré-treinamento com dados de um domínio específico, fazer SFT com dados de instrução e, a partir do SFT, reforçar a capacidade de raciocínio ou treinar trajetórias de agentes.
Na fase de pré-treinamento, o Wenxin já recebeu dados de código, como commits, issues, PRs e validação de correções em CI, além de textos longos com perguntas e respostas que exigem raciocínio em múltiplas etapas. Por isso, engenharia de software e documentos longos são as áreas em que o fine-tuning parece mais promissor.
🎯 Dica técnica: antes de investir em GPUs para fine-tuning, rode seu conjunto de avaliação de negócios em um modelo de instrução já disponível para obter uma pontuação de referência. A APIYI apiyi.com oferece uma interface unificada para modelos de vários provedores, permitindo obter uma referência comparativa a baixo custo antes de decidir se vale a pena investir no treinamento do seu próprio modelo-base.
Guia rápido do Wenxin 5.5 Flash Base: como acessar a API conforme sua necessidade
Primeiro, vale esclarecer: a APIYI ainda não oferece os modelos da série Wenxin ERNIE, incluindo o Wenxin 5.5 Flash Base. Eles serão disponibilizados assim que possível. Além disso, o modelo Base não é adequado para uso direto como API de conversa; a maioria das aplicações precisa de uma versão de instrução ou de raciocínio.
Se você precisa integrar esses recursos ao produto agora, pode começar com um modelo já disponível para montar o fluxo da aplicação e, quando a versão final do Wenxin 5.5 Flash estiver disponível, fazer a troca e comparar os resultados. A APIYI é compatível com os formatos de API da OpenAI e da Anthropic. Para trocar de modelo, basta alterar o parâmetro model, sem reescrever a lógica de invocação.
Preços dos modelos alternativos disponíveis na APIYI
Os preços abaixo são baseados nos dados da página de preços da APIYI, docs.apiyi.com/models, e estão em dólares por milhão de tokens. Consulte os valores mais recentes na página antes de fazer chamadas.
| Modelo | Entrada | Saída | Cache | Cenários recomendados | Plataforma |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Tarefas de alta concorrência e sensíveis a custos | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | Contexto longo e tarefas em chinês | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | Principal opção para programação e agentes | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | Raciocínio complexo e tarefas de alta dificuldade | APIYI apiyi.com |
| Wenxin 5.5 Flash Base / versão final | — | — | — | A APIYI ainda não oferece esse modelo | Disponível em breve |
Além disso, a APIYI oferece outros modelos chineses, como os da série qwen3.8, e os modelos de imagem gpt-image-2.6-flare e gpt-image-2.6-sunburst (entrada de texto a $5, entrada de imagem a $8 e saída a $30; consulte também a página de preços). Vale lembrar que o deepseek-v4.1-flash da tabela é um modelo de instrução que pode ser invocado diretamente. Ele não é o mesmo que o DeepSeek-V4-Flash-Base usado na comparação dos testes.
Como integrar
No formato da OpenAI, configure o base_url do SDK com o endereço da API fornecido na documentação da APIYI e preencha api_key com a chave gerada no console. Projetos que usam o SDK da Anthropic também podem ser integrados diretamente. Para consultar o endereço completo da API, os parâmetros e exemplos, acesse a central de documentação da APIYI em docs.apiyi.com.
🚀 Comece agora: recomendamos usar o deepseek-v4.1-flash ou o claude-sonnet-5-5 na APIYI apiyi.com para testar o protótipo da sua aplicação. Quando a versão final do Wenxin 5.5 Flash estiver disponível na plataforma, basta alterar o nome do modelo para fazer uma comparação A/B.
Autohospedagem do 文心5.5 Flash Base ou chamada de API: tabela de decisão
Veja as recomendações em cinco dimensões para identificar qual caminho faz mais sentido para sua equipe.
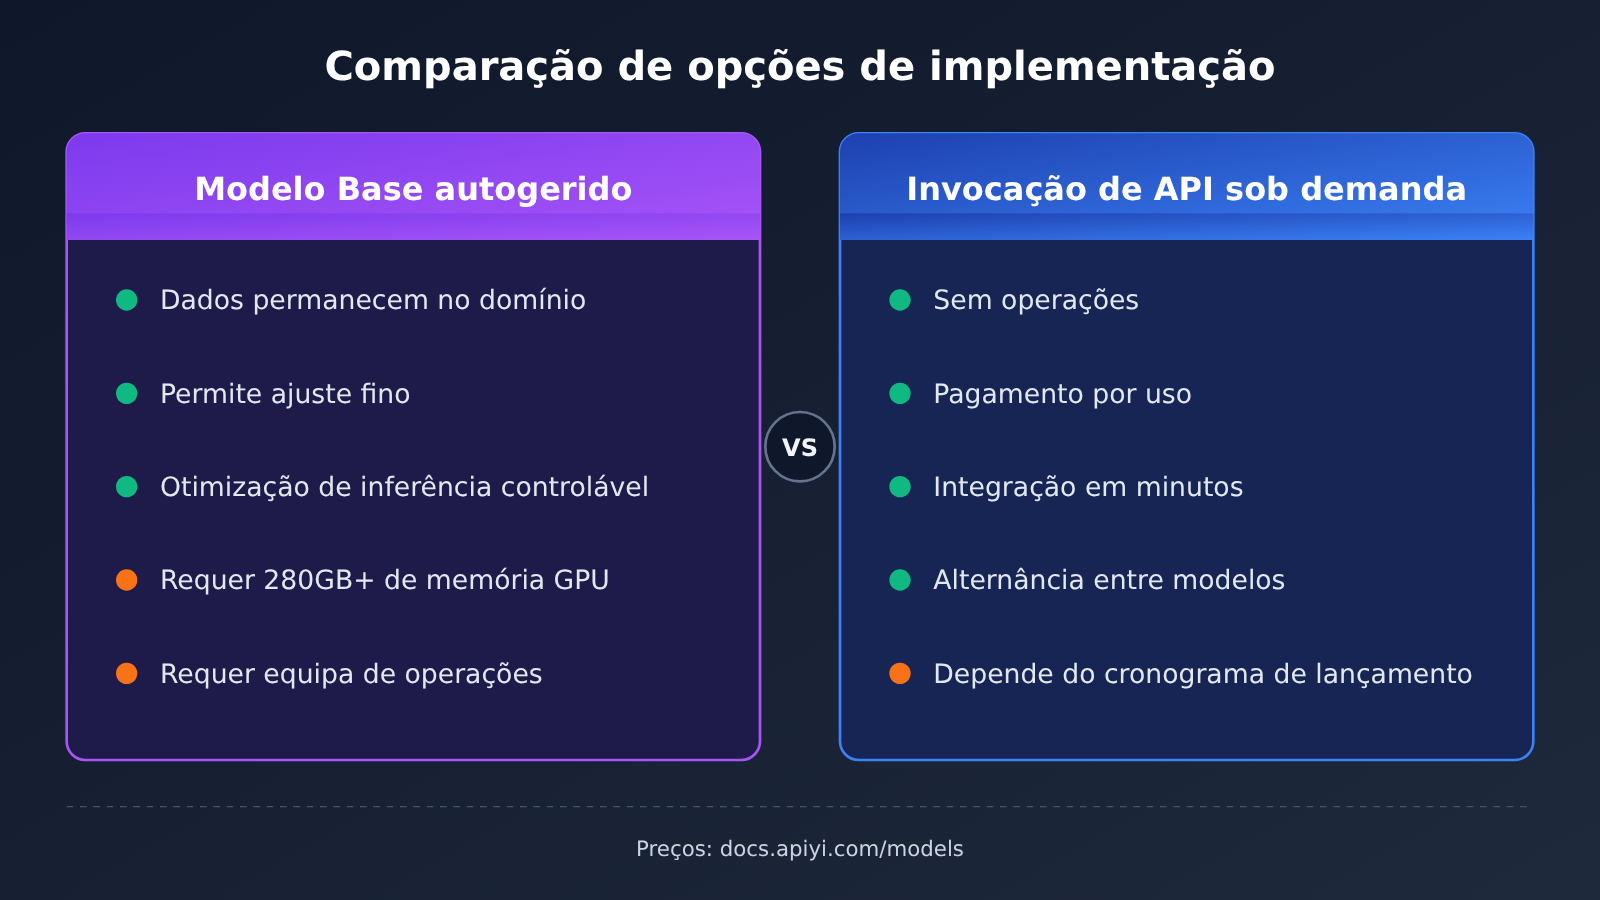
| Critério | Escolha a autohospedagem do Base | Escolha chamadas de API sob demanda |
|---|---|---|
| Objetivo de uso | Continuar o pré-treinamento em um domínio, fazer SFT, RL ou experimentos comparativos de pesquisa | Criar diretamente aplicações de perguntas e respostas, redação ou assistência à programação |
| Conformidade dos dados | Os dados não podem sair da rede interna e exigem implantação privada | Os dados podem ser enviados à nuvem, e os termos de conformidade do provedor são aceitáveis |
| Escala de chamadas | Carga alta e estável no longo prazo, com alta utilização das GPUs | Tráfego muito variável ou volume diário limitado de chamadas |
| Capacidade da equipe | Há engenheiros para operar e manter o treinamento e a inferência | O foco é o desenvolvimento de aplicações, sem interesse em manter um cluster |
| Prazo de lançamento | É possível aceitar um ciclo de treinamento de semanas a meses | É preciso lançar ainda esta semana |
Dois perfis típicos de usuários do 文心5.5 Flash Base
Equipes para as quais a autohospedagem faz sentido: por exemplo, equipes dos setores financeiro, de saúde ou governamental com exigências de implantação privada, grandes volumes de dados específicos do domínio e o objetivo de treinar um modelo próprio. Para elas, os atrativos do 文心5.5 Flash Base são sua base de pré-treinamento em código e contextos longos, além da economia de KV Cache proporcionada pela arquitetura HCA.
Equipes para as quais chamadas de API fazem sentido: por exemplo, equipes que desenvolvem SaaS, ferramentas de conteúdo ou sistemas de atendimento e precisam de estabilidade, rapidez e cobrança por uso. Para elas, usar diretamente um modelo Base acrescentaria uma etapa de treinamento desnecessária. É mais sensato lançar primeiro com um modelo de instruções já consolidado e concentrar os esforços no produto.
Os dois caminhos podem seguir em paralelo
Muitas equipes adotam um modelo híbrido: usam chamadas de API nas aplicações em produção para garantir estabilidade e, ao mesmo tempo, experimentam internamente com os pesos do Base. Quando o modelo treinado pela equipe supera a API de referência nos conjuntos de avaliação, elas começam a migrar o tráfego gradualmente. Essa abordagem reduz os riscos e mantém uma referência clara para avaliar o investimento em desenvolvimento próprio.
💡 Como escolher: se ainda estiver em dúvida, faça uma conta: estime o custo mensal das chamadas usando os preços unitários da página de preços da APIYI e compare-o com o custo de aluguel ou depreciação das GPUs. Faça um teste em pequena escala por uma semana usando a interface unificada da APIYI em apiyi.com. Decidir com base no consumo real de tokens será bem mais preciso do que estimar por intuição.
Perguntas frequentes (FAQ)
Q1: O que é o 文心5.5 Flash Base?
É um modelo base de código aberto lançado pelo Baidu em 5 de novembro de 2026. Ele usa uma arquitetura MoE esparsa, com 280B de parâmetros no total e 14B ativados por token, e foi pré-treinado do zero com 33,5T de tokens. Os pesos disponibilizados oficialmente são os do fim do pré-treinamento, destinados principalmente à continuação do treinamento, e não ao uso direto em conversas.
Q2: Qual é a diferença entre o 文心5.5 Flash Base e o DeepSeek-V4-Flash-Base?
Os dois têm tamanhos semelhantes; o DeepSeek-V4-Flash-Base tem 284B de parâmetros, com 13B ativos. Ele também é um modelo base robusto, mas, segundo as avaliações publicadas pelo Baidu, o 文心5.5 Flash Base tem desempenho superior em raciocínio, código, conhecimento de áreas específicas e contexto longo. Na arquitetura, o 文心 combina atenção híbrida HCA e MLA com MoE de múltiplos roteadores, dando mais foco à compressão do KV Cache e à robustez do roteamento.
Q3: Quando será lançada a versão final do 文心5.5 Flash?
O Baidu afirmou que a versão final será lançada em breve, mas, até a publicação deste artigo, em 6 de novembro de 2026, não havia informado uma data específica. Ela passará por pós-treinamento a partir da versão Base, o que a tornará mais adequada para integração direta em aplicações.
Q4: Para quais cenários o 文心5.5 Flash Base é mais indicado?
Ele é indicado principalmente para:
– **Treinamento de modelos de código em nível de repositório**: o pré-treinamento já inclui dados de engenharia, como commits, PRs e correções de CI.
– **Modelos especializados em documentos longos**: por exemplo, para compreender processos jurídicos e relatórios de pesquisa em contextos longos. O ajuste fino e a inferência suportam 1M de tokens.
– **Pesquisa sobre métodos de treinamento**: como ponto de partida comum para comparar os resultados de diferentes estratégias de SFT e RL.
Q5: Já é possível acessar o 文心5.5 Flash Base por API?
A APIYI ainda não disponibiliza esse modelo nem os demais da família ERNIE, mas pretende disponibilizá-los o mais rápido possível. Por enquanto, é possível acessar modelos já disponíveis na APIYI, em apiyi.com, como deepseek-v4.1-flash, kimi-k3.1-pro e claude-sonnet-5-5. A plataforma é compatível com os formatos de interface da OpenAI e da Anthropic; consulte os preços em docs.apiyi.com/models.
Q6: Quais são as limitações de hospedar o 文心5.5 Flash Base por conta própria?
Primeiro, a exigência de memória de GPU é alta: mesmo com pesos em FP8, só os pesos precisam de cerca de 280 GB. Segundo, o modelo Base não está pronto para uso imediato e exige investimento em treinamento. Terceiro, a inferência com contexto longo ainda precisa de espaço reservado para o KV Cache. Se a equipe não tiver experiência em treinamento e operações, vale começar pela API.
Q7: O que equipes pequenas e médias podem fazer com o 文心5.5 Flash Base?
É possível alugar GPUs na nuvem para executar inferência em FP8 e avaliar as capacidades do modelo, ou usar métodos como LoRA para uma adaptação leve a um domínio específico. Para o tráfego em produção, a recomendação continua sendo usar uma API e tomar os resultados obtidos para o negócio com a APIYI, em apiyi.com, como referência para comparar o modelo treinado pela própria equipe.
Pontos principais do Wenxin 5.5 Flash Base
- Foi feito para ser um ponto de partida para treinamento: o Base não passou por pós-treinamento. É adequado para ajuste fino e pesquisa, mas não para conversas diretas.
- O processamento depende dos parâmetros ativados; a memória, do total: apenas 14B de parâmetros são ativados, mas os pesos em FP8 ainda exigem cerca de 280 GB de memória de GPU.
- O contexto longo usa menos cache: 37 camadas HCA com compressão e 6 camadas MLA-DSA reduzem significativamente o KV Cache.
- Tem uma base sólida para código e textos longos: é adequado para criar modelos especializados em código de repositórios completos e documentos extensos.
- O ecossistema está pronto: o plugin vLLM e o SGLang Cookbook foram lançados ao mesmo tempo, facilitando a integração para inferência.
- A API ainda não está disponível: a APIYI ainda não oferece a série Wenxin. Enquanto isso, é possível usar os modelos disponíveis para criar uma base de comparação para a aplicação.
Resumo
Os principais pontos para decidir se o Wenxin 5.5 Flash Base é a escolha certa:
- Comece pelo objetivo: para treinar um modelo, faça a implantação própria do Base; para usá-lo, escolha uma API ou espere a versão final.
- Avalie os requisitos: os pesos exigem cerca de 280 GB de memória de GPU em FP8 ou 560 GB em BF16, uma limitação incontornável.
- Faça as contas: compare o custo mensal da API com o custo das GPUs usando o volume real de chamadas. O modelo híbrido apresenta o menor risco.
Para a maioria das equipes de aplicações, o caminho mais prático é colocar a aplicação em funcionamento primeiro por meio de uma API e depois usar o Base de código aberto em experimentos internos. Recomendamos usar os modelos disponíveis na APIYI, em apiyi.com, para criar rapidamente uma base de comparação. A documentação da interface está em docs.apiyi.com, e os preços podem ser consultados em docs.apiyi.com/models. Quando a série Wenxin estiver disponível, bastará alterar o nome do modelo no mesmo código para fazer a comparação.
📚 Referências
- 量子位 – Reportagem sobre a abertura do código do modelo ERNIE 5.5 Flash Base pela Baidu: visão geral do lançamento e das avaliações do modelo
- Link:
qbitai.com/2026/11/507787.html -
Descrição: inclui comparações com modelos-base de mesmo tamanho e apresenta as principais tecnologias
-
Central de documentação da APIYI: endereços das interfaces e instruções para chamadas compatíveis com OpenAI e Anthropic
- Link:
docs.apiyi.com -
Descrição: leitura essencial antes da integração, com parâmetros e exemplos
-
Página de preços dos modelos da APIYI: preços unitários de entrada, saída e cache dos modelos disponíveis
- Link:
docs.apiyi.com/models - Descrição: os preços deste artigo devem ser conferidos com os dados atuais dessa página
Autor: Equipe técnica da APIYI
Contato técnico: entre em contato pela página inicial da APIYI em apiyi.com. Para mais informações sobre integração, acesse a central de documentação em docs.apiyi.com


