
글쓴이 노트: d1.2-ultra는 Decision Index v2.1에서 1위를 보여요. 이 글은 먼저 여러분의 업무가 문서 추출인지, 도구 호출인지, 어려운 문제 풀이인지 구분하고, 거기에 맞는 세부 점수만 본 다음, 자체 샘플 20~50개로 교체 여부를 판단하는 방법을 알려드려요.
2026-11-16, Liquid AI가 d1.2와 d1.2-ultra를 공개했어요. 공식 블로그에서는 d1.2-ultra가 Artificial Analysis Decision Index v2.1에서 75점을 받아 의사결정 모델 중 가장 높다고 말해요. API를 연동하던 많은 개발자가 “1위”를 보면 가장 먼저 하는 생각이 바로 프로덕션 모델을 바꾸는 거예요. 성급하게 바꾸지 마세요. 종합 점수 75점은 하나의 단서일 뿐이고, 정말 봐야 할 것은 여러분의 비즈니스와 맞는 그 세부 항목의 점수예요.
이 글은 비판이나 옹호를 위한 글이 아니에요. 같은 모델이 문서 추출에서는 1위지만, 아주 어려운 객관식 문제에서는 원시 정확도가 24개 의사결정 모델 가운데 가장 낮아요. 두 사실은 동시에 성립하고, 종합 점수는 이 둘을 평균 내어 가려버려요.
핵심 가치: 이 글을 읽고 나면 어떤 세부 항목을 봐야 하는지, 의사결정 점수와 원시 정확도를 어떻게 읽어야 하는지, 그리고 자체 샘플 20~50개로 한나절 안에 교체 여부 결론을 내는 방법을 알게 될 거예요.
d1.2-ultra 종합 1위의 핵심 포인트
먼저 리더보드 페이지의 숫자부터 정확히 짚어볼게요. 아래 데이터는 Artificial Analysis의 d1.2-ultra 모델 페이지에서 가져온 것이고, 조회일은 2026-11-17이며, 비교에 참여한 의사결정 모델은 총 24개예요.
| 항목 | 리더보드 페이지 데이터 | 해석 |
|---|---|---|
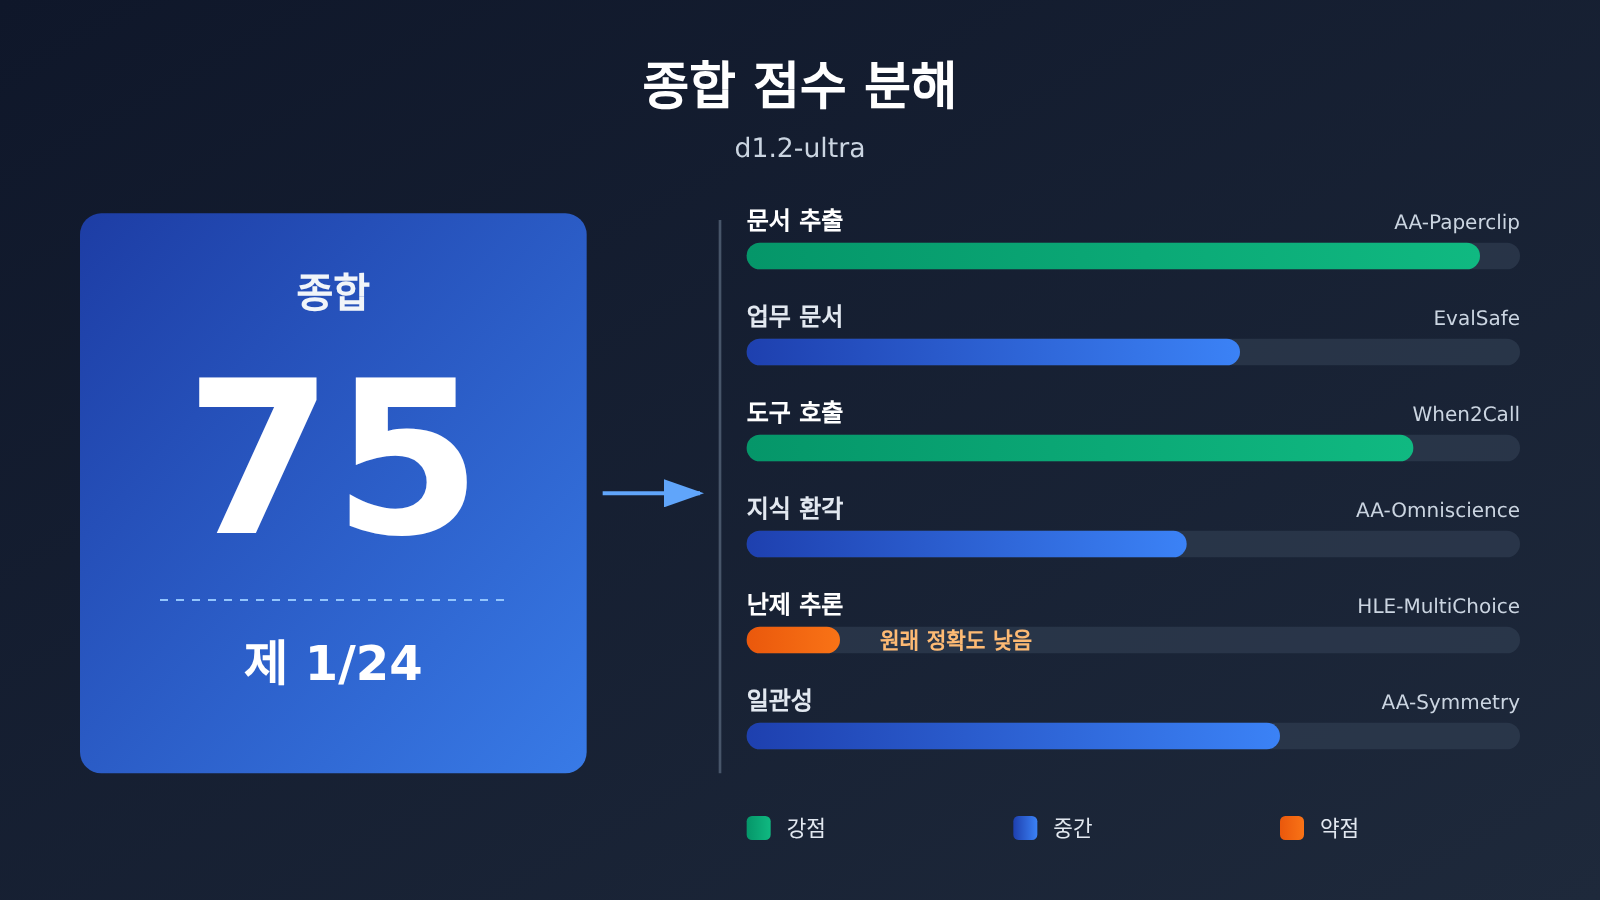
| 종합 지수 | 74.85, 페이지 표시값 75, 1/24위 | 2위 Drex Max v1.1은 72.62로 약 2.2점 차이예요. 공식에서 말한 “2점”은 같은 차이를 반올림해서 표현한 거예요 |
| 소요 시간 | 작업당 218밀리초, 14/24위 | 페이지 중앙값은 209밀리초로 중위권이에요 |
| 지수 전체 실행 비용 | 100만 작업당 133달러, 11/24위 | 이건 작업 비용이지, 100만 토큰당 표시 가격이 아니에요 |
| 입력 가격 | 100만 토큰당 0.042달러 | Liquid 공식 블로그와 일치해요. 공식 계산은 입력만 집계해요 |
| Brier | 0.150, 24개 중 최저 | 낮을수록 좋아요. 제시한 확률이 비교적 “정직”하다는 의미예요 |
d1.2-ultra의 종합 점수는 어떻게 나왔나요
Decision Index v2.1은 여섯 개 세부 항목의 가중 평균이에요. 모델 페이지에서 의사결정 점수를 정의한 방식은 정확도에서 선택한 답의 확률에 대한 Brier 점수를 뺀 값이고, 범위는 0부터 100까지이며 높을수록 좋아요. 즉, 확신을 갖고 틀리는 쪽이 망설이며 틀리는 쪽보다 더 많이 감점돼요. 원시 정확도는 모델이 가장 높은 확률을 정답 선택지에 준 문항의 비율인데, 이것은 의사결정 점수와 같은 숫자가 아니에요.
이 차이는 d1.2-ultra를 읽는 방식에 직접 영향을 줘요. 어떤 모델은 자주 추측하지 않고 확신에 찬 실수를 적게 해서 나쁘지 않은 의사결정 점수를 받으면서도 원시 정확도는 매우 낮을 수 있어요. 비즈니스에서 “반드시 답을 내야 한다”면 원시 정확도를 봐야 하고, “불확실하면 사람에게 넘긴다”가 허용된다면 의사결정 점수가 더 참고할 만해요.
| 세부 항목 | 가중치 | 측정 내용 | AA 분류 |
|---|---|---|---|
| AA-Paperclip | 30% | 문서 판단 및 추출, 문서 한 건의 답 15개를 한 번의 판단으로 집계 | 문서 |
| EvalSafe-O*NET-AA | 15% | 업무 문서 판단 | 문서 |
| When2Call | 10% | 도구 호출 | 도구 |
| AA-Omniscience-Decision v1.1 | 15% | 지식과 환각 | 지식 |
| HLE-MultiChoice v1.1 | 15% | Humanity’s Last Exam 텍스트 객관식 문제, 답변 거부 가능 | 추론 |
| AA-Symmetry v1.1 | 15% | 표현을 바꾸거나, 선택지 순서를 바꾸거나, 부정문으로 바꾼 뒤에도 판단이 그대로인지 확인 | 일관성 |
주의할 점은 HLE-MultiChoice가 AA에서 지식이 아니라 추론으로 표시된다는 거예요. 따라서 아래에서 이 항목을 언급할 때는 “지식 테스트”라고 쓰면 안 돼요.
d1.2-ultra에서 내 작업에 맞는 항목 점수 보는 법
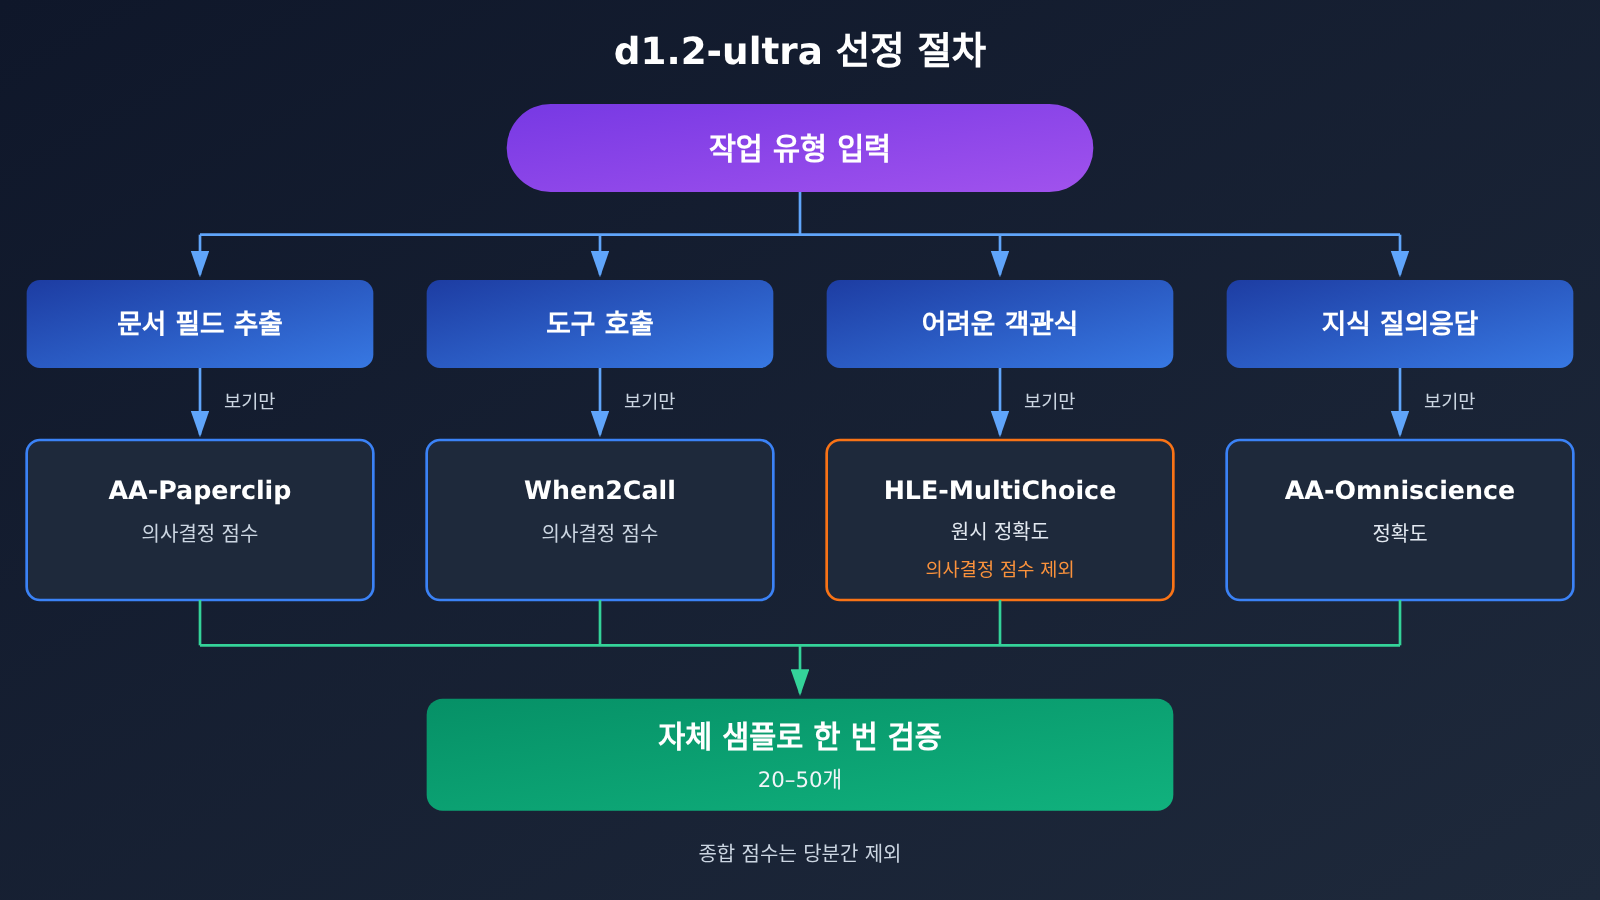
첫 단계는 리더보드를 보는 게 아니라, 종이 한 장을 꺼내 내 작업이 대체로 어느 유형인지 적는 거예요. 서류에서 필드를 추출하는 일인지, 도구를 호출하는 일인지, 어려운 문제를 푸는 일인지, 아니면 지식 질답인지요. 다 적고 나면 딱 맞는 항목 하나만 보고, 나머지 세부 점수와 종합 점수 75는 당분간 보지 마세요.
| 내가 하려는 일 | 이것만 보기 | d1.2-ultra 리더보드 페이지 데이터 | 해석 방법 |
|---|---|---|---|
| 청구서·이력서·논문 필드 추출 | AA-Paperclip | 의사결정 점수 75.81, 문서 전체 정답률 67.7%, 두 항목 모두 1/24위 | 2위 Drex Max v1.1은 72.82와 63.0%라서 앞서는 정도가 비교적 분명해요 |
| 도구 호출, 호출해야 하는지 판단 | When2Call | 의사결정 점수 96.49, 1위 | SubQ Snap 1.2는 96.10, d1.2는 96.09로 상위 몇 개가 약 1점 차 안에 몰려 있어요 |
| 업무 문서 판단 | EvalSafe-O*NET-AA | 의사결정 점수 89.53, 3위 | 앞에는 Jev 1.14(91.14)와 GLiDE v1.2(89.67)가 있어요 |
| 아주 어려운 객관식 문제 풀이 | HLE-MultiChoice 원시 정확도 | 2.36%, 24개 의사결정 모델 중 최저 | 의사결정 점수 46.36은 최하위가 아니고, 환각 없음 비율 76.1%라서 자주 추측을 포기해요 |
| 지식 질답 | AA-Omniscience 정확도 | 원시 정확도 23.6%, 20/24위 | 의사결정 점수 60.80은 6위, 환각 없음 비율 83.8% |
| 표현을 바꿔도 답이 안정적인지 | AA-Symmetry 전체 통과율 | 점수 86.34로 2위; 전체 통과율 56.7%로 5위 | 점수 2위가 안정성 2위를 뜻하지는 않아요 |
d1.2-ultra 세부 항목에서 가장 쉽게 잘못 읽는 두 곳
첫 번째는 HLE-MultiChoice예요. 원시 정확도 2.36%는 확실히 24개 의사결정 모델 중 최저지만, 의사결정 점수 46.36은 최하위가 아니에요. 같은 페이지에는 더 낮은 점수도 있는데, 예를 들어 Mercury Decide의 34.79예요. 여기에 환각 없음 비율 76.1%까지 더하면, 합리적인 해석은 이렇습니다. 아주 어려운 추론형 객관식 문제를 만나면 d1.2-ultra는 높은 확신의 답을 내놓지 않는 쪽을 택한다는 거예요. AA는 이 항목을 추론으로 분류하므로, 이걸 “지식 테스트 꼴찌”라고 말하면 안 돼요.
두 번째는 AA-Omniscience예요. 정확도 23.6%는 20/24위이지 꼴찌가 아니에요. 흥미로운 건 같은 페이지의 더 작은 d1.2가 이 항목에서 30.0%, HLE 원시 정확도도 5.30%로 둘 다 ultra보다 높다는 점이에요. 하지만 d1.2의 종합 지수는 68.69로 9/24위예요. 그래서 “더 비싼 ultra가 지식이 더 나쁘다”는 건 이 두 항목에만 해당하지, 전반적으로 더 나쁘다고 확장해서 말할 수는 없어요.
🎯 리더보드 읽기 팁: 내 작업이 서류 추출이라면
d1.2-ultra의 AA-Paperclip 1위는 진지하게 볼 만해요. 도구 호출이라면 1위는 사실이지만 뒤쪽 몇 개와의 차이가 1점 이내라, 바꿀지는 내 샘플로 판단해야 해요.
d1.2-ultra의 공식 자체 보고 데이터, 어떻게 활용할까요
Liquid는 같은 블로그 글에서 다섯 가지 새로운 작업과 내부 테스트 결과도 함께 공개했어요. 제조사가 직접 밝힌 대로 이 새 작업들은 아직 공개 벤치마크가 없는 영역이고, 아래 데이터는 모두 공식 자체 보고 수치예요. 내부 홀드아웃 세트를 사용한 결과이며 Artificial Analysis의 성적이 아니에요.
| 새 작업(공식 자체 보고) | d1.2-ultra | d1.2 | 비고 |
|---|---|---|---|
| 영수증 값 읽기(CORD, SROIE) | 98% | 96% | 없는 값은 not found로 답변 |
| 민감 정보 스팬(Nemotron PII) 정밀도/재현율 | 94% / 93% | 92% / 88% | 각 구간의 위치를 제시 |
| 설명 기반 객체 박스 지정(RefCOCO 계열) | 94% | 94% | 둘 다 동일 |
| 객체 세기, 오차 1 허용(COCO) | 93% | 92% | 숫자를 추정하고 범위를 제시 |
| 이미지 속 모든 객체 식별(COCO) | 87% | 90% | 이 항목은 저렴한 d1.2가 더 높음 |
오디오 쪽에서는 공식 발표 기준, 홀드아웃 녹음에서 소리 카테고리(ESC-50)와 언어(43개 언어를 다루는 FLEURS)를 판별할 때 두 모델 모두 약 95%에서 97% 사이를 기록했어요. 캘리브레이션 오차는 Liquid가 13개 벤치마크, 22505개 문제에서 측정한 결과 d1.2-ultra가 0.8, d1.2가 1.2, Jev 1.14가 2.7, Perplexity Decider v1.3이 3.7, GPT-6 Luna의 Decisions API가 7.2였어요.
여기서 꼭 구분해야 할 점이 있어요. GPT-6 Luna(Decisions)는 Artificial Analysis 의사결정 리더보드에서 종합 지수 60.25로 22/24위를 기록했고, HLE 원시 정확률은 7.86%였어요. 이 수치는 모두 Decisions 인터페이스의 성적이며, 채팅 인터페이스인 gpt-6-luna의 성적으로 보면 안 돼요. 공식 블로그에는 “Coming to OpenRouter and Vercel soon”이라는 문구도 있는데, 이는 제조사의 예고일 뿐 이미 출시됐다는 뜻은 아니에요.
d1.2-ultra 빠른 시작: 자신의 샘플로 직접 검증하기
리더보드를 다 봤다면, 실제로 모델을 바꿀지 말지를 결정하는 건 결국 여러분 자신의 데이터예요. 실제 샘플 20~50개면 충분한데, 예를 들어 송장 30장이나 이력서 30份처럼요. 각 항목에 정답 필드를 미리 표기하고, 그중 몇 개는 일부러 특정 필드를 비워두면 좋아요.
초간단 실행 단계
- 비즈니스에서 샘플 20~50개를 골라 각 필드의 정답 값을 수동으로 표기하고, 없는 필드는 not found로 표시하세요.
- 고정된 프롬프트를 하나 작성하세요. 모델이 지정된 필드를 JSON으로 출력하도록 요구하고, 찾을 수 없는 필드는 반드시
not found로 채우게 하며, 추측은 금지한다고 명시하세요. - OpenAI 호환 SDK를 사용해서
base_url을https://api.apiyi.com/v1로 설정하고,model은 먼저gpt-6-luna로 채운 뒤gpt-6.1-sol로 바꿔 각각 한 번씩 실행하세요. - 항목별로 하나하나 비교하면서 세 가지 수치를 기록하세요: 필드 수준 정확도, 문서 전체 정답률, 누락 필드가 엉뚱하게 채워진 횟수.
- 대상 모델을 호출할 수 있게 되면 같은 샘플과 같은 프롬프트로 다시 한 번 실행해서 세 수치를 바로 비교하세요.
전체 비교 방법 살펴보기
– **입력**: 샘플 파일 하나로, 각 줄에 원문(또는 이미지)과 수동으로 표기한 필드 사전이 포함돼요.
– **호출**: 샘플을 반복해서 읽으며 `client.chat.completions.create` 또는 `responses` 엔드포인트를 호출하고, `temperature`는 0으로 설정하며 엄격한 JSON 출력을 요구하세요.
– **파싱**: 출력 파싱 실패는 별도로 집계하는데, 이것 자체가 하나의 가용성 지표예요.
– **비교**: 필드별로 정규화 비교를 수행하세요 (공백 제거, 날짜 형식 통일, 금액은 소수점 둘째 자리까지 유지).
– **환각 집계**: not found로 표기됐는데 모델이 값을 채워 넣은 필드는 별도로 ‘추측’으로 기록하세요.
– **요약**: 필드 정확도, 문서 전체 정답률, 추측 횟수, 평균 token 사용량을 출력해서 나중에 비용 계산을 쉽게 하세요.
APIYI로 먼저 베이스라인 측정하기
이 작업에는 token이 들어요. d1.2와 d1.2-ultra는 APIYI 모델 목록에 없기 때문에, 지금은 APIYI(apiyi.com)에서 이미 제공 중인 gpt-6.1-sol 또는 gpt-6-luna를 사용해서 호출 주소 https://api.apiyi.com/v1으로 같은 송장이나 이력서 배치를 한 번 실행해 보세요. 필드가 맞는지, 없는 필드를 엉뚱하게 추측하는지 확인하는 거죠. 이렇게 하면 여러분 손에 정량화 가능한 베이스라인이 하나 생겨요.
아직 출시되지 않았지만, 이 모델을 최대한 빨리 출시할게요. 모델과 가격은 플랫폼의 모델 목록을 기준으로 해주세요.
| 자체 점검 항목 | 기록 방법 | 판단 기준 |
|---|---|---|
| 필드 정확도 | 정확한 필드 수 / 전체 필드 수 | 현재 프로덕션 모델과 비교 |
| 문서 전체 정답률 | 모든 필드가 맞는 문서 비율 | AA-Paperclip의 ‘문서 전체 정답률’에 대응 |
| 추측 횟수 | not found 필드에 값이 채워진 횟수 | 적을수록 좋고, 비환각률 사고방식에 대응 |
| 파싱 실패 | JSON을 파싱할 수 없는 건수 | 배포 비용에 직접 영향 |
| token 사용량 | 항목당 평균 입력·출력 token | 실제 비용 환산에 사용 |
🚀 시작 팁: 먼저 APIYI apiyi.com의 신규 사용자 무료 테스트 한도로 20건을 실행해서 프롬프트와 비교 스크립트에 문제가 없는지 확인한 뒤, 50건으로 늘리세요. 처음부터 한도를 디버깅에 다 써버리는 걸 피하는 게 좋아요.
d1.2-ultra의 가격과 호출 방식
가격은 단위를 먼저 구분해야 해요. 리더보드에 표시된 133달러는 “백만 태스크당” 평가 실행 비용이고, Liquid 공식 가격은 “백만 입력 토큰당”이에요. d1.2는 0.02달러, d1.2-ultra는 0.042달러이며 입력만 계산해요. 이미지는 32×32픽셀당 1.5토큰으로 텍스트와 같은 가격 기준으로 계산되고, 1024×1024는 약 1536토큰이에요. 한 번의 요청에서 텍스트와 이미지는 한 번만 계산되고, 질문을 하나 더 추가하면 그 질문의 텍스트만 추가로 계산돼요.
공식 호출 방식도 일반적인 채팅 인터페이스와 달라요. 모델 ID는 d1.2-ultra와 d1.2, 주소는 https://api.liquid.ai/decisions/v1/systemone이고, 키는 Liquid 콘솔에서 신청해요. 공식 블로그에는 텍스트, 이미지, 오디오 입력이 적혀 있지만, Artificial Analysis 페이지의 기술 사양에는 텍스트와 이미지, 컨텍스트 66k로 적혀 있어요. 이 윈도우 숫자는 리더보드 페이지에만 나오는 값이고 Liquid 블로그가 공개한 사양은 아니에요.
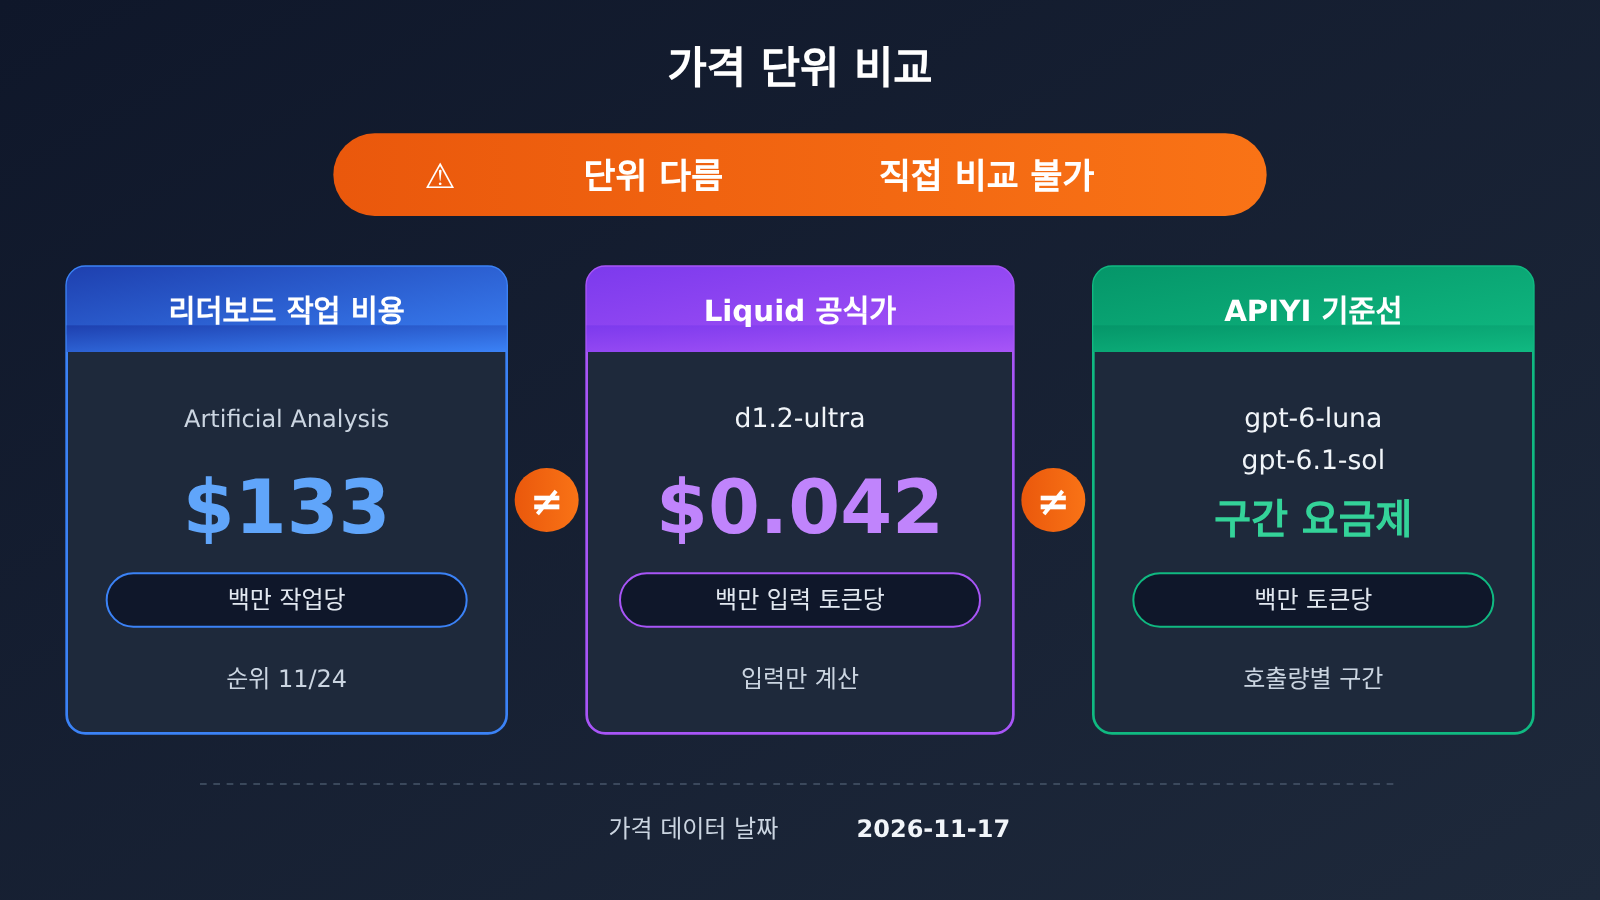
베이스라인 실행에 사용한 APIYI 모델의 가격은 다음과 같아요(단위: 달러/백만 토큰, 요청 1회당 토큰량에 따라 구간이 나뉘며, 데이터는 2026-11-17 가격 API에서 가져왔고 2026-11-16에 업데이트된 모델 총표와 일치해요):
| 모델 | 구간 | 입력 | 출력 | 캐시 읽기 | 엔드포인트 |
|---|---|---|---|---|---|
gpt-6-luna |
≤ 272000 | 0.1 | 0.5 | 0.01 | responses 우선, chat도 지원 |
gpt-6-luna |
≥ 272001 | 0.2 | 0.75 | 별도 표기 없음 | 위와 같음 |
gpt-6.1-sol |
≤ 272000 | 2 | 10 | 0.1 | responses 우선, chat도 지원 |
gpt-6.1-sol |
≥ 272001 | 4 | 15 | 별도 표기 없음 | 위와 같음 |
💰 비용 팁: 50개 샘플로 비교할 때는
gpt-6-luna가 먼저 물량을 돌리기에 적합하고,gpt-6.1-sol은 고품질 참조용으로 적합해요. APIYI apiyi.com 충전은 1:7로 계산되고 그룹 할인이 중첩 적용될 수 있으며, 실제 청구는 콘솔 기준이에요.
자주 묻는 질문 FAQ
Q1: d1.2-ultra는 어떤 모델인가요?
Liquid AI가 2026-11-16에 공개한 의사결정 모델이고, 더 작은 d1.2와 같은 시기에 나왔어요. 의사결정 모델의 특징은 각 선택지에 확률을 부여한다는 점인데, 긴 글 작성보다는 문서 추출, 도구 호출 판단, 분류처럼 “선택을 내리는” 작업에 강해요.
Q2: d1.2-ultra가 종합 1위라면 모든 면에서 최강인가요?
아니에요. 종합 지수 74.85로 24개 중 1위지만, EvalSafe-O\*NET-AA는 3위, AA-Symmetry 전체 통과율은 5위, AA-Omniscience 원시 정확도는 20위, HLE-MultiChoice 원시 정확도는 24개 중 가장 낮아요. 종합 점수는 어디까지나 가중치를 적용한 뒤 앞선다는 것만 말해줘요.
Q3: HLE-MultiChoice 항목에서 지식 테스트 꼴등이라고 볼 수 있나요?
그건 아니에요. 꼴등은 HLE-MultiChoice의 원시 정확도 2.36%이고, 이는 24개 의사결정 모델 중 원시 정확도 기준이에요. 이 모델의 의사결정 점수 46.36은 최하위가 아니고, AA도 이 항목을 지식이 아니라 추론으로 분류했어요.
Q4: d1.2-ultra는 어떤 상황에 가장 적합한가요?
리더보드 페이지를 보면 가장 잘 맞는 건 인보이스, 이력서, 논문 필드 추출(AA-Paperclip 의사결정 점수와 전부 정답률 모두 1위)과 도구 호출 판단(When2Call 1위, 다만 상위 몇 개의 차이가 약 1점)이에요. 까다로운 객관식 문제나 지식형 질의응답에서는 원시 정확도가 우세하지 않아요.
Q5: 지금 APIYI에서 d1.2-ultra를 호출할 수 있나요?
현재 d1.2와 d1.2-ultra는 APIYI 모델 목록에 없어요. 아직 상장되지 않았고, 이 모델을 최대한 빠르게 상장하도록 할게요. 모델과 가격은 플랫폼 모델 목록을 기준으로 하세요. 우선 APIYI apiyi.com에서 `gpt-6-luna`나 `gpt-6.1-sol`로 자사 샘플의 베이스라인을 측정해 두면, 그때 모델만 바꿔서 비교할 수 있어요.
Q6: Liquid가 발표한 보정 오차 0.8을 그대로 믿어도 되나요?
그건 Liquid가 13개 벤치마크, 22505문항에서 자체 테스트한 값이라 공식 자체 보고에 해당해요. 리더보드 페이지에서 교차 확인할 수 있는 건 Brier 0.150이 24개 중 가장 낮다는 점이고, 방향은 일치하지만, 실제 업무에 적용할 때는 자사 샘플에서 “대충 찍은 횟수”가 정말 줄었는지를 확인해야 해요.
Q7: GPT-6 Luna의 7.2와 APIYI의 `gpt-6-luna`는 같은 건가요?
같지 않아요. 7.2는 GPT-6 Luna의 Decisions API를 Liquid 테스트에서 측정한 보정 오차이고, 리더보드의 60.25도 Decisions 인터페이스 성적이에요. APIYI가 제공하는 `gpt-6-luna`는 챗 인터페이스라서 성능은 자사 샘플로 직접 측정해야 해요.
Q8: 샘플이 몇 개 정도 있어야 충분한가요?
20~50개면 뚜렷한 차이를 확인할 수 있어요. 핵심은 실제 분포를 잘 반영하는 것이라, 흔한 형식, 드문 형식, 필드가 빠진 샘플이 모두 들어가야 해요. 두 모델이 50개 샘플에서 한두 개 차이에 그친다면 바꾸든 말든 큰 의미가 없으니, 가격과 지연 시간을 우선 보세요.
d1.2-ultra 핵심 요점 Key Takeaways
- 종합 75점은 그저 시작점일 뿐: 74.85점으로 1/24위, 2위를 약 2.2점 앞서지만 모든 항목에서 1위라는 뜻은 아니에요.
- 문서 추출은 AA-Paperclip: 결정 점수 75.81, 전 항목 정답률 67.7%로 모두 1위.
- 도구 호출은 When2Call: 96.49로 1위지만 상위권이 약 1점 차로 몰려 있어요.
- 난제는 원시 정확도: HLE-MultiChoice 2.36%로 최저지만 결정 점수는 꼴찌가 아니며, AA는 추론으로 분류해요.
- 지식 Q&A는 Omniscience 정확도: 23.6%로 20/24위, 꼴찌는 아니에요.
- 단위를 혼동하지 마세요: 133달러는 백만 태스크당, 0.042달러는 백만 입력 토큰당이에요.
- 샘플로 결정하세요: 먼저 APIYI apiyi.com에서 사용 가능한 모델로 20~50개를 돌려보고 필드 정확도와 무작위 추측 횟수를 기록하세요.
정리
d1.2-ultra의 리더보드를 읽을 때 핵심은 세 단계예요:
- 태스크 유형을 적어두세요: 문서 추출, 도구 호출, 난제 풀이, 지식 Q&A 중 어떤 것인지 확인하고 해당 세부 점수만 보세요.
- 두 숫자를 구분하세요: 결정 점수는 “자신 없으면 추측하지 않기”를 보상하고, 원시 정확도는 “얼마나 맞혔는지”를 측정해요. 비즈니스 요구에 따라 어느 쪽을 볼지 선택하세요.
- 자기 샘플로 결정하세요: 라벨이 붙은 실제 데이터 20~50개가 어떤 종합 점수보다 문제를 더 잘 설명해요.
여러분의 업무가 정확히 문서 추출이라면 d1.2-ultra는 후보 명단에 올릴 만해요. 난제 추론이나 지식 Q&A라면 종합 1위라는 이유만으로 갈아타지는 마세요. 지금 APIYI apiyi.com에서 gpt-6-luna와 gpt-6.1-sol로 베이스라인을 만들어 두고, 목표 모델이 사용 가능해지면 한 번에 비교해 보시길 권해요.
📚 참고 자료
-
Liquid AI 공식 블로그 – d1.2 출시: 출시 정보, 공식 가격 및 자체 보고 테스트
- 링크:
liquid.ai/blog/d1-2 - 설명: 신규 작업 정확도와 캘리브레이션 오차는 모두 공식 자체 보고 수치예요
- 링크:
-
Liquid AI 의사결정 모델 문서: 모델 ID와 호출 주소
- 링크:
docs.liquid.ai/lfm/models/decision-models - 설명: 공식 호출 방식 안내
- 링크:
-
Artificial Analysis – d1.2-ultra 모델 페이지: 종합 지수와 각 세부 항목
- 링크:
artificialanalysis.ai/decision-models/d1-2-ultra - 설명: 본문의 순위 데이터는 모두 2026-11-17에 조회했어요
- 링크:
-
Artificial Analysis – Decision Index 방법 페이지: 가중치와 점수 정의
- 링크:
artificialanalysis.ai/methodology/decision-index - 설명: 의사결정 점수와 원시 정확도의 차이
- 링크:
-
APIYI 모델 총표: 서비스 중인 모델과 가격
- 링크:
docs.apiyi.com/models - 설명: 모델과 가격은 플랫폼 모델 목록을 기준으로 해요
- 링크:
작성자: APIYI 기술팀
기술 문의: 모델 선정이나 비교 스크립트에 궁금한 점이 있으시면 APIYI 공식 홈페이지에서 연락 주세요. 더 많은 연동 안내는 문서 센터에서 확인하실 수 있어요


