
작성자 주: 멀티모델 애플리케이션은 통합 메시지 형식, 프로바이더 어댑터 계층, 모델 기능 레지스트리를 통해 도구 호출, 추론 상태, 스트리밍 출력, 구조화 데이터, 캐시 차이를 처리해야 합니다.
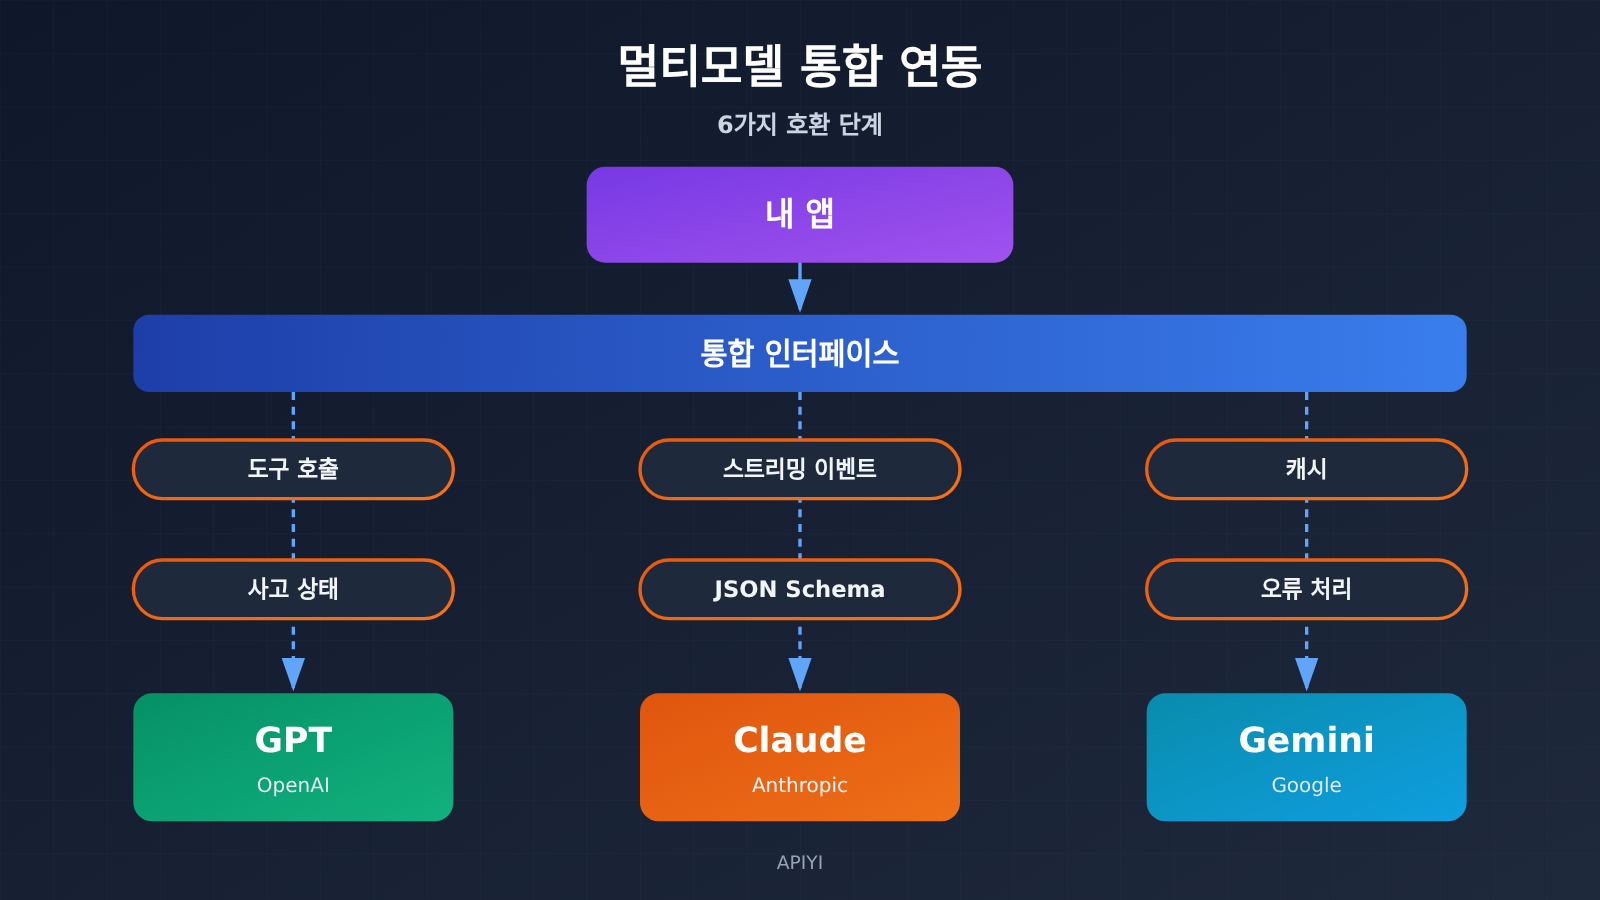
GPT, Claude, Gemini 모두 일반 텍스트 호출을 처리할 수 있고, Claude와 Gemini는 공식 OpenAI SDK 호환 엔드포인트도 제공합니다. 프로덕션급 애플리케이션에서 모델을 전환할 때는 6가지 호환 문제: 메시지 역할과 시스템 지시문, 도구 호출 프로토콜, 추론 파라미터와 사고 상태, 스트리밍 이벤트, 구조화 출력과 멀티모달, 캐시 과금과 오류 처리를 해결해야 합니다. Model ID만 바꾸면 간단한 질의응답은 동작하지만, 다중 턴 도구 호출, 스트림 중단 복구, 비용 산정은 별도로 처리해야 합니다. 비교적 안정적인 엔지니어링 방식은 “통합 비즈니스 인터페이스 + 프로바이더 어댑터(Provider Adapter) + 모델 기능 레지스트리”입니다. 이렇게 하면 모델 전환을 유지 관리 가능한 제품 기능으로 관리할 수 있습니다.
아래에서는 먼저 세 업체의 네이티브 API 구조 차이를 비교하고, OpenAI 호환 인터페이스가 어떤 시나리오를 커버할 수 있는지 설명합니다. 이어서 6가지 호환 문제가 어떤 실제 장애를 일으키는지 하나씩 분석하고, 6계층 연동 아키텍처와 실행 가능한 통합 호출 코드를 제시합니다. 마지막으로 출시 전에 수행할 6가지 호환성 테스트를 나열하고, 통합 API 게이트웨이와 네이티브 기능 어댑터가 어떻게 역할을 나누는지 설명합니다.
알아두기: 멀티모델 API 호환 용어집
| 용어 | 설명 |
|---|---|
| API | 애플리케이션이 모델 서비스에 요청을 보내고 결과를 받아오는 인터페이스예요. |
| SDK | 인터페이스 호출의 세부 구현을 감싼 소프트웨어 개발 도구 키트예요. |
| 네이티브 API | 벤더가 직접 설계한 주력 인터페이스로, 예를 들어 OpenAI Responses, Claude Messages, Gemini Interactions가 있어요. |
| 호환 인터페이스 | 다른 요청 형식(보통 OpenAI 형식)을 따르는 어댑터 진입점으로, 같은 SDK로 호출하기 쉽게 해줘요. |
| 함수 호출(Function Calling) | 모델이 구조화된 매개변수로 애플리케이션에 특정 외부 함수 실행을 요청하는 기능이에요. |
| 호출 ID | 모델이 시작한 도구 요청과 애플리케이션이 돌려준 실행 결과를 서로 연결해 주는 식별자예요. |
| 사고 서명(Thought / Thinking Signature) | 일부 모델이 추론 및 도구 호출 컨텍스트를 저장하는 데 사용하는 암호화된 상태 데이터로, 그대로 되돌려 보내야 해요. |
| 스트리밍 출력(Streaming) | 서버가 이벤트 단위로 결과를 순차 반환하고, 프런트엔드가 받는 대로 표시할 수 있는 방식이에요. |
| JSON Schema | JSON 데이터 구조와 검증 규칙을 설명하는 사양이에요. |
| 프롬프트 캐싱(Prompt Caching) | 반복되는 입력 프리픽스에 대해 계산 결과를 재사용해 지연 시간과 비용을 줄이는 기능이에요. |
| TTL | 캐시의 유지 시간으로, 만료되면 다시 기록해야 해요. |
| 어댑터(Provider Adapter) | 통합 요청을 특정 벤더의 네이티브 형식으로 변환하고, 반환 결과를 다시 통합 형식으로 변환하는 컴포넌트예요. |
| 기능 레지스트리 | 각 모델과 각 연결 엔드포인트가 실제로 어떤 매개변수와 기능을 지원하는지 기록한 구성 목록이에요. |
| 멱등 | 같은 작업을 한 번 실행하든 여러 번 실행하든 효과가 같다는 뜻으로, 재시도로 인한 중복 결제나 중복 발송을 방지하는 데 쓰여요. |
1 멀티모델 API 호환성: 모델을 바꾼다고 Model ID만 바꿔서는 안 되는 이유
세 업체 모두 하나의 model 필드로 모델을 지정할 수 있지만, 요청 본문, 응답 객체, 컨텍스트 상태를 구성하는 방식은 각기 다릅니다. 일반적인 질의응답에서는 차이가 필드 이름에 집중되기 때문에 적응 비용이 낮습니다. Agent 계열 애플리케이션은 도구 호출, 추론 상태, 스트리밍 이벤트에 의존하기 때문에, 그 차이가 곧바로 프로덕션 장애로 이어집니다.
1.1 GPT, Claude, Gemini三家 네이티브 API 대조
아래 표는 네이티브 API만 설명하며, 어떤 호환 레이어나 게이트웨이 엔드포인트도 다루지 않습니다.
| 구분 | OpenAI (네이티브) | Claude (네이티브) | Gemini (네이티브) |
|---|---|---|---|
| 주력 인터페이스 | Responses API, /v1/responses |
Messages API, /v1/messages |
Interactions API(2026년 6월 GA, 신규 프로젝트에 공식 권장); generateContent는 여전히 지원됨 |
| 입력 구성 | model + input |
model + messages + max_tokens, system은 메시지 배열과 별도 |
네이티브 Interactions 구조, 별도로 system_instruction 규칙이 있음 |
| 출력 구조 | 여러 유형의 출력 항목: 텍스트, reasoning 항목, function_call 등 |
content blocks: text, thinking, tool_use 등 |
steps: 모델 출력, 도구 호출, 추론 등 단계 |
| 종료 판정 | 응답 완료 이벤트 / 출력 항목 유형 | stop_reason(정상 종료, 도구 실행 필요 등) |
단계 유형과 상호작용 상태 |
| 컨텍스트 연속성 | previous_response_id |
애플리케이션이 전체 메시지 기록을 직접 되돌려 보냄 | previous_interaction_id, 선택적으로 서버 측 세션 상태 |
| 내장 도구 | 플랫폼 도구 + 사용자 정의 함수 | 주로 사용자 정의 도구 | Google Search, URL Context, 코드 실행 등 내장 도구; 서드파티 도구는 애플리케이션이 실행 |
위 표에서 볼 수 있듯이, 세 업체는 “누가 컨텍스트를 저장하는가”라는 점에서 이미 두 갈래 길로 나뉩니다. OpenAI와 Gemini는 서버 측에서 컨텍스트를 이어가는 방식을 지원하고, Claude Messages는 애플리케이션이 직접 기록을 되돌려 보내야 합니다. 애플리케이션의 세션 저장소가 둘 중 한 방식만을 전제로 설계되어 있다면, 다른 업체로 전환할 때 컨텍스트 유실이나 중복 전송이 발생합니다.
1.2 OpenAI 호환 인터페이스는 얼마나 많은 문제를 해결할 수 있을까
Claude와 Gemini 모두 OpenAI SDK 호환 엔드포인트를 제공합니다. Gemini의 공식 호환 엔드포인트는 generativelanguage.googleapis.com/v1beta/openai/이며, OpenAI 클라이언트를 사용할 때 base_url, API 키, model만 수정하면 됩니다. Claude의 호환 문서는 지원 범위를 명확히 한정하고 있으며, 2026-11-13 기준 알려진 제한 사항은 다음과 같습니다.
- 도구 정의의
strict파라미터는 무시되므로, 도구 파라미터의 엄격한 제약이 무력화됩니다. - Prompt Caching을 지원하지 않습니다.
- audio, file 유형 입력을 지원하지 않습니다.
system과developer메시지는 맨 앞으로 끌어올려 병합 처리됩니다.thinking관련 필드는 네이티브 API와 차이가 있습니다.
호환 인터페이스는 세 가지 시나리오에 적합합니다: 일반 채팅, 단일 턴 생성, 그리고 여러 모델의 답변 품질을 빠르게 비교하는 용도입니다. 복잡한 Agent 마이그레이션은 엄격한 도구 파라미터, 캐싱, 파일 입력, 다중 턴 추론 상태를 다루므로, 이런 기능은 네이티브 API로 돌아가거나 항목별 검증을 거친 뒤에 배포해야 합니다. 실용적인 판단 기준은 이렇습니다: 애플리케이션이 의존하는 기능이 네이티브 문서에만 등장한다면, 그것을 기능 레지스트리에 기록하고 전용 어댑터에서 처리하도록 하세요.
2 GPT, Claude, Gemini 모델을 전환할 때 가장 자주 만나는 여섯 가지 호환성 문제
2.1 메시지 역할과 시스템 지시문의 호환 처리
OpenAI는 developer와 system 등의 역할을 구분해요. Claude의 system 지시문은 메시지 배열 바깥에 위치하고, Gemini는 system_instruction을 사용하며 사용자와 모델 콘텐츠에도 자체적인 구조 규칙이 있어요. 세 모델 모두 “지시 우선순위 + 멀티턴 히스토리”를 표현하지만, 이를 담는 필드 위치는 각기 달라요.
흔한 장애는 대충 이어 붙이는 방식에서 나와요. 시스템 지시문, 히스토리 메시지, 도구 결과를 하나의 긴 문자열로 합쳐 사용자 입력으로 모델에 넘기는 거죠. 이렇게 해도 동작은 하지만 지시 우선순위가 약해져서, 모델이 히스토리 속 도구 출력을 사용자의 새 요구로 오해할 수 있어요. 올바른 방법은 애플리케이션 내부에서 역할 의미를 유지하고, 어댑터가 각 벤더의 필드로 매핑하도록 하는 거예요. 또한 Claude 호환 레이어는 system과 developer를 병합한다는 점을 유의해야 해요. 두 계층에 의존하는 프롬프트 설계는 실제 테스트로 효과를 확인해야 해요.
2.2 도구 호출 프로토콜과 호출 ID 호환 처리
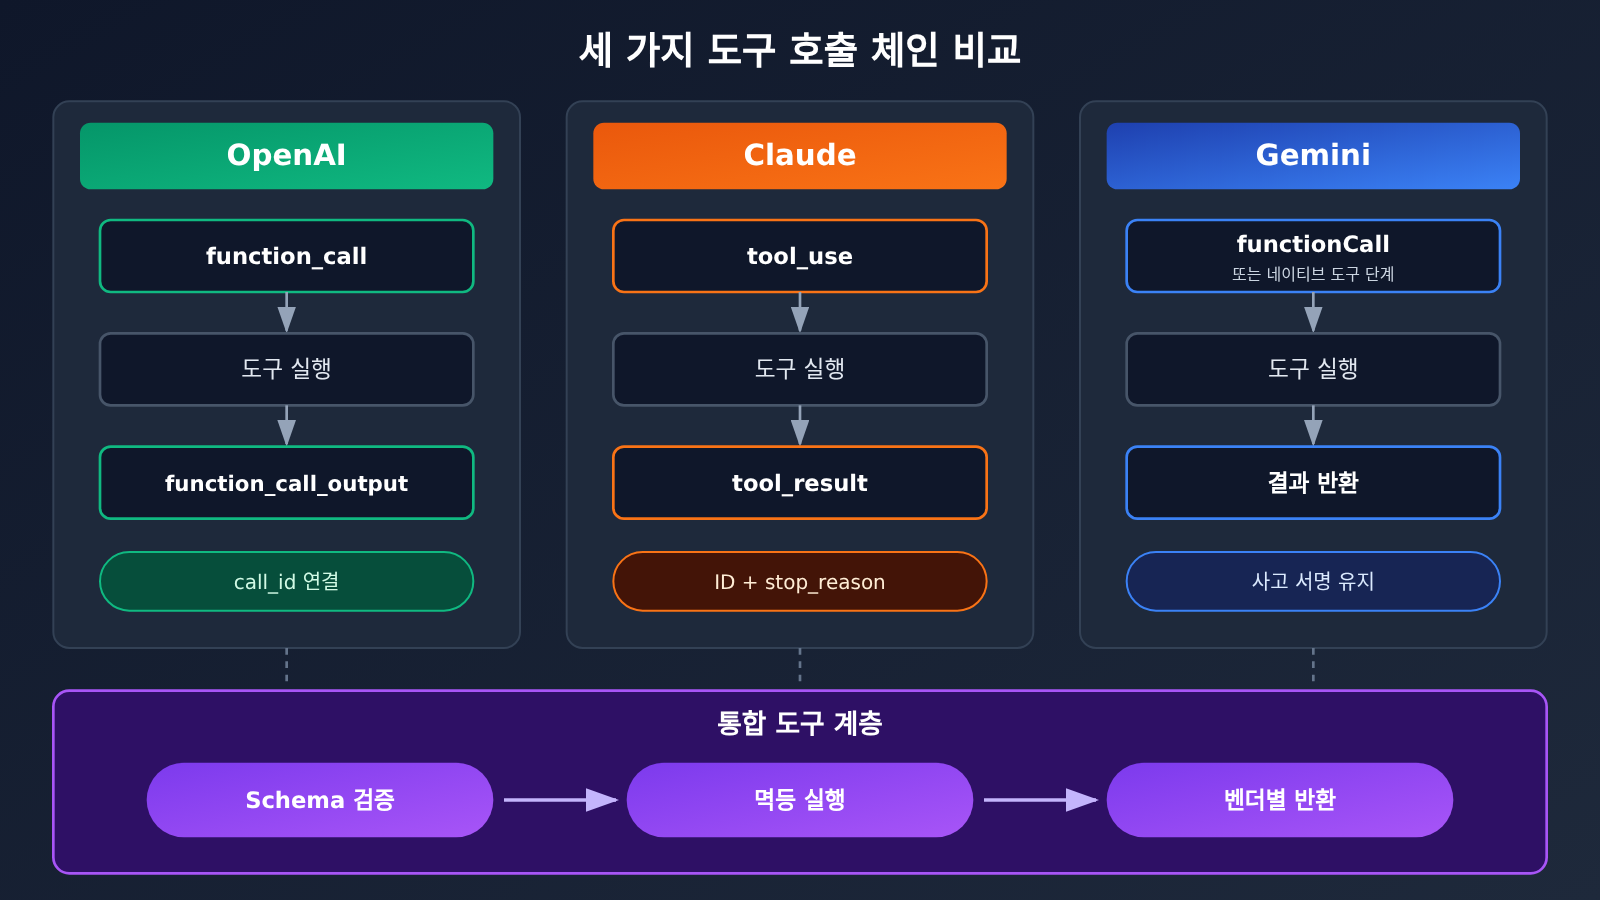
세 제공자 모두 Function Calling을 지원하며, 호출 흐름은 다음과 같아요:
| 단계 | OpenAI | Claude | Gemini |
|---|---|---|---|
| 모델의 호출 시작 | function_call 출력 항목 |
tool_use 콘텐츠 블록 |
functionCall / 네이티브 도구 단계 |
| 연결 식별자 | call_id |
tool_use의 ID |
해당 호출 식별자 |
| 애플리케이션의 결과 회신 | function_call_output |
tool_result 콘텐츠 블록 |
해당 결과 회신 구조 |
| 계속 필요 여부 | 출력 항목을 기준으로 판단 | stop_reason이 도구 실행 필요를 나타냄 |
단계 상태를 기준으로 판단 |
| 추론 상태 | reasoning 항목을 이력과 함께 전달해야 할 수 있음 | thinking 블록을 그대로 회신해야 할 수 있음 | stateless 모드에서는 thought 블록과 서명을 보존해야 함 |
도구 계층은 여섯 가지 정보를 온전히 보존해야 해요: 호출 ID, 함수명, 매개변수 JSON, 병렬 호출 관계, 실행 결과, 그리고 모델이 추론을 계속하도록 요구하는지 여부예요. 병렬 호출은 가장 오류가 나기 쉬운 부분이에요. 모델이 한 번에 여러 도구 요청을 시작했는데 애플리케이션이 그중 하나의 결과만 회신하거나 결과와 ID를 잘못 짝지으면, 다음 요청에서 매개변수 오류가 나거나 모델이 잘못된 데이터를 토대로 답변을 이어가요.
도구 계층에서는 먼저 JSON Schema로 매개변수를 검증한 뒤, 검증을 통과하면 실제 외부 작업을 실행하도록 통일하는 걸 권장해요. 모델이 생성한 매개변수가 항상 유효한 것은 아니므로, 사전 검증을 통해 “외부 시스템 호출” 전 단계에서 오류를 막을 수 있어요.
2.3 사고 모드와 컨텍스트 상태의 호환 처리
추론 파라미터의 이름과 의미는 세 서비스 간에 서로 대응되지 않아요.
- OpenAI:
reasoning.effort같은 파라미터를 사용해요. GPT-6 Astra와 GPT-6.1 Sol은reasoning.effort=none을 받아들이지 않고, 이 두 모델의 도구 호출은 Responses API를 사용해야 해요. - Claude: 최신 모델은 주로 Adaptive Thinking을 사용하고, 여기에 effort 같은 사고 설정을 곁들여요. 일부 신형 모델은 고정된
budget_tokens를 쓰는 구식 수동 사고 모드를 더는 지원하지 않아요. - Gemini: 모델마다 thinking level이나 budget을 사용하고, 추론을 끌 수 있는지, 어떤 단계가 있는지도 모델별로 달라요. 네이티브 API와 OpenAI 호환 진입점의 파라미터 매핑 규칙도 서로 달라요.
제품 UI에서 “빠름, 표준, 심층” 세 단계의 추론 강도를 설계할 때, 단계 이름이 담는 것은 제품의 의도예요. 어댑터는 이를 각 모델이 실제로 지원하는 파라미터로 변환해야 하고, 같은 단계라도 세 서비스가 받는 연산 자원은 서로 달라요. 또한 사용자가 보는 사고 요약과 실제로 과금되는 사고 토큰 수가 맞지 않을 수 있으니, 비용 집계는 인터페이스가 반환하는 사용량 필드를 기준으로 삼아야 해요.
멀티턴 도구 호출에서의 암호화 상태는 장기 실행 Agent가 가장 놓치기 쉬운 문제예요.
- OpenAI Responses의 reasoning 항목과 도구 호출은 히스토리에 따라 계속 전달해야 할 수 있어요.
- Claude의
thinking/redacted_thinking블록은 암호화 상태를 담을 수 있고, 도구 실행 후 되돌려 보낼 때 원래 구조를 유지해야 해요. - Gemini Interactions의 stateless 모드는 thought 블록과 서명을 그대로 보존해야 하고, stateful 모드를 사용할 때는 일부 상태를 서버 측에서 유지할 수 있어요.
채팅 창에 표시되는 텍스트만 저장하면 모델의 추론 히스토리를 온전히 복원할 수 없어요. 전형적인 장애는 이래요. Agent가 세 번째 도구 호출 후 갑자기 오류를 내거나, 이미 끝난 단계를 반복하기 시작하는 경우죠. 원인은 보통 중간의 어느 한 라운드에서 서명 블록을 잃어버린 데 있어요.
2.4 Streaming 스트리밍 이벤트의 통일
세 곳의 스트리밍 이벤트 타입과 순서, 종료 신호는 모두 다릅니다. OpenAI Responses는 response.output_text.delta, 도구 호출 증분, 그리고 response 완료 이벤트를 출력할 수 있습니다. Claude Messages 스트림은 message_start, content_block_delta, message_delta 등의 이벤트를 사용합니다. Gemini의 네이티브 API는 자체적인 출력과 단계 구조를 사용하죠.
프론트엔드에서 각 벤더의 원본 이벤트를 그대로 파싱하면, 모델을 하나 연결할 때마다 프론트엔드 코드를 수정해야 합니다. 백엔드에서 내부 이벤트 프로토콜로 통일해 변환하는 걸 권장합니다.
| 내부 이벤트 | 의미 | 처리 포인트 |
|---|---|---|
text_delta |
텍스트 증분 | 바로 덧붙여 표시 |
reasoning_summary |
사고 요약 | 접어서 표시할 수 있고, 과금은 usage 기준 |
tool_call_start |
도구 호출 시작 | 호출 ID와 함수명 기록 |
tool_call_args |
파라미터 분할 | 호출 ID 또는 인덱스로 이어 붙이고, 모두 모은 뒤에 파싱 가능 |
tool_result |
도구 실행 결과 | 호출 ID와 1:1 대응 |
usage |
사용량 통계 | 입력, 캐시, 사고, 출력 토큰 구분 |
completed |
정상 종료 | 명확한 종료 신호를 반드시 수신 |
error |
에러 또는 스트림 끊김 | 재시도 가능/불가능 구분 |
스트리밍 처리에는 자주 발생하는 세 가지 장애 지점이 있습니다. 첫째, 여러 도구 호출의 파라미터 조각이 교대로 도착하는데, 도착 순서대로 이어 붙이면 호출 ID가 뒤섞입니다. 둘째, JSON 파라미터가 임의의 문자 위치에서 잘리는데, 절반만 받은 상태에서 파싱하면 예외가 발생합니다. 셋째, 연결이 중간에 끊겼는데 완료 이벤트를 받지 못하면, 화면은 계속 ‘생성 중’ 상태에 머무릅니다. 변환 계층에서 이 세 가지 경우를 명시적으로 처리해야 합니다.
2.5 JSON Schema 구조화 출력과 멀티모달 능력의 차이
세 서비스 모두 구조화 출력 기능을 제공하지만, 지원하는 JSON Schema 특성, 엄격 모드, 그리고 도구 호출과의 결합 방식에는 차이가 있어요. Claude는 공식적으로 두 가지 메커니즘을 구분하는데, JSON outputs는 최종 응답의 구조를 제약하고, Strict tool use는 도구 호출 파라미터의 구조를 제약해요. 일부 모델은 엄격한 형식을 사용할 때 추가적인 Schema 컴파일 또는 캐싱 비용이 발생하기도 해요.
엔지니어링 관점에서의 권장 사항은 이래요. 애플리케이션이 자체적인 표준 JSON Schema를 유지하고, 능력 레지스트리에 각 모델이 어떤 Schema 특성을 지원하는지 기록해 두는 거예요. 지원하지 않는 특성은 어댑터가 폴백 변환을 수행하도록 하고요. 모델이 아무리 엄격하다고 말하더라도 애플리케이션 측에서 검증을 한 번 더 수행해야 하며, 검증에 실패하면 통제된 재시도나 오류 처리 흐름으로 넘어가야 해요.
멀티모달도 마찬가지예요. “이미지 입력을 지원한다”는 것은 능력 범주를 알려줄 뿐이므로, 구체적으로는 다음 항목들을 비교해야 해요. 허용되는 파일 유형, 크기와 이미지 개수, 비디오 및 오디오 능력, 파일 업로드 방식, 긴 컨텍스트의 상한과 실제 사용 가능한 범위, 최대 출력 토큰, 그리고 도구 호출을 멀티모달 입력과 함께 쓸 수 있는지 여부예요. Claude 호환 레이어가 audio, file 입력을 지원하지 않는 것도 레지스트리에 명시해야 할 구체적인 제한 사항이에요.
2.6 캐싱, 과금, 오류 처리의 모델 간 차이
세 곳의 프롬프트 캐싱 메커니즘은 차이가 뚜렷해요.
- OpenAI: GPT-5.6 및 이후 모델은 암시적 캐시와 명시적 캐시 브레이크포인트를 지원하며, TTL은 30분과 12시간 두 가지예요.
- Claude:
cache_control로 자동 캐시 또는 명시적 캐시를 지정할 수 있고, 5분과 1시간 두 가지 모드를 지원해요. 다만 이 기능은 Claude의 OpenAI 호환 레이어에서는 지원되지 않아요. - Gemini: 최신 모델은 자동 암시적 캐시를 제공하고, 일부 API와 모델은 캐시 객체를 명시적으로 생성하는 기능을 지원해요.
모델을 바꾸면 원래 제공사의 캐시는 보통 재사용할 수 없어요. 세션 도중에 Claude에서 Gemini로 전환하면, 첫 요청은 전체 입력 기준으로 과금돼요. 비용 예측에서 “캐시가 항상 적중한다”고 기본 가정하면, 전환 전략이 잦을수록 청구서 오차는 커져요.
표준 단가도 제공사별로 차이가 뚜렷해요. 2026-11-13 기준 공식 표준 가격은 다음과 같아요(USD / 백만 토큰).
| 모델 | 입력 | 출력 | 비고 |
|---|---|---|---|
| GPT-6 Astra | $10 | $50 | 도구 호출 시 Responses API를 사용해야 함 |
| GPT-6.1 Sol | $1 | $5 | 도구 호출 시 Responses API를 사용해야 함 |
| Claude Sonnet 5.5 | $2 | $10 | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | 프로모션 가격은 2026-12-31까지이며, 2027-01-01부터 $1.50 / $7.50로 조정 예정 |
이 표는 과금 차이를 설명하기 위한 것이고, 모델마다 성능과 사용 조건이 다르기 때문에 가격的高低을 곧바로 성능 비교로 환산할 수는 없어요. 또한 이 표에는 캐시 쓰기, 도구 호출, 서비스 등급, 제3자 마진 같은 비용은 포함되지 않았어요.
💰 비용 산정 권장 사항: 멀티모델 애플리케이션의 청구서는 “일반 입력, 캐시 쓰기, 캐시 적중, 사고 및 출력, 도구 비용, 장문 컨텍스트 추가 요금” 항목으로 나눠 기록해야 해요. APIYI apiyi.com을 통해 여러 모델을 통합 호출하면 각 모델의 사용량을 한곳에서 확인할 수 있어서, 라우팅 전략과 실제 비용을 대응시키기 쉬워요.
오류 처리 측면에서도 세 곳은 요청 속도, 토큰 속도, 할당량, 타임아웃, 오류 형식이 모두 달라요. 애플리케이션은 통일된 오류 분류를 세워야 해요. 인증 실패, 모델 미지원, 파라미터 오류, 요청 과대 또는 컨텍스트 초과, 429 속도 제한, 서버 오류, 네트워크 단절, 응답 스트림 중단, 도구 호출 실패 같은 항목이에요.
모델 폴백에서는 작업에 부작용이 있는지도 따져야 해요. 주 모델이 도구 실행 이후에야 타임아웃되고, 시스템이 자동으로 대체 모델로 전환해 작업 전체를 다시 돌리면 결제, 이메일 발송, 파일 수정 같은 작업이 두 번 실행될 수 있어요. 해결 방법은 부작용이 있는 도구에 멱등 키를 붙이고, 폴백 시에는 “아직 실행되지 않은 단계”부터 이어가는 거예요.
3 다중 모델 API 호환 아키텍처는 어떻게 설계해야 할까
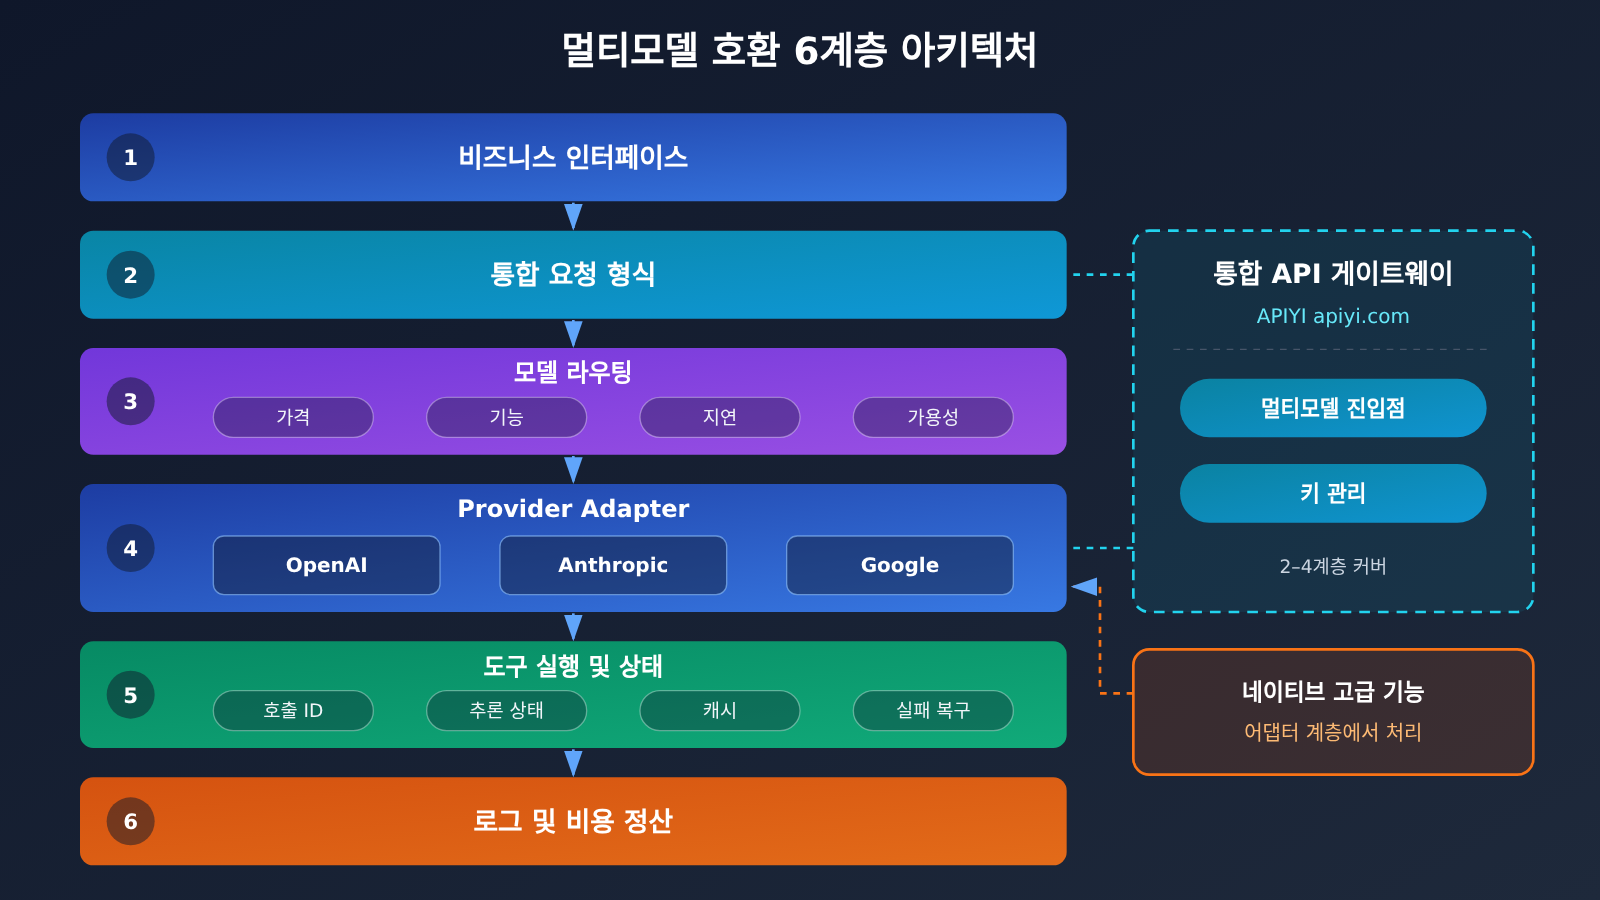
권장하는 6계층 구조는 다음과 같아요:
- 비즈니스 인터페이스: 사용자 질문, 자료 업로드, 모델 및 작업 선택.
- 통합 요청 형식: 통합된 구조로 메시지 기록, 첨부 파일, 도구 목록, 구조화 출력 요구 사항, 추론 강도, 작업 ID를 표현.
- 모델 라우팅: 가격, 능력, 지연, 가용성, 비즈니스 규칙에 따라 GPT, Claude, Gemini를 선택.
- Provider Adapter: 표준 요청을 각 사의 네이티브 형식으로 변환하고, 반환 결과를 내부 형식으로 다시 매핑.
- 도구 실행 및 상태 관리: 호출 ID, 실행 기록, 대화 컨텍스트, 벤더 추론 상태, 캐시, 실패 복구를 유지.
- 로그 및 비용 산정: 요청마다 모델, 토큰, 실제 비용, 지연, 캐시, 오류, 도구 호출을 기록.
3.1 통일된 메시지 및 도구 형식 구축
통일된 형식의 핵심 원칙은 히스토리를 두 개의 계층으로 나누어 저장하는 거예요. 첫 번째 계층은 보편적으로 통용되는 표준 히스토리로, 사용자 메시지, 모델의 최종 답변, 도구 요청, 도구 결과를 포함하며 어떤 벤더든 읽을 수 있어요. 두 번째 계층은 벤더 전용 상태로, reasoning 항목, thinking 서명, thought 블록 같은 것들을 벤더별로 격리해 저장하고, 같은 벤더에 요청할 때만 원본 그대로 다시 가져와요.
from dataclasses import dataclass, field
from typing import Any, Literal

@dataclass
class ToolCall:
    call_id: str              # 통일된 호출 ID, 어댑터가 벤더 ID와 상호 매핑을 담당
    name: str
    arguments: dict[str, Any]
    result: Any = None
    idempotency_key: str = "" # 부작용이 있는 도구는 반드시 설정해야 함

@dataclass
class Message:
    role: Literal["system", "developer", "user", "assistant", "tool"]
    content: list[dict]                      # 텍스트, 이미지 등 멀티모달 블록
    tool_calls: list[ToolCall] = field(default_factory=list)
    # 벤더 전용 상태: 키는 벤더명, 값은 원본 그대로 저장된 서명 / reasoning 블록
    vendor_state: dict[str, Any] = field(default_factory=dict)
모델을 전환할 때 어댑터는 표준 필드를 읽어 새로운 요청을 생성해요. vendor_state에서 다른 벤더에 속하는 부분은 전송하지 않고, 대상 벤더에 속하는 부분만 원본 그대로 되돌려 보내요.
3.2 Provider Adapter를 통한 네이티브 API 연동
각 어댑터는 세 가지 역할을 담당해요:
- 입력 변환: 역할 매핑(예를 들어 system을 Claude의 독립 필드로 옮기는 것), 도구 정의 변환, Schema 다운그레이드, 추론 단계 매핑.
- 출력 변환: 네이티브 응답과 스트리밍 이벤트를 2.4절의 내부 이벤트로 변환하고, 도구 호출 ID를 통합 ID로 매핑해요.
- 상태 처리: 서명, reasoning 항목 등 벤더 상태를 추출해 저장하고, 서버 측 연속 사용(
previous_response_id,previous_interaction_id)을 쓸지 아니면 전체 히스토리를 되돌려 보낼지 결정해요.
일반적인 질의응답은 OpenAI 호환 형식의 공용 어댑터로 처리할 수 있어요. 엄격한 도구 파라미터, 캐시 제어, 암호화된 사고 상태가 필요한 상황이라면 각각 네이티브 어댑터를 구현하면 돼요. 이렇게 하면 통합 진입점의 편리함을 그대로 누리면서도 고급 기능에 명확한 자리를 마련해 줄 수 있어요.
3.3 기능 레지스트리로 사용 가능한 기능 결정하기
기능 레지스트리는 “모델 + 접속 엔드포인트”를 단위로 실제 지원 여부를 기록해요. 같은 모델이라도 네이티브 API로 접속하는 경우와 호환 레이어로 접속하는 경우가 각각 다른 두 개의 레코드에 대응될 수 있어요. 아래는 구조 예시이고, 구체적인 값은 반드시 공식 문서와 직접 테스트한 결과를 기준으로 삼아야 해요:
gpt-6.1-sol@responses:
  tools: true
  tool_api: responses          # 도구 호출은 Responses API 사용을 요구함
  reasoning_effort: [low, medium, high]   # none은 허용하지 않음
  vendor_state: reasoning_items
claude-sonnet@openai-compat:
  tools: true
  strict_tools: false          # 호환 레이어는 strict를 무시함
  prompt_caching: false
  file_input: false
  merges_system_developer: true
gemini-flash@interactions:
  tools: true
  builtin_tools: [google_search, url_context, code_execution]
  vendor_state: thought_signatures
라우팅 레이어는 모델을 고르기 전에 레지스트리를 조회해요. 요청에 파일이 포함되어 있으면 file_input: false인 항목을 제외하고, 엄격한 도구 파라미터가 필요하면 strict_tools: true인 항목만 선택해요. 제품 UI에서도 이 정보를 활용해 현재 모델이 지원하지 않는 옵션을 숨길 수 있어서, 사용자가 굳이 오류를 마주칠 일이 줄어들어요.
4 다중 모델 API 호환 출시 전 테스트와 관측
4.1 간단한 질의응답부터 다중 턴 도구 체인까지의 6가지 호환 테스트
복잡도가 증가하는 순서대로 다음 6가지 테스트를 차례로 완료해요:
- 일반 질의응답: 같은 프롬프트를 세 모델에 보내고, 답변 내용과 Token 통계가 정상인지 확인해요.
- 스트리밍 출력: 출력이 지속적으로 도달하는지, 그리고 올바른 종료 신호를 수신하는지 확인해요.
- 도구 호출: 모델이 날씨 조회나 데이터 조회 도구를 호출하고, 애플리케이션이 실행한 뒤 결과를 반환해요.
- 다중 도구 루프: 두 라운드 이상 연속으로 도구를 호출하고, 히스토리와 호출 ID가 온전한지 확인해요.
- 구조화 JSON: 동일한 Schema로 출력하고, 애플리케이션 측 검증기로 구조를 검증해요.
- 모델 전환: 동일한 비즈니스 세션이 GPT, Claude, Gemini 사이에서 전환되며 컨텍스트, 도구 기록, 최종 답변이 모두 정상인지 확인해요.
4번과 6번 항목이 추론 상태 문제를 가장 잘 드러내니 지속적 통합 프로세스에 포함하는 걸 권장해요. 모델 버전을 업그레이드하거나 접속 엔드포인트를 교체할 때마다 다시 한 번씩 실행해 주세요.
4.2 통합된 비용 및 안정성 관측 구축
매 요청마다 최소한 다음 필드를 기록해요: 모델과 엔드포인트, 요청 성공률, 이상 유형(2.6절의 분류에 따름), 첫 토큰 지연과 총 작업 소요 시간, 항목별 Token(입력, 캐시 쓰기, 캐시 히트, 사고, 출력), 도구 호출 횟수와 실패 횟수, 재시도와 폴백 횟수.
모델을 평가할 때는 전체 작업의 총 소요 시간과 총비용을 봐야 해요. 단일 요청 데이터만으로는 참고 가치가 제한적이거든요. 단가가 저렴한 모델이라도 도구 파라미터 오류율이 높아 여러 번 재시도해야 한다면 전체 비용은 오히려 더 높아질 수 있어요.
5 통합 API 게이트웨이가 다중 모델 API 호환성에서 하는 역할
5.1 접속 및 유지보수 비용
세 개 모델을 동시에 사용한다는 건 계정 세 개, 키 세 개, 과금 체계 세 개, SDK 설정 세 개를 관리해야 한다는 뜻이에요. 통합 API 게이트웨이는 이런 작업을 하나의 진입점으로 모아줘요. 모델 접속과 자격 증명을 중앙에서 관리하고, 각 서비스 제공업체의 설정 유지보수를 줄이며, 설정 계층에서 모델을 선택하고 전환할 수 있게 하고, 사용량과 비용을 통합적으로 관찰하도록 해줘요. 모델 효과를 자주 비교해야 하는 팀이라면 새 모델을 시험해보는 문턱도 그만큼 낮아지죠.
5.2 APIYI의 포지셔닝: 통합 진입점과 네이티브 능력 적응의 분업
APIYI는 AI 대규모 언어 모델 API 집계 플랫폼으로, 하나의 API 키만으로 OpenAI 호환 인터페이스를 통해 OpenAI, Claude, Gemini 등 주류 모델을 호출할 수 있고 사용량 기반으로 과금해요. 아키텍처에서 “통합 호출 진입점”이라는 계층을 담당하기에 적합해요. 일반 질의응답, 스트리밍 출력, 모델 비교, 다중 모델 라우팅 모두 바로 연결할 수 있어요.
통합 호출 진입점과 벤더의 네이티브 능력을 완전히 일치시키는 것은 서로 다른 두 가지 기술 요구사항이에요. 특정 모델에 접속할 때는 여전히 능력 등록표에서 도구 호출, 사고 상태, 멀티모달, 캐시, 구조화 출력의 지원 범위를 항목별로 확인해야 해요. Responses API, cache_control, 암호화 서명 등 네이티브 능력에 의존하는 경로는 해당 엔드포인트가 실제로 사용 가능한지 확인한 뒤 출시하거나, 아니면 전용 네이티브 어댑터를 따로 남겨두어야 해요.
멀티모델 API 호환 빠르게 시작하기
초간단 예제: 동일한 프롬프트로 세 모델 비교하기
다음 코드는 동일한 OpenAI SDK 클라이언트로 세 모델을 차례로 호출하며, 4.1절의 첫 번째 테스트에 해당해요.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
)

# 모델 ID는 플랫폼 모델 목록을 기준으로 해요
MODELS = ["너의GPT모델ID", "너의Claude모델ID", "너의Gemini모델ID"]

for model in MODELS:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是幂等"}],
    )
    print(model, "→", resp.choices[0].message.content)
    print("usage:", resp.usage)
전체 구현 보기: 통합 스트리밍 이벤트 + 능력 레지스트리 + 도구 검증
import json
import openai
from openai import OpenAI
from jsonschema import validate, ValidationError

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
)

# 기능 레지스트리: 값은 구조 예시일 뿐이니 공식 문서와 실제 테스트 결과에 따라 관리하세요
CAPABILITIES = {
    "gpt":    {"model": "你的GPT模型ID",    "tools_via": "responses"},  # 도구 호출은 Responses 어댑터를 거쳐야 함
    "claude": {"model": "你的Claude模型ID", "tools_via": "chat"},
    "gemini": {"model": "你的Gemini模型ID", "tools_via": "chat"},
}

def classify_error(e: Exception) -> str:
    """오류를 통합 분류해 재시도 가능 여부를 판단합니다"""
    if isinstance(e, openai.AuthenticationError):
        return "auth_failed"
    if isinstance(e, openai.NotFoundError):
        return "model_not_supported"
    if isinstance(e, openai.RateLimitError):
        return "rate_limited"          # 백오프 후 재시도 가능
    if isinstance(e, openai.BadRequestError):
        return "invalid_request"       # 파라미터 오류 또는 컨텍스트 초과이므로 무작정 재시도하면 안 됨
    if isinstance(e, openai.APIConnectionError):
        return "network_error"
    if isinstance(e, openai.InternalServerError):
        return "server_error"
    return "unknown"

def stream_chat(provider: str, messages: list, tools: list | None = None):
    """OpenAI 호환 형식의 스트림을 내부 통합 이벤트로 변환합니다"""
    cap = CAPABILITIES[provider]
    if tools and cap["tools_via"] != "chat":
        raise NotImplementedError(f"{provider} 的工具调用请交给原生适配器处理")

    kwargs = {
        "model": cap["model"],
        "messages": messages,
        "stream": True,
        "stream_options": {"include_usage": True},
    }
    if tools:
        kwargs["tools"] = tools

    calls: dict[int, dict] = {}   # index 기준으로 병렬 도구 호출의 파라미터 조각을 이어붙임
    finished = False
    try:
        for chunk in client.chat.completions.create(**kwargs):
            if not chunk.choices:
                if chunk.usage:
                    yield {"type": "usage", "data": chunk.usage.model_dump()}
                continue
            choice = chunk.choices[0]
            delta = choice.delta
            if delta.content:
                yield {"type": "text_delta", "data": delta.content}
            for tc in delta.tool_calls or []:
                slot = calls.setdefault(tc.index, {"id": None, "name": "", "args": ""})
                if tc.id:
                    slot["id"] = tc.id
                if tc.function and tc.function.name:
                    slot["name"] = tc.function.name
                    yield {"type": "tool_call_start", "data": {"id": slot["id"], "name": slot["name"]}}
                if tc.function and tc.function.arguments:
                    slot["args"] += tc.function.arguments
                    yield {"type": "tool_call_args", "data": {"index": tc.index}}
            if choice.finish_reason:
                finished = True
                yield {"type": "completed", "data": {
                    "finish_reason": choice.finish_reason,
                    "tool_calls": list(calls.values()),
                }}
    except Exception as e:
        yield {"type": "error", "data": classify_error(e)}
        return
    if not finished:
        yield {"type": "error", "data": "stream_interrupted"}  # 중간에 스트림이 끊김

EXECUTED_KEYS: set[str] = set()   # 프로덕션 환경에서는 영구 저장소로 교체하세요

def run_tool(call: dict, schema: dict, func, idempotency_key: str | None = None):
    """먼저 파라미터를 검증한 뒤 멱등하게 실행합니다"""
    try:
        args = json.loads(call["args"])   # 조각이 모두 모인 뒤에만 파싱
        validate(instance=args, schema=schema)
    except (json.JSONDecodeError, ValidationError) as e:
        return {"error": f"invalid_arguments: {e}"}
    if idempotency_key:
        if idempotency_key in EXECUTED_KEYS:
            return {"skipped": "already_executed"}
        EXECUTED_KEYS.add(idempotency_key)
    return func(**args)

# 사용 예시
for event in stream_chat("claude", [{"role": "user", "content": "介绍一下流式输出"}]):
    print(event)
🚀 빠른 시작: APIYI apiyi.com 에서 회원가입하면 무료 테스트 크레딧을 받을 수 있어요. 위 코드로 동일한 Key 아래에서 4.1절의 처음 두 가지 테스트를 완료해 보세요. 도구 호출과 다중 턴 추론 관련 테스트는 기능 레지스트리를 참고해 모델별로 하나씩 검증하시길 권합니다.
자주 묻는 질문 FAQ
Q1: 멀티모델 API 호환 문제는 주로 무엇을 의미하나요?
같은 애플리케이션이 GPT, Claude, Gemini 사이를 전환할 때, 네이티브 API 구조가 달라서 처리해야 하는 차이를 말해요. 주로 6가지로 나뉘어요: 메시지 역할, 도구 호출, 추론 상태, 스트리밍 이벤트, 구조화 출력과 멀티모달, 캐시 과금과 오류 처리예요.
Q2: OpenAI 호환 인터페이스로 Claude와 Gemini를 호출할 때도 어댑터 레이어가 필요한가요?
일반 채팅은 호환 인터페이스를 바로 사용할 수 있어요. 엄격한 도구 파라미터, Prompt Caching, 파일 입력, 암호화된 사고 상태가 관련되면 어댑터 레이어가 필요해요. Claude 공식 호환 레이어를 예로 들면, `strict`를 무시하고 캐시와 audio/file 입력도 지원하지 않아요. 이런 차이는 능력 레지스트리에 기록해 두어야 해요.
Q3: Gemini 새 프로젝트에는 Interactions API를 써야 하나요, generateContent를 써야 하나요?
Interactions API는 2026년 6월에 GA에 진입했고, Google은 새 프로젝트에서 우선 채택할 것을 권장해요. 서버 측 세션 상태, `previous_interaction_id`, steps 구조를 지원해요. `generateContent`도 여전히 지원되며, 기존 프로젝트는 계획에 따라 마이그레이션할 수 있어요.
Q4: 세션 중간에 모델을 전환하면 히스토리는 어떻게 처리하나요?
사용자 메시지, 최종 답변, 도구 요청, 도구 결과는 표준 히스토리로 저장하고, 전환 후에는 대상 어댑터가 다시 조립해요. 서명, reasoning 항목 등 벤더 전용 상태는 별도로 저장하고, 같은 벤더에 요청할 때만 원본 그대로 되돌려 보내요. 또한 전환 후에는 원래 벤더의 캐시를 보통 재사용할 수 없으니, 첫 라운드의 전체 입력 비용을 미리 고려해야 해요.
Q5: 세 모델이 제 비즈니스에서 호환되는지 빠르게 검증하려면 어떻게 하나요?
다음 단계를 권장해요:
1. APIYI apiyi.com에 접속해 계정을 등록하고 API Key와 무료 테스트 크레딧을 받아요.
2. 이 글의 코드를 사용해 base_url을 APIYI 인터페이스 주소로 설정하고, 세 모델 ID를 입력해요.
3. 4.1절의 여섯 가지 테스트를 단계별로 실행하고, 성공률, 예외 유형, 비용, 총 소요 시간을 기록해요.
Q6: 모델 자동 폴백을 설정할 때 주의할 점은 무엇인가요?
먼저 작업에 부작용이 있는지 판단해야 해요. 결제, 이메일 발송, 파일 수정 등의 도구는 반드시 멱등 키를 가져야 하고, 폴백 시에는 완료되지 않은 단계부터 이어서 전체 작업을 다시 실행하지 않도록 해요. 속도 제한과 서버 오류는 백오프 재시도가 적합하고, 파라미터 오류와 컨텍스트 초과는 요청을 수정한 후에 다시 보내야 해요.
Q7: 멀티모델 라우팅 시 비용을 어떻게 제어하나요?
항목별 토큰으로 비용을 기록하고, 전체 작업의 총비용으로 비교해요. 세 곳의 단가 차이가 커서, 예를 들어 GPT-6 Astra의 출력 가격은 백만 토큰당 $50이고, Gemini 3.8 Flash의 현재 프로모션 가격은 $3.75예요. APIYI apiyi.com에서 각 모델 사용량을 통합 조회하면 고비용 경로를 더 빨리 발견할 수 있고, 이를 바탕으로 라우팅 규칙을 조정할 수 있어요.
Q8: 통합 API 게이트웨이에는 어떤 한계가 있나요?
게이트웨이가 통합하는 것은 호출 진입점, 키, 과금이에요. 벤더 네이티브 고급 기능(예: Responses API 전용 도구 호출, `cache_control`, 암호화 서명 반환)의 사용 가능 여부는 특정 엔드포인트의 지원 상황에 따라 다르므로 항목별로 실제 테스트가 필요해요. 이런 기능에 의존하는 경로는 네이티브 어댑터를 보완으로 유지해야 해요.
멀티모델 API 호환 핵심 포인트
- 모델 교체 ≠ ID 교체: 일반 Q&A는 그대로 이전할 수 있지만, 에이전트 체인에서는 6가지 차이를 처리해야 해요.
- 호환 계층의 범위에는 한계가 있어요: Claude 호환 계층은
strict를 무시하며, 캐시와 파일 입력은 지원하지 않아요. - 서명은 원본 그대로 보존해야 해요: thinking / thought 서명이 사라지는 것은 다중 턴 도구 체인에서 오류가 발생하는 흔한 원인이에요.
- 스트리밍 이벤트를 통일해야 해요: 백엔드는 8가지 내부 이벤트를 출력하고, 프런트엔드는 한 가지 프로토콜만 연결해요.
- 기능 레지스트리 기반 라우팅: ‘모델 + 엔드포인트’ 단위로 실제 지원하는 기능을 기록해요.
- 폴백은 멱등성을 보장해야 해요: 부작용이 있는 도구에는 멱등 키를 붙여 중복 실행을 막아요.
- 출시 전 테스트: APIYI apiyi.com의 무료 사용량으로 6가지 호환성 테스트를 먼저 통과해 보세요.
요약
하나의 앱에 GPT, Claude, Gemini를 동시에 연결할 때 핵심은 차이점을 소수의 컴포넌트에 모아 관리하는 것이에요.
- 통합 메시지 및 도구 형식: 표준 히스토리와 벤더 전용 상태를 계층형으로 저장해, 모델을 바꿔도 컨텍스트가 유지돼요.
- Provider Adapter: 입력 변환, 출력 변환, 상태 처리를 담당하고, 네이티브 고급 기능은 여기에서 구현해요.
- 기능 레지스트리: 모델별·엔드포인트별로 도구, 추론, 멀티모달, 스키마, 캐시 지원 여부를 있는 그대로 기록하며, 이 정보가 라우팅과 UI 옵션을 결정해요.
이 바탕 위에서 6가지 호환성 테스트와 항목별 비용 모니터링으로 출시 품질을 지켜요. 일반 호출과 모델 비교 단계에서는 APIYI apiyi.com을 이용해 하나의 키로 여러 모델을 빠르게 검증하고, 테스트 결과에 따라 어떤 체인에 네이티브 맞춤 구현이 필요한지 판단하는 걸 추천해요.
📚 참고 자료
- OpenAI Function Calling: 도구 호출,
call_id및function_call_output - 링크:
developers.openai.com/api/docs/guides/function-calling -
설명: Responses API 도구 호출 프로토콜에 대한 권위 있는 설명
-
OpenAI 최신 모델 마이그레이션 가이드: GPT-6 시리즈 추론 파라미터 및 인터페이스 요구사항
- 링크:
developers.openai.com/api/docs/guides/latest-model -
설명:
reasoning.effort값 제한 및 Responses API 요구사항 -
OpenAI Prompt Caching: 캐시 중단점 및 TTL
- 링크:
developers.openai.com/api/docs/guides/prompt-caching -
설명: 암시적 및 명시적 캐싱 메커니즘
-
Claude OpenAI SDK 호환: 호환 계층 지원 범위 및 제한
- 링크:
platform.claude.com/docs/en/cli-sdks-libraries/libraries/openai-sdk -
설명:
strict, 캐싱, 파일 입력, system 병합 등 차이점 -
Claude Extended Thinking: Adaptive Thinking 및 사고 서명
- 링크:
platform.claude.com/docs/en/build-with-claude/extended-thinking -
설명: 다중 턴 도구 호출에서 thinking 블록의 반환 규칙
-
Claude 구조화 출력 및 캐싱: JSON outputs, Strict tool use,
cache_control - 링크:
platform.claude.com/docs/en/build-with-claude/structured-outputs - 링크:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
설명: 구조화 제약 및 캐싱 모드
-
Gemini Interactions API 및 OpenAI 호환: 새 인터페이스 및 호환 진입점
- 링크:
ai.google.dev/gemini-api/docs/interactions-overview - 링크:
ai.google.dev/gemini-api/docs/openai -
설명: steps 구조, 세션 상태 및 호환 파라미터 매핑
-
Gemini 사고 서명, 도구 호출 및 캐싱
- 링크:
ai.google.dev/gemini-api/docs/thought-signatures - 링크:
ai.google.dev/gemini-api/docs/function-calling - 링크:
ai.google.dev/gemini-api/docs/caching -
설명: stateless 모드 서명 보존, 도구 프로토콜 및 명시적 캐싱
-
세 곳의 공식 가격 페이지
- 링크:
developers.openai.com/api/docs/pricing - 링크:
platform.claude.com/docs/en/models/sonnet-5-5/overview - 링크:
ai.google.dev/gemini-api/docs/pricing - 설명: 이 글의 가격표 데이터 출처, 확인 날짜 2026-11-13
작성자: APIYI 기술팀
기술 교류: APIYI 웹사이트 홈페이지에서 저희에게 연락해 주시면 감사하겠습니다. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인하실 수 있습니다.


