
作者注:生码率超过 30% 不等于交付变快。本文拆解“7% 理论上限”的推导逻辑,分析 5 个流程瓶颈,并给出一张团队自查清单。
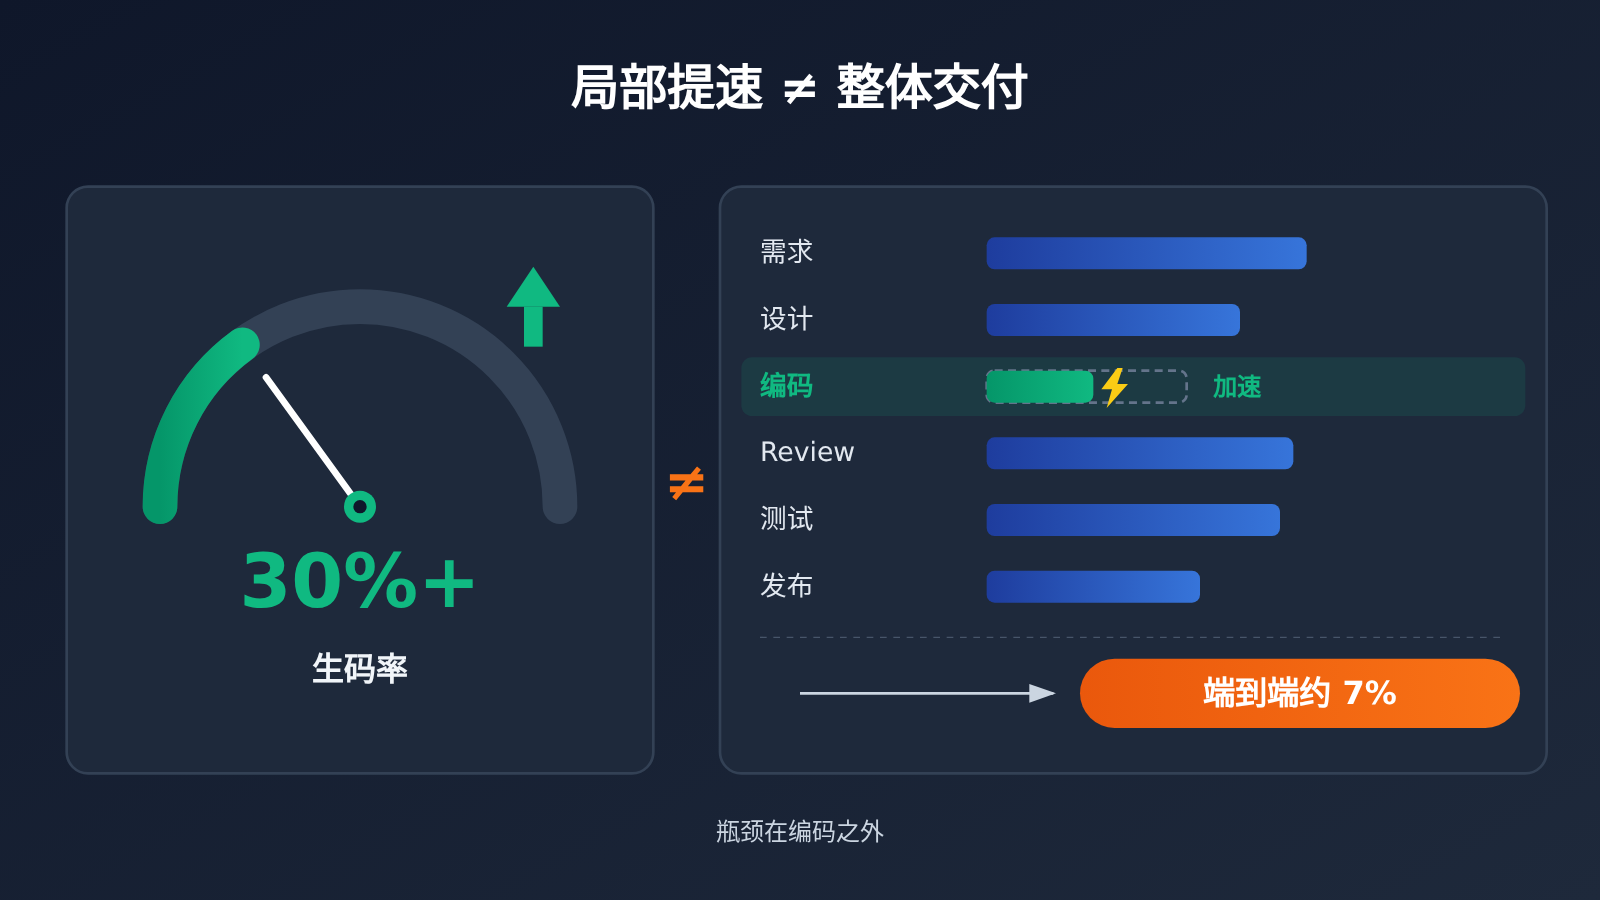
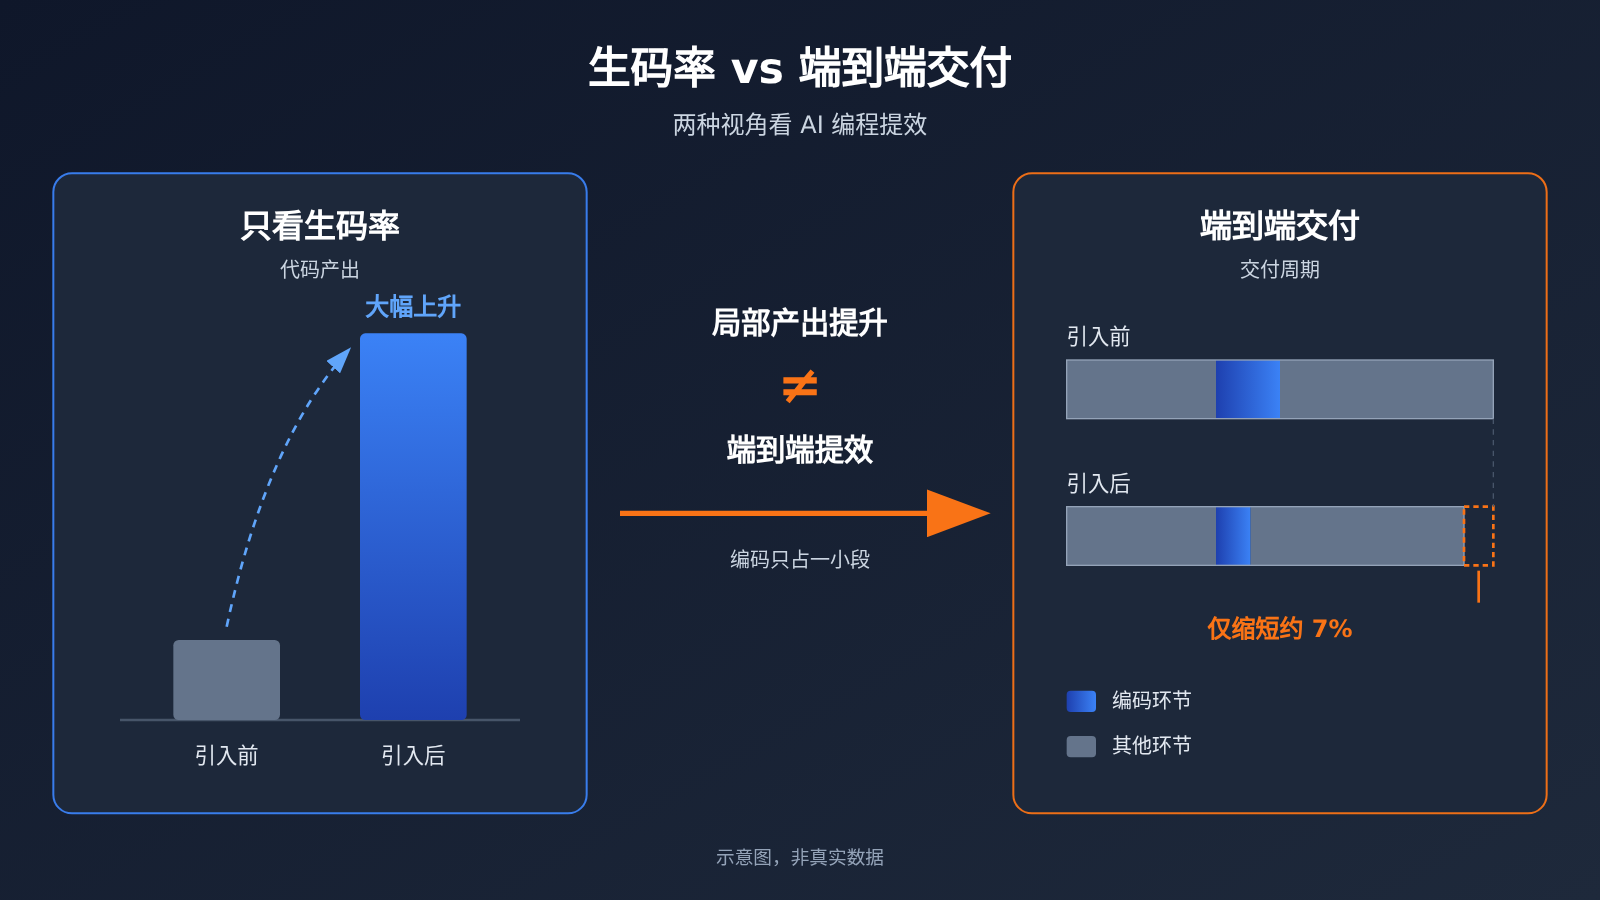
先说结论:生码率不等于交付速度。AI 生成的代码占比从个位数涨到 30% 以上,提升的只是“编码”这一个环节的产出。端到端交付时间还包括需求确认、设计、Review、测试、联调、发布和验收。编码在整条链路里往往只占一部分,所以生码率提升得再多,交付周期也只能缩短 编码占比所允许的那一点。
这也解释了很多技术管理者的困惑:工具推了、生码率报表很好看,交付周期却没怎么变。有一份行业材料根据某个团队的耗时拆解,推算出端到端提效的上限大约在 7% 量级。这不是唱衰 AI 编程,而是提醒大家:真正卡住交付的,是编码之外的 5 个瓶颈。本文会讲清 7% 是怎么算出来的、它适用的边界,以及你的团队该如何自查。
生码率超过 30% 与 7% 上限:核心信息速览
在进入推导之前,先用一张表把这次讨论的关键信息和口径交代清楚。尤其要注意每个数字的来源和可信程度,后文所有分析都建立在这些边界之上。
| 信息项 | 详情 | 口径说明 |
|---|---|---|
| 生码率 | 超过 30% | 指代码中由 AI 生成的比例,只反映编码环节产出 |
| 端到端提效上限 | 约 7% 量级 | 特定团队耗时拆解下的推算,不是普适定律 |
| 业界交流说法 | 约 3%-5% | 来自交流,缺少可核验样本 |
| 有效代码吞吐 | 2-3 倍 | 团队回顾数据,统计口径与对照方法未披露 |
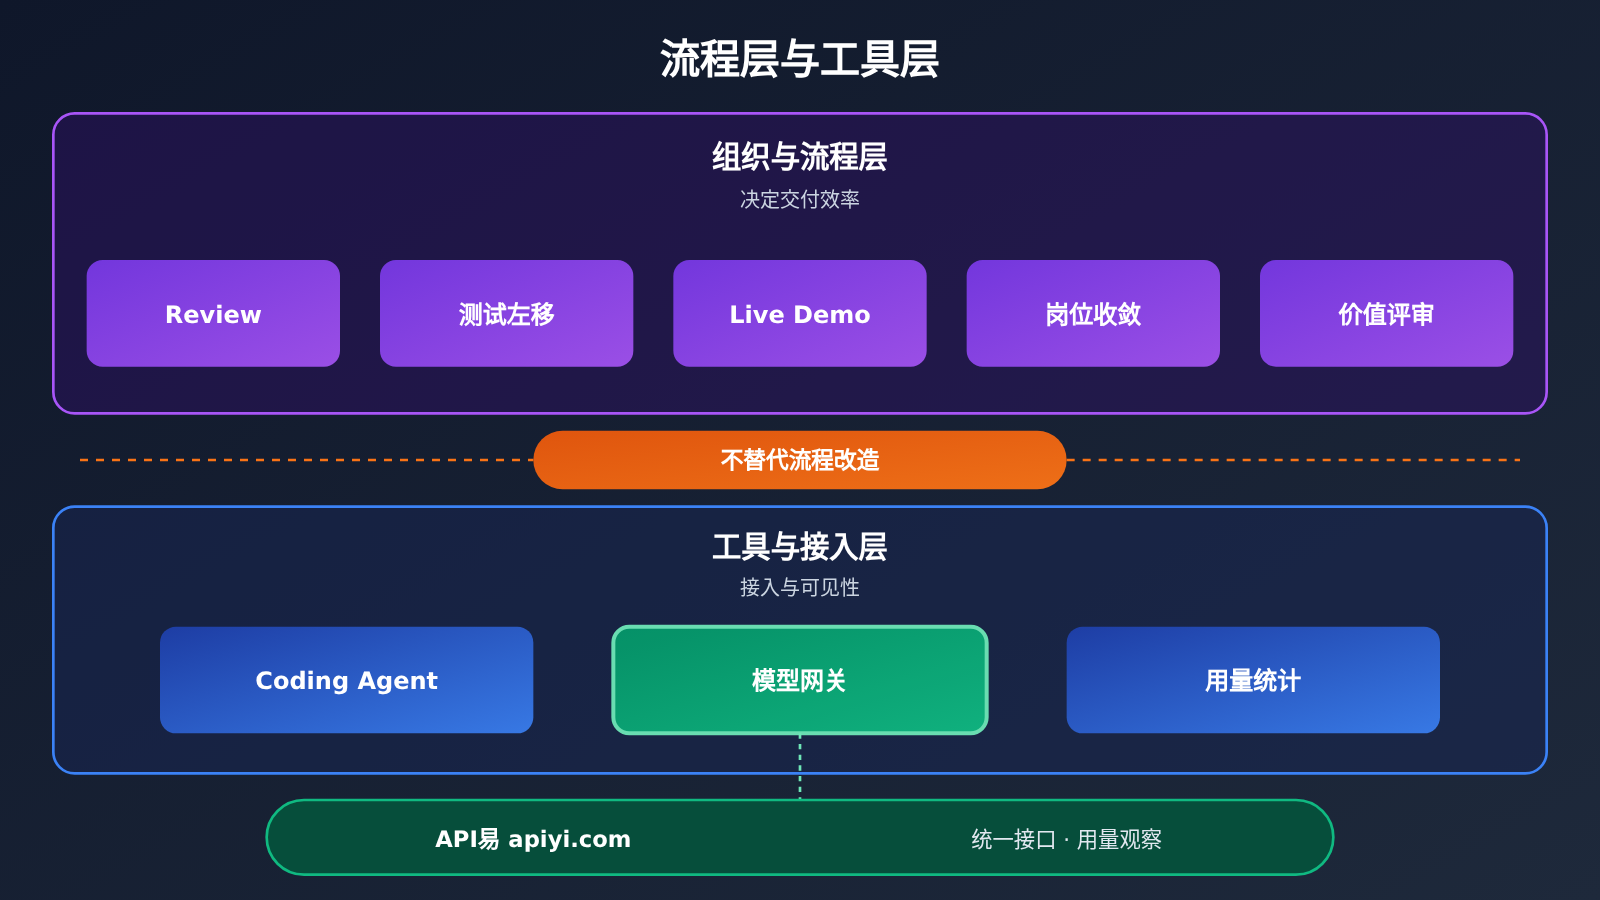
| 五个瓶颈 | Review 排队、测试与观测左移、Live Demo、岗位收敛、价值评审 | 组织与流程层面的问题 |
| Coding Agent 接入 | 可通过 API易 apiyi.com 等聚合接口统一接入 | 解决接入与用量观察,不解决流程瓶颈 |
这几个数字之间并不矛盾。“2-3 倍有效代码吞吐”说的是编码产出,“7%”和“3%-5%”说的是端到端交付。前者是局部指标,后者是全局指标,中间隔着一整条交付链路。
7% 上限怎么来的:生码率与编码占比的乘法关系
端到端提效公式拆解
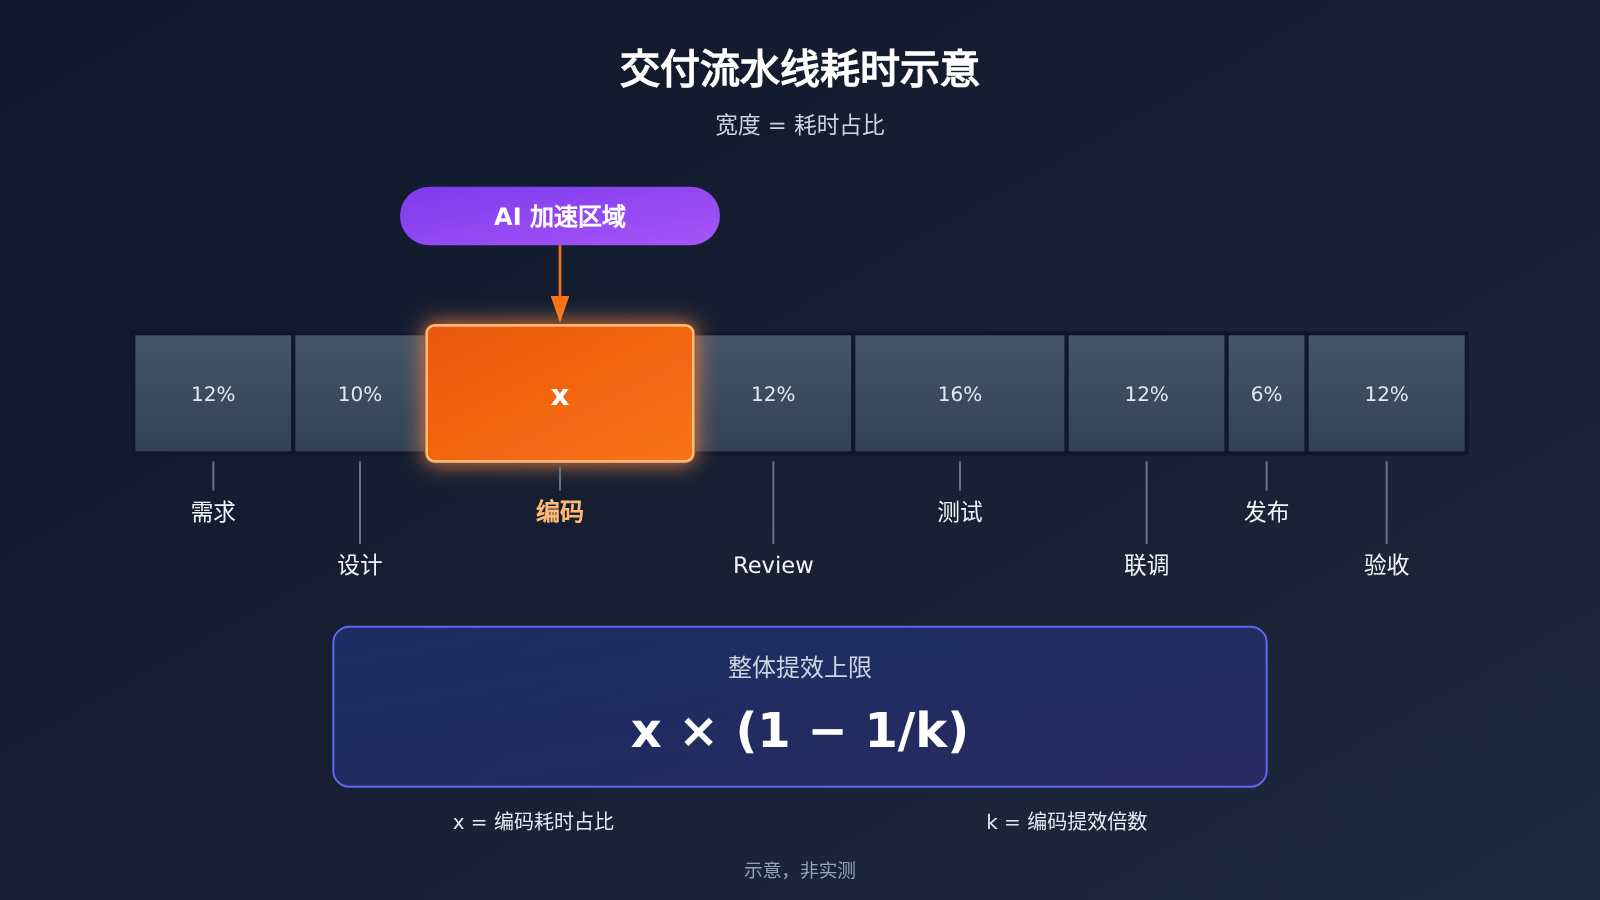
端到端提效的上限可以用一个简单的公式估算:端到端提效上限 ≈ x × (1 - 1/k)。其中 x 是编码环节占总交付时间的比例,k 是编码环节的提效倍数。这本质上是阿姆达尔定律在研发流程上的应用:你只加速了系统的一部分,整体收益就被这一部分的占比封顶。
举个直观的例子:假设编码占交付时间的 14%,AI 让编码快了一倍(k = 2),那么 14% × (1 - 1/2) = 7%。即使假设编码时间被压缩到零(k 趋于无穷大),端到端最多也只能缩短 14%。下表列出几组假设参数下的计算结果,它们只是公式演示,不是任何团队的实测数据。
编码占比 x |
编码提效倍数 k |
端到端提效上限 | 解读 |
|---|---|---|---|
| 10% | 3 | 约 6.7% | 编码快 3 倍,整体仍不到 7% |
| 14% | 2 | 7% | 与材料推算量级相当的一组示例 |
| 20% | 1.5 | 约 6.7% | 提效倍数低时收益很快被稀释 |
| 20% | 2 | 10% | 编码占比高的团队空间更大 |
| 30% | 2 | 15% | 编码密集型团队的情况 |
| 20% | 趋于无穷 | 20% | 编码时间归零时的理论天花板 |
生码率 30% 不等于编码快 30%
还有一个常被忽略的误区:生码率和 k 不是一回事。生码率说的是“多少代码由 AI 写出”,而 k 说的是“编码耗时缩短了多少”。AI 生成的代码仍需要阅读、调试和修改,生成本身也有提示、等待和纠错的成本。
即便做一个极端简化的假设,认为 AI 生成的那 30% 代码完全不花时间,编码提效倍数也只有 1 / (1 - 0.3) ≈ 1.43。再乘以编码占比,端到端收益就更小了。所以材料里 7% 的量级并不奇怪,反而说明问题的关键不在“生成更多代码”,而在编码之外的环节。
需要再次强调:7% 是基于某个特定团队耗时拆解的推算,你的团队编码占比、需求稳定度、测试体系都不同,结果可能更高也可能更低。它的价值是提供一种思考框架,而不是一个可以直接套用的结论。
交付没变快的 5 个瓶颈:生码率之外的真问题
当编码变快后,压力会沿着流水线向下游传导。下面五个瓶颈,有的是 AI 编程放大出来的新问题,有的是一直存在、只是以前被编码速度掩盖了。
瓶颈 1:骨干 Review 排队
AI 生成的代码越多,需要审查的代码就越多。Review 往往集中在少数骨干身上,他们既要理解业务上下文,又要判断 AI 代码的边界条件和潜在风险。结果是编码阶段省下的时间,很大一部分变成了 Review 队列里的等待时间。
更麻烦的是,AI 代码“看起来都对”,审查者需要更仔细地读,单位代码的 Review 成本未必下降。如果不调整 Review 机制,例如分级审查、明确哪些改动可以由非骨干审批、把规范检查交给自动化工具,骨干就会成为整条链路上最窄的瓶颈。
瓶颈 2:测试与观测左移
很多团队的测试、监控和可观测性是在开发后期才介入的。编码变快之后,问题被更快地堆积到测试阶段,返工反而更集中。如果测试用例、埋点和告警规则不能在编码前或编码中同步设计,后期的联调和修复会吞掉前面的收益。
测试与观测左移的核心,是让“验证”和“编写”同时发生。对于 AI 生成的代码,这一点尤其重要,因为你需要可运行的验证手段来快速判断生成结果是否正确,而不是依赖人工逐行确认。
瓶颈 3:用 Live Demo 确认需求,减少返工
交付周期里最昂贵的往往不是写代码,而是写错了再改。需求理解偏差导致的返工,会让编码、Review、测试全部重来一遍。AI 让编码变便宜之后,一个更好的用法是快速做出可运行的 Live Demo,让需求方在真实交互里确认“是不是这个意思”。
这相当于把需求确认从文档评审变成原型评审。文档容易各自理解,可运行的 Demo 则能尽早暴露分歧。编码成本下降带来的真正红利,可能不是更快写完正式代码,而是更便宜地试错。
瓶颈 4:岗位收敛,PDFE 与 ABE 的角色变化
传统流程中,产品、设计、前端、后端、测试之间存在大量交接。每一次交接都意味着等待、上下文丢失和重新对齐。材料中提到的 PDFE、ABE 等角色合并方向,本质上是让一个人或一个小组覆盖更长的链路,减少交接次数。
当 AI 承担了更多编码工作后,工程师有余力向需求和测试两端延伸,岗位收敛才变得可行。但要注意,不同规模团队复制这种组织调整的条件和成本,目前缺少证据。小团队可能天然适合,大型组织则涉及职责、考核和协作方式的系统性改变,不能简单照搬。
瓶颈 5:价值评审与概念字典/SDD
如果概念和数据定义没有对齐,AI 写得越快,错得越快。同一个业务名词在不同模块里含义不同,接口字段口径不一致,这些问题会在联调和验收阶段集中爆发。材料提到的做法是先做价值评审,再用概念字典和 SDD(规格驱动开发)对齐概念与数据,然后再写代码。
价值评审回答的是“这件事值不值得做”,概念字典和 SDD 回答的是“我们说的是不是同一件事”。这两步看起来增加了前期成本,但它们让 AI 有了清晰、一致的上下文,生成的代码更容易一次对齐。
5 个瓶颈与对应动作
| 瓶颈 | 典型症状 | 建议动作 | 观察指标 |
|---|---|---|---|
| 骨干 Review 排队 | PR 等待时间变长,骨干超负荷 | 分级审查,自动化规范检查 | PR 平均等待时长 |
| 测试与观测左移 | 返工集中在测试阶段 | 用例与埋点前置设计 | 测试阶段缺陷回退次数 |
| Live Demo 确认需求 | 验收时发现“不是想要的” | 用可运行原型确认需求 | 需求变更与返工次数 |
| 岗位收敛 | 交接多、等待多、上下文丢失 | 减少交接节点,扩大单人链路 | 环节间交接次数 |
| 价值评审与概念字典/SDD | 联调时口径不一致 | 编码前对齐概念与数据 | 联调阶段问题数量 |
团队自查:如何拆解自己的交付耗时与生码率收益
与其争论 7% 还是 3%-5%,不如把自己团队的数字算出来。下面是一套可以直接落地的拆解方法,建议选一个小项目先跑一遍。
- 拆环节:把一个需求从提出到上线的过程,按需求、设计、编码、Review、测试、联调、发布、验收拆开,记录每段的实际耗时和等待时间。
- 算编码占比:用编码环节的耗时除以总交付时间,得到你的
x。很多团队会发现这个数字比想象中小。 - 找等待与返工:单独统计 Review 排队时间、测试返工次数、需求变更次数,这些通常是隐藏的大头。
- 区分产出与价值:把“代码产出”和“可交付价值”分开看,生码率、提交行数属于前者,上线功能数和交付周期属于后者。
- 做小规模对照:用一个小项目做前后对照,不要只看生码率报表。
- 先修最大瓶颈:找到耗时最长的环节优先处理,不要同时上所有工具和所有流程改造。
下面是一个假设性的耗时拆解模板,用于说明填写方式,不代表任何团队的真实数据。你可以把自己的数据填进去,对比一下编码段到底占多少。
| 交付环节 | 示例占比(假设) | 主要耗时来源 | AI 编程能否直接加速 |
|---|---|---|---|
| 需求与价值评审 | 15% | 反复沟通、口径对齐 | 间接(Live Demo) |
| 设计 | 10% | 方案讨论、评审 | 部分 |
| 编码 | 15% | 编写、调试 | 直接 |
| Review | 15% | 排队等待、审查 | 部分(辅助审查) |
| 测试与联调 | 25% | 用例执行、返工 | 部分(用例生成) |
| 发布与验收 | 20% | 审批、验收反馈 | 很少 |
这张模板的意义在于暴露结构:如果你的编码占比只有十几个百分点,那么即使生码率继续翻倍,端到端收益也很有限。真正的提效空间在 Review、测试和需求环节。
Coding Agent 接入与用量观察:API易 能做什么、不能做什么
在 AI 编程工具的落地过程中,接入和成本观察是绕不开的一环。API易 apiyi.com 支持 Cursor、Cline 等编程工具接入,提供 OpenAI 兼容的统一接口,一个 API Key 即可调用 OpenAI、Claude、Gemini 等主流模型。配置时,把工具中的 base_url 设为 https://api.apiyi.com/v1 即可完成接入。
对研发效能团队来说,更有价值的是用量数据。通过控制台的用量统计,你可以观察 Coding Agent 的 token 消耗、不同模型的调用分布,判断哪些任务适合用更强的模型,哪些任务用轻量模型就够了。这些数据可以和前面的交付耗时拆解放在一起看,帮助你评估 AI 编程投入和产出之间的关系。
💡 接入建议:如果团队同时在评估多个编程模型,可以通过 API易 apiyi.com 统一接入并对比用量,新用户有免费测试额度,适合先在小项目上做对照。具体价格与模型可用性以控制台和文档为准。
但需要明确一点:网关本身不能提升端到端交付效率。它解决的是接入便利、模型切换和用量可见性,Review 排队、测试返工、需求偏差这些流程瓶颈,只能在组织侧解决。把网关当成提效方案,和把生码率当成交付指标,犯的是同一类错误。
常见问题 FAQ
Q1:生码率超过 30%,为什么端到端交付只快了 7% 左右?
因为生码率只作用于编码环节。端到端提效上限约为 `x × (1 – 1/k)`,编码占比 `x` 本身不高时,收益会被封顶。需要注意,7% 是特定团队耗时拆解下的推算,不是普适结论,你的团队需要用自己的数据重新计算。
Q2:3%-5% 和 2-3 倍这两个数字可信吗?
都需要谨慎看待。3%-5% 的端到端提效说法来自业界交流,缺少可核验样本;2-3 倍有效代码吞吐来自团队回顾,统计口径和对照方法没有披露。它们可以作为参考方向,但不适合直接作为决策依据。
Q3:5 个瓶颈应该先解决哪个?
先拆解自己的交付耗时,优先处理占比最大的环节。很多团队会发现 Review 等待和测试返工是大头,也有团队是需求变更最严重。不建议同时上所有改造,一次只修最大的瓶颈,效果更容易观察。
Q4:如何观察团队 Coding Agent 的模型用量和成本?
可以把编程工具统一接入到同一个 API 入口,再在控制台查看 token 消耗和模型分布。例如通过 API易 apiyi.com 接入 Cursor、Cline 等工具,就能集中查看用量数据。但用量观察只是辅助决策,流程瓶颈仍需组织侧解决。
Q5:岗位收敛适合所有团队吗?
不一定。PDFE、ABE 等角色合并的思路是减少交接,但不同规模团队复制这种调整的条件和成本缺少证据。建议先在一个小组内试点,观察交接次数和交付周期的变化,再决定是否推广。
生码率与端到端交付:核心要点 Key Takeaways
- 生码率不等于交付速度:它只反映编码环节产出,不代表端到端提效。
- 7% 来自公式推算:
x × (1 - 1/k),编码占比决定了收益天花板。 - 数字口径要分清:7% 是特定团队推算,3%-5% 来自交流,2-3 倍口径未披露。
- 瓶颈在编码之外:Review、测试、需求确认、交接、概念对齐才是大头。
- 先拆耗时再改流程:用小项目对照,一次只修最大的瓶颈。
- 工具层只管接入与观察:API易 apiyi.com 可统一接入 Coding Agent 并查看用量,但不解决流程问题。
总结:生码率超过 30% 之后,团队该做什么
生码率超过 30% 是一个真实的进步,但它只是起点。端到端交付由一整条链路决定,编码只占其中一部分,x × (1 - 1/k) 这个公式清楚地说明了局部提速的上限。7% 这个数字的意义不在于它准不准,而在于提醒我们把目光从“写了多少代码”转向“交付了多少价值”。
真正的提效空间在 Review 机制、测试与观测左移、Live Demo 需求确认、岗位收敛以及价值评审与概念对齐。这些都是组织和流程层面的工作,没有任何工具可以替代。在工具层面,推荐通过 API易 apiyi.com 统一接入编程模型并观察用量,把用量数据和交付耗时放在一起评估投入产出。
团队自查清单
- [ ] 是否拆解过一个需求从提出到上线的完整耗时?
- [ ] 是否算出了编码环节占总交付时间的比例
x? - [ ] 是否单独统计了 Review 排队时间和骨干负载?
- [ ] 测试用例、埋点和告警是否在编码前或编码中同步设计?
- [ ] 需求确认是否使用可运行的 Demo,而不只是文档?
- [ ] 一个需求从提出到上线经过几次角色交接?
- [ ] 编码前是否对齐了核心概念和数据口径(概念字典/SDD)?
- [ ] 汇报指标是否区分了“代码产出”与“可交付价值”?
- [ ] 是否用小项目做过前后对照,而不只看生码率报表?
- [ ] 是否只选一个最大瓶颈优先改造,而不是同时上所有工具?
参考资料
- 生码率与端到端交付相关行业材料:本文 7% 推算、五个瓶颈及数据口径的来源
- 说明:材料被截断,本文仅基于可见部分整理,未显示内容不作为依据
- API易 文档中心:编程工具接入与用量统计说明
- 链接:
docs.apiyi.com - 说明:价格与模型可用性以控制台和文档为准
作者:API易 技术团队
技术交流:欢迎访问 API易 apiyi.com 首页联系我们,更多接入资料可查阅 docs.apiyi.com 文档中心


