
著者注:自分が使っているモデルが公式ランキングより劣るからといって、すぐに結論を出さないでください。多くの場合、思考レベル、入口ウィンドウ、またはモデル ID が、ランキング測定時のそれと一致していないだけです。本記事では、この3点を確認する順序を示します。確認が終わってから、モデルを切り替えるかどうかを判断しましょう。
多くの開発者が同じような落差に直面します。公式アナウンスで、あるモデルがランキングで高スコアを獲得したと書かれているのに、自分で同種の問題を試すと、結果が明らかに期待を下回ります。そこで「モデルがバカになった」あるいは「性能を落とされた」と疑ってしまうのです。本記事では、より実践的な調査の考え方を紹介します。まず思考レベル、入口ウィンドウ、同一のモデル ID を一致させることから始め、そのうえで差が本当に存在するかを判断します。
これは「3つのスイッチを調整すれば公式ランキングに並べる」という秘訣ではありません。 以下に示す差異はすべて公開ドキュメントに基づくものです。これらは、自分が比較している対象が同じものかどうかを確認する助けにすぎず、調整後にランキング上のスコアが得られることを保証するものではありません。また、APIYI が公式ランキングを再現したことを意味するものでもありません。
本記事の価値:読み終えると、この3点を確認する順序と、各ステップでどのドキュメントを見ればよいかが分かります。さらに、確認後もなお差がある場合に、モデルを切り替える前にどの価格とエンドポイントを照合すべきかも分かります。
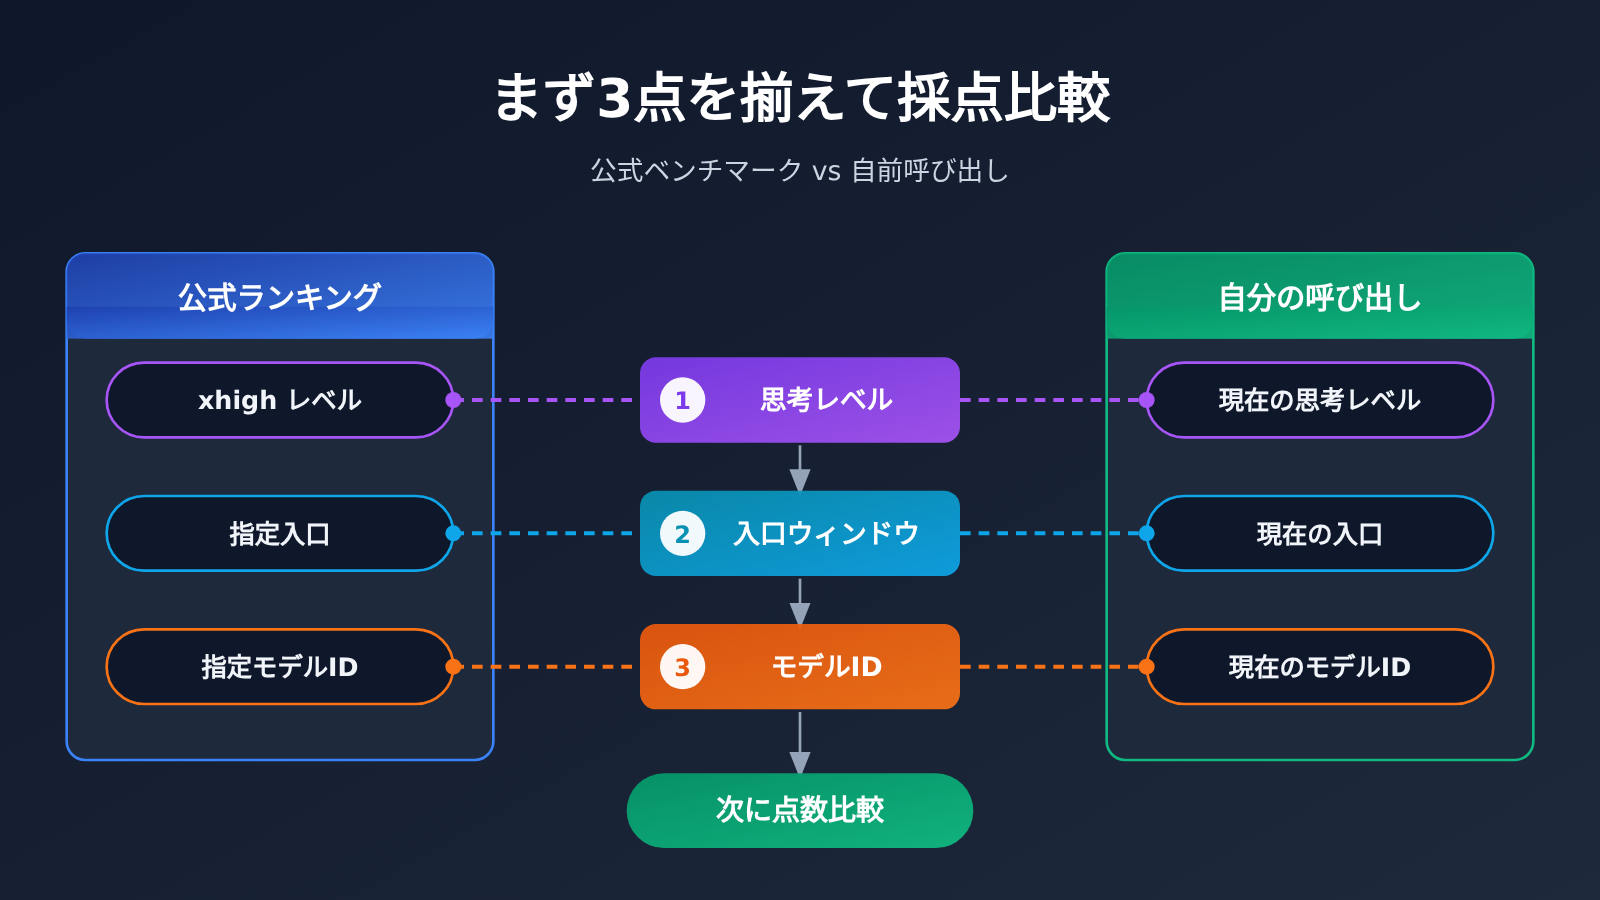
公式ベンチマークと食い違うときに確認すべき要点
まず結論から。リーダーボードのスコアは「モデル名」のスコアではなく、「特定のモデルID + 特定の思考レベル + 特定の入口条件」におけるスコアです。この3つのどれか1つでも違えば、手元で得た結果をそのままリーダーボードと比べることはできません。
| 確認項目 | 典型的な差異(公開ドキュメントより) | 一致しないとどうなるか | 優先度 |
|---|---|---|---|
| 思考レベル | Neon は API 上ではデフォルトが high で、ほかに low、medium、xhigh がある。Carbon はデフォルトが medium で、xhigh は存在しない |
出力長と推論の深さが変わるので、結果も当然変わる | ステップ1 |
| 入口ウィンドウ | Neon の API ウィンドウは 1,048,576 token、Antigravity のドキュメントには最大 512K と記載されている |
リーダーボード上の長文脈能力を、あなたの入口では収めきれないことがある | ステップ2 |
| モデルID | Gemini 4 には少なくとも argon、carbon、hydrogen、neon の4本があり、思考レベルと価格がそれぞれ異なる |
A の結果を B のリーダーボードと比べると、同じもの同士の比較にならない | ステップ3 |
思考レベルが公式ベンチマーク確認の第一位である理由
思考レベルは最も見落とされやすい変数です。多くの場合デフォルト値があり、設定しなくても普通に呼び出せるからです。問題は、モデルによってデフォルト値が違うことです。Gemini 4 を例にすると、Neon は API 上でのデフォルトが high、Carbon は medium です。同じプロンプトでもレベルが違えば、出力長も最終結果も変わります。
リーダーボードには通常、テスト時のレベルが明記されています。公式発表で引用されるスコア、たとえば Neon が xhigh レベルで Artificial Analysis の61点を取ったという数値は、必ずレベルとセットで読む必要があります。デフォルトの high で xhigh のスコアと比べたら、それ自体が同じ条件ではありません。さらに注意すべきなのは、Carbon には xhigh というレベルがそもそも存在しないことです。つまり「Carbon を最高レベルに設定する」は、Neon の xhigh と等しくありません。
入口によって同じレベルの呼び名が違うこともあります。Antigravity では Neon の最高レベルが画面上で Extra と表示され、API ドキュメントの xhigh とは名前が異なります。確認するときはドキュメントの対応関係に沿って探す必要があり、字面だけで判断してはいけません。
入口ウィンドウとモデルIDも同じくらい重要
入口ウィンドウは、モデルにどれだけのコンテキストを渡せるかを決めます。Neon を API 経由で呼び出すときのウィンドウは 1,048,576 token ですが、Antigravity のドキュメントには最大 512K と書かれています。リーダーボードが長文書の検索や大規模コードベースの理解を測っている場合、ウィンドウの小さい入口では同じモデルに切り替えても、内容が切り捨てられて結果が悪化する可能性があります。
モデルIDは最も「ハード」な項目です。Gemini 4 世代には少なくとも argon、carbon、hydrogen、neon の4つのIDがあり、思考レベルの設定も価格もそれぞれ異なります。Hydrogen の結果を Neon の xhigh レベルのリーダーボードと比べたところで、差が出るのは当然です。呼び出し前に APIYI apiyi.com のモデル一覧で、リクエストに書いたIDがどれなのかを必ず確認してください。記憶や他人のスクリーンショットをもとに記入しないようにしましょう。
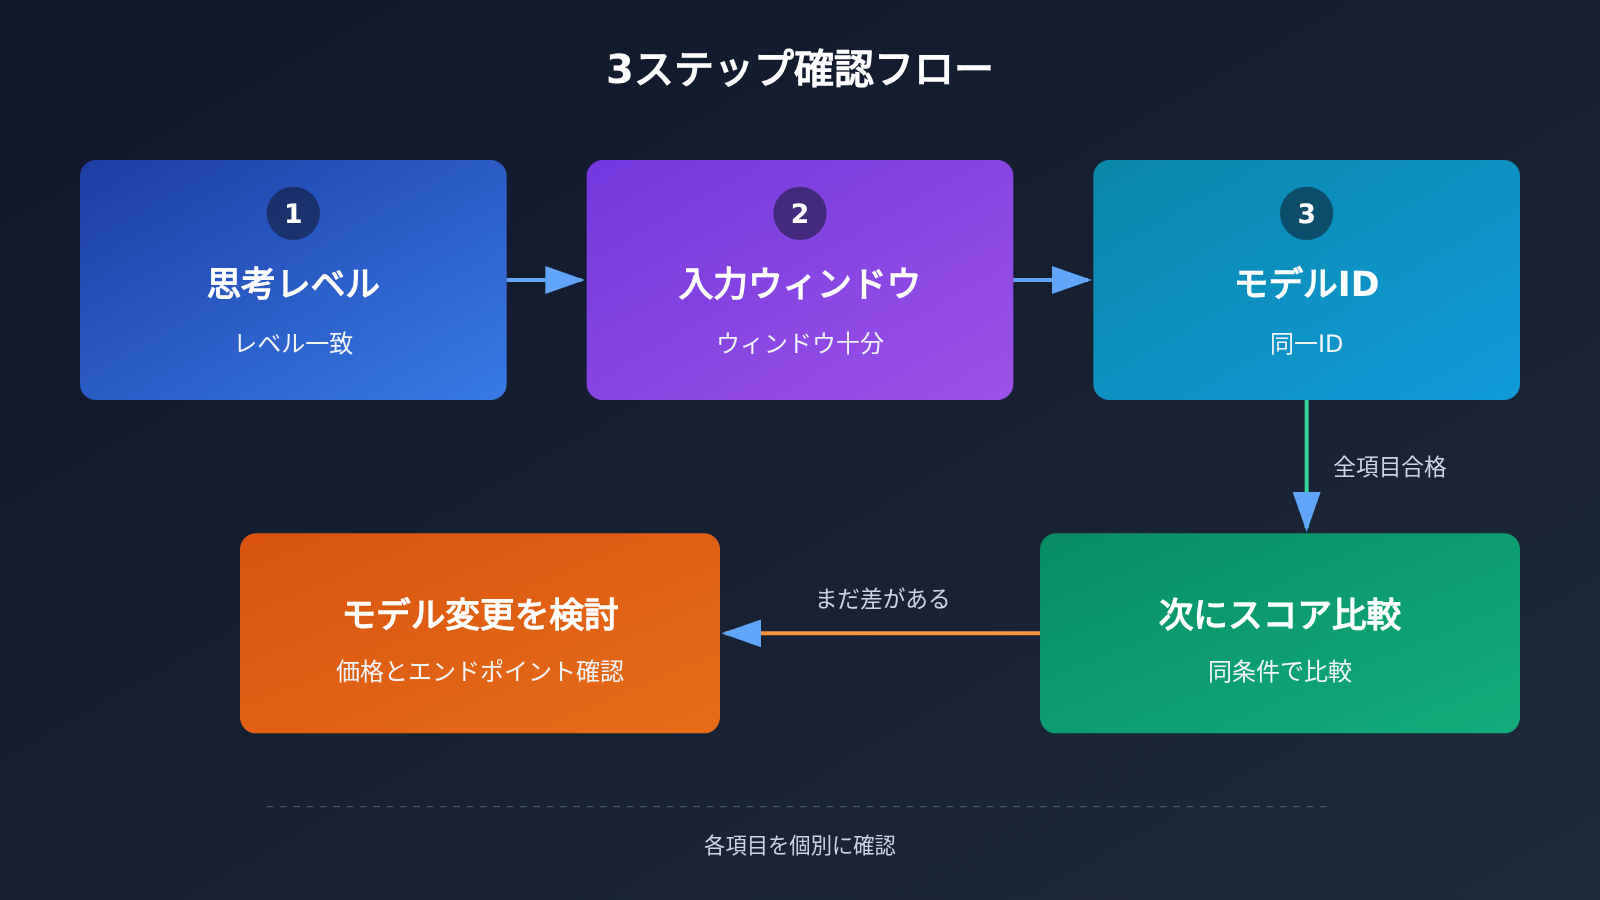
公式ベンチマークに合わせるためのクイックスタート手順
このセクションでは、3つの照合ポイントを具体的な操作に落とし込みます。コピーしやすいように、パラメータ名・モデルID・アドレスはインラインコードで記載しているので、ご自身のリクエストと照らし合わせて項目ごとに確認してください。
ステップ1:呼び出し入口とエンドポイントを確認する
まず、どの入口からモデルを使っているのかをはっきりさせましょう。Web UI、IDE プラグイン、それとも直接 API を呼び出しているのか。入口によってウィンドウの上限やティア(档位)の命名が異なる場合があります。OpenAI 互換インターフェースを使う場合は、base_url を https://api.apiyi.com/v1 に設定し、api_key には APIYI コンソールで生成した Key を入力します。こうすれば、後でモデルを切り替えるときに model フィールドだけを変更すればよく、入口の条件が一定に保たれるので、比較に意味が出てきます。
ステップ2:モデルIDを完全な形で記述する
リクエスト内の model には完全なIDを記述します。たとえば gemini-4-neon や gemini-4-carbon のように。曖昧な「Gemini 4」は使わないでください。記述したら、モデル一覧表に戻って照合し、このIDがランキングで測定されたものと同一であることを確認します。ランキングで測定されたのが Neon なのに、呼び出しているのが gemini-4-hydrogen だったら、その後の比較はすべて無意味です。まずIDを正しく直しましょう。
ステップ3:思考ティアを明示的に設定する
デフォルト値に頼らず、リクエスト内で思考ティアを明示的に指定します。具体的なフィールド名は、該当モデルの公式ドキュメントに従ってください。設定時は次の3点に注意します。
- ランキングの測定ティアに合わせる:ランキングが
xhighと書いていればxhighを設定し、highと書いていればhighを設定します。 - ティアが存在するか確認する:Carbon には
xhighがありません。Neon のxhighランキングに無理やり合わせても意味はありません。 - 名称のマッピングに注意する:Antigravity インターフェースの
Extraは Neon の最高ティアに対応します。API に移行する際は、ドキュメントにあるティア名に置き換えてください。
ステップ4:コンテキストが入口のウィンドウを超えていないか確認する
テスト内容が長い場合は、まず token 数を推定し、それから入口の上限と比較します。API 経由で Neon を呼び出す場合の上限は 1,048,576 token で、Antigravity のドキュメントには最高 512K と記載されています。上限を超えた内容は切り捨てられたりエラーになったりするので、そのときの「効果が悪い」は、実は入力が不完全なだけかもしれません。
🚀 クイックスタート:同じ入口条件下で複数のモデルIDを比較したい場合は、APIYI apiyi.com を通じて1つの Key で Gemini、Claude、GPT などのモデルを呼び出せます。新規ユーザーには無料のテスト枠があるので、まずティアとIDを揃えてから、小規模な比較を行うのに適しています。
3つの照合ポイントのチェックリスト
| チェック項目 | リクエストで見るフィールド | 合格基準 | よくある間違い |
|---|---|---|---|
| 入口 | base_url |
1つの入口に固定する(例:https://api.apiyi.com/v1) |
Web 側で1回、API で1回と測って混ぜて比較する |
| モデルID | model |
ランキングと一致する完全なID | hydrogen で neon のランキングと比較する |
| 思考ティア | 思考ティアのパラメータ(フィールド名はドキュメントに従う) | ランキングの測定ティアと一致し、そのティアが存在する | デフォルト値に頼る;Carbon に xhigh を設定する |
| コンテキスト | 入力 token 数 | 入口のウィンドウ上限を超えない | 512K の入口に百万級の内容を詰め込む |
公式ベンチマーク照合後も差が残る:モデルを替える前に価格とエンドポイントを確認
3つの項目がすべて一致した後でも差が明らかに残る場合に初めて、モデルの切り替えを検討する価値があります。モデルの切り替えは名前を変えるだけではなく、能力のティアとコストを同時に見る必要があります。Gemini 4 の各 ID の価格にはかなりの差があるからです。以下は 2026-11-20 に照合した APIYI の棚価格で、単位はすべて米ドル/100万トークンです。
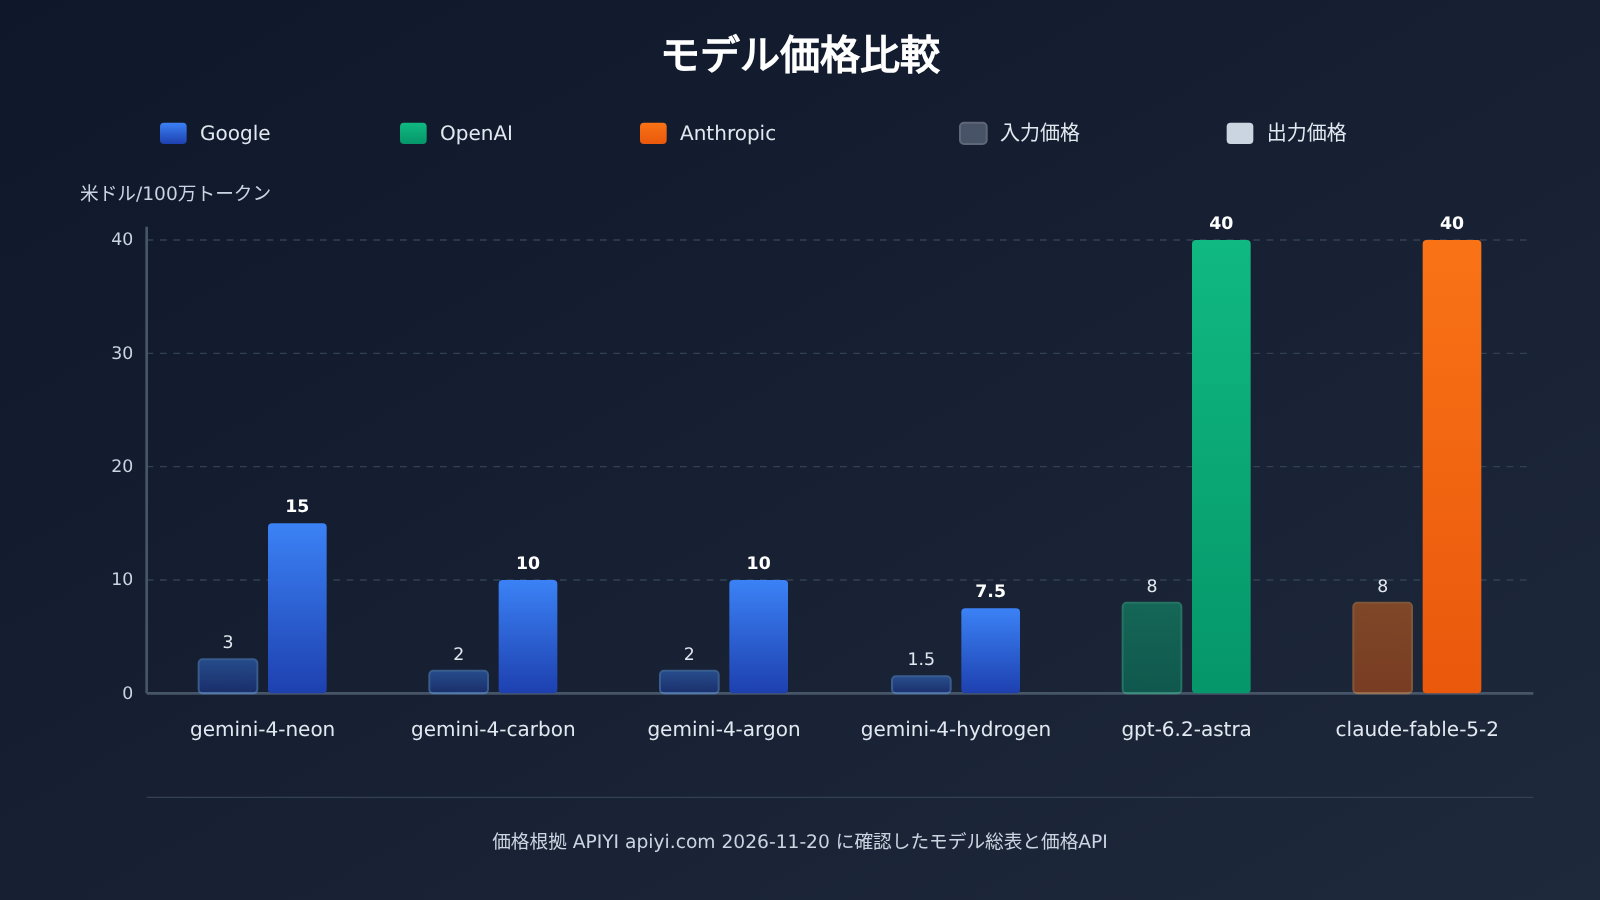
| モデル ID | 入力 | キャッシュ読み取り | 出力 | 備考 |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
価格設定インターフェースを基準とし、Google の提示価格と一致 |
gemini-4-carbon |
2 |
0.1 |
10 |
Google の 2026-11-30 までの紹介価格に対応 |
gemini-4-argon |
2 |
0.1 |
10 |
モデル総表に由来 |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
4つの中で単価が最も低い |
gpt-6.2-astra |
8 |
0.4 |
40 |
272000 token を超えると入力は 16、詳細は後述 |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 |
0.2 |
40 |
2つの ID の価格は同じ |
この表には個別に説明が必要な箇所がいくつかあります。そうしないとコスト計算を間違えやすくなるためです:
- gemini-4-neon の出典:2026-11-19 10:59(UTC+8)に更新された版のモデル総表には収録されていませんが、価格設定インターフェースには存在します。価格設定インターフェースが示す
model_ratioは1.5、completion_ratioは5、cache_ratioは0.05です。model_ratioが1で入力2米ドル/100万トークンに相当する換算により、入力3、出力15、キャッシュ読み取り0.15が得られます。 - gemini-4-carbon の価格の有効期間:現在の価格は Google の 2026-11-30 までの紹介価格に対応しています。12月1日以降、Google の標準価格は入力
4、出力20となるため、長期予算を立てる際はこの変化を織り込む必要があります。 - gpt-6.2-astra の段階設定:モデル総表には第1段階の入力
8、キャッシュ読み取り0.4、出力40と記載され、272000token を超えると入力は16となります。価格設定インターフェースでは272000token を超える場合、出力は60、キャッシュ読み取りは0.8で計算されます。2つの情報を併せて参照してください。
💡 選択のアドバイス:モデルを切り替える際は、候補の ID を同じ
base_urlの下に置き、同じ思考ティアと入力で比較することで、結論に説得力が生まれます。APIYI apiyi.com のモデル総表と価格設定インターフェースの両方でこれらの ID の現在価格を確認できます。呼び出し前に一度再確認することをおすすめします。本文のこの表だけに依存しないでください。
モデル切り替え時のエンドポイントと課金チェックリスト
| チェック項目 | 確認する場所 | 確認する理由 |
|---|---|---|
| モデルIDが存在するか | モデル一覧表 docs.apiyi.com/models.md |
一覧表のバージョンが古い可能性があるため、個別のIDは価格APIで再確認が必要 |
| 現在の単価と倍率 | 価格API api.apiyi.com/api/pricing |
倍率はドル単価に換算できます。バージョン番号は shell-api-modelmak-v1 |
| 長いコンテキストでの段階設定 | 一覧表と価格APIの両方を照合 | 例:gpt-6.2-astra は 272000 トークンを超えると単価が変わります |
| 呼び出しエンドポイント | https://api.apiyi.com/v1 |
OpenAI互換形式のため、モデルを切り替えるときは model だけを変更します |
| 上流の価格変動 | 公式の価格発表 | 例:Carbonの紹介価格は2026-11-30で終了します |
よくある質問 FAQ
Q1:公式ベンチマークスコアは、いったいどのような条件に対応しているのですか?
ランキングのスコアは「特定のモデルID + 特定の思考レベル + 特定のエントリー条件」の組み合わせに対応するものであり、漠然としたモデル名ではありません。たとえば Neon の 61 点は、`xhigh` レベルの Artificial Analysis における成績です。レベルを切り離してこの数値を単独で引用すると、誤解を招きやすいです。
Q2:思考レベル、エントリーのウィンドウ、モデルID のうち、最初にどれを確認すべきですか?
推奨される順序は、まず思考レベルを確認し、次にエントリーのウィンドウを確認し、最後にモデルIDを照合するという流れで、3項目すべてが一致したうえでスコアを比較します。実際の作業では、ID を先にざっと見てもかまいません。ID が間違っていれば、後の2項目は見る必要がないからです。順序の意味は項目ごとに除外していくことにあり、毎回決まった手順を機械的に実行することではありません。
Q3:思考レベルを最高に設定すれば、公式ベンチマークに到達できますか?
そのような約束はできません。レベルを合わせることで保証できるのは、あなたとランキングが同じ条件で比較していることだけであり、問題の分布、プロンプトの書き方、サンプリング方式などの要因によって依然として差異が生じる可能性があります。また、すべての ID に最高レベルがあるわけではありません。たとえば Carbon には `xhigh` がなく、その最高レベルに設定しても Neon の `xhigh` と同じではありません。
Q4:同じ Neon なのに、IDE 内と API を直接呼び出す場合で結果が違うのはなぜですか?
エントリー条件が異なる可能性があります。Neon が API 経由で動作する場合のウィンドウは `1,048,576` token ですが、Antigravity のドキュメントには最大 `512K` と書かれています。両側のレベルの命名も異なり、Antigravity のインターフェース上での最高レベルは `Extra` と呼ばれています。長いコンテキストのタスクが、より小さなウィンドウのエントリーで性能が低下するのは、条件の違いによるものであり、モデル自体が劣化したことを示すものではありません。
Q5:同じエントリーで複数のモデルIDを比較するにはどうすればよいですか?
以下の3ステップで操作できます:
1. APIYI apiyi.com で登録して APIキーを生成します。新規ユーザーは無料のテスト枠を受け取れます。
2. `base_url` を統一して `https://api.apiyi.com/v1` に設定し、`model` フィールドだけを変更して ID を切り替えます。
3. 各 ID に対して明示的に同じ思考レベルを設定し、同じ入力セットで比較します。
これによりエントリーとレベルが固定され、差異は主にモデル自体に由来するものになります。
Q6:gemini-4-neon がモデル一覧表に見つかりませんが、それでも呼び出せますか?
2026-11-19 に更新された版の一覧表には `gemini-4-neon` が収録されていませんが、料金インターフェースにはその倍率があり、換算すると入力 `3`、出力 `15`、キャッシュ読み取り `0.15` ドル/百万 token で、Google の表示価格と一致しています。APIYI apiyi.com の料金インターフェースのリアルタイム結果を基準とし、呼び出し前にもう一度確認することをおすすめします。
Q7:モデルを切り替えるときに最も計算を間違えやすい項目はどれですか?
最も間違えやすいのは、長いコンテキストの段階分けと価格の有効期限です。`gpt-6.2-astra` は `272000` token を超えると入力単価が `8` から `16` に変わります。料金インターフェースには、このとき出力は `60`、キャッシュ読み取りは `0.8` と記載されています。Carbon は現在紹介価格であり、12月1日から Google 標準価格は入力 `4`、出力 `20` になります。
公式ベンチマーク照合の要点
- リーダーボードのスコアには条件がある:基準スコアは「モデル ID + 思考レベル + エントリポイント」の組み合わせに対応するもので、モデル名そのもののスコアではありません。
- まず思考レベルを確認:Neon のデフォルトは
high、Carbon のデフォルトはmediumでxhighはありません。デフォルト値に依存しないでください。 - 次にエントリポイントのコンテキストウィンドウを確認:API 上の Neon は
1,048,576token ですが、Antigravity のドキュメントには最大512Kと記載されています。 - ID は同じものを使う:Gemini 4 には少なくとも 4 つの ID があり、Hydrogen の結果を Neon のリーダーボードと比較するのは意味がありません。
- 条件を調整しても同点は保証されない:条件を揃えることで比較が成立するだけで、スコアがリーダーボードに追いつくことを保証するものではありません。
- モデル変更時は料金表の価格も確認:APIYI apiyi.com の統一エンドポイントで複数の ID を比較し、一覧表と価格 API の価格も併せて確認します。
まとめ
モデルの性能が公式ベンチマークに及ばない場合、次の 3 点をこの順で確認します。
- 思考レベルを合わせる:ベンチマーク測定と同じレベルを明示的に設定し、その ID に該当レベルがあることを確認します。
- エントリポイントのコンテキストウィンドウを合わせる:使用するエントリポイントがテスト内容を収容できることを確認し、エントリポイントごとにレベルの命名が異なる点に注意します。
- モデル ID を合わせる:リクエストに完全な ID を記述し、モデル一覧表に戻って一字一句確認します。
3 点とも一致しても差が残る場合は、モデルの変更を検討します。モデルを変更する際は、能力レベル、単価、長いコンテキストの段階、価格の有効性を同時に比較します。このときの判断根拠は、条件を揃えた比較結果であり、条件から切り離して引用したリーダーボードの数値ではありません。
APIYI apiyi.com の同じ https://api.apiyi.com/v1 エンドポイントで複数のモデル ID を検証することをおすすめします。エントリポイントとレベルを固定すれば、比較の結論ははるかに信頼できるものになります。
📚 参考資料
-
APIYI モデル一覧表:モデル ID と公開価格のまとめ
- リンク:
docs.apiyi.com/models.md - 説明:本記事では 2026-11-19 10:59(UTC+8)に更新されたバージョンを参照しています。モデル ID の有無を確認する際に利用できます。
- リンク:
-
APIYI 料金 API:リアルタイム倍率と単価
- リンク:
api.apiyi.com/api/pricing - 説明:バージョン
shell-api-modelmak-v1。model_ratioが1の場合、入力 2 米ドル/100万トークンに相当し、各モデルの単価に換算できます。
- リンク:
-
Google Gemini 4 公式ドキュメントと料金説明:思考レベル、コンテキストウィンドウ、価格
- リンク:
ai.google.dev - 説明:各 ID のデフォルト思考レベル、選択可能なレベル、API コンテキストウィンドウの上限、価格改定日時を確認できます。
- リンク:
著者:APIYI 技術チーム
技術交流:APIYI 公式サイトのトップページからお気軽にお問い合わせください。その他のモデルや API に関する資料は、APIYI ドキュメントセンターでご覧いただけます。


