
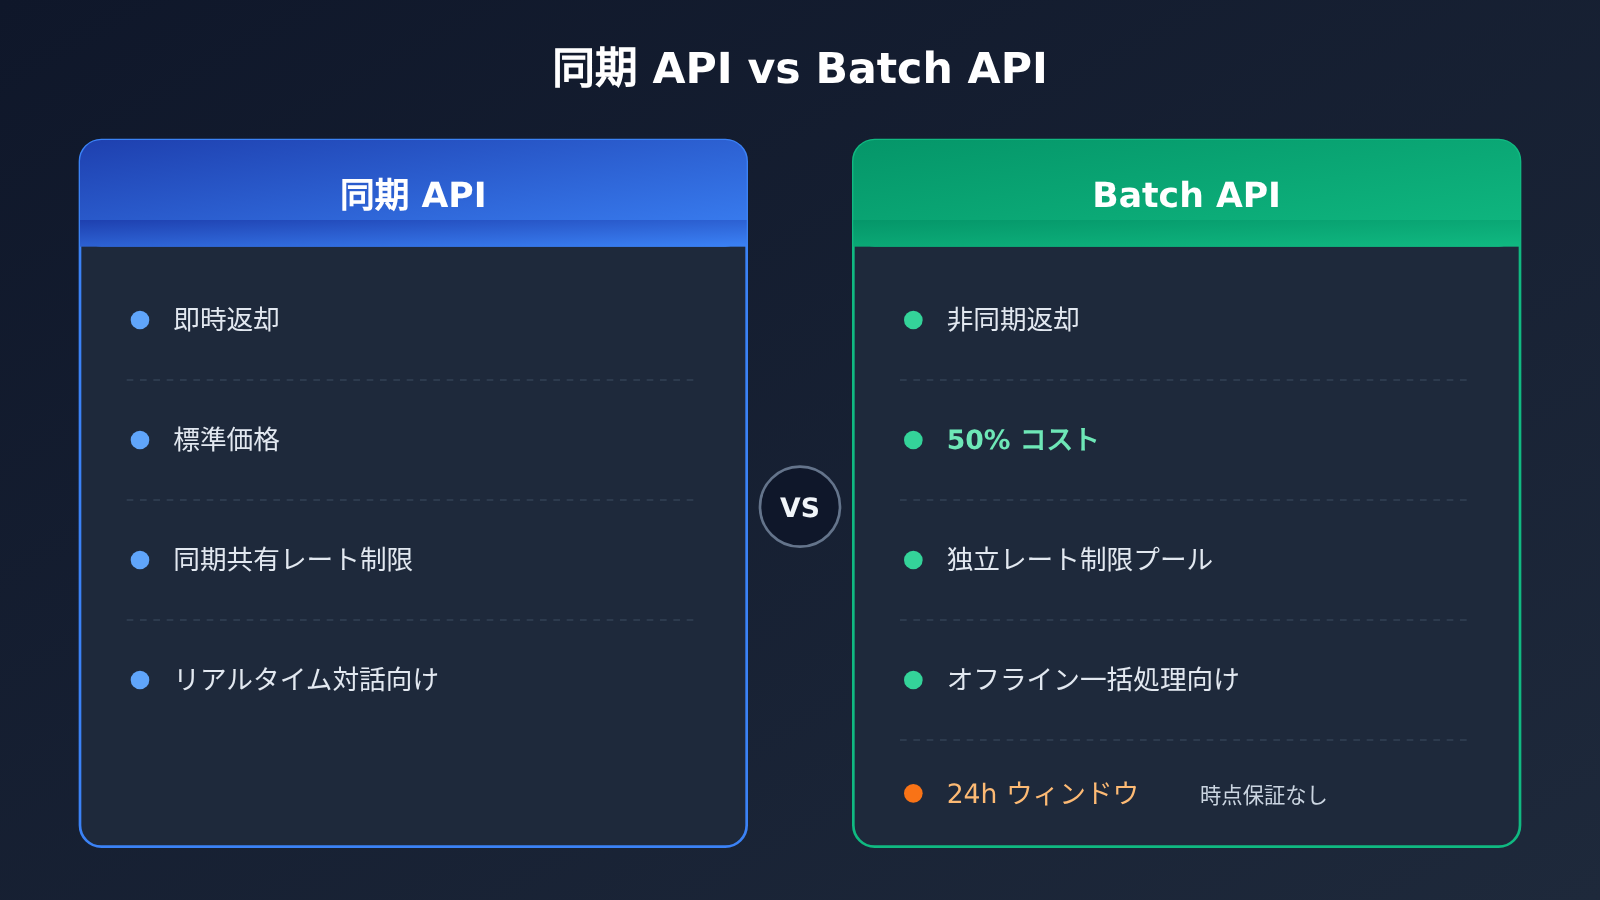
直接回答:OpenAI Batch API は、「結果を少し遅れて受け取ってもよい、互いに独立した、大量のバッチ処理」に適しています。 料金は同期 API の半額で、独立したレート制限プールを使用します。制約は 24 時間の処理ウィンドウであり、このウィンドウ内の特定の時点で結果が配信される保証はありません。既定ルールに基づく分類、ナレッジベース加工、モデル評価といったオフライン作業では、Batch を優先的に検討できます。リアルタイムのカスタマーサポート、即時応答が必要なインタラクション、および前のステップの結果が次のステップの内容を決める依存型ワークフローは、Batch API に任せるべきではありません。
この記事を読むと何がわかる?
- OpenAI Batch API の基本ルール:割引、レート制限、ウィンドウ、ファイル形式、数量上限。
- 送信成功・生成成功・期限どおりの配信という 3 つの違い。
- バッチが期限切れになった後の課金方法と、失敗したリクエストだけを再実行する方法。
- 50% 割引が具体的にどのコストを削減するのか、半減しないコストは何か。
- あるタスクが Batch に向くかどうかを判断する実用的な方法。
索引: 本文に入る前に、概念表と影響サマリーで基礎知識を整理します。「客観的事実」パートでは公式ドキュメントのルールを項目ごとに整理し、「分析と判断」パートでは、これらのルールがタスク選定、コスト試算、エンジニアリング設計にとって何を意味するのかを論じ、適したタスク類型と適さないタスク類型を示します。
なお、本記事は OpenAI 公式が継続的にメンテナンスしている Batch ガイドに基づき、2026-11-17 に確認したものです。このドキュメントには明確な初版公開日がないため、本記事では当日に公開された新機能として扱わず、既存機能のルールを読み解く内容としています。
知っておきたい:OpenAI Batch API の主要概念
| 概念 | 簡単な説明 |
|---|---|
| 同期 API | リクエストを送信するとすぐに待機して結果を返す、通常の呼び出し方法 |
| Batch API | 大量のリクエストを一度に送信し、非同期で処理して、後でまとめて結果を取得するインターフェース |
| JSONL | 各行が独立した JSON オブジェクトであるテキスト形式。Batch では各行が1つのリクエストに対応します |
| custom_id | 各リクエストに設定する一意の識別子で、出力結果を元のリクエストに対応付けるために使います |
| 独立したレート制限プール | Batch リクエストのレート制限は同期リクエストとは別に計算され、互いに枠を奪い合いません |
| 24時間の処理ウィンドウ | バッチの処理期限。タイムアウト後に未完了のリクエストはキャンセルされます |
| 期限切れバッチ | 処理ウィンドウを超えてもなおすべて完了していないバッチ |
OpenAI Batch API の影響をひと目で
- 開発者: オフラインのバッチタスクの API 費用は、同期料金の半額で見積もることができ、しかもオンラインサービスの同期レート制限枠を消費しません。ただし、custom_id のマッチング、失敗時の再送信、結果の検証は自分で実装する必要があります。
- コンテンツ・データチーム: 大量の分類、要約、ナレッジベースのクリーニングなどの作業は、よりコスト効率が高くなります。代償として「その場で結果が出る」ことを諦め、納品時間に余裕を持たせる必要があります。
- 評価・研究担当者: 大規模なテストセットの実行には Batch が最適です。ただし、1つのファイルでは1つのモデルしか使えないため、複数モデルの比較を行う場合は複数のファイルに分割する必要があります。
- プロダクト・運用責任者: 「24時間」を「明日の朝には必ず納品」と解釈してはいけません。対外的に納期を約束する際は、Batch をベストエフォート型のチャネルとして扱うべきです。
OpenAI Batch API の客観的事実
Batch API の課金とレート制限のルール
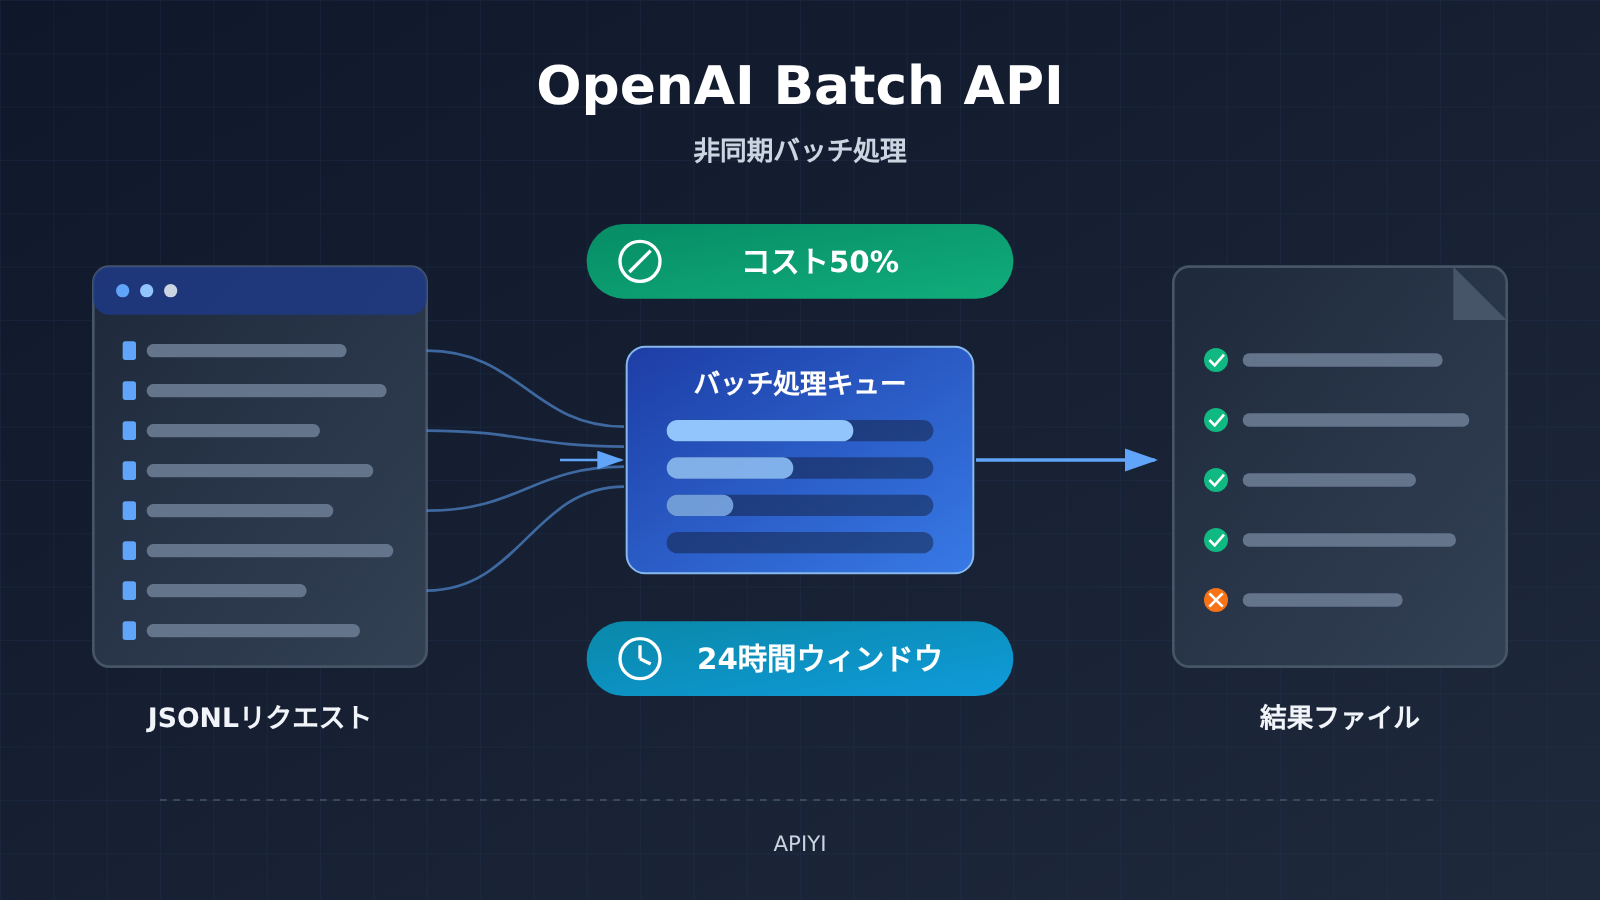
公式のBatchガイド(OpenAI公式ドキュメント: developers.openai.com/api/docs/guides/batch)によると、Batch APIには3つの核心的な特性があります。
- コスト割引: 同期APIと比較して50%のコスト割引を提供します。
- 独立したレート制限: 独立したレート制限プールを使用し、同期リクエストとは枠を共有しません。
- 処理ウィンドウ: バッチは24時間のウィンドウ内で処理が完了します。
どのモデルとエンドポイントがサポートされるかは、公式ドキュメントに記載された範囲に準じます。現時点では「すべてのモデルがBatchをサポートする」と一概に言うことはできません。
Batch API のファイル形式と数量上限
| ルール項目 | 公式要件 | 実際の意味 |
|---|---|---|
| ファイル形式 | JSONL、1行につき1リクエスト | 1行が1つの独立したタスク |
| リクエスト識別子 | 各リクエストに一意の custom_id | 結果の回収はこれでマッチングする |
| モデル制約 | 1つのファイルでは1つのモデルしか使えない | 複数モデルのタスクは複数ファイルに分割する必要がある |
| 数量上限 | 1バッチあたり最大50,000リクエスト | 上限を超える場合は分割して提出する |
| サイズ上限 | 1バッチのファイルは最大200MB | 長いコンテキストのタスクでは先にサイズ上限に達する可能性がある |
| 出力順序 | 入力順序との一致は保証されない | 行番号で結果を対応付けることはできない |
以下はリクエスト行の構造を示す一例で、custom_idの位置を説明するためのものです。具体的なエンドポイントとパラメータは公式ドキュメントのサポートリストに準じます。
{"custom_id": "article-001", "method": "POST", "url": "/v1/chat/completions", "body": {"model": "MODEL_NAME", "messages": [{"role": "user", "content": "为以下主题写一段摘要:..."}]}}
Batch API の失効と課金のルール
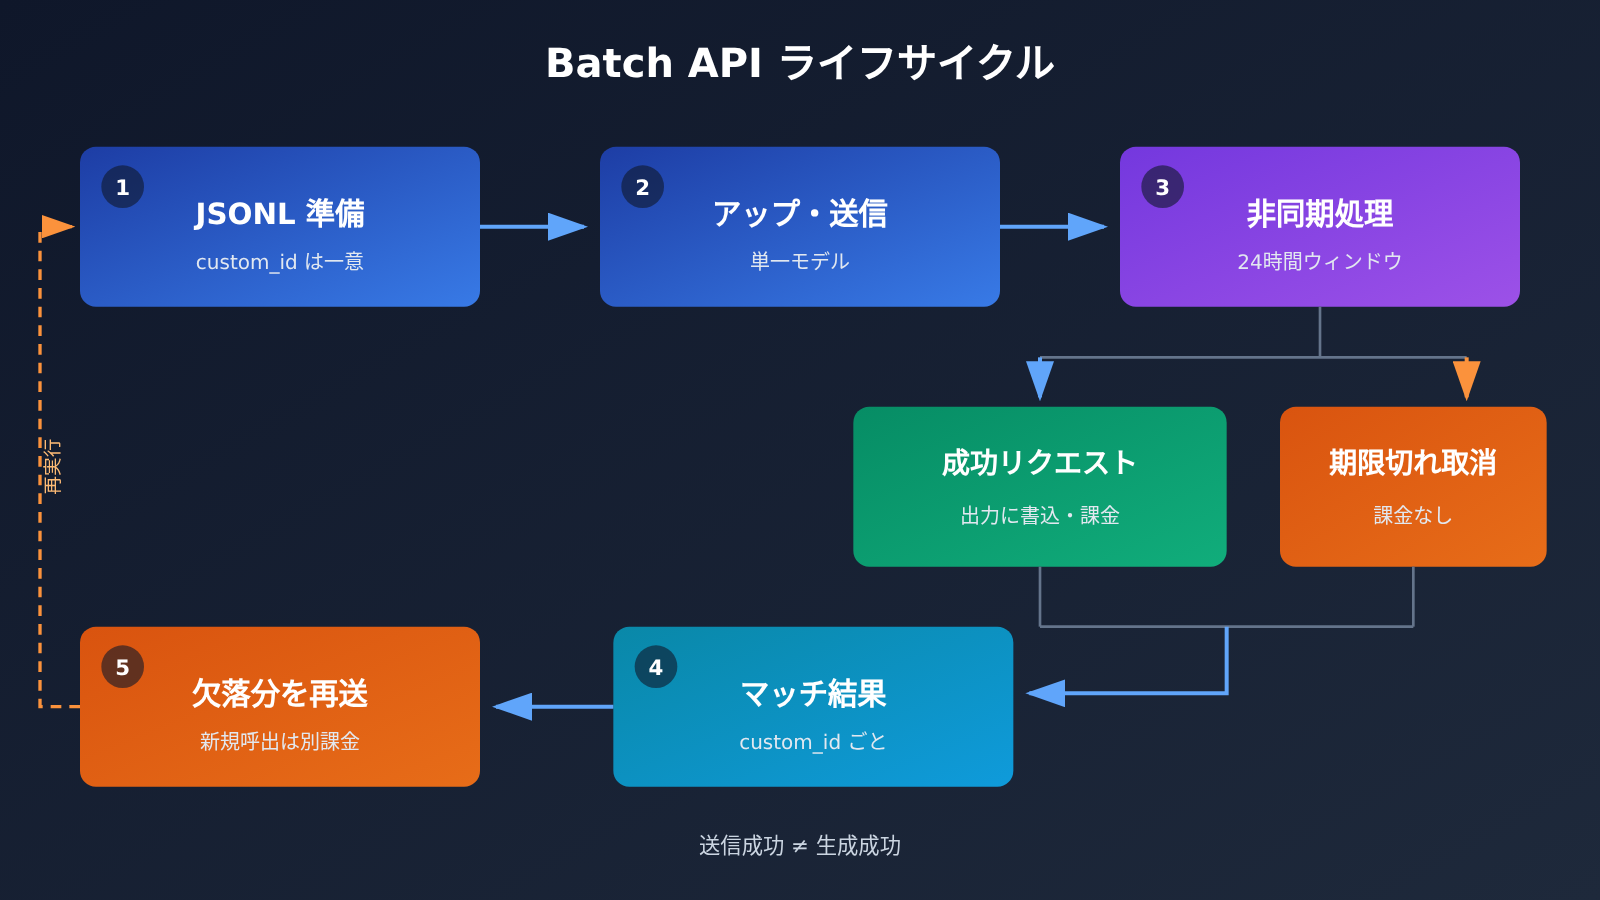
バッチが処理ウィンドウを超えると、その中でまだ完了していないリクエストはキャンセルされます。すでに成功した結果は引き続きダウンロードでき、課金は成功したリクエストのみが対象です。
ドキュメントは同時に次の点も注意喚起しています。提出の成功は生成の成功を意味しません。 バッチが受け付けられたのは処理フローに入ったというだけであり、各行が結果を生み出すことを意味するわけではありません。24時間のウィンドウも「翌朝の某時点で納品する」という約束ではありません。
OpenAI Batch API の分析と判断
半額で節約できるのはどの部分か
「半額」が対象としているのは、Batch 処理自体のモデル呼び出し費用です。以下では設計例を使って説明しますが、数字は実測データではありません。
あるタスクが同期リクエストでは100元と課金されると仮定すると、同じリクエストを Batch で処理する場合の示意費用は50元になります。ただし、プロジェクト全体の総コストが必ずしも半減するとは限りません。自動的に割引されないコストがいくつかあるからです。
| コスト項目 | Batch で半額になるか | 説明 |
|---|---|---|
| バッチ処理リクエストのモデル呼び出し費 | はい | 示意:同期100元に対し Batch は50元 |
| 事前調査で使うツール呼び出し | いいえ | 例:まず検索・調査してから書く内容を決める |
| 人手によるレビュー | いいえ | 人件費は課金方式とは無関係 |
| 追加のリトライ | いいえ、別途計算が必要 | 失敗や期限切れの後の再実行で新たな呼び出しが発生する |
| エンジニアリング開発と保守 | いいえ | ファイル生成、結果のマッチング、再提出ロジックへの工数投入が必要 |
そのため予算を立てるときは、半額を「バッチ処理できる呼び出し部分」にだけ適用し、プロジェクトの総予算をそのまま半分に削ってはいけません。プロジェクト内で調査やレビューの割合が高い場合、Batch による全体的な節約は50%を大きく下回ることになります。
24時間ウィンドウをどう理解すべきか
24時間ウィンドウが示しているのは処理期限であり、納品の約束ではありません。より安全な方法は、Batch の結果を「ウィンドウ期間内に高い確率で取得できるが、一部が欠ける可能性もある」産出として扱い、スケジュールに再実行のための時間を確保しておくことです。
もしビジネス側から「明日の午前9時までに必ず全結果を取得しなければならない」と要求された場合、一度の Batch 提出だけに頼るのはリスクがあります。時間厳守が求められるタスクでは、事前に提出しておく、再実行のウィンドウを確保する、あるいは重要な部分を同期リクエストに切り替えるといった対策が取れます。
custom_id は Batch エンジニアリング設計の中核
出力の順序が保証されないため、結果の回収は完全に custom_id に依存する必要があります。そのため、custom_id は設計段階から業務上の意味を持ち、グローバルに一意であることが求められます。たとえば「タスク種別-バッチ番号-連番」のような形式です。
以下の設計例も同様に実測ではありません。同一モデルで互いに独立した記事を20本生成したい場合、20行の JSONL として記述できます。最終的に18本が成功し、2本が期限切れでキャンセルされた場合、custom_id によって欠落している2本を特定して再提出するだけで済み、20本すべてを再実行する必要はありません。成功した18本は成功リクエストとして課金され、キャンセルされた2本は課金されません。
このフローの要点は次のようにまとめられます:
- 提出前に各行の custom_id が一意であることを検証する。
- 結果回収後、入力の custom_id 集合から出力の custom_id 集合を引いて、欠落リストを取得する。
- 欠落リストだけを対象に新しい JSONL を生成し、再提出する。
- 再実行は新たな呼び出しコストを発生させるため、予算に計上する必要がある。
複数モデルと依存関係のあるフローは分けて処理する
1つのファイルで使用できるモデルは1つだけです。同じプロジェクトでAモデルに分類を、Bモデルに要約を担当させたい場合は、2つのファイルをそれぞれ用意し、個別に送信して個別に回収する必要があります。
さらに注意すべきは依存関係です。「まず資料を調査し、その調査結論に基づいて何を書くかを決める」というフローでは、第2ステップが第1ステップの出力に依存します。Batchはこの2つのステップを自動で編成してくれません。第1バッチの結果を回収した後、自前のプログラムで第2バッチのリクエストを生成して再送信する必要があります。これは、チェーン全体の総所要時間が複数の処理ウィンドウ分だけ積み重なる可能性があることも意味します。
どのタスクが OpenAI Batch API に適しているか
| タスク種別 | Batch 適性 | 理由 |
|---|---|---|
| 既定のルールに基づく一括分類 | 適している | ルールが固定され、項目が独立し、リアルタイムの返却を急がない |
| ナレッジベースの加工(要約、クレンジング、構造化) | 適している | データ量が多く、オフラインで完了できる |
| モデル評価、テストセットの一括推論 | 適している | もともと一括処理であり、即時性に敏感でない |
| 同一モデルによる独立コンテンツの一括生成 | 適している | 各行が独立しており、失敗時は custom_id で再実行できる |
| リアルタイムのカスタマーサポート、対話インタラクション | 適していない | ユーザーは即時の返信を必要とするため、同期などの方式を使うべき |
| 厳密な納品時点があるタスク | 慎重に | 24時間のウィンドウでは具体的な時点を保証できない |
| まず調査してから内容を決める多段階フロー | 自前での編成が必要 | Batch はステップ間の依存を自動処理しない |
簡単な判断方法は、3つの問いを続けて投げることです。結果を少し遅めて取得できるか?各リクエストは互いに独立しているか?量が多く、ファイルと回収ロジックを書く価値があるか?3つすべての答えが「はい」なら、Batchは通常より割の良い選択です。1つでも「いいえ」があれば、まずタスクを分割するか、同期呼び出しを残す必要があります。
今後注目すべき変化
これは継続的にメンテナンスされている公式ドキュメントであるため、対応モデルやエンドポイントの範囲、件数、サイズの上限は変更される可能性があります。以下の判断はあくまで予測です。より多くのモデルやエンドポイントが Batch に組み込まれるにつれて、オフライン評価やデータ加工系のワークフローでは、バッチ処理がデフォルトの選択肢となる場面が増えていくでしょう。実際に導入する際は、その時点のドキュメントに記載されたルールに従うべきであり、本記事の確認日時点の数値をそのまま流用しないでください。
Batch API の価値は、「どの作業は待てるのか」をはっきり考えさせてくれることにあります。待つことを許容できるタスクは、半額の料金と、邪魔されないレート制限枠と引き換えます。一方、すぐに応答が必要なタスクは、引き続き同期リクエストに任せればよいのです。
「欲速ばあれば則ち達せず、小利を見れば則ち大事成らず」――『論語・子路』


