
Catatan penulis: Kalau kinerja model yang Anda pakai lebih buruk daripada yang ditunjukkan papan peringkat resmi, jangan buru-buru menyimpulkan. Sering kali penyebabnya adalah tingkat penalaran, jendela akses, atau ID model tidak cocok dengan konfigurasi yang dipakai dalam pengujian papan peringkat. Artikel ini memberikan urutan pengecekan ketiga hal tersebut; setelah selesai memeriksa, baru putuskan apakah perlu mengganti model.
Banyak developer mengalami kesenjangan yang sama. Pengumuman resmi menyebut suatu model meraih skor tinggi di papan peringkat, tetapi saat mencoba soal sejenis, hasilnya jelas di bawah ekspektasi, lalu curiga model “jadi bodoh” atau “spesifikasinya diturunkan”. Artikel ini memperkenalkan pendekatan diagnosis yang lebih praktis: selaraskan dulu tingkat penalaran, jendela akses, dan ID model yang sama, baru nilai apakah selisihnya benar-benar ada.
Ini bukan kumpulan trik “atur tiga saklar langsung menyamai papan peringkat resmi”. Selisih di bawah ini semuanya berasal dari dokumentasi publik. Mereka hanya membantu Anda memastikan apakah yang Anda bandingkan memang hal yang sama; tidak menjamin setelah disetel Anda langsung memperoleh skor di papan peringkat, dan bukan berarti APIYI pernah mereproduksi papan peringkat resmi.
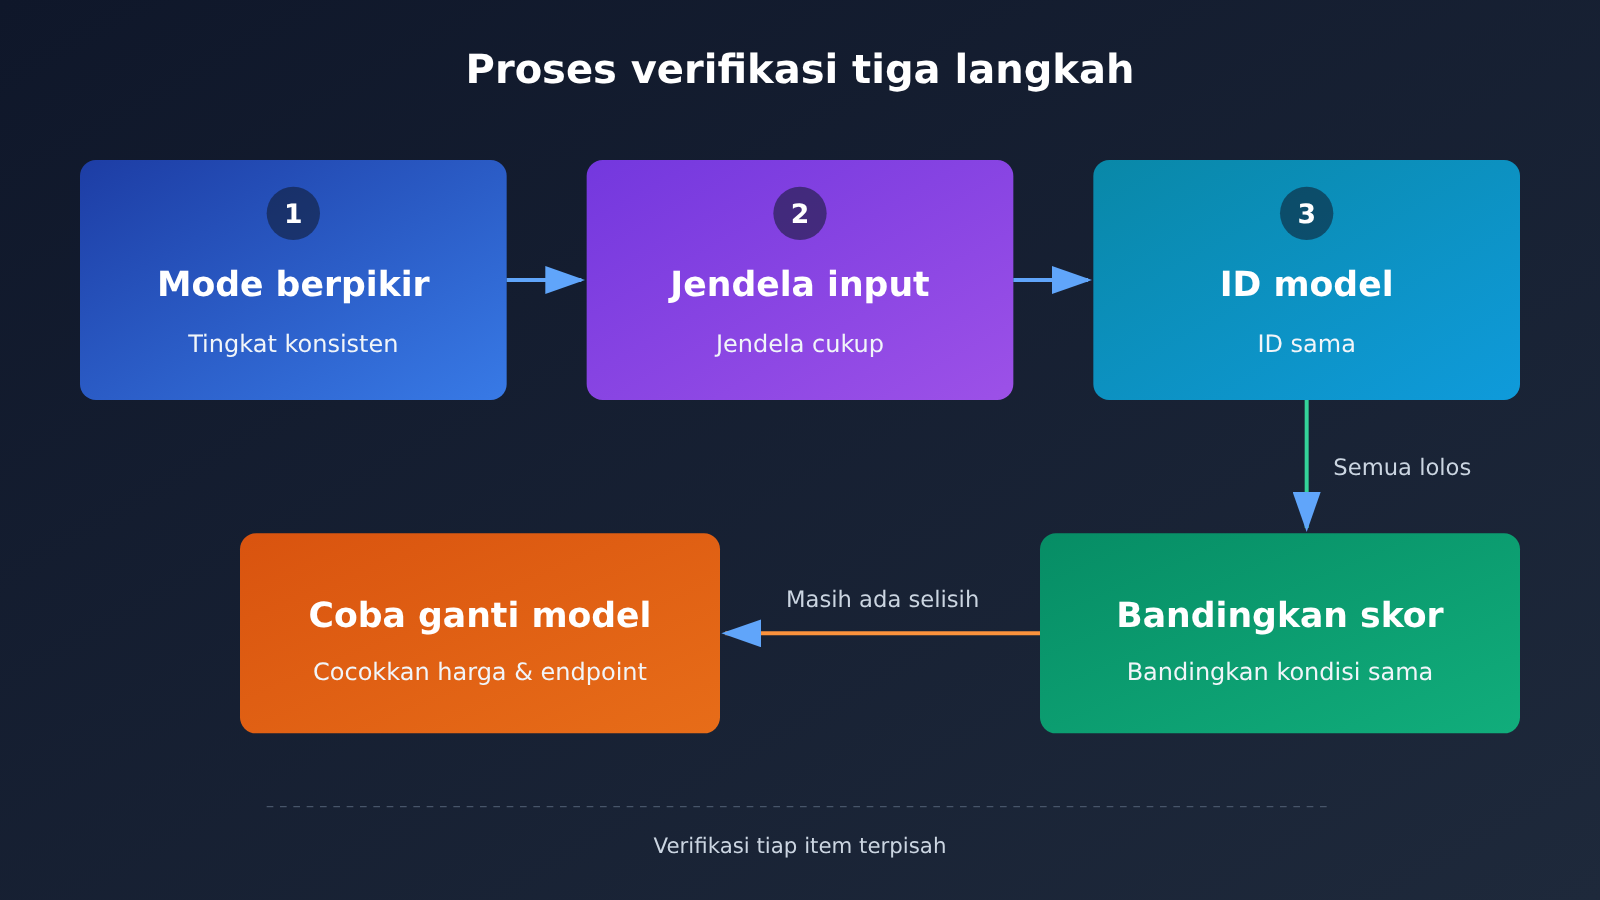
Nilai inti: Setelah membaca artikel ini, Anda akan tahu urutan memeriksa ketiga hal tersebut dan dokumen mana yang harus dilihat pada setiap langkah. Anda juga akan tahu, jika setelah diperiksa masih ada selisih, harga dan endpoint mana yang perlu dicocokkan sebelum mengganti model.
Poin inti saat hasil tidak cocok dengan benchmark resmi
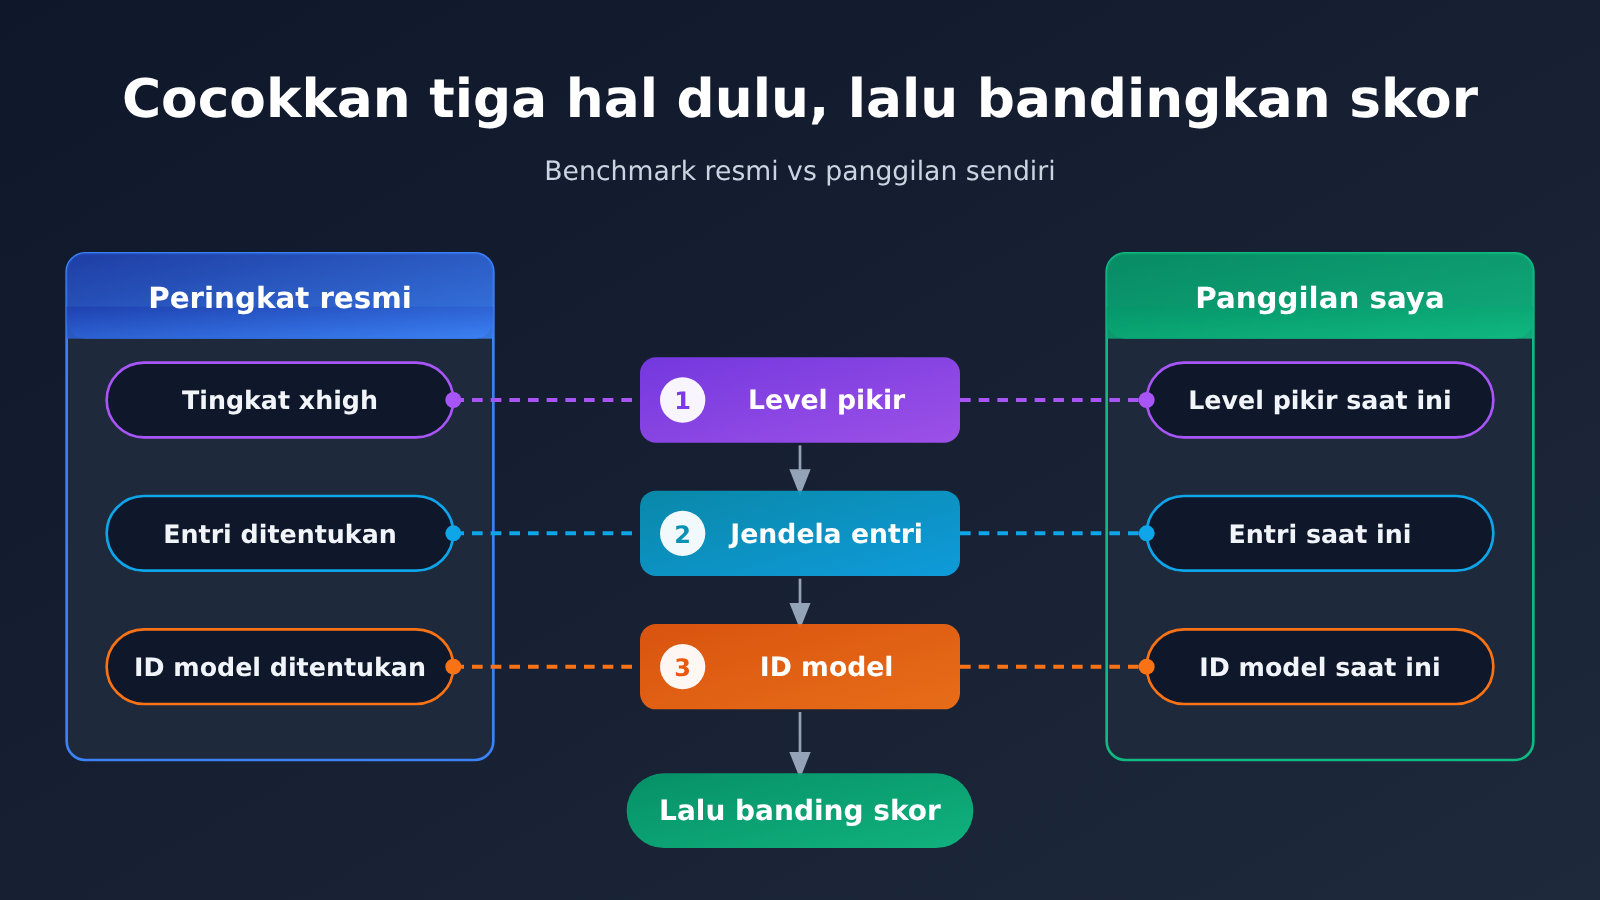
Langsung saja, ini kesimpulannya. Skor di papan peringkat bukanlah skor “nama model”, melainkan skor pada kondisi “ID model tertentu + tingkat penalaran tertentu + jalur akses tertentu”. Selama salah satu dari ketiganya berbeda, hasil yang Anda dapatkan tidak bisa langsung dibandingkan dengan papan peringkat.
| Hal yang dicek | Perbedaan umum (dari dokumentasi publik) | Dampaknya jika tidak cocok | Prioritas |
|---|---|---|---|
| Tingkat penalaran | Neon di API default-nya high, tersedia juga low, medium, xhigh; Carbon default-nya medium, tidak punya xhigh |
Panjang output dan kedalaman penalaran berbeda, hasilnya tentu berbeda | Langkah pertama |
| Jendela konteks jalur akses | Jendela API Neon adalah 1,048,576 token, sedangkan dokumentasi Antigravity menulis maksimal 512K |
Kemampuan konteks panjang yang diuji di papan peringkat belum tentu muat di jalur akses Anda | Langkah kedua |
| ID model | Gemini 4 setidaknya punya empat ID: argon, carbon, hydrogen, neon; pengaturan tingkat penalaran dan harganya berbeda-beda |
Membandingkan hasil A dengan papan peringkat B berarti bukan model yang sama | Langkah ketiga |
Mengapa tingkat penalaran menempati urutan pertama dalam pemeriksaan benchmark resmi
Tingkat penalaran adalah variabel yang paling mudah terlewat karena biasanya punya nilai default; Anda tetap bisa memanggil model dengan normal tanpa mengaturnya. Masalahnya, nilai default antar model berbeda. Contohnya Gemini 4: Neon di API default-nya high, Carbon default-nya medium. Dengan petunjuk yang sama, tingkat yang berbeda akan menghasilkan panjang output dan hasil akhir yang berbeda.
Papan peringkat biasanya mencantumkan level yang diuji. Skor yang dikutip di pengumuman resmi, misalnya skor 61 Neon pada level xhigh dari Artificial Analysis, harus dibaca bersama levelnya. Jika Anda memakai default high untuk membandingkan dengan skor xhigh, kondisinya sejak awal bukan kondisi yang sama. Yang lebih perlu diperhatikan, Carbon sama sekali tidak punya level xhigh, jadi “menaikkan Carbon ke level tertinggi” juga tidak sama dengan xhigh milik Neon.
Penyebutan level yang sama juga bisa berbeda antar jalur akses. Di Antigravity, level tertinggi Neon ditulis sebagai Extra di antarmuka, berbeda dari nama xhigh di dokumentasi API. Saat mencocokkan, cari berdasarkan padanan di dokumentasi, jangan hanya melihat tulisan di layar.
Mengapa jendela konteks jalur akses dan ID model juga sama pentingnya
Jendela konteks jalur akses menentukan berapa banyak konteks yang bisa Anda masukkan ke model. Saat memanggil Neon lewat API, jendelanya 1,048,576 token, sedangkan dokumentasi Antigravity menulis maksimal 512K. Jika papan peringkat menguji pengambilan dokumen panjang atau pemahaman basis kode besar, di jalur akses dengan jendela lebih kecil, meskipun Anda memakai model yang sama, hasilnya bisa lebih buruk karena konten terpotong.
ID model adalah hal yang paling “kaku”. Generasi Gemini 4 setidaknya punya empat ID: argon, carbon, hydrogen, neon; pengaturan tingkat penalaran dan harganya berbeda-beda. Membandingkan hasil Hydrogen dengan papan peringkat Neon di level xhigh jelas akan menunjukkan selisih yang wajar. Sebelum memanggil, sebaiknya cek di tabel model lengkap APIYI apiyi.com ID mana yang benar-benar Anda tulis di permintaan; jangan mengandalkan ingatan atau tangkapan layar orang lain.
Langkah cepat menyelaraskan dengan benchmark resmi
Bagian ini mengubah tiga pemeriksaan menjadi langkah operasional yang konkret. Supaya mudah disalin, nama parameter, ID model, dan alamat ditulis dalam kode inline; Anda bisa mencocokkannya satu per satu dengan request Anda sendiri.
Langkah pertama: Pastikan entry point dan endpoint pemanggilan
Pertama, tentukan dari entry point mana Anda memakai model: antarmuka web, plugin IDE, atau langsung memanggil API. Batas jendela konteks dan penamaan tingkat bisa berbeda di tiap entry point. Jika memakai antarmuka yang kompatibel dengan OpenAI, set base_url ke https://api.apiyi.com/v1, dan isi api_key dengan kunci API yang dibuat di konsol APIYI. Dengan begitu, saat mengganti model nanti Anda hanya perlu mengubah field model; kondisi entry point tetap sama, sehingga perbandingan jadi bermakna.
Langkah kedua: Tulis ID model secara lengkap
Dalam request, tulis model sebagai ID lengkap, misalnya gemini-4-neon atau gemini-4-carbon; jangan pakai sebutan samar seperti “Gemini 4”. Setelah itu, kembali ke tabel ringkasan model dan cocokkan sekali lagi untuk memastikan ID ini persis yang diuji di leaderboard. Jika leaderboard menguji Neon tetapi yang Anda panggil adalah gemini-4-hydrogen, semua perbandingan setelahnya tidak ada gunanya; perbaiki dulu ID-nya.
Langkah ketiga: Set tingkat berpikir secara eksplisit
Jangan bergantung pada nilai default; tentukan tingkat berpikir secara eksplisit dalam request. Untuk nama field spesifik, ikuti dokumentasi resmi model yang bersangkutan. Ada tiga hal yang perlu diperhatikan saat menyetelnya:
- Selaraskan dengan tingkat yang diuji di leaderboard: jika leaderboard menulis
xhigh, setxhigh; jika menulishigh, sethigh. - Pastikan tingkat itu ada: Carbon tidak punya
xhigh; memaksakan pencocokan dengan leaderboardxhighmilik Neon tidak ada artinya. - Perhatikan pemetaan nama:
Extradi antarmuka Antigravity sesuai dengan tingkat tertinggi Neon; saat beralih ke API, ganti dengan nama tingkat yang tercantum di dokumentasi.
Langkah keempat: Periksa apakah konteks melebihi jendela entry point
Jika konten pengujian Anda sangat panjang, perkirakan jumlah token lebih dulu, lalu bandingkan dengan batas entry point. Saat memanggil Neon lewat API, batasnya adalah 1,048,576 token; di dokumentasi Antigravity tertulis maksimum 512K. Konten yang melebihi batas akan dipotong atau menimbulkan error. Dalam kasus ini, “hasilnya buruk” sebenarnya karena input tidak lengkap.
🚀 Mulai cepat: Jika ingin membandingkan beberapa ID model dalam kondisi entry point yang sama, Anda dapat memanggil model seperti Gemini, Claude, dan GPT melalui APIYI di apiyi.com dengan satu kunci API. Pengguna baru mendapat kuota pengujian gratis, cocok untuk menyelaraskan tingkat dan ID terlebih dahulu, lalu melakukan perbandingan skala kecil.
Daftar periksa tiga pemeriksaan
| Item pemeriksaan | Field yang perlu dilihat dalam request | Kriteria lolos | Kesalahan umum |
|---|---|---|---|
| Entry point | base_url |
Tetapkan satu entry point, misalnya https://api.apiyi.com/v1 |
Menguji sekali di web, sekali di API, lalu mencampur hasilnya |
| ID model | model |
ID lengkap yang sama dengan leaderboard | Memakai hydrogen untuk membandingkan dengan leaderboard neon |
| Tingkat berpikir | Parameter tingkat berpikir (nama field mengikuti dokumentasi) | Sama dengan tingkat yang diuji leaderboard dan tingkat tersebut ada | Bergantung pada nilai default; menyetel xhigh untuk Carbon |
| Konteks | Jumlah token input | Tidak melebihi batas jendela konteks entry point | Menjejalkan konten berukuran jutaan token ke entry point 512K |
Setelah memeriksa tolok ukur resmi masih ada selisih: periksa harga dan endpoint sebelum mengganti model
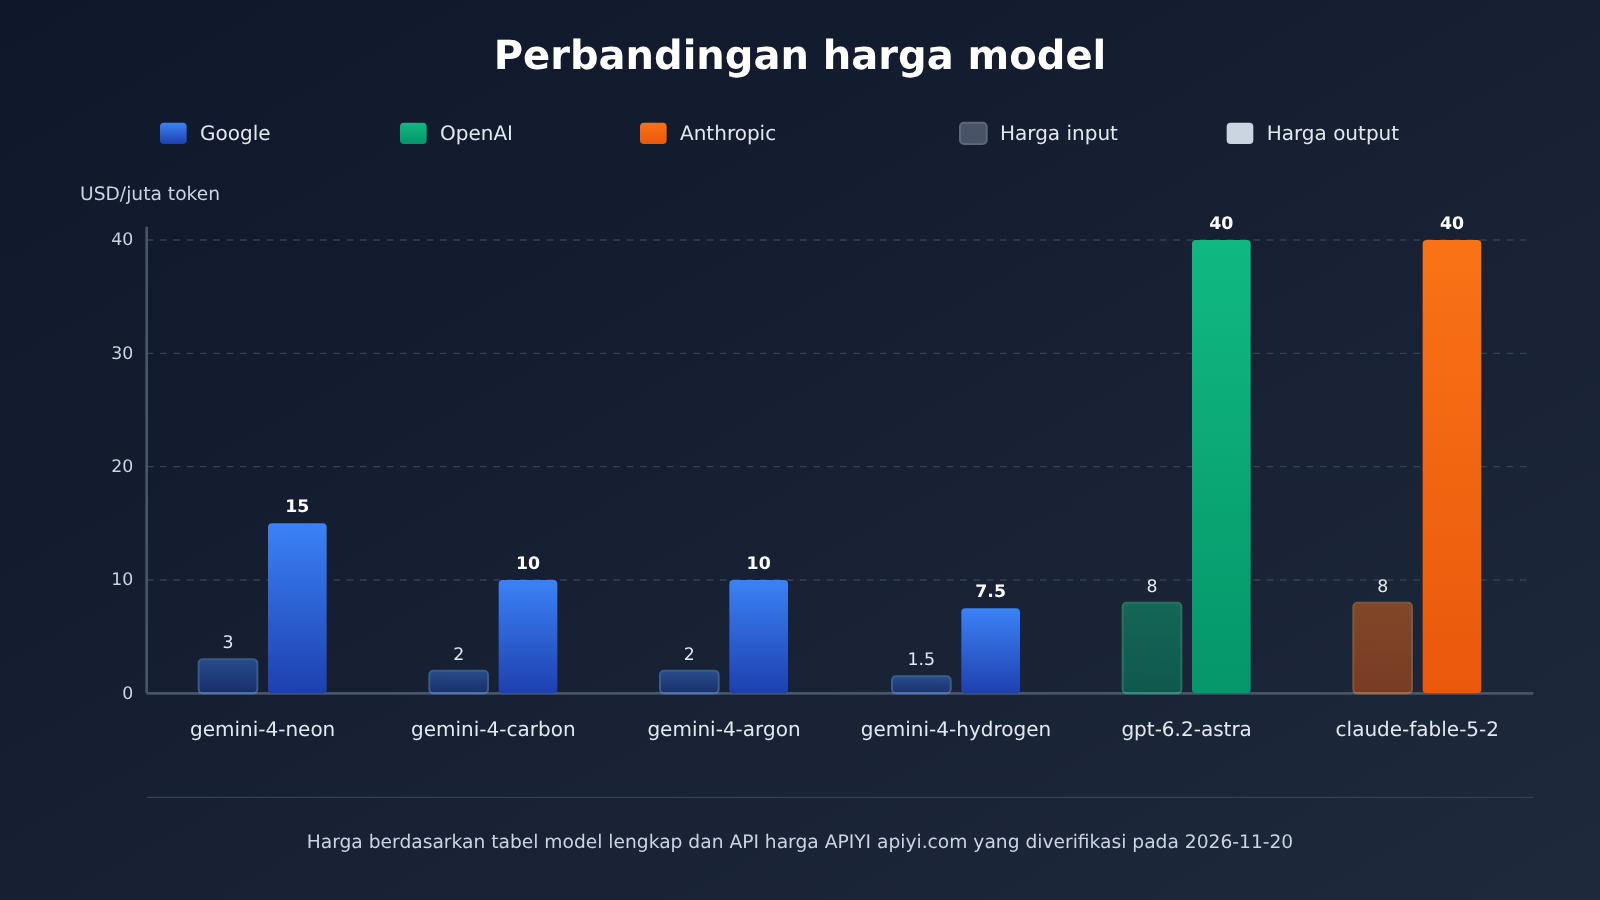
Setelah ketiga hal itu cocok, jika selisihnya masih terlihat jelas, barulah saat itu layak mempertimbangkan ganti model. Mengganti model bukan sekadar mengganti nama, tetapi juga harus melihat tingkat kemampuan dan biaya sekaligus, karena harga tiap ID Gemini 4 cukup berbeda. Berikut ini harga etalase APIYI yang diperiksa pada 2026-11-20, semuanya dalam dolar per juta token.
| ID Model | Input | Baca cache | Output | Catatan |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
Mengikuti endpoint harga, sesuai dengan harga Google |
gemini-4-carbon |
2 |
0.1 |
10 |
Sesuai harga perkenalan Google hingga 2026-11-30 |
gemini-4-argon |
2 |
0.1 |
10 |
Dari tabel model lengkap |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
Harga satuan terendah di antara keempatnya |
gpt-6.2-astra |
8 |
0.4 |
40 |
Setelah melewati 272000 token, input menjadi 16, lihat detail di bawah |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 |
0.2 |
40 |
Kedua ID harganya sama |
Tabel ini punya beberapa hal yang perlu dijelaskan terpisah, kalau tidak mudah salah hitung biaya:
- Sumber gemini-4-neon: Versi tabel model lengkap yang diperbarui pada 2026-11-19 10:59 (UTC+8) tidak memuatnya, tetapi endpoint harga memuatnya. Endpoint harga memberikan
model_ratiosebesar1.5,completion_ratiosebesar5, dancache_ratiosebesar0.05. Dengan konversimodel_ratiobernilai1setara input 2 dolar/juta token, didapatkan input3, output15, baca cache0.15. - Masa berlaku harga gemini-4-carbon: Harga saat ini sesuai harga perkenalan Google hingga 2026-11-30. Mulai 1 Desember, harga standar Google adalah input
4, output20, saat menyusun anggaran jangka panjang perubahan ini harus diperhitungkan. - Tingkatan harga gpt-6.2-astra: Tabel model lengkap menuliskan tingkat pertama input
8, baca cache0.4, output40, setelah melewati272000token input menjadi16. Endpoint harga ketika melewati272000token menghitung output sebesar60dan baca cache sebesar0.8. Silakan rujuk kedua informasi ini bersamaan.
💡 Saran pemilihan: Saat mengganti model, letakkan ID kandidat di bawah
base_urlyang sama, lalu bandingkan dengan tingkat pemikiran dan input yang sama, barulah kesimpulannya bisa diandalkan. Tabel model lengkap dan endpoint harga APIYI apiyi.com dapat menampilkan harga terkini ID-ID ini, disarankan untuk mengonfirmasi sekali lagi sebelum pemanggilan, jangan hanya bergantung pada tabel di artikel ini.
Daftar periksa endpoint dan penagihan saat mengganti model
| Poin pemeriksaan | Di mana mencarinya | Mengapa perlu diperiksa |
|---|---|---|
| Apakah ID model ada | Tabel daftar model docs.apiyi.com/models.md |
Versi tabel daftar model bisa tertinggal, beberapa ID perlu dicek lagi di endpoint harga |
| Harga satuan dan rasio saat ini | Endpoint harga api.apiyi.com/api/pricing |
Rasio bisa dikonversi menjadi harga satuan dolar, nomor versinya shell-api-modelmak-v1 |
| Tingkatan harga konteks panjang | Cocokkan di dua tempat: tabel daftar model dan endpoint harga | Contohnya gpt-6.2-astra berubah harga satuannya setelah melewati 272000 token |
| Endpoint pemanggilan | https://api.apiyi.com/v1 |
Format kompatibel OpenAI, mengganti model hanya perlu mengubah model |
| Perubahan harga upstream | Pengumuman harga resmi | Contohnya harga perkenalan Carbon berakhir pada 2026-11-30 |
Pertanyaan Umum (FAQ)
Q1: Skor benchmark resmi sebenarnya merujuk pada kondisi apa?
Skor di papan peringkat merujuk pada kombinasi “ID model tertentu + tingkat berpikir tertentu + kondisi akses tertentu”, bukan nama model yang generik. Misalnya, skor 61 milik Neon adalah hasil Artificial Analysis pada tingkat `xhigh`. Mengutip angka ini tanpa menyebut tingkatannya sangat mudah menimbulkan salah paham.
Q2: Tingkat berpikir, jendela akses, dan ID model — mana yang harus dicek lebih dulu?
Urutan yang disarankan: cek tingkat berpikir dulu, lalu jendela akses, terakhir verifikasi ID model. Setelah ketiganya cocok, baru bandingkan skor. Dalam praktik, boleh juga melihat ID sekilas lebih dulu, karena kalau ID-nya salah, dua item lainnya tidak perlu dilihat. Makna urutan ini adalah menyingkirkan satu per satu, bukan menjalankan langkah secara mekanis setiap kali.
Q3: Kalau tingkat berpikir disetel ke paling tinggi, apakah bisa mencapai benchmark resmi?
Tidak bisa dijanjikan begitu. Menyelaraskan tingkat hanya memastikan Anda membandingkan dengan kondisi yang sama seperti papan peringkat; distribusi soal, cara penulisan prompt, metode sampling, dan faktor lain tetap bisa menimbulkan perbedaan. Selain itu, tidak setiap ID punya tingkat tertinggi — misalnya Carbon tidak punya `xhigh`, dan menyetelnya ke tingkat tertingginya tidak sama dengan `xhigh` milik Neon.
Q4: Mengapa Neon yang sama bisa berbeda hasilnya di IDE dan saat memanggil API langsung?
Kondisi aksesnya bisa berbeda. Saat Neon diakses lewat API, jendelanya `1,048,576` token, sedangkan dokumentasi Antigravity menulis maksimal `512K`. Penamaan tingkat di kedua sisi juga berbeda — tingkat tertinggi di antarmuka Antigravity disebut `Extra`. Tugas berkonteks panjang tampil lebih buruk di jalur dengan jendela lebih kecil; itu akibat perbedaan kondisi, bukan bukti modelnya menurun.
Q5: Bagaimana membandingkan beberapa ID model pada jalur akses yang sama?
Anda bisa melakukannya dalam tiga langkah berikut:
1. Daftar di APIYI apiyi.com dan buat API Key; pengguna baru bisa mendapatkan kuota uji gratis.
2. Setel `base_url` seragam ke `https://api.apiyi.com/v1`, hanya ubah field `model` untuk berganti ID.
3. Setel tingkat berpikir yang sama secara eksplisit untuk setiap ID, dan gunakan kumpulan input yang sama untuk perbandingan.
Dengan begitu jalur akses dan tingkat sudah tetap, sehingga perbedaan terutama berasal dari model itu sendiri.
Q6: gemini-4-neon tidak ada di tabel model utama, apakah masih bisa dipanggil?
Versi tabel utama yang diperbarui 2026-11-19 tidak memuat `gemini-4-neon`, tetapi antarmuka harga memiliki pengalinya: setelah dikonversi, input `3`, output `15`, cache read `0.15` USD per juta token, sama dengan harga Google. Sebaiknya jadikan hasil real-time dari antarmuka harga APIYI apiyi.com sebagai acuan, dan konfirmasi sekali lagi sebelum memanggil.
Q7: Saat mengganti model, item mana yang paling mudah salah dihitung?
Yang paling mudah salah adalah pengelompokan konteks panjang dan masa berlaku harga. `gpt-6.2-astra` setelah melewati `272000` token, harga input berubah dari `8` menjadi `16`; antarmuka harga juga mencantumkan bahwa output dihitung `60` dan cache read `0.8`. Carbon saat ini berharga perkenalan; mulai 1 Desember, harga standar Google adalah input `4`, output `20`.
Verifikasi Benchmark Resmi: Poin-Poin Penting
- Skor leaderboard bersyarat: Skor benchmark mengacu pada kombinasi “ID model + tingkat berpikir + jalur akses”, bukan skor dari nama model itu sendiri.
- Cek dulu tingkat berpikirnya: Neon default-nya
high, Carbon default-nyamediumdan tidak punyaxhigh. Jangan bergantung pada nilai default. - Lalu cek jendela konteks jalur akses: Neon di API punya
1,048,576token, sedangkan dokumentasi Antigravity menyebut maksimal512K. - ID harus sama persis: Gemini 4 setidaknya punya empat ID. Memakai hasil Hydrogen untuk membandingkan dengan leaderboard Neon tidak ada artinya.
- Setelah disetel, belum tentu imbang: Menyamakan kondisi hanya membuat perbandingan valid, bukan jaminan skornya menyusul leaderboard.
- Ganti model, cocokkan harga katalog: Di APIYI apiyi.com, bandingkan beberapa ID lewat endpoint yang sama, sekaligus cocokkan harga di tabel utama dan endpoint harga.
Ringkasan
Saat performa model tidak sesuai dengan benchmark resmi, urutan pengecekan tiga hal adalah:
- Samakan tingkat berpikir: Setel secara eksplisit tingkat yang sama seperti saat pengujian leaderboard, dan pastikan ID ini memang punya tingkat tersebut.
- Samakan jendela konteks jalur akses: Pastikan jalur aksesmu cukup menampung isi pengujian, dan perhatikan penamaan tingkat di tiap jalur akses.
- Samakan ID model: Tulis ID lengkap dalam permintaan, lalu kembali ke tabel utama model dan cocokkan kata per kata.
Setelah ketiganya cocok, kalau selisihnya masih ada, baru pertimbangkan ganti model. Saat ganti model, bandingkan sekaligus tingkat kemampuan, harga satuan, pembagian harga untuk konteks panjang, dan kebaruan harga. Dasar keputusannya adalah hasil perbandingan pada kondisi yang sama, bukan angka leaderboard yang dikutip tanpa konteks.
Sebaiknya verifikasi beberapa ID model melalui APIYI apiyi.com di endpoint yang sama, https://api.apiyi.com/v1. Setelah jalur akses dan tingkatnya dipatok, kesimpulan perbandingan akan jauh lebih andal.
📚 Referensi
-
Tabel Lengkap Model APIYI: ringkasan ID model dan harga terdaftar
- Tautan:
docs.apiyi.com/models.md - Keterangan: versi yang dikutip dalam artikel ini diperbarui pada 2026-11-19 10:59 (UTC+8), bisa dipakai untuk memverifikasi apakah suatu ID model tersedia
- Tautan:
-
Antarmuka Harga APIYI: rasio dan harga satuan secara real-time
- Tautan:
api.apiyi.com/api/pricing - Keterangan: versi
shell-api-modelmak-v1, saatmodel_ratiobernilai1setara dengan input 2 dolar AS per juta token, sehingga bisa dikonversi menjadi harga satuan tiap model
- Tautan:
-
Dokumentasi dan Penjelasan Harga Resmi Google Gemini 4: tingkat pemikiran, jendela konteks, dan harga tertera
- Tautan:
ai.google.dev - Keterangan: untuk memeriksa tingkat pemikiran default tiap ID, tingkat yang tersedia, batas jendela API, dan waktu perubahan harga
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami lewat beranda situs resmi APIYI, materi model dan antarmuka lainnya bisa dilihat di pusat dokumentasi APIYI


