
Catatan penulis: d1.2-ultra tercantum di peringkat 1 pada Decision Index v2.1. Artikel ini mengajak Anda lebih dulu mengenali apakah pekerjaan Anda termasuk ekstraksi dokumen, pemanggilan tool, atau menjawab soal sulit; lihat hanya subskor yang relevan, lalu putuskan pindah atau tidak memakai 20 sampai 50 sampel milik Anda sendiri.
Pada 2026-11-16, Liquid AI merilis d1.2 dan d1.2-ultra. Blog resminya menyebut d1.2-ultra meraih skor 75 pada Artificial Analysis Decision Index v2.1, tertinggi di antara model pengambilan keputusan. Banyak developer yang sedang mengintegrasikan API melihat “peringkat 1”, dan reaksi pertamanya adalah langsung mengganti model produksi. Jangan buru-buru mengganti — skor gabungan 75 hanyalah pemicunya; yang benar-benar perlu Anda lihat adalah skor subitem yang cocok dengan bisnis Anda.
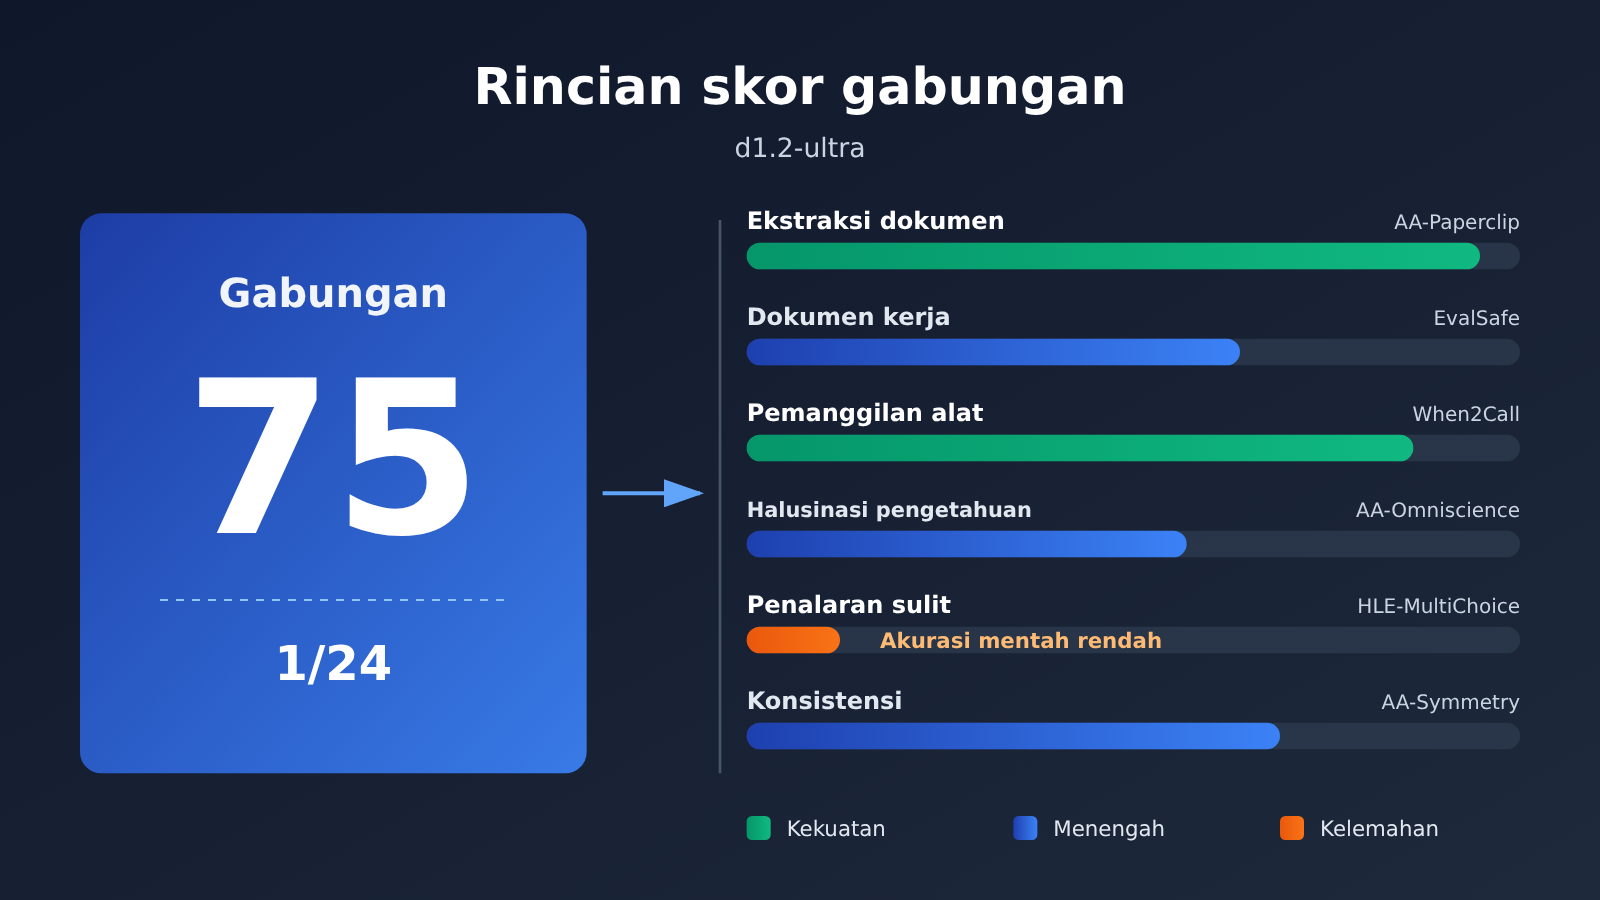
Ini bukan artikel yang menjatuhkan atau memuji. Model yang sama menempati peringkat 1 pada ekstraksi dokumen, tetapi pada soal pilihan ganda yang sangat sulit akurasi mentahnya justru terendah di antara 24 model pengambilan keputusan. Kedua hal itu benar sekaligus, dan skor gabunganlah yang meratakan keduanya.
Nilai inti: setelah membaca artikel ini, Anda akan tahu subskor mana yang harus dilihat, cara membaca skor keputusan dan akurasi mentah, serta bagaimana memakai 20 sampai 50 sampel milik Anda sendiri untuk menyimpulkan perlu pindah atau tidak dalam satu sore.
Poin inti d1.2-ultra sebagai peringkat pertama keseluruhan
Mari kita lihat dulu angka-angka di halaman peringkat. Data berikut diambil dari halaman model d1.2-ultra di Artificial Analysis, tanggal pembacaan 2026-11-17, dengan total 24 model pengambilan keputusan yang dibandingkan.
| Item | Data halaman peringkat | Cara membaca |
|---|---|---|
| Indeks keseluruhan | 74.85, halaman menampilkan 75, peringkat 1/24 | Peringkat ke-2, Drex Max v1.1, sebesar 72.62, selisih sekitar 2.2 poin—sama dengan yang disebut resmi sebagai “dua poin”, hanya soal pembulatan |
| Waktu eksekusi | 218 milidetik/tugas, peringkat 14/24 | Median di halaman 209 milidetik, tergolong menengah |
| Biaya menjalankan indeks penuh | 133 dolar/per juta tugas, peringkat 11/24 | Ini biaya per tugas, bukan harga daftar per satu juta token |
| Harga input | 0.042 dolar/per satu juta token | Konsisten dengan blog resmi Liquid; yang dihitung resmi hanya input |
| Brier | 0.150, terendah dari 24 | Semakin rendah semakin baik, artinya probabilitas yang diberikan cukup “jujur” |
Bagaimana skor keseluruhan d1.2-ultra dihitung
Decision Index v2.1 adalah rata-rata berbobot dari enam subskor. Definisi skor keputusan di halaman model adalah: akurasi dikurangi skor Brier dari probabilitas jawaban yang dipilih, rentang 0 sampai 100, semakin tinggi semakin baik. Artinya, menjawab salah dengan percaya diri dipotong lebih banyak daripada menjawab salah dengan ragu-ragu. Akurasi mentah adalah proporsi soal di mana model memberikan probabilitas tertinggi pada opsi yang benar, dan itu bukan angka yang sama dengan skor keputusan.
Perbedaan ini langsung memengaruhi cara Anda membaca d1.2-ultra. Sebuah model bisa mendapat skor keputusan yang tidak rendah karena sering tidak menebak dan jarang membuat kesalahan dengan percaya diri, sementara akurasi mentahnya rendah. Jika bisnis Anda menuntut “harus memberikan jawaban”, Anda sebaiknya melihat akurasi mentah; jika bisnis mengizinkan “kalau tidak yakin, alihkan ke manusia”, skor keputusan lebih berguna sebagai referensi.
| Subskor | Bobot | Mengukur apa | Kategori AA |
|---|---|---|---|
| AA-Paperclip | 30% | Penilaian dan ekstraksi dokumen transaksi; satu dokumen dengan 15 jawaban dihitung sebagai satu penilaian | Dokumen |
| EvalSafe-O*NET-AA | 15% | Penilaian dokumen dunia kerja | Dokumen |
| When2Call | 10% | Pemanggilan alat | Alat |
| AA-Omniscience-Decision v1.1 | 15% | Pengetahuan dan halusinasi | Pengetahuan |
| HLE-MultiChoice v1.1 | 15% | Soal pilihan ganda teks Humanity’s Last Exam, boleh menolak menjawab | Penalaran |
| AA-Symmetry v1.1 | 15% | Mengganti ungkapan, mengubah urutan opsi, dan setelah negasi apakah penilaian tetap tidak berubah | Konsistensi |
Perhatikan bahwa HLE-MultiChoice di AA ditandai sebagai penalaran, bukan pengetahuan. Jadi saat disebut di bagian bawah, jangan ditulis sebagai “tes pengetahuan”.
Cara mencocokkan skor untuk item yang tepat pada d1.2-ultra
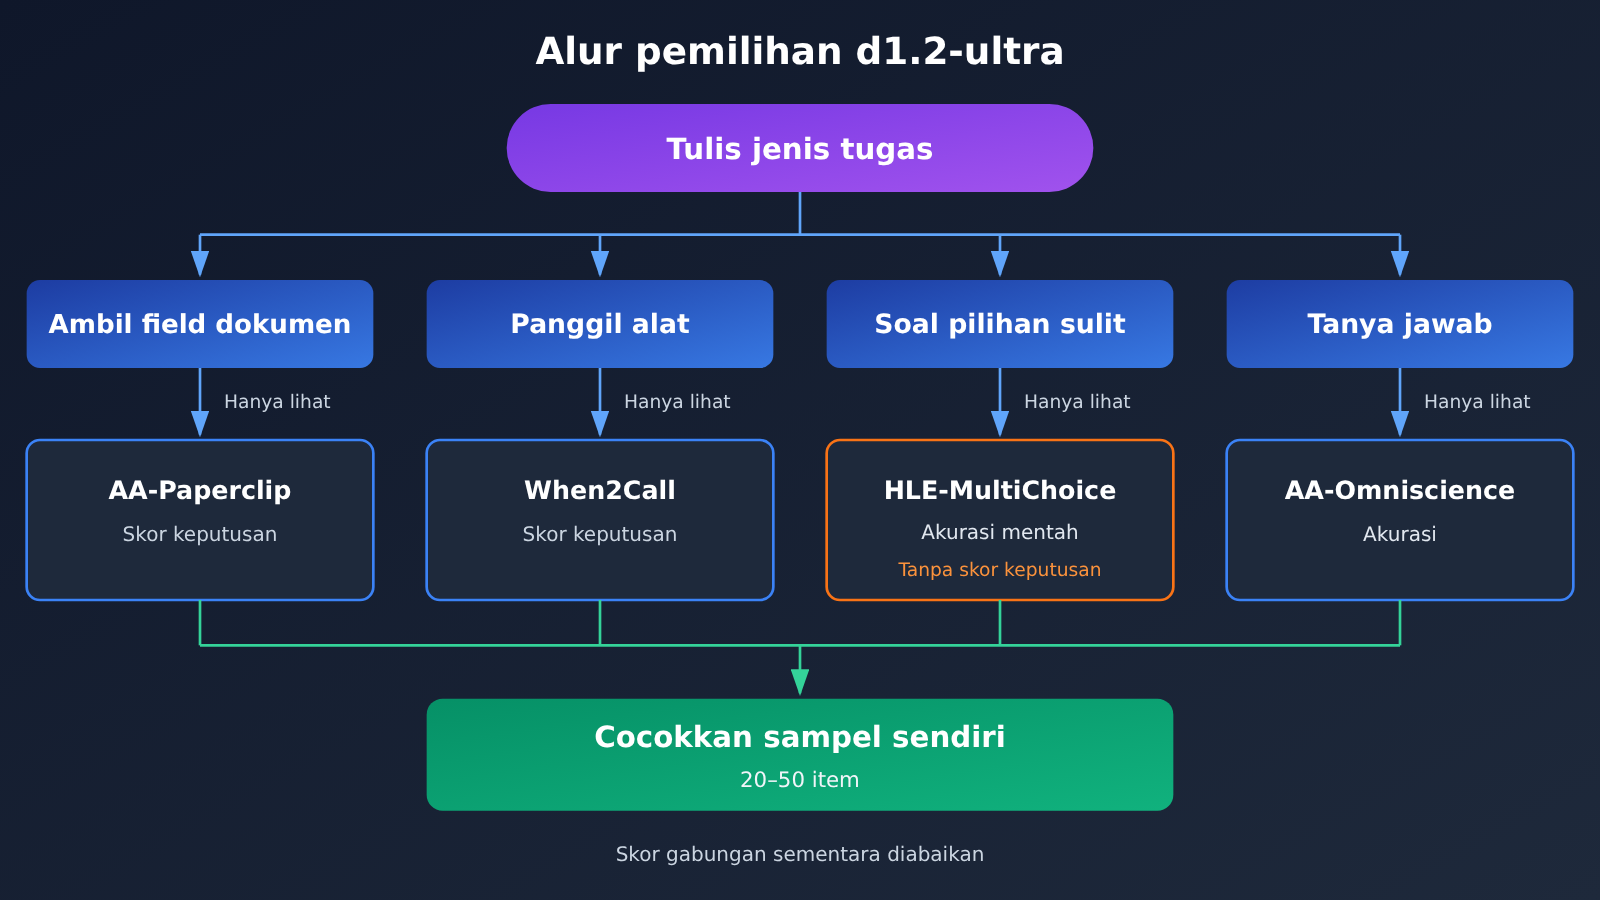
Langkah pertama bukan melihat papan peringkat, melainkan mengambil selembar kertas dan menuliskan tugas Anda sebenarnya termasuk kategori mana: mengekstrak dokumen, memanggil alat, menjawab pertanyaan sulit, atau tanya jawab pengetahuan. Setelah selesai, hanya lihat item yang cocok; subskor lain dan skor komprehensif 75 untuk sementara diabaikan.
| Tugas Anda | Hanya lihat item ini | Data halaman peringkat d1.2-ultra | Cara memahaminya |
|---|---|---|---|
| Mengekstrak field faktur, resume, makalah | AA-Paperclip | Skor keputusan 75.81, tingkat dokumen sepenuhnya benar 67.7%, keduanya peringkat 1/24 | Peringkat 2 Drex Max v1.1 adalah 72.82 dan 63.0%, keunggulannya cukup jelas |
| Memanggil alat, menilai apakah perlu memanggil | When2Call | Skor keputusan 96.49, peringkat 1 | SubQ Snap 1.2 adalah 96.10, d1.2 adalah 96.09, beberapa nama teratas berdesakan dalam sekitar 1 poin |
| Penilaian dokumen tempat kerja | EvalSafe-O*NET-AA | Skor keputusan 89.53, peringkat 3 | Di depannya adalah Jev 1.14 (91.14) dan GLiDE v1.2 (89.67) |
| Menjawab soal pilihan ganda yang sangat sulit | Akurasi mentah HLE-MultiChoice | 2.36%, terendah di antara 24 model keputusan | Skor keputusan 46.36 tidak berada di dasar, tingkat tidak berhalusinasi 76.1%, ia sering memilih untuk tidak menebak |
| Tanya jawab pengetahuan | Akurasi AA-Omniscience | Akurasi mentah 23.6%, peringkat 20/24 | Skor keputusan 60.80 peringkat 6, tingkat tidak berhalusinasi 83.8% |
| Stabil atau tidaknya jawaban setelah mengubah cara penyampaian | Tingkat lulus semua AA-Symmetry | Skor 86.34 peringkat 2; tingkat lulus semua 56.7% peringkat 5 | Skor peringkat dua tidak sama dengan stabilitas peringkat dua |
Dua hal yang paling mudah salah baca dalam subskor d1.2-ultra
Hal pertama adalah HLE-MultiChoice. Akurasi mentah 2.36% memang yang terendah di antara 24 model keputusan, tetapi skor keputusannya 46.36 tidak berada di dasar; di halaman yang sama ada yang lebih rendah, misalnya Mercury Decide dengan 34.79. Ditambah tingkat tidak berhalusinasi 76.1%, cara membaca yang wajar adalah: ketika menghadapi soal pilihan ganda penalaran yang sangat sulit, d1.2-ultra cenderung tidak memberikan jawaban dengan keyakinan tinggi. AA mengklasifikasikan item ini sebagai penalaran, jadi tidak bisa disebut “peringkat terakhir dalam tes pengetahuan”.
Hal kedua adalah AA-Omniscience. Akurasi 23.6% menempati peringkat 20/24, bukan yang terakhir. Yang menarik, d1.2 yang lebih kecil di halaman yang sama memperoleh 30.0% pada item ini, akurasi mentah HLE-nya juga 5.30%, kedua item lebih tinggi daripada ultra. Namun indeks komprehensif d1.2 adalah 68.69, peringkat 9/24, jadi “ultra yang lebih mahal pengetahuannya lebih buruk” hanya berlaku untuk kedua item ini, tidak bisa disimpulkan menjadi lebih buruk secara menyeluruh.
🎯 Saran membaca papan peringkat: Jika tugas Anda adalah mengekstrak dokumen, peringkat 1
d1.2-ultrapada AA-Paperclip layak dipertimbangkan dengan serius; jika pemanggilan alat, peringkat 1 itu benar, tetapi jarak dengan beberapa nama berikutnya dalam 1 poin, apakah perlu mengganti atau tidak tergantung pada sampel Anda sendiri.
Cara memakai data yang dilaporkan sendiri oleh d1.2-ultra
Liquid dalam blog yang sama juga menyajikan lima kategori tugas baru beserta hasil pengujian internal. Pihak vendor menulis dengan jelas bahwa tugas-tugas baru ini belum tercakup oleh benchmark publik; data di bawah semuanya merupakan laporan resmi dari vendor sendiri, menggunakan set holdout internal, bukan hasil dari Artificial Analysis.
| Tugas baru (laporan resmi vendor) | d1.2-ultra | d1.2 | Catatan |
|---|---|---|---|
| Membaca nilai struk (CORD, SROIE) | 98% | 96% | Nilai yang tidak ada dijawab not found |
| Span informasi sensitif (Nemotron PII) presisi/recall | 94% / 93% | 92% / 88% | Memberikan posisi setiap segmen |
| Menyeleksi objek berdasarkan deskripsi (seri RefCOCO) | 94% | 94% | Keduanya setara |
| Menghitung objek, toleransi selisih 1 (COCO) | 93% | 92% | Memberikan estimasi angka beserta rentangnya |
| Mengidentifikasi setiap objek dalam gambar (COCO) | 87% | 90% | Di baris ini d1.2 yang lebih murah justru lebih tinggi |
Untuk audio, vendor mengklaim bahwa saat menentukan kategori suara (ESC-50) dan bahasa (FLEURS, 43 bahasa) pada rekaman holdout, keduanya berada di kisaran 95% hingga 97%. Untuk kesalahan kalibrasi, Liquid mengukur pada 13 benchmark dan 22505 soal bahwa d1.2-ultra sebesar 0.8, d1.2 sebesar 1.2, Jev 1.14 sebesar 2.7, Perplexity Decider v1.3 sebesar 3.7, dan Decisions API milik GPT-6 Luna sebesar 7.2.
Di sini perlu dibedakan dengan jelas: GPT-6 Luna (Decisions) memiliki indeks komprehensif 60.25 pada papan peringkat keputusan Artificial Analysis, menempati peringkat 22/24, dengan akurasi mentah HLE 7.86%. Semua ini adalah skor dari antarmuka Decisions, tidak boleh dianggap sebagai skor antarmuka chat gpt-6-luna. Blog resmi juga menulis “Coming to OpenRouter and Vercel soon”; ini merupakan pengumuman awal pihak vendor, bukan berarti sudah diluncurkan.
Mulai cepat d1.2-ultra: uji dengan sampel Anda sendiri
Setelah melihat peringkat, yang benar-benar menentukan apakah Anda perlu beralih adalah data Anda sendiri. Siapkan 20 hingga 50 sampel nyata saja sudah cukup, misalnya 30 faktur atau 30 resume. Tandai lebih dulu nilai yang benar untuk setiap field di setiap sampel, dan sebaiknya ada beberapa sampel yang sengaja tidak memiliki field tertentu.
Langkah-langkah operasi paling simpel
- Pilih 20 hingga 50 sampel dari bisnis Anda, tandai secara manual nilai yang benar untuk setiap field, dan field yang tidak ada ditandai sebagai not found.
- Tulis satu petunjuk tetap: minta model mengeluarkan field yang ditentukan dalam format JSON, field yang tidak ditemukan harus diisi
not found, dan tidak boleh menebak. - Gunakan SDK yang kompatibel dengan OpenAI, set
base_urlkehttps://api.apiyi.com/v1, isimodeldengangpt-6-lunalebih dulu, lalu ganti kegpt-6.1-soldan jalankan masing-masing sekali. - Bandingkan satu per satu, catat tiga angka: akurasi tingkat field, rasio dokumen yang seluruhnya benar, dan berapa kali field yang hilang diisi dengan tebakan.
- Setelah model target bisa dipanggil, jalankan sekali lagi dengan sampel yang sama dan petunjuk yang sama, lalu bandingkan ketiga angka itu secara langsung.
Lihat pendekatan pembandingan lengkap
– **Input**: satu file sampel, setiap baris berisi teks asli (atau gambar) dan kamus field yang dianotasi manual.
– **Pemanggilan**: baca sampel secara berulang, panggil `client.chat.completions.create` atau endpoint `responses`, set `temperature` ke 0, dan minta output JSON yang ketat.
– **Parsing**: kegagalan parsing output dihitung terpisah, ini sendiri sudah menjadi indikator ketersediaan.
– **Pembandingan**: lakukan perbandingan ternormalisasi per field (hapus spasi, seragamkan format tanggal, nominal uang dengan dua desimal).
– **Penghitungan halusinasi**: field yang dianotasi sebagai not found tetapi diisi nilai oleh model, dicatat terpisah sebagai “tebakan”.
– **Ringkasan**: keluarkan akurasi field, rasio dokumen yang seluruhnya benar, jumlah tebakan, dan rata-rata penggunaan token, agar mudah menghitung biaya nanti.
Jalankan baseline lebih dulu dengan APIYI
Ini akan menghabiskan token. d1.2 dan d1.2-ultra tidak ada dalam daftar model APIYI, jadi untuk sekarang Anda bisa lebih dulu memakai gpt-6.1-sol atau gpt-6-luna yang sudah tersedia di APIYI (apiyi.com) dengan alamat pemanggilan https://api.apiyi.com/v1, lalu jalankan batch faktur atau resume yang sama untuk melihat apakah field-nya benar dan apakah field yang tidak ada ditebak sembarangan. Dengan begitu Anda sudah punya baseline yang bisa diukur.
Belum tersedia untuk sementara waktu, kami akan segera menghadirkan model ini; tipe dan harga mengacu pada daftar model platform.
| Item pemeriksaan mandiri | Cara mencatat | Kriteria penilaian |
|---|---|---|
| Akurasi field | Jumlah field benar / total field | Bandingkan dengan model produksi saat ini |
| Rasio dokumen全对 | Proporsi dokumen yang semua field-nya benar | Setara dengan “akurasi dokumen penuh” AA-Paperclip |
| Jumlah tebakan | Berapa kali field not found diisi nilai | Semakin sedikit semakin baik, sejalan dengan konsep tingkat non-halusinasi |
| Kegagalan parsing | Jumlah entri JSON yang tidak bisa di-parse | Berdampak langsung pada biaya peluncuran |
| Penggunaan token | Rata-rata token input dan output per entri | Dipakai untuk mengonversi ke biaya sebenarnya |
🚀 Saran memulai: Pakai dulu kuota uji gratis pengguna baru APIYI apiyi.com untuk menjalankan 20 entri, pastikan petunjuk dan skrip pembanding tidak bermasalah, baru perluas ke 50 entri, supaya kuota tidak habis untuk debugging di awal.
d1.2-ultra: Harga dan Cara Pemanggilan
Harga harus jelas satuannya. Angka 133 dolar di papan peringkat adalah biaya benchmark “per juta tugas”, sedangkan harga resmi Liquid memakai satuan “per juta token input”: d1.2 sebesar 0.02 dolar, d1.2-ultra sebesar 0.042 dolar, dan hanya menghitung input. Gambar dihitung 1.5 token per 32×32 piksel dengan tarif teks; untuk 1024×1024 sekitar 1536 token. Teks dan gambar dalam satu permintaan dihitung sekali; jika menambahkan pertanyaan, yang bertambah hanya teks pertanyaan itu sendiri.
Cara pemanggilan resminya juga berbeda dari API chat pada umumnya: ID model adalah d1.2-ultra dan d1.2, alamatnya https://api.liquid.ai/decisions/v1/systemone, dan kunci API dibuat di konsol Liquid. Blog resmi menyebut input teks, gambar, dan audio; spesifikasi teknis di halaman Artificial Analysis menyebut teks dan gambar dengan konteks 66k. Angka jendela konteks ini hanya muncul di halaman papan peringkat, bukan spesifikasi yang diumumkan di blog Liquid.
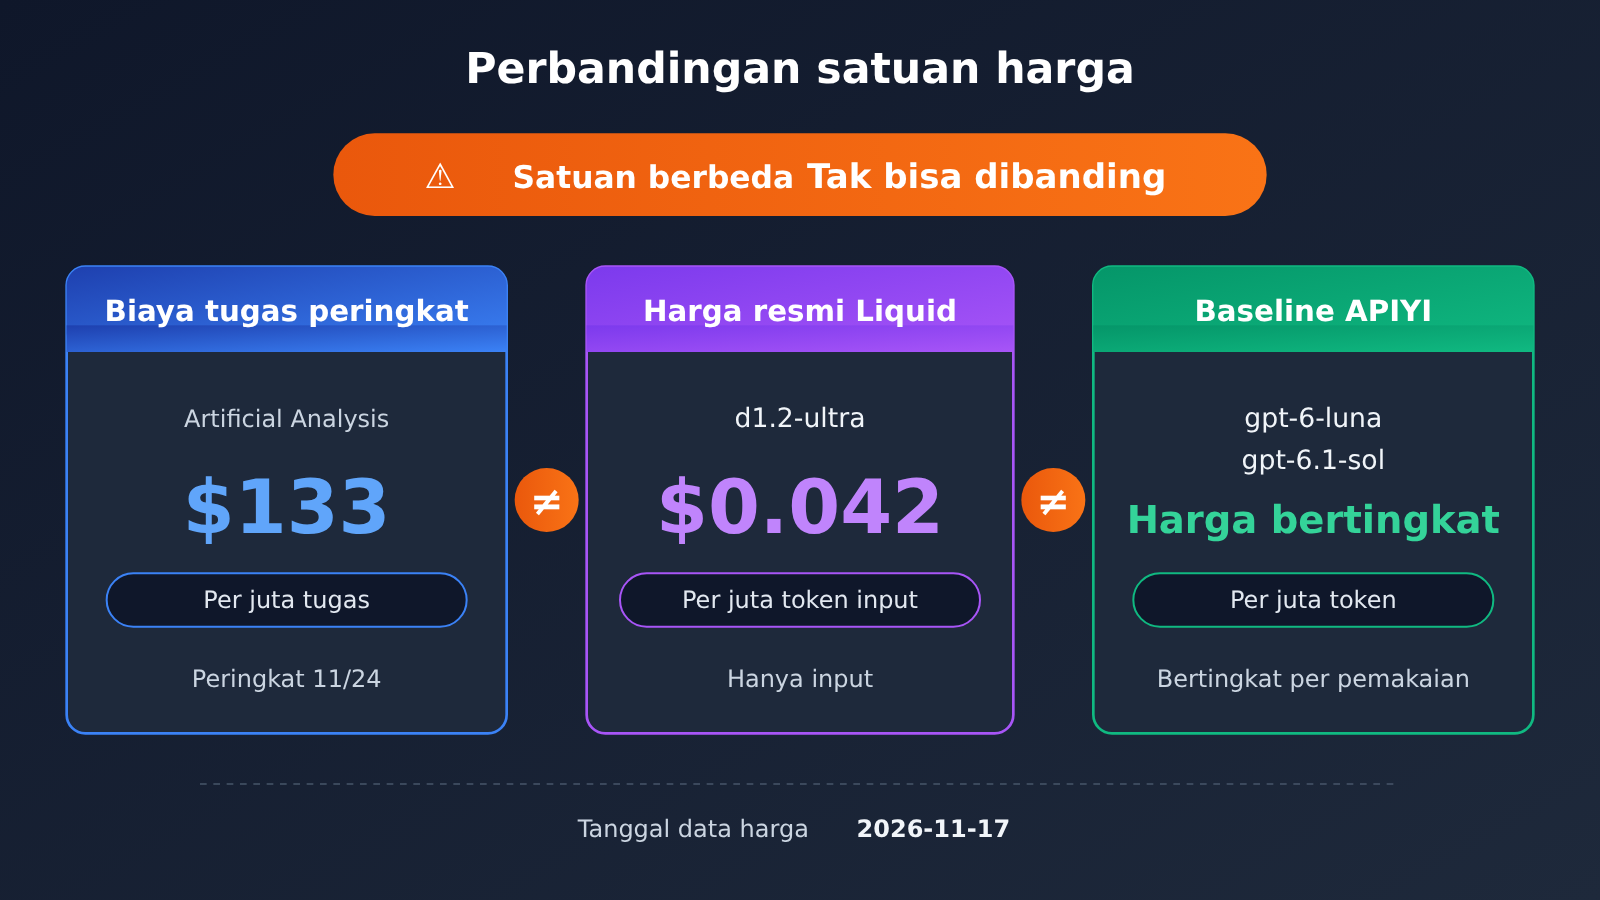
Model APIYI yang dipakai saat menjalankan baseline harganya sebagai berikut (satuan: dolar/per juta token, berdasarkan jumlah token per permintaan, data dari API daftar harga 2026-11-17, sesuai pembaruan tabel model utama 2026-11-16):
| Model | Tier | Input | Output | Baca cache | Endpoint |
|---|---|---|---|---|---|
gpt-6-luna |
≤ 272000 | 0.1 | 0.5 | 0.01 | responses diutamakan, tersedia juga chat |
gpt-6-luna |
≥ 272001 | 0.2 | 0.75 | tidak dicantumkan terpisah | sama seperti di atas |
gpt-6.1-sol |
≤ 272000 | 2 | 10 | 0.1 | responses diutamakan, tersedia juga chat |
gpt-6.1-sol |
≥ 272001 | 4 | 15 | tidak dicantumkan terpisah | sama seperti di atas |
💰 Tips biaya: Untuk perbandingan 50 sampel,
gpt-6-lunacocok untuk menjalankan volume lebih dulu, sedangkangpt-6.1-solcocok sebagai referensi kualitas tinggi. Isi ulang di APIYI apiyi.com dihitung 1:7, diskon grup bisa ditumpuk, dan tagihan aktual mengikuti konsol.
FAQ (Pertanyaan Umum)
Q1: Model apa d1.2-ultra?
Model ini adalah model keputusan yang dirilis oleh Liquid AI pada 2026-11-16, bersamaan dengan d1.2 yang lebih kecil. Ciri model keputusan adalah memberikan probabilitas untuk setiap opsi dan unggul dalam tugas-tugas yang bersifat “memilih”, seperti ekstraksi dokumen, penilaian pemanggilan tool, dan klasifikasi, bukan penulisan teks panjang.
Q2: d1.2-ultra peringkat pertama secara keseluruhan, apakah berarti paling kuat di semua aspek?
Tidak. Indeks gabungan 74.85 berada di peringkat 1/24, tetapi EvalSafe-O\*NET-AA berada di peringkat 3, tingkat lulus penuh AA-Symmetry di peringkat 5, akurasi mentah AA-Omniscience di peringkat 20, dan akurasi mentah HLE-MultiChoice adalah yang terendah di antara 24 model. Skor gabungan hanya menunjukkan keunggulan setelah pembobotan.
Q3: Apakah item HLE-MultiChoice terhitung sebagai peringkat terakhir dalam tes pengetahuan?
Tidak. Yang berada di peringkat terakhir adalah akurasi mentah HLE-MultiChoice sebesar 2.36%, yaitu akurasi mentah di antara 24 model keputusan; skor keputusannya 46.36 bukan yang paling bawah, dan AA menandai item ini sebagai penalaran, bukan pengetahuan.
Q4: Skenario apa yang paling cocok untuk d1.2-ultra?
Melihat halaman peringkat, yang paling cocok adalah ekstraksi field faktur, résumé, dan makalah (skor keputusan dan tingkat benar penuh AA-Paperclip sama-sama peringkat 1) serta penilaian pemanggilan tool (When2Call peringkat 1, tetapi selisih dengan beberapa peringkat teratas sekitar 1 poin). Untuk menjawab soal pilihan ganda yang sulit dan tanya jawab pengetahuan, akurasi mentahnya tidak unggul.
Q5: Apakah d1.2-ultra sekarang bisa dipanggil di APIYI?
Saat ini d1.2 dan d1.2-ultra tidak ada dalam daftar model APIYI. Belum tersedia, dan kami akan segera menghadirkan model ini; model dan harga mengacu pada daftar model platform. Sebaiknya Anda lebih dulu membuat baseline dari sampel Anda sendiri di APIYI apiyi.com menggunakan `gpt-6-luna` atau `gpt-6.1-sol`, lalu nanti cukup ganti model untuk membandingkan.
Q6: Apakah galat kalibrasi 0.8 yang diumumkan Liquid bisa langsung dipercaya?
Itu adalah pengujian yang dilakukan Liquid sendiri pada 13 benchmark dan 22505 soal, jadi merupakan laporan pihak resmi. Yang dapat diverifikasi silang dari halaman peringkat adalah Brier 0.150 sebagai yang terendah dari 24, arahnya konsisten, tetapi untuk bisnis Anda secara spesifik, tetap perlu melihat apakah “frekuensi menebak asal” pada sampel Anda sendiri benar-benar lebih sedikit.
Q7: Apakah 7.2 milik GPT-6 Luna dan gpt-6-luna di APIYI adalah hal yang sama?
Bukan hal yang sama. 7.2 adalah galat kalibrasi Decisions API milik GPT-6 Luna dalam pengujian Liquid, dan skor 60.25 di peringkat juga merupakan hasil antarmuka Decisions. `gpt-6-luna` yang disediakan APIYI adalah antarmuka chat, jadi performanya harus diuji dengan sampel Anda sendiri.
Q8: Berapa banyak sampel yang benar-benar cukup?
20 sampai 50 sampel sudah cukup untuk melihat perbedaan yang jelas; kuncinya adalah cakupan distribusi nyata: format umum, format jarang, dan sampel dengan field yang hilang semuanya harus ada. Jika dua model hanya berbeda dalam selisih satu atau dua sampel pada 50 sampel, berarti mengganti atau tidak sama saja; prioritaskan harga dan latensi.
Poin Penting Utama d1.2-ultra
- Skor komposit 75 hanyalah angka pembuka: 74.85 peringkat 1/24, unggul sekitar 2.2 poin dari peringkat kedua, bukan berarti unggul di setiap kategori.
- Untuk ekstraksi dokumen, lihat AA-Paperclip: skor keputusan 75.81 dan tingkat jawaban sepenuhnya benar 67.7%, keduanya peringkat 1.
- Untuk pemanggilan tool, lihat When2Call: 96.49 peringkat 1, tetapi beberapa peringkat teratas berdesakan dalam selisih sekitar 1 poin.
- Untuk soal sulit, lihat akurasi mentah: HLE-MultiChoice 2.36% terendah, skor keputusan tidak berada di posisi terbawah, AA menandainya sebagai penalaran.
- Untuk tanya jawab pengetahuan, lihat akurasi Omniscience: 23.6% peringkat 20/24, bukan peringkat terakhir.
- Jangan campur satuan: 133 dolar adalah per juta tugas, 0.042 dolar adalah per juta token input.
- Ambil keputusan dengan sampel: pertama, jalankan 20 hingga 50 item di APIYI apiyi.com menggunakan model yang tersedia, catat akurasi field dan jumlah tebakan asal-asalan.
Ringkasan
Saat membaca papan peringkat d1.2-ultra, ada tiga langkah kunci:
- Tuliskan jenis tugas: ekstraksi dokumen, pemanggilan tool, menjawab soal sulit, atau tanya jawab pengetahuan; lihat hanya subskor yang relevan.
- Bedakan dua angka: skor keputusan memberi insentif pada “jangan menebak kalau tidak yakin”; akurasi mentah mengukur “berapa banyak tebakan yang benar”. Pilih yang dilihat sesuai kebutuhan bisnis.
- Putuskan dengan sampel Anda sendiri: 20 hingga 50 data nyata berlabel lebih menjelaskan kondisi sebenarnya daripada skor komposit mana pun.
Jika pekerjaan Anda tepatnya ekstraksi dokumen, d1.2-ultra layak masuk daftar kandidat; jika soal penalaran sulit atau tanya jawab pengetahuan, jangan langsung beralih hanya karena peringkat pertama secara keseluruhan. Sebaiknya sekarang bangun baseline di APIYI apiyi.com dengan gpt-6-luna dan gpt-6.1-sol, lalu saat model target tersedia, bandingkan dengan sekali klik.
📚 Referensi
-
Blog Resmi Liquid AI – Rilis d1.2: informasi rilis, harga resmi, dan pengujian yang dilaporkan sendiri
- Tautan:
liquid.ai/blog/d1-2 - Keterangan: akurasi tugas baru dan error kalibrasi semuanya dilaporkan sendiri oleh pihak resmi
- Tautan:
-
Dokumentasi Model Keputusan Liquid AI: ID model dan alamat pemanggilan
- Tautan:
docs.liquid.ai/lfm/models/decision-models - Keterangan: penjelasan cara pemanggilan resmi
- Tautan:
-
Halaman Model d1.2-ultra Artificial Analysis: indeks keseluruhan dan masing-masing komponen
- Tautan:
artificialanalysis.ai/decision-models/d1-2-ultra - Keterangan: data peringkat dalam artikel ini dibaca pada 2026-11-17
- Tautan:
-
Halaman Metodologi Decision Index Artificial Analysis: bobot dan definisi skor
- Tautan:
artificialanalysis.ai/methodology/decision-index - Keterangan: perbedaan antara skor keputusan dan akurasi mentah
- Tautan:
-
Daftar Induk Model APIYI: model yang tersedia dan harga
- Tautan:
docs.apiyi.com/models - Keterangan: model dan harga mengacu pada daftar model platform
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Jika ada pertanyaan tentang pemilihan model atau skrip perbandingan, silakan hubungi kami melalui beranda situs resmi APIYI; untuk petunjuk integrasi lebih lanjut, lihat pusat dokumentasi


