
Catatan penulis: Aplikasi multi-model sebaiknya menangani perbedaan pemanggilan tool, status penalaran, output streaming, data terstruktur, dan cache melalui format pesan terpadu, lapisan adaptasi vendor, serta registri kapabilitas model.
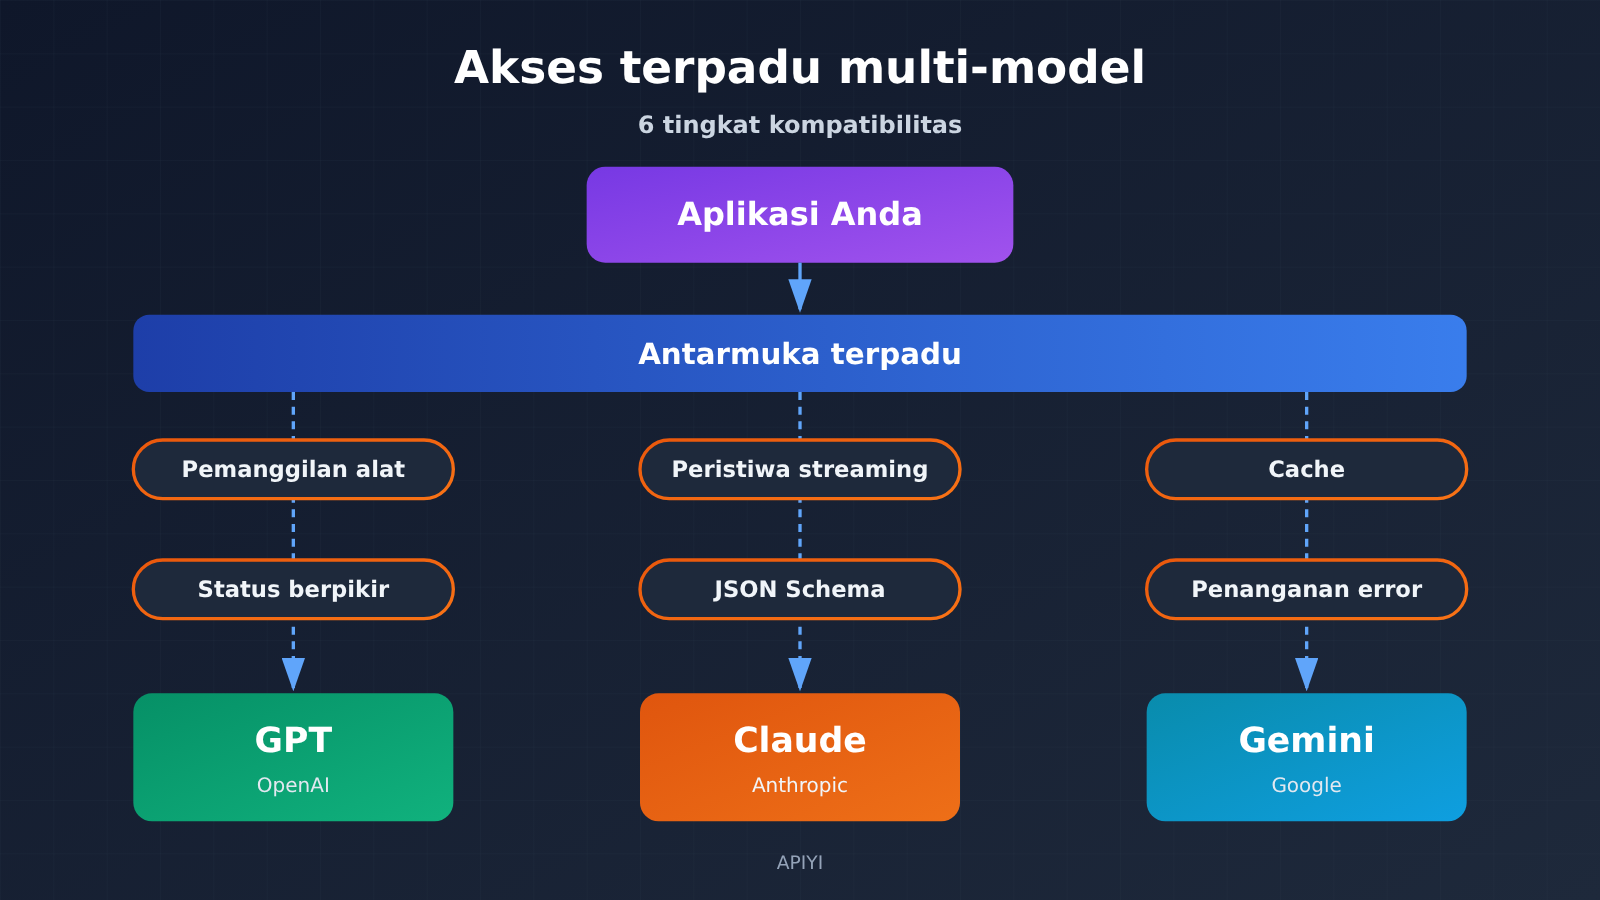
GPT, Claude, dan Gemini semuanya bisa melakukan pemanggilan teks biasa, dan Claude serta Gemini juga menyediakan pintu masuk kompatibel SDK OpenAI resmi. Saat beralih model, aplikasi tingkat produksi perlu menyelesaikan 6 jenis masalah kompatibilitas: peran pesan dan instruksi sistem, protokol pemanggilan tool, parameter penalaran dan status berpikir, event streaming, output terstruktur dan multimodal, penagihan cache serta penanganan error. Mengganti Model ID saja cukup untuk tanya jawab sederhana, tetapi pemanggilan tool multi-putaran, pemulihan aliran yang terputus, dan akuntansi biaya perlu ditangani secara terpisah. Rencana rekayasa yang cukup aman adalah “antarmuka bisnis terpadu + lapisan adaptasi vendor (Provider Adapter) + registri kapabilitas model”. Dengan begitu, pergantian model dapat dikelola sebagai fitur produk yang terpelihara.
Berikutnya, kita bandingkan dulu perbedaan struktur API native ketiga vendor, sekaligus menjelaskan skenario mana saja yang bisa dicakup oleh antarmuka kompatibel OpenAI. Setelah itu, kita bedah satu per satu kegagalan nyata yang muncul akibat 6 jenis masalah kompatibilitas, lalu berikan arsitektur integrasi enam lapis dan kode pemanggilan terpadu yang bisa dijalankan. Terakhir, kami daftarkan enam pengujian kompatibilitas sebelum peluncuran, dan jelaskan bagaimana pembagian kerja antara gateway API terpadu dan adaptasi kapabilitas native.
Perlu Diketahui: Glosarium Kompatibilitas API Multi-Model
| Istilah | Penjelasan |
|---|---|
| API | Antarmuka yang digunakan aplikasi untuk mengirim permintaan ke layanan model dan mengambil hasilnya. |
| SDK | Perangkat pengembangan perangkat lunak yang membungkus detail pemanggilan antarmuka. |
| API native | Antarmuka utama yang dirancang oleh penyedia sendiri, misalnya OpenAI Responses, Claude Messages, Gemini Interactions. |
| Antarmuka kompatibel | Entri adaptasi yang mengikuti format permintaan lain (biasanya format OpenAI), sehingga dapat dipanggil dengan SDK yang sama. |
| Pemanggilan fungsi (Function Calling) | Model meminta aplikasi menjalankan fungsi eksternal tertentu dengan parameter terstruktur. |
| ID pemanggilan | Penanda yang mencocokkan permintaan alat dari model dengan hasil eksekusi yang dikirim balik oleh aplikasi. |
| Tanda tangan pemikiran (Thought / Thinking Signature) | Data status terenkripsi yang digunakan sebagian model untuk menyimpan konteks penalaran dan pemanggilan alat, dan harus dikembalikan apa adanya. |
| Keluaran streaming (Streaming) | Server mengembalikan hasil secara bertahap sebagai peristiwa, sehingga frontend dapat menampilkan saat diterima. |
| JSON Schema | Spesifikasi yang mendeskripsikan struktur data JSON dan aturan validasinya. |
| Cache petunjuk (Prompt Caching) | Menggunakan kembali hasil komputasi untuk awalan input yang berulang, guna mengurangi latensi dan biaya. |
| TTL | Durasi cache tetap hidup; setelah kedaluwarsa, cache perlu ditulis ulang. |
| Adaptor penyedia (Provider Adapter) | Komponen yang mengubah permintaan terpadu menjadi format native suatu penyedia, lalu mengubah hasilnya kembali ke format terpadu. |
| Registri kemampuan | Daftar konfigurasi yang mencatat parameter dan fitur yang benar-benar didukung oleh setiap model dan setiap endpoint akses. |
| Idempoten | Operasi yang sama memberikan efek yang sama saat dijalankan sekali maupun berkali-kali, untuk mencegah penagihan ganda atau pengiriman pesan ganda akibat percobaan ulang. |
1 Kompatibilitas API Multi-Model: Mengapa Mengganti Model Tidak Cukup Hanya dengan Mengganti Model ID
Ketiga penyedia sama-sama bisa menentukan model lewat satu bidang model, tetapi cara menyusun isi permintaan, objek respons, dan status konteks masing-masing berbeda. Perbedaan pada tanya jawab biasa terpusat pada nama bidang, sehingga biaya adaptasinya relatif rendah. Aplikasi jenis Agent akan bergantung pada pemanggilan alat, status penalaran, dan peristiwa streaming, sehingga perbedaannya langsung berubah menjadi gangguan produksi.
1.1 Perbandingan API native GPT, Claude, dan Gemini
Tabel berikut hanya menjelaskan API native, tanpa melibatkan lapisan kompatibilitas atau endpoint gateway apa pun.
| Dimensi | OpenAI (native) | Claude (native) | Gemini (native) |
|---|---|---|---|
| Antarmuka utama | Responses API, /v1/responses |
Messages API, /v1/messages |
Interactions API (GA Juni 2026, direkomendasikan resmi untuk proyek baru); generateContent masih didukung |
| Penyusunan input | model + input |
model + messages + max_tokens, system terpisah dari array pesan |
Struktur Interactions native, plus aturan system_instruction |
| Struktur output | Butir output multi-tipe: teks, butir reasoning, function_call, dan lain-lain |
content blocks: text, thinking, tool_use, dan lain-lain |
steps: keluaran model, pemanggilan alat, penalaran, serta langkah lainnya |
| Penentuan akhir | Peristiwa selesai respons / tipe butir output | stop_reason (selesai normal, perlu menjalankan alat, dan lain-lain) |
Tipe langkah dan status interaksi |
| Kelanjutan konteks | previous_response_id |
Aplikasi mengirim ulang riwayat pesan lengkap sendiri | previous_interaction_id, opsional status sesi di sisi server |
| Alat bawaan | Alat platform + fungsi kustom | Didominasi alat kustom | Alat bawaan seperti Google Search, URL Context, eksekusi kode; alat pihak ketiga dijalankan oleh aplikasi |
Dari tabel di atas terlihat bahwa ketiganya terbagi menjadi dua jalur dalam hal “siapa yang menyimpan konteks”. OpenAI dan Gemini mendukung kelanjutan konteks di sisi server, sedangkan Claude Messages mengharuskan aplikasi mengirim ulang riwayat sendiri. Jika penyimpanan sesi aplikasi hanya dirancang untuk salah satu cara, maka saat beralih ke penyedia lain akan muncul konteks yang hilang atau pengiriman berulang.
1.2 Seberapa banyak masalah yang bisa diselesaikan antarmuka kompatibel OpenAI
Claude dan Gemini sama-sama menyediakan pintu masuk yang kompatibel dengan OpenAI SDK. Endpoint kompatibel resmi Gemini adalah generativelanguage.googleapis.com/v1beta/openai/; saat menggunakan klien OpenAI, cukup ubah base_url, kunci API, dan model. Dokumentasi kompatibilitas Claude justru menetapkan cakupan dukungan secara tegas; batasan yang diketahui per 2026-11-13 adalah sebagai berikut:
- Parameter
strictdalam definisi alat akan diabaikan, sehingga batasan ketat pada parameter alat menjadi tidak berlaku. - Prompt Caching tidak didukung.
- Input bertipe audio dan file tidak didukung.
- Pesan
systemdandeveloperakan diangkat ke paling depan lalu digabungkan. - Bidang terkait
thinkingmemiliki perbedaan dengan API native.
Antarmuka kompatibel cocok untuk tiga jenis skenario: obrolan biasa, pembuatan satu putaran, serta perbandingan cepat kualitas jawaban antar model. Migrasi Agent yang kompleks melibatkan parameter alat yang ketat, caching, input file, dan status penalaran multi-putaran; kemampuan tersebut perlu kembali ke API native, atau diverifikasi satu per satu sebelum dirilis. Patokan praktisnya adalah: jika fitur yang diandalkan aplikasi hanya muncul di dokumentasi native, catat fitur itu ke dalam registri kemampuan dan serahkan penanganannya kepada adaptor khusus.
2 Enam jenis masalah kompatibilitas yang paling sering ditemui saat beralih antara model GPT, Claude, dan Gemini
2.1 Penanganan kompatibilitas peran pesan dan instruksi sistem
OpenAI membedakan peran seperti developer dan system. Instruksi system milik Claude berada di luar array pesan. Gemini menggunakan system_instruction, dan konten pengguna serta konten model juga memiliki aturan strukturnya sendiri. Ketiganya sama-sama menyatakan “prioritas instruksi + riwayat multi-putaran”, tetapi posisi field yang menampungnya berbeda-beda.
Masalah umum muncul dari penggabungan yang asal-asalan: menyatukan instruksi sistem, riwayat pesan, dan hasil alat menjadi satu blok string panjang, lalu memberikannya ke model sebagai input pengguna. Cara ini memang bisa berjalan, tetapi prioritas instruksi jadi melemah, dan model bisa menganggap output alat dalam riwayat sebagai permintaan baru dari pengguna. Pendekatan yang benar adalah mempertahankan semantik peran di dalam aplikasi, lalu membiarkan adapter memetakannya ke field masing-masing penyedia. Selain itu, perlu diingat bahwa lapisan kompatibilitas Claude akan menggabungkan system dan developer; desain petunjuk yang bergantung pada pemisahan keduanya perlu diuji secara nyata.
2.2 Protokol Pemanggilan Alat dan Penanganan Kompatibilitas ID Pemanggilan
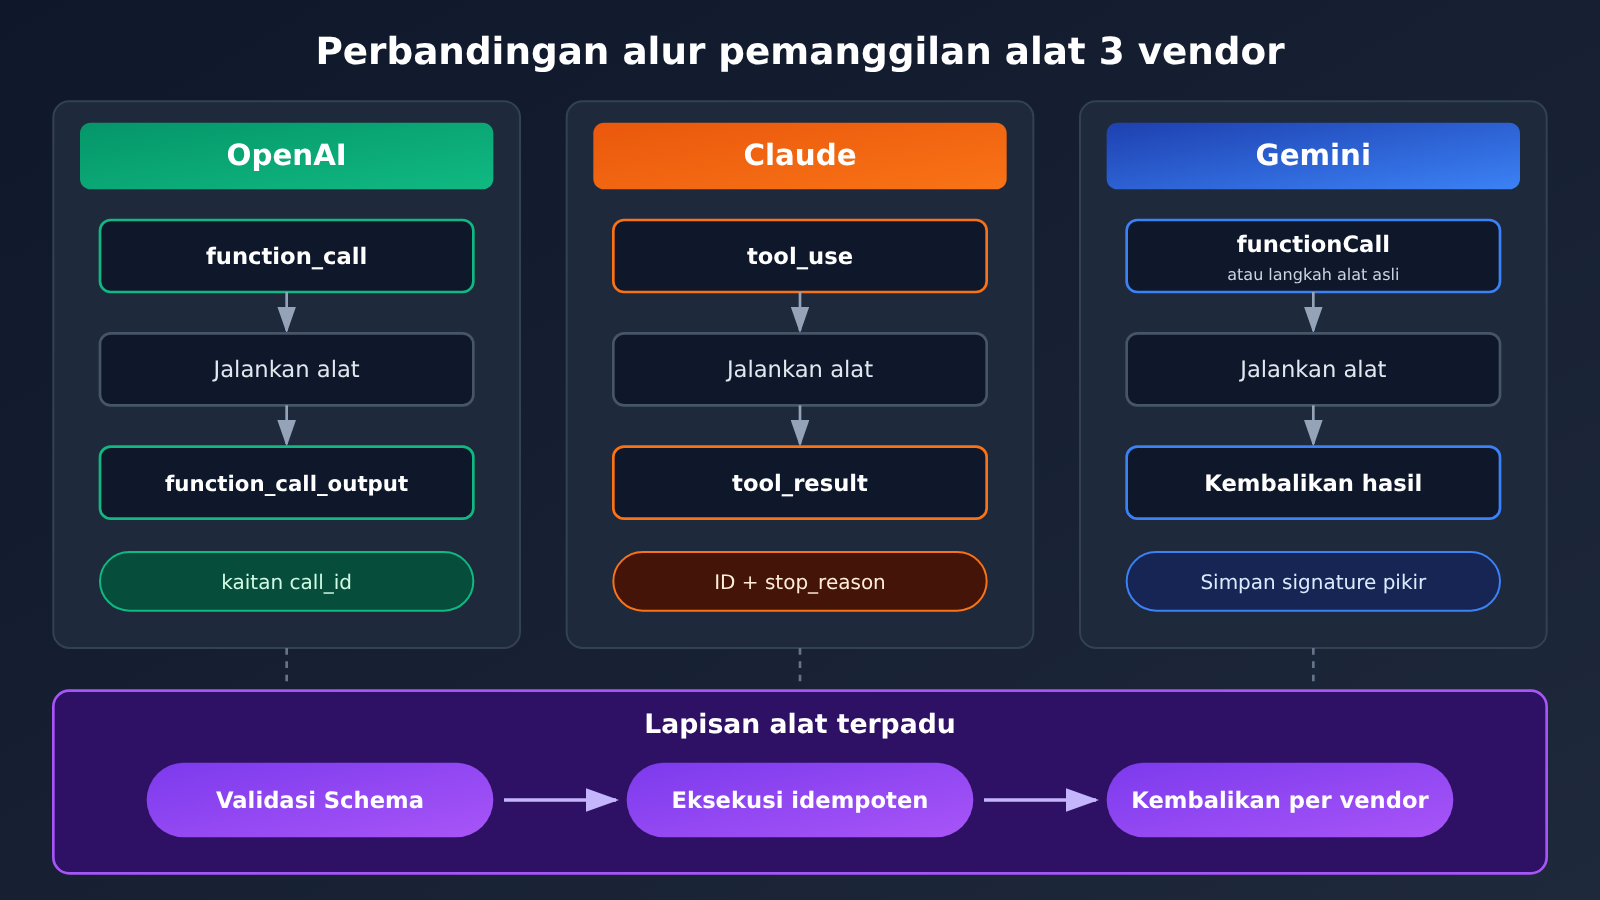
Ketiganya mendukung Function Calling, adapun bentuk alur pemanggilannya sebagai berikut:
| Tahap | OpenAI | Claude | Gemini |
|---|---|---|---|
| Model memulai pemanggilan | Item keluaran function_call |
Blok konten tool_use |
functionCall / langkah alat bawaan |
| Penanda terkait | call_id |
ID pada tool_use |
Penanda pemanggilan terkait |
| Aplikasi mengembalikan | function_call_output |
Blok konten tool_result |
Struktur pengembalian hasil terkait |
| Perlu lanjut atau tidak | Ditentukan berdasarkan item keluaran | stop_reason menunjukkan perlunya menjalankan alat |
Ditentukan berdasarkan status langkah |
| Status penalaran | Item reasoning mungkin perlu diteruskan bersama riwayat | Blok thinking mungkin perlu dikembalikan apa adanya | Mode stateless perlu menyimpan blok thought dan signature |
Lapisan alat perlu menyimpan enam informasi secara lengkap: ID pemanggilan, nama fungsi, parameter JSON, hubungan pemanggilan paralel, hasil eksekusi, serta apakah model meminta untuk melanjutkan penalaran. Pemanggilan paralel adalah bagian yang paling rawan kesalahan. Ketika model memulai beberapa permintaan alat sekaligus, aplikasi hanya mengembalikan salah satu hasilnya, atau hasil dan ID-nya tertukar, maka permintaan putaran berikutnya akan melaporkan kesalahan parameter, atau model melanjutkan jawaban berdasarkan data yang salah.
Disarankan agar lapisan alat yang terpadu terlebih dahulu memvalidasi parameter menggunakan JSON Schema, lalu setelah validasi lolos baru menjalankan operasi eksternal yang sebenarnya. Parameter yang dihasilkan model tidak selalu valid, validasi di awal dapat menahan kesalahan sebelum “memanggil sistem eksternal”.
2.3 Penanganan kompatibilitas mode berpikir dan status konteks
Nama dan makna parameter penalaran tidak setara di antara ketiga penyedia:
- OpenAI: Menggunakan parameter seperti
reasoning.effort. GPT-6 Astra dan GPT-6.1 Sol tidak menerimareasoning.effort=none, dan pemanggilan tool pada kedua model ini juga mengharuskan penggunaan Responses API. - Claude: Model generasi baru terutama mengadopsi Adaptive Thinking, dipadukan dengan konfigurasi berpikir seperti effort. Sebagian model baru sudah tidak lagi mendukung mode berpikir manual dengan
budget_tokenstetap seperti model lama. - Gemini: Berbagai model menggunakan thinking level atau budget; apakah penalaran bisa dimatikan dan tingkat apa saja yang tersedia berbeda-beda tergantung model. Aturan pemetaan parameter antara API native dan endpoint kompatibel OpenAI juga berbeda.
Ketika merancang tiga tingkat intensitas penalaran “cepat, standar, mendalam” pada antarmuka produk, nama tingkat tersebut mengungkapkan maksud produk. Adaptor perlu mengonversinya menjadi parameter yang benar-benar didukung setiap model, dan sumber daya komputasi yang diperoleh ketiga penyedia pada tingkat yang sama juga tidak identik. Selain itu, ringkasan berpikir yang dilihat pengguna mungkin tidak cocok dengan jumlah Token berpikir yang sebenarnya ditagih; statistik biaya harus berpedoman pada field penggunaan yang dikembalikan oleh antarmuka.
Status terenkripsi dalam pemanggilan tool multi-putaran adalah masalah yang paling mudah diabaikan pada Agent jarak jauh:
- Item reasoning dan pemanggilan tool pada OpenAI Responses mungkin perlu diteruskan seiring riwayat berlanjut.
- Blok
thinking/redacted_thinkingmilik Claude mungkin berisi status terenkripsi; struktur asli harus dipertahankan saat dikirim balik setelah eksekusi tool. - Mode stateless pada Gemini Interactions mengharuskan blok thought dan signature dipertahankan apa adanya; saat menggunakan mode stateful, sebagian status dapat dipelihara oleh sisi server.
Hanya menyimpan teks yang ditampilkan di jendela obrolan tidak cukup untuk memulihkan riwayat penalaran model secara utuh. Kegagalan tipikalnya adalah: Agent tiba-tiba melaporkan error setelah pemanggilan tool putaran ketiga, atau mulai mengulangi langkah yang sudah selesai. Penyebabnya biasanya karena salah satu putaran di tengah kehilangan blok signature.
2.4 Penyatuan Event Streaming
Ketiga penyedia memiliki tipe event streaming, urutan, dan sinyal akhir yang berbeda-beda. OpenAI Responses dapat mengeluarkan response.output_text.delta, increment pemanggilan tool, serta event penyelesaian response. Stream Claude Messages menggunakan event seperti message_start, content_block_delta, message_delta. API native Gemini menggunakan struktur output dan langkahnya sendiri.
Jika frontend langsung mem-parsing event mentah dari vendor, setiap kali menambahkan model, kode frontend harus diubah lagi. Sebaiknya backend mengonversinya secara terpadu ke protokol event internal:
| Event internal | Arti | Poin penanganan |
|---|---|---|
text_delta |
Delta teks | Langsung tambahkan ke tampilan |
reasoning_summary |
Ringkasan penalaran | Dapat ditampilkan dalam bagian yang bisa dilipat; penagihan mengacu pada usage |
tool_call_start |
Awal pemanggilan tool | Catat ID pemanggilan dan nama fungsi |
tool_call_args |
Potongan parameter | Gabungkan berdasarkan ID pemanggilan atau indeks; parsing hanya boleh dilakukan setelah semua bagian terkumpul |
tool_result |
Hasil eksekusi tool | Berkorespondensi satu-satu dengan ID pemanggilan |
usage |
Statistik penggunaan | Bedakan Token input, cache, penalaran, dan output |
completed |
Selesai normal | Harus menerima sinyal akhir yang jelas |
error |
Error atau aliran terputus | Bedakan yang dapat di-retry dan yang tidak |
Pemrosesan streaming memiliki tiga titik kegagalan yang sering terjadi. Pertama, potongan parameter dari beberapa pemanggilan tool datang secara bergantian; jika digabungkan berdasarkan urutan kedatangan, ID bisa tertukar. Kedua, parameter JSON dipotong di posisi karakter sembarang; jika langsung di-parsing saat baru diterima sebagian, akan muncul exception. Ketiga, koneksi terputus di tengah jalan tetapi event penyelesaian tidak pernah diterima, sehingga antarmuka terus berada di status “sedang membuat”. Lapisan konversi perlu menangani ketiga kasus ini secara eksplisit.
2.5 Perbedaan Output Terstruktur JSON Schema dan Kemampuan Multimodal
Ketiga penyedia menawarkan kemampuan output terstruktur, tetapi ada perbedaan pada fitur JSON Schema yang didukung, mode ketat, serta cara menggabungkannya dengan pemanggilan alat. Claude secara resmi membedakan dua mekanisme: JSON outputs membatasi struktur jawaban akhir, sedangkan Strict tool use membatasi struktur parameter pemanggilan alat. Sebagian model, saat menggunakan format ketat, juga menimbulkan biaya tambahan untuk kompilasi atau cache Schema.
Saran dari sisi rekayasa: aplikasi sebaiknya memelihara satu JSON Schema standar miliknya sendiri, dan mencatat di registri kemampuan fitur Schema mana yang didukung oleh setiap model. Untuk fitur yang tidak didukung, adaptor melakukan konversi degradasi. Seberapa ketat pun klaim model, sisi aplikasi tetap harus melakukan validasi sekali lagi; jika validasi gagal, masuk ke alur percobaan ulang atau pelaporan error yang terkendali.
Hal yang sama berlaku untuk multimodal. “Mendukung input gambar” hanya menjelaskan kategori kemampuannya; secara spesifik masih perlu membandingkan beberapa hal berikut: jenis file, ukuran, dan jumlah gambar yang dapat diterima, kemampuan video dan audio, cara unggah file, batas jendela konteks panjang dan rentang yang benar-benar dapat digunakan, Token output maksimum, serta apakah pemanggilan alat dapat digabungkan dengan input multimodal. Lapisan kompatibilitas Claude yang tidak mendukung input audio dan file adalah salah satu batasan spesifik yang perlu dicatat di registri.
2.6 Perbedaan antar-model dalam cache, penagihan, dan penanganan error
Mekanisme cache petunjuk di ketiga penyedia ini jelas berbeda:
- OpenAI: GPT-5.6 dan model sesudahnya mendukung cache implisit serta breakpoint cache eksplisit, dengan TTL dua pilihan: 30 menit dan 12 jam.
- Claude: Cache otomatis atau eksplisit ditentukan lewat
cache_control, dengan mode 5 menit dan 1 jam; kemampuan ini tidak didukung di lapisan kompatibel OpenAI-nya. - Gemini: Model baru menyediakan cache implisit otomatis, dan sebagian API serta model mendukung pembuatan objek cache secara eksplisit.
Setelah berpindah model, cache milik penyedia asal biasanya tidak bisa dipakai ulang. Kalau di tengah sesi Anda beralih dari Claude ke Gemini, permintaan putaran pertama akan ditagih berdasarkan input lengkap. Bila estimasi biaya mengasumsikan “cache selalu hit”, semakin sering strategi pergantian model dilakukan, semakin besar selisih tagihannya.
Harga standar tiap penyedia juga berbeda cukup jauh. Berikut harga resmi per 2026-11-13 (USD / juta Token):
| Model | Input | Output | Catatan |
|---|---|---|---|
| GPT-6 Astra | $10 | $50 | Pemanggilan tool harus memakai Responses API |
| GPT-6.1 Sol | $1 | $5 | Pemanggilan tool harus memakai Responses API |
| Claude Sonnet 5.5 | $2 | $10 | — |
| Gemini 3.8 Flash | $0.75 | $3.75 | Harga promo berlaku hingga 2026-12-31; mulai 2027-01-01 direncanakan menjadi $1.50 / $7.50 |
Tabel ini hanya untuk menggambarkan perbedaan penagihan; kemampuan dan syarat pemakaian tiap model tidak sama, jadi tinggi-rendahnya harga tidak bisa langsung dijadikan perbandingan performa. Tabel ini juga belum mencakup biaya penulisan cache, pemanggilan tool, tier layanan, dan markup pihak ketiga.
💰 Saran penghitungan biaya: Tagihan aplikasi multi-model perlu dicatat per komponen: “input biasa, penulisan cache, cache hit, thinking dan output, biaya tool, tambahan konteks panjang”. Kalau Anda memanggil beberapa model secara terpadu lewat APIYI apiyi.com, pemakaian tiap model bisa dilihat di satu tempat, sehingga strategi routing mudah dicocokkan dengan biaya aktual.
Soal penanganan error, laju permintaan, laju Token, kuota, timeout, dan format error ketiga penyedia juga berbeda. Aplikasi sebaiknya membangun klasifikasi error yang seragam: kegagalan autentikasi, model tidak didukung, parameter tidak valid, permintaan terlalu besar atau melewati batas konteks, pembatasan laju 429, error sisi server, koneksi jaringan terputus, aliran respons terputus, dan kegagalan pemanggilan tool.
Fallback model juga perlu mempertimbangkan apakah tugasnya punya efek samping. Kalau model utama timeout setelah tool dieksekusi, lalu sistem otomatis beralih ke model cadangan dan menjalankan ulang seluruh tugas, operasi seperti pembayaran, pengiriman email, atau pengubahan file bisa terjadi dua kali. Solusinya: tambahkan kunci idempoten pada tool yang punya efek samping, dan saat fallback lanjutkan hanya dari “langkah yang belum dieksekusi”.
3 Bagaimana seharusnya arsitektur kompatibilitas API multi-model dirancang
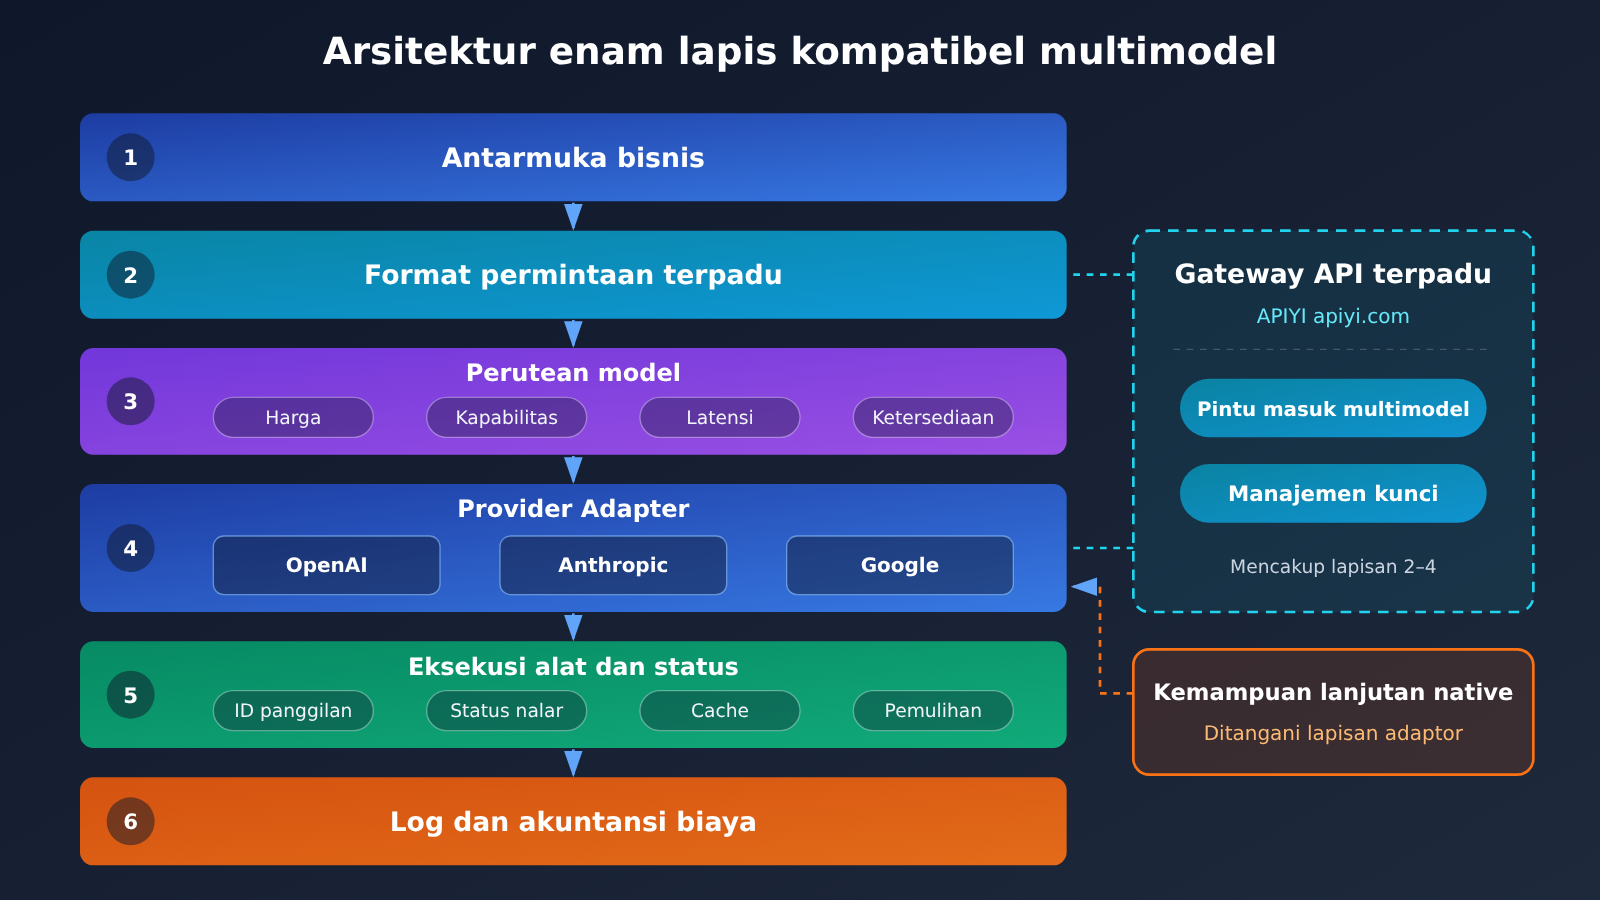
Struktur enam lapisan yang direkomendasikan adalah sebagai berikut:
- Antarmuka bisnis: pengguna mengajukan pertanyaan, mengunggah materi, memilih model dan tugas.
- Format permintaan terpadu: gunakan struktur terpadu untuk merepresentasikan riwayat pesan, lampiran, daftar alat, persyaratan output terstruktur, intensitas penalaran, dan ID tugas.
- Perutean model: pilih GPT, Claude, atau Gemini berdasarkan harga, kemampuan, latensi, ketersediaan, dan aturan bisnis.
- Provider Adapter: mengubah permintaan standar menjadi format native masing-masing vendor, lalu memetakan hasil yang dikembalikan ke format internal.
- Eksekusi alat dan manajemen status: mengelola ID panggilan, catatan eksekusi, konteks percakapan, status penalaran vendor, cache, dan pemulihan kegagalan.
- Log dan akuntansi biaya: mencatat model, Token, biaya aktual, latensi, cache, kesalahan, dan panggilan alat untuk setiap permintaan.
3.1 Membangun Format Pesan dan Alat yang Terpadu
Prinsip inti dari format terpadu adalah menyimpan riwayat dalam dua lapisan. Lapisan pertama adalah riwayat standar yang bersifat universal, mencakup pesan pengguna, jawaban akhir model, permintaan alat, dan hasil alat — semuanya dapat dipahami oleh vendor mana pun. Lapisan kedua adalah status khusus vendor, misalnya item reasoning, tanda tangan thinking, dan blok thought, yang disimpan secara terpisah per vendor dan hanya dikirim kembali apa adanya saat meminta ke vendor yang sama.
from dataclasses import dataclass, field
from typing import Any, Literal

@dataclass
class ToolCall:
    call_id: str              # ID panggilan terpadu, adapter bertanggung jawab memetakan timbal balik dengan ID vendor
    name: str
    arguments: dict[str, Any]
    result: Any = None
    idempotency_key: str = "" # alat dengan efek samping wajib mengisi ini

@dataclass
class Message:
    role: Literal["system", "developer", "user", "assistant", "tool"]
    content: list[dict]                      # blok multimodal seperti teks, gambar, dll.
    tool_calls: list[ToolCall] = field(default_factory=list)
    # status khusus vendor: kuncinya nama vendor, nilainya tanda tangan / blok reasoning yang disimpan apa adanya
    vendor_state: dict[str, Any] = field(default_factory=dict)
Saat beralih model, adapter membaca field standar untuk menghasilkan permintaan baru. Bagian vendor_state yang milik vendor lain tidak dikirim, sedangkan bagian yang milik vendor tujuan dikirim kembali apa adanya.
3.2 Mengadaptasi API native melalui Provider Adapter
Setiap adapter memikul tiga tanggung jawab:
- Transformasi input: pemetaan peran (misalnya memindahkan system ke field terpisah milik Claude), transformasi definisi tool, penurunan Schema, pemetaan tingkat reasoning.
- Transformasi output: mengubah respons native dan event streaming menjadi event internal pada bagian 2.4, memetakan ID pemanggilan tool menjadi ID terpadu.
- Penanganan state: mengekstrak dan menyimpan state vendor seperti signature dan item reasoning, lalu memutuskan apakah menggunakan kelanjutan sisi server (
previous_response_id,previous_interaction_id) atau mengirim ulang seluruh riwayat.
Untuk tanya jawab biasa, Anda bisa memakai adapter publik berformat kompatibel OpenAI. Untuk skenario yang menuntut parameter tool ketat, kontrol cache, atau state pemikiran terenkripsi, barulah implementasikan adapter native secara terpisah. Dengan begitu, kemudahan pintu masuk yang terpadu tetap terjaga, sekaligus memberi kemampuan lanjutan tempat berpijak yang jelas.
3.3 Menentukan fitur yang tersedia lewat capability registry
Capability registry mencatat dukungan aktual per unit “model + endpoint”, sehingga model yang sama lewat API native dan lewat lapisan kompatibilitas bisa jadi punya dua catatan berbeda. Berikut contoh strukturnya; nilai konkretnya harus mengikuti dokumentasi resmi dan hasil pengujian Anda sendiri:
gpt-6.1-sol@responses:
  tools: true
  tool_api: responses          # Pemanggilan tool mewajibkan Responses API
  reasoning_effort: [low, medium, high]   # Tidak menerima none
  vendor_state: reasoning_items
claude-sonnet@openai-compat:
  tools: true
  strict_tools: false          # Lapisan kompatibilitas mengabaikan strict
  prompt_caching: false
  file_input: false
  merges_system_developer: true
gemini-flash@interactions:
  tools: true
  builtin_tools: [google_search, url_context, code_execution]
  vendor_state: thought_signatures
Lapisan routing menanyakan registry sebelum memilih model. Jika request membawa file, entri dengan file_input: false dikesampingkan; jika butuh parameter tool ketat, hanya entri dengan strict_tools: true yang dipilih. Antarmuka produk juga bisa memanfaatkannya untuk menyembunyikan opsi yang tidak didukung model saat ini, sehingga mengurangi error yang dipicu pengguna.
4 Pengujian dan observasi sebelum peluncuran kompatibilitas API multi-model
4.1 Enam pengujian kompatibilitas: dari tanya jawab sederhana hingga rantai alat multi-putaran
Urutkan dari yang paling sederhana ke yang paling kompleks, lalu selesaikan enam pengujian berikut satu per satu:
- Tanya jawab biasa: kirim petunjuk yang sama ke tiga model, lalu periksa apakah isi jawaban dan statistik Token sudah normal.
- Output streaming: pastikan output terus berdatangan dan sinyal akhir diterima dengan benar.
- Pemanggilan alat: model memanggil alat kueri cuaca atau kueri data, aplikasi mengeksekusinya lalu mengirimkan kembali hasilnya.
- Perulangan multi-alat: panggil alat lebih dari dua putaran berturut-turut, lalu pastikan riwayat dan ID pemanggilan tetap utuh.
- JSON terstruktur: hasilkan output sesuai Schema yang sama, lalu verifikasi strukturnya dengan validator di sisi aplikasi.
- Perpindahan model: sesi bisnis yang sama berpindah antara GPT, Claude, dan Gemini; pastikan konteks, rekaman alat, dan jawaban akhir semuanya normal.
Item 4 dan 6 paling banyak mengungkap masalah status penalaran, jadi sebaiknya dimasukkan ke dalam alur integrasi berkelanjutan. Setiap kali versi model dinaikkan atau endpoint akses diganti, jalankan ulang seluruh pengujian.
4.2 Membangun observasi biaya dan stabilitas yang terpadu
Setiap permintaan minimal harus mencatat field berikut: model dan endpoint, tingkat keberhasilan permintaan, jenis anomali (sesuai klasifikasi di bagian 2.6), latensi token pertama dan total durasi tugas, Token per komponen (input, penulisan cache, cache hit, penalaran/thinking, output), jumlah pemanggilan alat dan jumlah kegagalannya, serta jumlah percobaan ulang dan fallback.
Saat mengevaluasi model, lihatlah total durasi dan total biaya untuk tugas secara keseluruhan; data dari satu permintaan saja nilai rujukannya terbatas. Model dengan harga satuan murah bisa jadi justru lebih mahal secara keseluruhan jika tingkat kesalahan parameter alatnya tinggi sehingga butuh banyak putaran percobaan ulang.
5 Peran gateway API terpadu dalam kompatibilitas API multi-model
5.1 Biaya integrasi dan pemeliharaan
Menggunakan tiga model sekaligus berarti tiga set akun, tiga set kunci, tiga set penagihan, dan tiga set konfigurasi SDK. Gateway API terpadu menyatukan semua pekerjaan ini ke dalam satu pintu masuk: pengelolaan akses model dan kredensial secara terpusat, mengurangi pemeliharaan konfigurasi di tiap penyedia, mendukung pemilihan dan pergantian model di lapisan konfigurasi, serta memantau penggunaan dan biaya secara terpadu. Bagi tim yang perlu sering membandingkan performa model, ambang untuk mencoba model baru pun ikut turun.
5.2 Posisi APIYI: pembagian tugas antara pintu masuk terpadu dan adaptasi kemampuan native
APIYI adalah platform agregasi API Model Bahasa Besar AI. Dengan satu kunci API, Anda dapat memanggil model-model populer seperti OpenAI, Claude, dan Gemini melalui antarmuka yang kompatibel dengan OpenAI, dengan penagihan sesuai pemakaian. Platform ini cocok mengemban lapisan “pintu masuk pemanggilan terpadu” dalam arsitektur: tanya jawab biasa, output streaming, perbandingan model, dan routing multi-model bisa langsung terhubung.
Pintu masuk pemanggilan terpadu yang sepenuhnya identik dengan kemampuan native vendor merupakan dua kebutuhan teknis yang berbeda. Saat mengintegrasikan model tertentu, tetap perlu memverifikasi satu per satu di registri kemampuan cakupan dukungan pemanggilan tool, status berpikir, multimodal, caching, dan output terstruktur. Untuk rantai yang bergantung pada kemampuan native seperti Responses API, cache_control, dan tanda tangan terenkripsi, pastikan endpoint terkait benar-benar tersedia sebelum diluncurkan, atau sediakan adapter native khusus untuknya.
Mulai Cepat Kompatibilitas API Multi-Model
Contoh Minimal: Membandingkan Tiga Model dengan Petunjuk yang Sama
Kode berikut memakai klien OpenAI SDK yang sama untuk memanggil tiga model secara berurutan, sesuai dengan pengujian item ke-1 pada bagian 4.1.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI
)

# ID model mengikuti daftar model di platform
MODELS = ["你的GPT模型ID", "你的Claude模型ID", "你的Gemini模型ID"]

for model in MODELS:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "用一句话解释什么是幂等"}],
    )
    print(model, "→", resp.choices[0].message.content)
    print("usage:", resp.usage)
Lihat implementasi lengkap: event streaming terpadu + registri kapabilitas + validasi alat
import json
import openai
from openai import OpenAI
from jsonschema import validate, ValidationError

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI
)

# Registri kapabilitas: nilai hanya contoh struktur, harap pelihara sesuai dokumentasi resmi dan hasil pengujian
CAPABILITIES = {
    "gpt":    {"model": "你的GPT模型ID",    "tools_via": "responses"},  # Pemanggilan alat harus melalui adaptor Responses
    "claude": {"model": "你的Claude模型ID", "tools_via": "chat"},
    "gemini": {"model": "你的Gemini模型ID", "tools_via": "chat"},
}

def classify_error(e: Exception) -> str:
    """Klasifikasi error terpadu, menentukan apakah dapat dicoba ulang"""
    if isinstance(e, openai.AuthenticationError):
        return "auth_failed"
    if isinstance(e, openai.NotFoundError):
        return "model_not_supported"
    if isinstance(e, openai.RateLimitError):
        return "rate_limited"          # Dapat dicoba ulang dengan backoff
    if isinstance(e, openai.BadRequestError):
        return "invalid_request"       # Kesalahan parameter atau melebihi konteks, jangan coba ulang secara buta
    if isinstance(e, openai.APIConnectionError):
        return "network_error"
    if isinstance(e, openai.InternalServerError):
        return "server_error"
    return "unknown"

def stream_chat(provider: str, messages: list, tools: list | None = None):
    """Mengubah stream berformat kompatibel OpenAI menjadi event internal yang terpadu"""
    cap = CAPABILITIES[provider]
    if tools and cap["tools_via"] != "chat":
        raise NotImplementedError(f"{provider} 的工具调用请交给原生适配器处理")

    kwargs = {
        "model": cap["model"],
        "messages": messages,
        "stream": True,
        "stream_options": {"include_usage": True},
    }
    if tools:
        kwargs["tools"] = tools

    calls: dict[int, dict] = {}   # Gabungkan fragmen argumen pemanggilan alat paralel berdasarkan index
    finished = False
    try:
        for chunk in client.chat.completions.create(**kwargs):
            if not chunk.choices:
                if chunk.usage:
                    yield {"type": "usage", "data": chunk.usage.model_dump()}
                continue
            choice = chunk.choices[0]
            delta = choice.delta
            if delta.content:
                yield {"type": "text_delta", "data": delta.content}
            for tc in delta.tool_calls or []:
                slot = calls.setdefault(tc.index, {"id": None, "name": "", "args": ""})
                if tc.id:
                    slot["id"] = tc.id
                if tc.function and tc.function.name:
                    slot["name"] = tc.function.name
                    yield {"type": "tool_call_start", "data": {"id": slot["id"], "name": slot["name"]}}
                if tc.function and tc.function.arguments:
                    slot["args"] += tc.function.arguments
                    yield {"type": "tool_call_args", "data": {"index": tc.index}}
            if choice.finish_reason:
                finished = True
                yield {"type": "completed", "data": {
                    "finish_reason": choice.finish_reason,
                    "tool_calls": list(calls.values()),
                }}
    except Exception as e:
        yield {"type": "error", "data": classify_error(e)}
        return
    if not finished:
        yield {"type": "error", "data": "stream_interrupted"}  # Stream terputus di tengah jalan

EXECUTED_KEYS: set[str] = set()   # Di lingkungan produksi, ganti dengan penyimpanan persisten

def run_tool(call: dict, schema: dict, func, idempotency_key: str | None = None):
    """Validasi argumen terlebih dahulu, lalu eksekusi secara idempoten"""
    try:
        args = json.loads(call["args"])   # Parse hanya setelah semua fragmen terkumpul
        validate(instance=args, schema=schema)
    except (json.JSONDecodeError, ValidationError) as e:
        return {"error": f"invalid_arguments: {e}"}
    if idempotency_key:
        if idempotency_key in EXECUTED_KEYS:
            return {"skipped": "already_executed"}
        EXECUTED_KEYS.add(idempotency_key)
    return func(**args)

# Contoh penggunaan
for event in stream_chat("claude", [{"role": "user", "content": "介绍一下流式输出"}]):
    print(event)
🚀 Mulai cepat: Daftar melalui APIYI apiyi.com untuk mendapatkan kuota uji gratis, lalu gunakan kode di atas dengan kunci yang sama untuk menyelesaikan dua pengujian pertama di bagian 4.1. Untuk pengujian terkait pemanggilan alat dan penalaran multi-putaran, verifikasi setiap model satu per satu dengan merujuk pada registri kapabilitas.
Pertanyaan Umum (FAQ)
Q1:Apa yang dimaksud dengan masalah kompatibilitas API multi-model?
Yaitu perbedaan yang harus ditangani ketika aplikasi yang sama berpindah antara GPT, Claude, dan Gemini karena struktur API native masing-masing berbeda. Secara garis besar mencakup 6 kategori: peran pesan, pemanggilan tool, status reasoning, event streaming, output terstruktur dan multimodal, serta caching/penagihan dan penanganan error.
Q2:Kalau memanggil Claude dan Gemini lewat antarmuka kompatibel OpenAI, masih perlu lapisan adaptasi?
Untuk obrolan biasa, antarmuka kompatibel bisa langsung dipakai. Namun begitu melibatkan parameter tool yang ketat, Prompt Caching, input file, atau status thinking terenkripsi, lapisan adaptasi tetap diperlukan. Contohnya lapisan kompatibel resmi Claude, ia mengabaikan `strict`, dan juga tidak mendukung caching serta input audio/file. Perbedaan seperti ini harus dicatat dalam registri kapabilitas.
Q3:Untuk proyek baru Gemini, sebaiknya pakai Interactions API atau generateContent?
Interactions API masuk GA pada Juni 2026, dan Google menyarankan proyek baru memakainya lebih dulu. API ini mendukung status sesi di sisi server, `previous_interaction_id`, dan struktur steps. `generateContent` masih didukung, proyek yang sudah berjalan bisa migrasi sesuai rencana.
Q4:Kalau ganti model di tengah sesi, bagaimana menangani riwayatnya?
Pesan pengguna, jawaban final, permintaan tool, dan hasil tool disimpan sebagai riwayat standar, lalu dirakit ulang oleh adaptor target setelah pergantian. Status khusus vendor seperti signature dan item reasoning disimpan terpisah, dan hanya dikirim balik apa adanya saat melakukan request ke vendor yang sama. Selain itu, cache dari vendor asal biasanya tidak bisa dipakai ulang setelah pergantian, jadi siapkan biaya input penuh untuk putaran pertama.
Q5:Bagaimana cara cepat memverifikasi kompatibilitas ketiga model di bisnis saya?
Disarankan mengikuti langkah berikut:
1. Kunjungi APIYI apiyi.com untuk mendaftar akun, dapatkan kunci API dan kuota uji gratis.
2. Gunakan kode di artikel ini, setel base_url ke alamat antarmuka APIYI, lalu isi tiga ID model.
3. Jalankan enam pengujian pada bagian 4.1 secara bertahap, dan catat tingkat keberhasilan, jenis anomali, biaya, serta total waktu.
Q6:Apa yang perlu diperhatikan saat menyetel fallback otomatis model?
Pertama, tentukan apakah tugas tersebut punya efek samping. Tool seperti pembayaran, pengiriman email, dan perubahan file wajib memiliki idempotency key; saat fallback, lanjutkan dari langkah yang belum selesai agar seluruh tugas tidak dijalankan ulang. Rate limit dan error sisi server cocok ditangani dengan retry dan backoff, sedangkan error parameter dan melewati batas konteks perlu perbaikan request dulu sebelum dikirim ulang.
Q7:Bagaimana mengontrol biaya saat melakukan routing multi-model?
Catat biaya berdasarkan Token per komponen, lalu bandingkan dengan total biaya tugas secara utuh. Selisih harga satuan ketiga vendor cukup besar, misalnya harga output GPT-6 Astra $50 per juta Token, sementara Gemini 3.8 Flash saat ini dalam harga promo $3.75. Dengan melihat pemakaian tiap model secara terpusat di APIYI apiyi.com, jalur berbiaya tinggi bisa lebih cepat terdeteksi, lalu aturan routing disesuaikan berdasarkan temuan itu.
Q8:Apa saja keterbatasan gateway API terpadu?
Gateway menyatukan pintu masuk pemanggilan, kunci, dan penagihan. Ketersediaan kemampuan native lanjutan vendor (misalnya pemanggilan tool khusus Responses API, `cache_control`, pengiriman balik signature terenkripsi) bergantung pada dukungan endpoint masing-masing, jadi perlu diuji satu per satu. Jalur yang bergantung pada kemampuan tersebut sebaiknya tetap menyimpan adaptor native sebagai pelengkap.
Poin Inti Kompatibilitas API Multi-Model — Key Takeaways
- Ganti model ≠ ganti ID: untuk tanya jawab biasa bisa dimigrasi langsung, sedangkan alur Agent perlu menangani 6 jenis perbedaan.
- Lapisan kompatibilitas punya batas: lapisan kompatibilitas Claude mengabaikan
strict, serta tidak mendukung cache dan input file. - Signature harus disimpan apa adanya: hilangnya signature thinking / thought adalah penyebab umum error pada rantai tool multi-putaran.
- Unifikasi event streaming: backend mengeluarkan 8 jenis event internal, sementara frontend hanya terhubung ke satu protokol.
- Routing digerakkan oleh capability registry: mencatat fitur yang benar-benar didukung dengan satuan “model + endpoint”.
- Fallback harus idempoten: tool yang punya efek samping diberi idempotency key untuk mencegah eksekusi berulang.
- Uji dulu sebelum rilis: jalankan enam tes kompatibilitas memakai kuota gratis dari APIYI apiyi.com.
Ringkasan
Kunci agar satu aplikasi bisa terhubung sekaligus ke GPT, Claude, dan Gemini adalah memusatkan perbedaan ke dalam sedikit komponen saja untuk dikelola:
- Format pesan dan tool yang terpadu: riwayat standar dan status khusus vendor disimpan secara berlapis, sehingga konteks tidak hilang saat berganti model.
- Provider Adapter: bertanggung jawab atas konversi input, konversi output, dan penanganan status; kemampuan lanjutan native diwujudkan di sini.
- Capability registry: mencatat secara akurat dukungan tool, reasoning, multimodal, Schema, dan cache untuk setiap model dan setiap endpoint; inilah yang menentukan routing serta opsi di antarmuka.
Di atas landasan itu, jaga kualitas rilis dengan enam tes kompatibilitas dan observasi biaya per komponen. Pada tahap pemanggilan biasa dan perbandingan model, disarankan menyelesaikan verifikasi multi-model dengan cepat lewat APIYI apiyi.com menggunakan satu Key, lalu berdasarkan hasil tes menentukan alur mana yang perlu adaptasi native.
📚 Referensi
- OpenAI Function Calling: pemanggilan alat,
call_id, danfunction_call_output - Tautan:
developers.openai.com/api/docs/guides/function-calling -
Deskripsi: Penjelasan otoritatif tentang protokol pemanggilan alat Responses API
-
Panduan migrasi model terbaru OpenAI: parameter penalaran dan persyaratan antarmuka seri GPT-6
- Tautan:
developers.openai.com/api/docs/guides/latest-model -
Deskripsi: Batasan nilai
reasoning.effortdan persyaratan Responses API -
OpenAI Prompt Caching: titik henti cache dan TTL
- Tautan:
developers.openai.com/api/docs/guides/prompt-caching -
Deskripsi: Mekanisme cache implisit dan eksplisit
-
Kompatibilitas Claude OpenAI SDK: cakupan dan batasan dukungan lapisan kompatibilitas
- Tautan:
platform.claude.com/docs/en/cli-sdks-libraries/libraries/openai-sdk -
Deskripsi: Perbedaan seperti
strict, cache, input file, dan penggabungan system -
Claude Extended Thinking: Adaptive Thinking dan tanda tangan pemikiran
- Tautan:
platform.claude.com/docs/en/build-with-claude/extended-thinking -
Deskripsi: Aturan pengiriman kembali blok thinking dalam pemanggilan alat multi-putaran
-
Output terstruktur dan cache Claude: output JSON, Strict tool use,
cache_control - Tautan:
platform.claude.com/docs/en/build-with-claude/structured-outputs - Tautan:
platform.claude.com/docs/en/build-with-claude/prompt-caching -
Deskripsi: Batasan terstruktur dan pola cache
-
Gemini Interactions API dan kompatibilitas OpenAI: antarmuka baru dan endpoint kompatibilitas
- Tautan:
ai.google.dev/gemini-api/docs/interactions-overview - Tautan:
ai.google.dev/gemini-api/docs/openai -
Deskripsi: Struktur steps, status sesi, dan pemetaan parameter kompatibilitas
-
Tanda tangan pemikiran, pemanggilan alat, dan cache Gemini
- Tautan:
ai.google.dev/gemini-api/docs/thought-signatures - Tautan:
ai.google.dev/gemini-api/docs/function-calling - Tautan:
ai.google.dev/gemini-api/docs/caching -
Deskripsi: Retensi tanda tangan mode stateless, protokol alat, dan cache eksplisit
-
Halaman harga resmi ketiga perusahaan
- Tautan:
developers.openai.com/api/docs/pricing - Tautan:
platform.claude.com/docs/en/models/sonnet-5-5/overview - Tautan:
ai.google.dev/gemini-api/docs/pricing - Deskripsi: Sumber data tabel harga artikel ini, tanggal verifikasi 2026-11-13
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami melalui halaman beranda situs APIYI; materi lainnya dapat diakses di pusat dokumentasi docs.apiyi.com


