
Catatan penulis: Bobot open-source 文心5.5 Flash Base sudah bisa diunduh. Artikel ini membahas parameter arsitektur, kebutuhan perangkat keras, tujuan penggunaan, dan biaya untuk membantu Anda memilih antara men-deploy model dasar sendiri atau memanggil API sesuai kebutuhan.
Pada 5 November 2026, Baidu resmi merilis dan membuka sumber 文心5.5 Flash Base(ERNIE-5.5-Flash-Base). Ini adalah model dasar sparse MoE dengan total 280B parameter dan 14B parameter aktif per token. Model ini meraih hasil SOTA untuk model seukuran pada sejumlah benchmark. Bobotnya sudah tersedia di Hugging Face dalam versi FP8 dan BF16, sementara plugin vLLM dan SGLang Cookbook juga dirilis bersamaan. Jadi, kali ini bukan sekadar “merilis paper tanpa bobot”.
Ini bukan sekadar artikel yang mengulang skor benchmark. Banyak tim melihat label “open-source + SOTA” lalu bersiap mengunduh bobot dan menjalankannya, tetapi melewatkan satu fakta penting: ini adalah model Base yang belum melalui mid-training dan post-training. Model ini cocok sebagai titik awal pelatihan, tetapi tidak bisa langsung digunakan sebagai chatbot.
Manfaat utama: Setelah membaca artikel ini, Anda akan memahami skenario yang cocok untuk 文心5.5 Flash Base, perkiraan kebutuhan VRAM untuk men-deploy-nya sendiri, serta kondisi yang membuat pemanggilan API sesuai kebutuhan lebih hemat.
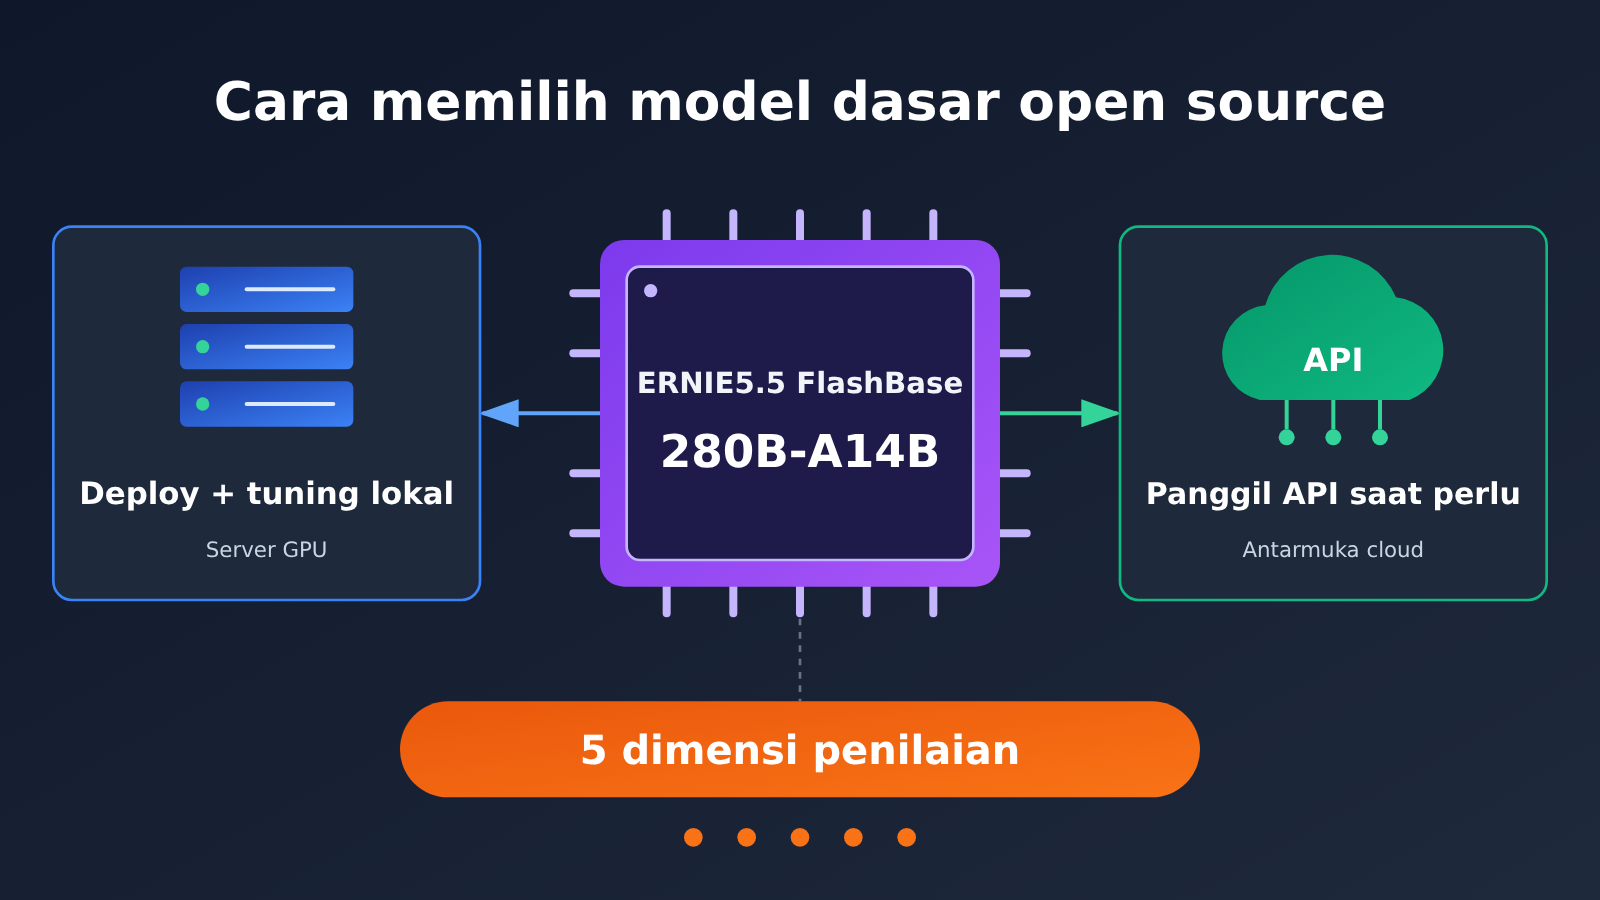
Poin penting Wenxin 5.5 Flash Base
Tabel berikut merangkum informasi terpenting tentang model ini. Poin-poin ini akan membantu menentukan apakah lebih baik melakukan deployment sendiri atau memanggil model melalui layanan.
| Poin | Penjelasan | Pengaruh pada pemilihan |
|---|---|---|
| Posisi model | Checkpoint pada akhir prapelatihan, tanpa pelatihan menengah maupun pascapelatihan | Tidak bisa langsung digunakan untuk percakapan, tetapi cocok untuk dilatih lebih lanjut |
| Ukuran parameter | 280B parameter total, dengan 14B diaktifkan per token | Kebutuhan komputasi inferensi lebih rendah, tetapi penggunaan memori GPU untuk bobot tetap dihitung berdasarkan 280B |
| Konteks | Konteks pelatihan 128K, mendukung 1M token untuk fine-tuning dan inferensi | Cocok untuk adaptasi domain pada dokumen panjang dan kode setingkat repositori |
| Format bobot | FP8 dan BF16 tersedia di Hugging Face | FP8 dapat menurunkan kebutuhan sumber daya untuk deployment secara signifikan |
| Dukungan ekosistem | Plugin vLLM dan SGLang Cookbook | Dapat langsung diintegrasikan dengan framework inferensi populer |
Apa arti “Base” pada Wenxin 5.5 Flash Base?
Model Base hanya belajar “memprediksi token berikutnya”, bukan “memahami instruksi dan memberikan jawaban”. Jika diberi pertanyaan, model ini mungkin justru melanjutkannya dengan lebih banyak pertanyaan, bukan memberikan jawaban. Baidu juga menjelaskan bahwa pengembang dapat menggunakan model ini sebagai titik awal untuk adaptasi domain, fine-tuning instruksi, penguatan kemampuan penalaran, dan pelatihan Agent.
Jadi, pertimbangan pertamanya sederhana: jika tujuanmu adalah “menggunakan model”, Base bukan pilihan yang tepat; jika tujuanmu adalah “melatih model”, model ini bisa menjadi titik awal yang baik. Baidu juga menyebutkan bahwa versi resmi Wenxin 5.5 Flash akan segera dirilis. Tim yang ingin langsung menggunakannya untuk percakapan bisa menunggu versi tersebut.
Pesaing Wenxin 5.5 Flash Base dengan ukuran serupa
Dalam evaluasi yang dipublikasikan Baidu, model yang dibandingkan meliputi DeepSeek-V4-Flash-Base (284B-A13B), Hy3-preview-Base (295B-A21B), dan MiMo-V2.5-Base (310B-A15B). Wenxin 5.5 Flash Base menunjukkan performa yang menonjol dalam penalaran, kode, kemampuan berbagai bidang ilmu, dan tugas dengan konteks panjang. Bagi tim yang ingin melakukan fine-tuning untuk bidang seperti Agent kode atau pemahaman dokumen panjang, model dasar ini layak masuk daftar kandidat.
Cara kerja 文心5.5 Flash Base: tiga peningkatan efisiensi
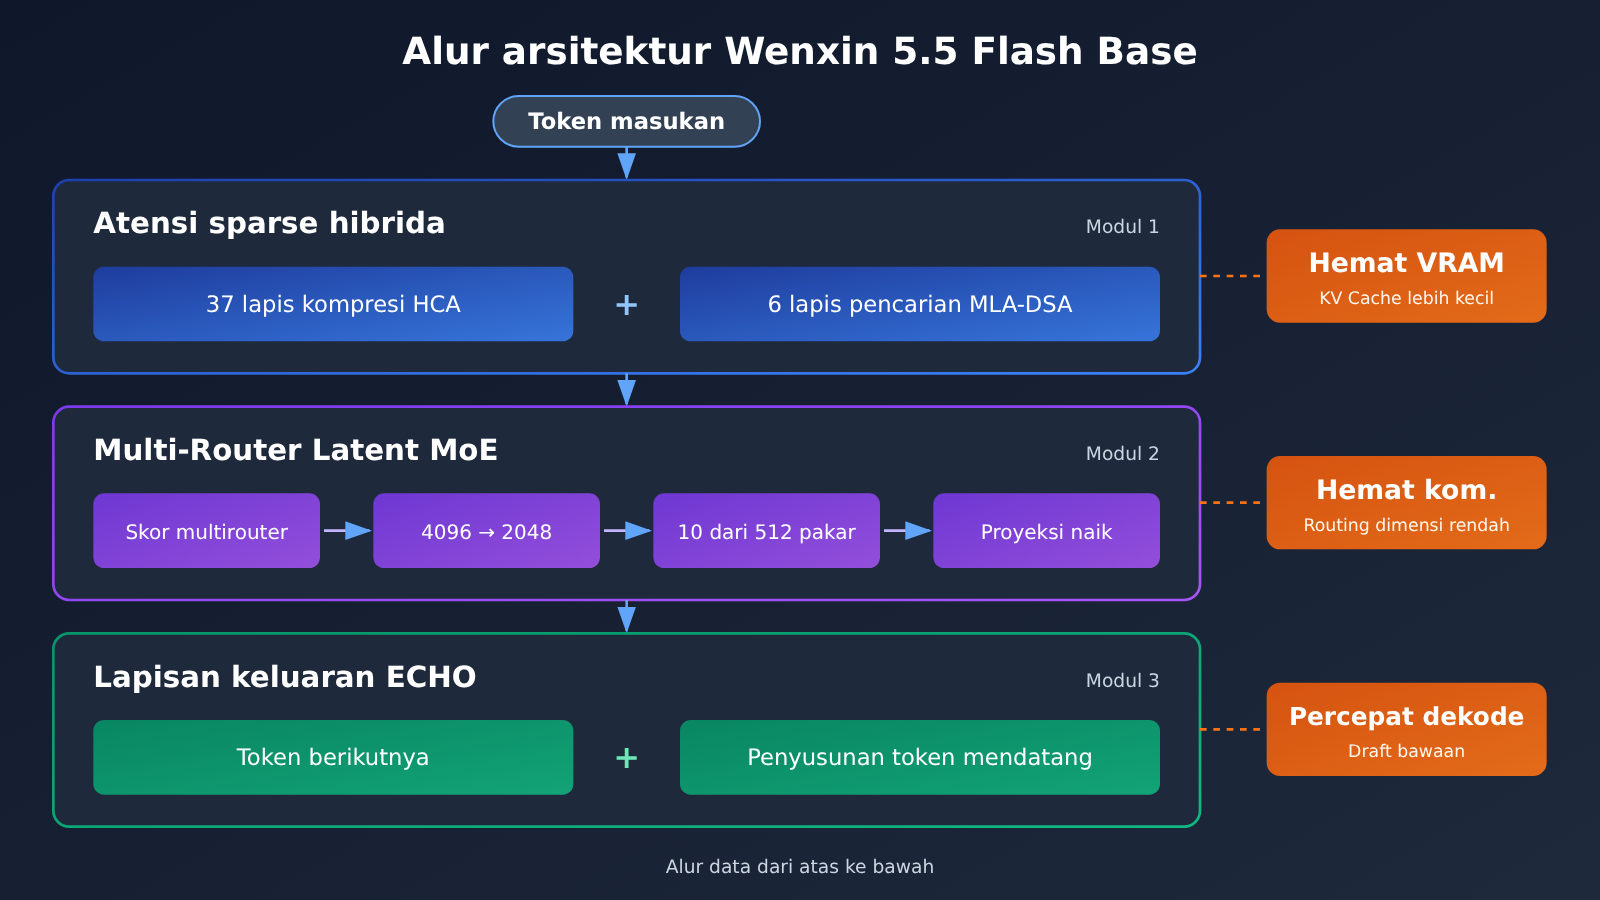
Memahami arsitekturnya membantu memperkirakan biaya deployment. Tim 文心 menjadikan efisiensi sebagai variabel desain saat prapelatihan, dengan perubahan utama pada tiga bagian: attention, routing expert, dan prediksi token mendatang.
| Modul | Desain utama | Manfaat untuk deployment |
|---|---|---|
| Hybrid sparse attention | 37 dari 43 lapisan menggunakan HCA (setiap 128 token dikompresi menjadi satu entri cache), sedangkan 6 lapisan menggunakan pencarian sparse MLA + DSA | KV Cache jauh lebih kecil, sehingga konteks panjang lebih hemat memori GPU |
| Multi-Router Latent MoE | Beberapa router Sigmoid memberi skor bersama; 10 dari 512 routed expert dipilih, ditambah 1 shared expert; expert melakukan komputasi di ruang laten berdimensi 2048 | FLOPs expert dan volume komunikasi distribusi berkurang sekitar setengahnya |
| ECHO | Menggunakan kembali lapisan terakhir backbone untuk memprediksi token mendatang | Bisa langsung digunakan sebagai model draft bawaan untuk speculative decoding, tanpa menambah parameter |
| Desain pendukung | Output head MultiMax dan tokenizer R2L dengan kosakata sekitar 200 ribu token | Penanganan angka dan aritmetika lebih stabil |
Mengapa KV Cache 文心5.5 Flash Base lebih hemat
Pada model tradisional, setiap lapisan harus menyimpan KV Cache lengkap. Semakin panjang konteksnya, semakin besar pula kebutuhan memori GPU. 文心5.5 Flash Base membuat 37 lapisan hanya melihat “ringkasan” yang sudah dikompresi, sementara hanya 6 lapisan yang mengakses riwayat per token. Keenam lapisan ini kemudian menggunakan Indexer ringan untuk memilih posisi Top-K bagi komputasi yang lebih detail. Artinya, pada konteks 128K atau lebih panjang, penggunaan KV Cache jauh lebih rendah dibandingkan model full attention dengan ukuran serupa. Bagi tim yang melakukan deployment mandiri, ini berarti penghematan memori GPU yang nyata.
Manfaat ECHO untuk mempercepat inferensi
Saat prapelatihan, ECHO hanya memprediksi 1 token tambahan. Namun, sebagai model draft, ECHO bisa menyusun beberapa token berturut-turut, dengan tingkat penerimaan yang lebih tinggi daripada modul MTP eksternal yang dilatih dengan cara serupa. Saat melakukan deployment mandiri, throughput bisa meningkat signifikan jika framework inferensi mendukung jalur speculative decoding ini. Ini juga salah satu keunggulan bobot open-source dibandingkan API: Anda punya kendali penuh atas optimasi inferensi semacam ini.
Panduan cepat Wenxin 5.5 Flash Base: deployment mandiri
Jika Anda ingin menggunakan model dasar ini untuk pelatihan atau inferensi privat, berikut jalur paling singkat untuk memulainya. Artikel ini tidak menyertakan kode; parameter penting dijelaskan dengan kata-kata.
Langkah pertama: perkirakan kebutuhan VRAM
Beban komputasi model MoE dihitung berdasarkan parameter yang aktif, tetapi seluruh bobot harus dimuat. Jadi, kebutuhan VRAM dihitung berdasarkan total 280B parameter. Tabel berikut adalah perkiraan kasar berdasarkan “jumlah byte per parameter × jumlah parameter”, tanpa memperhitungkan KV Cache, nilai aktivasi, dan overhead framework. Kebutuhan sebenarnya tetap perlu mengacu pada dokumentasi resmi dan pengujian sendiri.
| Versi bobot | Estimasi VRAM untuk bobot | Saran deployment (estimasi) | Kegunaan |
|---|---|---|---|
| FP8 | Sekitar 280GB | Satu mesin dengan 8 GPU kelas 80GB, masih menyisakan ruang untuk KV Cache | Evaluasi inferensi, layanan ringan |
| BF16 | Sekitar 560GB | Satu mesin dengan 8 GPU ber-VRAM besar atau paralelisme tensor di beberapa mesin | Evaluasi yang sensitif terhadap presisi dan titik awal fine-tuning |
| Fine-tuning semua parameter | Jauh lebih besar daripada inferensi (juga membutuhkan ruang untuk status optimizer dan gradien) | Klaster multi-mesin dengan framework pelatihan terdistribusi | Adaptasi mendalam untuk domain tertentu |
| Fine-tuning seperti LoRA | Di antara inferensi dan fine-tuning semua parameter | Bergantung pada rank dan panjang sekuens | Adaptasi domain untuk tim kecil hingga menengah |
Langkah kedua: pilih framework inferensi dan muat bobot
Pihak resmi juga menyediakan plugin vLLM dan SGLang Cookbook. Sebaiknya mulai dengan mengikuti kedua panduan tersebut. Langkah-langkahnya:
- Unduh bobot FP8 atau BF16 dari Hugging Face, dan siapkan ruang disk yang kurang lebih setara dengan kebutuhan VRAM untuk bobot.
- Instal vLLM dan muat plugin resmi, atau atur parameter saat menjalankan model sesuai SGLang Cookbook.
- Samakan tingkat paralelisme tensor dengan jumlah GPU (di vLLM, gunakan parameter
tensor-parallel-size). - Mulai dengan panjang konteks sekitar 32K sampai berhasil berjalan, lalu tingkatkan secara bertahap sambil memantau penggunaan KV Cache.
- Lakukan smoke test dengan petunjuk berbentuk lanjutan teks, misalnya berikan awal potongan kode untuk dilengkapi, alih-alih langsung mengajukan pertanyaan.
Langkah ketiga: tentukan tujuan pelatihan
Setelah bobot Base siap digunakan, pekerjaan sesungguhnya baru dimulai. Ada tiga pendekatan umum: melanjutkan prapelatihan dengan korpus domain, melakukan SFT dengan data instruksi, dan setelah SFT, memperkuat kemampuan penalaran atau melatih jejak Agent. Pada tahap prapelatihan, Wenxin sudah menggunakan data kode seperti commit, issue, PR, serta validasi dan perbaikan CI, juga data teks panjang seperti tanya jawab multi-hop. Karena itu, potensi fine-tuning yang paling menjanjikan ada pada rekayasa kode dan dokumen panjang.
🎯 Saran teknis: Sebelum menggunakan GPU untuk fine-tuning, sebaiknya jalankan set evaluasi bisnis Anda dengan model instruksi yang sudah tersedia untuk mendapatkan “skor baseline”. APIYI apiyi.com menyediakan antarmuka terpadu untuk berbagai model populer, sehingga Anda bisa mendapatkan baseline pembanding dengan biaya rendah sebelum memutuskan apakah pelatihan model dasar sendiri sepadan dengan investasinya.
Memulai dengan Wenxin 5.5 Flash Base: jalur API sesuai kebutuhan
Hal pertama yang perlu diperjelas: APIYI saat ini belum menyediakan seri model Wenxin ERNIE, termasuk Wenxin 5.5 Flash Base. Kami akan menyediakannya secepat mungkin. Selain itu, model Base sendiri tidak cocok digunakan langsung sebagai API percakapan. Sebagian besar kebutuhan bisnis lebih cocok menggunakan versi instruksi atau penalaran.
Jika ingin segera mengintegrasikan kemampuannya ke produk, kamu bisa membangun alur kerja terlebih dahulu dengan model matang yang sudah tersedia, lalu menggantinya untuk dibandingkan setelah versi resmi Wenxin 5.5 Flash tersedia. APIYI mendukung format antarmuka OpenAI dan Anthropic, sehingga kamu cukup mengubah parameter model tanpa perlu menulis ulang logika pemanggilan.
Harga model alternatif yang tersedia di APIYI
Harga berikut mengacu pada data di halaman harga APIYI, docs.apiyi.com/models, dalam dolar AS per satu juta token. Periksa data terbaru di halaman tersebut sebelum melakukan pemanggilan.
| Model | Input | Output | Cache | Skenario yang cocok | Platform yang tersedia |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Tugas dengan konkurensi tinggi dan sensitif terhadap biaya | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | Konteks panjang dan penggunaan bahasa Mandarin | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | Model andalan untuk pemrograman dan Agent | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | Penalaran kompleks dan tugas sulit | APIYI apiyi.com |
| Wenxin 5.5 Flash Base / versi resmi | — | — | — | Model ini belum tersedia di APIYI | Akan tersedia secepat mungkin |
Selain itu, APIYI juga menyediakan model Tiongkok seperti seri qwen3.8, serta model gambar gpt-image-2.6-flare dan gpt-image-2.6-sunburst (input teks $5, input gambar $8, output $30; tetap mengacu pada halaman harga). Perlu dicatat, deepseek-v4.1-flash dalam tabel adalah model instruksi yang bisa langsung dipanggil, dan berbeda dari DeepSeek-V4-Flash-Base yang digunakan dalam perbandingan evaluasi.
Cara integrasi
Untuk format OpenAI, atur base_url pada SDK ke alamat antarmuka yang tersedia dalam dokumentasi APIYI, lalu isi api_key dengan kunci yang dibuat di konsol. Proyek yang menggunakan Anthropic SDK juga bisa langsung terhubung. Untuk alamat antarmuka lengkap, penjelasan parameter, dan contoh, lihat pusat dokumentasi APIYI di docs.apiyi.com.
🚀 Mulai cepat: Sebaiknya gunakan deepseek-v4.1-flash atau claude-sonnet-5-5 di APIYI apiyi.com untuk menjalankan prototipe bisnis terlebih dahulu. Setelah versi resmi Wenxin 5.5 Flash tersedia di platform, cukup ubah nama model untuk melakukan perbandingan A/B.
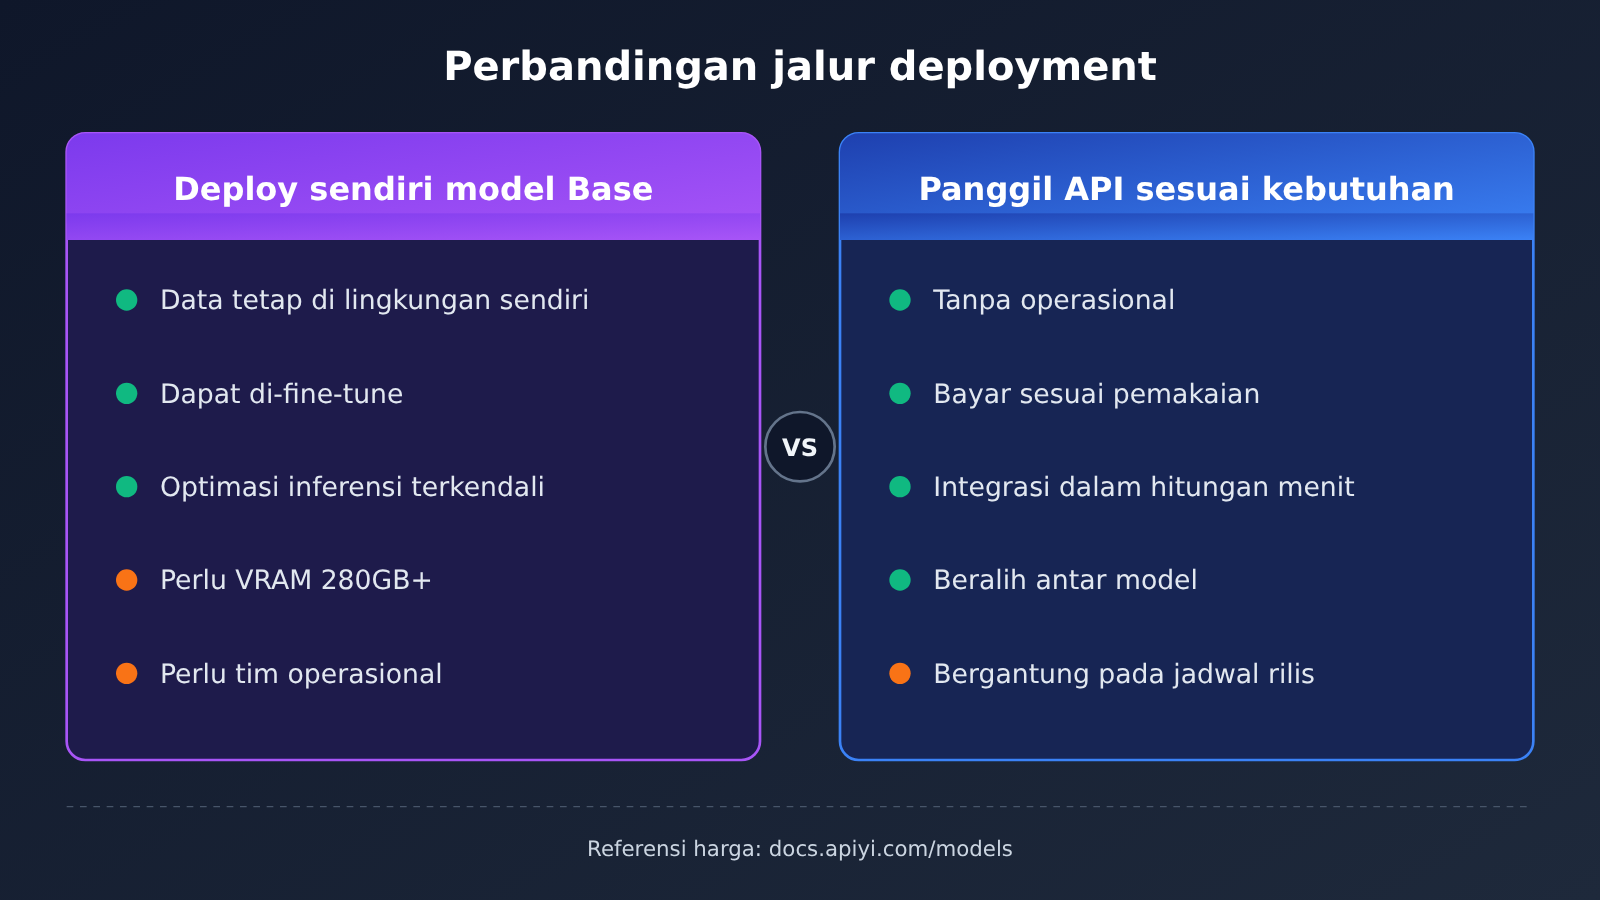
Perbandingan deployment mandiri Wenxin 5.5 Flash Base dan pemanggilan API: tabel keputusan
Berikut rekomendasi berdasarkan 5 aspek untuk membantu menentukan pilihan yang cocok bagi tim Anda.
| Aspek | Pilih deployment mandiri Base | Pilih pemanggilan API sesuai kebutuhan |
|---|---|---|
| Tujuan penggunaan | Melanjutkan prapelatihan domain, SFT, RL, atau eksperimen perbandingan untuk riset | Langsung membuat aplikasi tanya jawab, penulisan, asisten pemrograman, dan sebagainya |
| Kepatuhan data | Data tidak boleh keluar dari jaringan internal dan harus dikelola secara privat | Data boleh diproses di cloud dan menerima ketentuan kepatuhan penyedia layanan |
| Skala pemanggilan | Beban tinggi dan stabil dalam jangka panjang, dengan utilisasi GPU yang tetap tinggi | Traffic berfluktuasi atau jumlah pemanggilan harian terbatas |
| Kemampuan tim | Memiliki engineer untuk pelatihan serta operasional dan pemeliharaan inferensi | Fokus pada pengembangan aplikasi dan tidak ingin memelihara cluster |
| Waktu peluncuran | Bisa menerima siklus pelatihan selama beberapa minggu hingga beberapa bulan | Harus meluncurkan produk minggu ini |
Dua tipe pengguna Wenxin 5.5 Flash Base
Tim yang cocok melakukan deployment mandiri: Misalnya, tim di sektor keuangan, kesehatan, pemerintahan, dan perusahaan yang memiliki persyaratan privatisasi, banyak korpus domain, dan ingin melatih model khusus. Tim seperti ini memilih Wenxin 5.5 Flash Base karena fondasi prapelatihannya pada kode dan konteks panjang, serta penghematan KV Cache dari arsitektur HCA.
Tim yang cocok menggunakan API: Misalnya, tim aplikasi yang membuat SaaS, alat bantu konten, atau sistem layanan pelanggan, dengan kebutuhan utama berupa layanan yang stabil, cepat, dan dibayar sesuai pemakaian. Bagi mereka, menggunakan model Base justru berarti harus menempuh tahap pelatihan tambahan. Pilihan yang lebih masuk akal adalah meluncurkan produk terlebih dahulu dengan model instruksi yang sudah matang, lalu memusatkan perhatian pada produk.
Kedua jalur bisa berjalan bersamaan
Banyak tim sebenarnya menggunakan “model campuran”: memanggil API untuk menjaga stabilitas layanan produksi, sambil bereksperimen dengan bobot Base secara internal. Setelah model yang dilatih sendiri mengungguli baseline API pada set evaluasi, traffic dialihkan secara bertahap. Cara ini meminimalkan risiko sekaligus memastikan investasi pengembangan internal selalu memiliki tolok ukur yang jelas.
💡 Saran memilih: Jika masih ragu, coba hitung dulu perkiraan biaya bulanan berdasarkan volume pemanggilan dan harga satuan di halaman harga APIYI, lalu bandingkan dengan biaya sewa atau penyusutan GPU. Jalankan uji coba skala kecil selama seminggu melalui antarmuka terpadu APIYI apiyi.com. Keputusan berdasarkan penggunaan token yang sebenarnya akan jauh lebih akurat daripada perkiraan berdasarkan firasat.
Pertanyaan Umum FAQ
Q1: Apa itu 文心5.5 Flash Base?
Ini adalah model dasar yang dirilis secara open source oleh Baidu pada 5 November 2026. Model ini menggunakan arsitektur sparse MoE, memiliki total 280B parameter dengan 14B parameter aktif per token, dan dilatih dari awal pada 33.5T token. Bobot yang dirilis adalah hasil akhir prapelatihan, sehingga terutama ditujukan untuk pelatihan lanjutan, bukan untuk langsung digunakan dalam percakapan.
Q2: Apa perbedaan 文心5.5 Flash Base dan DeepSeek-V4-Flash-Base?
Keduanya memiliki skala yang mirip; DeepSeek-V4-Flash-Base berukuran 284B-A13B. DeepSeek-V4-Flash-Base juga merupakan model dasar yang kuat, tetapi menurut evaluasi yang dipublikasikan Baidu, 文心5.5 Flash Base unggul dalam penalaran, kode, pengetahuan bidang akademis, dan konteks panjang. Dari segi arsitektur, 文心 menggunakan perhatian hibrida HCA dan MLA serta MoE dengan beberapa router, dengan fokus pada kompresi KV Cache dan peningkatan keandalan routing.
Q3: Kapan versi resmi 文心5.5 Flash dirilis?
Baidu menyatakan bahwa versi resmi akan segera dirilis, tetapi hingga artikel ini ditulis pada 6 November 2026, belum ada tanggal pastinya. Versi resmi akan melalui pelatihan lanjutan di atas model Base, sehingga lebih cocok untuk langsung diintegrasikan ke aplikasi.
Q4: Untuk skenario apa 文心5.5 Flash Base paling cocok?
Model ini terutama cocok untuk beberapa skenario berikut:
– **Pelatihan model kode tingkat repositori**: prapelatihannya sudah mencakup data rekayasa seperti commit, PR, dan perbaikan CI.
– **Model khusus domain untuk dokumen panjang**: misalnya, untuk memahami berkas hukum atau laporan riset dengan konteks panjang. Fine-tuning dan inferensi mendukung hingga 1M token.
– **Riset metode pelatihan**: sebagai titik awal yang sama untuk membandingkan hasil berbagai strategi SFT dan RL.
Q5: Apakah 文心5.5 Flash Base sudah bisa dipanggil melalui API?
APIYI saat ini belum menyediakan model ini, begitu pula dengan seri ERNIE secara keseluruhan. Kami akan menyediakannya sesegera mungkin. Untuk saat ini, Anda bisa memanggil model yang sudah tersedia seperti deepseek-v4.1-flash, kimi-k3.1-pro, dan claude-sonnet-5-5 melalui APIYI di apiyi.com. Platform ini kompatibel dengan format antarmuka OpenAI dan Anthropic. Untuk harga, lihat docs.apiyi.com/models.
Q6: Apa saja keterbatasan deployment 文心5.5 Flash Base secara mandiri?
Pertama, kebutuhan memori GPU tinggi: meski menggunakan bobot FP8, bobotnya saja membutuhkan sekitar 280GB. Kedua, model Base tidak bisa langsung digunakan tanpa pelatihan. Ketiga, inferensi dengan konteks panjang tetap membutuhkan ruang untuk KV Cache. Jika tim belum berpengalaman dalam pelatihan dan operasional, sebaiknya mulai dengan API.
Q7: Apa yang bisa dilakukan tim kecil dan menengah dengan 文心5.5 Flash Base?
Tim dapat menyewa GPU cloud untuk menjalankan inferensi FP8 dan mengevaluasi kemampuan model, atau menggunakan metode seperti LoRA untuk adaptasi domain yang ringan. Untuk lalu lintas produksi, sebaiknya tetap gunakan API. Hasil pada kebutuhan bisnis yang diperoleh melalui APIYI di apiyi.com dapat digunakan sebagai tolok ukur untuk model yang dilatih sendiri.
Poin Utama Wenxin 5.5 Flash Base
- Diposisikan sebagai titik awal pelatihan: Base belum menjalani pascapelatihan, sehingga cocok untuk fine-tuning dan riset, tetapi tidak bisa langsung digunakan untuk percakapan.
- Komputasi mengikuti parameter aktif, VRAM mengikuti total parameter: Hanya 14B parameter yang aktif, tetapi bobot FP8 tetap membutuhkan sekitar 280GB VRAM.
- Konteks panjang lebih hemat cache: Kompresi HCA pada 37 lapisan ditambah MLA-DSA pada 6 lapisan membuat KV Cache jauh lebih kecil.
- Fondasi kuat untuk kode dan teks panjang: Cocok untuk membangun model khusus domain yang menangani kode tingkat repositori dan dokumen panjang.
- Ekosistem sudah siap: Plugin vLLM dan SGLang Cookbook dirilis bersamaan, sehingga lebih mudah diintegrasikan untuk inferensi.
- Belum tersedia melalui API: APIYI saat ini belum menyediakan seri Wenxin. Sementara itu, Anda bisa membangun baseline bisnis dengan model yang sudah tersedia.
Kesimpulan
Hal utama yang perlu dipertimbangkan saat memilih Wenxin 5.5 Flash Base:
- Tentukan tujuan: Jika ingin melatih model, pilih Base yang di-deploy sendiri. Jika ingin langsung menggunakan model, pilih API atau tunggu versi resminya.
- Hitung kebutuhan: VRAM untuk bobot sekitar 280GB pada FP8 dan 560GB pada BF16 merupakan batasan yang harus dipenuhi.
- Bandingkan biaya: Gunakan volume pemanggilan aktual untuk membandingkan biaya API bulanan dengan biaya GPU. Pendekatan gabungan memiliki risiko paling rendah.
Bagi sebagian besar tim aplikasi, langkah paling praktis adalah menjalankan kebutuhan bisnis terlebih dahulu melalui API, lalu menggunakan Base open source untuk eksperimen internal. Anda bisa menggunakan model yang sudah tersedia di APIYI apiyi.com untuk membangun baseline dengan cepat. Dokumentasi antarmuka tersedia di docs.apiyi.com, dan harga dapat dilihat di docs.apiyi.com/models. Setelah seri Wenxin tersedia, Anda cukup mengganti nama model dalam kode yang sama untuk melakukan perbandingan.
📚 Referensi
- 量子位 – Laporan tentang rilis sumber terbuka Baidu Wenxin 5.5 Flash Base: Gambaran umum rilis dan evaluasi model
- Tautan:
qbitai.com/2026/11/507787.html -
Keterangan: Mencakup perbandingan model dasar berukuran sama dan penjelasan teknologi utama
-
Pusat Dokumentasi APIYI: Alamat endpoint dan panduan pemanggilan yang kompatibel dengan OpenAI dan Anthropic
- Tautan:
docs.apiyi.com -
Keterangan: Panduan yang perlu dibaca sebelum integrasi, termasuk parameter dan contoh
-
Halaman Harga Model APIYI: Harga satuan input, output, dan cache untuk model yang sudah tersedia
- Tautan:
docs.apiyi.com/models - Keterangan: Semua harga dalam artikel ini mengacu pada data aktual di halaman tersebut
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama APIYI di apiyi.com. Untuk materi integrasi lainnya, kunjungi pusat dokumentasi di docs.apiyi.com


