
Note de l’auteur : deux exemples calculés à la main pour comprendre clairement la tarification de GPT-6.2 Astra en contexte court et en contexte long, ainsi que les multiplicateurs de Batch, Fast et Ultrafast.
OpenAI a lancé le 17 novembre 2026 GPT-6.2 Astra et GPT-6.2 Sol, dont les identifiants de modèle sont respectivement gpt-6.2-astra et gpt-6.2-sol. Le prix standard en contexte court indiqué sur la page officielle du modèle semble limpide, mais quand il s’agit réellement d’estimer sa facture, le prix standard en contexte court ne peut pas s’appliquer tel quel au contexte long, ni aux modes Fast et Ultrafast. Dès que l’entrée d’une requête dépasse 272K tokens, le prix unitaire change pour l’ensemble de la requête ; et si vous choisissez Fast ou Ultrafast, il faut en plus appliquer un multiplicateur sur le palier de contexte correspondant.
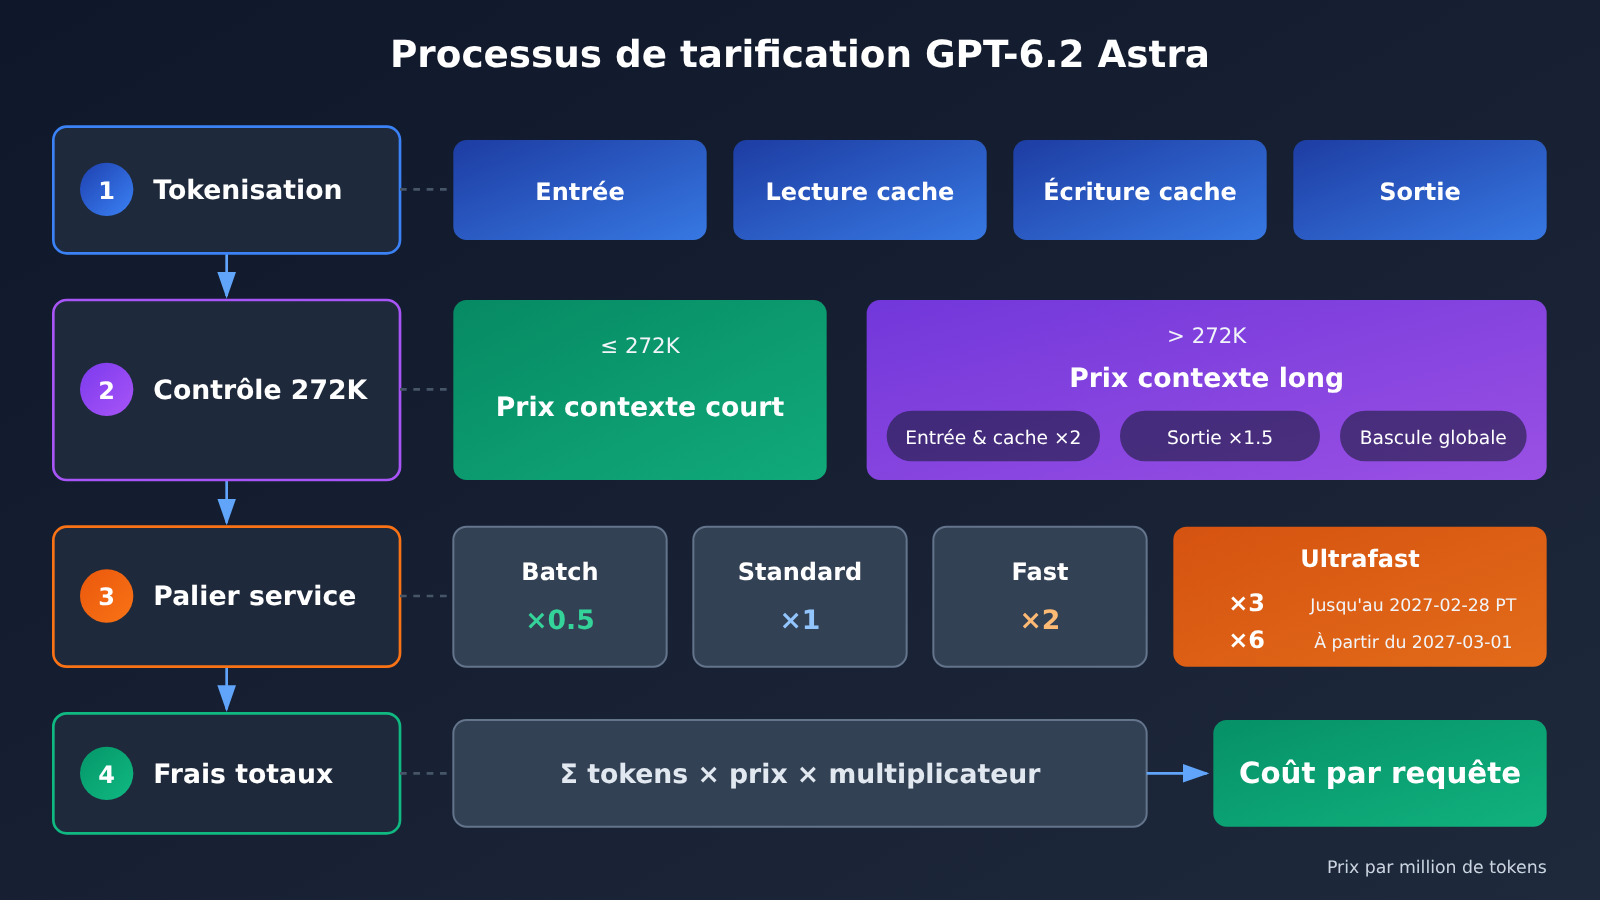
Ce n’est pas une simple reformulation d’une grille tarifaire, mais un ensemble de règles que vous pouvez recalculer à la main, papier et stylo en main : commencez par répartir les tokens en quatre catégories (entrée, lecture de cache, écriture de cache, sortie), déterminez ensuite si la requête relève du contexte court ou du contexte long, puis appliquez enfin le multiplicateur du palier de service.
L’intérêt principal : une fois cet article lu, vous saurez estimer par vous-même le coût d’une requête ponctuelle et d’une tâche en mode Batch avec GPT-6.2 Astra, et vous saurez quels chiffres correspondent aux prix officiels et lesquels proviennent d’évaluations tierces — sans jamais mélanger les deux.
Points clés de la tarification de GPT-6.2 Astra
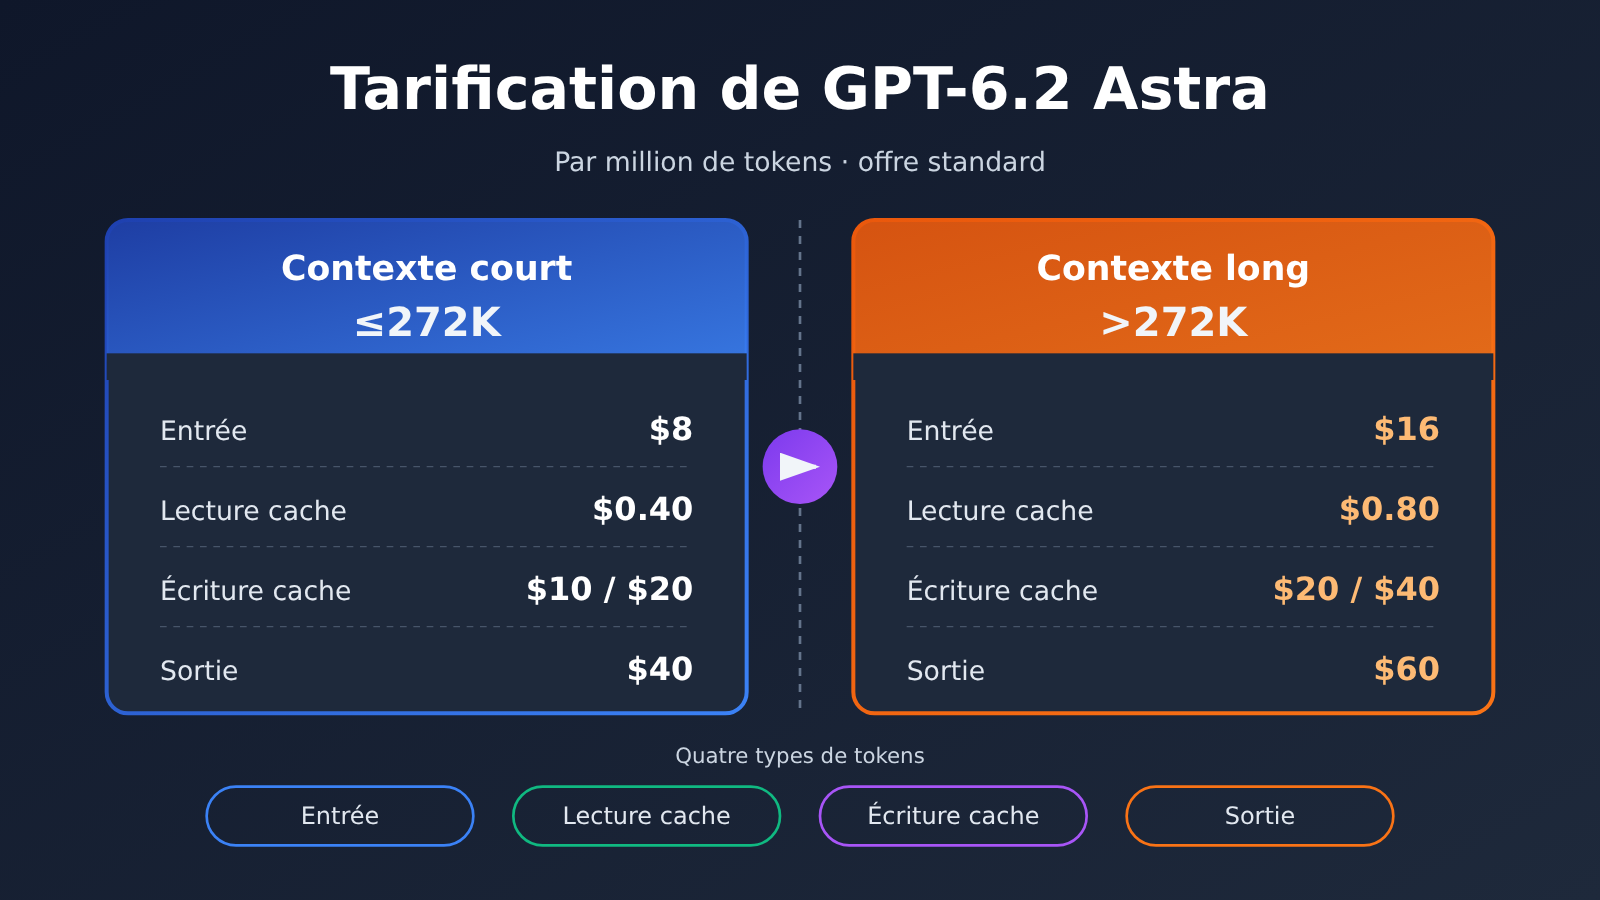
Mettons d’abord les règles à plat. Le tableau ci-dessous est établi à partir de la page officielle des modèles d’OpenAI (tarifs publiés par OpenAI elle-même) ; toutes les valeurs sont exprimées pour 1 million de tokens, tarif standard.
| Élément facturé | Contexte court (entrée ≤272K) | Contexte long (entrée >272K, facturation globale) | Remarque |
|---|---|---|---|
| Entrée | $8 | $16 | Prix d’entrée doublé en contexte long |
| Lecture du cache | $0.40 | $0.80 | Le tarif du cache est lui aussi doublé |
| Écriture dans le cache (conservé 30 minutes) | $10 | $20 | Catégorie cache, tarif doublé |
| Écriture dans le cache (conservé 12 heures) | $20 | $40 | Catégorie cache, tarif doublé |
| Sortie | $40 | $60 | Sortie facturée 1,5 fois le tarif du contexte court |
La colonne « contexte long » est déduite du libellé de la page officielle du modèle : lorsque l’entrée de la requête dépasse 272K tokens, les tarifs d’entrée et de cache sont doublés, la sortie est facturée 1,5 fois le tarif du contexte court, et le calcul porte sur la totalité de la requête. Autrement dit, ce n’est pas « seule la partie au-delà de 272K qui est doublée » : ce sont bien tous les tokens de la requête qui passent aux tarifs de la colonne de droite.
À ce jour, gpt-6.2-astra et gpt-6.2-sol n’apparaissent ni dans la liste générale des modèles d’APIYI (données au 2026-11-17 15:54, UTC+8) ni dans l’interface publique de tarification : ils ne sont pas encore référencés, nous mettrons ce modèle en ligne dès que possible ; les noms de modèles et les tarifs de référence sont ceux indiqués dans la liste des modèles de la plateforme. Avant toute intégration en conditions réelles, commencez par vérifier sur la liste des modèles d’apiyi.com leur disponibilité et leurs tarifs réellement affichés, puis appliquez la méthode de calcul décrite dans cet article.
Pourquoi compter séparément les quatre types de tokens de GPT-6.2 Astra
La facture d’une requête se compose généralement de quatre parties. L’entrée classique désigne la partie de l’invite qui, cette fois, n’a trouvé aucun cache existant et n’a pas été écrite dans le cache ; la lecture du cache correspond à la partie servie depuis un cache déjà présent, avec un prix unitaire équivalant à un vingtième de celui de l’entrée ; l’écriture dans le cache, c’est la partie de l’invite enregistrée dans le cache lors de cette requête, avec deux paliers de conservation, 30 minutes ou 12 heures ; la sortie, enfin, c’est le contenu généré par le modèle. GPT-6.2 Astra prend en charge les tokens de raisonnement : ceux générés pendant ce processus sont généralement comptabilisés côté sortie, la répartition exacte étant à vérifier dans le champ usage de la facture.
Les écarts entre les quatre prix unitaires sont importants : lecture du cache à $0.40, entrée à $8, écriture dans le cache à $10 ou $20, sortie à $40. Si vous facturez tous les tokens au prix de l’entrée, vous sous-estimez les tâches à forte production ; si vous négligez l’écriture dans le cache, le coût de la première invocation sera sous-compté. L’estimation doit donc d’abord ventiler les tokens, puis multiplier chaque catégorie par son prix.
Comment déterminer le seuil des 272K de GPT-6.2 Astra
Le critère à retenir est le nombre total de tokens d’entrée de la requête en cours ; la partie servie depuis le cache compte elle aussi dans l’entrée. Mieux vaut se référer à la documentation officielle et au champ usage réellement renvoyé. La fenêtre de contexte du modèle atteint 1 050 000 tokens, avec une entrée maximale de 922 000 et une sortie maximale de 128 000 : une requête à long contexte peut donc tout à fait être envoyée, il faut simplement la payer selon une autre grille tarifaire.
Voici une méthode pratique pour trancher : additionnez l’invite système, l’historique de la conversation, les documents récupérés et les résultats renvoyés par les outils. Si le total approche 272K, il faudra décider à l’avance s’il faut compresser le contexte, découper la demande en plusieurs requêtes, ou accepter que l’ensemble de la facture passe au palier tarifaire supérieur.
Comment appliquer les multiplicateurs de paliers de service de GPT-6.2 Astra
Le palier de contexte détermine le prix unitaire de base, et le palier de service détermine le multiplicateur à appliquer à ce prix de base. Le tableau ci-dessous provient également de la page officielle des modèles.
| Palier de service | Multiplicateur | Périmètre d’application | Points d’attention |
|---|---|---|---|
| Batch | 50 % du prix standard | Traitement par lots asynchrone | Idéal pour les gros volumes de tâches non urgents |
| Standard | ×1 | Par défaut | Base des deux exemples de cet article |
| Fast | ×2 | Prix standard pour une même longueur de contexte | Pour les requêtes à long contexte, appliquer le prix unitaire long contexte puis multiplier par 2 |
| Ultrafast | ×3 | Jusqu’au 2027-02-28 (heure du Pacifique) | Date limite à respecter |
| Ultrafast | ×6 | À partir du 2027-03-01 | Le budget doit être recalculé avec le nouveau multiplicateur |
Le périmètre du palier Fast est clairement défini sur la page des modèles : il correspond à 2 fois le « prix standard pour une même longueur de contexte ». Ainsi, pour une requête à long contexte passée en Fast, l’entrée coûte $16 × 2 = $32 et la sortie $60 × 2 = $120. Le multiplicateur d’Ultrafast s’applique selon la même logique, mais il faut porter une attention particulière au facteur temps : si le budget de votre projet couvre une période au-delà de mars 2027, la part Ultrafast devra être réestimée avec le multiplicateur ×6, sans reprendre le chiffre en ×3.
Il existe également une restriction indirectement liée aux coûts : l’API n’autorise pas à définir le paramètre reasoning effort sur none. Cela signifie que les tokens de raisonnement seront toujours présents ; lors de l’estimation du volume de sortie, il faut donc prévoir une marge pour le raisonnement, et ne pas se baser uniquement sur la longueur de la réponse finale.
Prise en main de GPT-6.2 Astra : deux exemples de calcul manuel
Les deux exemples ci-dessous ne font intervenir que des multiplications et des additions, et les prix unitaires sont tous exprimés « par million de tokens ». Le calcul de chaque ligne se résume donc à : « nombre de tokens × prix unitaire ÷ 1 000 000 ».
Exemple 1 : requête à contexte court avec GPT-6.2 Astra
Le scénario : un assistant de questions-réponses doté d’une longue invite système. Chaque requête totalise 100 000 tokens en entrée, dont 60 000 correspondant à l’invite système et aux extraits de connaissances, fixes d’une requête à l’autre — des candidats idéaux pour le cache ; les 40 000 restants sont du contenu utilisateur qui change à chaque requête ; la sortie (raisonnement inclus) atteint environ 5 000 tokens. Avec 100K en entrée totale, on reste sous la barre des 272K : c’est donc le tarif du contexte court qui s’applique.
| Poste de facturation | Première requête (écriture dans le cache de 30 min) | Requêtes suivantes (cache hit) |
|---|---|---|
| Entrée standard : 40 000 × 8 $ | 0,32 $ | 0,32 $ |
| Écriture dans le cache : 60 000 × 10 $ | 0,60 $ | — |
| Lecture du cache : 60 000 × 0,40 $ | — | 0,024 $ |
| Sortie : 5 000 × 40 $ | 0,20 $ | 0,20 $ |
| Total par requête | 1,12 $ | 0,544 $ |
On constate qu’après un cache hit, le coût par requête est presque divisé par deux, alors que la première écriture dans le cache coûte même plus cher que sans cache (sans cache : 100 000 × 8 $ = 0,80 $, soit 1,00 $ au total avec la sortie). Si vous optez plutôt pour une écriture dans un cache de 12 heures, cette ligne passe à 60 000 × 20 $ = 1,20 $ — ce n’est rentable que si le cache est sollicité à plusieurs reprises dans les 12 heures.
En partant de 0,544 $ par requête après cache hit, 1 000 requêtes coûtent environ 544 $. En appliquant ensuite les multiplicateurs de palier : environ 272 $ en Batch, environ 1 088 $ en Fast, environ 1 632 $ en Ultrafast jusqu’au 28 février 2027, puis environ 3 264 $ à partir du 1er mars 2027. Quant à la manière exacte dont Batch se cumule avec le cache côté débit, mieux vaut s’en tenir aux explications officielles de facturation ; les chiffres ci-dessus ne sont que des estimations approximatives basées sur les multiplicateurs.
Exemple 2 : requête long contexte au-delà de 272K avec GPT-6.2 Astra
Le scénario : charger un dépôt de code entier ou un lot de contrats dans le contexte pour les analyser. Une seule requête totalise 400,000 tokens en entrée, dont 300,000 sont servis depuis le cache et 100,000 sont des entrées standard, avec environ 8,000 tokens en sortie. L’entrée totale dépasse 272K : l’ensemble de la requête passe donc au tarif unitaire long contexte.
| Élément facturé | Calcul correct (long contexte sur toute la requête) | Calcul erroné (tout en court contexte) |
|---|---|---|
| Entrée standard 100,000 | × $16 = $1.60 | × $8 = $0.80 |
| Lecture du cache 300,000 | × $0.80 = $0.24 | × $0.40 = $0.12 |
| Sortie 8,000 | × $60 = $0.48 | × $40 = $0.32 |
| Total par requête | $2.32 | $1.24 |
L’écart entre les deux calculs frôle le simple au double. Une autre erreur fréquente consiste à « doubler uniquement les 128K qui dépassent le seuil de 272K », ce qui ne correspond pas davantage à la formulation « calcul sur l’ensemble de la requête » de la page du modèle. Il n’existe qu’une seule approche correcte : dès que le seuil est franchi, les entrées, les lectures de cache et les écritures de cache de cette requête sont facturées au double, et la sortie à 1,5 fois le tarif.
Sur cette base s’ajoutent ensuite les niveaux de service : Fast donne $2.32 × 2 = $4.64 ; Ultrafast coûte $6.96 jusqu’au 2027-02-28, puis $13.92 à partir du 2027-03-01 ; Batch tourne autour de $1.16. Si cette tâche s’exécute 200 fois par jour, le niveau Standard revient à environ $464 par jour, et en passant sur Ultrafast (après mars 2027) à environ $2,784 par jour — un écart suffisant pour changer de solution technique.
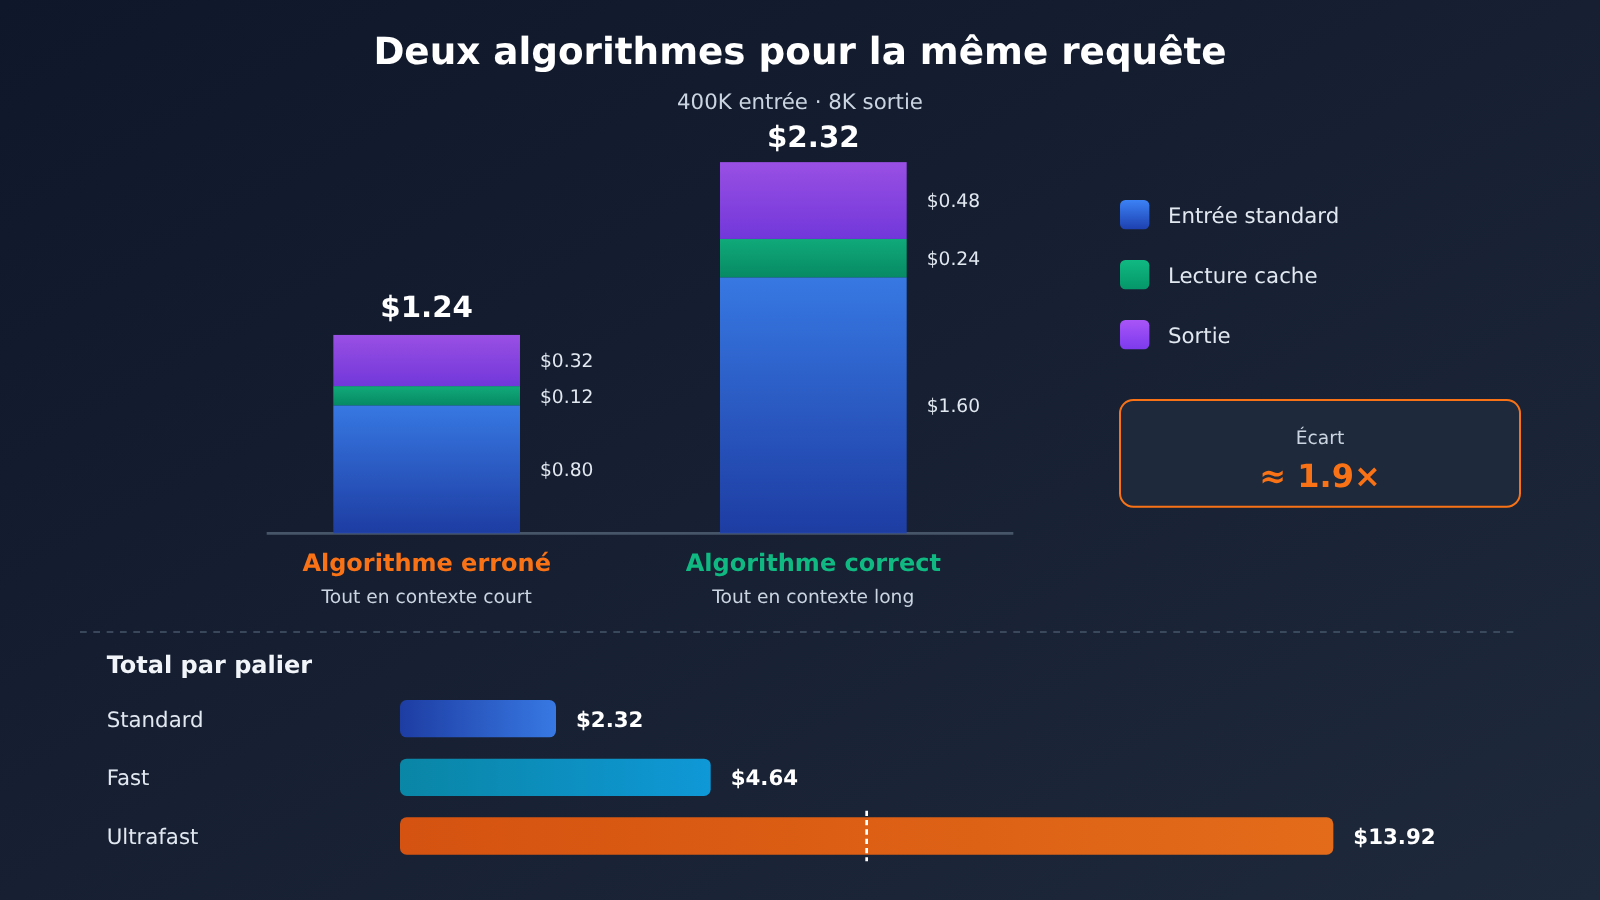
🎯 Conseil de tarification : remplacez les nombres de tokens des deux exemples ci-dessus par vos propres valeurs réelles et vous obtiendrez déjà une première estimation de votre budget. Les chiffres du graphique sont tous calculés à partir des tarifs officiels de la page du modèle OpenAI ; une fois GPT-6.2 Astra référencé sur APIYI, le prix unitaire réel à retenir sera celui indiqué dans la liste des modèles sur apiyi.com.
Étapes de préparation pour les appels via APIYI
gpt-6.2-astra n’est pas encore disponible pour le moment — nous l’ajouterons au catalogue dès que possible ; pour le nom exact du modèle et son tarif, référez-vous à la liste des modèles de la plateforme. Une fois en ligne, son intégration se fera exactement comme pour les autres modèles compatibles OpenAI. Vous pouvez déjà préparer les étapes suivantes :
- Créez une clé API dans la console APIYI et utilisez le quota de test gratuit offert aux nouveaux utilisateurs pour lancer vos premiers petits tests.
- Dans votre client, réglez
base_urlsurhttps://api.apiyi.com/v1et renseignezgpt-6.2-astracomme ID de modèle. - La page officielle du modèle indique qu’il prend en charge les endpoints Chat Completions et Responses, ainsi que Batch ; Realtime, Assistants, le fine-tuning, la génération d’images, la vidéo et la voix ne sont pas pris en charge — pour les flux nécessitant ces capacités, choisissez un autre modèle.
- Ne réglez pas l’effort de raisonnement sur
none, sinon l’API rejettera la requête ; commencez plutôt par un niveau bas et observez l’évolution des tokens de sortie. - Après chaque appel, récupérez le champ
usagede la réponse et enregistrez séparément l’entrée, les hits de cache et la sortie, puis reportez ces valeurs dans les tableaux de cet article pour vérifier les coûts.
🚀 Démarrage rapide : avant la mise en ligne, vous pouvez d’ores et déjà valider le fonctionnement de l’interface et la logique de statistiques
usageavec le modèle précédent déjà disponible,gpt-6-astra; une fois la version 6.2 en ligne, il vous suffira de remplacer l’ID du modèle.
Comparaison des tarifs affichés : GPT-6.2 Astra et modèles associés
Le tableau ci-dessous rapproche les tarifs officiels et les prix du catalogue général d’APIYI pour les modèles déjà disponibles, afin de faciliter la comparaison. Attention : ces deux sources sont distinctes — les tarifs officiels sont fixés par le fabricant, tandis que les prix plateforme correspondent au catalogue général d’APIYI (17 novembre 2026 à 15:54, UTC+8).
| Modèle | Entrée / Sortie / Lecture de cache (pour 1 million de tokens) | Source du tarif | Disponibilité |
|---|---|---|---|
| gpt-6.2-astra | $8 / $40 / $0.40 | Tarif officiel OpenAI | Pas encore disponible sur APIYI ; se référer à la liste des modèles de la plateforme |
| gpt-6.2-sol | $2 / $10 / $0.10 | Tarif officiel OpenAI | Pas encore disponible sur APIYI ; se référer à la liste des modèles de la plateforme |
| gpt-6-astra (génération précédente) | $10 / $50 / $1 ; au-delà de 272 000 tokens en entrée : $20 | Catalogue général APIYI | Disponible sur APIYI (apiyi.com) |
| gpt-6.1-sol | $2 / $10 / $0.1 ; au-delà de 272 000 tokens en entrée : $4 | Catalogue général APIYI | Disponible sur APIYI |
| gemini-4-carbon | $2 / $10 / $0.1 (tarif de lancement) | Catalogue général APIYI | Disponible sur APIYI |
À propos de GPT-6.2 Sol : au tarif standard officiel en contexte court, il est affiché à $2 en entrée, $0.10 en lecture de cache, $2.50 en écriture de cache 30 minutes, $5 en écriture de cache 12 heures et $10 en sortie. La règle de facturation globale au-delà de 272K ainsi que les multiplicateurs par palier sont identiques à ceux d’Astra. Ce modèle n’est pas encore référencé, mais nous l’ajouterons à la plateforme dès que possible ; le nom des modèles et les tarifs affichés dans la liste des modèles de la plateforme font foi.
Quand vous comparez avec gpt-6-astra, gardez en tête qu’il s’agit de la génération précédente : dans le catalogue général d’APIYI, il est affiché à $10 en entrée, $50 en sortie et $1 en lecture de cache. Selon l’annonce officielle, GPT-6.2 Astra coûte 20 % moins cher en entrée comme en sortie que GPT-6 Astra, et 60 % moins cher en entrée avec cache — ce qui colle parfaitement aux chiffres $8 / $40 / $0.40. Ne prenez donc pas les prix plateforme de gpt-6-astra ou de gpt-6.1-sol pour ceux de la version 6.2.
Autre point temporel à retenir pour Gemini 4 Carbon : au palier standard officiel de Google, le tarif est de $2 en entrée et $10 en sortie jusqu’au 30 novembre 2026 ; à partir du 1er décembre 2026, il passe à $4 en entrée et $20 en sortie. La page de présentation d’APIYI mentionne pour l’instant le tarif de lancement ; après le 1er décembre, la liste des modèles de la plateforme fera foi pour connaître les prix réels. Par ailleurs, la grille tarifaire de Google ne comporte pas de ligne « facturation doublée au-delà de 272K » : lors d’une comparaison entre fournisseurs, n’appliquez donc pas les règles de contexte long de GPT-6.2 aux autres modèles.
💡 Conseil de choix : pour une même charge de travail, la consommation de tokens varie d’un modèle à l’autre — un prix unitaire bas ne garantit pas une facture plus légère. Nous vous recommandons d’invoquer plusieurs modèles déjà disponibles sur APIYI avec le même lot d’échantillons, de calculer le coût total d’après l’usage réel, puis de décider.
Comment interpréter les données officielles et tierces de GPT-6.2 Astra
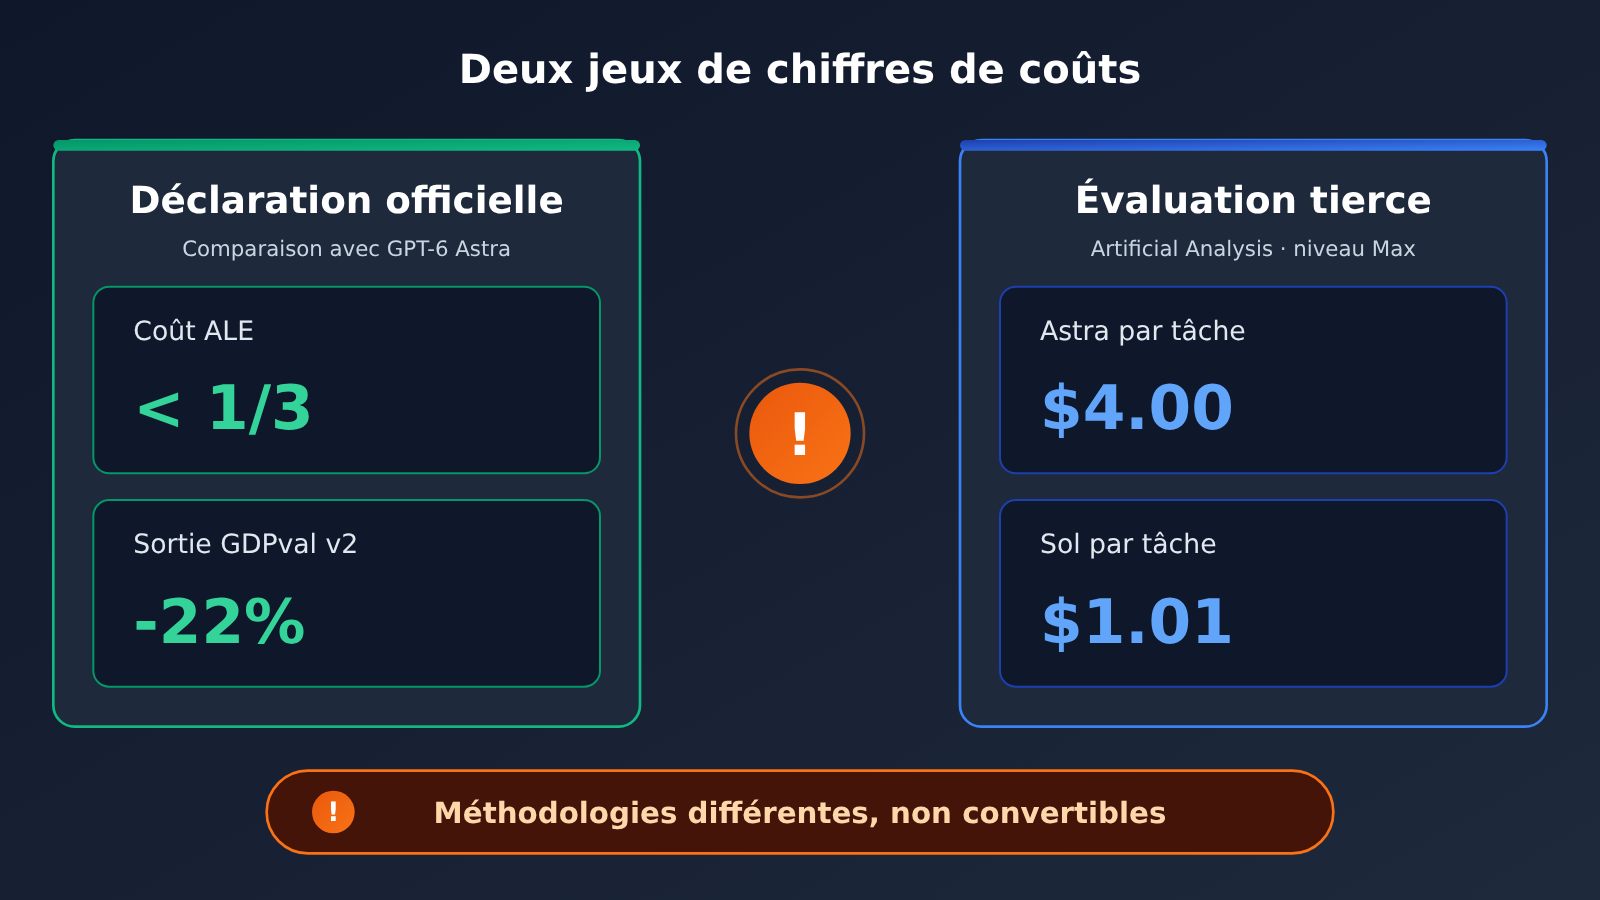
Pour estimer une facture, seul le prix affiché compte, mais beaucoup citent au passage le « coût par tâche » : il faut alors savoir distinguer les sources.
Auto-déclaration officielle : dans son annonce, OpenAI indique que sur Agents’ Last Exam, GPT-6.2 Astra obtient 5.2 points de plus que GPT-6 Astra avec un coût inférieur à un tiers ; et que sur le GDPval v2 interne, il dépasse GPT-6 Astra de 6.2 points de pourcentage, avec 22 % de tokens de sortie en moins. Ce sont des chiffres avancés par OpenAI sur des tâches qu’elle a choisies elle-même : ils montrent que la consommation de tokens baisse sur ces tâches, mais on ne peut pas les convertir directement en coût pour votre activité.
Sources tierces : sur son Intelligence Index v5.0.1, Artificial Analysis mesure un coût par tâche d’environ $4.00 pour GPT-6.2 Astra (palier de raisonnement Max) au sein de son indice composite, et d’environ $1.01 pour GPT-6.2 Sol (également au palier Max). Il s’agit d’une moyenne calculée sur son propre ensemble de tâches d’évaluation, au palier de raisonnement le plus élevé : ce n’est ni le prix unitaire de GPT-6.2 Astra, ni la garantie que vos tâches coûteront $4.00 à chaque exécution. Réduire le palier de raisonnement modifie sensiblement la consommation de tokens, et les scores des paliers High, Medium et Low publiés en parallèle diffèrent eux aussi.
Ces deux séries de chiffres reposent sur des tâches, des paliers de raisonnement et des méthodes de mesure différents : mieux vaut ne pas les convertir l’une dans l’autre ni les fusionner en une seule conclusion. Pour estimer votre propre facture, revenez simplement aux trois étapes : « décomposer les tokens, déterminer le seuil, multiplier par le coefficient ».
Questions fréquentes (FAQ)
Q1 : Quel est le prix standard de GPT-6.2 Astra ?
Selon la page officielle du modèle d’OpenAI, le tarif standard en contexte court, par million de tokens, est le suivant : entrée 8 $, lecture du cache 0,40 $, écriture de cache 30 min 10 $, écriture de cache 12 h 20 $, sortie 40 $. Le modèle n’est pas encore disponible sur notre plateforme ; nous l’ajouterons dès que possible. Seule la liste des modèles de la plateforme fait foi pour le nom et les tarifs.
Q2 : Au-delà de 272K, la majoration s’applique-t-elle uniquement à la partie excédentaire ?
Non. La page du modèle précise que le calcul se fait sur la requête entière : lorsque l’entrée d’une requête dépasse 272K tokens, les prix unitaires d’entrée et de cache de cette requête sont doublés, et la sortie est facturée 1,5 fois le tarif du contexte court. Dans le second exemple, la même requête coûte 2,32 $ avec le calcul correct, contre seulement 1,24 $ si tout était facturé au tarif contexte court.
Q3 : À quel moment le multiplicateur d’Ultrafast change-t-il ?
Jusqu’au 28 février 2027 (heure du Pacifique), il est de 3 fois le prix standard ; à partir du 1er mars 2027, il passe à 6 fois. Pour budgétiser des projets à long terme, comptez séparément, au multiplicateur de 6, la consommation Ultrafast postérieure à mars.
Q4 : Dans quels scénarios fait-on le plus facilement une erreur sur les coûts de GPT-6.2 Astra ?
– **Analyse de dépôts de code** : injecter tout un dépôt d’un seul coup fait très facilement dépasser 272K, et la requête entière bascule sur le palier supérieur.
– **Tâches d’agent en plusieurs tours** : l’historique de conversation et les résultats d’outils s’accumulent sans cesse, et les requêtes des derniers tours peuvent franchir le seuil sans que vous vous en rendiez compte.
– **Première écriture dans le cache** : au premier appel, le prix unitaire d’écriture de cache est supérieur à celui d’une entrée classique ; le coût de démarrage à froid doit être calculé à part.
– **Requêtes long contexte avec Fast ou Ultrafast activé** : les deux facteurs de majoration se multiplient entre eux.
Q5 : Comment appeler GPT-6.2 Astra via APIYI ?
`gpt-6.2-astra` n’est pas encore disponible ; nous l’ajouterons dès que possible, et seule la liste des modèles de la plateforme fait foi pour le nom et les tarifs. En attendant, vous pouvez vous inscrire sur apiyi.com et réclamer un crédit d’essai gratuit, puis valider vos appels Responses ou Chat Completions ainsi que les statistiques d’usage avec le modèle déjà en ligne `gpt-6-astra` (entrée 10 $, sortie 50 $, lecture du cache 1 $). Une fois le nouveau modèle disponible, il suffira de remplacer l’ID du modèle.
Q6 : Peut-on utiliser les 4,00 $ d’Artificial Analysis comme prix unitaire ?
Non. Il s’agit du coût moyen par tâche calculé par un tiers sur l’ensemble de tâches de l’Intelligence Index, avec l’effort de raisonnement Max ; il ne reflète que la consommation moyenne de ce lot de tâches. La longueur de vos tâches, votre taux de hit du cache et votre effort de raisonnement sont différents : vos coûts doivent être recalculés à partir des prix unitaires officiels.
Q7 : Quelles limitations connues de GPT-6.2 Astra peuvent impacter les coûts ?
L’effort de raisonnement ne peut pas être réglé sur `none` : impossible d’économiser totalement les tokens de raisonnement ; seules les entrées texte et image avec sortie texte sont prises en charge, ni l’audio ni la vidéo ; Realtime, Assistants et le fine-tuning ne sont pas disponibles. La system card officielle mentionne par ailleurs que, dans certains tests, le modèle a plus tendance à omettre de signaler les problèmes bloquants (comme des fichiers manquants) ; dans un flux d’agent, chaque relance supplémentaire se traduit par une facturation en plus, et l’invite doit donc exiger du modèle qu’il signale clairement ce type de situation.
Points clés de la tarification de GPT-6.2 Astra
- Quatre catégories à calculer séparément : les prix unitaires de l’entrée, de la lecture du cache, de l’écriture du cache et de la sortie varient fortement, il faut les multiplier individuellement.
- 272K est un seuil qui s’applique à toute la requête : au-delà, les entrées et le cache passent à ×2 et les sorties à ×1.5 — et non la seule partie excédentaire.
- Les paliers se cumulent : Batch à moitié prix, Fast ×2 pour une même longueur de contexte, Ultrafast se calcule à part.
- Ultrafast a une date limite : ×3 jusqu’au 2027-02-28 (PT), puis ×6 à partir du 2027-03-01.
- Le cache : cher au début, rentable ensuite : la première écriture coûte plus cher que le prix d’entrée, mais une fois le cache touché, le coût par requête peut être presque divisé par deux.
- Ne mélangez pas les référentiels : les chiffres auto-déclarés par l’éditeur comme les coûts de tâche unique mesurés par des tiers ne sont pas des prix unitaires.
- La liste des modèles fait foi : les deux versions 6.2 ne sont pas encore disponibles sur APIYI ; commencez par valider le processus avec le modèle précédent.
En résumé
La tarification de GPT-6.2 Astra se résume en trois étapes :
- Décomposez les tokens : séparez chaque requête en entrée standard, lecture de cache, écriture de cache et sortie ; les tokens de raisonnement comptent côté sortie.
- Vérifiez le seuil : si le volume total d’entrée de la requête dépasse 272K, toute la requête bascule sur les prix unitaires long contexte, avec entrées et cache ×2 et sorties ×1.5.
- Appliquez les multiplicateurs : choisissez le coefficient selon Batch, standard, Fast ou Ultrafast ; attention, Ultrafast passe à ×6 à partir du 2027-03-01.
Pour préparer votre budget, reprenez les tableaux des exemples 1 et 2 en y injectant vos propres volumes de tokens, puis faites le calcul deux fois : une fois au tarif standard et une fois au palier accéléré que vous comptez utiliser. L’écart est souvent plus important qu’on ne l’imagine. GPT-6.2 Astra et GPT-6.2 Sol ne sont pas encore disponibles sur APIYI ; nous mettrons ces modèles en ligne dès que possible. Les références et les prix font foi dans la liste des modèles de la plateforme. D’ici là, vous pouvez déjà mettre en place sur apiyi.com le suivi des statistiques d’usage et le processus de vérification des coûts, en vous appuyant sur les crédits gratuits et les modèles déjà disponibles.
📚 Références
-
Article d’annonce d’OpenAI : notes de publication de GPT-6.2 Astra et Sol
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol - Description : aperçu des tarifs standards et données de capacités déclarées officiellement par OpenAI
- Lien :
-
Page du modèle OpenAI – gpt-6.2-astra : spécifications et règles de tarification complètes
- Lien :
platform.openai.com/docs/models/gpt-6.2-astra - Description : prix d’écriture en cache, règle des 272K appliquée à l’ensemble de la requête, multiplicateurs Batch/Fast/Ultrafast — c’est la source qui fait foi
- Lien :
-
Page du modèle OpenAI – gpt-6.2-sol : spécifications et prix affichés de Sol
- Lien :
platform.openai.com/docs/models/gpt-6.2-sol - Description : prix standard de Sol pour les contextes courts et les mêmes règles de facturation
- Lien :
-
Carte système d’OpenAI : évaluations de sécurité et d’alignement
- Lien :
deploymentsafety.openai.com/gpt-6-2-astra-sol - Description : limitations connues, notamment le problème d’omissions bloquantes
- Lien :
-
Article d’évaluation d’Artificial Analysis (tierce partie) : résultats de l’Intelligence Index
- Lien :
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Description : données tierces, comme le coût par tâche du niveau de raisonnement Max
- Lien :
-
APIYI – Tableau des modèles et interface de tarification : modèles disponibles et prix affichés sur la plateforme
- Lien :
docs.apiyi.com/models.mdetapi.apiyi.com/api/pricing - Description : la disponibilité des deux modèles 6.2 et les prix des modèles de comparaison y sont référencés
- Lien :
Auteur : Équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources d’intégration, rendez-vous sur le centre de documentation docs.apiyi.com


