
Note de l’auteur : d1.2-ultra apparaît en 1re position sur Decision Index v2.1. Cet article vous apprend d’abord à identifier la nature de votre tâche — extraire des documents, appeler des outils ou répondre à des questions difficiles —, à ne regarder que la sous-catégorie pertinente, puis à décider s’il faut changer de modèle avec 20 à 50 échantillons de votre propre production.
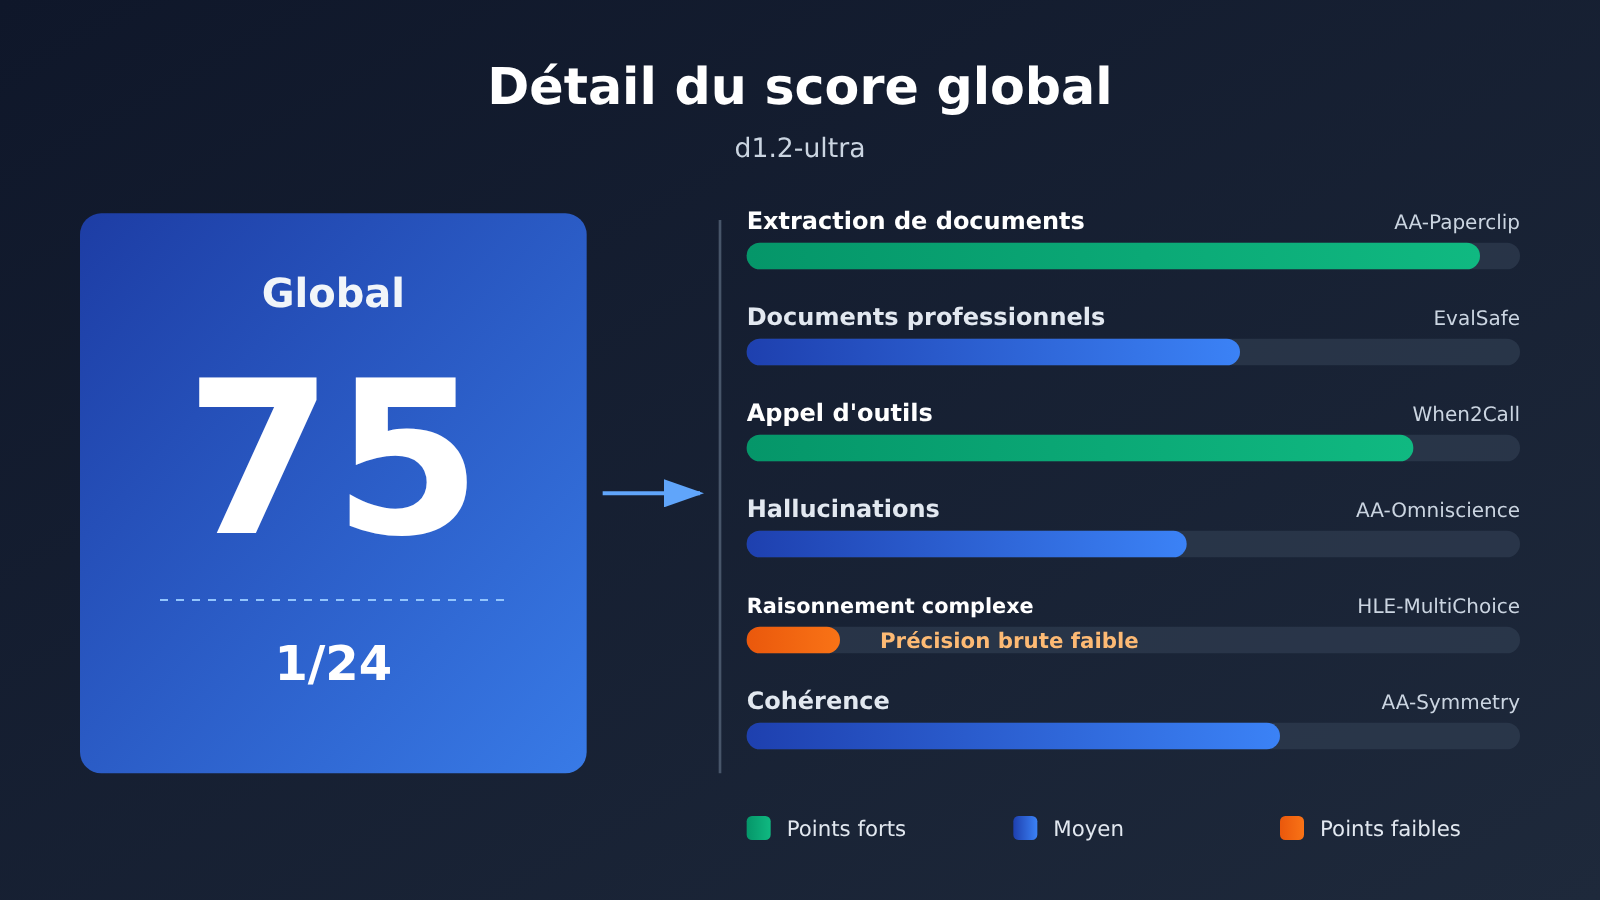
Le 16 novembre 2026, Liquid AI a publié d1.2 et d1.2-ultra. Selon le blog officiel, d1.2-ultra obtient un score de 75 sur l’Artificial Analysis Decision Index v2.1, le plus élevé parmi les modèles de décision. Beaucoup de développeurs en train d’intégrer des API, en voyant « n° 1 », ont eu pour première réaction de remplacer leur modèle de production. Ne vous précipitez pas : le score global de 75 n’est qu’un prétexte, ce qu’il faut vraiment regarder, c’est le score de la sous-catégorie qui correspond à votre activité.
Cet article n’est ni une critique ni une promotion. Un même modèle peut être n° 1 en extraction de documents et afficher, sur des questions à choix multiples difficiles, la précision brute la plus faible des 24 modèles de décision. Les deux constats sont vrais en même temps, et le score global les gomme.
Ce que vous allez y gagner : à la fin de cet article, vous saurez quelle sous-catégorie consulter, comment lire le score de décision et la précision brute, et comment trancher en un après-midi, avec vos propres 20 à 50 échantillons, pour savoir s’il faut changer de modèle.
Les points clés du classement général de d1.2-ultra
Commençons par poser les chiffres de la page du classement. Les données ci-dessous proviennent de la page du modèle d1.2-ultra sur Artificial Analysis, relevées le 2026-11-17, avec 24 modèles de décision comparés.
| Élément | Données de la page du classement | Comment les lire |
|---|---|---|
| Indice global | 74.85, affiché 75 sur la page, 1er sur 24 | Le 2e, Drex Max v1.1, est à 72.62, soit environ 2.2 points d’écart : c’est exactement la même chose que les « deux points » annoncés officiellement, juste arrondie |
| Durée | 218 ms par tâche, 14e sur 24 | La médiane de la page est de 209 ms, donc on est dans la moyenne |
| Coût pour boucler l’indice | 133 USD par million de tâches, 11e sur 24 | C’est un coût par tâche, pas le prix affiché au million de tokens |
| Prix d’entrée | 0.042 USD par million de tokens | Conforme au blog officiel de Liquid, qui ne compte que l’entrée |
| Brier | 0.150, le plus bas des 24 | Plus c’est bas, mieux c’est : cela montre que les probabilités annoncées sont plutôt « honnêtes » |
Comment se construit le score global de d1.2-ultra
Decision Index v2.1 est une moyenne pondérée de six sous-composantes. La définition du score de décision sur la page du modèle est la suivante : le taux d’exactitude moins le score de Brier de la probabilité de la réponse choisie, sur une échelle de 0 à 100, où plus c’est élevé, mieux c’est. Autrement dit, se tromper avec assurance coûte plus cher que se tromper en hésitant. Le taux d’exactitude brut, lui, correspond à la proportion de questions pour lesquelles le modèle attribue sa probabilité la plus élevée à la bonne option : ce n’est pas le même chiffre que le score de décision.
Cette distinction change directement la façon de lire d1.2-ultra. Un modèle peut, en refusant souvent de deviner et en commettant peu d’erreurs assurées, obtenir un score de décision pas trop mauvais tout en ayant un taux d’exactitude brut très faible. Si votre activité exige « une réponse dans tous les cas », c’est le taux d’exactitude brut qu’il faut regarder ; si elle permet de « passer à un humain en cas de doute », le score de décision est plus pertinent.
| Sous-composante | Poids | Ce qu’elle mesure | Catégorie AA |
|---|---|---|---|
| AA-Paperclip | 30% | Jugement et extraction de documents, 15 réponses par document comptant pour un jugement | Documents |
| EvalSafe-O*NET-AA | 15% | Jugement de documents professionnels | Documents |
| When2Call | 10% | Appel d’outils | Outils |
| AA-Omniscience-Decision v1.1 | 15% | Connaissances et hallucinations | Connaissances |
| HLE-MultiChoice v1.1 | 15% | QCM textuel Humanity’s Last Exam, avec possibilité de refuser de répondre | Raisonnement |
| AA-Symmetry v1.1 | 15% | Vérifie si le jugement reste identique après reformulation, changement de l’ordre des options ou négation | Cohérence |
À noter : chez AA, HLE-MultiChoice est classé en raisonnement, pas en connaissances. Donc quand on le mentionne plus bas, il ne faut pas l’écrire comme un « test de connaissances ».
Comment faire correspondre le score de d1.2-ultra au bon indicateur
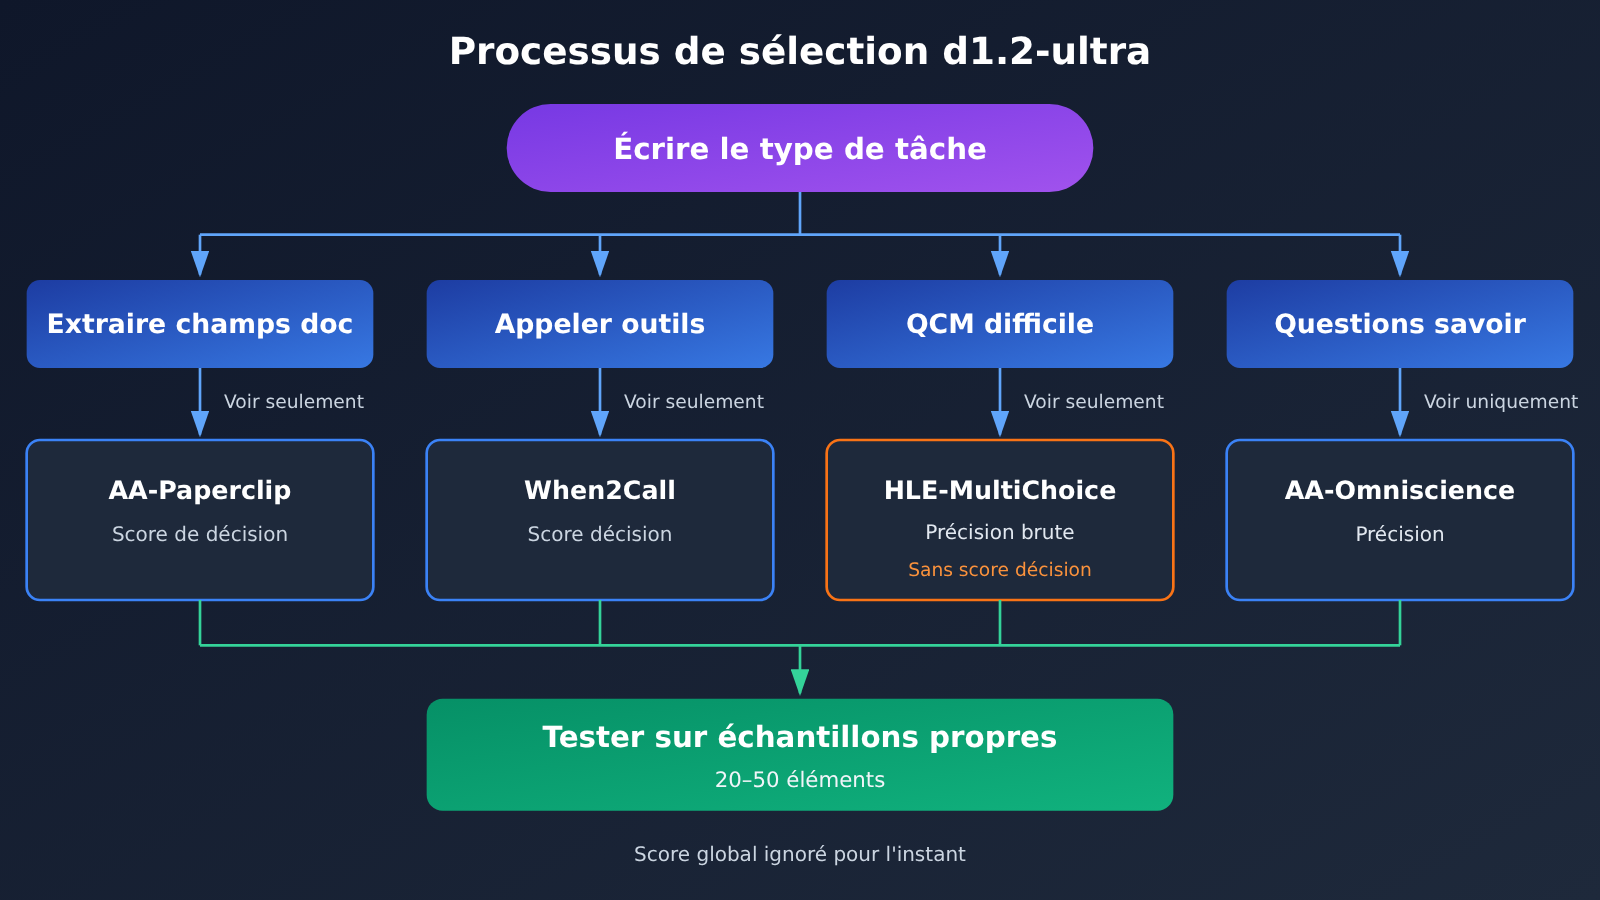
La première étape n’est pas de regarder le classement, mais de prendre une feuille et de noter à quelle catégorie appartient réellement votre travail : extraire des données de documents, appeler des outils, répondre à des questions difficiles, ou répondre à des questions de connaissances. Une fois cela fait, ne regardez que l’indicateur qui correspond, et ignorez pour l’instant les autres sous-scores ainsi que le score global de 75.
| Ce que vous devez faire | Le seul indicateur à regarder | Données de la page de classement de d1.2-ultra | Comment l’interpréter |
|---|---|---|---|
| Extraire des champs de factures, CV, articles | AA-Paperclip | Score de décision 75,81 ; taux de documents entièrement corrects 67,7 % ; les deux indicateurs sont classés 1/24 | Le 2e, Drex Max v1.1, est à 72,82 et 63,0 % ; l’avance est assez nette |
| Appeler des outils, décider s’il faut les appeler | When2Call | Score de décision 96,49, 1er | SubQ Snap 1.2 est à 96,10, d1.2 à 96,09 ; les premiers se tiennent dans environ 1 point |
| Juger des documents professionnels | EvalSafe-O*NET-AA | Score de décision 89,53, 3e | Devant : Jev 1.14 (91,14) et GLiDE v1.2 (89,67) |
| Répondre à des questions à choix multiples très difficiles | Précision brute de HLE-MultiChoice | 2,36 %, la plus basse parmi 24 modèles de décision | Le score de décision de 46,36 n’est pas dernier ; le taux de non-hallucination est de 76,1 % ; il choisit souvent de ne pas deviner |
| Questions de connaissances | Précision d’AA-Omniscience | Précision brute 23,6 %, 20e sur 24 | Score de décision 60,80, 6e ; taux de non-hallucination 83,8 % |
| Stabilité de la réponse après reformulation | Taux de pleine réussite d’AA-Symmetry | Score 86,34, 2e ; taux de pleine réussite 56,7 %, 5e | Être deuxième au score ne signifie pas être deuxième en stabilité |
Les deux points les plus faciles à mal interpréter dans les sous-scores de d1.2-ultra
Le premier, c’est HLE-MultiChoice. Le taux de précision brut de 2.36 % est bien le plus bas des 24 modèles de décision, mais son score de décision de 46.36 n’est pas le dernier : sur la même page, il y en a de plus bas, par exemple Mercury Decide à 34.79. Si on y ajoute un taux de non-hallucination de 76.1 %, la lecture raisonnable est la suivante : face à des questions à choix multiples de raisonnement très difficiles, d1.2-ultra a tendance à ne pas fournir de réponse à haute confiance. AA classe cet élément dans le raisonnement ; on ne peut donc pas le présenter comme « dernier au test de connaissances ».
Le second, c’est AA-Omniscience. Son taux de précision de 23.6 % le place à la 20e position sur 24, et non en dernière place. Fait intéressant : le plus petit d1.2, sur la même page, affiche 30.0 % sur cet élément, et son taux de précision brut sur HLE atteint 5.30 % ; les deux dépassent ultra. Mais l’indice global de d1.2 est de 68.69, pour une 9e place sur 24. Donc « l’ultra plus cher a de moins bonnes connaissances » ne vaut que pour ces deux éléments ; on ne peut pas en conclure qu’il est globalement moins bon.
🎯 Conseil pour la lecture du classement : si votre travail consiste à extraire des documents, la 1re place de
d1.2-ultrasur AA-Paperclip mérite d’être prise au sérieux ; s’il s’agit d’appels d’outils, la 1re place est bien réelle, mais l’écart avec les suivants est inférieur à 1 point — reste à voir si le changement en vaut la peine, en fonction de votre propre échantillon.
Comment utiliser les données communiquées par d1.2-ultra
Dans le même article de blog, Liquid présente aussi cinq nouvelles tâches et les résultats de tests internes. La société précise que ces nouvelles tâches ne sont pas encore couvertes par des benchmarks publics : les chiffres ci-dessous sont donc tous déclarés par l’éditeur, obtenus sur un ensemble de validation interne réservé, et non des scores d’Artificial Analysis.
| Nouvelle tâche (déclarée par l’éditeur) | d1.2-ultra | d1.2 | Remarques |
|---|---|---|---|
| Lecture de tickets de caisse (CORD, SROIE) | 98% | 96% | répond « not found » lorsqu’une valeur est absente |
| Détection des segments d’informations sensibles (Nemotron PII), précision/rappel | 94% / 93% | 92% / 88% | indique la position de chaque segment |
| Localisation d’objets à partir d’une description (série RefCOCO) | 94% | 94% | les deux modèles sont à égalité |
| Comptage d’objets avec une tolérance de 1 (COCO) | 93% | 92% | estime un nombre et donne une fourchette |
| Identification de chaque objet dans l’image (COCO) | 87% | 90% | ici, le d1.2, moins cher, fait mieux |
Côté audio, Liquid indique que, sur des enregistrements réservés à la validation, la classification des catégories sonores (ESC-50) et l’identification de la langue (FLEURS, 43 langues) placent les deux modèles autour de 95 % à 97 %. Pour l’erreur de calibration, Liquid a mesuré, sur 13 benchmarks et 22505 questions, d1.2-ultra à 0.8, d1.2 à 1.2, Jev 1.14 à 2.7, Perplexity Decider v1.3 à 3.7 et l’API Decisions de GPT-6 Luna à 7.2.
Il faut bien faire la distinction : GPT-6 Luna (Decisions) affiche un indice composite de 60.25 dans le classement Decisions d’Artificial Analysis, se classe 22e sur 24 et obtient un taux de précision brut de 7.86 % sur HLE. Tous ces résultats concernent l’endpoint Decisions et ne doivent pas être pris pour ceux de l’endpoint de chat gpt-6-luna. Le blog officiel mentionne aussi « Coming to OpenRouter and Vercel soon » : c’est une annonce de l’éditeur, pas une mise en ligne déjà effective.
Prise en main rapide de d1.2-ultra : testez avec vos propres échantillons
Une fois les classements parcourus, ce qui décide vraiment d’un changement de modèle, ce sont vos propres données. 20 à 50 échantillons réels suffisent : par exemple 30 factures ou 30 CV, chacun annoté à l’avance avec les bonnes valeurs de champs — et il vaut mieux que quelques-uns soient volontairement privés d’un champ.
La procédure, version minimaliste
- Choisissez 20 à 50 échantillons dans votre activité, annotez à la main la valeur correcte de chaque champ, et marquez les champs absents comme not found.
- Rédigez une invite fixe : demandez au modèle de produire les champs indiqués au format JSON, avec
not foundobligatoire pour tout champ introuvable, sans aucune inférence. - Avec le SDK compatible OpenAI, réglez
base_urlsurhttps://api.apiyi.com/v1,modeld’abord surgpt-6-luna, puis relancez avecgpt-6.1-sol. - Comparez ligne par ligne et relevez trois chiffres : la précision au niveau des champs, le taux de documents entièrement corrects, et le nombre de champs manquants remplis n’importe comment.
- Quand le modèle cible sera appelable, refaites un passage avec la même série d’échantillons et la même invite, et comparez directement les trois chiffres.
Voir la méthode de comparaison complète
– **Entrée** : un fichier d’échantillons, chaque ligne contenant le texte source (ou l’image) et un dictionnaire de champs annotés manuellement.
– **Appel** : on parcourt les échantillons en boucle et on appelle `client.chat.completions.create` ou le point de terminaison `responses`, avec `temperature` à 0 et une exigence de sortie JSON stricte.
– **Analyse** : les échecs de parsing de la sortie sont comptés séparément — c’est en soi un indicateur de disponibilité.
– **Comparaison** : comparaison champ par champ après normalisation (suppression des espaces, format de date unifié, montants à deux décimales).
– **Comptage des hallucinations** : les champs annotés not found que le modèle a malgré tout remplis d’une valeur sont consignés à part comme « devinettes ».
– **Récapitulatif** : on sort la précision par champ, le taux de documents entièrement corrects, le nombre de devinettes et la consommation moyenne de tokens, pour pouvoir calculer le coût ensuite.
Établir d’abord une base avec APIYI
Cette opération consomme des tokens. d1.2 et d1.2-ultra ne figurent pas dans la liste des modèles d’APIYI : vous pouvez donc commencer sur APIYI (apiyi.com) avec gpt-6.1-sol ou gpt-6-luna, déjà en place, à l’adresse d’appel https://api.apiyi.com/v1, et faire passer la même série de factures ou de CV pour voir si les champs sont corrects et si les champs absents sont inventés. Vous disposez ainsi d’une base quantifiable.
Pas encore disponible : nous publierons ce modèle dès que possible ; les modèles et les prix font foi sur la liste de la plateforme.
| Point d’auto-contrôle | Comment le noter | Critère d’évaluation |
|---|---|---|
| Précision des champs | champs corrects / total des champs | à comparer au modèle de production actuel |
| Taux de documents entièrement corrects | part des documents dont tous les champs sont corrects | correspond au « document-level accuracy » d’AA-Paperclip |
| Nombre de devinettes | nombre de champs not found remplis d’une valeur | le moins possible, dans l’esprit du taux de non-hallucination |
| Échecs de parsing | nombre de lignes dont le JSON est inexploitable | impacte directement le coût de mise en production |
| Consommation de tokens | tokens moyens en entrée et en sortie par ligne | sert à convertir en coût réel |
🚀 Conseil de démarrage : commencez avec les crédits d’essai gratuits pour nouveaux utilisateurs d’APIYI (apiyi.com) sur 20 lignes, vérifiez que l’invite et le script de comparaison fonctionnent, puis élargissez à 50 — histoire de ne pas brûler vos crédits en mise au point dès le départ.
d1.2-ultra : le prix et le mode d’invocation
Côté prix, il faut bien distinguer les unités. Les 133 dollars affichés dans le classement correspondent à un coût de benchmark « par million de tâches », tandis que le tarif officiel de Liquid s’exprime « par million de tokens d’entrée » : 0.02 dollar pour d1.2 et 0.042 dollar pour d1.2-ultra, et seule l’entrée est facturée. Les images sont comptées à raison de 1.5 token par bloc de 32×32 pixels, au tarif du texte, soit environ 1536 tokens pour du 1024×1024 ; le texte et les images d’une même requête ne sont comptés qu’une fois, et poser une question supplémentaire n’ajoute que le texte de cette question.
Le mode d’invocation officiel change aussi des interfaces de chat habituelles : les ID de modèle sont d1.2-ultra et d1.2, l’adresse est https://api.liquid.ai/decisions/v1/systemone, et la clé API se demande dans la console Liquid. Le blog officiel mentionne des entrées texte, image et audio ; la fiche technique de la page Artificial Analysis indique pour sa part texte et image, avec une fenêtre de contexte de 66k — ce chiffre n’apparaît que sur la page du classement, il ne fait pas partie des spécifications publiées dans le blog Liquid.
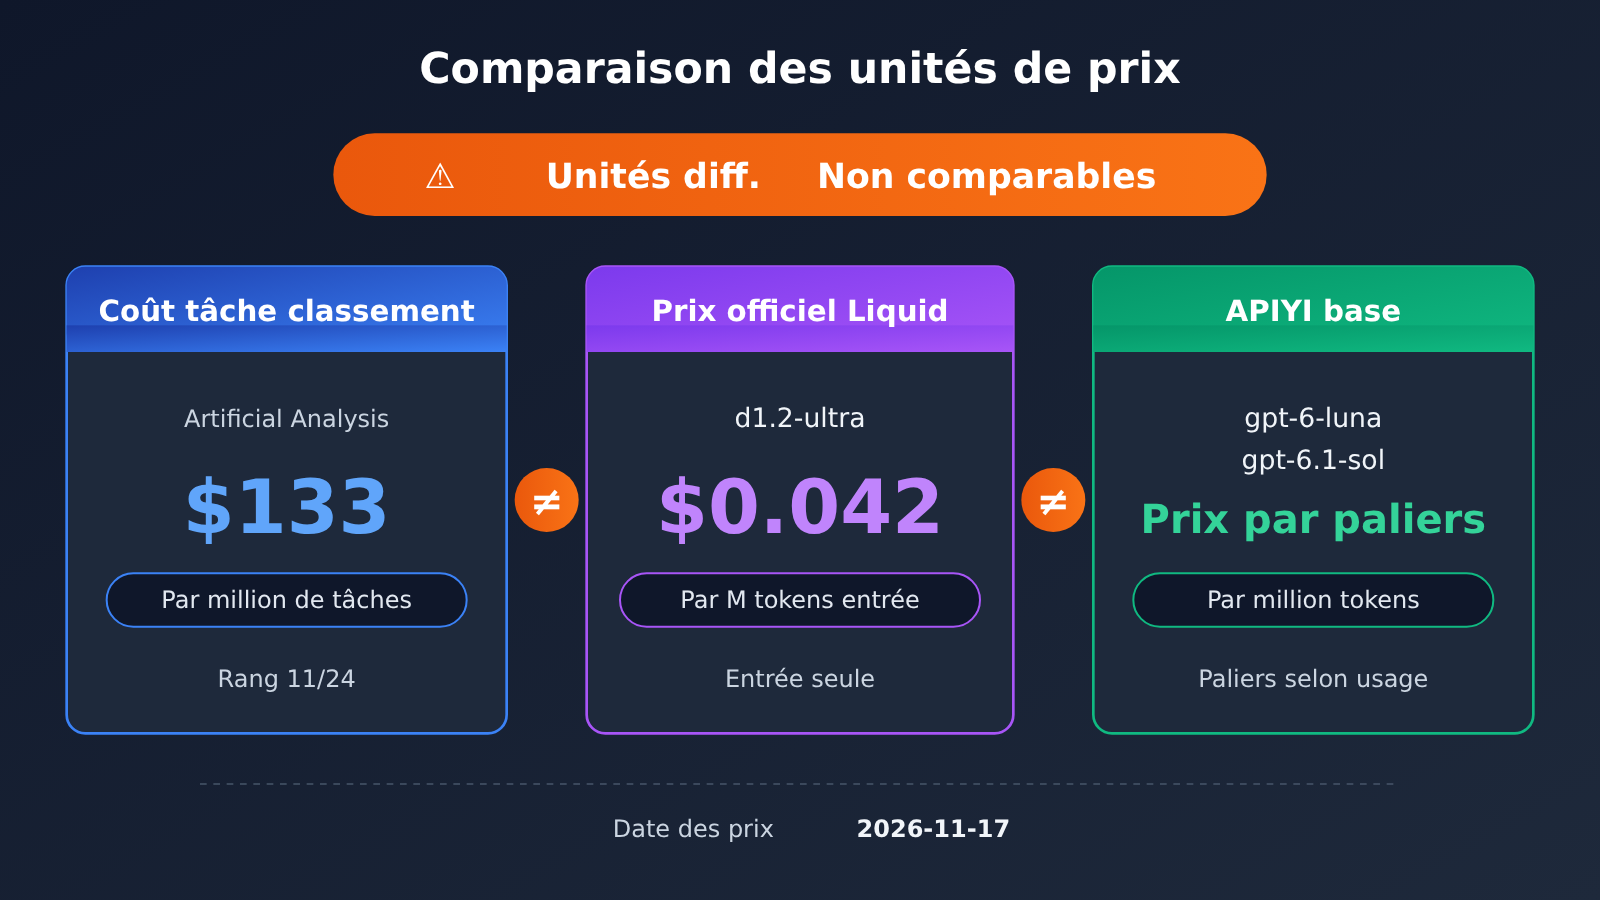
Voici les modèles APIYI utilisés pour le run de référence, avec leurs tarifs (en dollars par million de tokens, par paliers selon le volume de tokens d’une requête ; données issues de l’API de tarifs du 2026-11-17, cohérentes avec la mise à jour du 2026-11-16 du tableau récapitulatif des modèles) :
| Modèle | Palier | Entrée | Sortie | Lecture de cache | Point de terminaison |
|---|---|---|---|---|---|
gpt-6-luna |
≤ 272000 | 0.1 | 0.5 | 0.01 | responses en priorité, chat aussi disponible |
gpt-6-luna |
≥ 272001 | 0.2 | 0.75 | non listée séparément | idem |
gpt-6.1-sol |
≤ 272000 | 2 | 10 | 0.1 | responses en priorité, chat aussi disponible |
gpt-6.1-sol |
≥ 272001 | 4 | 15 | non listée séparément | idem |
💰 Astuce coût : pour une comparaison sur 50 échantillons,
gpt-6-lunaest le bon choix pour commencer par le volume,gpt-6.1-solservant de référence haut de gamme. Sur APIYI apiyi.com, la recharge est calculée sur une base 1:7, les remises de groupe se cumulent, et le débit réel fait foi dans la console.
FAQ — Questions fréquentes
Q1 : d1.2-ultra, c’est quel type de modèle ?
C’est un modèle de décision publié par Liquid AI le 16/11/2026, lancé en même temps que le plus petit d1.2. Sa particularité : il donne une probabilité pour chaque option, ce qui le rend à l’aise sur les tâches de « choix » — extraction de documents, décision d’appel d’outil, classification — plutôt que sur la rédaction de longs textes.
Q2 : d1.2-ultra est premier au classement général, donc c’est le meilleur partout ?
Non. L’indice global de 74,85 le place 1er sur 24, mais il est 3e sur EvalSafe-O\*NET-AA, 5e sur le taux de réussite total d’AA-Symmetry, 20e sur la précision brute d’AA-Omniscience, et sa précision brute sur HLE-MultiChoice est la plus basse des 24. Un score global dit seulement qu’il est en tête après pondération.
Q3 : Sur HLE-MultiChoice, est-ce qu’on peut dire qu’il est dernier en test de connaissances ?
Non. Le dernier, c’est la précision brute de HLE-MultiChoice, à 2,36 % — une précision brute parmi les 24 modèles de décision. Son score de décision de 46,36 n’est pas en queue de peloton, et AA classe cette catégorie comme du raisonnement, pas de la connaissance.
Q4 : Dans quels cas d’usage d1.2-ultra est-il le plus adapté ?
D’après la page du classement, ce qui colle le mieux, c’est l’extraction de champs depuis des factures, des CV ou des articles (score de décision et taux de tout-juste AA-Paperclip tous deux 1er) et le jugement d’appel d’outil (When2Call 1er, mais avec environ 1 point d’écart seulement sur les premiers). Sur des QCM difficiles et de la question-réponse factuelle, sa précision brute n’est pas à son avantage.
Q5 : Peut-on déjà appeler d1.2-ultra via APIYI ?
Pour l’instant, d1.2 et d1.2-ultra ne figurent pas dans la liste des modèles d’APIYI. Pas encore référencés, mais nous allons mettre ce modèle en ligne dès que possible ; les modèles et les prix font foi selon la liste de la plateforme. Le conseil : commencez par établir votre baseline sur vos propres échantillons avec `gpt-6-luna` ou `gpt-6.1-sol` sur APIYI apiyi.com, puis il suffira de changer de modèle pour comparer.
Q6 : Peut-on faire confiance directement à l’erreur de calibration de 0,8 annoncée par Liquid ?
C’est un test mené par Liquid elle-même sur 13 benchmarks et 22 505 questions : une auto-déclaration de l’éditeur. Ce que la page du classement permet de recouper, c’est un Brier de 0,150, le plus bas des 24 — la direction va dans le même sens — mais pour votre métier, il faut surtout vérifier si le nombre de « coups de poker » baisse réellement sur vos propres échantillons.
Q7 : Le 7.2 de GPT-6 Luna et le `gpt-6-luna` d’APIYI, c’est la même chose ?
Non. Le 7.2 correspond à l’erreur de calibration de l’API Decisions de GPT-6 Luna dans les tests de Liquid, et le 60,25 du classement est aussi un résultat de l’interface Decisions. Le `gpt-6-luna` proposé par APIYI est une interface de chat : ses performances, c’est à vous de les mesurer sur vos propres échantillons.
Q8 : Combien d’échantillons faut-il au minimum ?
Avec 20 à 50 échantillons, on voit déjà une différence nette ; l’essentiel est de couvrir la distribution réelle : formats courants, formats rares et échantillons avec des champs manquants doivent tous être représentés. Si deux modèles se tiennent à un ou deux échantillons près sur 50, cela veut dire que changer ne sert à rien : privilégiez le prix et la latence.
Points clés de d1.2-ultra
- Le score global de 75 n’est qu’un prétexte : 74.85, 1er sur 24, environ 2.2 points devant le 2e — ce n’est pas être premier partout.
- Pour l’extraction de documents, regardez AA-Paperclip : score de décision 75.81 et taux de réponses entièrement correctes 67.7 %, les deux classés 1er.
- Pour l’appel d’outils, regardez When2Call : 96.49, 1er, mais les premiers se tiennent dans environ 1 point.
- Pour les problèmes difficiles, regardez la précision brute : HLE-MultiChoice à 2.36 %, le plus bas ; le score de décision n’est pas dernier, AA le classe en raisonnement.
- Pour les questions de connaissances, regardez la précision Omniscience : 23.6 %, 20e sur 24, pas dernier.
- Ne mélangez pas les unités : 133 dollars, c’est par million de tâches ; 0.042 dollar, c’est par million de tokens d’entrée.
- Décidez à partir d’échantillons : commencez par tester 20 à 50 échantillons sur APIYI apiyi.com avec les modèles disponibles sur la plateforme, et notez le taux d’exactitude des champs ainsi que le nombre de réponses devinées au hasard.
Résumé
Pour lire le classement de d1.2-ultra, tout tient en trois étapes :
- Notez le type de tâche : extraction de documents, appels d’outils, résolution de problèmes difficiles ou questions-réponses de connaissances — ne regardez que la sous-catégorie correspondante.
- Distinguez bien deux chiffres : le score de décision récompense le fait de « ne pas deviner quand on manque de confiance », tandis que l’exactitude brute mesure « combien de fois on a vu juste ». Choisissez celui à regarder selon votre besoin métier.
- Tranchez avec vos propres échantillons : 20 à 50 données réelles annotées parleront plus que n’importe quel score global.
Si votre travail consiste précisément à extraire des documents, d1.2-ultra mérite une place dans votre liste de candidats. En revanche, si vous faites du raisonnement complexe ou des questions-réponses de connaissances, ne changez pas de modèle juste parce qu’il est premier au classement global. Je vous recommande de mettre dès maintenant en place une base de référence avec gpt-6-luna et gpt-6.1-sol sur APIYI apiyi.com, puis de comparer en un clic quand le modèle cible sera disponible.
📚 Références
-
Blog officiel de Liquid AI – sortie de d1.2 : informations de publication, tarifs officiels et tests autodéclarés
- Lien :
liquid.ai/blog/d1-2 - Description : les taux d’exactitude sur de nouvelles tâches et l’erreur de calibration sont tous deux déclarés par l’éditeur.
- Lien :
-
Documentation des modèles de décision de Liquid AI : ID des modèles et adresses d’appel
- Lien :
docs.liquid.ai/lfm/models/decision-models - Description : explication officielle de la méthode d’appel.
- Lien :
-
Artificial Analysis – page du modèle d1.2-ultra : indice global et sous-scores
- Lien :
artificialanalysis.ai/decision-models/d1-2-ultra - Description : les données de classement de cet article ont été relevées le 2026-11-17.
- Lien :
-
Artificial Analysis – page de méthodologie du Decision Index : pondérations et définition du scoring
- Lien :
artificialanalysis.ai/methodology/decision-index - Description : différence entre score de décision et exactitude brute.
- Lien :
-
Liste complète des modèles APIYI : modèles disponibles et tarifs
- Lien :
docs.apiyi.com/models - Description : les modèles et tarifs font foi dans la liste des modèles de la plateforme.
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : pour toute question sur le choix de modèle ou les scripts de comparaison, n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI ; vous trouverez plus de détails d’intégration dans le centre de documentation.


