
Note de l’auteur : un taux de code généré supérieur à 30 % ne signifie pas que les livraisons sont plus rapides. Cet article explique le calcul du « plafond théorique de 7 % », analyse 5 goulots d’étranglement et propose une liste de vérification pour votre équipe.
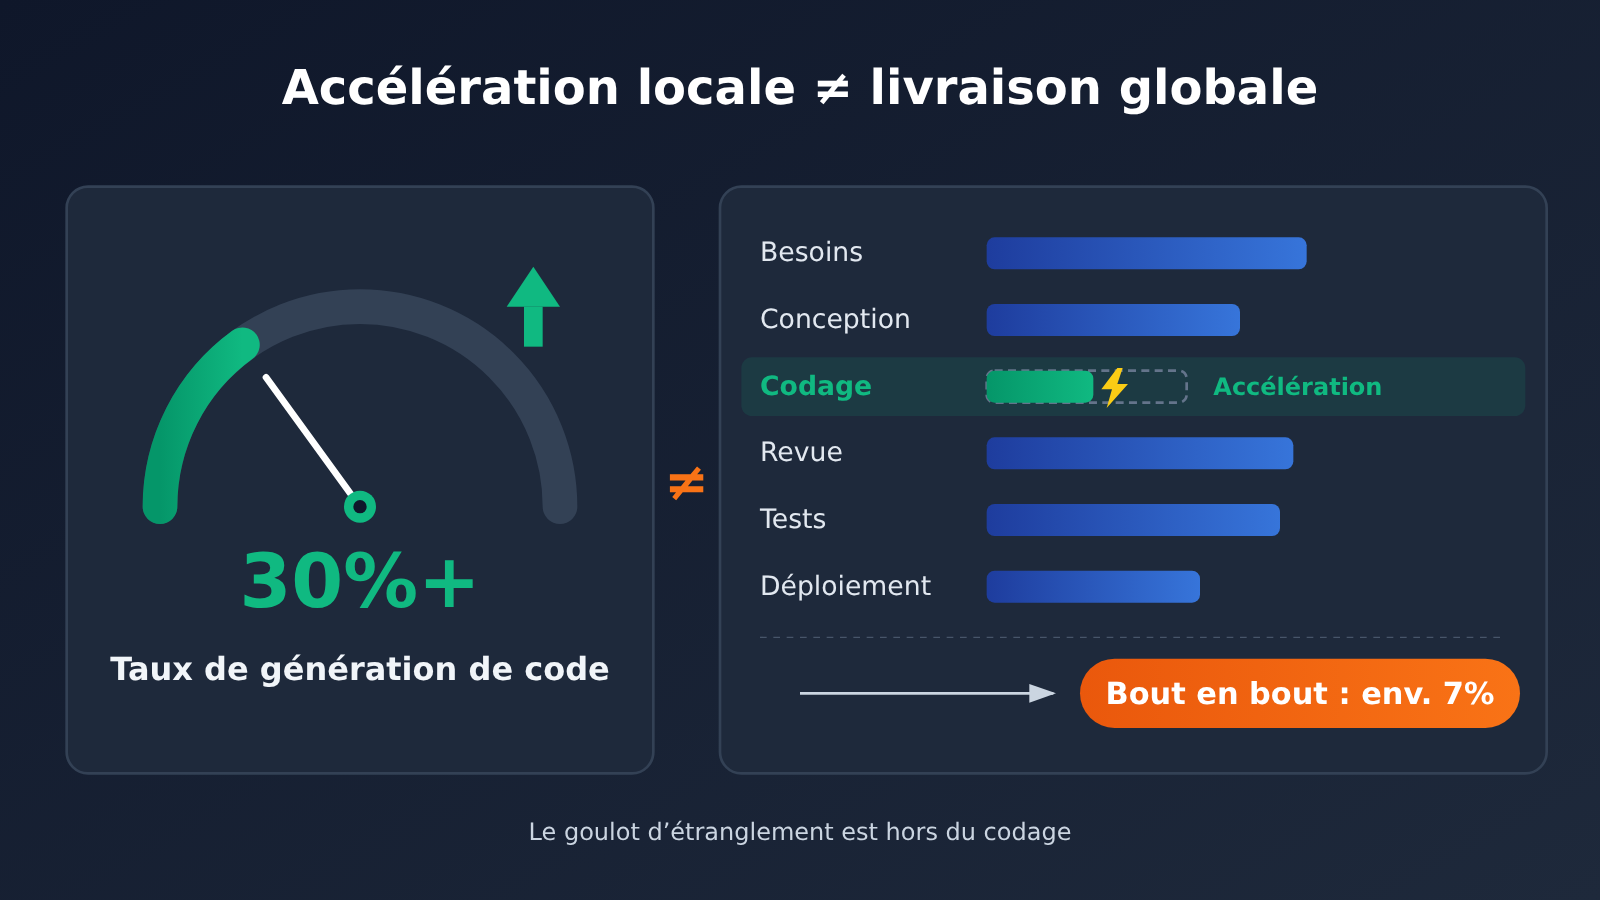
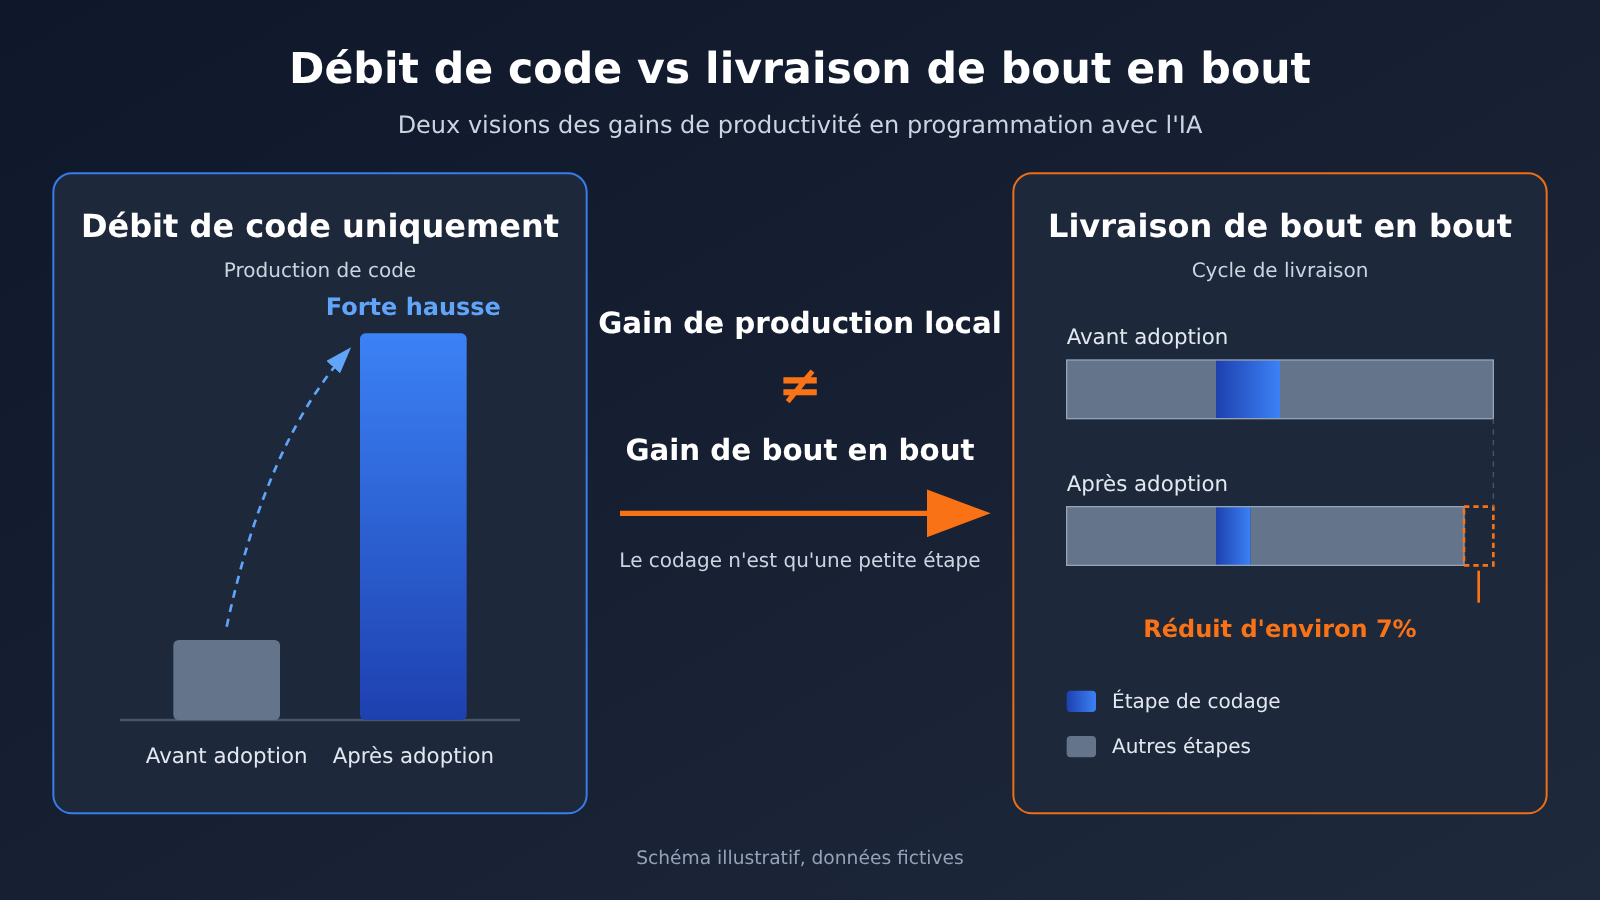
Commençons par la conclusion : le taux de code généré n’est pas la vitesse de livraison. Quand la part de code généré par l’IA passe de moins de 10 % à plus de 30 %, c’est seulement la production à l’étape de codage qui augmente. Or, le délai de livraison de bout en bout comprend aussi la clarification des besoins, la conception, la revue de code, les tests, l’intégration, la mise en production et la validation. Le codage ne représente souvent qu’une partie de cette chaîne : même si le taux de code généré augmente fortement, le cycle de livraison ne peut se raccourcir que dans la limite de la part qu’occupe le codage.
Cela explique aussi la perplexité de nombreux responsables techniques : les outils sont déployés, les rapports sur le taux de code généré sont excellents, mais les délais de livraison changent à peine. À partir de la répartition du temps d’une équipe, une étude sectorielle a estimé le gain maximal d’efficacité de bout en bout à environ 7 %. Il ne s’agit pas de dénigrer la programmation assistée par IA, mais de rappeler que les véritables freins à la livraison se trouvent dans 5 goulots d’étranglement en dehors du codage. Nous allons voir comment ces 7 % sont calculés, dans quelles limites cette estimation s’applique et comment votre équipe peut faire son propre diagnostic.
Plus de 30 % de code généré, mais un plafond de 7 % : l’essentiel en bref
Avant de passer au calcul, voici les chiffres clés et ce qu’ils recouvrent. Leur provenance et leur degré de fiabilité sont importants : toute l’analyse qui suit repose sur ces limites.
| Élément | Détail | Précision |
|---|---|---|
| Part de code généré | Plus de 30 % | Proportion du code générée par l’IA ; ne reflète que la production à l’étape du codage |
| Plafond du gain de productivité de bout en bout | De l’ordre de 7 % | Estimation fondée sur la répartition du temps d’une équipe donnée, et non règle universelle |
| Chiffre évoqué dans le secteur | Environ 3 à 5 % | Issu d’échanges, sans échantillon vérifiable |
| Débit de code utile | Multiplié par 2 à 3 | Données issues du bilan d’une équipe ; critères de mesure et méthode de comparaison non divulgués |
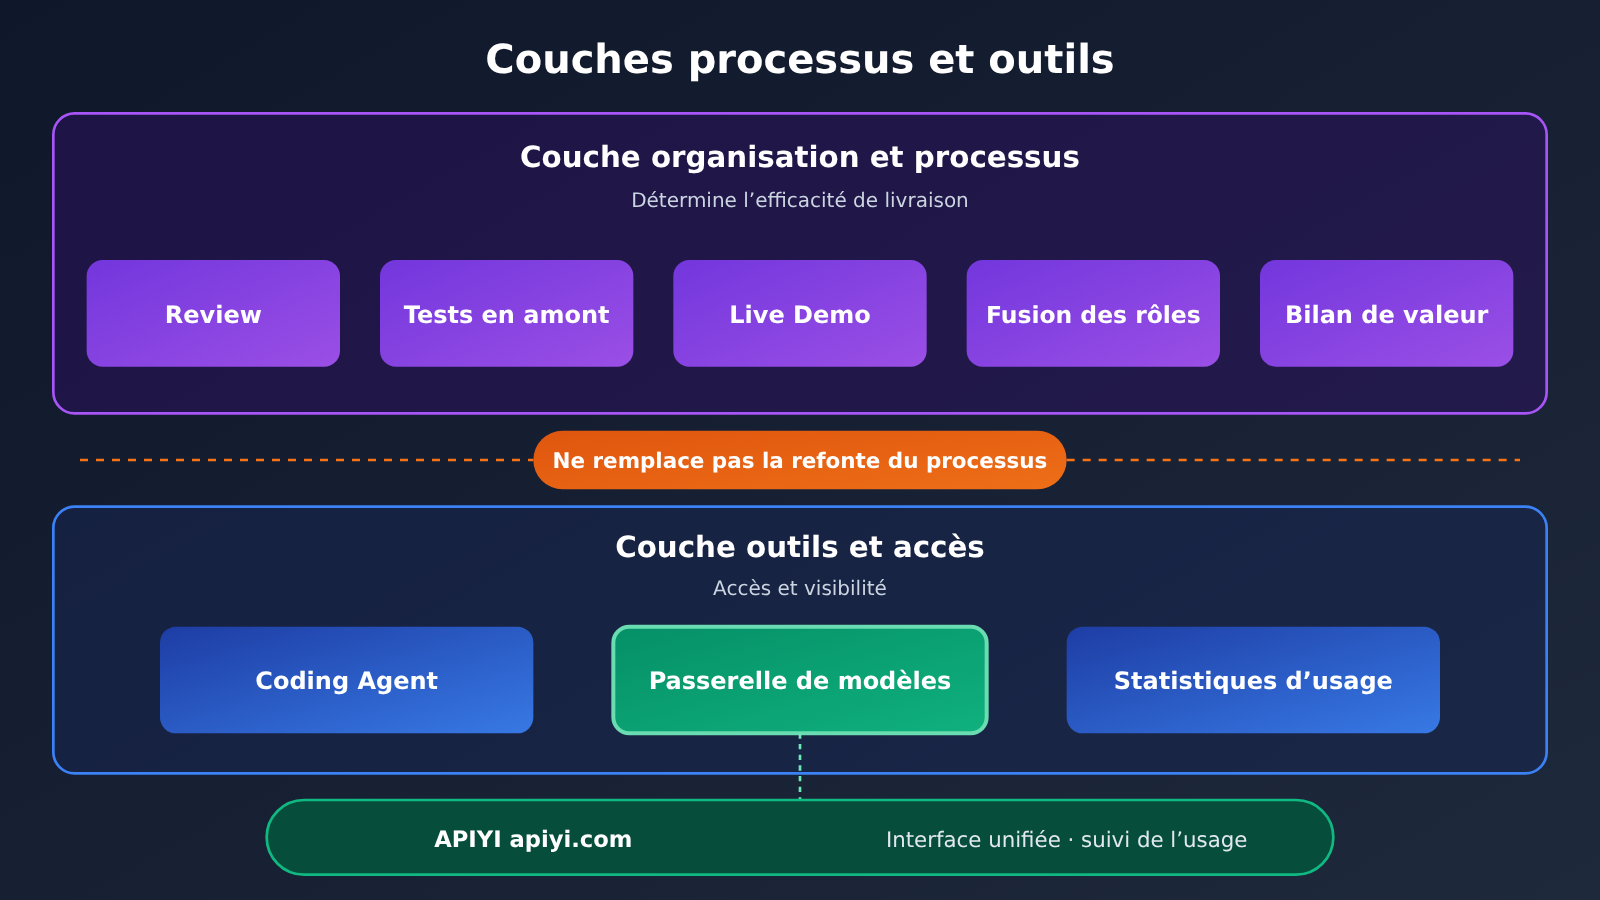
| Cinq goulots d’étranglement | File d’attente des revues de code, tests et observabilité intégrés plus tôt, Live Demo, convergence des rôles, évaluation de la valeur | Problèmes d’organisation et de processus |
| Intégration des agents de codage | Possible via des interfaces agrégées comme APIYI apiyi.com | Simplifie l’intégration et le suivi de l’utilisation, sans résoudre les blocages du processus |
Ces chiffres ne se contredisent pas. Un « débit de code utile multiplié par 2 à 3 » concerne la production de code, tandis que les « 7 % » et les « 3 à 5 % » portent sur la livraison de bout en bout. Le premier est un indicateur local, les autres sont des indicateurs globaux : entre les deux se trouve toute une chaîne de livraison.
D’où vient le plafond de 7 % : le rôle du taux de code généré et du temps consacré au codage
Décomposer la formule du gain de temps de bout en bout
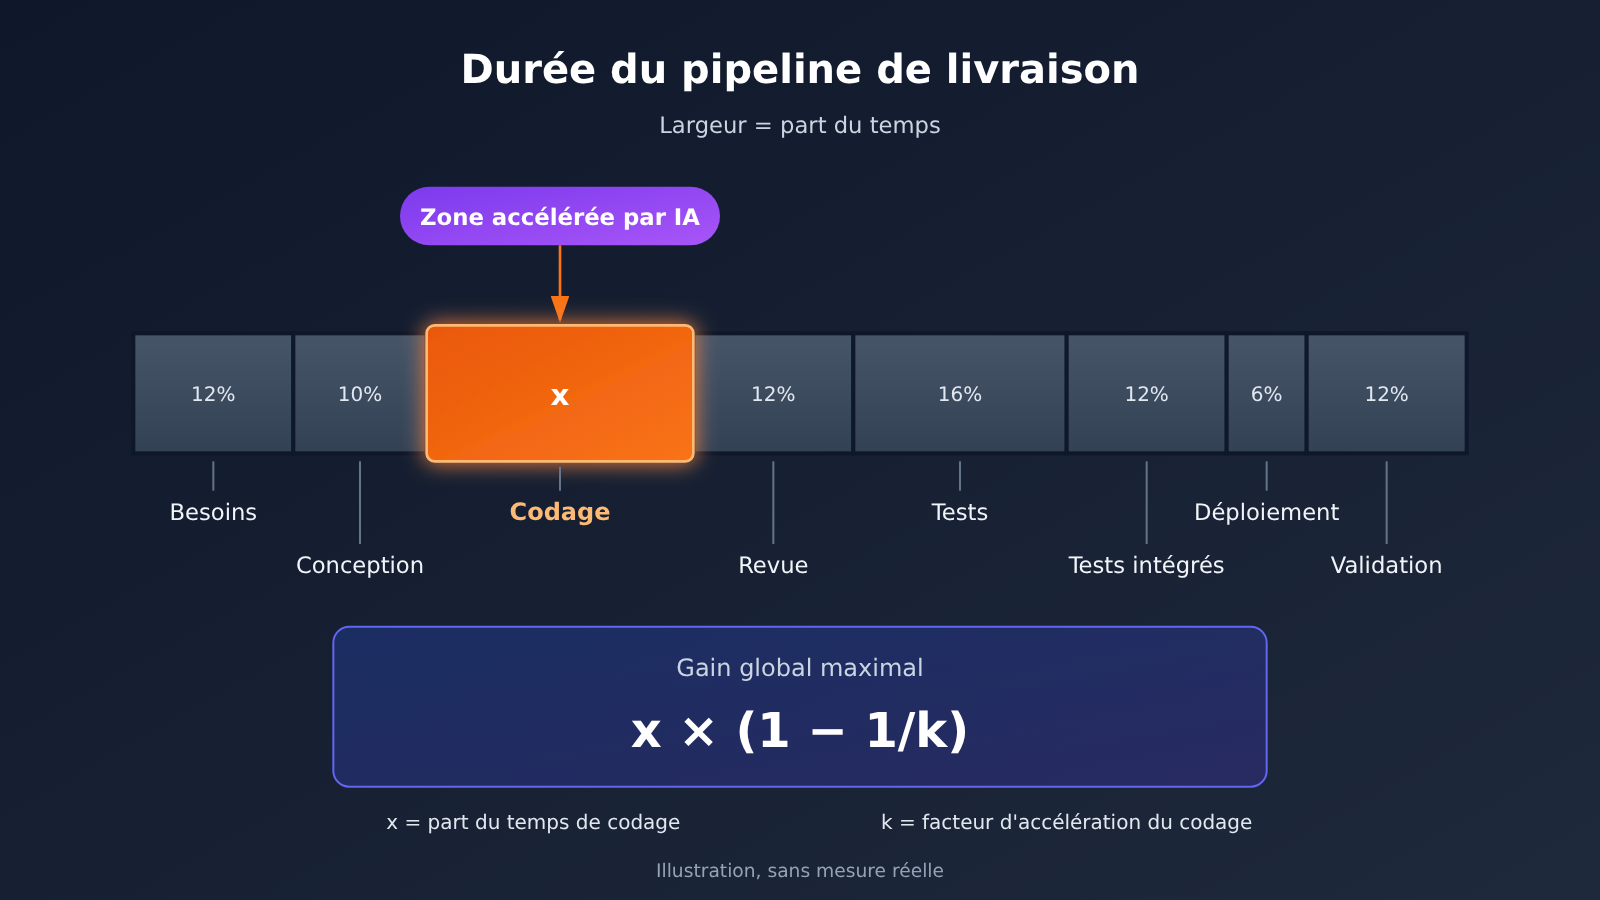
On peut estimer le gain de temps maximal de bout en bout avec une formule simple : gain maximal de bout en bout ≈ x × (1 - 1/k). Ici, x représente la part du temps total de livraison consacrée au codage, et k le facteur d’accélération du codage. C’est une application de la loi d’Amdahl au processus de développement : si vous n’accélérez qu’une partie du processus, le gain global est plafonné par la part qu’elle représente.
Prenons un exemple concret : si le codage représente 14 % du temps de livraison et que l’IA permet de coder deux fois plus vite (k = 2), le gain est de 14% × (1 - 1/2) = 7%. Même en supposant que le temps de codage soit réduit à zéro (k tend vers l’infini), le temps de bout en bout ne pourrait diminuer que de 14 % au maximum. Le tableau ci-dessous présente les résultats pour plusieurs hypothèses. Il s’agit uniquement d’illustrations de la formule, pas de mesures réalisées auprès d’équipes.
Part du codage x |
Facteur d’accélération du codage k |
Gain maximal de bout en bout | Interprétation |
|---|---|---|---|
| 10% | 3 | Environ 6,7 % | Codage 3 fois plus rapide, mais gain global inférieur à 7 % |
| 14% | 2 | 7 % | Exemple du même ordre de grandeur que l’estimation présentée dans le document |
| 20% | 1.5 | Environ 6,7 % | Avec un faible facteur d’accélération, le gain global est vite dilué |
| 20% | 2 | 10 % | Les équipes qui consacrent plus de temps au codage ont une marge de progression plus grande |
| 30% | 2 | 15 % | Cas d’une équipe dont le travail est fortement axé sur le codage |
| 20% | Tend vers l’infini | 20 % | Plafond théorique lorsque le temps de codage est réduit à zéro |
30 % de code généré ne signifie pas que le codage est 30 % plus rapide
Autre confusion fréquente : le taux de code généré et k ne sont pas la même chose. Le premier indique « quelle proportion du code est écrite par l’IA », tandis que k mesure l’accélération du codage. Le code généré par l’IA doit encore être lu, débogué et modifié. La génération elle-même demande aussi du temps pour rédiger les invites, attendre les résultats et corriger les erreurs.
Même en faisant l’hypothèse extrêmement simplifiée que les 30 % de code générés par l’IA ne prennent absolument aucun temps, le facteur d’accélération du codage n’est que de 1 / (1 - 0.3) ≈ 1.43. Une fois ce gain ramené à la part du codage dans le temps total, le bénéfice de bout en bout est encore plus faible. L’ordre de grandeur de 7 % présenté dans le document n’a donc rien de surprenant. Il montre plutôt que l’enjeu n’est pas de « générer plus de code », mais d’agir sur les étapes qui entourent le codage.
Rappelons-le : les 7 % sont une estimation fondée sur la répartition du temps d’une équipe précise. La part consacrée au codage, la stabilité des besoins et le dispositif de test varient d’une équipe à l’autre : votre résultat pourrait donc être plus élevé ou plus faible. Cette estimation sert de cadre de réflexion, pas de conclusion à appliquer telle quelle.
5 goulots d’étranglement qui ralentissent toujours la livraison, malgré la génération de code
Quand le codage s’accélère, la pression se déplace vers les étapes suivantes du processus. Parmi ces cinq goulots d’étranglement, certains sont de nouveaux problèmes amplifiés par la programmation assistée par IA ; d’autres existaient déjà, mais la vitesse de codage les masquait jusque-là.
Goulot d’étranglement 1 : les revues s’accumulent chez les développeurs clés
Plus l’IA génère de code, plus il y a de code à examiner. Les revues reposent souvent sur un petit nombre de développeurs clés. Ils doivent à la fois comprendre le contexte métier et évaluer les cas limites et les risques potentiels du code généré par l’IA. Résultat : une grande partie du temps gagné pendant le codage se transforme en temps d’attente dans la file de revue.
Autre difficulté : le code généré par l’IA « semble correct », ce qui oblige les personnes chargées de la revue à le lire plus attentivement. Le coût de revue par unité de code ne diminue donc pas forcément. Sans adaptation du processus — par exemple, en échelonnant les revues selon leur niveau de risque, en précisant quelles modifications peuvent être approuvées par d’autres développeurs et en confiant les vérifications de conformité à des outils automatisés —, ces développeurs clés deviendront le principal goulot d’étranglement de toute la chaîne.
Goulot d’étranglement 2 : intégrer les tests et l’observabilité plus tôt
Dans beaucoup d’équipes, les tests, la surveillance et l’observabilité n’entrent en jeu qu’à la fin du développement. Quand le codage s’accélère, les problèmes s’accumulent plus vite à l’étape des tests et les corrections se concentrent en fin de cycle. Si les cas de test, les points d’instrumentation et les règles d’alerte ne sont pas conçus avant ou pendant le codage, l’intégration et les corrections tardives risquent d’effacer les gains obtenus en amont.
L’idée est de faire avancer la vérification en même temps que l’écriture du code. C’est particulièrement important pour le code généré par l’IA : il faut pouvoir exécuter des tests pour vérifier rapidement si le résultat est correct, plutôt que de tout contrôler manuellement ligne par ligne.
Goulot d’étranglement 3 : valider les besoins avec une démo interactive pour limiter les corrections
Dans un cycle de livraison, le plus coûteux n’est souvent pas d’écrire du code, mais de le corriger après s’être trompé. Une mauvaise compréhension des besoins peut obliger à reprendre le codage, la revue de code et les tests. Puisque l’IA réduit le coût du codage, une meilleure approche consiste à créer rapidement une démo interactive fonctionnelle, pour que les parties prenantes puissent confirmer en l’utilisant : « Est-ce bien ce que nous avions en tête ? »
On passe ainsi d’une revue de documents à une revue de prototype. Un document peut être interprété différemment par chacun, tandis qu’une démo fonctionnelle révèle les divergences plus tôt. Le vrai bénéfice de la baisse du coût du codage n’est peut-être pas de terminer plus vite le code définitif, mais de pouvoir expérimenter à moindre coût.
Goulot d’étranglement 4 : convergence des rôles, évolution de PDFE et ABE
Dans un processus traditionnel, les équipes produit, design, front-end, back-end et test se transmettent le travail à de nombreuses reprises. Chaque transfert entraîne de l’attente, une perte de contexte et un nouvel effort d’alignement. Le regroupement des rôles PDFE et ABE évoqué dans le document vise à permettre à une personne ou à une petite équipe de couvrir une plus grande partie du processus, afin de réduire ces transferts.
Quand l’IA prend en charge davantage de code, les ingénieurs peuvent consacrer plus de temps aux besoins en amont et aux tests en aval. La convergence des rôles devient alors possible. Mais attention : on manque encore de données sur les conditions et les coûts liés à l’adoption de cette organisation selon la taille des équipes. Elle peut convenir naturellement aux petites équipes, tandis que les grandes organisations doivent revoir en profondeur les responsabilités, les critères d’évaluation et les modes de collaboration. Il ne suffit donc pas de copier le modèle.
Goulot d’étranglement 5 : revue de valeur, dictionnaire des concepts et SDD
Si les concepts et les définitions des données ne sont pas alignés, plus l’IA écrit vite, plus elle produit vite des erreurs. Un même terme métier peut avoir des sens différents selon les modules, et les champs des interfaces peuvent reposer sur des définitions incohérentes. Ces problèmes éclatent au grand jour pendant l’intégration et la validation. L’approche décrite dans le document consiste à effectuer d’abord une revue de valeur, puis à aligner les concepts et les données à l’aide d’un dictionnaire des concepts et du SDD (développement piloté par les spécifications), avant d’écrire le code.
La revue de valeur répond à la question « Est-ce que cela vaut la peine de le faire ? ». Le dictionnaire des concepts et le SDD répondent à une autre question : « Parlons-nous bien de la même chose ? ». Ces deux étapes semblent alourdir le travail en amont, mais elles donnent à l’IA un contexte clair et cohérent, ce qui permet d’obtenir plus facilement un code conforme aux attentes dès le premier essai.
5 goulots d’étranglement et les actions correspondantes
| Goulot d’étranglement | Symptômes typiques | Action recommandée | Indicateur à suivre |
|---|---|---|---|
| File d’attente des revues par les experts clés | Les PR attendent plus longtemps, les experts sont surchargés | Hiérarchiser les revues et automatiser les contrôles de conformité | Temps d’attente moyen des PR |
| Tests et observabilité trop tardifs | Les reprises se concentrent pendant les tests | Concevoir les cas de test et l’instrumentation en amont | Nombre de défauts renvoyés en correction pendant les tests |
| Validation des besoins par une démo en direct | À la recette, le résultat ne correspond pas aux attentes | Valider les besoins avec un prototype fonctionnel | Nombre de changements de besoins et de reprises |
| Cloisonnement des rôles | Transmissions et attentes fréquentes, perte de contexte | Réduire les points de passage et élargir le périmètre pris en charge par une personne | Nombre de transmissions entre étapes |
| Revue de la valeur et dictionnaire des concepts/SDD | Les interprétations divergent lors de l’intégration | Aligner les concepts et les données avant de coder | Nombre de problèmes pendant l’intégration |
Bilan d’équipe : comment analyser les délais de livraison et les gains liés à la génération de code
Plutôt que de débattre entre 7 % et 3 à 5 %, calculez les chiffres de votre propre équipe. Voici une méthode que vous pouvez appliquer directement, en commençant par un petit projet.
- Découper les étapes : de la formulation d’un besoin à sa mise en production, distinguez les besoins, la conception, le codage, la revue de code, les tests, les tests d’intégration, le déploiement et la validation. Notez le temps réellement passé et le temps d’attente pour chaque étape.
- Calculer la part du codage : divisez le temps consacré au codage par le délai total de livraison pour obtenir votre
x. Beaucoup d’équipes découvrent que cette part est plus faible qu’elles ne le pensaient. - Repérer les attentes et les reprises : comptabilisez séparément le temps d’attente avant revue, le nombre de reprises après les tests et les changements de besoins. Ce sont souvent des postes importants, mais peu visibles.
- Distinguer production et valeur : séparez la « production de code » de la « valeur livrable ». Le taux de génération de code et le nombre de lignes soumises relèvent de la première ; le nombre de fonctionnalités mises en production et le délai de livraison relèvent de la seconde.
- Faire une comparaison à petite échelle : comparez les résultats avant et après sur un petit projet, sans vous limiter aux rapports sur le taux de génération de code.
- Résoudre d’abord le principal goulot d’étranglement : traitez en priorité l’étape qui prend le plus de temps, sans déployer tous les outils ni modifier tous les processus en même temps.
Voici un modèle hypothétique de répartition du temps qui montre comment remplir le tableau. Il ne représente les données réelles d’aucune équipe. Vous pouvez y inscrire vos propres chiffres pour voir quelle part revient réellement au codage.
| Étape de livraison | Part indicative (hypothétique) | Principales sources de temps | La programmation assistée par IA peut-elle accélérer directement cette étape ? |
|---|---|---|---|
| Évaluation des besoins et de la valeur | 15% | Échanges répétés, alignement sur les objectifs | Indirectement (Live Demo) |
| Conception | 10% | Discussions sur les solutions, revues | Partiellement |
| Codage | 15% | Écriture, débogage | Directement |
| Revue de code | 15% | Attente, examen du code | Partiellement (aide à la revue) |
| Tests et intégration | 25% | Exécution des cas de test, reprises | Partiellement (génération de cas de test) |
| Déploiement et validation | 20% | Approbations, retours de validation | Très peu |
Ce modèle sert à mettre en évidence la répartition du temps : si le codage ne représente qu’un peu plus de 10 % du total, même un nouveau doublement du taux de génération de code aura un effet limité sur le délai de livraison de bout en bout. Les principales possibilités d’amélioration se trouvent dans la revue de code, les tests et la définition des besoins.
Intégration des Coding Agents et suivi de leur consommation : ce qu’APIYI peut faire, et ce qu’il ne peut pas faire
Lorsqu’on déploie des outils de programmation assistée par IA, l’intégration et le suivi des coûts sont incontournables. APIYI apiyi.com prend en charge l’intégration d’outils comme Cursor et Cline et fournit une interface unifiée compatible avec OpenAI. Une seule clé API suffit pour invoquer les principaux modèles, notamment ceux d’OpenAI, de Claude et de Gemini. Pour connecter un outil, il suffit de définir son base_url sur https://api.apiyi.com/v1.
Pour les équipes chargées de l’efficacité du développement, les données de consommation sont encore plus utiles. Les statistiques de la console permettent de suivre la consommation de tokens des Coding Agents et la répartition des invocations entre les modèles. Vous pouvez ainsi déterminer quelles tâches nécessitent un modèle plus puissant et lesquelles peuvent être confiées à un modèle léger. Mises en regard de la décomposition des délais de livraison présentée plus haut, ces données aident à évaluer le rapport entre l’investissement dans la programmation assistée par IA et les résultats obtenus.
💡 Conseil d’intégration : si votre équipe évalue plusieurs modèles de programmation en parallèle, APIYI apiyi.com permet de les connecter via une interface unifiée et de comparer leur consommation. Les nouveaux utilisateurs disposent d’un crédit de test gratuit, pratique pour commencer par une comparaison sur un petit projet. Consultez la console et la documentation pour connaître les tarifs et la disponibilité des modèles.
Il faut toutefois garder un point en tête : la passerelle ne peut pas, à elle seule, améliorer l’efficacité de livraison de bout en bout. Elle facilite l’intégration et le changement de modèle, tout en donnant de la visibilité sur la consommation. En revanche, les goulots d’étranglement comme les files d’attente pour la revue de code, les reprises après les tests ou les écarts par rapport aux besoins doivent être résolus au niveau de l’organisation. Considérer la passerelle comme une solution de gain d’efficacité revient à commettre la même erreur que d’utiliser le taux de génération de code comme indicateur de livraison.
Questions fréquentes (FAQ)
Q1 : Si plus de 30 % du code est généré, pourquoi la livraison de bout en bout n’est-elle accélérée que d’environ 7 % ?
Parce que la génération de code n’agit que sur l’étape de codage. Le gain maximal de productivité de bout en bout est d’environ `x × (1 – 1/k)` : si la part du codage `x` est faible, le gain est plafonné. Attention, les 7 % sont une estimation fondée sur la répartition du temps d’une équipe précise, pas une conclusion universelle. Votre équipe doit refaire le calcul avec ses propres données.
Q2 : Les chiffres de 3 à 5 % et de 2 à 3 fois sont-ils fiables ?
Les deux sont à prendre avec prudence. Le gain de productivité de 3 à 5 % de bout en bout provient d’échanges dans le secteur, sans échantillon vérifiable. Le débit de code utile multiplié par 2 à 3 provient d’un bilan d’équipe dont les critères de mesure et la méthode de comparaison n’ont pas été communiqués. Ces chiffres peuvent servir de repères, mais pas directement de base de décision.
Q3 : Lequel des 5 goulots d’étranglement faut-il résoudre en premier ?
Commencez par décomposer le temps consacré à la livraison et traitez en priorité l’étape qui en occupe la plus grande part. Beaucoup d’équipes constatent que l’attente des revues de code et les reprises après les tests pèsent lourd ; pour d’autres, ce sont surtout les changements de besoins qui posent problème. Évitez de tout transformer en même temps : en résolvant un seul goulot, le plus important, les effets seront plus faciles à observer.
Q4 : Comment suivre l’utilisation des modèles et les coûts des Coding Agents de l’équipe ?
Vous pouvez connecter tous les outils de programmation à un même point d’entrée API, puis consulter la consommation de tokens et la répartition entre les modèles dans la console. Par exemple, en connectant des outils comme Cursor et Cline via APIYI apiyi.com, vous pouvez consulter leurs données d’utilisation au même endroit. Ce suivi aide à prendre des décisions, mais les goulots d’étranglement du processus doivent toujours être résolus au niveau de l’organisation.
Q5 : Le regroupement des rôles convient-il à toutes les équipes ?
Pas nécessairement. L’idée de fusionner des rôles comme PDFE et ABE est de réduire les transferts entre personnes, mais on manque de données sur les conditions et les coûts nécessaires pour reproduire ce changement dans des équipes de tailles différentes. Commencez par un projet pilote dans un petit groupe, observez l’évolution du nombre de transferts et du cycle de livraison, puis décidez s’il faut l’étendre.
Taux de code généré et livraison de bout en bout : points clés
- Le taux de code généré ne reflète pas la vitesse de livraison : il mesure uniquement la production à l’étape de codage, pas le gain d’efficacité sur l’ensemble du processus.
- Les 7 % sont issus d’un calcul :
x × (1 - 1/k). La part du codage détermine le plafond des gains possibles. - Attention au périmètre des chiffres : les 7 % sont une estimation pour une équipe précise, les 3 % à 5 % proviennent d’échanges et le périmètre des chiffres de 2 à 3 fois n’a pas été précisé.
- Les principaux goulots d’étranglement sont ailleurs que dans le codage : revue de code, tests, validation des besoins, transferts entre rôles et alignement sur les concepts.
- Mesurez d’abord les délais, puis ajustez le processus : comparez les résultats sur un petit projet et corrigez un seul goulot d’étranglement à la fois, en commençant par le plus important.
- Les outils servent à l’accès et au suivi : APIYI apiyi.com permet d’accéder aux agents de codage depuis un point unique et de suivre leur utilisation, mais ne résout pas les problèmes de processus.
Conclusion : que faire une fois le taux de code généré supérieur à 30 % ?
Un taux de code généré supérieur à 30 % est un vrai progrès, mais ce n’est qu’un début. La livraison de bout en bout dépend de toute une chaîne, dont le codage ne représente qu’une partie. La formule x × (1 - 1/k) montre clairement les limites d’une accélération locale. L’intérêt du chiffre de 7 % n’est pas tant de savoir s’il est exact que de nous rappeler de passer de « combien de code avons-nous écrit ? » à « quelle valeur avons-nous livrée ? ».
Les vrais gains d’efficacité se trouvent dans les mécanismes de revue de code, l’intégration plus précoce des tests et de l’observabilité, la validation des besoins par une démonstration en direct, le rapprochement des rôles, ainsi que l’évaluation de la valeur et l’alignement sur les concepts. Ce sont des questions d’organisation et de processus qu’aucun outil ne peut régler à lui seul. Côté outils, APIYI apiyi.com permet d’accéder aux modèles de programmation depuis un point unique et d’en suivre l’utilisation. Comparez ces données aux délais de livraison pour évaluer le retour sur investissement.
Liste de vérification pour l’équipe
- [ ] Avez-vous décomposé le temps nécessaire pour répondre à un besoin, de sa formulation jusqu’à la mise en production ?
- [ ] Avez-vous calculé la proportion
xdu temps total de livraison consacrée au codage ? - [ ] Avez-vous mesuré séparément le temps d’attente des revues de code et la charge des membres clés de l’équipe ?
- [ ] Les cas de test, l’instrumentation et les alertes sont-ils conçus avant ou pendant le codage ?
- [ ] Validez-vous les besoins à l’aide d’une démonstration fonctionnelle plutôt que de vous limiter aux documents ?
- [ ] Combien de transferts entre rôles un besoin traverse-t-il avant sa mise en production ?
- [ ] Avant de coder, l’équipe s’est-elle alignée sur les concepts clés et les définitions des données (dictionnaire de concepts/SDD) ?
- [ ] Les indicateurs communiqués distinguent-ils la « production de code » de la « valeur livrable » ?
- [ ] Avez-vous comparé les résultats avant et après sur un petit projet, au lieu de vous fier uniquement aux rapports sur le taux de code généré ?
- [ ] Avez-vous choisi de traiter d’abord le principal goulot d’étranglement, plutôt que de déployer tous les outils en même temps ?
Références
- Documents sectoriels sur le taux de code généré et la livraison de bout en bout : source du calcul des 7 %, des cinq goulots d’étranglement et du périmètre des données présentés dans cet article
- Remarque : les documents étaient tronqués. Cet article s’appuie uniquement sur les parties visibles ; le contenu non affiché n’a pas été utilisé comme source.
- Centre de documentation APIYI : informations sur l’intégration des outils de programmation et le suivi de leur utilisation
- Lien :
docs.apiyi.com - Remarque : consultez la console et la documentation pour connaître les prix et la disponibilité des modèles.
Auteur : équipe technique APIYI
Échanges techniques : rendez-vous sur la page d’accueil d’APIYI apiyi.com pour nous contacter. Pour plus d’informations sur l’intégration, consultez le centre de documentation docs.apiyi.com.


