
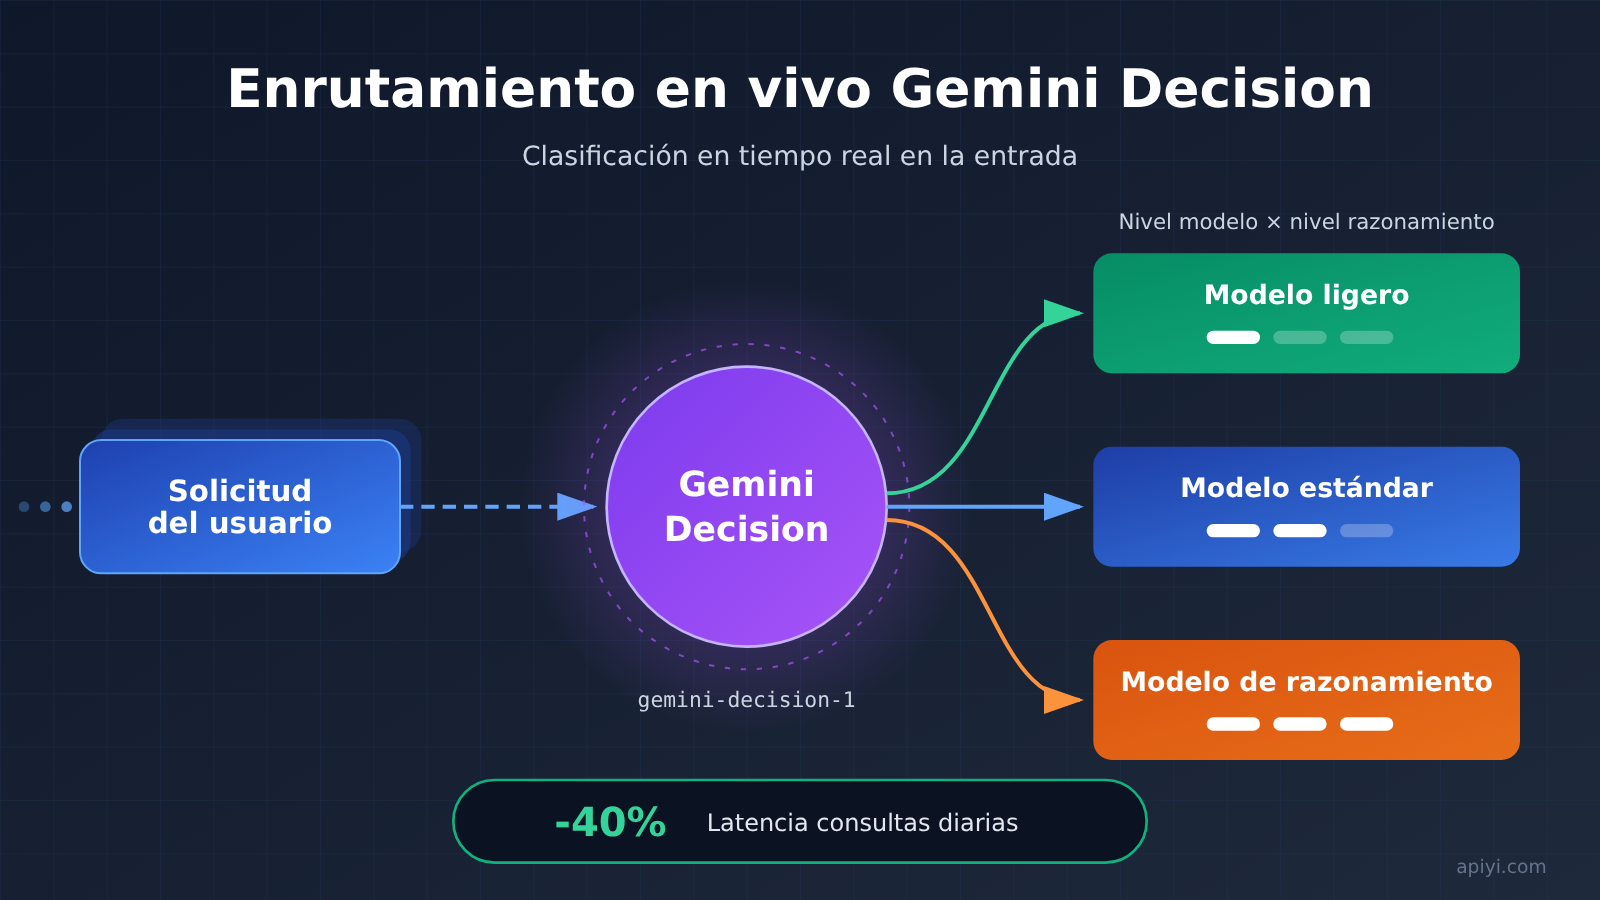
Google publicó el 2026-11-11 en su blog para desarrolladores un caso de uso muy concreto: Gemini Notebook usa la Decisions API como enrutador en tiempo real. Cuando entra una consulta, la clasifica en el nivel de modelo y el nivel de razonamiento que le corresponden. Según las cifras que informa la propia Google, la latencia de las consultas cotidianas baja hasta un 40 %. Ojo: el dato lo da Google, no es una prueba de carga de terceros ni una conclusión medida por ninguna plataforma.
Esto no es otra mejora de capacidad del modelo, sino mover la decisión de «qué modelo usar» del código del desarrollador a la ruta de la petición.
Valor clave: en 3 minutos entenderás qué es realmente gemini-decision-1, cómo se factura y qué implica para tu cadena de llamadas.
Resumen rápido de Gemini Decision
| Dato | Detalle |
|---|---|
| Fecha de anuncio | 2026-11-11, blog para desarrolladores de Google |
| ID del modelo | gemini-decision-1 |
| Posicionamiento | Enrutamiento y decisión en tiempo real, no generación de contenido |
| Primer caso de uso público | Gemini Notebook lo usa internamente para clasificar consultas cotidianas por nivel |
| Precio de entrada | $0.10 / 1M tokens |
| Precio de salida | $0 |
| Mejora de latencia | Según Google, hasta un 40 % menos en consultas cotidianas |
| Disponibilidad en plataformas agregadoras | A 2026-11-12, este ID todavía no aparece en la lista de precios de APIYI apiyi.com |
Lo que más fácilmente se pasa por alto en la tabla es la fila del precio de salida: $0. Significa que lo que produce gemini-decision-1 no es un texto, sino un veredicto muy corto: a qué nivel va la consulta y cuánto presupuesto de razonamiento merece. Si comparas su precio unitario con el de un modelo conversacional en la misma lista, llegarás a una conclusión totalmente equivocada.
Otro detalle es que ya tiene un caso de uso real en producción, y no se queda en un ejemplo de documentación. Gemini Notebook es un producto propio de Google, así que esta forma de enrutar se puso a funcionar primero en casa y luego se presentó al público. Eso le da más credibilidad que un simple benchmark, aunque sigue siendo una descripción unilateral de la propia empresa.
Cómo funciona Gemini Decision: el caso de enrutamiento que Google cuenta de su propio producto
Según el blog de Google, las preguntas del día a día en Gemini Notebook pasan primero por la Decisions API, que decide a qué nivel de modelo y a qué nivel de razonamiento se envía cada una. Es decir, la decisión de enrutamiento es en sí misma una invocación del modelo, y no un bloque de if-else escrito a mano ni un umbral ajustado manualmente.
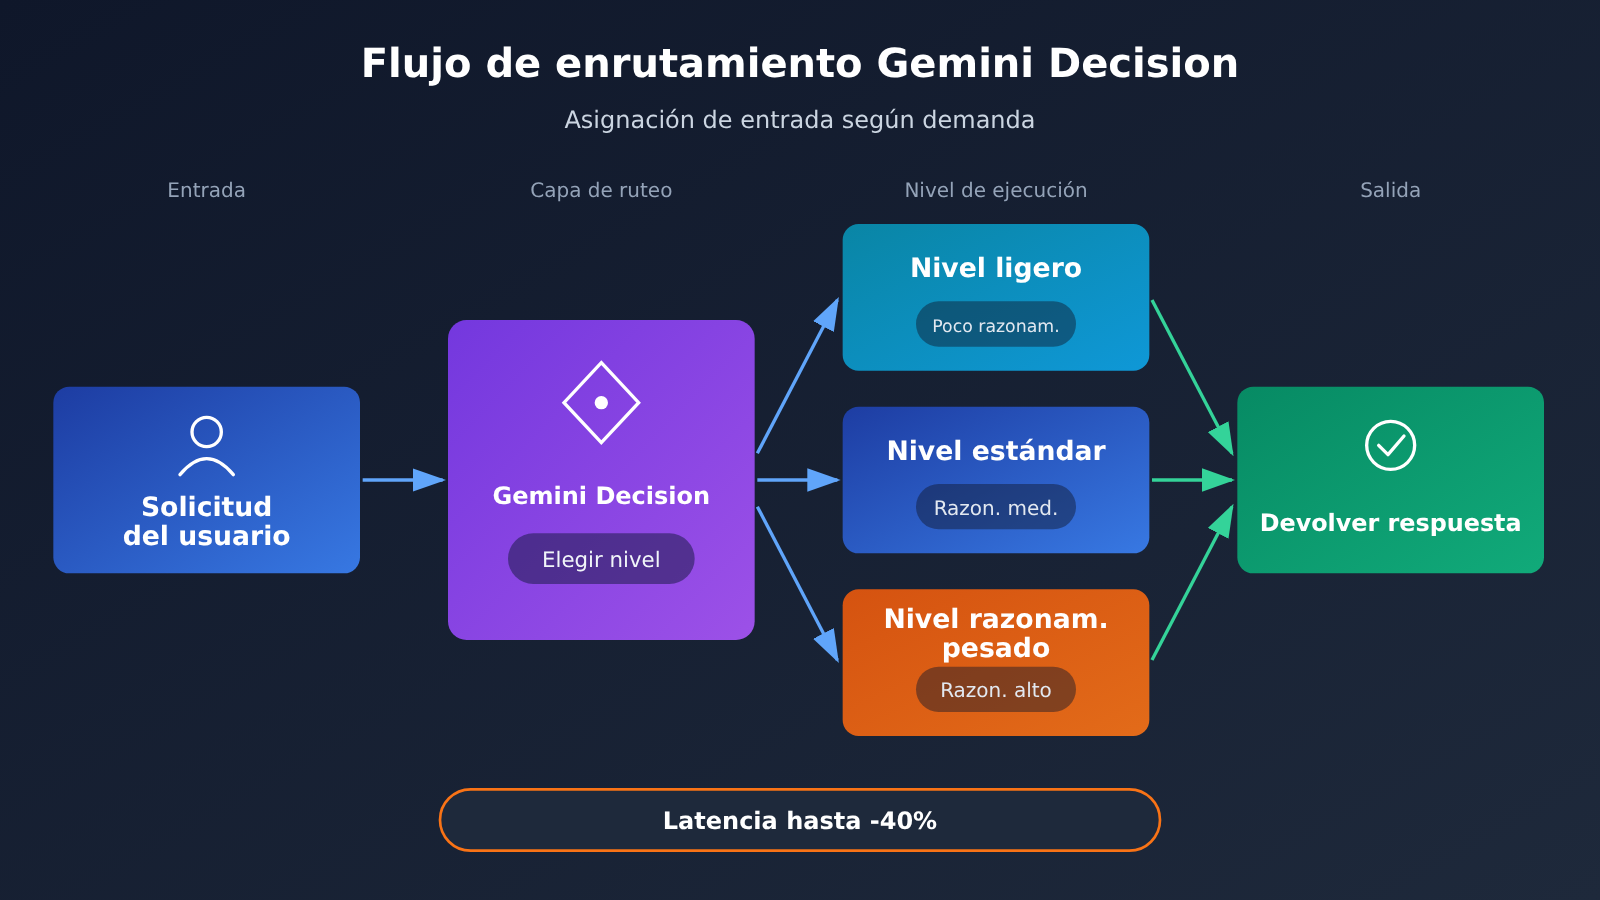
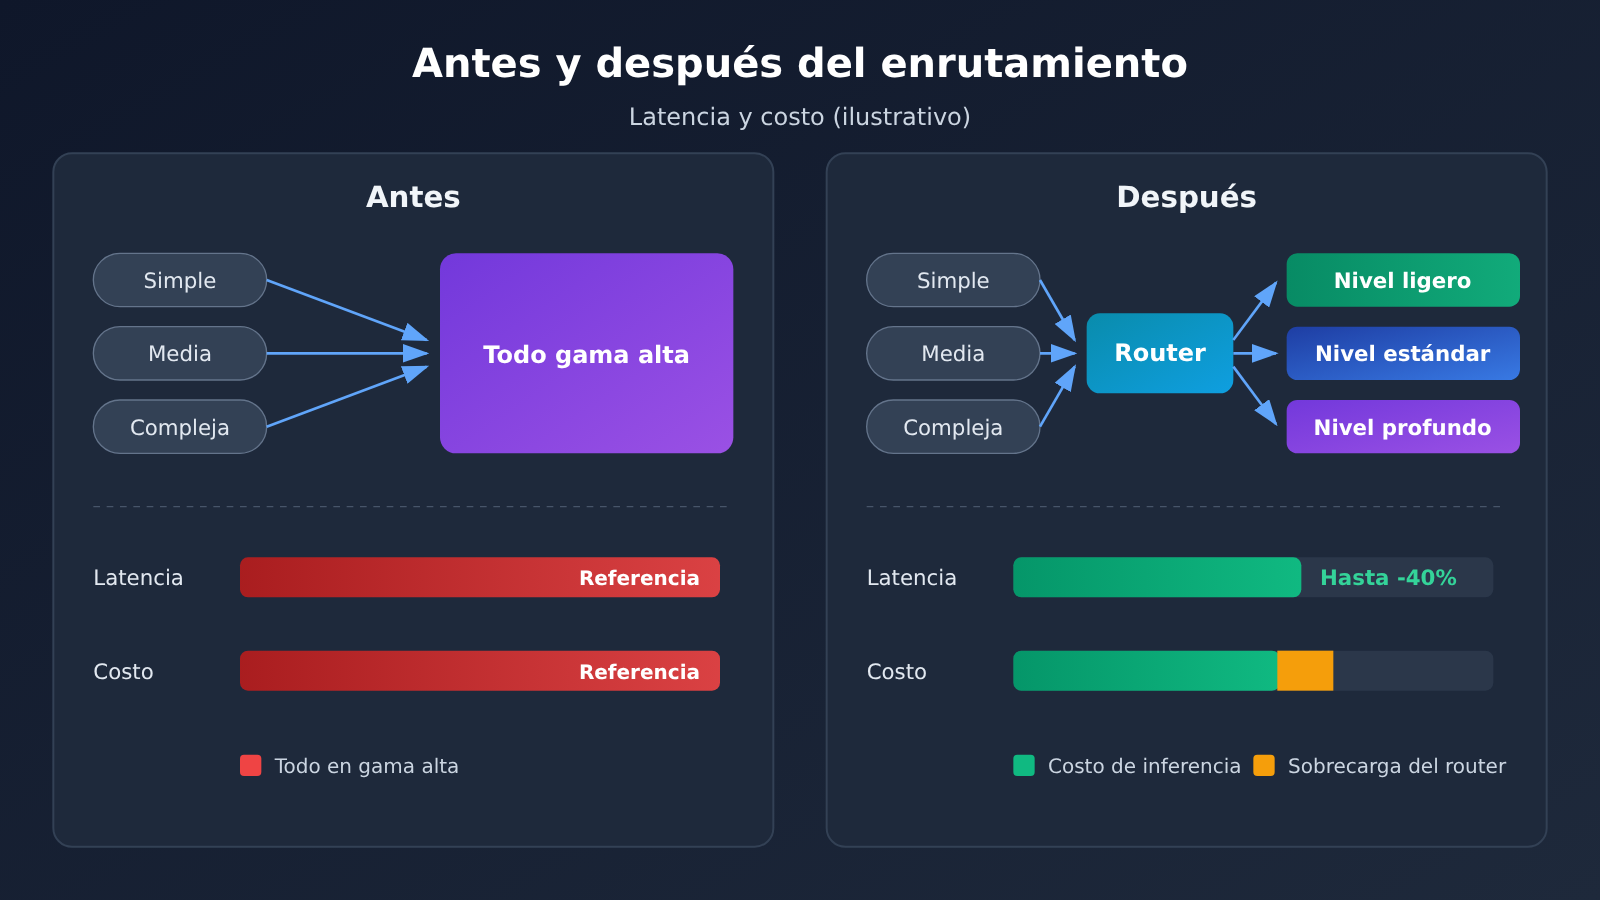
El problema que resuelve este diseño es muy real: en un mismo producto, la mayoría de las solicitudes son preguntas cotidianas y ligeras, y solo unas pocas requieren razonamiento profundo. Si todo va al mismo nivel, las solicitudes ligeras arrastran el peso de un modelo pesado y se disparan a la vez la latencia y el costo. Si todo va al nivel ligero, las preguntas complejas no se responden bien. Poner un modelo de decisión dedicado en la entrada convierte la «asignación según la necesidad» en infraestructura.
| Etapa | Práctica habitual antes del enrutamiento | Con Decision |
|---|---|---|
| Selección de nivel | Reglas en el código o coincidencia por palabras clave | Un modelo decide a partir del contenido de la solicitud |
| Mantenimiento | Los umbrales hay que ajustarlos a mano según cambia el negocio | La lógica de decisión evoluciona con las actualizaciones del modelo |
| Impacto en latencia | Si abundan las solicitudes de nivel pesado, todo se vuelve más lento | Según Google, hasta un 40 % menos de latencia en consultas cotidianas |
| Impacto en costo | Todas las solicitudes se cobran al mismo nivel | Las solicitudes ligeras caen en el nivel ligero y cambia la estructura de la factura |
Conviene dejar claro que ese 40 % corresponde al escenario de las «consultas cotidianas», no a todas las solicitudes. La cifra oficial está expresada como un tope, y la mejora real en tu caso dependerá de cuántas de tus solicitudes sean de las que se pueden pasar a un nivel inferior. Si tu producto se dedica casi por completo al análisis de documentos largos o a tareas complejas de programación, el margen para bajar de nivel será, por naturaleza, mucho menor.
🎯 Consejo técnico: si quieres comprobar cuánto te aportaría un enfoque de enrutamiento como este, puedes usar la interfaz unificada de APIYI (apiyi.com) para ejecutar modelos de distintos niveles sobre un mismo lote de solicitudes. Compara la latencia y la calidad de la salida, y luego decide si merece la pena añadir una capa de enrutamiento.
Estructura de facturación de Gemini Decision y su impacto en los costos
Con una entrada de $0.10 / 1M tokens y una salida de $0, la estructura básicamente cobra por «cuánto contexto lee el modelo». Para decidir la ruta hace falta ver el contenido de la solicitud, así que tiene sentido cobrar en la entrada. En cambio, solo devuelve una conclusión sobre el nivel, así que la salida casi no genera costo y el precio oficial es directamente 0.
Esto implica que quien lo integre tiene que hacer una cuenta más: la propia capa de enrutamiento también consume tokens. Para que el balance sea positivo, el ahorro de razonamiento que se obtiene al bajar de nivel una solicitud tiene que cubrir ese gasto extra de decisión. Cuanto más larga sea la solicitud y mayor la diferencia entre niveles, más fácil es que la cuenta salga a favor. En escenarios con solicitudes cortas, que ya iban por un nivel ligero, añadir una capa de enrutamiento puede incluso salir más caro.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# gemini-decision-1 todavía no aparece en la lista de precios de la plataforma
# Puedes sustituir model por un modelo de chat existente para validar el flujo de negocio
response = client.chat.completions.create(
    model="YOUR_MODEL",
    messages=[{"role": "user", "content": "这个问题需要多深的推理?"}]
)
print(response.choices[0].message.content)
🚀 Inicio rápido: a fecha de 2026-11-12, gemini-decision-1 aún no figura en la lista de precios de APIYI (apiyi.com), y la plataforma lo incorporará lo antes posible. Mientras tanto, puedes validar el flujo llamando a otros modelos con la misma interfaz compatible con OpenAI; el costo de cambiar después es casi nulo. Consulta los modelos y precios concretos en la lista de apiyi.com.
A quién afecta: los cambios reales en tres tipos de cadena de llamadas
Lado de la aplicación: el enrutamiento pasa de escribirse a mano a consumirse como una interfaz
Hasta ahora, quien quería repartir el tráfico entre varios modelos solía mantener una tabla de reglas y ajustarla una y otra vez cada vez que cambiaba la generación de los modelos. Si la decisión de enrutamiento se puede delegar a un modelo especializado, la lógica de la aplicación se adelgaza bastante, y el trabajo se reduce a definir «qué niveles hay» y «qué modelo va en cada nivel». El precio es una llamada más en serie, así que la calidad de la red en la capa de entrada influye directamente en la latencia total.
Lado del costo: que baje la latencia no significa que baje la factura
Latencia y costo son dos curvas distintas. Bajar de nivel puede reducir ambas a la vez, pero el propio enrutador se cobra por tokens de entrada, y en escenarios de solicitudes cortas el costo marginal sube. Lo más sensato es agrupar primero las solicitudes por tipo y activar el enrutamiento solo en la parte del tráfico donde la complejidad varía mucho, dejando el resto en un nivel fijo.
| Tipo de equipo | Principal beneficio | Costos a vigilar |
|---|---|---|
| Productos de preguntas y respuestas para usuarios finales | Baja la latencia en las consultas cotidianas y la experiencia mejora de forma notable | Tokens adicionales por la llamada de enrutamiento |
| Herramientas internas de empresa | Se mezclan solicitudes complejas y simples, con grandes diferencias entre niveles | Hay que rediseñar la división de niveles |
| Servicios de solicitudes cortas y de alta frecuencia | Beneficio limitado, poco margen para bajar de nivel | Un salto más en serie puede no compensar |
Lado de la plataforma: la rapidez para incorporar nuevos ID de modelo se convierte en un criterio de selección
El ritmo de actualización de los modelos es cada vez más rápido, y entre que se anuncia un ID y que está disponible de forma estable suele haber una ventana. Para los equipos que usan plataformas de agregación, poder obtener rápido una interfaz invocable durante ese tiempo afecta directamente a la planificación de las validaciones. Ahí está precisamente el valor de plataformas como APIYI (apiyi.com): una sola clave API, una interfaz compatible con OpenAI y, cuando un modelo se publica, la posibilidad de cambiarte a él sin tocar la estructura del código. El estado de las incorporaciones y los detalles de facturación son los que se muestran en la página de apiyi.com.
Preguntas frecuentes (FAQ)
P1: ¿Qué es Gemini Decision?
gemini-decision-1, anunciado por Google, es un modelo pensado para el enrutamiento y la toma de decisiones en tiempo real. No se encarga de generar el contenido de la respuesta: lo que hace es decidir a qué nivel de modelo y a qué nivel de razonamiento debe ir cada solicitud. Gemini Notebook es, por ahora, su primer caso de uso en producción que se ha hecho público.
P2: ¿En qué se diferencia de un modelo Gemini normal?
Un modelo de conversación normal produce contenido; este produce un resultado de decisión muy corto, así que la facturación funciona de forma totalmente distinta: entrada a $0.10 / 1M tokens y salida a $0. Si lo entiendes como un «modelo de generación más barato», vas por mal camino.
P3: ¿De dónde sale eso de «hasta un 40 % menos de latencia»?
La cifra viene de lo que Google cuenta en su blog oficial. Se refiere al techo de mejora de latencia de Gemini Notebook en escenarios de consultas cotidianas, y no es el resultado de una prueba de carga independiente de terceros. El beneficio real depende de cuántas de tus solicitudes sean consultas ligeras que se puedan mandar a un nivel inferior.
P4: ¿Cuánto dinero podría ahorrarle a mi negocio?
No hay una respuesta universal. El ahorro en costes de inferencia viene de que las solicitudes se asignan a niveles más ligeros, mientras que el propio enrutamiento se cobra por tokens de entrada. Cuanto más largas sean las solicitudes y más grande sea la diferencia entre niveles, más claro será el beneficio neto; en escenarios con muchas solicitudes cortas y frecuentes conviene evaluarlo con cuidado.
P5: ¿Ya puedo usar Gemini Decision?
A fecha de 2026-11-12, gemini-decision-1 todavía no aparece en la lista de precios de APIYI (apiyi.com), pero la plataforma lo añadirá lo antes posible. Mientras tanto, puedes usar la interfaz unificada de apiyi.com para dejar funcionando el flujo de tu negocio y, cuando el ID esté disponible, solo tendrás que cambiar el nombre del modelo. El modelo concreto y su precio son los que figuren en la lista de apiyi.com.
P6: ¿Qué costes conocidos tiene añadir una capa de enrutamiento?
Principalmente tres: hay una llamada en serie más en la ruta de la solicitud, así que la calidad de la red en la entrada pasa a importar más; la propia decisión de enrutamiento consume tokens de entrada, de modo que el coste marginal de las solicitudes cortas sube; y la división en niveles hay que rediseñarla según tu negocio, no sirve copiar la de otros.
Puntos clave de Gemini Decision (Key Takeaways)
- Posicionamiento: gemini-decision-1 es un modelo de enrutamiento en tiempo real; devuelve una decisión de nivel y no genera texto de respuesta.
- Caso de uso: Gemini Notebook lo usa para asignar las consultas del día a día al nivel de modelo y al nivel de razonamiento adecuados.
- Beneficio: según Google, la latencia de las consultas cotidianas baja hasta un 40 %, una cifra autoinformada.
- Precio: entrada a $0.10 / 1M tokens, salida a $0; se cobra según el contexto leído.
- Coste: el propio enrutamiento consume tokens, así que en peticiones cortas hay que calcular aparte el beneficio neto.
- Disponibilidad: a fecha de 2026-11-12, APIYI (apiyi.com) todavía no tiene este ID; lo añadiremos lo antes posible. Los precios son los que aparecen en la lista de apiyi.com.
- Cómo validarlo: primero haz funcionar el flujo con una interfaz unificada y, después, decide si merece la pena introducir una capa de enrutamiento en producción.
Conclusión
Lo interesante de este anuncio no es lo potente que sea el modelo, sino que Google ha convertido «elegir modelo» en una interfaz que se puede ofrecer al exterior, y que antes la ha puesto a prueba en sus propios productos. Para quienes desarrollamos, hay tres cosas que conviene recordar: la decisión de enrutamiento está pasando de ser lógica de código a ser una invocación del modelo; la mejora de latencia es una cifra autoinformada y, además, un techo, así que hay que recalcularla con la estructura de tu propio tráfico; y la nueva dimensión de cobro cambia la estructura de costes, por lo que no basta con mirar lo que se ahorra al bajar de nivel.
Si quieres probar este enfoque cuanto antes, puedes empezar montando la lógica de niveles con los modelos actuales. Cuando gemini-decision-1 esté disponible en APIYI (apiyi.com), bastará con cambiar el nombre del modelo para hacer el cambio. Los modelos y los precios son los que figuran en la lista de apiyi.com.
Referencias
- Blog oficial de Google: Gemini Decisions API
- Enlace:
blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/ -
Descripción: única fuente original de este artículo para el ID del modelo, los casos de uso de enrutamiento, las cifras de latencia y los precios
-
Lista de precios de APIYI apiyi.com
- Enlace:
apiyi.com - Descripción: sirve para verificar si gemini-decision-1 ya está disponible y cuál es el criterio final de facturación
Autor: Equipo técnico de APIYI
Intercambio técnico: te invitamos a contactarnos desde la página principal de APIYI (apiyi.com). Las novedades sobre modelos añadidos y la documentación de nuevas interfaces están en el centro de documentación del sitio.


