
Nota del autor: que más del 30 % del código sea generado por IA no significa que la entrega sea más rápida. En este artículo desglosamos el cálculo del «límite teórico del 7 %», analizamos cinco cuellos de botella y proponemos una lista de comprobación para equipos.
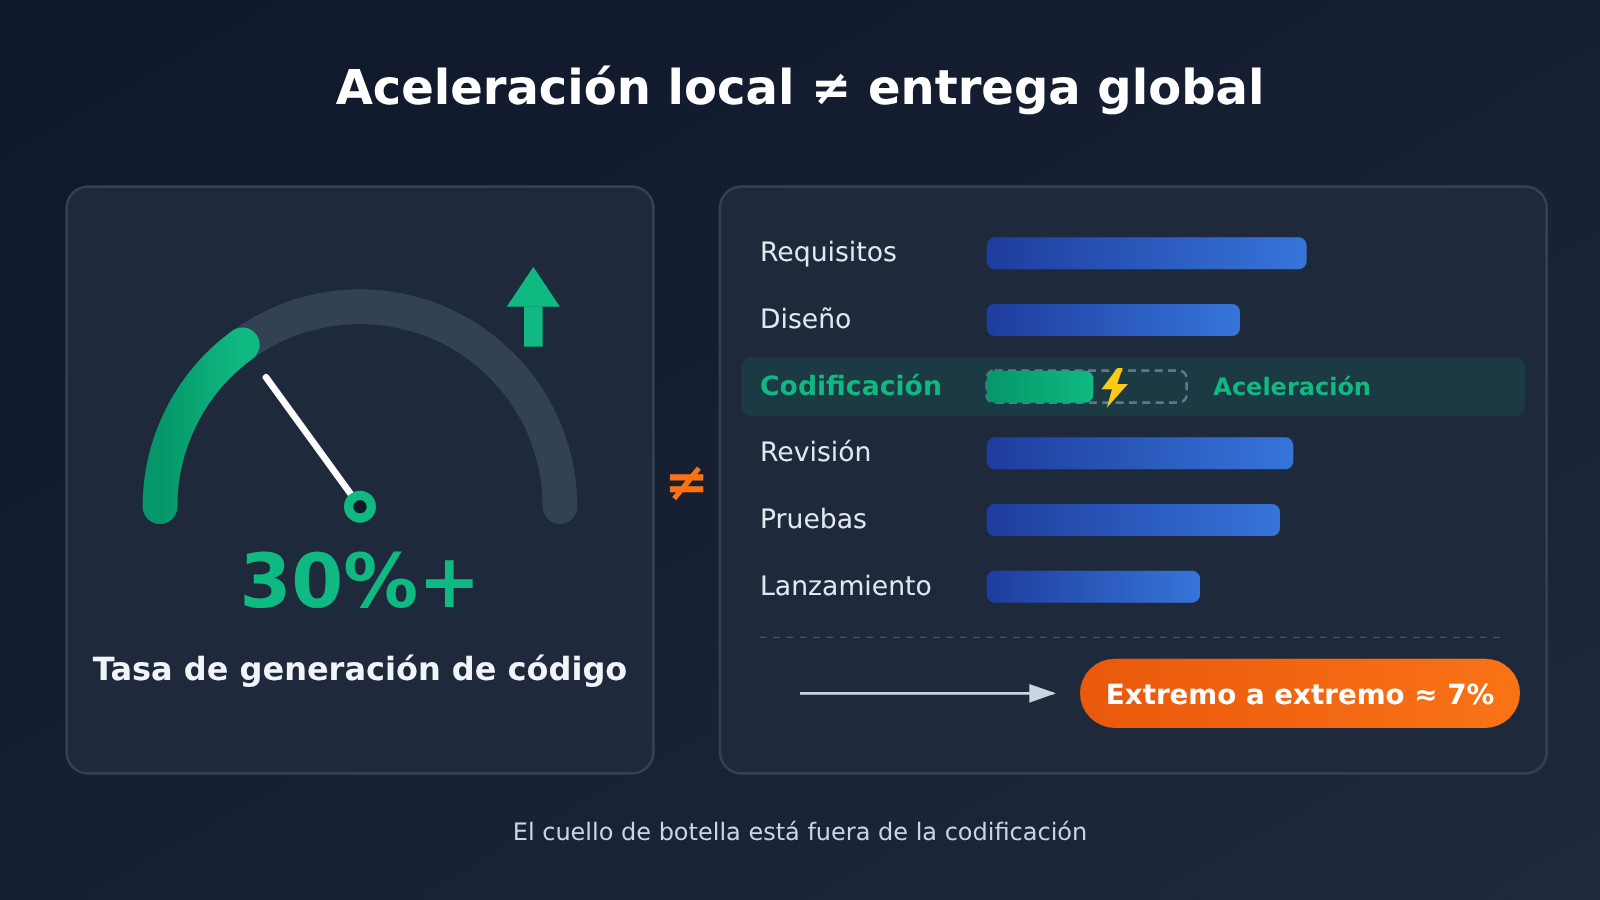
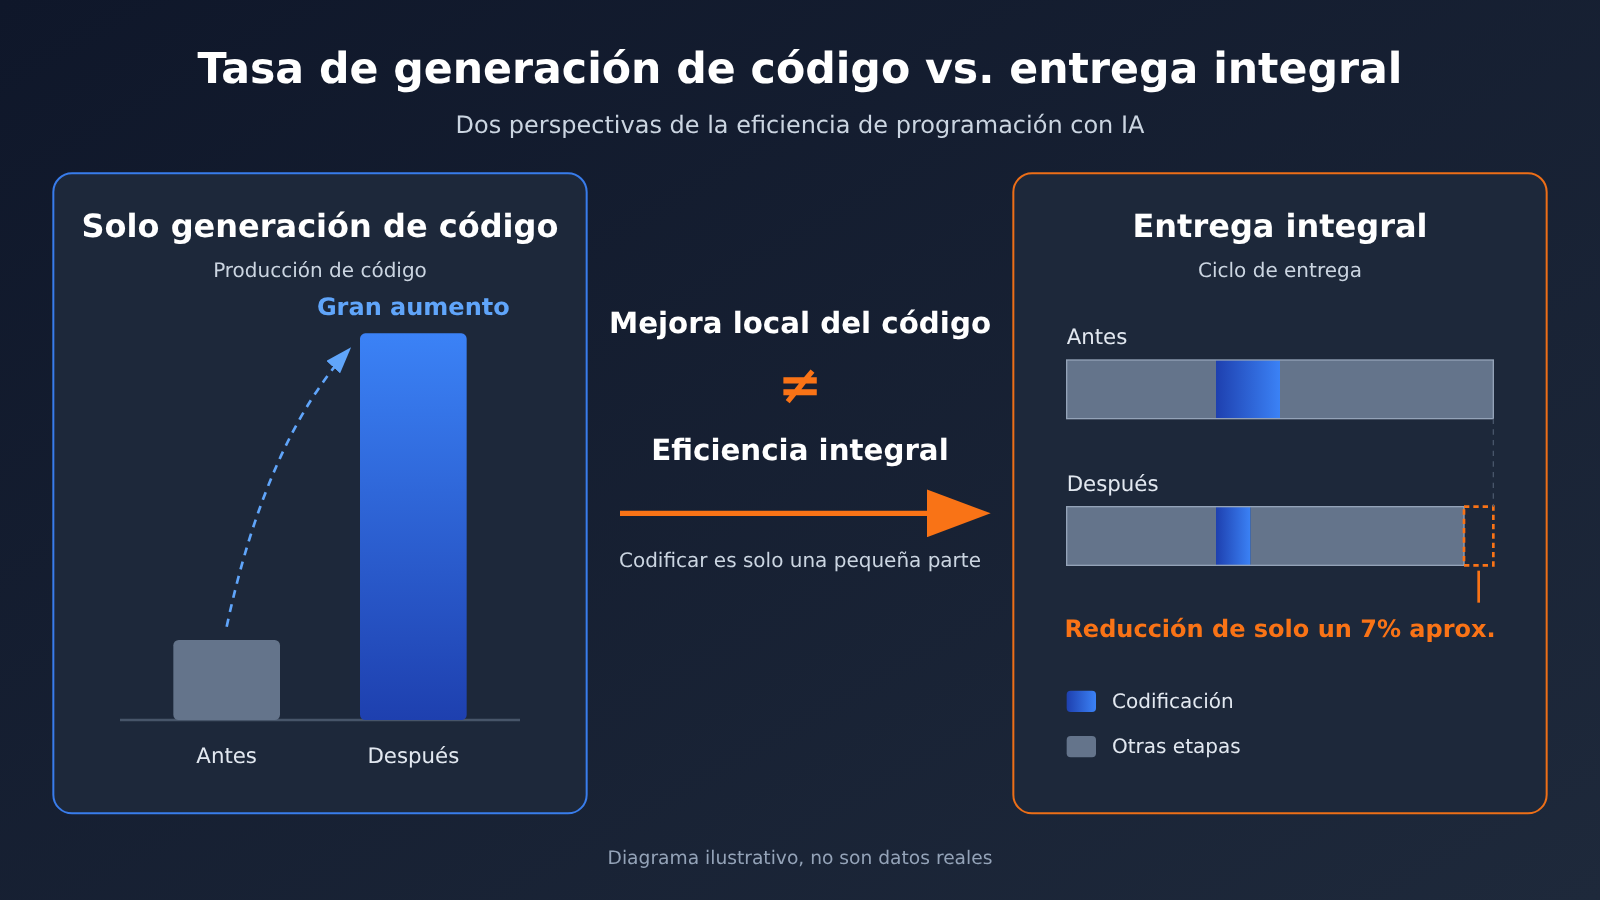
La conclusión, de entrada, es esta: el porcentaje de código generado no equivale a la velocidad de entrega. Que la proporción de código generado por IA pase de un solo dígito a más del 30 % solo aumenta la producción en una etapa: la codificación. El tiempo de entrega de extremo a extremo también incluye la confirmación de requisitos, el diseño, la revisión, las pruebas, la integración, el despliegue y la aceptación. La codificación suele representar solo una parte de todo el proceso, así que, por mucho que aumente el porcentaje de código generado, el ciclo de entrega solo puede acortarse en la medida que permita la proporción de tiempo dedicada a codificar.
Esto también explica la desconcertante situación que viven muchos responsables técnicos: han implantado las herramientas y los informes sobre código generado son excelentes, pero el ciclo de entrega apenas ha cambiado. Un informe del sector, basado en el desglose del tiempo de trabajo de un equipo, estimó que el límite de mejora de eficiencia de extremo a extremo rondaba el 7 %. No se trata de desacreditar la programación con IA, sino de recordar que lo que realmente frena las entregas son cinco cuellos de botella ajenos a la codificación. En este artículo veremos cómo se calcula ese 7 %, cuáles son los límites de esa estimación y cómo puede evaluar su situación tu equipo.
Más del 30% de código generado y un límite del 7%: claves de un vistazo
Antes de entrar en los cálculos, esta tabla resume los datos clave y cómo se han medido. Conviene prestar atención al origen y la fiabilidad de cada cifra: el resto del análisis se apoya en esos límites.
| Dato | Detalle | Alcance |
|---|---|---|
| Proporción de código generado | Más del 30% | Porcentaje de código generado por IA; solo refleja la producción en la fase de programación |
| Límite de mejora de la eficiencia de extremo a extremo | En torno al 7% | Estimación basada en el desglose de tiempos de un equipo concreto; no es una ley universal |
| Cifra comentada en el sector | En torno al 3%-5% | Procede de conversaciones y carece de muestras verificables |
| Producción de código útil | 2-3 veces mayor | Datos de una retrospectiva del equipo; no se han detallado los criterios de medición ni el método de comparación |
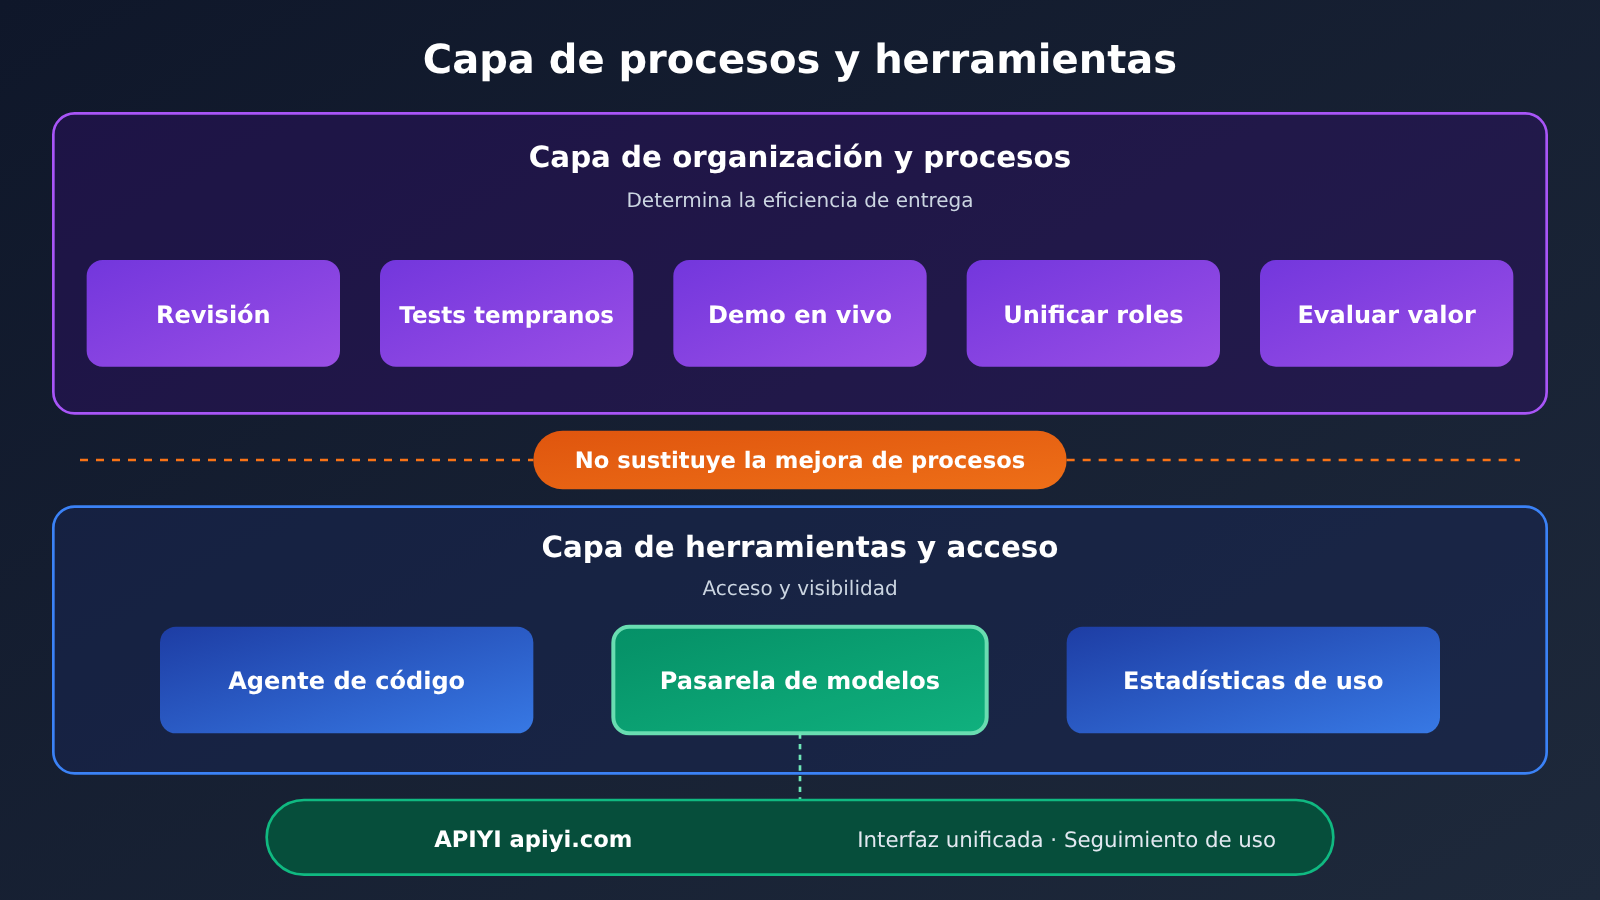
| Cinco cuellos de botella | Cola de revisión, pruebas y observabilidad en fases tempranas, Live Demo, convergencia de roles y evaluación de valor | Problemas de organización y procesos |
| Integración de Coding Agents | Se pueden integrar de forma unificada mediante interfaces agregadoras como APIYI apiyi.com | Facilita la integración y el seguimiento del uso, pero no resuelve los cuellos de botella del proceso |
Estas cifras no se contradicen. La «producción de código útil 2-3 veces mayor» se refiere al resultado de la programación; el «7%» y el «3%-5%», a la entrega de extremo a extremo. La primera es una métrica local y las otras son métricas globales: entre ellas hay toda una cadena de entrega.
De dónde sale el límite del 7%: la relación entre la tasa de código generado y el peso de la codificación
Desglose de la fórmula de mejora de extremo a extremo
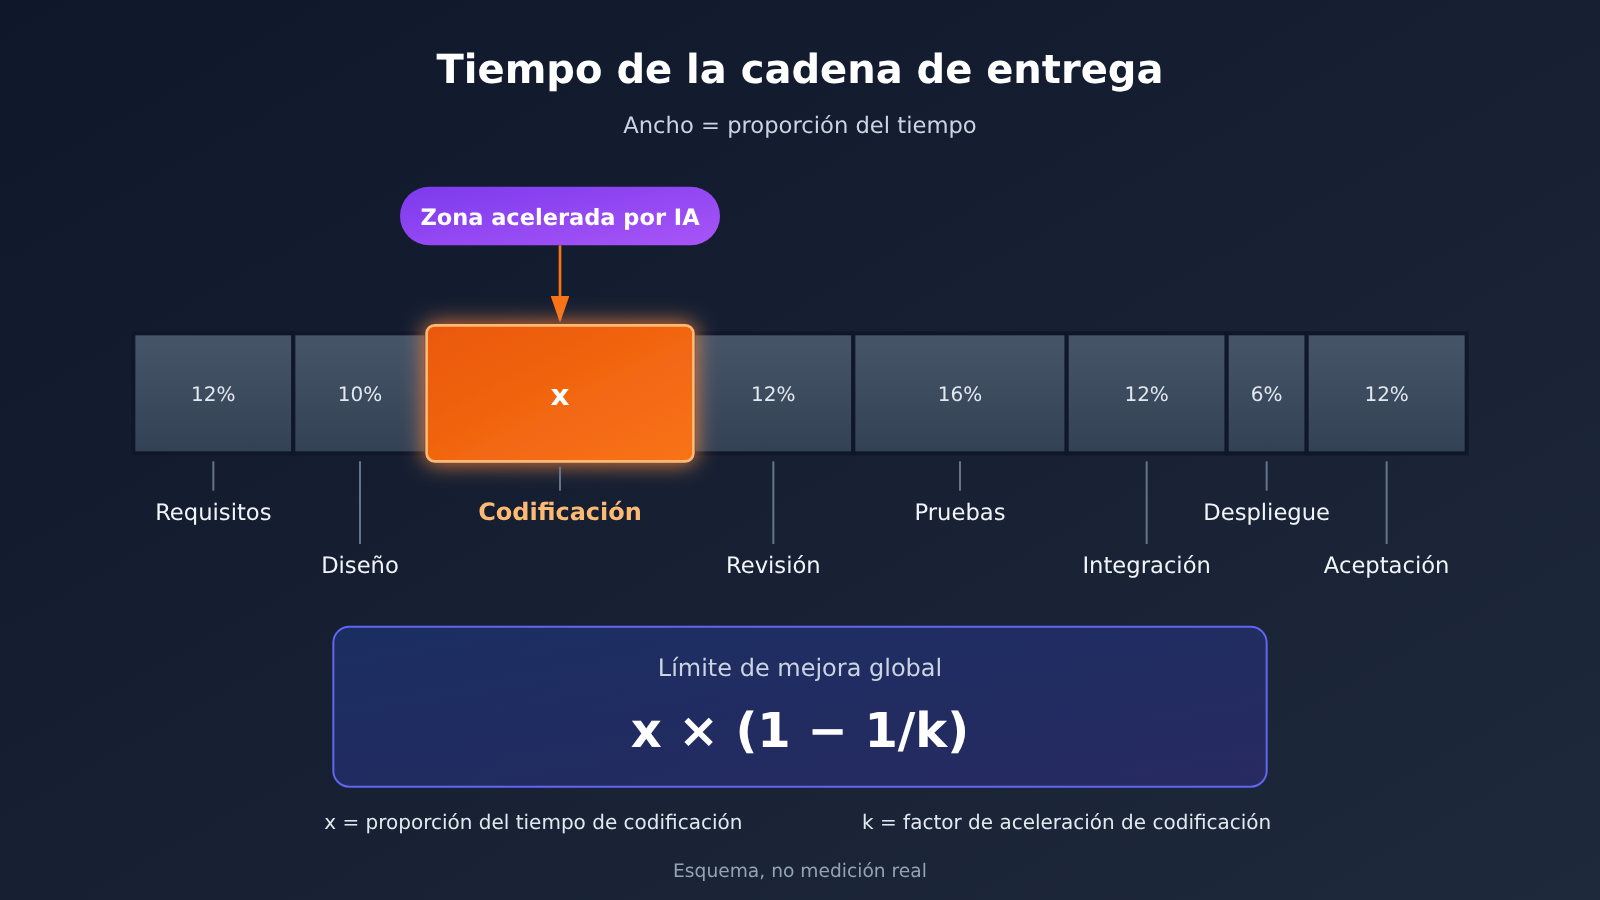
El límite de la mejora de extremo a extremo puede estimarse con una fórmula sencilla: límite de mejora de extremo a extremo ≈ x × (1 - 1/k). Aquí, x es la proporción del tiempo total de entrega que se dedica a codificar y k es el factor de aceleración de la codificación. En esencia, es una aplicación de la ley de Amdahl al proceso de desarrollo: si solo aceleras una parte del sistema, la proporción que representa esa parte limita la mejora global.
Veamos un ejemplo: supongamos que la codificación ocupa el 14% del tiempo de entrega y que la IA permite codificar el doble de rápido (k = 2). En ese caso, 14% × (1 - 1/2) = 7%. Incluso si el tiempo de codificación se redujera a cero (k tiende a infinito), el tiempo de extremo a extremo solo podría reducirse, como máximo, un 14%. La siguiente tabla muestra los resultados con varios supuestos; son solo ejemplos de la fórmula, no datos medidos de ningún equipo.
Proporción de codificación x |
Factor de aceleración de la codificación k |
Límite de mejora de extremo a extremo | Interpretación |
|---|---|---|---|
| 10% | 3 | Aproximadamente 6.7% | Se codifica 3 veces más rápido, pero la mejora global sigue por debajo del 7% |
| 14% | 2 | 7% | Un ejemplo del mismo orden de magnitud que la estimación del material |
| 20% | 1.5 | Aproximadamente 6.7% | Cuando el factor de aceleración es bajo, la mejora se diluye rápidamente |
| 20% | 2 | 10% | Los equipos que dedican más tiempo a codificar tienen más margen de mejora |
| 30% | 2 | 15% | El caso de un equipo que dedica mucho tiempo a codificar |
| 20% | Tiende a infinito | 20% | Límite teórico si el tiempo de codificación se redujera a cero |
Una tasa de código generado del 30% no significa codificar un 30% más rápido
Hay otra confusión que suele pasarse por alto: la tasa de código generado y k no son lo mismo. La primera indica «qué proporción del código escribe la IA», mientras que k indica cuánto se acelera la codificación. El código generado por IA todavía hay que leerlo, depurarlo y modificarlo; además, la propia generación requiere tiempo para dar indicaciones, esperar y corregir errores.
Incluso bajo el supuesto extremadamente simplificado de que el 30% del código generado por IA no requiere nada de tiempo, el factor de aceleración de la codificación sería solo de 1 / (1 - 0.3) ≈ 1.43. Al combinarlo con la proporción de tiempo dedicada a codificar, la mejora de extremo a extremo es aún menor. Por eso, una cifra cercana al 7%, como la del material, no resulta extraña. Más bien, indica que la clave no está en «generar más código», sino en las etapas que rodean a la codificación.
Conviene insistir: el 7% es una estimación basada en el desglose del tiempo de un equipo concreto. La proporción dedicada a codificar, la estabilidad de los requisitos y el sistema de pruebas de tu equipo serán distintos, así que el resultado podría ser mayor o menor. Su valor está en ofrecer un marco para pensar el problema, no una conclusión que se pueda aplicar directamente.
5 cuellos de botella que impiden acelerar las entregas: el problema real va más allá de generar código
Cuando escribir código es más rápido, la presión se desplaza hacia las etapas posteriores del flujo de trabajo. De los cinco cuellos de botella que veremos, algunos son problemas nuevos amplificados por la programación con IA; otros siempre estuvieron ahí, pero antes quedaban ocultos por la velocidad de desarrollo.
Cuello de botella 1: la cola de revisión del personal clave
Cuanto más código genera la IA, más código hay que revisar. Estas revisiones suelen recaer en unas pocas personas clave del equipo, que deben entender el contexto de negocio y evaluar tanto los casos límite como los riesgos potenciales del código generado. Como resultado, gran parte del tiempo ahorrado al escribir código acaba convertido en tiempo de espera en la cola de revisión.
Para complicar las cosas, el código generado por IA «parece correcto», así que quienes lo revisan necesitan leerlo con más atención. Eso significa que el costo de revisión por unidad de código no necesariamente disminuye. Si no se ajusta el proceso —por ejemplo, estableciendo distintos niveles de revisión, definiendo qué cambios pueden aprobar otras personas del equipo y delegando las comprobaciones de estilo y normas en herramientas automatizadas—, el personal clave se convertirá en el principal cuello de botella de todo el flujo.
Cuello de botella 2: Adelantar las pruebas y la observabilidad
En muchos equipos, las pruebas, la monitorización y la observabilidad no entran en juego hasta las últimas etapas del desarrollo. Cuando la programación se acelera, los problemas se acumulan más rápido en la fase de pruebas y el retrabajo se concentra al final. Si los casos de prueba, la instrumentación y las reglas de alerta no se diseñan antes o durante la programación, la integración y las correcciones posteriores pueden consumir lo que se ganó al principio.
La clave de adelantar las pruebas y la observabilidad es que la «verificación» y la «programación» ocurran al mismo tiempo. Esto es especialmente importante con el código generado por IA: necesitas pruebas ejecutables que te permitan comprobar rápidamente si el resultado es correcto, en lugar de revisarlo manualmente línea por línea.
Cuello de botella 3: Confirmar los requisitos con una demo en vivo para reducir el retrabajo
Lo más costoso del ciclo de entrega no suele ser escribir código, sino escribirlo mal y tener que corregirlo. Cuando los requisitos se interpretan de forma incorrecta, hay que repetir la programación, la revisión y las pruebas. Ahora que la IA reduce el costo de programar, una mejor opción es crear rápidamente una demo en vivo y funcional para que quienes solicitaron el desarrollo puedan confirmar, mediante una interacción real, si «era esto lo que querían decir».
Esto equivale a pasar de revisar documentos a revisar prototipos para confirmar los requisitos. Cada persona puede interpretar un documento de forma distinta, mientras que una demo funcional permite detectar esas diferencias cuanto antes. La verdadera ventaja de reducir el costo de programar quizá no sea terminar antes el código definitivo, sino poder probar, equivocarse y corregir a menor costo.
Cuello de botella 4: convergencia de puestos y cambios en los roles de PDFE y ABE
En un proceso tradicional, hay numerosos traspasos entre producto, diseño, frontend, backend y pruebas. Cada traspaso implica esperas, pérdida de contexto y un nuevo esfuerzo de coordinación. La convergencia de roles como PDFE y ABE, que se menciona en el material, busca que una persona o un equipo pequeño cubra una parte más amplia del proceso y reduzca el número de traspasos.
Cuando la IA asume más trabajo de programación, los ingenieros tienen margen para ampliar su participación hacia los requisitos y las pruebas. Esto hace viable la convergencia de puestos. Sin embargo, por ahora faltan pruebas sobre las condiciones y los costos de replicar este cambio organizativo en equipos de distintos tamaños. Puede que encaje de forma natural en equipos pequeños, pero en organizaciones grandes implica cambios sistémicos en las responsabilidades, la evaluación del desempeño y las formas de colaboración. No se puede copiar sin más.
Cuello de botella 5: evaluación del valor y diccionario de conceptos/SDD
Si las definiciones de conceptos y datos no están alineadas, cuanto más rápido programe la IA, más rápido se equivocará. Un mismo término de negocio puede tener significados distintos según el módulo, y los campos de las interfaces pueden seguir criterios inconsistentes. Estos problemas suelen salir a la luz durante la integración y la aceptación. La práctica que se menciona en el material consiste en evaluar primero el valor, alinear después los conceptos y datos mediante un diccionario de conceptos y SDD (desarrollo guiado por especificaciones), y solo entonces escribir el código.
La evaluación del valor responde a «¿vale la pena hacer esto?», mientras que el diccionario de conceptos y SDD responden a «¿estamos hablando de lo mismo?». Estos dos pasos parecen aumentar el costo inicial, pero proporcionan a la IA un contexto claro y coherente, lo que facilita que el código generado cumpla los requisitos desde el primer intento.
5 cuellos de botella y acciones para resolverlos
| Cuello de botella | Síntoma típico | Acción recomendada | Indicador de seguimiento |
|---|---|---|---|
| Acumulación de revisiones en el equipo clave | Aumenta la espera de los PR y el equipo clave está sobrecargado | Establecer niveles de revisión y automatizar las comprobaciones de estándares | Tiempo medio de espera de los PR |
| Pruebas y observabilidad tardías | El retrabajo se concentra en la fase de pruebas | Diseñar los casos de prueba y la instrumentación desde el inicio | Número de defectos que requieren volver a una fase anterior durante las pruebas |
| Confirmación de requisitos con una demo en vivo | Durante la aceptación se descubre que «no era lo que se quería» | Confirmar los requisitos con un prototipo funcional | Número de cambios de requisitos y retrabajos |
| Convergencia de roles | Hay demasiados traspasos y esperas, y se pierde contexto | Reducir los puntos de traspaso y ampliar las etapas que cubre cada persona | Número de traspasos entre etapas |
| Revisión de valor y diccionario de conceptos/SDD | Surgen criterios inconsistentes durante las pruebas de integración | Alinear conceptos y datos antes de programar | Número de problemas durante las pruebas de integración |
Autoevaluación del equipo: cómo analizar los tiempos de entrega y el beneficio de generar código más rápido
En lugar de debatir si la mejora es del 7% o del 3%-5%, es mejor calcular las cifras de tu propio equipo. Aquí tienes un método práctico para desglosarlas. Te recomendamos probarlo primero en un proyecto pequeño.
- Divide el proceso en etapas: desde que se plantea un requisito hasta su puesta en producción, sepáralo en requisitos, diseño, codificación, Review, pruebas, integración conjunta, despliegue y aceptación. Registra el tiempo efectivo y el tiempo de espera de cada etapa.
- Calcula la proporción de codificación: divide el tiempo de codificación entre el tiempo total de entrega para obtener tu
x. Muchos equipos descubren que esta cifra es menor de lo que imaginaban. - Identifica esperas y retrabajo: registra por separado el tiempo en cola para Review, el número de retrabajos durante las pruebas y los cambios de requisitos. Estos suelen concentrar buena parte del tiempo que pasa desapercibido.
- Distingue entre producción y valor: analiza por separado la «producción de código» y el «valor entregable». La tasa de generación de código y las líneas enviadas pertenecen a la primera categoría; el número de funcionalidades puestas en producción y el ciclo de entrega, a la segunda.
- Haz una comparación a pequeña escala: compara el antes y el después en un proyecto pequeño; no te limites a consultar los informes de generación de código.
- Resuelve primero el mayor cuello de botella: identifica la etapa que más tiempo consume y dale prioridad. No implementes todas las herramientas y cambios de proceso a la vez.
A continuación tienes una plantilla hipotética de desglose de tiempos que muestra cómo completarla; no representa los datos reales de ningún equipo. Puedes introducir tus propias cifras para ver qué proporción corresponde a la codificación.
| Etapa de entrega | Proporción de ejemplo (hipotética) | Principales fuentes de consumo de tiempo | ¿Puede la programación con IA acelerar esta etapa directamente? |
|---|---|---|---|
| Revisión de requisitos y valor | 15% | Comunicaciones repetidas, alineación de criterios | Indirectamente (Live Demo) |
| Diseño | 10% | Debate y revisión de propuestas | Parcialmente |
| Codificación | 15% | Escritura y depuración | Directamente |
| Review | 15% | Espera en cola, revisión | Parcialmente (asistencia en la revisión) |
| Pruebas e integración conjunta | 25% | Ejecución de casos de prueba, retrabajo | Parcialmente (generación de casos de prueba) |
| Despliegue y aceptación | 20% | Aprobaciones, comentarios de aceptación | Muy poco |
La utilidad de esta plantilla es que revela la estructura del proceso: si la codificación representa apenas algo más del diez por ciento, incluso duplicar de nuevo la tasa de generación de código tendrá un impacto limitado en el resultado de extremo a extremo. Las verdaderas oportunidades de mejora están en Review, pruebas y requisitos.
Integración y seguimiento del uso de Coding Agent: qué puede y qué no puede hacer APIYI
Al implementar herramientas de programación con IA, hay dos aspectos inevitables: la integración y el seguimiento de los costos. APIYI apiyi.com permite conectar herramientas como Cursor y Cline y ofrece una interfaz unificada compatible con OpenAI. Con una sola clave API puedes invocar modelos de OpenAI, Claude, Gemini y otros proveedores. Para conectarte, basta con configurar https://api.apiyi.com/v1 como base_url en la herramienta.
Para los equipos responsables de la productividad de desarrollo, los datos de uso son aún más valiosos. Las estadísticas de la consola permiten observar el consumo de tokens de Coding Agent y la distribución de invocaciones entre modelos. Así puedes determinar qué tareas se benefician de modelos más potentes y cuáles se pueden resolver con modelos ligeros. Estos datos pueden analizarse junto con el desglose de los tiempos de entrega presentado antes, para evaluar la relación entre la inversión en programación con IA y sus resultados.
💡 Recomendación de integración: si el equipo está evaluando varios modelos de programación, puede usar APIYI apiyi.com para integrarlos y comparar su uso desde una interfaz unificada. Los nuevos usuarios cuentan con créditos gratuitos de prueba, ideales para empezar con una comparación en un proyecto pequeño. Consulta la consola y la documentación para conocer los precios y la disponibilidad de los modelos.
Pero hay algo que conviene dejar claro: la pasarela por sí sola no puede mejorar la eficiencia de entrega de extremo a extremo. Facilita la integración, el cambio de modelo y la visibilidad del uso, pero los cuellos de botella del proceso —como las colas de revisión, las pruebas que hay que repetir y las desviaciones respecto a los requisitos— solo pueden resolverse a nivel organizativo. Considerar la pasarela una solución de productividad es el mismo tipo de error que usar la tasa de generación de código como indicador de entrega.
Preguntas frecuentes (FAQ)
P1: Si más del 30% del código se genera con IA, ¿por qué la entrega de principio a fin solo es alrededor de un 7% más rápida?
Porque el porcentaje de código generado solo afecta a la etapa de programación. El límite aproximado de la mejora de principio a fin es `x × (1 – 1/k)`: si la proporción de tiempo dedicada a programar, `x`, no es alta, la ganancia tiene un techo. Ten en cuenta que el 7% es una estimación basada en el desglose de tiempos de un equipo concreto, no una conclusión universal. Tu equipo debe recalcularlo con sus propios datos.
P2: ¿Son fiables las cifras del 3%-5% y de 2-3 veces?
Conviene tomar ambas con cautela. La mejora del 3%-5% de principio a fin procede de conversaciones en el sector y carece de muestras verificables; el aumento de 2-3 veces en la producción de código efectivo proviene de una retrospectiva de equipo, sin que se hayan publicado los criterios de medición ni los métodos de comparación. Pueden servir como referencia, pero no conviene usarlas directamente para tomar decisiones.
P3: ¿Cuál de los 5 cuellos de botella conviene resolver primero?
Empieza por desglosar el tiempo que dedica tu equipo a la entrega y prioriza la etapa que ocupe la mayor proporción. Muchos equipos descubren que la espera de revisiones y el trabajo repetido tras las pruebas son los principales problemas; en otros, lo más grave son los cambios de requisitos. No se recomienda aplicar todos los cambios a la vez: resuelve primero el mayor cuello de botella para que sea más fácil observar el efecto.
P4: ¿Cómo se pueden observar el uso de modelos y los costos de los agentes de programación del equipo?
Puedes conectar todas las herramientas de programación a un mismo punto de acceso de API y consultar después el consumo de tokens y la distribución por modelo en la consola. Por ejemplo, al conectar herramientas como Cursor y Cline a través de APIYI apiyi.com, puedes consultar los datos de uso de forma centralizada. Sin embargo, observar el uso solo ayuda a tomar decisiones; los cuellos de botella del proceso siguen requiriendo soluciones organizativas.
P5: ¿La consolidación de puestos es adecuada para todos los equipos?
No necesariamente. La idea de combinar roles como PDFE y ABE es reducir los traspasos de trabajo, pero faltan datos sobre las condiciones y los costos de aplicar este cambio en equipos de distintos tamaños. Conviene hacer primero una prueba piloto en un grupo pequeño, observar los cambios en el número de traspasos y el ciclo de entrega, y después decidir si se extiende.
Tasa de generación de código y entrega de extremo a extremo: puntos clave
- La tasa de generación de código no equivale a la velocidad de entrega: solo refleja la producción durante la codificación, no la mejora de todo el proceso.
- El 7% se obtiene mediante una fórmula:
x × (1 - 1/k). La proporción de tiempo dedicada a codificar determina el límite de la mejora. - Hay que distinguir el alcance de las cifras: el 7% es una estimación para un equipo concreto, el 3%-5% procede de conversaciones y no se ha indicado cómo se calculó la cifra de 2-3 veces.
- Los cuellos de botella están fuera de la codificación: la revisión, las pruebas, la confirmación de requisitos, los traspasos y la alineación de conceptos ocupan la mayor parte del tiempo.
- Primero desglosa los tiempos y luego cambia el proceso: compara proyectos pequeños y corrige un solo cuello de botella a la vez, empezando por el mayor.
- Las herramientas facilitan el acceso y la observación: APIYI apiyi.com permite acceder de forma unificada a agentes de programación y consultar su uso, pero no resuelve los problemas de proceso.
Conclusión: ¿qué debe hacer el equipo cuando la tasa de generación de código supera el 30%?
Superar una tasa de generación de código del 30% es un avance real, pero solo es el punto de partida. La entrega de extremo a extremo depende de toda una cadena, y la codificación es solo una parte. La fórmula x × (1 - 1/k) muestra claramente el límite de acelerar una fase aislada. La importancia del 7% no está en su precisión, sino en que nos recuerda que debemos dejar de mirar «cuánto código se escribió» y centrarnos en «cuánto valor se entregó».
Las mayores oportunidades de mejora están en los mecanismos de revisión, la incorporación temprana de pruebas y observabilidad, la confirmación de requisitos mediante demos en vivo, la concentración de responsabilidades y la revisión del valor y alineación de conceptos. Todo esto implica trabajo organizativo y de procesos que ninguna herramienta puede sustituir. En cuanto a las herramientas, recomendamos usar APIYI apiyi.com para acceder de forma unificada a modelos de programación y observar su uso, y evaluar el retorno de la inversión combinando esos datos con los tiempos de entrega.
Lista de comprobación para el equipo
- [ ] ¿Se ha desglosado el tiempo completo de un requisito, desde que se plantea hasta que llega a producción?
- [ ] ¿Se ha calculado la proporción
xque ocupa la codificación en el tiempo total de entrega? - [ ] ¿Se han medido por separado el tiempo de espera para la revisión y la carga de los miembros clave del equipo?
- [ ] ¿Se diseñan los casos de prueba, la instrumentación y las alertas antes o durante la codificación?
- [ ] ¿Se utilizan demos funcionales para confirmar los requisitos, en lugar de depender solo de documentos?
- [ ] ¿Por cuántos traspasos entre roles pasa un requisito desde que se plantea hasta que llega a producción?
- [ ] ¿Se alinean los conceptos clave y los criterios de medición de datos antes de codificar (diccionario de conceptos/SDD)?
- [ ] ¿Las métricas comunicadas distinguen entre «producción de código» y «valor entregable»?
- [ ] ¿Se ha comparado el antes y el después en proyectos pequeños, en lugar de mirar solo los informes de tasa de generación de código?
- [ ] ¿Se ha elegido un único cuello de botella principal para abordarlo primero, en lugar de implementar todas las herramientas a la vez?
Referencias
- Materiales del sector sobre la tasa de generación de código y la entrega de extremo a extremo: fuente de la estimación del 7%, los cinco cuellos de botella y el alcance de las cifras de este artículo
- Nota: el material está truncado. Este artículo se basa únicamente en la parte visible y no toma como referencia el contenido que no se muestra
- Centro de documentación de APIYI: información sobre la integración de herramientas de programación y las estadísticas de uso
- Enlace:
docs.apiyi.com - Nota: consulta la consola y la documentación para conocer los precios y la disponibilidad de los modelos
Autor: equipo técnico de APIYI
Contacto técnico: visita la página principal de APIYI apiyi.com para contactar con nosotros. Encontrarás más información sobre integraciones en el centro de documentación docs.apiyi.com


