
Anmerkung des Autors: Ein Überblick über Gemini 4 Carbon, Claude Fable 5.2 und Apples FastFrames vom November 2026 – damit du klar unterscheiden kannst, was heute per API aufrufbar ist und was nur Paper und Forschung sein Gewichte sind.
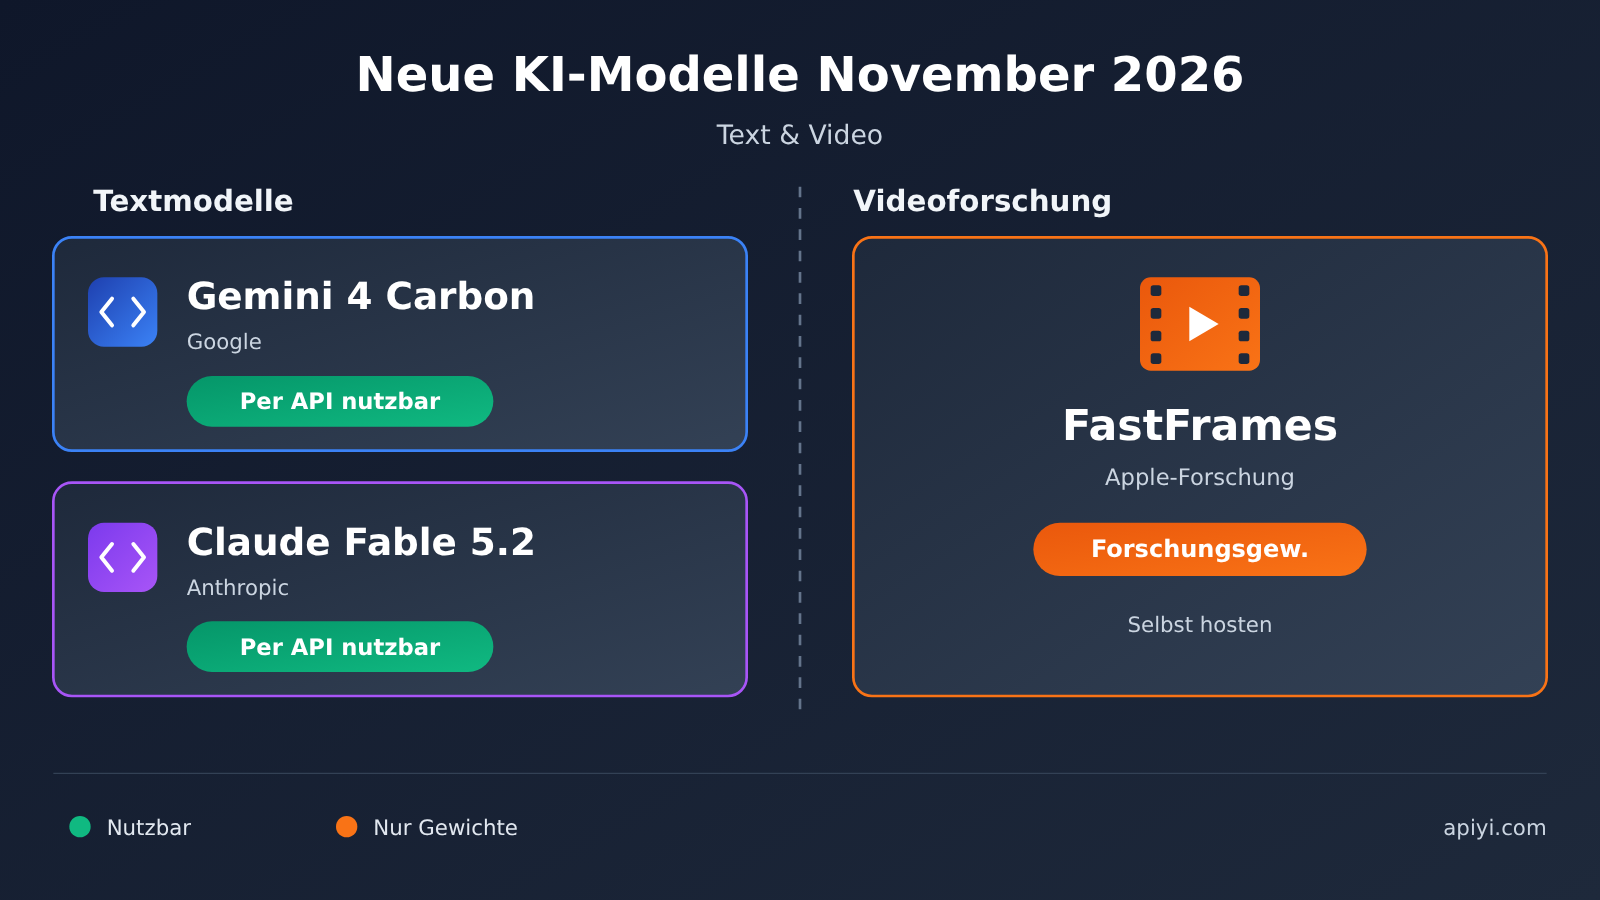
Die neuen KI-Modelle vom November 2026 kamen innerhalb von zwei Wochen auf den Markt: Google öffnete Gemini 4 Carbon am 10. November für zahlende Entwickler, Anthropic veröffentlichte am 9. November Claude Fable 5.2, und Apple brachte am 17. November das Paper und die Gewichte zur Videoforschung FastFrames heraus. Es sind viele Namen – doch für alle, die sofort loslegen wollen, lautet die eigentlich entscheidende Frage: Was lässt sich heute per API aufrufen, und was ist nur Paper und Gewichte?.
Dies ist keine umfassende Rangliste nach dem Motto „Wer ist Erster“. Der Artikel fasst ausschließlich Informationen zusammen, die sich aus offiziellen Originaltexten, den Eigenangaben der Paper und den Modellseiten der Plattformen zusammenbringen lassen. Es werden keine Testergebnisse gezogen, und die von den Anbietern als „höchste“ bezeichnete Fähigkeit wird nicht als bereits gemessene Zahl behandelt.
Der Kernnutzen: Nach dem Lesen dieses Artikels hast du eine Vergleichstabelle in der Hand. Bei Textaufgaben kannst du je nach Bedarf zwischen Gemini 4 Carbon und Claude Fable 5.2 wechseln. Beim Thema Video musst du zuerst klären, dass FastFrames Forschungsgewichte sind und keine aufrufbare Schnittstelle.
Wichtige Informationen zu neuen KI-Modellen im November 2026 auf einen Blick
Die folgende Tabelle beantwortet zunächst die wichtigsten Fragen: Welchen Typ hat jedes Modell, wer hat es veröffentlicht und lässt es sich heute bereits über die API aufrufen? Alle Datumsangaben richten sich nach den offiziellen Ankündigungen bzw. dem Datum der jeweiligen Paper-Version.
| Modell | Anbieter | Typ | Wichtiges Datum | Heute per API aufrufbar? |
|---|---|---|---|---|
| Gemini 4 Carbon | Großes Sprachmodell (Text) | 28. Oktober zunächst für Cybersicherheits-Verteidiger (Fairwind); ab 10. November für zahlende Entwickler und Unternehmen | Ja, Modell-ID gemini-4-carbon |
|
| Claude Fable 5.2 | Anthropic | Großes Sprachmodell (Text) | Veröffentlicht am 9. November | Ja, Modell-ID claude-fable-5-2 |
| FastFrames | Apple Research | Forschung zur Videogenerierung | Paper v1 vom 17. November | Kein API-Endpunkt; Paper und offene Gewichte |
Beide Textmodelle stehen bereits in der Modellliste der APIYI-Plattform und lassen sich direkt im OpenAI-kompatiblen Format aufrufen. Maßgeblich für Modellbezeichnungen und Preise ist die Modellliste auf APIYI apiyi.com; die Preisangaben in diesem Artikel wurden am 19.11.2026 geprüft.
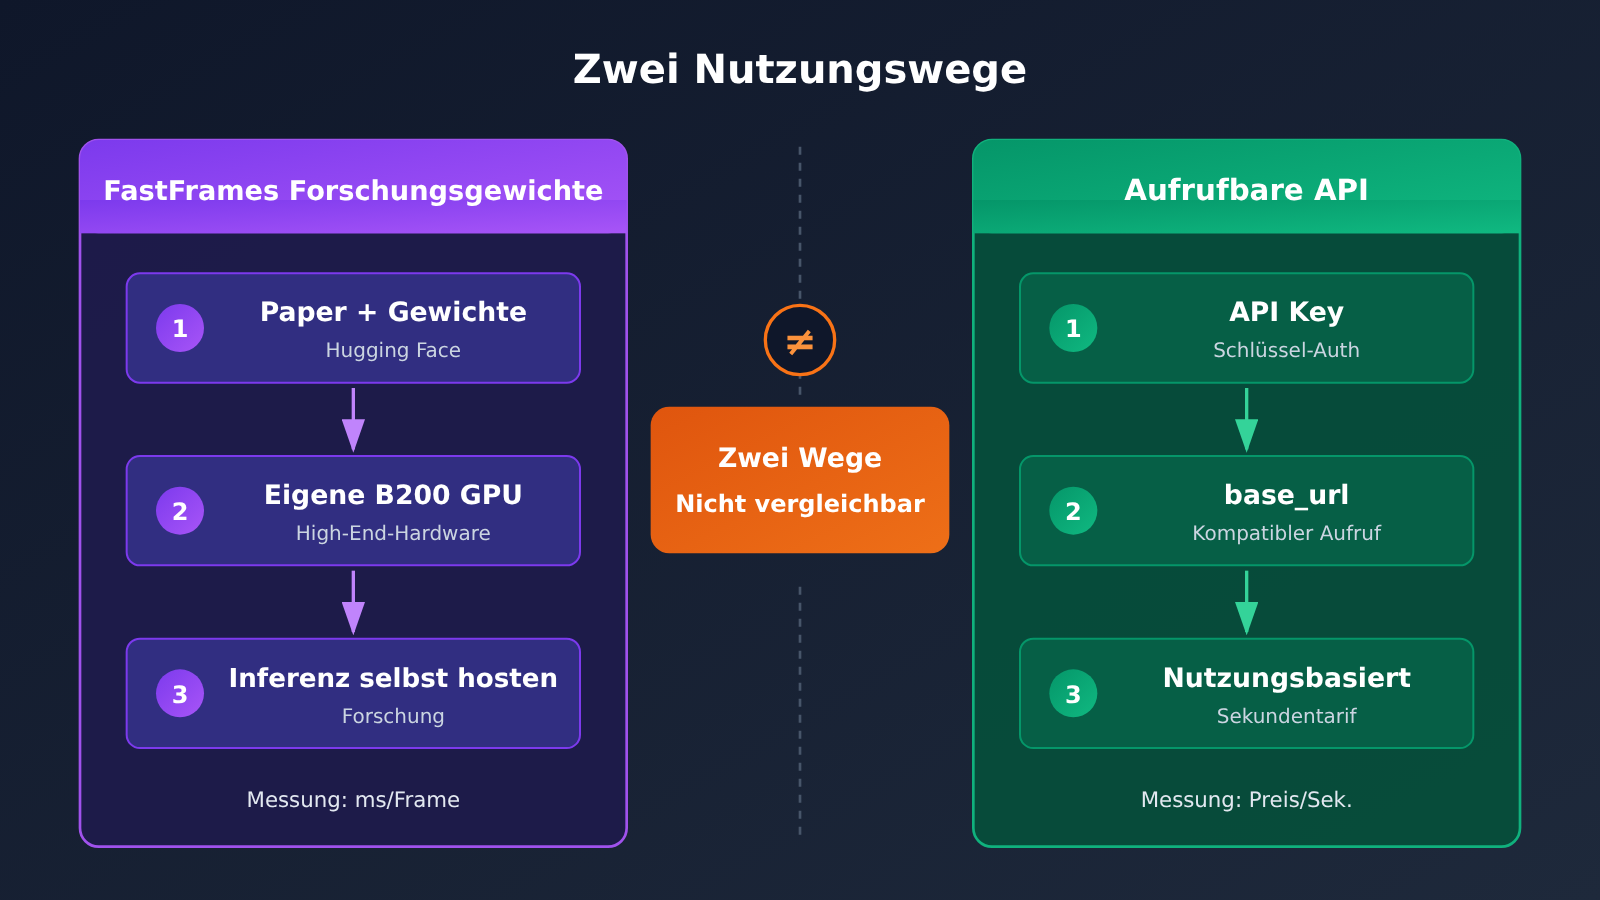
Bei FastFrames liegt der Fall völlig anders. Es handelt sich um ein Paper plus eine Sammlung von Gewichtsdateien auf Hugging Face. Wer es nutzen möchte, muss selbst eine GPU für die Inferenz bereitstellen; es gibt keinen Preis pro Aufruf. Darauf wird weiter unten gesondert eingegangen.
Neue Textmodelle im November 2026: Gemini 4 Carbon im Überblick
Der Rollout von Gemini 4 Carbon folgt einem etwas ungewöhnlichen Rhythmus. Google hat das Modell zunächst am 28. Oktober für Verteidiger im Bereich Cybersicherheit freigegeben und es dann am 10. November für zahlende Entwickler und Unternehmen geöffnet. Der offizielle Einführungspreis ist derselbe wie bei Gemini 4 Argon: 2 US-Dollar für Input und 10 US-Dollar für Output pro Million Tokens.
Offizielle Angaben zu Gemini 4 Carbon im Vergleich zur Modellseite der Plattform
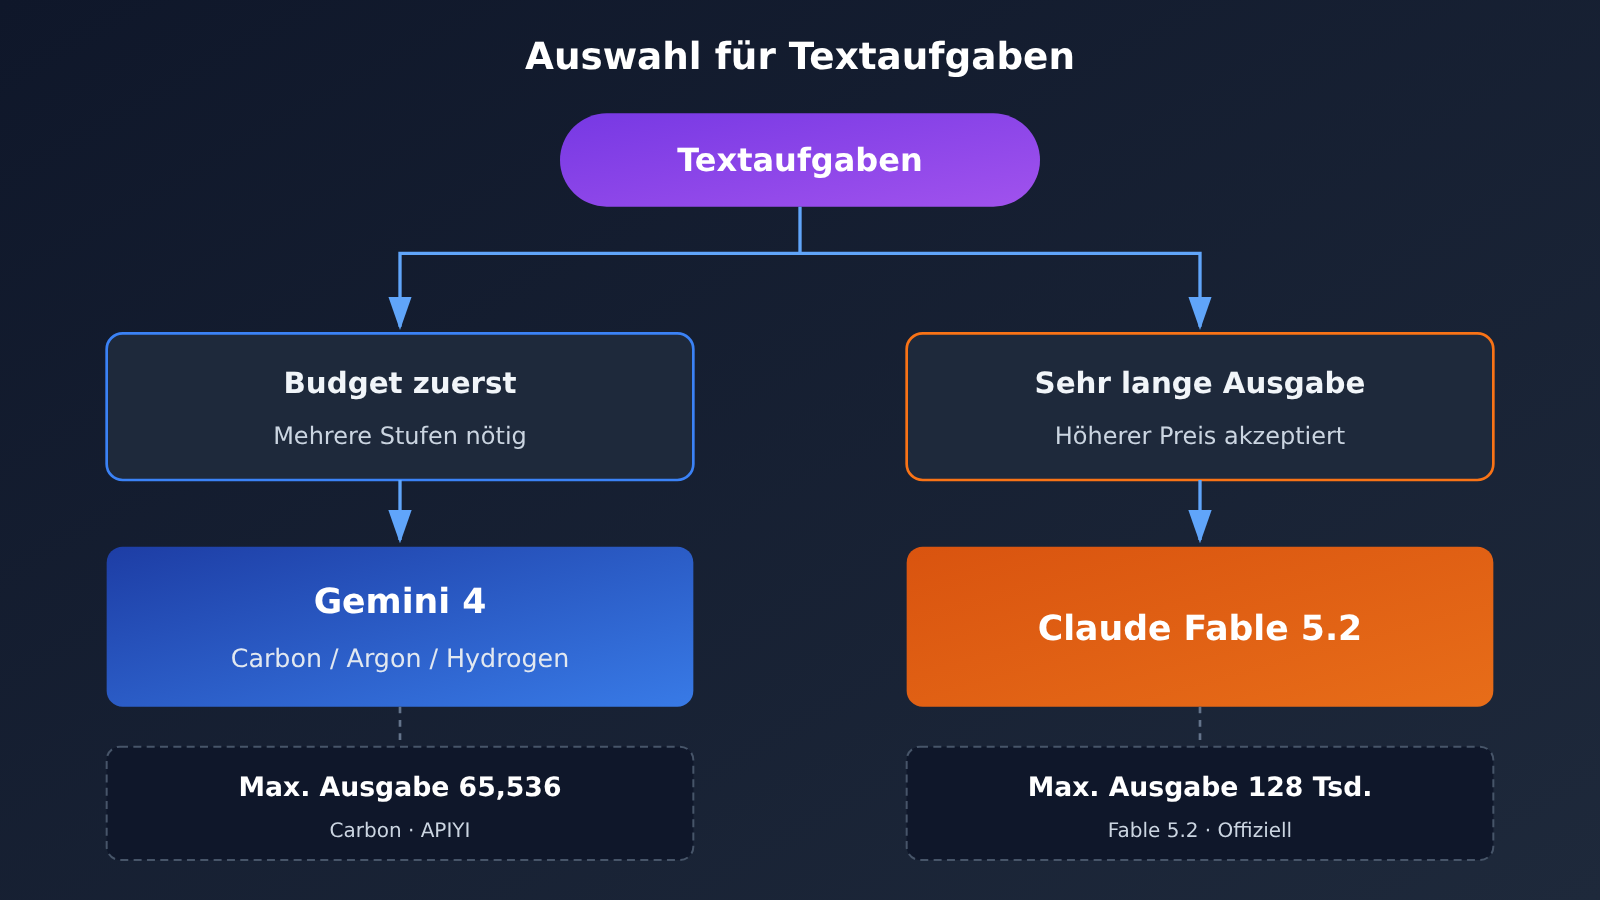
Für die maximale Ausgabe gibt es bei Carbon zwei unterschiedliche Angaben, die man getrennt betrachten muss. Auf der Erklärungsseite von Google AI Studio steht, dass eine einzelne Antwort mehr als 64K umfassen kann, und zwar bis zu 1 Million minus der Input-Länge. Die Modellseite von APIYI gibt die maximale Ausgabe dagegen mit 65,536 Tokens an.
| Parameter | Offizieller Text (Google) | Modellseite von APIYI |
|---|---|---|
| Modell-ID | Gemini 4 Carbon | gemini-4-carbon |
| Veröffentlichungsdatum | 10. November, Freigabe für zahlende Entwickler | 2026-11-11 |
| Kontextlänge | rund 1 Million | 1,048,576 Tokens |
| Maximale Ausgabe | über 64K möglich, bis 1 Million minus Input | 65,536 Tokens |
| Input-Preis | 2 US-Dollar / Mio. Tokens | 2 US-Dollar / Mio. Tokens |
| Cache-Lesen | — | 0,1 US-Dollar / Mio. Tokens |
| Output-Preis | 10 US-Dollar / Mio. Tokens | 10 US-Dollar / Mio. Tokens |
| Unterstützte Endpunkte | — | chat und gemini |
Für die praktische Nutzung ist die Schlussfolgerung ganz einfach: Wenn Sie gemini-4-carbon über APIYI aufrufen, planen Sie die Obergrenze für eine einzelne Ausgabe nach den 65,536 Tokens auf der Modellseite. Die offizielle Angabe zu sehr langen Ausgaben ist eine andere Größe und gehört zur Beschreibung in der nativen Google-Umgebung – die beiden Zahlen sollte man nicht vermischen. Auf der Modellseite steht außerdem ein Satz aus der Originaldokumentation: „Langtext mit 199.000 Tokens bestanden“ – das ist ein Eintrag aus der Dokumentation und keine Testerkenntnis aus diesem Artikel.
Gleicher Stückpreis bei Gemini 4 Carbon bedeutet nicht gleiche Kosten pro Aufgabe
Viele sehen, dass Carbon und Argon denselben Stückpreis haben, und gehen davon aus, dass beide sich auch im Einsatz gleich teuer anfühlen. Hier gibt es ein Detail, das leicht übersehen wird. Google schreibt im Original ausdrücklich, dass Carbon mehr Tokens für die Verifikation aufwendet als Argon. Das heißt: Stellt man Carbon dieselbe Frage, können die für Output oder Nachdenken verbrauchten Tokens höher ausfallen.
Ein gleicher Stückpreis sagt also nur, dass die Abrechnung pro Million Tokens identisch ist – nicht, dass die Rechnung für eine einzelne Aufgabe gleich aussieht. Google nennt keinen konkreten Faktor, um den mehr verbraucht wird, und dieser Artikel schätzt auch keinen solchen Faktor. Wenn Sie kostensensibel sind, ist der solidere Weg, Ihre eigenen realen Aufgaben jeweils mehrfach laufen zu lassen und den Token-Verbrauch in der Abrechnung zu vergleichen.
In derselben Serie gibt es außerdem eine günstigere Option: gemini-4-hydrogen. Sie ist in der Übersichtstabelle von APIYI mit 1,5 US-Dollar für Input, 0,075 US-Dollar für Cache-Lesen und 7,5 US-Dollar für Output pro Million Tokens gelistet und eignet sich für Szenarien, in denen die Verifikationstiefe nicht so wichtig ist und hohe Aufrufvolumina anfallen.
Neues Textmodell im November 2026: Claude Fable 5.2 im Überblick
Claude Fable 5.2 wurde von Anthropic am 9. November veröffentlicht. Die offizielle Dokumentation nennt die Modell-ID claude-fable-5-2. Laut offiziellen Angaben hat das Modell ein Kontextfenster von 1 Mio. Tokens und eine maximale Ausgabe von 128.000 Tokens. Der Preis liegt bei 8 USD für die Eingabe und 40 USD für die Ausgabe pro 1 Mio. Tokens.
Claude Fable 5.2 im Preisvergleich mit der Vorgängergeneration
In der APIYI-Gesamtübersicht sind sowohl claude-fable-5-2 als auch claude-fable-5-2-thinking aufgeführt, beide zum selben Preis. Die offizielle Dokumentation gibt an, dass Cache-Reads bei Fable 5.2 2,5 % des Eingabepreises kosten. 2,5 % von 8 USD sind genau 0,2 USD – das deckt sich mit der Plattformübersicht.
| Modell-ID | Eingabe (USD/Mio. Tokens) | Cache-Read (USD/Mio. Tokens) | Ausgabe (USD/Mio. Tokens) |
|---|---|---|---|
claude-fable-5-2 |
8 | 0,2 | 40 |
claude-fable-5-2-thinking |
8 | 0,2 | 40 |
claude-fable-5-1 (Vorgängergeneration) |
10 | 0,25 | 50 |
Der Tabelle lässt sich entnehmen, dass alle drei Preise von Fable 5.2 unter denen von Fable 5.1 liegen. Wenn Ihr Projekt derzeit auf 5.1 läuft, sinkt beim Umstieg auf 5.2 zumindest der Stückpreis direkt. Etwaige Unterschiede bei der Ergebnisqualität sollten Sie jedoch mit eigenen Aufgaben prüfen.
Hinweis: In der APIYI-Gesamtübersicht gibt es keine eigene Detailseite für Fable 5.2. Die Angaben zum Kontextfenster und zur maximalen Ausgabe stammen daher aus der offiziellen Anthropic-Dokumentation. Wenn Sie bei einem Aufruf eine besonders lange Ausgabe benötigen, orientieren Sie sich an den offiziellen Angaben und setzen Sie max_tokens in der Anfrage ausdrücklich.
Preis- und Aufrufvergleich neuer KI-Modelle im November 2026
Legt man die beiden neuen Textmodelle und ihre benachbarten Varianten nebeneinander, werden die Preisunterschiede deutlicher. Die folgenden Stückpreise sind in US-Dollar pro Million Tokens angegeben und stammen aus der Modellübersicht von APIYI vom selben Tag.
| Modell-ID | Eingabe | Cache-Lesezugriff | Ausgabe | Verfügbare Plattformen |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0,1 | 10 | APIYI apiyi.com, Google (offiziell) |
gemini-4-argon |
2 | 0,1 | 10 | APIYI, Google (offiziell) |
gemini-4-hydrogen |
1,5 | 0,075 | 7,5 | APIYI, Google (offiziell) |
claude-fable-5-2 |
8 | 0,2 | 40 | APIYI, Anthropic (offiziell) |
claude-fable-5-1 |
10 | 0,25 | 50 | APIYI, Anthropic (offiziell) |
Ein hypothetisches Szenario macht die Rechnung greifbar: Eine Aufgabe benötigt 100.000 Eingabe-Tokens und 10.000 Ausgabe-Tokens. Nach den Stückpreisen kostet Carbon etwa 0,2 + 0,1 = 0,3 US-Dollar, Fable 5.2 etwa 0,8 + 0,4 = 1,2 US-Dollar. Das ist lediglich eine rechnerische Veranschaulichung anhand der Stückpreise; bei Carbon können die tatsächlichen Kosten höher ausfallen, weil es möglicherweise mehr Tokens für die Verifikation verbraucht. Maßgeblich ist die tatsächliche Abrechnung.
Beim Aufruf lassen sich beide Modelle über die OpenAI-kompatible Schnittstelle von APIYI ansprechen. Als base_url wird durchgängig https://api.apiyi.com/v1 eingetragen; um das Modell zu wechseln, muss nur das Feld model geändert werden. Ein einziger API-Schlüssel reicht aus, um sowohl gemini-4-carbon als auch claude-fable-5-2 aufzurufen. So lassen sich A/B-Vergleiche innerhalb derselben Codebasis durchführen.
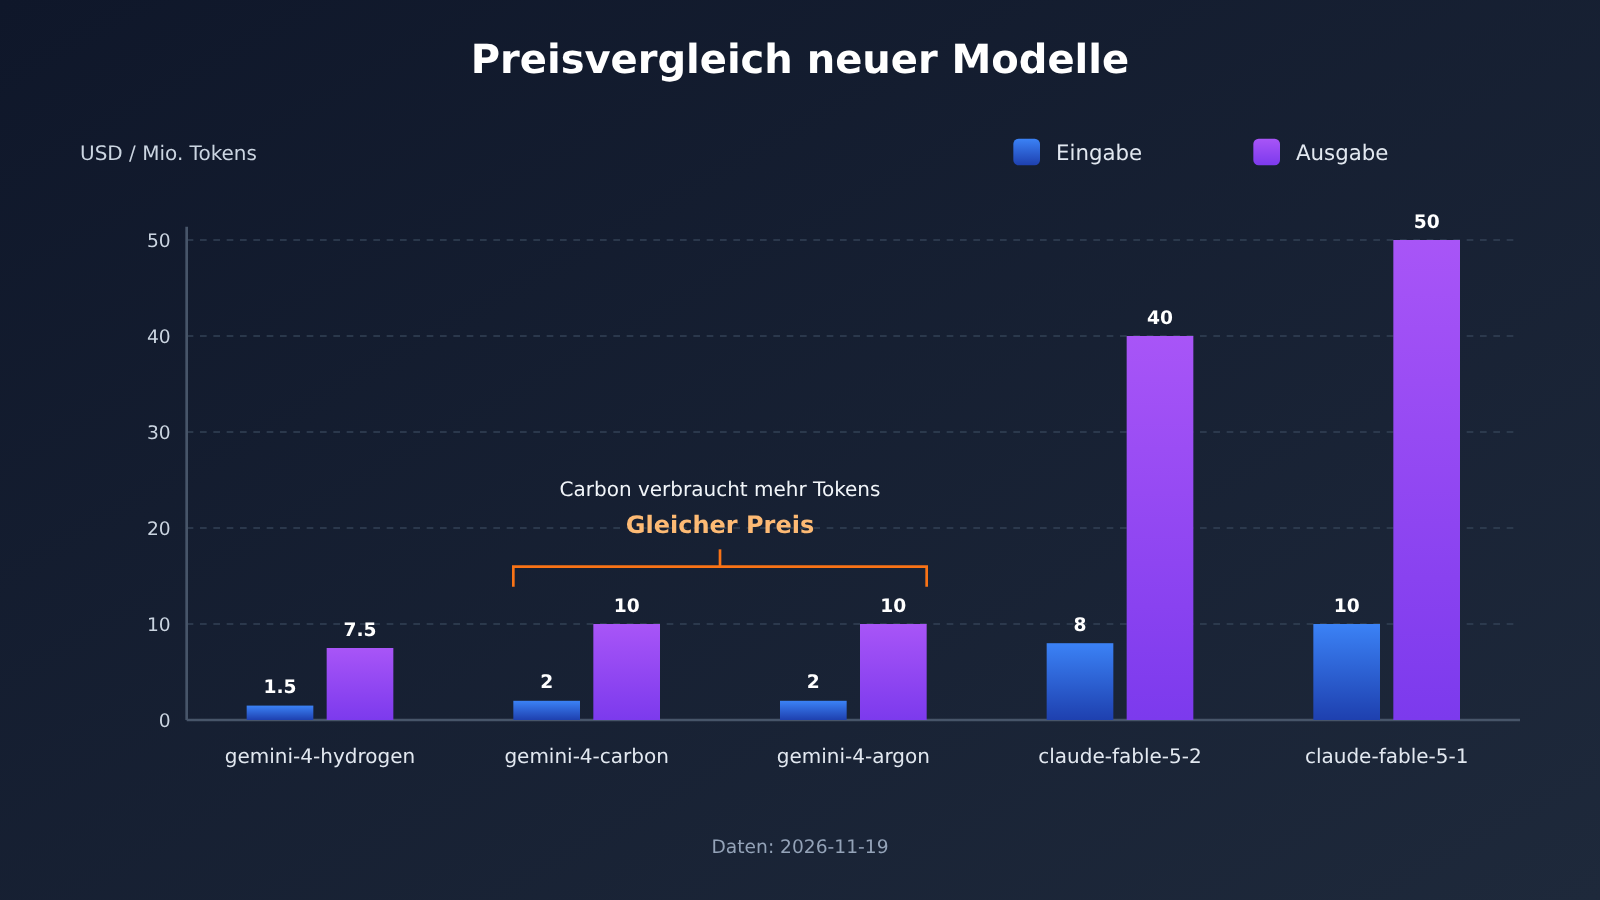
Hinweis zur Grafik: Die Stückpreise in der Grafik stammen aus der Modellübersicht von APIYI apiyi.com vom 2026-11-19. Dass die Säulen von Carbon und Argon gleich hoch sind, bedeutet nur, dass die Stückpreise übereinstimmen; die Kosten pro Aufgabe müssen anhand des tatsächlichen Tokenverbrauchs beurteilt werden.
Gemini 4 Carbon und Claude Fable 5.2 schnell per API aufrufen
So rufen Sie die beiden Modelle am einfachsten auf: Ändern Sie nur das Feld model, um zwischen den beiden neuen Modellen zu wechseln:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # Auf "claude-fable-5-2" ändern, um zu wechseln
    messages=[{"role": "user", "content": "用三句话解释零信任架构"}]
)
print(response.choices[0].message.content)
Vollständigen Code für den Vergleichsaufruf anzeigen
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Bei APIYI wird die maximale Ausgabe für Carbon gemäß Modellseite mit 65,536 geplant
MAX_OUTPUT = {
    "gemini-4-carbon": 65536,
    "claude-fable-5-2": 8192,  # Nach Bedarf anpassen; offizielle maximale Ausgabe: 128.000
}

def ask(model: str, prompt: str, system: Optional[str] = None) -> dict:
    messages = []
    if system:
        messages.append({"role": "system", "content": system})
    messages.append({"role": "user", "content": prompt})

    resp = client.chat.completions.create(
        model=model,
        messages=messages,
        max_tokens=min(MAX_OUTPUT.get(model, 4096), 8192),
    )
    return {
        "model": model,
        "text": resp.choices[0].message.content,
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
    }

if __name__ == "__main__":
    task = "审查下面这段代码的安全隐患,并给出修复建议:..."
    for m in ["gemini-4-carbon", "claude-fable-5-2"]:
        r = ask(m, task, system="你是资深安全工程师")
        print(m, r["prompt_tokens"], r["completion_tokens"])
        print(r["text"][:300], "\n---")
Der vollständige Code gibt bei jedem Aufruf die Eingabe- und Ausgabe-Tokens aus. Das eignet sich genau, um die zuvor erwähnte Aussage „gleicher Stückpreis, unterschiedliche Kosten pro Aufruf“ zu überprüfen. Lassen Sie dieselbe Aufgabe einige Male auf beiden Modellen laufen und vergleichen Sie die completion_tokens – das ist verlässlicher, als nur die Preisliste anzusehen.
🚀 Tipp für den schnellen Einstieg: Wenn Sie die beiden neuen Modelle mit Ihren eigenen Aufgaben vergleichen möchten, registrieren Sie sich zuerst bei APIYI apiyi.com, um ein kostenloses Testkontingent zu erhalten. Lassen Sie den obigen Code jeweils einmal laufen und entscheiden Sie dann anhand des Token-Verbrauchs und der Ausgabequalität, welches Modell Ihr Hauptmodell wird.
Neues Video-Modell im November 2026: FastFrames sind Forschungsgewichte
FastFrames stammt vom Forschungsteam von Apple. Die arXiv-Nummer lautet arXiv:2611.23226, die Version v1 ist vom 2026-11-17. Das Projekt bietet außerdem eine Projektseite auf GitHub Pages und hat auf Hugging Face zwei Gewichtssätze veröffentlicht: FastFrames-S und FastFrames-L.
Selbst berichtete Daten aus dem FastFrames-Paper
Die folgenden Zahlen stammen ausschließlich aus dem Paper selbst. Sie sind kein finales Ranking unabhängiger Tests und schon gar kein Preis pro Aufruf einer API.
| Version | Parameteranzahl | Im Paper angegebene Hardware | Im Paper angegebene Geschwindigkeit | Auflösung |
|---|---|---|---|---|
| FastFrames-S | 1,3 Milliarden | eine B200 | ca. 36 Millisekunden pro Frame | 480p |
| FastFrames-L | 14 Milliarden | 8 B200 | ca. 45 Millisekunden pro Frame | 480p |
Aus dieser Tabelle wird die Positionierung von FastFrames deutlich: Es zeigt eine Forschungsmethode, mit der sich Videos auf High-End-GPUs Frame für Frame schnell erzeugen lassen. Um diese Geschwindigkeiten zu reproduzieren, müssen Sie selbst Hardware in der Klasse einer B200 bereitstellen und das Modell deployen – das ist etwas völlig anderes, als „einen API-Schlüssel einzutragen und loszulegen“.
FastFrames ist außerdem nur eine Forschung im Video-Bereich, kein universelles Modell, das Text und Video gleichzeitig verarbeitet. Wenn Sie heute in Ihrem Produkt Videos erzeugen möchten, sollten Sie in der Modellübersicht von APIYI die Video-Modelle ansehen, die bereits pro Sekunde bepreist sind. Vergleichen Sie nicht die Frame-Geschwindigkeit von Forschungsgewichten mit dem Preis einer sekundenbasierten API.
Auswirkungsanalyse der neuen KI-Modelle im November 2026
Auswirkungen auf Entwickler
- Mehr Auswahl bei Textmodellen, geringere Wechselkosten: Carbon und Fable 5.2 unterstützen beide OpenAI-kompatible Modellaufrufe. Mit demselben Code lässt sich durch Ändern einer einzigen Modell-ID vergleichen – ideal, um Aufgaben je nach Typ aufzuteilen, statt auf ein einzelnes Modell zu setzen.
- Bei der Kostenbewertung zählt der Token-Verbrauch, nicht nur der Stückpreis: Carbon und Argon haben denselben Stückpreis, aber laut offizieller Beschreibung verbraucht Carbon mehr Tokens für die Verifizierung. Das Budget sollte man daher an der tatsächlichen Abrechnung ausrichten.
- Das Ausgabelimit muss je nach Aufrufkanal geprüft werden: Carbons offizielle Langausgabe und die 65.536 auf der Produktseite der Plattform sind zwei verschiedene Angaben. Im Code sollte man
max_tokensentsprechend dem tatsächlich genutzten Kanal setzen. - Bei Video muss man zuerst zwischen Forschung und API unterscheiden: FastFrames eignet sich für Teams mit GPU-Ressourcen, die Echtzeit-Videogenerierung erforschen wollen – nicht dafür, direkt als Video-API in einem Live-Produkt eingesetzt zu werden.
Auswirkungen auf die Branche
- Sicherheitsszenarien zuerst freizugeben wird zu einer eigenen Art der Veröffentlichung: Carbon geht zuerst an Verteidiger in der Netzwerksicherheit und erst danach an zahlende Entwickler. Das zeigt, dass Hersteller neue Modelle inzwischen szenarioabhängig und in Phasen freigeben.
- Die Stückpreise von High-End-Modellen sinken: Alle drei Stückpreise von Fable 5.2 liegen unter denen von Fable 5.1. Der Trend zu niedrigeren Preisen bei der Iteration von Modellen derselben Klasse hält also an.
- Videogenerierung strebt Echtzeit an: Das FastFrames-Paper setzt das Ziel auf Millisekunden-Geschwindigkeit bei der Generierung einzelner Frames. Der Forschungsschwerpunkt verschiebt sich damit von „generieren zu können“ hin zu „schnell zu generieren“.
Häufig gestellte Fragen (FAQ)
F1: Welche neuen KI-Modelle kann man im November 2026 direkt per API aufrufen?
Im Textbereich sind Gemini 4 Carbon (`gemini-4-carbon`) und Claude Fable 5.2 (`claude-fable-5-2`, `claude-fable-5-2-thinking`) direkt aufrufbar. Im Videobereich ist FastFrames ein Paper samt Forschungsgewichten und keine aufrufbare Schnittstelle.
F2: Gemini 4 Carbon und Gemini 4 Argon kosten gleich viel – welches sollte ich wählen?
Beide kosten pro Million Tokens 2 US-Dollar für Input, 0,1 US-Dollar für Cache-Lesen und 10 US-Dollar für Output. Google weist im Originaltext jedoch darauf hin, dass Carbon mehr Tokens für die Verifikation verbraucht als Argon, sodass eine einzelne Aufgabe teurer werden kann. Am besten lässt man beide mit echten Aufgaben einige Male laufen und vergleicht Token-Verbrauch und Ergebnisqualität, bevor man entscheidet.
F3: Wie hoch ist die maximale Ausgabe von Gemini 4 Carbon wirklich?
Das hängt vom Kanal ab. Beim Aufruf über APIYI sollte man mit den 65.536 Tokens planen, die auf der Modellseite angegeben sind. Laut offizieller Dokumentation in Google AI Studio kann eine einzelne Antwort über 64K hinausgehen und bis zu 1 Million minus Input erreichen – das ist eine andere Angabe aus der nativen Google-Umgebung.
F4: Kann man FastFrames für die Videogenerierung in einem Produkt einsetzen?
FastFrames ist ein Forschungsergebnis von Apple mit Paper und Hugging-Face-Gewichten; die im Paper angegebene Geschwindigkeit setzt eine GPU der B200-Klasse voraus. Wer Videos direkt über eine Schnittstelle generieren will, sollte in der Modellübersicht von APIYI ein Videomodell mit Preis pro Sekunde auswählen und nicht Forschunggewichte für einen Preisvergleich heranziehen.
F5: Wie ruft man Gemini 4 Carbon und Claude Fable 5.2 schnell auf?
Empfohlen wird ein einheitlicher Test über eine API-Aggregationsplattform:
1. Bei APIYI unter apiyi.com ein Konto registrieren
2. API-Schlüssel und das kostenlose Testkontingent für neue Nutzer abrufen
3. Den Code aus diesem Artikel verwenden, `base_url` mit `https://api.apiyi.com/v1` belegen und bei `model` jeweils `gemini-4-carbon` bzw. `claude-fable-5-2` eintragen
Mit einem einzigen Schlüssel lassen sich beide Modelle gleichzeitig aufrufen, was den Vergleich und Wechsel erleichtert.
F6: Welche Einschränkungen sollte man bei diesen neuen Modellen beachten?
Carbon kostet pro Einheit gleich viel wie Argon, verbraucht aber möglicherweise mehr Tokens – die Kosten muss man praktisch verifizieren. Fable 5.2 kostet viermal so viel wie Carbon, was bei langen Ausgaben deutlich zu Buche schlägt. Die Geschwindigkeitsangaben zu FastFrames stammen alle aus dem Paper und setzen eine eigene High-End-GPU voraus; sie sind nicht mit der Leistung einer Schnittstelle gleichzusetzen.
Wichtige Kernpunkte der neuen KI-Modelle im November 2026
- Zwei Modelle für Textaufrufe verfügbar:
gemini-4-carbonundclaude-fable-5-2lassen sich beide über eine OpenAI-kompatible Schnittstelle aufrufen. - Carbon kostet pro Einheit dasselbe wie Argon: jeweils 2 USD für die Eingabe und 10 USD für die Ausgabe pro Million Tokens. Laut offiziellen Angaben verbraucht Carbon jedoch mehr Tokens.
- Bei Carbon gibt es zwei Angaben zur Ausgabelänge: Auf der Plattform sind 65,536 Tokens vorgesehen; die offizielle Angabe für lange Ausgaben nennt eine andere Zahl.
- Fable 5.2 ist günstiger als 5.1: Eingabe 8, Cache-Read 0.2, Ausgabe 40 – alle drei Einheitspreise liegen unter denen der vorherigen Generation.
- FastFrames sind Forschungsgewichte: ein Apple-Paper plus Gewichte auf Hugging Face. Die Geschwindigkeit stammt aus der Selbsteinschätzung des Papers und ist kein API-Preis.
- So starten Sie: Bei APIYI mit demselben Key einfach die Modell-ID ändern und die beiden neuen Textmodelle vergleichen.
Zusammenfassung
Die Kernpunkte der neuen KI-Modelle im November 2026:
- Im Textbereich gibt es zwei neue Optionen: Gemini 4 Carbon ist pro Einheit günstig und bietet mehrere Stufen innerhalb derselben Serie. Claude Fable 5.2 hat eine höhere offizielle Ausgabegrenze und niedrigere Einheitspreise als die vorherige Generation.
- Kosten nach tatsächlichem Verbrauch bewerten: Gleicher Einheitspreis bedeutet nicht gleicher Preis pro Aufruf. Zusätzliche Prüfungen bei Carbon schlagen sich im Token-Verbrauch nieder.
- Im Videobereich zuerst die Art des Angebots klären: FastFrames sind Forschungsgewichte und eignen sich für Forschungsteams mit GPU-Ressourcen. Für die Produktintegration sollten Sie ein Videomodell mit Abrechnung pro Sekunde wählen.
Für Entwickler, die sofort loslegen wollen, ist die praktischste Vorgehensweise die Aufteilung nach Aufgaben: Geben Sie dieselben realen Aufgaben einmal an Carbon und einmal an Fable 5.2 und entscheiden Sie anhand von Abrechnung und Ausgabequalität – nicht anhand eines wie auch immer gearteten Gesamtrankings. Empfohlen wird, diesen Vergleich schnell über APIYI apiyi.com mit einem Key durchzuführen. Maßgeblich für Modelle und Preise ist die Modellliste der Plattform.
📚 Referenzen
-
Google offizieller Blog – Ankündigung zu Gemini 4 Carbon: Verfügbarkeitstermin und offizieller Einführungspreis
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/ - Hinweis: Enthält die offiziellen Angaben zum gleichen Preis wie bei Argon sowie zur Bestätigung des höheren Tokenverbrauchs
- Link:
-
Google AI Studio – Update-Hinweise zu Gemini 4 Carbon: Offizielle Aussage zur langen Ausgabe
- Link:
aistudio.google.com/docs/whats-new-gemini-4-carbon - Hinweis: Die offizielle Quelle dafür, dass eine einzelne Antwort 64K überschreiten kann
- Link:
-
Anthropic offizielle Dokumentation – Claude Fable 5.2 im Überblick: Modell-ID, Kontext und Preis
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Hinweis: Quelle für maximal 128.000 Ausgabe-Tokens und 2,5 % beim Cache-Lesen
- Link:
-
Apple Research – FastFrames-Projektseite: Paper und Forschungsbeschreibung
- Link:
apple-aiml-research.github.io/ml-fastframes/ - Hinweis: Paper arXiv:2611.23226, v1 datiert auf den 2026-11-17
- Link:
-
Hugging Face – FastFrames-Gewichte: Die beiden Versionen S und L
- Link:
huggingface.co/apple/FastFrames-S - Hinweis: Einstiegspunkt zum Herunterladen der Forschungsgewichte; die Inferenz muss selbst bereitgestellt werden
- Link:
Autor: APIYI-Team
Technischer Austausch: Sie erreichen uns gerne über die Startseite der APIYI-Website; Details zu den Modellen und Aufrufdokumentation finden Sie im Dokumentationszentrum unter docs.apiyi.com


