
Anmerkung des Autors: Zwei per Hand gerechnete Beispiele verdeutlichen, wie GPT-6.2 Astra bei kurzen und langen Kontexten abgerechnet wird – und welche Multiplikatoren für Batch, Fast und Ultrafast gelten.
OpenAI hat am 17. November 2026 GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht, die Modell-IDs lauten gpt-6.2-astra und gpt-6.2-sol. Die Standardpreise für kurze Kontexte, die die offizielle Modellseite nennt, wirken auf den ersten Blick unkompliziert. Will man aber tatsächlich die Rechnung abschätzen, gilt: Der Standardpreis für kurze Kontexte lässt sich nicht einfach auf lange Kontexte, Fast und Ultrafast übertragen. Sobald die Eingabe einer einzelnen Anfrage 272K Token überschreitet, ändern sich die Einzelpreise für die gesamte Anfrage; wählt man zusätzlich Fast oder Ultrafast, kommt auf der jeweiligen Kontextstufe noch ein weiterer Multiplikator obendrauf.
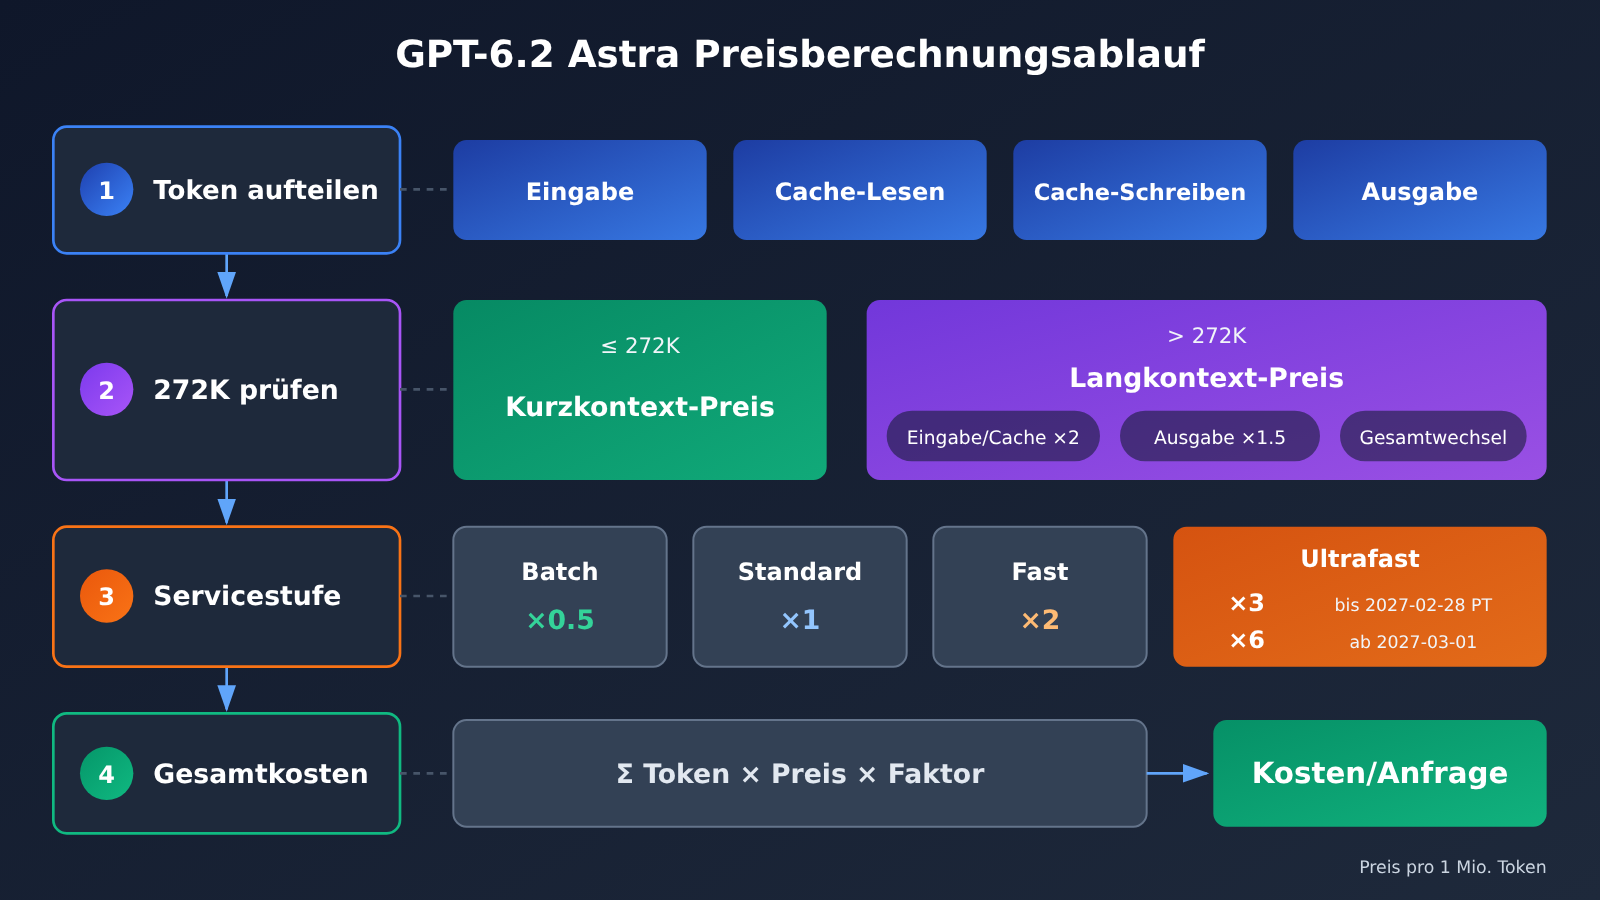
Das hier ist keine bloße Wiedergabe einer Preisliste, sondern ein Regelsatz, den Sie mit Papier und Stift von Hand nachrechnen können: Zuerst zerlegen Sie die Token in vier Kategorien – Eingabe, Cache-Lesen, Cache-Schreiben und Ausgabe; dann bestimmen Sie, ob die Anfrage unter den kurzen oder den langen Kontext fällt; zuletzt wenden Sie den Multiplikator der Dienststufe an.
Der Kernnutzen: Nach der Lektüre dieses Artikels können Sie die Kosten für einzelne GPT-6.2-Astra-Anfragen und für Batch-Aufträge selbstständig abschätzen – und Sie wissen, welche Zahlen offizielle Listenpreise sind und welche auf unabhängigen Dritttests beruhen, ohne beides zu vermischen.
Kernpunkte der Preisgestaltung von GPT-6.2 Astra
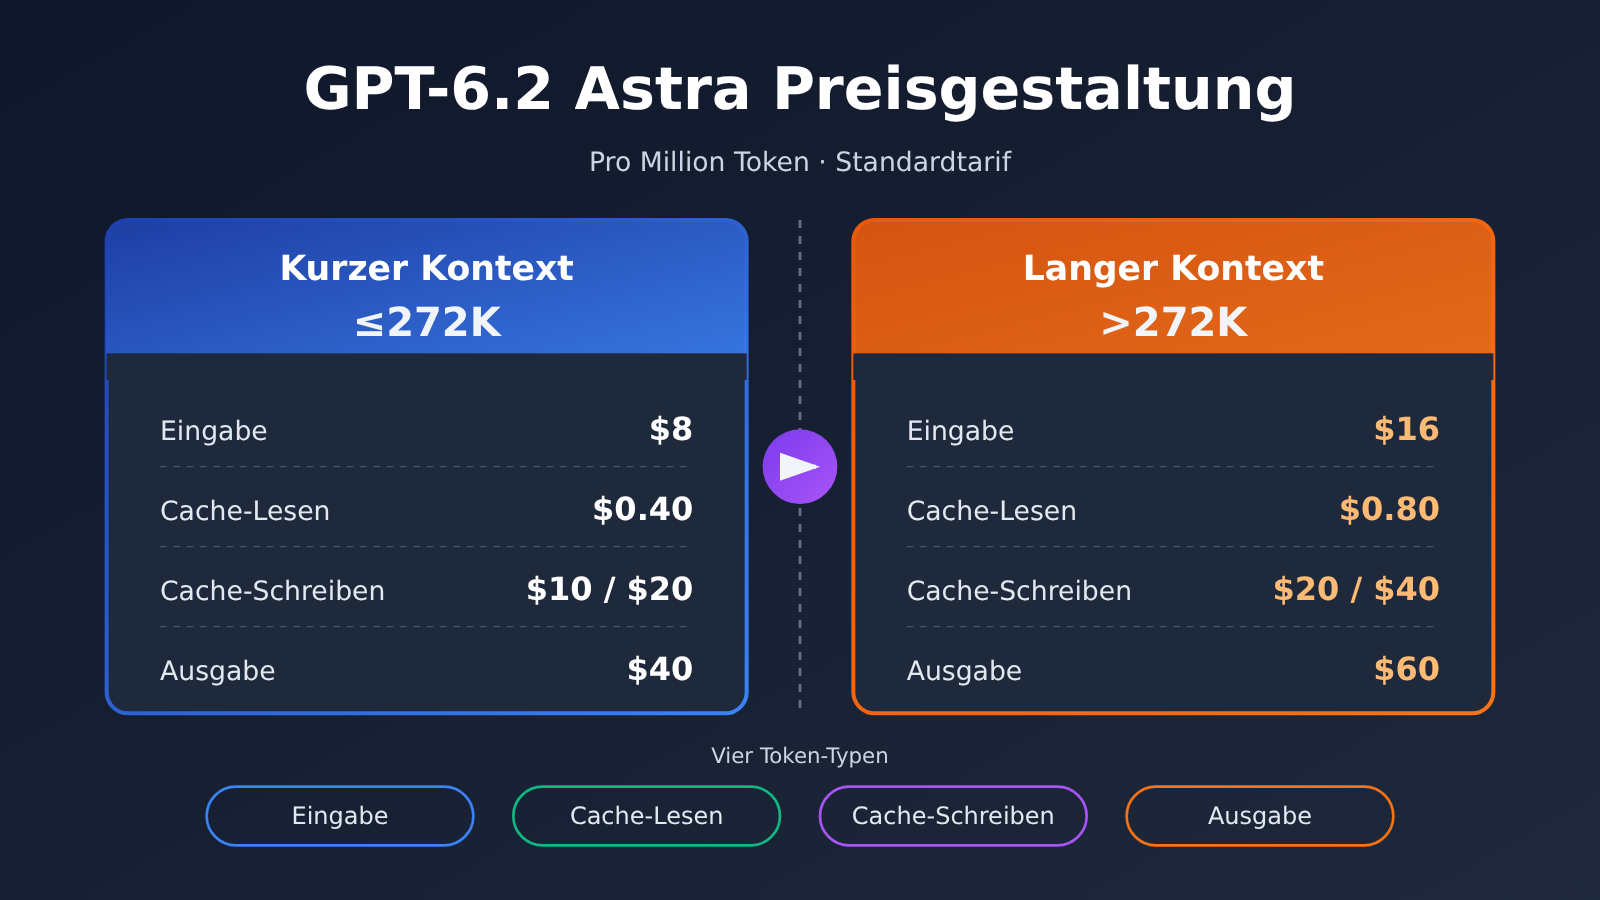
Zuerst einmal die Regeln klar auf den Tisch. Die folgende Tabelle stammt von der offiziellen OpenAI-Modellseite (den dort selbst angegebenen Preisen); alle Beträge gelten pro 1 Million Token zum Standardtarif.
| Abrechnungsposten | Kurzer Kontext (Eingabe ≤272K) | Langer Kontext (Eingabe >272K, gesamte Anfrage) | Erläuterung |
|---|---|---|---|
| Eingabe | $8 | $16 | Eingabe kostet bei langem Kontext das Doppelte |
| Cache-Lesen | $0.40 | $0.80 | Auch der Cache-Preis verdoppelt sich |
| Cache-Schreiben (30 Minuten Aufbewahrung) | $10 | $20 | Zählt zur Cache-Kategorie, ebenfalls verdoppelt |
| Cache-Schreiben (12 Stunden Aufbewahrung) | $20 | $40 | Zählt zur Cache-Kategorie, ebenfalls verdoppelt |
| Ausgabe | $40 | $60 | Ausgabe kostet das 1,5-Fache des kurzen Kontexts |
Die Spalte für langes Kontextfenster lässt sich aus dem Originaltext der Modellseite ableiten: Überschreitet die Eingabe einer Anfrage 272K Token, verdoppeln sich die Einheitspreise für Eingabe und Cache, die Ausgabe wird mit dem 1,5-Fachen des kurzen Kontexts berechnet – und zwar auf die gesamte Anfrage bezogen. Das heißt: Nicht etwa nur der Anteil jenseits von 272K wird teurer, sondern sämtliche Token dieser Anfrage werden zu den Preisen der rechten Spalte abgerechnet.
gpt-6.2-astra und gpt-6.2-sol sind derzeit weder in der Modellübersicht von APIYI (Datenstand: 2026-11-17 15:54, UTC+8) noch in der öffentlichen Preisschnittstelle zu finden: Das Modell ist noch nicht gelistet – wir werden es schnellstmöglich nachtragen. Maßgeblich für Modellbezeichnungen und Preise ist die Modulliste der Plattform. Bevor Sie das Modell offiziell einbinden, prüfen Sie am besten zuerst in der Modulliste auf apiyi.com den Listing-Status und die tatsächlichen Preise und wenden Sie dann die hier beschriebene Rechenlogik an.
Warum die vier Token-Typen von GPT-6.2 Astra getrennt abgerechnet werden
Die Abrechnung einer einzelnen Anfrage besteht in der Regel aus vier Bestandteilen. Die normale Eingabe umfasst den Teil der Eingabeaufforderung, der weder den Cache trifft noch in den Cache geschrieben wurde; Cache-Lesen betrifft den Teil, der bereits im Cache vorhanden ist, und kostet nur ein Zwanzigstel des Eingabepreises; Cache-Schreiben umfasst den Teil der Eingabeaufforderung, der bei dieser Anfrage in den Cache geschrieben wird, aufgeteilt in zwei Stufen nach Aufbewahrungsdauer: 30 Minuten und 12 Stunden; die Ausgabe ist schließlich der vom Modell generierte Inhalt. GPT-6.2 Astra unterstützt Reasoning-Token; die während des Denkprozesses erzeugten Token werden in der Regel der Ausgabe zugerechnet – maßgeblich ist die Aufschlüsselung im usage-Feld der Abrechnung.
Die vier Einzelpreise liegen weit auseinander: Cache-Lesen $0.40, Eingabe $8, Cache-Schreiben $10 oder $20, Ausgabe $40. Rechnet man alle Token zum Eingabepreis, unterschätzt man ausgabelastige Aufgaben; ignoriert man das Cache-Schreiben, fallen die Kosten des ersten Aufrufs zu niedrig aus. Bei der Kostenschätzung müssen Sie daher zuerst aufteilen und dann jede Kategorie separat multiplizieren.
So bestimmen Sie die 272K-Schwelle bei GPT-6.2 Astra
Maßgeblich ist die Gesamtzahl der Eingabe-Token dieser einen Anfrage; auch die Cache-Treffer zählen zur Eingabe. Verlassen Sie sich am besten auf die offiziellen Angaben und die tatsächlichen usage-Werte. Das Kontextfenster des Modells beträgt 1,050,000, die maximale Eingabe 922,000 und die maximale Ausgabe 128,000 – Anfragen mit langem Kontext lassen sich also problemlos absenden, sie werden nur nach einem anderen Preisschema abgerechnet.
Ein praktisches Vorgehen: Addieren Sie System-Eingabeaufforderung, bisherigen Gesprächsverlauf, abgerufene Dokumente und Tool-Rückgaben. Nähert sich die Summe der 272K-Marke, sollten Sie frühzeitig entscheiden, ob Sie den Kontext komprimieren, die Anfrage auf mehrere Aufrufe verteilen oder in Kauf nehmen, dass die gesamte Anfrage in die andere Preisstufe wechselt.
So wenden Sie die Servicestufen-Multiplikatoren von GPT-6.2 Astra an
Die Kontextstufe bestimmt den Basis-Einzelpreis, die Servicestufe legt fest, mit welchem Faktor dieser Basispreis multipliziert wird. Die folgende Tabelle stammt ebenfalls von der offiziellen Modellseite.
| Servicestufe | Multiplikator | Basis | Hinweise |
|---|---|---|---|
| Batch | 50 % des Standardpreises | Asynchrone Batch-Verarbeitung | Geeignet für Großaufträge ohne Zeitdruck |
| Standard | 1× | Vorgabe | Grundlage für die beiden Beispiele in diesem Artikel |
| Fast | 2× | Standardpreis derselben Kontextlänge | Bei langem Kontext: Einzelpreis für langen Kontext nehmen und mit 2 multiplizieren |
| Ultrafast | 3× | bis 2027-02-28 (Pazifische Zeit) | Gilt nur bis zum Stichtag |
| Ultrafast | 6× | ab 2027-03-01 | Budget muss mit dem neuen Multiplikator neu berechnet werden |
Bei Fast ist die Regel auf der Modellseite ausdrücklich formuliert: Es gilt das Zweifache des Standardpreises derselben Kontextlänge. Aktivieren Sie Fast für eine Anfrage mit langem Kontext, liegen die Kosten also bei $16 × 2 = $32 für die Eingabe und $60 × 2 = $120 für die Ausgabe. Die Ultrafast-Multiplikatoren übertragen Sie nach derselben Logik – achten Sie dabei unbedingt auf die Zeitpunkte: Reicht die Laufzeit Ihres Projektbudgets über März 2027 hinaus, müssen Sie den Ultrafast-Anteil mit Faktor 6 neu durchrechnen; die Zahlen mit Faktor 3 dürfen Sie dann nicht weiterverwenden.
Eine weitere Einschränkung hängt indirekt mit den Kosten zusammen: Die API erlaubt es nicht, reasoning effort auf none zu setzen. Das bedeutet, dass Reasoning-Tokens immer anfallen. Planen Sie bei der Abschätzung des Ausgabevolumens also einen Puffer für das Reasoning ein – Sie dürfen nicht nur anhand der Länge der finalen Antwort kalkulieren.
GPT-6.2 Astra Schnellstart: Zwei handgerechnete Beispiele
Beide folgenden Beispiele kommen nur mit Multiplikation und Addition aus, und alle Einzelpreise gelten „pro 1 Million Token“. Die Rechnung lautet in jeder Zeile also: „Anzahl der Token × Einzelpreis ÷ 1,000,000“.
Beispiel 1: GPT-6.2 Astra – Anfragen mit kurzem Kontext
Das Szenario ist ein Frage-Antwort-Assistent mit langer System-Eingabeaufforderung. Jede Anfrage bringt insgesamt 100,000 Token Eingabe mit: 60,000 Token sind die feste System-Eingabeaufforderung samt Wissensschnipseln, die sich gut cachen lassen; weitere 40,000 Token sind Nutzerinhalte, die sich von Anfrage zu Anfrage ändern; die Ausgabe (inklusive Reasoning) liegt bei etwa 5,000 Token. Die Gesamteingabe von 100K liegt unter 272K, daher greift der Tarif für kurzen Kontext.
| Kostenposition | Erste Anfrage (Schreiben in den 30-Minuten-Cache) | Folgeanfragen (Cache-Treffer) |
|---|---|---|
| Normale Eingabe 40,000 × $8 | $0.32 | $0.32 |
| Cache-Schreiben 60,000 × $10 | $0.60 | — |
| Cache-Lesen 60,000 × $0.40 | — | $0.024 |
| Ausgabe 5,000 × $40 | $0.20 | $0.20 |
| Summe pro Anfrage | $1.12 | $0.544 |
Wie man sieht, liegen die Kosten pro Anfrage nach einem Cache-Treffer bei fast der Hälfte. Der erste Schreibvorgang in den Cache ist dagegen sogar teurer als ganz ohne Cache (ohne Cache: 100,000 × $8 = $0.80, plus Ausgabe macht zusammen $1.00). Nutzt man stattdessen das 12-Stunden-Cache-Schreiben, wird aus dieser Zeile 60,000 × $20 = $1.20 – das lohnt sich nur, wenn der Cache innerhalb der 12 Stunden wiederholt getroffen wird.
Rechnet man mit $0.544 pro Anfrage nach dem Cache-Treffer, kosten 1,000 Anfragen rund $544. Setzt man die Multiplikatoren der Preisstufen obendrauf: Batch etwa $272, Fast etwa $1,088, Ultrafast vor dem 2027-02-28 etwa $1,632 und ab dem 2027-03-01 etwa $3,264. Wie Batch und Cache im Detail zusammengerechnet und abgebucht werden, sollten Sie der offiziellen Abrechnungsdokumentation entnehmen – die Zahlen hier sind nur eine grobe Schätzung anhand der Multiplikatoren.
Beispiel 2: Langkontext-Anfrage mit über 272K Token an GPT-6.2 Astra
Das Szenario: Ein komplettes Code-Repository oder ein Stapel Verträge soll für die Analyse in den Kontext gepackt werden. Die Gesamteingabe einer einzelnen Anfrage beträgt 400.000 Token – davon treffen 300.000 den Cache, 100.000 sind normale Eingaben, und die Ausgabe umfasst rund 8.000 Token. Da die Gesamteingabe die 272K-Marke überschreitet, wird der gesamte Auftrag zum Langkontext-Preis abgerechnet.
| Abrechnungsposition | Korrekte Berechnung (gesamter Auftrag zum Langkontext-Preis) | Falsche Berechnung (alles zum Kurzkontext-Preis) |
|---|---|---|
| Normale Eingabe 100.000 | × 16 $ = 1,60 $ | × 8 $ = 0,80 $ |
| Cache-Lesen 300.000 | × 0,80 $ = 0,24 $ | × 0,40 $ = 0,12 $ |
| Ausgabe 8.000 | × 60 $ = 0,48 $ | × 40 $ = 0,32 $ |
| Summe pro Anfrage | 2,32 $ | 1,24 $ |
Je nach Rechenweg liegt das Ergebnis fast doppelt so hoch. Ein anderer häufiger Fehler: nur die 128K oberhalb der 272K-Schwelle zu verdoppeln – auch das widerspricht der Formulierung „Berechnung auf Basis des Gesamtauftrags“ auf der Modellseite. Es gibt genau eine korrekte Vorgehensweise: Sobald die Schwelle überschritten ist, werden bei diesem Auftrag Eingabe, Cache-Lesen und Cache-Schreiben jeweils zum doppelten Preis berechnet, die Ausgabe zum 1,5-Fachen.
Darauf kommen noch die Tarifstufen obendrauf: Fast liegt bei 2,32 $ × 2 = 4,64 $; Ultrafast kostet bis zum 28.02.2027 6,96 $ und ab dem 01.03.2027 13,92 $; Batch liegt bei rund 1,16 $. Läuft diese Aufgabe 200 Mal pro Tag, macht der Standard-Tarif rund 464 $ am Tag, mit Ultrafast (ab März 2027) sind es rund 2.784 $ am Tag – ein Unterschied, der ausreicht, um die technische Lösung zu verändern.
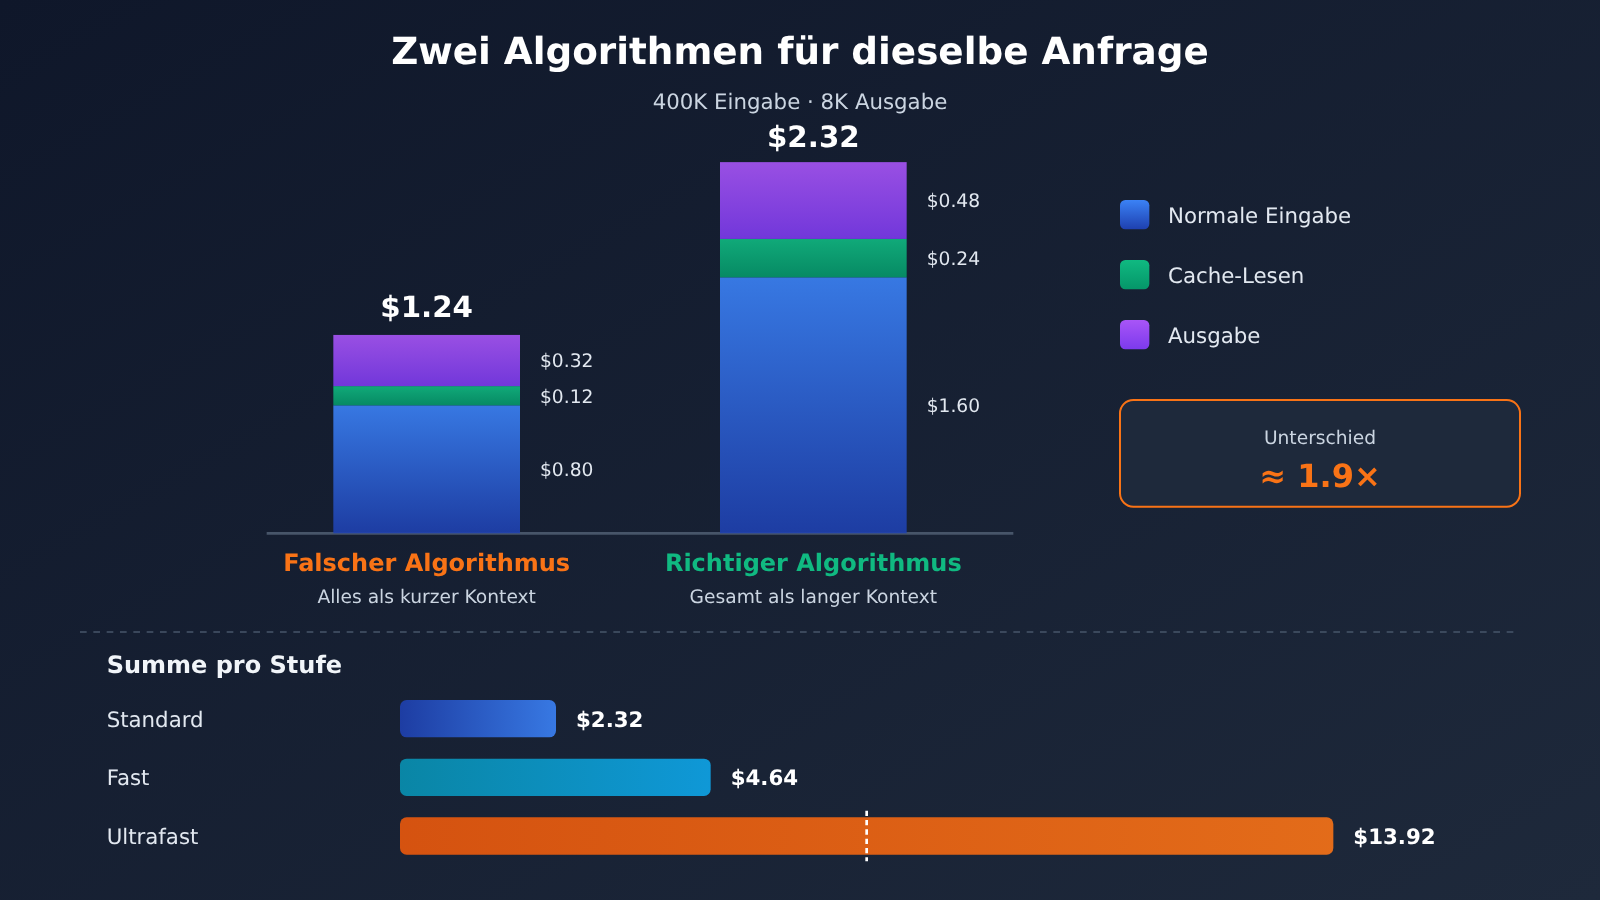
🎯 Preis-Tipp: Ersetzen Sie die Token-Zahlen in den beiden Beispielen oben durch Ihre eigenen tatsächlichen Werte, und Sie haben ein erstes Budget. Alle Zahlen im Diagramm wurden auf Grundlage der offiziellen Preise auf der OpenAI-Modellseite errechnet; sobald GPT-6.2 Astra bei APIYI gelistet ist, gilt der tatsächliche Stückpreis laut der Modellliste auf apiyi.com.
Vorbereitungsschritte für den Aufruf über APIYI
gpt-6.2-astra ist derzeit noch nicht gelistet. Wir werden das Modell so bald wie möglich verfügbar machen; Modellbezeichnung und Preis richten sich nach der Modellliste auf der Plattform. Nach der Listung erfolgt die Anbindung genauso wie bei anderen OpenAI-kompatiblen Modellen, und Sie können sich wie folgt vorbereiten:
- Erstellen Sie in der APIYI-Konsole einen API-Schlüssel und nutzen Sie das kostenlose Testguthaben für neue Nutzer, um zunächst kleine Stichproben zu testen.
- Setzen Sie im Client base_url auf
https://api.apiyi.com/v1und tragen Sie als Modell-IDgpt-6.2-astraein. - Der offiziellen Modellseite zufolge unterstützt das Modell die Endpunkte Chat Completions und Responses sowie Batch; nicht unterstützt werden Realtime, Assistants, Fine-Tuning, Bilderzeugung, Video und Sprache. Workflows, die diese Fähigkeiten benötigen, müssen auf ein anderes Modell ausweichen.
- Setzen Sie den Reasoning-Aufwand nicht auf
none, da die API die Anfrage sonst ablehnt. Beginnen Sie am besten mit einer niedrigeren Stufe und beobachten Sie, wie sich die Ausgabe-Token verändern. - Lesen Sie nach jedem Aufruf die usage-Daten aus der Antwort, erfassen Sie Eingaben, Cache-Treffer und Ausgaben getrennt und setzen Sie die Werte anschließend in die Tabellen dieses Artikels ein, um die Kosten zu prüfen.
🚀 Schnellstart: Bis zur Listung können Sie zunächst das bereits verfügbare Vorgängermodell
gpt-6-astraverwenden, um Schnittstelle und usage-Auswertelogik durchzutesten. Sobald 6.2 gelistet ist, müssen Sie nur die Modell-ID austauschen.
Preisvergleich: GPT-6.2 Astra und verwandte Modelle
Die folgende Tabelle stellt die offiziellen Listenpreise und die Preise aus der Gesamttabelle der bei APIYI gelisteten Modelle zusammen, damit Sie sie direkt vergleichen können. Beachten Sie, dass es sich um zwei unterschiedliche Quellen handelt: Die offiziellen Preise sind die Preise der Hersteller, die Plattformpreise stammen aus der Gesamttabelle von APIYI (Stand: 17.11.2026, 15:54 Uhr, UTC+8).
| Modell | Eingabe / Ausgabe / Cache-Lesen (pro 1 Mio. Token) | Preisquelle | Verfügbarkeit |
|---|---|---|---|
| gpt-6.2-astra | $8 / $40 / $0.40 | Offizieller OpenAI-Listenpreis | Bei APIYI noch nicht gelistet; maßgeblich ist die Modellliste der Plattform |
| gpt-6.2-sol | $2 / $10 / $0.10 | Offizieller OpenAI-Listenpreis | Bei APIYI noch nicht gelistet; maßgeblich ist die Modellliste der Plattform |
| gpt-6-astra (Vorgängermodell) | $10 / $50 / $1; bei über 272,000 Eingabe-Tokens $20 | APIYI-Gesamttabelle | Bei APIYI gelistet (apiyi.com) |
| gpt-6.1-sol | $2 / $10 / $0.1; bei über 272,000 Eingabe-Tokens $4 | APIYI-Gesamttabelle | Bei APIYI gelistet |
| gemini-4-carbon | $2 / $10 / $0.1 (Einführungspreis) | APIYI-Gesamttabelle | Bei APIYI gelistet |
Zu GPT-6.2 Sol: Der offizielle Standardpreis für kurze Kontexte liegt bei $2 für die Eingabe, $0.10 für das Cache-Lesen und $10 für die Ausgabe; das Cache-Schreiben kostet $2.50 für 30 Minuten und $5 für 12 Stunden. Die Regel für Gesamtaufträge über 272K sowie die Multiplikatoren der Tarifstufen entsprechen denen von Astra. Das Modell ist noch nicht gelistet – wir werden es so bald wie möglich verfügbar machen; maßgeblich für Modell und Preise ist die Modellliste der Plattform.
Wenn Sie gpt-6-astra zum Vergleich heranziehen, halten Sie vor Augen, dass es sich um das Vorgängermodell handelt: In der APIYI-Gesamttabelle kostet es $10 für die Eingabe, $50 für die Ausgabe und $1 für das Cache-Lesen. Laut der offiziellen Ankündigung liegen Eingabe und Ausgabe von GPT-6.2 Astra 20 % unter denen von GPT-6 Astra, das Cache-Lesen sogar 60 % darunter – das passt zu den Zahlen $8 / $40 / $0.40. Die Plattformpreise von gpt-6-astra oder gpt-6.1-sol dürfen Sie also nicht als Preise für 6.2 behandeln.
Bei Gemini 4 Carbon gibt es außerdem einen wichtigen Zeitpunkt: Der offizielle Google-Standardtarif gilt bis zum 30.11.2026 mit $2 für die Eingabe und $10 für die Ausgabe; ab dem 01.12.2026 ändert er sich auf $4 für die Eingabe und $20 für die Ausgabe. Auf der Hinweisseite von APIYI ist derzeit noch der Einführungspreis vermerkt; wie die Preise nach dem 1. Dezember tatsächlich aussehen, entnehmen Sie bitte der Modellliste der Plattform. Zudem enthält die Google-Preisliste keine Zeile wie „über 272K: Verdopplung des Gesamtauftrags“ – bei einem herstellerübergreifenden Vergleich dürfen Sie die Regeln für lange Kontexte von GPT-6.2 also nicht einfach übertragen.
💡 Empfehlung zur Auswahl: Derselbe Workload verbraucht auf verschiedenen Modellen unterschiedlich viele Token – ein niedriger Einheitspreis bedeutet nicht automatisch eine niedrigere Rechnung. Rufen Sie am besten bei APIYI mit denselben Beispieldaten mehrere der gelisteten Modelle auf, berechnen Sie die Gesamtkosten anhand der tatsächlichen usage-Werte und treffen Sie dann Ihre Entscheidung.
GPT-6.2 Astra: Offizielle Zahlen und Drittanbieter-Zahlen richtig einordnen
Für die Rechnungsschätzung braucht man eigentlich nur die Listenpreise, doch viele greifen beiläufig zu den „Kosten pro Aufgabe“ – hier sollte man die Quellen sauber auseinanderhalten.
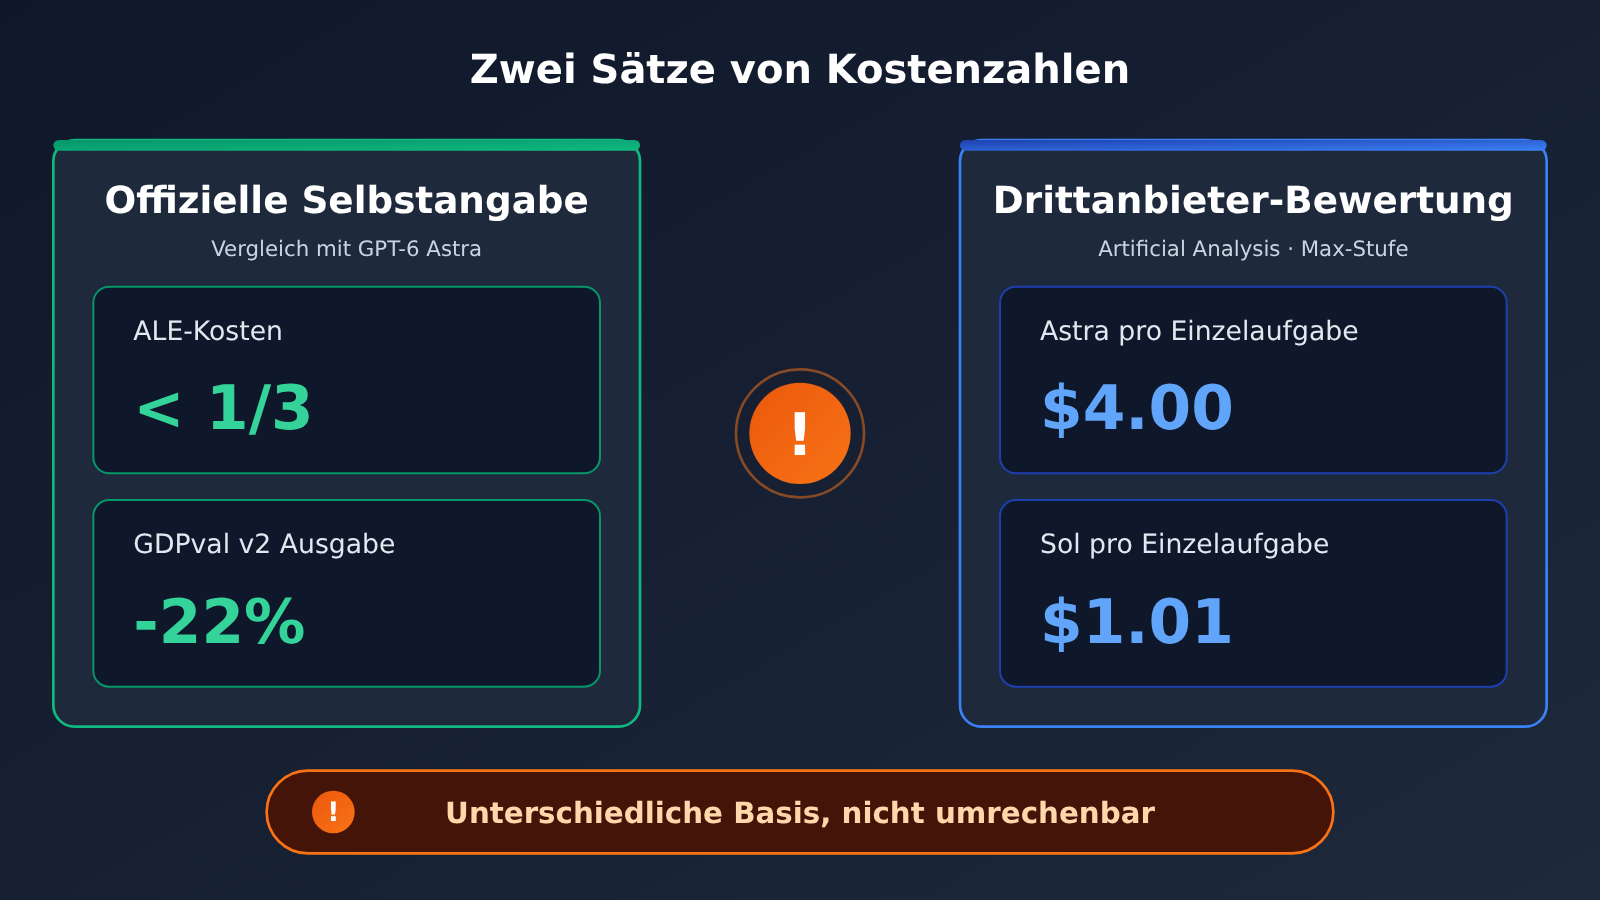
Offizielle Selbstauskunft: OpenAI schreibt in seiner Ankündigung, dass GPT-6.2 Astra beim Agents’ Last Exam 5,2 Punkte über GPT-6 Astra liegt und weniger als ein Drittel der Kosten verursacht; beim internen GDPval v2 liegt es 6,2 Prozentpunkte über GPT-6 Astra und verbraucht 22 % weniger Output-Token. Das sind Zahlen, die der Anbieter auf selbst gewählten Aufgaben ermittelt hat. Sie zeigen, dass der Token-Verbrauch bei diesen Aufgaben gesunken ist – lassen sich aber nicht direkt in Ihre Geschäftskosten umrechnen.
Drittanbieter: Artificial Analysis hat im Intelligence Index v5.0.1 für GPT-6.2 Astra (Reasoning-Stufe Max) im Gesamtindex durchschnittlich Kosten von etwa 4,00 $ pro Aufgabe gemessen, für GPT-6.2 Sol (Reasoning-Stufe Max) etwa 1,01 $. Das ist der Mittelwert über dessen eigene Eval-Aufgaben bei höchster Reasoning-Stufe – also weder der Einzelpreis von GPT-6.2 Astra noch eine Aussage darüber, dass Ihre Aufgaben jedes Mal 4,00 $ kosten. Eine niedrigere Reasoning-Stufe verändert den Token-Verbrauch erheblich, und die ebenfalls ausgewiesenen Werte für die Stufen High, Medium und Low fallen entsprechend unterschiedlich aus.
Beide Zahlensets basieren auf unterschiedlichen Aufgaben, Reasoning-Stufen und Auswertungsmethoden – man sollte sie weder ineinander umrechnen noch zu einem gemeinsamen Schluss zusammenführen. Für die Schätzung Ihrer eigenen Rechnung gilt weiterhin die bewährte Drei-Schritte-Formel: „Token aufschlüsseln, Schwellen prüfen, Multiplikatoren anwenden“.
Häufige Fragen (FAQ)
Q1: Wie hoch ist der Standardpreis für GPT-6.2 Astra?
Laut der offiziellen OpenAI-Modellseite liegt der Standardpreis für kurze Kontexte bei folgenden Werten pro 1 Million Token: Eingabe $8, Cache-Lesezugriff $0,40, Cache-Schreibzugriff (30 Minuten) $10, Cache-Schreibzugriff (12 Stunden) $20, Ausgabe $40. Das Modell ist derzeit noch nicht gelistet; wir werden es so bald wie möglich verfügbar machen. Modellname und Preise richten sich nach der Modellliste der Plattform.
Q2: Gilt der Aufpreis nur für den Teil, der 272K überschreitet?
Nein. Die Modellseite sieht ausdrücklich die Abrechnung über die gesamte Anfrage vor: Übersteigt die Eingabe einer Anfrage 272K Token, verdoppeln sich die Einheitspreise für Eingabe und Cache der gesamten Anfrage, und die Ausgabe wird mit dem 1,5-Fachen des Kurzkontext-Preises berechnet. In Beispiel 2 kostet dieselbe Anfrage korrekt berechnet $2,32 — würde man alles zum Kurzkontext-Preis abrechnen, wären es nur $1,24.
Q3: Wann ändert sich der Multiplikator für Ultrafast?
Bis zum 2027-02-28 (pazifische Zeit) gilt der dreifache Standardpreis, ab dem 2027-03-01 der sechsfache. Wer für Langzeitprojekte ein Budget plant, sollte die Ultrafast-Nutzung nach März separat mit dem Sechsfachen einrechnen.
Q4: Bei welchen Szenarien werden die Kosten von GPT-6.2 Astra am leichtesten falsch berechnet?
– **Code-Repository-Analysen**: Lädt man ein komplettes Repository auf einmal in die Anfrage, überschreitet man leicht die 272K — und die gesamte Anfrage wechselt die Preisklasse.
– **Agent-Aufgaben mit mehreren Runden**: Gesprächsverlauf und Tool-Ergebnisse wachsen stetig an; spätere Anfragen können unbemerkt über die Schwelle rutschen.
– **Erster Cache-Schreibzugriff**: Der Einheitspreis für den Cache-Schreibzugriff der ersten Anfrage liegt über dem normaler Eingaben — die Cold-Start-Kosten sollten separat einkalkuliert werden.
– **Anfragen mit langem Kontext und aktiviertem Fast oder Ultrafast**: Beide Aufpreisfaktoren multiplizieren sich.
Q5: Wie ruft man GPT-6.2 Astra über APIYI auf?
`gpt-6.2-astra` ist noch nicht gelistet; wir werden das Modell so bald wie möglich verfügbar machen. Modellname und Preise richten sich nach der Modellliste der Plattform. Bis dahin können Sie sich auf apiyi.com registrieren und kostenloses Testguthaben abrufen und mit dem bereits gelisteten `gpt-6-astra` (Eingabe $10, Ausgabe $50, Cache-Lesezugriff $1) zunächst den Modellaufruf über Responses oder Chat Completions samt usage-Statistiken durchtesten. Sobald das Modell gelistet ist, genügt es, die Modell-ID auszutauschen.
Q6: Kann man die $4,00 von Artificial Analysis als Einheitspreis verwenden?
Nein. Dabei handelt es sich um die gemittelten Kosten pro Aufgabe, die ein Dritter für das Intelligence-Index-Aufgabenset in der Reasoning-Stufe Max ermittelt hat — sie spiegeln lediglich den durchschnittlichen Verbrauch genau dieser Aufgabengruppe wider. Ihre Aufgabenlänge, Cache-Trefferquote und Reasoning-Stufe weichen davon ab; die Kosten sollten Sie anhand der offiziellen Einheitspreise selbst aufschlüsseln.
Q7: Welche bekannten Einschränkungen von GPT-6.2 Astra wirken sich auf die Kosten aus?
Der Reasoning-Effort lässt sich nicht auf `none` setzen, sodass sich Reasoning-Token nicht vollständig einsparen lassen; unterstützt werden nur Text- und Bildeingaben sowie Textausgaben, nicht aber Audio und Video; Realtime, Assistants und Fine-Tuning werden nicht unterstützt. Die offizielle System Card weist außerdem darauf hin, dass das Modell in einigen Tests blockierende Probleme (z. B. fehlende Dateien) leichter unerwähnt lässt. In Agent-Workflows bedeutet jeder zusätzliche Retry auch eine zusätzliche Abrechnung — die Eingabeaufforderung sollte das Modell daher ausdrücklich anweisen, solche Fälle zu melden.
GPT-6.2 Astra: Die wichtigsten Punkte zur Preisgestaltung (Key Takeaways)
- Vier Kategorien getrennt rechnen: Die Einheitspreise für Eingabe, Cache-Lesezugriffe, Cache-Schreibzugriffe und Ausgabe weichen stark voneinander ab – jeder Wert muss separat multipliziert werden.
- 272K gilt für die gesamte Anfrage: Wird die Schwelle überschritten, gelten Eingabe und Cache ×2 sowie Ausgabe ×1.5 – und zwar für die komplette Anfrage, nicht nur für den übersteigenden Teil.
- Tarifstufen kommen zusätzlich obendrauf: Batch mit 50 % Rabatt, Fast bei derselben Kontextlänge ×2, Ultrafast wird separat berechnet.
- Ultrafast hat einen Stichtag: Bis zum 2027-02-28 (PT) gilt ×3, ab dem 2027-03-01 ×6.
- Cache: erst teuer, dann sparen: Der erste Schreibvorgang liegt über dem Eingabepreis; nach einem Treffer sinken die Kosten pro Abruf auf fast die Hälfte.
- Rechengrundlagen nicht vermischen: Weder offizielle Selbstangaben noch Kosten von Drittanbietern pro Einzelaufgabe sind Einheitspreise.
- Verfügbarkeit richtet sich nach der Modellliste: Die beiden 6.2-Modelle sind bei APIYI noch nicht gelistet – zum Testen des Workflows können Sie vorerst das Vorgängermodell nutzen.
Fazit
Die Preisgestaltung von GPT-6.2 Astra lässt sich in drei Schritte zusammenfassen:
- Token aufschlüsseln: Zerlegen Sie eine Anfrage in normale Eingabe, Cache-Lesezugriffe, Cache-Schreibzugriffe und Ausgabe; die Reasoning-Tokens werden der Ausgabeseite zugerechnet.
- Schwelle prüfen: Liegt die Gesamteingabe einer Anfrage über 272K, wechselt die gesamte Anfrage zu den Einheitspreisen für lange Kontexte – Eingabe und Cache ×2, Ausgabe ×1.5.
- Multiplikator anwenden: Wählen Sie den Faktor je nach Batch, Standard, Fast oder Ultrafast – beachten Sie bei Ultrafast, dass ab dem 2027-03-01 der Faktor 6 gilt.
Für die Budgetplanung setzen Sie zunächst Ihre eigenen Token-Zahlen in die Tabellen aus Beispiel 1 und Beispiel 2 ein und rechnen Sie dann jeweils einmal mit der Standardstufe und einmal mit der Beschleunigungsstufe Ihrer Wahl – der Unterschied fällt meist größer aus, als man denkt. GPT-6.2 Astra und GPT-6.2 Sol sind bei APIYI noch nicht gelistet; wir werden diese Modelle so schnell wie möglich verfügbar machen. Maßgeblich für Modellnamen und Preise ist die Modellliste der Plattform. Bis dahin können Sie auf apiyi.com mit dem kostenlosen Guthaben und den bereits gelisteten Modellen den Workflow für Nutzungsstatistiken und die Kostenprüfung schon einmal aufsetzen.
📚 Referenzen
-
OpenAI-Ankündigung: Release Notes zu GPT-6.2 Astra und Sol
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Hinweis: Zusammenfassung der Standardpreise sowie offiziell angegebene Leistungsdaten
- Link:
-
OpenAI-Modellseite – gpt-6.2-astra: Spezifikationen und vollständige Preisregeln
- Link:
platform.openai.com/docs/models/gpt-6.2-astra - Hinweis: Maßgeblich für den Cache-Schreibpreis, die 272K-Gesamtauftragsregel und die Multiplikatoren für Batch/Fast/Ultrafast
- Link:
-
OpenAI-Modellseite – gpt-6.2-sol: Sol-Spezifikationen und Listenpreise
- Link:
platform.openai.com/docs/models/gpt-6.2-sol - Hinweis: Sol-Standardpreis für kurze Kontexte sowie dieselben Preisregeln
- Link:
-
OpenAI-Systemkarte: Sicherheits- und Alignment-Evaluierungen
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Hinweis: Bekannte Einschränkungen wie Fehlmeldungen und Blockadeprobleme
- Link:
-
Artificial-Analysis-Bewertungsartikel (Drittanbieter): Ergebnisse des Intelligence Index
- Link:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Hinweis: Drittanbieterdaten wie die Kosten pro Aufgabe in der Max-Inferenzstufe
- Link:
-
APIYI-Modellübersicht und Preis-API: Verfügbare Modelle und Plattform-Listenpreise
- Links:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing - Hinweis: Maßgeblich für den Verfügbarkeitsstatus der beiden 6.2-Modelle sowie die Preise der Vergleichsmodelle
- Links:
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Materialien zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com


