
Hinweis des Autors: Dieser Artikel analysiert die Blindtests auf der Tencent-Forschungsseite, die Benchmark-Tabellen im Anhang und die Aussagen aus der Produktseite, vergleicht Hy4 flash und GLM-5.3-Flash bei Alltagsaufgaben, Terminal-Coding, Kosten und Integrationsprotokoll und erklärt, welches Modell heute über APIYI aufgerufen werden kann.
Tencent Hunyuan hat am 16. November 2026 Hy4 flash veröffentlicht und positioniert es offiziell als „das günstigste Modell für die tägliche Produktivität“. Viele Menschen schwanken gerade zwischen GLM-5.3-Flash und Hy4 flash als ihrem täglichen Arbeitspferd. Die Tencent-Forschungsseite liefert drei Arten von Material: menschliche Blindtests, Benchmark-Tabellen im Anhang und Aussagen aus der Produktseite. Die Schlussfolgerungen der drei Quellen laufen nicht völlig in dieselbe Richtung.
Das ist kein Kompromisspapier nach dem Motto „Jeder hat seine Stärken“. Im Folgenden werden die drei Datenquellen getrennt dargestellt, und zu jeder Zahl wird die Quelle genannt. Zum Schluss gibt es je nach Szenario eine klare Empfehlung – und die Angabe, welches Modell sich heute direkt über APIYI aufrufen lässt.
Der Kernwert: Nach dem Lesen wissen Sie, wo Hy4 flash im Blindtest gewinnt, wo GLM-5.3-Flash bei den Benchmarks im Anhang gewinnt und auf welche Protokoll- und Preisangaben Sie bei der Anbindung achten müssen.
Hy4 flash vs. GLM 5.3 Flash: die zentralen Unterschiede
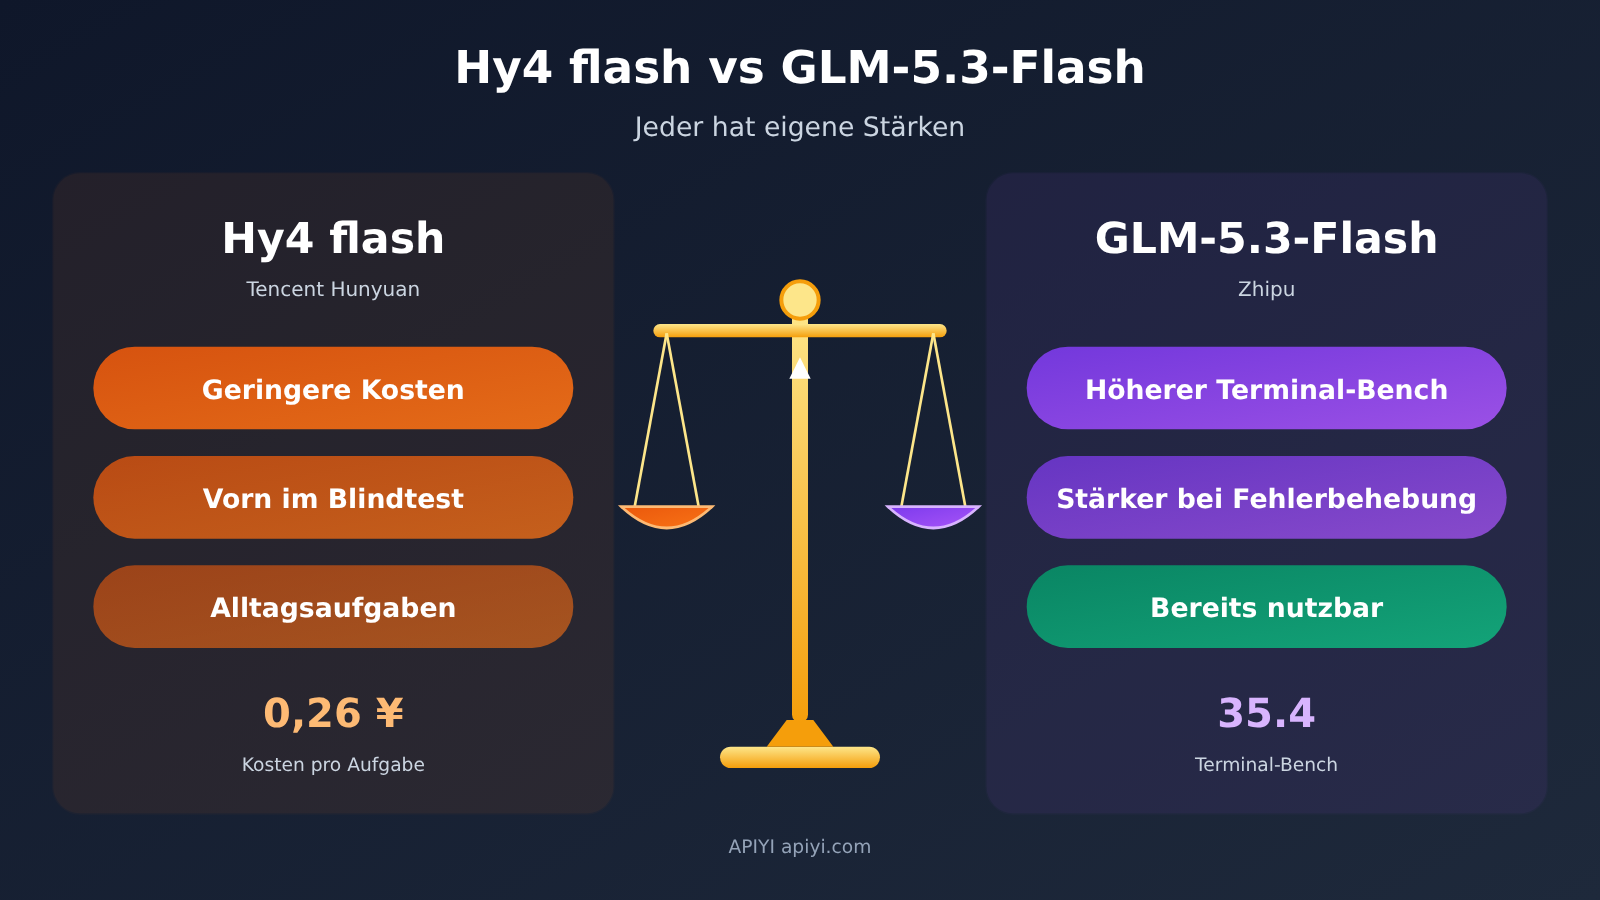
Das Fazit vorweg: Keiner von beiden ist in allen Belangen überlegen. Im Blindtest von Tencent erzielt Hy4 flash eine höhere Zufriedenheit und ist zugleich schneller und günstiger. In den Anhang-Benchmarks wie Terminal-Bench 4.0 und PPTFixBench, die stärker auf „Reparieren und Terminal-Bedienung“ ausgerichtet sind, erreicht GLM-5.3-Flash höhere Werte.
| Vergleichsdimension | Hy4 flash | GLM-5.3-Flash | Datenquelle |
|---|---|---|---|
| Blindtest-Zufriedenheit (4-Punkte-Skala) | 2.79 | 2.53 | Blindtest-Tabelle der Tencent-Forschungsseite (offizielle Selbstauskunft) |
| Mediane End-to-End-Dauer | 6.7 Minuten | 7.6 Minuten | ebenda |
| Kosten pro Aufgabe im Blindtest | 0.26 Yuan | 0.81 Yuan | ebenda, Renminbi |
| Terminal-Bench 4.0 | 19.2 | 35.4 | Anhang der Tencent-Forschungsseite |
| PPTFixBench | 23.7 | 28.6 | Anhang der Tencent-Forschungsseite |
| MdCoEditBench (gemeinsames Markdown-Schreiben) | 56.9 | 32.3 | Anhang der Tencent-Forschungsseite |
| Spezifikation | 224B Gesamtparameter (inkl. 64B Engram), 12B aktiv, 1M Kontextfenster | 320B Gesamtparameter, 18B aktiv, 1M Kontextfenster, maximale Ausgabe 128,000 | Forschungsseite / APIYI-Modellseite |
| Verfügbare Plattformen | Tencent Cloud TokenHub, WorkBuddy usw.; bei APIYI noch nicht gelistet | Bei APIYI (apiyi.com) ist glm-5.3-flash bereits gelistet |
Forschungsseite / APIYI-Modellliste |
Alle Werte in dieser Tabelle stammen von Tencent; GLM kommt nicht zu Wort, um sich zu verteidigen. Wichtig beim Lesen: Blindtest und Anhang sind offizielle Selbstauskünfte von Tencent, und die meisten Evaluationssets sind interne Tencent-Sets – keine Platzierungen in einer öffentlichen Abschlussrangliste.
Die drei Datenquellen hinter dem Vergleich von Hy4 flash und GLM 5.3 Flash
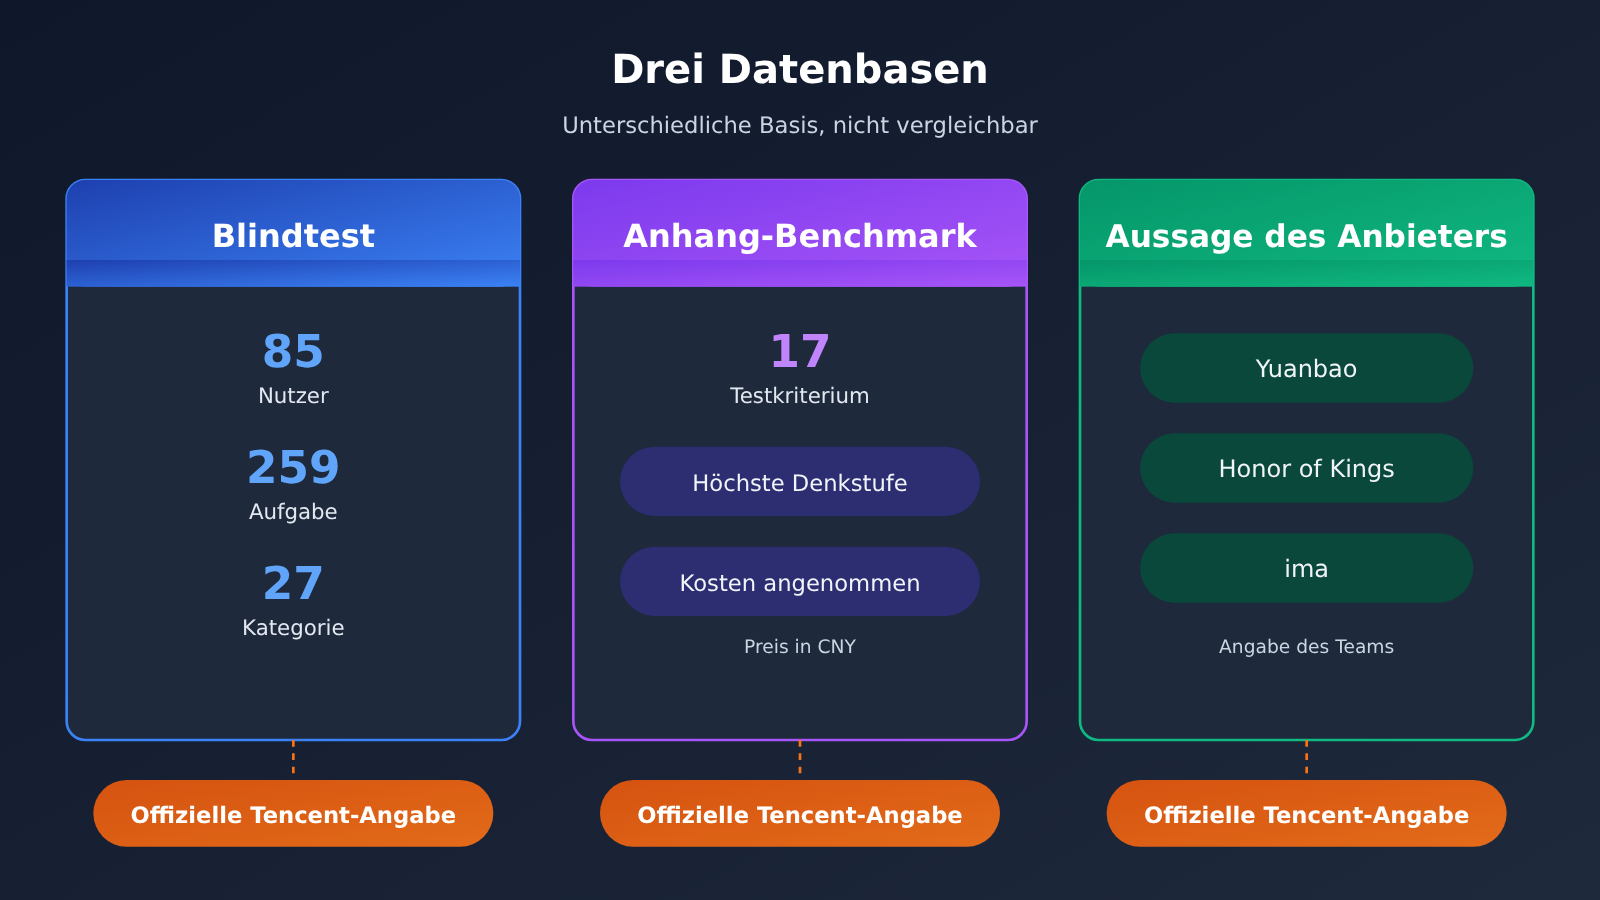
Die drei Materialien haben völlig unterschiedliche Bezugsrahmen; wer sie vermischt, zieht schnell falsche Schlüsse:
- Blindtest: 85 interne WorkBuddy-Nutzer, 259 Aufgaben, 27 Kategorien. Externe Modelle (inkl. GLM) nutzten die Einstellung high; bei der Zeile für Hy4 flash ist keine Stufe angegeben.
- Anhang-Tabelle: 17 Evaluationspunkte; alle Modelle wurden mit ihrer jeweils höchsten Inferenzstufe bewertet. Jede Zelle nennt zusätzlich die Kosten pro Aufgabe, berechnet nach den von Tencent festgelegten Pauschalpreisen in Renminbi.
- Aussagen der Produktteams: Selbstdarstellungen der Teams von Yuanbao, Honor of Kings, ima usw., jeweils mit eigenem Szenario und eigener Baseline – nicht quer vergleichbar.
Blindtest-Ergebnisse: Hy4 flash im Vergleich zu GLM 5.3 Flash
Der Blindtest ist der stärkste Beleg für Hy4 flash. Die vollständige Blindtest-Tabelle auf der Forschungsseite enthält vier Zeilen und ist hier unverändert wiedergegeben (von Tencent offiziell selbst berichtet):
| Modell | Zufriedenheit (4-Punkte-Skala) | Mediane End-to-End-Zeit | Kosten pro Aufgabe (RMB) |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 (high) | 3.09 | 10.3 Minuten | 1.20 RMB |
| Hy4 flash (Stufe nicht angegeben) | 2.79 | 6.7 Minuten | 0.26 RMB |
| Claude-Haiku-5.5 (high) | 2.81 | 6.8 Minuten | 4.73 RMB |
| GLM-5.3-Flash (high) | 2.53 | 7.6 Minuten | 0.81 RMB |
Betrachtet man nur die beiden Zeilen Hy4 flash und GLM-5.3-Flash, liegt Hy4 flash bei der Zufriedenheit um 0,26 Punkte höher, ist rund 0,9 Minuten schneller und kostet pro Aufgabe etwa ein Drittel von GLM. Das ist die unmittelbare Grundlage für die Aussage „im alltäglichen Blindtest günstiger“.
Drei Punkte sind dabei genau zu beachten. Erstens: Die höchste Zufriedenheit erzielt DeepSeek mit 3,09, nicht Hy4 flash. Zweitens: Hy4 flash liegt 0,02 Punkte unter Haiku; die Forschungsseite verwendet dafür den Ausdruck „nahe an“ (close to), nicht „übertrifft“. Drittens: Die im offiziellen Beitrag erwähnte „18-fache Senkung der Kosten pro Aufgabe“ ergibt sich aus 4,73 RMB geteilt durch 0,26 RMB; Vergleichsobjekt ist Haiku, nicht GLM.
Woher kommen die Blindtest-Kosten im Vergleich von Hy4 flash zu GLM 5.3 Flash?
Die RMB-Kosten in der Blindtest-Tabelle hat Tencent nach eigenen Preisberechnungsmaßstäben ermittelt. Sie zeigen, „wer bei derselben Aufgabencharge weniger ausgibt“, und entsprechen nicht Ihrer tatsächlichen Abrechnung auf irgendeiner Plattform. Die niedrigen Kosten von Hy4 flash kommen zum Teil vom niedrigeren Listenpreis und zum Teil daher, dass – wie auf der Forschungsseite angegeben – Reinforcement Learning die durchschnittliche Zahl der End-to-End-Output-Token um 50 % gesenkt hat.
Auf der Forschungsseite gibt es außerdem eine Gruppe von WorkIndex-Ergebnissen: Die durchschnittlichen Kosten pro Aufgabe liegen bei 1/13 von Hy4 preview und 1/20 von Hy4. Diese Aussagen beziehen sich ausschließlich auf WorkIndex; sie sollten nicht verwendet werden, um die RMB-Zahlen in der Blindtest-Tabelle zu ersetzen, und haben auch nichts mit GLM zu tun.
Hy4 flash im Vergleich zu GLM 5.3 Flash: Benchmarks im Anhang
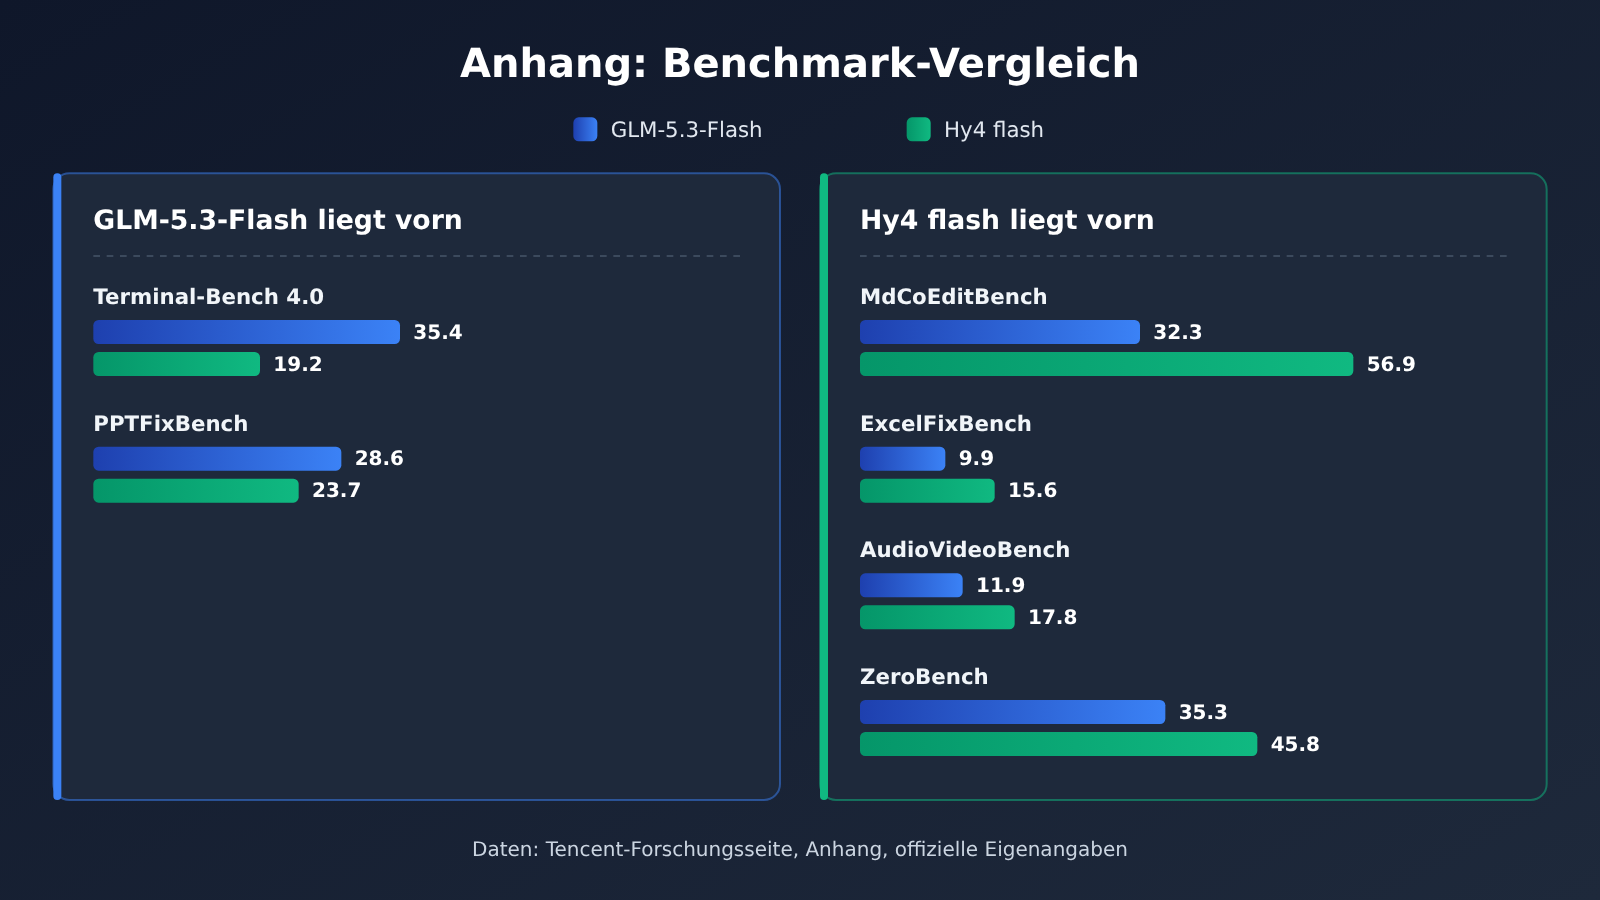
Im Anhang kann GLM-5.3-Flash wieder aufholen. Die folgende Tabelle stammt aus der vollständigen Grafik im Appendix der Tencent-Forschungsseite. Ich habe nur die beiden relevanten Spalten übernommen. Das Format ist „Punktzahl / Kosten pro Aufgabe (RMB)“:
| Benchmark | Hy4 flash | GLM-5.3-Flash | Höhere Punktzahl |
|---|---|---|---|
| PPTGenBench | 54.2 / 0.169 | 53.6 / 1.460 | Hy4 flash |
| PPTCoEditBench | 74.0 / 0.105 | 67.3 / 0.489 | Hy4 flash |
| PPTFixBench | 23.7 / 0.253 | 28.6 / 2.517 | GLM |
| MdCoEditBench | 56.9 / 0.057 | 32.3 / 0.133 | Hy4 flash |
| WordEditBench | 46.2 / 0.629 | 47.6 / 2.840 | GLM |
| ExcelFixBench | 15.6 / 0.310 | 9.9 / 2.879 | Hy4 flash |
| AudioVideoBench | 17.8 / 0.344 | 11.9 / 3.370 | Hy4 flash |
| BuddyVQA Atlas (ohne Tools) | 48.5 / 0.007 | 50.1 / 0.019 | GLM |
| DeepSWE v1.1 | 64.6 / 0.290 | 67.8 / 3.230 | GLM |
| ProgramBench | 16.0 / 0.561 | 13.0 / 17.959 | Hy4 flash |
| Terminal-Bench 4.0 | 19.2 / 0.558 | 35.4 / 5.597 | GLM |
| APEX-Agents v1.1 | 63.1 / 0.087 | 51.5 / 0.485 | Hy4 flash |
| AutomationBench v1.0.6 | 52.2 / 0.038 | 48.4 / 0.104 | Hy4 flash |
| HLE-Full (mit Tools) | 55.2 / 0.060 | 52.2 / 0.616 | Hy4 flash |
| OSWorld 2.1 | 68.1 / 0.451 | 64.0 / 3.803 | Hy4 flash |
| MMMU-Pro | 75.8 / 0.010 | 77.0 / 0.013 | GLM |
| ZeroBench-main (mit Tools) | 45.8 / 0.077 | 35.3 / 1.861 | Hy4 flash |
Den größten Unterschied gibt es bei Terminal-Bench 4.0: GLM erreicht 35.4, Hy4 flash 19.2 – fast das Doppelte. Dieser Benchmark nutzt das Claude-Code-Harness, läuft bis zu 500 Runden und pro Durchlauf maximal 13 Stunden. Geprüft werden lang andauernde Terminal-Operationen. Auch bei PPTFixBench liegt GLM rund 5 Punkte vorn. Bei DeepSWE, WordEditBench, BuddyVQA und MMMU-Pro führt GLM ebenfalls leicht.
Hy4 flash liegt dagegen beim gemeinsamen Schreiben in Markdown (56.9 zu 32.3), bei der Tabellenreparatur, der Audio- und Videoverarbeitung sowie bei ZeroBench deutlich vorn. Diese Aufgaben kommen der alltäglichen Büroarbeit näher: Dokumente schreiben, Tabellen korrigieren, Material bearbeiten. Das passt zur Empfehlung auf der Forschungsseite: Für lang andauernde Software-Engineering-Aufgaben weiterhin Hy4 verwenden, nicht Hy4 flash.
Die Kostenspalte im Anhang ist eine Tencent-Annahme, keine Plattformabrechnung
Der Originaltext des Anhangs erklärt: Die Kosten wurden anhand der offiziellen API-Preise der jeweiligen Modelle berechnet, mit einem Umrechnungskurs von 1 US-Dollar zu 7.2 RMB. Für GLM-5.3-Flash wird ein Festpreis von 0.8 Yuan pro Million Token Input, 0.23 Yuan bei Cache-Treffer und 2.8 Yuan Output angegeben, ausgewiesen als „Standard-API-Preis“. Das sind die Annahmen, die Tencent beim Erstellen der Tabelle im Anhang zugrunde gelegt hat – nicht der Listenpreis von APIYI. Und Sie sollten daraus auch nicht Ihre eigene Abrechnung bei APIYI ableiten.
Aussagen der Produktteams zu Hy4 flash im Vergleich zu GLM 5.3 Flash
Die Forschungsseite enthält außerdem Stellungnahmen der verschiedenen Tencent-Produktteams, und drei davon nennen GLM-5.3-Flash direkt beim Namen. All das sind Selbstauskünfte der Produktteams, jeweils mit eigenen Szenarien und Baselines:
- Yuanbao (Selbstauskunft des Produktteams): In allgemeinen Dialogen 2.52 % besser als GLM-5.3-Flash, am deutlichsten bei Multi-Turn-Dialogen. Das ist eine interne Bewertung des Yuanbao-Teams, kein öffentliches Ranking.
- 王者荣耀 / Honor of Kings (Selbstauskunft des Produktteams): Gegenüber DeepSeek-V4.1-Flash-1017 und GLM-5.3-Flash ist die Root-Cause-Lokalisierung vergleichbar. Dabei 22.0 % bis 39.1 % weniger Modellanfragen, 40.5 % bis 61.2 % weniger Tokens und jeweils 51.2 % bzw. 7.7 % mehr Tool-Aufrufe.
- ima (Selbstauskunft des Produktteams): Gegenüber den beiden genannten Modellen 18 % bis 35 % kürzere durchschnittliche Wartezeit, 1.8 % höhere Antwortbewertung und 8.1 % höhere Inhaltsqualität.
Der gemeinsame Nenner dieser Aussagen: Hy4 flash liegt beim „weniger Tokens verbrauchen, kürzer warten“ vorn, bei der Qualität ist es gleichauf oder leicht überlegen. Sie stützen die Ergebnisse des Blindtests, können aber den Terminal-Bench-Abstand aus dem Anhang nicht widerlegen – weil es schlicht nicht dieselbe Art von Aufgabe ist.
Hy4 flash im Vergleich zu GLM 5.3 Flash: Preise und Integration
Der Preis ist der Teil, bei dem am leichtesten Fehler passieren. Zahlen aus unterschiedlichen Quellen dürfen nicht vermischt werden. Die folgende Tabelle führt die Herkunft jedes Preises getrennt auf (alle Angaben in US-Dollar pro Million Token):
| Modell / Quelle | Eingabe | Ausgabe | Cache-Read | Hinweis |
|---|---|---|---|---|
| Hy4 flash (Tencent-Forschungsseite, Listenpreis) | 0.070 | 0.281 | 0.003 | Kein APIYI-Listenpreis; TokenHub bis 2026-11-30 50 % Rabatt |
glm-5.3-flash (APIYI-Modellseite auf apiyi.com) |
0.15 | 0.50 | 0.03 | Bereits verfügbar, Gruppen CodexResponses, Default, SVIP, Multiplikator 1x |
glm-5-3-flash-260828 (APIYI-Übersichtstabelle) |
0.15 | 0.499995 | 0.03 | Ein weiterer Kanal, steht nicht im Konflikt mit dem vorherigen Eintrag |
hy4 (APIYI-Übersichtstabelle) |
0.85 | 2.55 | 0.045 | Dies ist Hy4, nicht Hy4 flash |
| Hy4 (Tencent-Forschungsseite, Listenpreis) | 0.834 | 2.501 | 0.042 | Listenpreis der Forschungsseite, getrennt vom APIYI-Preis betrachten |
Der 50-%-Rabatt für Hy4 flash ist ein zeitlich begrenzter Aktionspreis von TokenHub. Auf der Forschungsseite gibt es keine separate Tabelle mit dem reduzierten Preis. Wenn Sie selbst durch 2 teilen, um den Preis zu schätzen, denken Sie daran, dass nach dem 30. November wieder der Listenpreis gilt.
Hy4 flash ist derzeit noch nicht gelistet; wir werden dieses Modell so schnell wie möglich aufnehmen. Modellbezeichnungen und Preise richten sich nach der Modellliste der Plattform. Derzeit gibt es bei APIYI nur hy4, keine Flash-Version von Hunyuan. Wenn Sie die Hunyuan-Version von Tencent mit dem hohen Limit benötigen, können Sie zunächst hy4 verwenden. Wenn Sie genau Hy4 flash wollen, geht das derzeit nur über offizielle Kanäle wie Tencent Cloud TokenHub, WorkBuddy und weitere. Die Forschungsseite gibt auch keine API-Modell-ID an; vor dem Aufruf gilt der Name, den die TokenHub-Konsole anzeigt.
So rufen Sie GLM-5.3-Flash über APIYI auf
glm-5.3-flash kann bereits heute aufgerufen werden. Bei APIYI wird ausschließlich OpenAI Chat Completions unterstützt, nicht Anthropic Messages und auch nicht Responses. Das entscheidet darüber, ob Sie es direkt in bestimmte Clients einbinden können:
- Erstellen Sie in der apiyi.com-Konsole einen Schlüssel.
- Setzen Sie die
base_urldes Clients aufhttps://api.apiyi.com/v1; der Anfragepfad ist/chat/completions. - Im Request-Body tragen Sie bei
modelglm-5.3-flashein und übergebenmessagesim OpenAI-Format. - Der Denkmodus ist standardmäßig aktiviert; Eingaben können Text, Bilder oder Videos sein, die Ausgabe ist Text.
Wenn Ihr Tool ausschließlich Anfragen im Anthropic-Messages-Format sendet, können Sie glm-5.3-flash nicht direkt verwenden. In solchen Fällen wechseln Sie entweder zu einem Client, der Chat Completions unterstützt, oder zu einem Modell, das sowohl Chat- als auch Messages-Endpunkte anbietet. Parameter wie Kontextfenster, maximale Ausgabe und Endpunkte richten sich nach der Modellseite von APIYI.
🚀 Integrationsempfehlung: Bei Modellen, die bereits bei APIYI verfügbar sind, verwenden Sie den Schlüssel von apiyi.com und senden die Anfrage einfach an
https://api.apiyi.com/v1. Bei OpenAI-kompatiblen Clients reicht es, zwei Konfigurationspunkte anzupassen, damit es läuft. Neue Nutzer erhalten ein kostenloses Testkontingent und könnenglm-5.3-flashzunächst mit ihren alltäglichen Aufgaben ausprobieren.
Szenarioempfehlungen: Hy4 flash im Vergleich zu GLM 5.3 Flash
Wann Sie Hy4 flash wählen sollten
- Gemeinsames Schreiben von Dokumenten und Markdown: Im Zusatz-Benchmark MdCoEditBench steht es 56,9 zu 32,3 – der Abstand ist deutlich.
- Tabellenreparatur, Verarbeitung von Audio- und Videomaterial: In ExcelFixBench und AudioVideoBench liegt Hy4 flash vorn.
- Kostenempfindliche, häufige Alltagsaufgaben: Im Blindtest 0,26 Yuan pro Aufgabe gegenüber 0,81 Yuan (Angabe von Tencent selbst).
- Produkte mit mehrstufigen Dialogen: Laut dem Produktteam von 元宝 liegt die allgemeine Dialogqualität um 2,52 % höher, am deutlichsten bei mehrstufigen Dialogen.
Wann Sie GLM-5.3-Flash wählen sollten
- Terminal-Bedienung und lang laufende Kommandozeilen-Aufgaben: Terminal-Bench 4.0 steht bei 35,4 zu 19,2 – das ist der größte Unterschied überhaupt.
- Reparatur-Aufgaben bei Präsentationsfolien: PPTFixBench 28,6 zu 23,7.
- Wenn es heute live gehen soll:
glm-5.3-flashist bereits auf APIYI verfügbar, Hy4 flash noch nicht. - Wenn Ihre Toolchain auf Chat Completions basiert: Clients im OpenAI-Format können direkt angebunden werden.
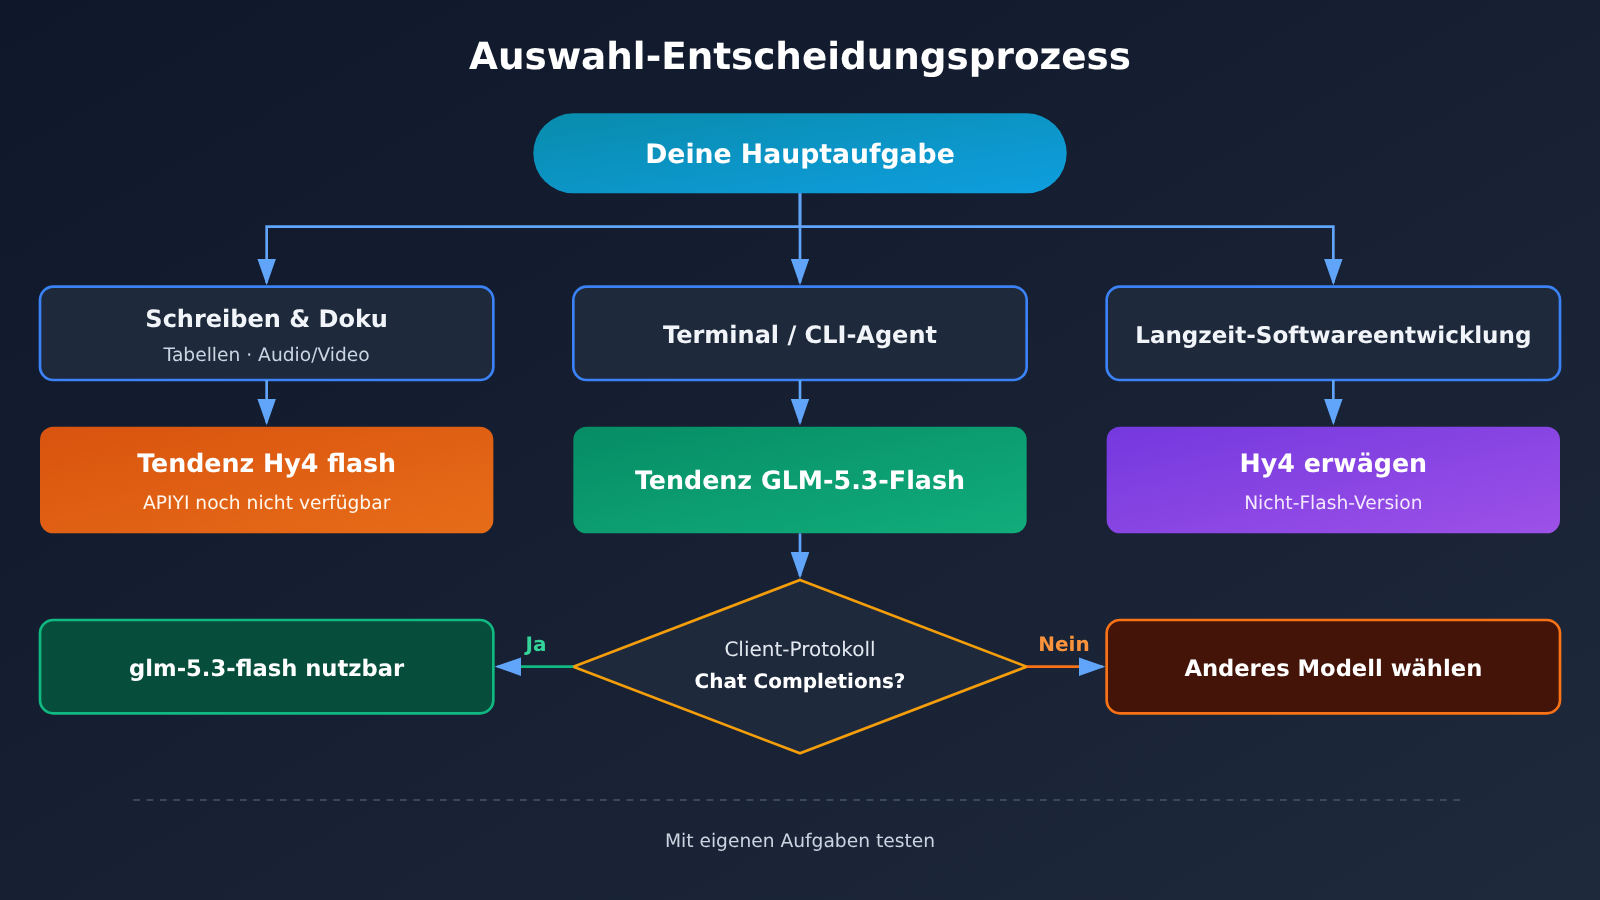
Entscheidungshilfe: Hy4 flash im Vergleich zu GLM 5.3 Flash
| Ihre Situation | Empfehlung |
|---|---|
| Schwerpunkt auf Schreiben, Dokumenten, Tabellen, Materialverarbeitung | Auf die Verfügbarkeit von Hy4 flash warten oder zunächst über den offiziellen Tencent-Kanal testen |
| Schwerpunkt auf Terminal-Bedienung, Kommandozeilen-Agenten | GLM-5.3-Flash wählen |
| Sie müssen heute auf APIYI live gehen | glm-5.3-flash wählen, über Chat Completions |
| Der Client unterstützt nur Anthropic Messages | glm-5.3-flash passt nicht, nehmen Sie ein Modell, das messages unterstützt |
| Langfristige Softwareentwicklung | Beide sind nicht die erste Wahl, die Forschungsseite empfiehlt Hy4 |
💡 Empfehlung: Blindtest und Zusatz-Benchmarks deuten in unterschiedliche Richtungen. Am sichersten ist es, mit Ihren eigenen Aufgaben jeweils eine Charge laufen zu lassen.
glm-5.3-flashkönnen Sie sofort auf APIYI unter apiyi.com testen; sobald Hy4 flash verfügbar ist, genügt ein Wechsel desmodel-Parameters, um beide im gleichen Code zu vergleichen.
Häufig gestellte Fragen (FAQ)
F1: Was sind Hy4 flash und GLM-5.3-Flash jeweils?
Hy4 flash ist ein Modell für alltägliche Aufgaben, das Tencent Hunyuan am 2026-11-16 veröffentlicht hat: 224B Gesamtparameter, 12B aktive Parameter, 1M Kontextfenster. GLM-5.3-Flash ist laut der Modellseite von APIYI mit 320B Gesamtparametern, 18B aktiven Parametern und 1M Kontextfenster angegeben; der Hersteller hat es am 2026-08-26 veröffentlicht.
F2: Hy4 flash gegen GLM 5.3 Flash – wer ist nun stärker?
Das hängt vom Aufgabentyp ab. Im Blindtest von Tencent erreicht Hy4 flash eine Zufriedenheit von 2.79, GLM 2.53; im Anhang liegt GLM bei Terminal-Bench 4.0 und PPTFixBench vorn, während Hy4 flash bei gemeinsamer Markdown-Erstellung, Tabellen, Audio/Video und ZeroBench besser abschneidet. Alle Daten sind offizielle Eigenangaben von Tencent.
F3: Yuanbao sagt, bei allgemeinen Dialogen liege es 2,52 % über GLM-5.3-Flash – kann man das glauben?
Das ist eine Selbsteinschätzung des Yuanbao-Produktteams, kein öffentliches Ranking, und es gibt keine offengelegten Methodendetails. Man kann es als Hinweis darauf nehmen, dass Hy4 flash bei mehrstufigen Dialogen möglicherweise vorn liegt, sollte es aber nicht als endgültige Aussage behandeln.
F4: Sind die 0,8 Yuan, 0,23 Yuan und 2,8 Yuan im Anhang Preise von APIYI?
Nein. Das sind feste RMB-Preisannahmen, die Tencent beim Erstellen der Anhangtabelle verwendet hat. Der Preis von `glm-5.3-flash` auf der APIYI-Modellseite liegt bei 0.15 für Eingabe, 0.50 für Ausgabe und 0.03 für Cache-Lesen pro Million Token in USD; maßgeblich ist die Modellliste der Plattform.
F5: Kann man Hy4 flash derzeit bei APIYI aufrufen?
Hy4 flash ist noch nicht gelistet, wir nehmen das Modell so schnell wie möglich auf; Modellbezeichnungen und Preise richten sich nach der Modellliste der Plattform. Derzeit lassen sich bei APIYI `glm-5.3-flash` und `hy4` aufrufen – beachten Sie, dass `hy4` nicht die Flash-Version ist. Neuigkeiten zur Aufnahme finden Sie in der Modellliste auf apiyi.com.
F6: Lässt sich glm-5.3-flash in Clients einbinden, die nur das Anthropic-Format unterstützen?
Nein. `glm-5.3-flash` bietet bei APIYI ausschließlich den OpenAI-Chat-Completions-Endpunkt, nicht Messages oder Responses. Der Client muss in der Lage sein, base_url auf `/v1` zu zeigen und Chat-Completions-Anfragen zu senden.
F7: Welche bekannten Schwächen haben die beiden Modelle?
Hy4 flash erreicht bei Terminal-Bench 4.0 nur 19.2 Punkte, und die Forschungsseite räumt ein, dass es bei langfristiger Softwareentwicklung hinter Hy4 zurückliegt; die Gewichte sollen derzeit nur als Open Source geplant sein. GLM-5.3-Flash liegt bei der Blindtest-Zufriedenheit und bei der gemeinsamen Markdown-Erstellung zurück und läuft ausschließlich über Chat Completions. Die Vergleichsdaten stammen in beiden Fällen von Tencent selbst.
Hy4 flash im Vergleich zu GLM 5.3 Flash – die Kernpunkte
- Blindtest: Hy4 flash liegt vorn – Zufriedenheit 2,79 gegenüber 2,53, 6,7 Minuten gegenüber 7,6 Minuten, 0,26 Yuan gegenüber 0,81 Yuan.
- Terminal-Benchmark: GLM besser – Terminal-Bench 4.0: 35,4 gegenüber 19,2; auch bei PPTFixBench führt GLM.
- Alltags- und Büroaufgaben: Hy4 flash besser – gemeinsames Markdown-Schreiben, Tabellenreparatur, Audio/Video und ZeroBench erzielen höhere Werte.
- Zeugnisse sind nur Selbstauskunft – die Angabe „2,52 % höher“ von Yuanbao stammt vom Produktanbieter selbst, nicht aus einer öffentlichen Rangliste.
- Preise: Quelle beachten – die Yuan-Beträge im Anhang sind Tencent-Annahmen, die Dollar-Beträge auf der Studienseite sind Listenpreise; beides sind nicht die Preise von APIYI.
- Heute aufrufbar ist GLM –
glm-5.3-flashist bereits auf APIYI apiyi.com verfügbar, unterstützt aber nur Chat Completions.
Fazit
Die zentralen Ergebnisse aus dem Vergleich von Hy4 flash mit GLM 5.3 Flash:
- Für Alltagsaufgaben spricht Hy4 flash: Im Blindtest von Tencent schneidet es zufriedenstellender, schneller und günstiger ab, auch bei Dokument- und Tabellen-Benchmarks liegt es vorn.
- Für Terminal-Aufgaben spricht GLM-5.3-Flash: Bei Terminal-Bench 4.0 ist der Abstand fast doppelt so groß – für langlaufende Kommandozeilen-Aufgaben sollten Sie nicht Hy4 flash wählen.
- Für den Praxiseinsatz zählen Verfügbarkeit und Protokoll: Was Sie heute bei APIYI aufrufen können, ist
glm-5.3-flash, und zwar ausschließlich über Chat Completions; Hy4 flash ist derzeit noch nicht gelistet.
Wenn Ihre Aufgaben überwiegend aus Schreiben und Dokumenten bestehen, lohnt es sich, den Verfügbarkeitsstart von Hy4 flash im Auge zu behalten. Geht es eher um Terminal-Operationen oder soll etwas sofort live gehen, ist glm-5.3-flash die direktere Wahl. Mein Tipp: Nutzen Sie das kostenlose Testkontingent auf apiyi.com und lassen Sie Ihre eigenen realen Aufgaben einmal durchlaufen, bevor Sie sich entscheiden.
📚 Referenzen
-
Tencent Hunyuan Hy4 flash Forschungsseite: Blindtest-Tabelle, Anhang-Benchmarks, Herstelleraussagen und Listenpreise
- Link:
hy.tencent.ai/research/hy4-flash - Beschreibung: Sämtliche Blindtests, Anhang-Ergebnisse und Aussagen in diesem Artikel stammen von dieser Seite und sind offizielle Angaben von Tencent selbst.
- Link:
-
Offizieller Veröffentlichungsbeitrag von Tencent Hunyuan: Hy4 flash Release und API-Listenpreise
- Link:
x.com/TencentHunyuan/status/2122217770314301469 - Beschreibung: Quelle für die „18-fache Senkung der Aufgabenkosten“, Vergleichsobjekt ist Claude Haiku 5.5
- Link:
-
APIYI GLM-5.3-Flash Modellseite: Parameter, Kontextfenster, Endpunkte und Preise
- Link:
docs.apiyi.com/models/glm-5-3-flash - Beschreibung: Spezifikationen und Protokoll von
glm-5.3-flashrichten sich nach dieser Seite.
- Link:
Autor: APIYI Technik-Team
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website. Weitere Modell- und Integrationsinformationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.


