
Anmerkung des Autors: Dieser Artikel ordnet den Mechanismus „Claude Dreaming“ ein, den der Anthropic-Engineering-Blog offengelegt hat. Er behandelt die vierschichtige Speicherstruktur, die Daten aus den Experimenten mit CL-Bench und Wiki, Beispiele für Fehlerkorrekturen sowie technische Risiken. Außerdem zeigt er, wie Entwickler die Idee, Erinnerungen zwischen den Sitzungen aufzuräumen, für ein eigenes Agent-Speichersystem nutzen können.
Am 6. November 2026 hat Anthropic im Engineering-Blog den Beitrag The components of agent memory veröffentlicht. Er erklärt erstmals systematisch, wie Claude Dreaming zwischen den Sitzungen Fehler korrigiert, Erinnerungen ordnet und eine Wissensbasis aufbaut. Der offizielle X-Account hat den Artikel zeitgleich geteilt, und in der Dokumentation zu Claude Managed Agents taucht inzwischen auch eine Research-Preview-Schnittstelle für Dreams auf.
Das ist nicht noch so ein Konzept nach dem Motto „Agent plus Vektordatenbank“. Anthropic zeigt anhand mehrerer Experimente: Für langlaufende Agenten reicht es nicht, den Verlauf nur zu speichern. Erst wenn Erinnerungen fortlaufend geprüft, korrigiert, zusammengeführt und organisiert werden, helfen alte Informationen bei der nächsten Aufgabe wirklich weiter.
Der Nutzen für Sie: Nach der Lektüre kennen Sie die vierschichtige Speicherstruktur von Claude Dreaming und die wichtigsten Zahlen aus den Experimenten. Sie wissen außerdem, wann der Ansatz hilft und wann er schadet, und wie Sie ihn in Ihrem eigenen Agenten aufgreifen können.
Claude Dreaming: die wichtigsten Infos im Überblick
| Info | Details |
|---|---|
| Veröffentlichung | 06.11.2026, Anthropic Engineering Blog |
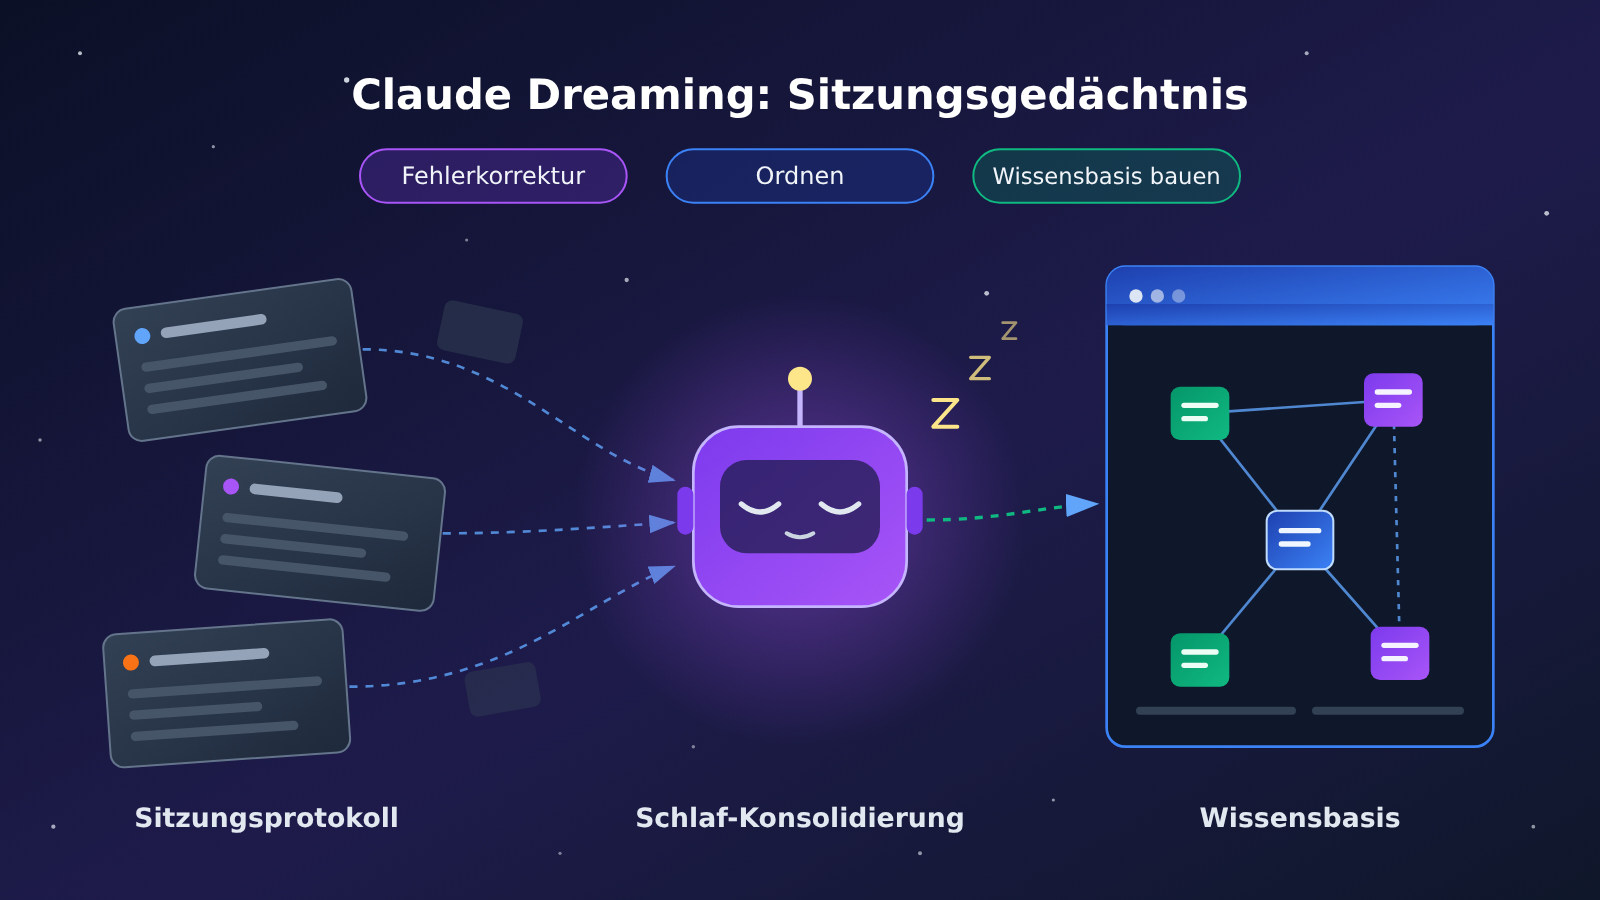
| Kernkonzept | Dreaming: ein Hintergrundprozess, der zwischen Sitzungen den bisherigen Verlauf nutzt, um Erinnerungen neu zu ordnen und zu pflegen |
| Speicherebenen | 4 Ebenen: Transcripts, Memory notes, Memory representations, Injected context |
| Produktform | Dreams in Claude Managed Agents, derzeit Research Preview, Zugang auf Antrag |
| Begleitmaterial | Offizielles Cookbook „Dreaming with a dynamic workflow“, veröffentlicht am 02.11.2026 |
| Betroffene Bereiche | Langlaufende Agents, sitzungsübergreifende Aufgaben, Aufbau unternehmensinterner Wissensdatenbanken |
Bevor wir zu Dreaming kommen, ein paar Begriffe vorab. Ein Transcript ist das vollständige Sitzungsprotokoll, also Nutzereingaben, Agent-Ausgaben, Tool-Aufrufe und deren Ergebnisse. Eine Memory Note enthält dauerhafte Fakten, Regeln und Erfahrungen, die aus früheren Sitzungen destilliert wurden. Der Memory Store ist ein persistenter Speicher, der Erinnerungsdateien sitzungsübergreifend aufbewahrt. Dreaming folgt einer ähnlichen Idee wie Sleep-time Compute: Neben der eigentlichen Interaktion wird freie Rechenleistung genutzt, um vorhandenen Kontext zu verarbeiten.
Warum Agent-Gedächtnis nicht einfach aus gespeicherten Gesprächen bestehen kann
Viele Teams speichern beim Thema Agent-Gedächtnis zunächst einmal alle Gespräche und rufen sie bei Bedarf per Suche ab. Das Problem: Verlaufsprotokolle, Sitzungszusammenfassungen und durchsuchbares Wissen sind drei verschiedene Dinge. Ein Protokoll ist nur eine Anhäufung roher Ereignisse, eine Zusammenfassung kann entscheidende Details verlieren, und nur geprüftes und gut organisiertes Wissen hilft der nächsten Aufgabe zuverlässig weiter.
Wer einfach alle Gespräche speichert, handelt sich drei Risiken ein: doppelte Informationen, veraltete Zustände und sich anhäufende Fehler. Ein falscher Eintrag wird in späteren Sitzungen immer wieder gelesen, und der Fehler wird dann als Fakt behandelt und weiter ausgeführt. Anthropic bringt es auf den Punkt: Mehr Gedächtnis ist nicht automatisch besser. Es braucht Auswahl, Überprüfung und Organisation.
Das Pokémon-Red-Experiment zeigt diesen Unterschied sehr anschaulich. Nach etwa 10.000 Schritten hatte Sonnet 3.7 413 Dateien und 225 Ordner angelegt, aber nur 1 Orden gewonnen. Fable 5 erstellte dagegen nur 9 gewöhnliche Gedächtnisdateien, 2 Ordner und eine global.md, und holte trotzdem 4 Orden.
Der Unterschied liegt in der Frage, was gemerkt wird. Sonnet 3.7 speicherte massenhaft sich ständig ändernde Spielzustände, die schnell veraltet waren. Fable 5 konzentrierte sich stärker auf Strategien, geprüfte Regeln und Aktionspläne. Daraus ergibt sich ein Designprinzip: Langzeitgedächtnis sollte vorrangig Wissen enthalten, das sich aus der aktuellen Umgebung nur schwer wiedergewinnen lässt. Live-Zustände, die sich jederzeit direkt auslesen lassen, muss man sich nicht merken.
Die 4 Ebenen des Claude-Gedächtnissystems
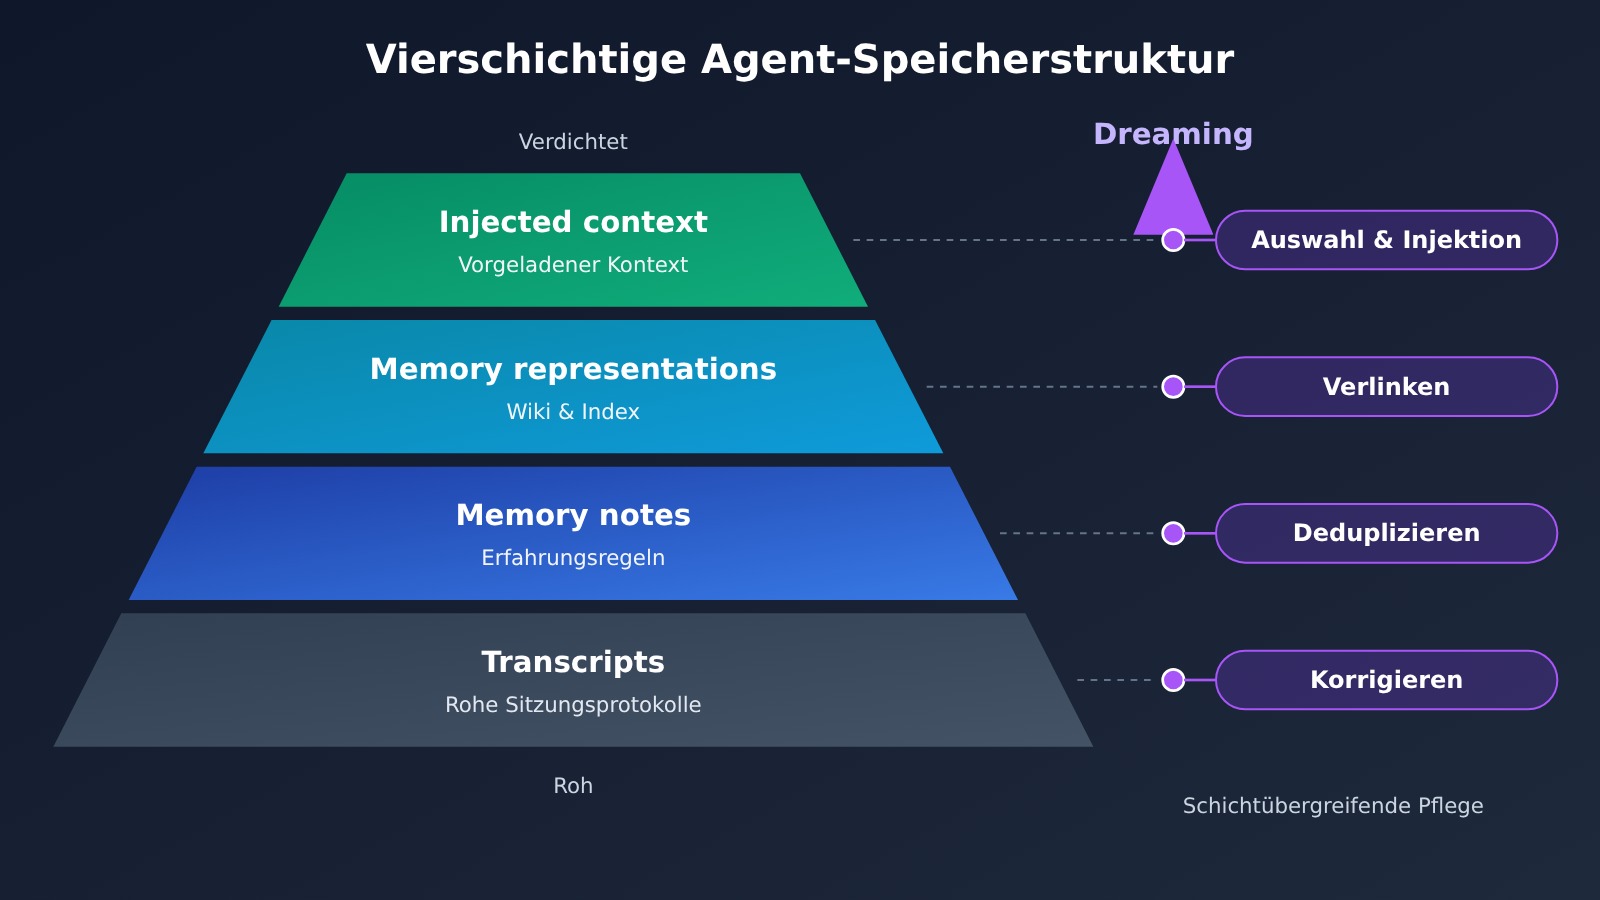
Anthropic teilt das Agent-Gedächtnis in 4 Ebenen auf. Jede Ebene unterscheidet sich in Aufgabe, Schreibhäufigkeit und Lesekosten.
| Ebene | Inhalt | Zweck | Zugriff |
|---|---|---|---|
| Transcripts | Vollständige Sitzungsprotokolle | Durchsuchbares Ereignisprotokoll, das als Rohbeleg für die Rückverfolgung von Fakten dient | Abruf bei Bedarf |
| Memory notes | Wichtige Fakten, Erfahrungen und Regeln, die während einer Aufgabe festgehalten werden | Verdichtet wiederverwendbare Erfahrungen | Lesen bei Bedarf |
| Memory representations | Strukturierte Darstellungen wie Wikis, Indizes und Links | Ordnet die Beziehungen zwischen Wissensbausteinen und ermöglicht dokumentübergreifende Suche | Navigation und Suche |
| Injected context | Kleine Menge besonders wertvoller Erinnerungen | Wird beim Start einer neuen Sitzung vorab geladen | Automatische Injektion |
Diese 4 Ebenen bilden einen Weg vom „Rohen“ zum „Veredelten“. Das Transcript enthält die meisten Informationen, ist aber umfangreich und voller Rauschen. Der Injected context ist am stärksten verdichtet. Dafür belegt jeder einzelne Eintrag Platz im Kontextfenster der neuen Sitzung, weshalb nur Informationen mit der höchsten Salienz (Salience) hineingehören.
Dreaming versteht sich als ebenenübergreifende Pflege. Es geht zurück in die Transcripts, um alte Einträge zu korrigieren, führt doppelte Informationen in den Memory notes zusammen, baut Wikis und Indizes auf und entscheidet, welche Inhalte beim Start einer neuen Sitzung vorab eingespielt werden sollen (Context Injection).
Wie Claude Dreaming Fehler korrigiert, Erinnerungen ordnet und eine Wissensbasis aufbaut
Fehlerkorrektur durch Dreaming: Das Navigationsbeispiel am Mt. Moon
Anthropic hat einen Navigationsfehler dokumentiert. Der Agent hatte die Lage des Pokémon Centers in der Nähe des Mt. Moon falsch gespeichert. In allen folgenden Sitzungen probierte er deshalb immer wieder denselben falschen Weg aus.
Nachdem Dreaming die gespeicherten Transcripts erneut durchgegangen war, fand es den ursprünglichen fehlerhaften Eintrag und korrigierte die Gedächtnisdatei. Der Agent mit dem korrigierten Gedächtnis erreichte Cerulean City bei Aktion Nr. 1.935. Die Version ohne Fehlerkorrektur scheiterte mehrfach auf dieselbe Weise und erreichte ihr Ziel am Ende nicht.
Das Beispiel zeigt: Dreaming fasst nicht bloß zusammen. Es kann zu den ursprünglichen Erfahrungen zurückgehen und prüfen, ob eine Erinnerung noch stimmt. Damit bekommen die gespeicherten Transcripts einen neuen Zweck: Sie sind eine Beweisbasis, die sich immer wieder heranziehen lässt.
Claude-Gedächtniseffekt: Experimentdaten aus CL-Bench
Anthropic hat die Wirkung des Gedächtnisses anhand von Datenbankaufgaben aus CL-Bench 1.0 getestet. Die folgende Tabelle zeigt den offiziell berichteten Mean Reward.
| Modell | Ohne Gedächtnis | Mit Gedächtnis | Verbesserung |
|---|---|---|---|
| Opus 5.5 | 0,655 | 0,838 | +0,183 |
| Sonnet 5.5 | 0,644 | 0,833 | +0,189 |
| Opus 5 | 0,564 | 0,828 | +0,264 |
| Opus 4.7 | 0,383 | 0,700 | +0,317 |
| Sonnet 5 | 0,306 | 0,610 | +0,304 |
| Sonnet 4.6 | 0,330 | 0,364 | +0,034 |
Dabei ist zu beachten: Diese Daten gelten nur für diese eine Aufgabe und sind keine allgemeine Bewertung der Agent-Gedächtnisfähigkeit. Interessanter ist ein anderes Phänomen: Je stärker das Modell, desto eher hält es geprüfte Regeln, Fehlerursachen und mögliche künftige Fallstricke fest, statt einfach den bisherigen Gesprächsverlauf zu übernehmen. Bei Sonnet 4.6 fällt die Verbesserung nur gering aus. Das zeigt, dass die Wirkung eines Gedächtnissystems eng mit der „Aufzeichnungsqualität“ des Modells selbst zusammenhängt.
Dreaming baut eine Wiki-Wissensbasis auf: die Ergebnisse
Das größte Experiment nutzte rund 350.000 interne Dokumente mit insgesamt etwa 420 Mio. Token. Anthropic baute in 128 Dreaming-Sitzungen schrittweise ein Wissens-Wiki auf und bewertete es anschließend mit Frage-Antwort-Aufgaben.
| Abrufmethode | Bewertung | Anmerkung |
|---|---|---|
| Wiki allein (vor → nach dem Aufbau) | 13 % → 48 % | Deutliche Wirkung, sobald das Wiki Gestalt annimmt |
| Search allein | 53 % | Baseline |
| Search + Wiki (vor → nach dem Aufbau) | 54 % → 61 % | Durchschnittlich rund 20.000 Token pro Frage gespart |
| Dokumentübergreifende Synthese-Aufgaben (M&A) | Wiki 87 % vs. reine Search 73 % | Vorteil bei der dokumentübergreifenden Synthese am deutlichsten |
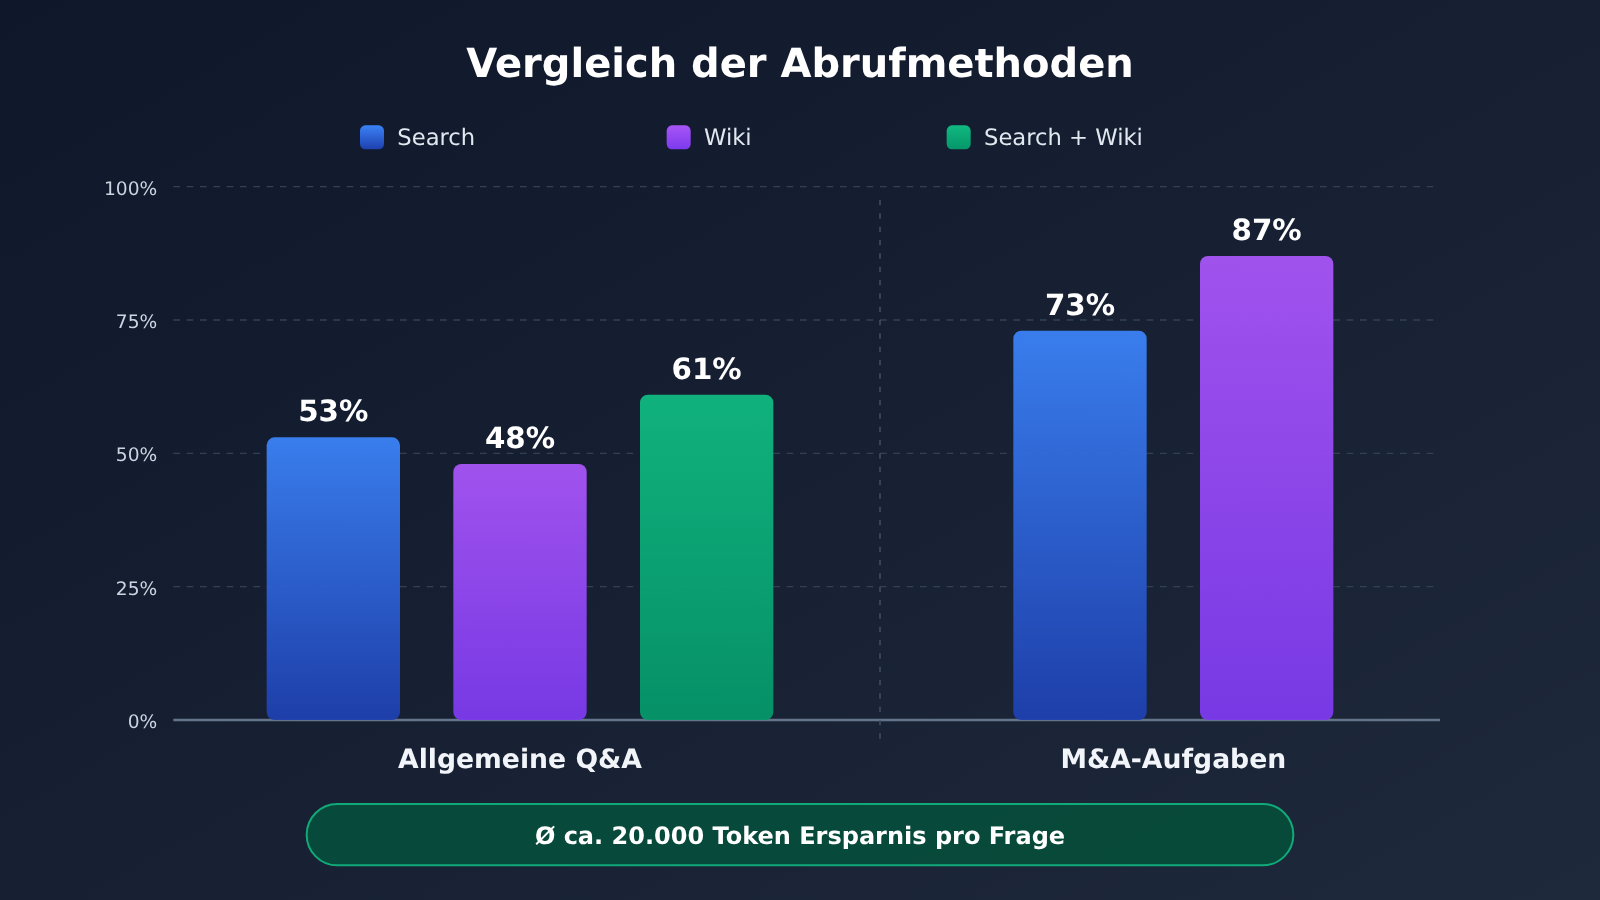
📊 Hinweis zur Grafik: Alle genannten Daten stammen aus den öffentlichen Experimenten im Anthropic-Engineering-Blog. Wenn Sie eine ähnliche kleine Validierung mit Ihrem eigenen Korpus durchführen möchten, können Sie über APIYI (apiyi.com) Claude-Modelle aufrufen und die beiden Varianten „reine Suche“ und „Suche + aufbereitetes Wiki“ hinsichtlich Wirkung und Token-Verbrauch vergleichen.
Der Wert strukturierten Gedächtnisses liegt vor allem in zwei Punkten: Erstens entstehen Verknüpfungen und Indizes, sodass sich Informationen aus mehreren Dateien zusammenführen lassen. Zweitens sinkt die Menge an Originaltext, die bei jedem Abruf neu gelesen werden muss – und damit die Token-Kosten.
Wirkungsanalyse: Warum Claudes Dreaming-Memory-Konsolidierung manchmal hilft und manchmal schadet
Anthropic hat Dreaming nicht als Allheilmittel dargestellt, und der Beitrag nennt mehrere Gegenbeispiele. Genau dieser Teil ist für die Praxis der Softwareentwicklung womöglich wertvoller als die positiven Zahlen.
Fünf technische Risikokategorien bei der Memory-Konsolidierung
- Übermäßiges Speichern: Wie bei Sonnet 3.7 werden massenhaft flüchtige Zustände abgelegt. Das Memory wächst schnell und veraltet ebenso schnell.
- Veraltete Informationen: Die Umgebung ändert sich, das Memory bleibt auf dem alten Stand. Ohne Abgleich mit der Quelle wird der Agent dauerhaft in die Irre geführt.
- Überschreibende Schreibzugriffe bei gemeinsamer Nutzung: Im Experiment zur Vertragskonsolidierung schrieben mehrere Agenten gleichzeitig in dieselbe Übersichtstabelle – von 57 zentralen Fakten blieben nur 41 erhalten, rund 72 %. Nach der Umstellung auf eine eigene Seite pro Vertrag, geschrieben von einem einzelnen Agenten, mit erhaltenen Originalklauseln, blieben alle 57 Fakten erhalten.
- Anschwellende Wiki-Größe: In einem Test umfasste die Ausgangsdatei nur 115 KB, das generierte Wiki wuchs jedoch auf 203 KB – die Konsolidierung führte zu mehr Informationen statt zu weniger.
- Kein Nutzen bei einfachen Aufgaben: Bei Fragen, deren Antwort sich direkt aus einer einzelnen Datei abrufen lässt, brachte das Wiki keine erkennbare Verbesserung, sondern nur zusätzlichen Wartungsaufwand.
Auswirkungen auf Entwickler
- Memory muss geschichtet sein: Rohlogs, Erfahrungsregeln, strukturiertes Wissen und vorab injizierter Kontext werden getrennt abgelegt, jeweils mit eigenen Schreib- und Lesestrategien.
- Quellen müssen nachvollziehbar sein: Jeder Memory-Eintrag sollte sich bis zum zugehörigen Transcript zurückverfolgen lassen – das ist die Voraussetzung für Korrekturen.
- Schreibzugriffe müssen serialisiert oder partitioniert werden: Mehrere Agenten sollten nicht gleichzeitig in dieselbe Datei schreiben; bevorzugt wird eine Struktur „eine Entität, eine Seite“.
- Regelmäßig aufräumen: Auch Wikis und Memory-Notizen müssen dedupliziert, zusammengeführt und ausgemustert werden, sonst wächst das Volumen immer weiter.
Auswirkungen auf die Branche
- Der Forschungsschwerpunkt bei Agent-Memory verschiebt sich von „präzise abrufen“ hin zu „ist das Memory selbst korrekt und wird es gepflegt“.
- Sleep-time Compute dürfte zur Standardarchitektur werden: Konsolidierungsarbeit wird in Leerlaufzeiten verlagert, wodurch die Kontextlast in der Hauptinteraktion sinkt.
- Strukturiertes Memory eignet sich besser für dateiübergreifende, mehrstufige und langfristig aufgebaute Aufgaben. Für einmalige, einfache Frage-Antwort-Situationen bleibt reines Retrieval die wirtschaftlichere Wahl.
Wie Entwickler die Claude-Dreaming-Idee in ihren eigenen Agenten nutzen
Voraussetzungen für die offizielle Dreams-Research-Preview
Laut aktueller Anthropic-Dokumentation gehört Dreams zu Claude Managed Agents und befindet sich im Status Research Preview. Der Zugriff muss beantragt werden. Bei Aufrufen müssen zwei Beta-Header mitgeschickt werden: managed-agents-2026-04-01 und dreaming-2026-04-21.
Als Eingabe dienen ein bestehender Memory Store und 1 bis 100 historische Sessions. Die Ausgabe ist ein neuer Memory Store, der ursprüngliche Store bleibt unverändert. Die Aufgabe läuft asynchron und dauert in der Regel einige Minuten bis mehrere Stunden. Abgerechnet wird nach dem Standard-Token-Preis des gewählten Modells. Unterstützt werden vor allem Opus 5.5 und Sonnet 5.5. Außerdem erfüllt Dreams derzeit weder die Anforderungen für Zero Data Retention noch für HIPAA. Wer sensible Daten verarbeitet, sollte das vorher prüfen.
Dynamische Workflows im Cookbook
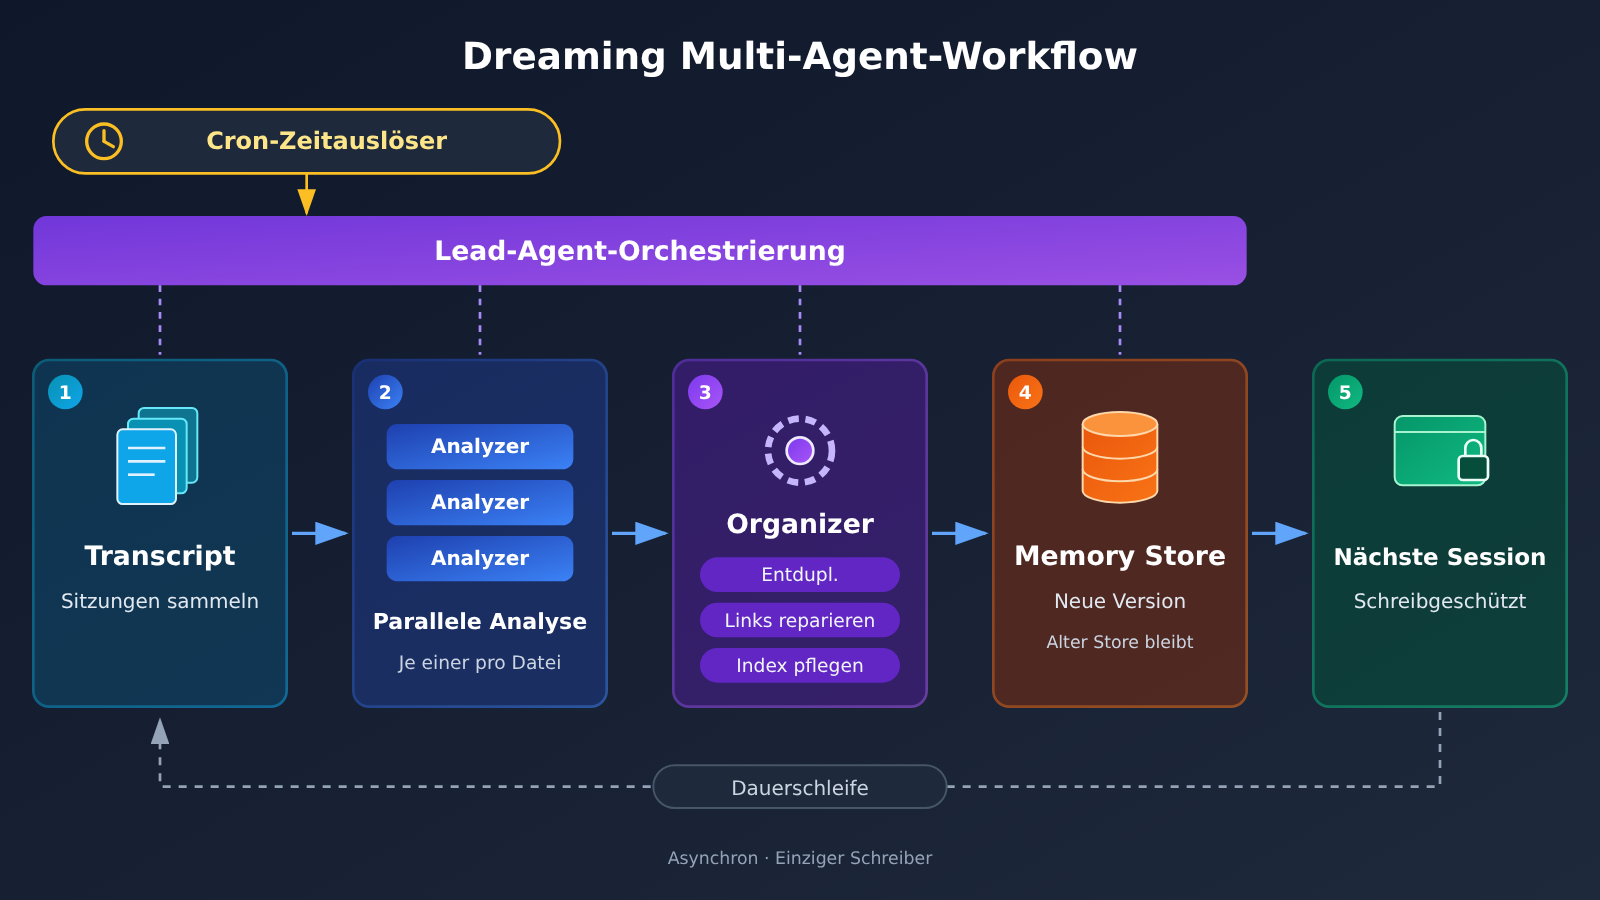
Das offizielle Cookbook enthält einen Multi-Agent-Workflow, den Sie selbst nachbauen können. Standardmäßig orchestriert ein Lead Agent den Ablauf: Jeder Analyzer Agent verarbeitet ein Transcript, und der Organizer Agent entfernt Duplikate, repariert Links und pflegt den Index. Der fertig aufbereitete Memory Store wird bei der nächsten Session eingebunden, in der Regel schreibgeschützt. Alternativ lässt sich das Ganze per Cron zeitgesteuert ausführen, etwa um jede Nacht die Sessions des vergangenen Tages aufzuarbeiten.
Das Cookbook liefert auch Beispiele für die Kosten: 11 Beispiel-Transcripts mit zusammen 283 KB laufen etwa 2,5 Minuten und kosten rund 0,36 $. 50 lange Transcripts mit etwa 12 MB kommen mit kostenoptimierten Einstellungen auf rund 8 $ und dauern etwa 10 Minuten. Das sind allerdings Ergebnisse aus bestimmten Experimenten und keine festen Preise.
Eigenen Prozess zur Gedächtniskonsolidierung zwischen Sitzungen mit Claude-Modellen aufbauen
Vorab eine Klarstellung: APIYI bietet Schnittstellen für den Modellaufruf der Claude-Reihe, aber nicht automatisch Managed Agents, Memory Stores oder die Dreams API. Die Kernidee von Dreaming lässt sich trotzdem mit gewöhnlichen Modellaufrufen selbst umsetzen: Im Hintergrund das Transcript lesen, bewährte Regeln herausfiltern und die Konsolidierung einem einzigen Schreiber überlassen. Das folgende Minimalbeispiel lässt Claude ein Sitzungsprotokoll analysieren und daraus Kandidaten für Erinnerungen ausgeben.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

transcript = open("session_001.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="YOUR_CLAUDE_MODEL",  # Durch ein in der Modellliste verfügbares Claude-Modell ersetzen
    messages=[
        {"role": "system", "content": "只提炼经过验证的规则、错误原因和未来陷阱,忽略易变状态,每条注明来源行号。"},
        {"role": "user", "content": transcript},
    ],
)
print(resp.choices[0].message.content)
Vollständigen Code anzeigen (Analyzer + Organizer mit einem einzigen Schreiber)
import json
import pathlib
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)
MODEL = "YOUR_CLAUDE_MODEL"
MEMORY_DIR = pathlib.Path("memory_store")
MEMORY_DIR.mkdir(exist_ok=True)

ANALYZER_PROMPT = """你是记忆分析器。阅读会话记录,输出 JSON 数组,每项包含:
topic(实体或主题名), rule(经过验证的规则/错误原因/陷阱), evidence(原文出处)。
不要记录每次都能直接从环境读取的实时状态。"""

ORGANIZER_PROMPT = """你是记忆整理器。给定某个主题的旧记忆页面和新候选条目:
1. 与旧记录冲突时,以 evidence 更可靠者为准,并注明修正原因;
2. 合并重复条目;
3. 保留原始证据引用;
输出更新后的 Markdown 页面全文。"""

def analyze(transcript: str) -> list:
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ANALYZER_PROMPT},
            {"role": "user", "content": transcript},
        ],
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return []

def organize(topic: str, items: list) -> None:
    # Ein Thema pro Seite; ein einziger Prozess schreibt seriell, um gegenseitiges Überschreiben bei Nebenläufigkeit zu vermeiden
    page = MEMORY_DIR / f"{topic}.md"
    old = page.read_text(encoding="utf-8") if page.exists() else ""
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": ORGANIZER_PROMPT},
            {"role": "user", "content": f"旧页面:\n{old}\n\n新条目:\n{json.dumps(items, ensure_ascii=False)}"},
        ],
    )
    page.write_text(resp.choices[0].message.content, encoding="utf-8")

def nightly_dream(transcript_files: list) -> None:
    grouped = {}
    for f in transcript_files:
        for item in analyze(pathlib.Path(f).read_text(encoding="utf-8")):
            grouped.setdefault(item.get("topic", "misc"), []).append(item)
    for topic, items in grouped.items():
        organize(topic, items)

# Kann jede Nacht per Cron ausgelöst werden; die nächste Sitzung lädt nur lesend die Indexseiten aus memory_store
nightly_dream(["session_001.txt", "session_002.txt"])
🚀 Tipp für den schnellen Einstieg: Beim Prototyping können Sie über APIYI (apiyi.com) mit demselben API-Schlüssel verschiedene Claude-Modelle als Analyzer und Organizer ausprobieren. Vergleichen Sie, welche Kombination die präziseren Regeln liefert und weniger Token verbraucht, und entscheiden Sie dann über die Konfiguration für die Produktion.
Die beiden Ansätze lassen sich in folgender Tabelle zusammenfassen:
| Vergleichspunkt | Anthropic Managed Agents Dreams | Eigene Gedächtnispflege auf Basis der Modell-API |
|---|---|---|
| Zugang | Research Preview, Zugriff muss beantragt werden, Beta-Header erforderlich | Direkter Aufruf der Claude-Modellschnittstelle |
| Gedächtnisspeicher | Offizieller Memory Store, die Ausgabe ist ein neuer Store | Dateien, Datenbank oder Wiki selbst implementieren |
| Planung und Parallelität | Offizielle asynchrone Aufgaben | Cron, Queue und Single-Writer-Steuerung selbst implementieren |
| Fehlerkorrektur und Berechtigungen | Im offiziellen Ablauf integriert | Quellenabgleich und Berechtigungen müssen selbst entworfen werden |
| Verfügbare Plattformen | Anthropic offiziell | APIYI apiyi.com (Modellaufruf), offizielle API |
Häufige Fragen (FAQ) zu Claude Dreaming
Q1: Was ist Claude Dreaming?
Dreaming ist ein von Anthropic vorgestellter Wartungsprozess für das Gedächtnis, der zwischen Sitzungen im Hintergrund läuft. Er nutzt historische Transcripts, um alte Einträge zu korrigieren, doppelte Informationen zusammenzuführen, ein Wiki samt Index aufzubauen und besonders wertvollen Kontext herauszufiltern, der in neuen Sitzungen vorab eingespielt werden soll.
Q2: Worin unterscheidet sich Dreaming von normalen Sitzungszusammenfassungen und Vektorsuche?
Zusammenfassungen komprimieren Informationen nur, die Suche findet sie nur. Dreaming geht dagegen zurück zum ursprünglichen Transcript und prüft, ob ein Gedächtniseintrag noch stimmt. Im Mt.-Moon-Beispiel wurde so eine falsche Richtungsangabe korrigiert. Außerdem legt Dreaming dokumentübergreifende Verknüpfungen an: Bei Aufgaben, die eine Synthese über mehrere Dateien hinweg erfordern, erreicht das Wiki 87 %, die reine Suche 73 %.
Q3: Kann ich Claude Dreaming schon nutzen?
Der zugehörige Engineering-Blogbeitrag erschien am 6. November 2026. Dreams ist derzeit als Research Preview in Claude Managed Agents verfügbar. Dafür muss man den Zugriff beantragen und beim Aufruf zwei Beta-Header mitsenden.
Q4: Kann ich die Dreaming-Idee auch ohne Zugriff auf Managed Agents nutzen?
Ja. Wenn man dem Ablauf „Transcripts sammeln, Analyse im Hintergrund, Konsolidierung mit einem einzigen Schreiber, schreibgeschütztes Einbinden, regelmäßige Wartung“ folgt, lässt sich mit gewöhnlichen Modellaufrufen eine vereinfachte Variante umsetzen. Über APIYI (apiyi.com) kannst du Claude-Modelle per OpenAI-kompatibler Schnittstelle für Analyse und Konsolidierung aufrufen. Speicherung, Planung und Berechtigungen musst du selbst umsetzen.
Q5: Bietet APIYI Claude Dreaming direkt an?
Nein. APIYI (apiyi.com) stellt Schnittstellen für Modellaufrufe von Claude und anderen Modellen bereit, enthält aber weder Anthropics Managed Agents noch Memory Stores oder die Dreams-API. Der Dienst eignet sich dafür, Modelle aufzurufen und einen eigenen Ablauf zur Gedächtnispflege aufzubauen. Neue Nutzer können ihr Konzept zunächst mit dem kostenlosen Testguthaben prüfen.
Q6: Welche bekannten Einschränkungen hat Dreaming?
Bei einfachen Fragen, die sich mit einer einzigen Datei beantworten lassen, bringt das Wiki keinen nennenswerten Vorteil. Die Konsolidierung kann den Umfang aufblähen: Aus 115 KB Originaltext entstand zum Beispiel ein Wiki mit 203 KB. Wenn mehrere Agents gemeinsam schreiben, gehen Fakten verloren. Das offizielle Dreams erfüllt außerdem noch nicht die Anforderungen für ZDR und HIPAA, und die Laufzeit einer Aufgabe reicht von wenigen Minuten bis zu mehreren Stunden.
Claude Dreaming: Die wichtigsten Erkenntnisse (Key Takeaways)
- Gedächtnis ist mehr als Speicherung: Wer alle Gespräche einfach ablegt, sammelt mit der Zeit Duplikate, veraltete und fehlerhafte Einträge an. Erinnerungen müssen geprüft und organisiert werden.
- Vierschichtige Gedächtnisstruktur: Transcripts, Memory notes, Memory representations und Injected context haben jeweils ihre eigene Aufgabe.
- Fehlerkorrektur hängt von den Rohprotokollen ab: Dreaming greift zum Abgleich auf das Transcript zurück und hat so eine falsche Positionsangabe korrigiert, die zu wiederholten Fehlschlägen geführt hatte.
- Wikis glänzen bei dokumentübergreifenden Aufgaben: Bei der M&A-Aufgabe erreichte das Wiki 87 %, reines Retrieval nur 73 %. Pro Frage spart das im Schnitt etwa 20.000 Token.
- Aufräumen hat auch Nebenwirkungen: Bei gleichzeitigen Schreibzugriffen gehen Fakten verloren, das Wiki wächst stetig, und für einfache Aufgaben bringt es nichts.
- Selbst bauen ist machbar: Über APIYI (apiyi.com) lassen sich Claude-Modelle aufrufen, um eine vereinfachte Variante der Gedächtnisaufbereitung zwischen Sitzungen umzusetzen.
Fazit
Aus Claude Dreaming lassen sich im Kern drei Erkenntnisse mitnehmen:
- Langzeitgedächtnis lebt von Pflege: Nur Erinnerungen, die geprüft, dedupliziert und gut organisiert sind, helfen bei der nächsten Aufgabe zuverlässig weiter.
- Was man speichert, zählt mehr als wie viel: Halten Sie vorrangig Regeln, Fehlerursachen und Stolperfallen fest, die sich aus der Umgebung nur schwer neu ermitteln lassen. Veränderliche Zustände gehören nicht ins Gedächtnis.
- Strukturiertes Gedächtnis hängt vom Einsatzszenario ab: Bei Aufgaben, die mehrere Dateien, viele Durchläufe und langfristig wachsendes Wissen umfassen, lohnt sich ein Wiki. Für einfache Retrieval-Aufgaben lohnt sich der zusätzliche Pflegeaufwand nicht.
Läuft Ihr Agent bereits über mehrere Sitzungen hinweg, starten Sie am besten mit einem minimalen Kreislauf: Transcripts aufbewahren, jede Nacht einmal seriell aufräumen und die Indexseite nur lesend einbinden. Um diesen Ablauf schnell zu testen, können Sie Claude-Modelle über APIYI (apiyi.com) aufrufen. Die Plattform bietet eine OpenAI-kompatible Schnittstelle und für neue Nutzer ein kostenloses Testguthaben.
📚 Referenzen
- The components of agent memory: Originalbeitrag im Anthropic-Engineering-Blog, der die vierschichtige Gedächtnisstruktur und das Dreaming-Experiment vorstellt
- Link:
anthropic.com/research/components-of-agent-memory -
Hinweis: Originalquelle der Versuchsdaten zu CL-Bench, Pokémon, Wiki und Vertragsorganisation
-
Dreaming with a dynamic workflow: Offizielles Claude Cookbook
- Link:
platform.claude.com/cookbook/managed-agents-cma-dreaming-with-a-dynamic-workflow -
Hinweis: Beispiel für einen Multi-Agent-Workflow mit Lead, Analyzer und Organizer samt Kostenreferenz
-
Offizieller Beitrag von Anthropic auf X: Veröffentlichungshinweis zum Dreaming-Engineering-Blog
- Link:
x.com/AnthropicAI/status/2118814753154064501 - Hinweis: Bestätigt den Veröffentlichungszeitpunkt und die offizielle Positionierung
Autor: APIYI Technik-Team
Austausch: Melden Sie sich gern über die APIYI-Startseite bei uns. Weitere Materialien finden Sie im Dokumentationszentrum unter docs.apiyi.com


