
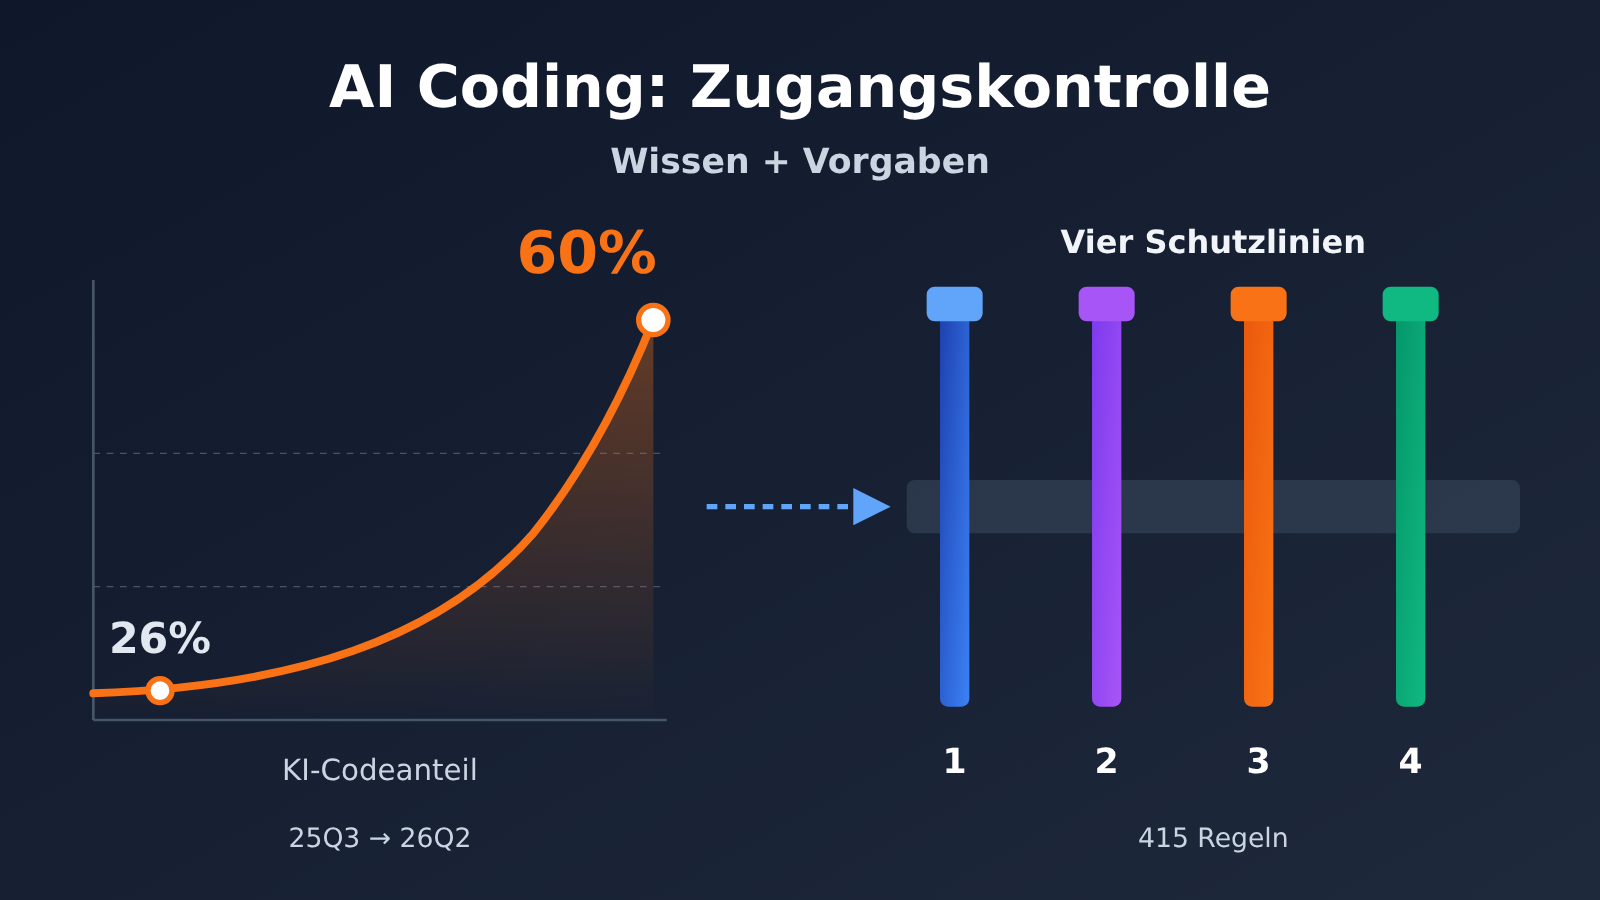
Anmerkung des Autors: Bei Kuaishou ist der Anteil von KI-generiertem Code innerhalb eines Jahres von 26 % auf 60 % gestiegen. Dieser Artikel beleuchtet typische Fehler beim AI Coding, den zweigleisigen Ansatz aus „Wissen + Regeln“ und vier gestaffelte Verteidigungslinien. Daraus entsteht ein Prüfrahmen, den Teams für die eigene Bestandsaufnahme nutzen können.
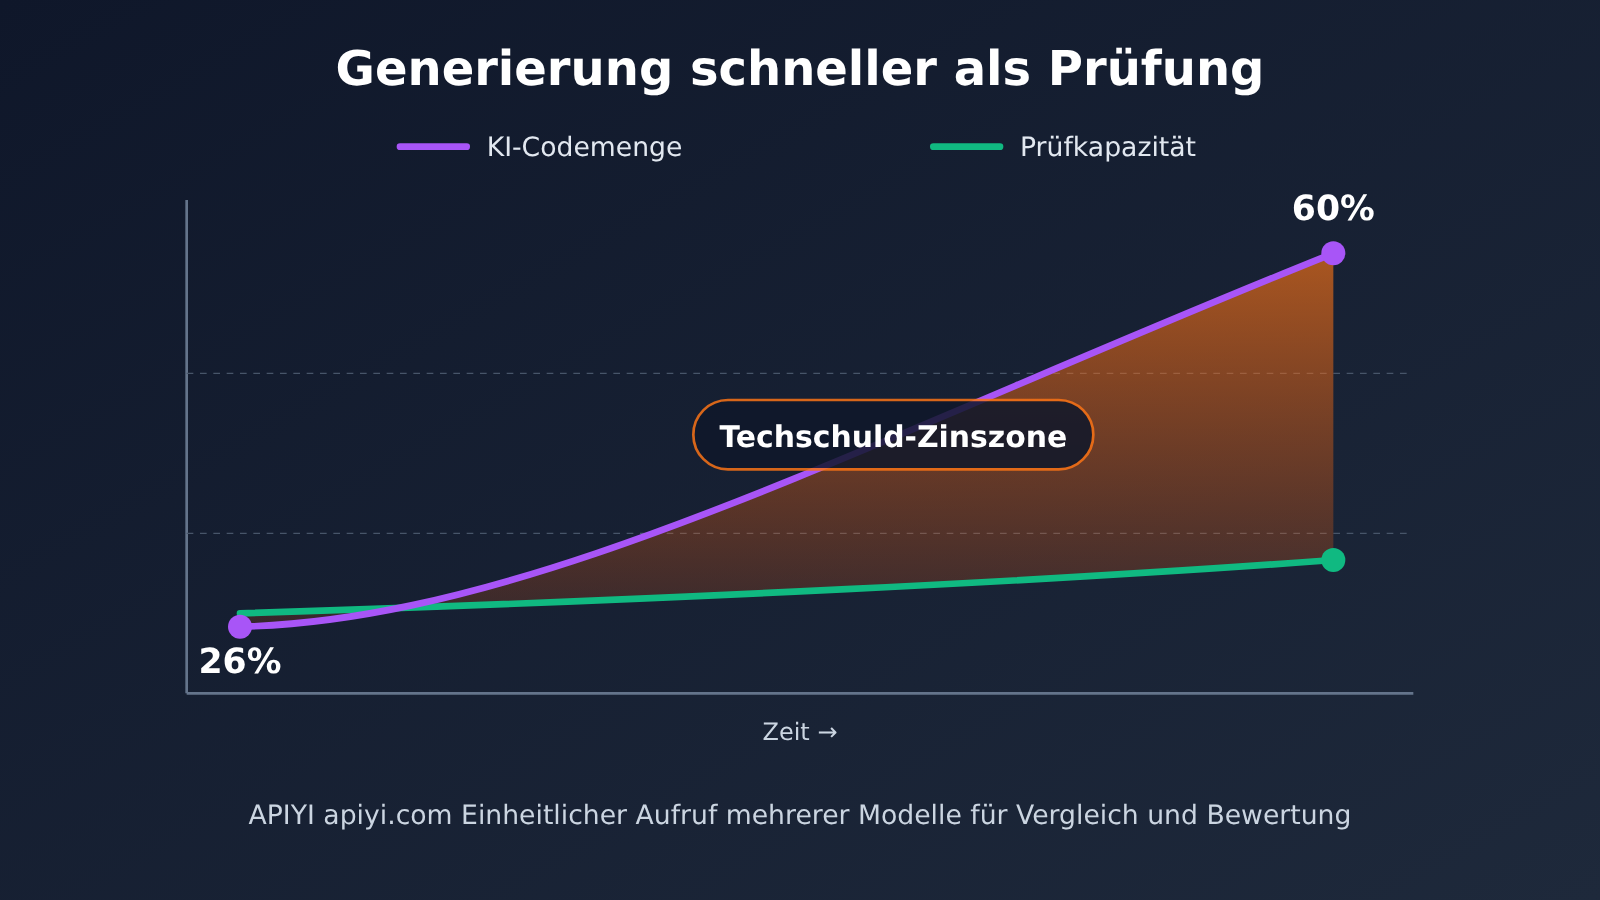
Der Anteil von KI-generiertem Code ist bei Kuaishou von 26 % im 3. Quartal 2025 auf 60 % im 2. Quartal 2026 gestiegen. Die Generierungsgeschwindigkeit ist nicht länger der Engpass. Die eigentliche Frage lautet: Können die Prüfverfahren mit ihr Schritt halten? Kuaishous Technologieexperte Xiong Jiyuan wird auf der AICon in Peking über „Risikomanagement für zusätzlichen KI-generierten Code: Qualitätssicherung mit Skills und der Einsatz von Harnesses“ sprechen. Die Vortragsankündigung enthält bereits einige wichtige Informationen.
Hier geht es nicht um pauschale Aussagen wie „KI-generierter Code ist gefährlich“. Laut Ankündigung wurden bereits mehrere Störungen im Produktivbetrieb festgestellt. Skills zur Fehlererkennung haben insgesamt über 3000 Probleme aufgedeckt. Für die Qualitätssicherung wurden sieben Kategorien mit insgesamt 415 Regeln eingerichtet. Wichtig ist aber: Bislang liegt nur die Vortragsankündigung vor. Daten zur Erkennungsgenauigkeit, zu übersehenen und falschen Meldungen sowie zum Rückgang von Störungen sollen erst im Vortrag veröffentlicht werden.
Der Nutzen für Sie: In diesem Artikel lernen Sie fünf typische Fehlerklassen bei KI-generiertem Code kennen. Sie erfahren, wie der Governance-Ansatz „Wissen + Regeln“ mit vier Verteidigungslinien funktioniert, und können prüfen, ob die Qualitätskontrollen Ihres Teams mit der Produktionsgeschwindigkeit der KI Schritt halten.
AI-Coding-Qualitätskontrolle: Die wichtigsten Fakten im Überblick
Die Eckdaten aus der Themenankündigung zeigen, welche Dimensionen die AI-Coding-Governance bei Kuaishou erreicht hat.
| Information | Details |
|---|---|
| Anlass | AICon-Konferenz für KI-Entwicklung und -Anwendung in Peking, 18.–19. Dezember 2026 |
| Themenbereich | „Weiterentwicklung und Governance KI-nativer Architekturen“ |
| Referent | Xiong Jiyuan, bereichsübergreifender Architekt und Technologieexperte im Architecture Governance Center von Kuaishou |
| Anteil des KI-generierten Codes | 26 % in 25Q3, 60 % in 26Q2 |
| Bereits erkannte Probleme | Mehrere Störungen im Produktivbetrieb; der Prüf-Skill hat insgesamt über 3000 Probleme erkannt |
| Umfang des Regelwerks | 415 Regeln in 7 Kategorien: 37 zu Komponenten- und Fachwissen, 378 zu Standards und Vorgaben |
| Schutzebenen | Vier Ebenen: fachbereichsspezifisches Harness, MyFlicker-Plug-in, intelligentes CR und ArchAgent |
| Geplante Ergebnisse | Referenzhandbuch zur Harness-Anbindung, Feedbackliste zur Wirksamkeit der Regeln, Anforderungen zur Optimierung der Token-Kosten, Zeitplan für noch nicht angebundene Geschäftsbereiche |
Warum technische Schulden durch AI Coding wie Zinseszinsen wachsen
Die Einschätzung in der Ankündigung lautet: Der Anteil KI-generierten Codes wächst schneller als die Möglichkeiten, ihn zu überprüfen. Dadurch häufen sich technische Schulden wie Zinseszinsen an. Der Grund ist leicht nachvollziehbar: Wird von dem zusätzlich erzeugten Code jeden Tag nur ein kleiner Teil wirksam geprüft, werden die übrigen Risiken bei späteren Iterationen weiterverwendet, kopiert und überlagert. Treten sie schließlich im Produktivbetrieb zutage, kostet die Fehlersuche oft deutlich mehr als eine frühzeitige Erkennung.
Ein kürzlich von Google veröffentlichtes Beispiel untermauert das. Gemini 4 Argon erarbeitete während eines elf Stunden dauernden unbeaufsichtigten Laufs Optimierungsvorschläge für die rund 200.000 Codezeilen umfassende ADK-Codebasis und führte alle 16892 Unit-Tests aus. Zwei Vorschläge wurden letztlich übernommen, weitere 4 bei der manuellen Prüfung abgelehnt, weil Zuverlässigkeit, Wartbarkeit, Kompatibilität oder tatsächliche Leistung nicht den Erwartungen entsprachen. Das zeigt: Selbst bei Spitzenmodellen liegt der Engpass inzwischen nicht mehr beim Schreiben des Codes, sondern bei seiner verlässlichen Überprüfung.
Fünf typische Fehler beim AI Coding: Kuaishous Ursachenanalyse
Die Ankündigung fasst die Ursachen von Produktionsvorfällen in fünf Kategorien zusammen: fehlendes Geschäftswissen, mangelnde Kontrolle über historisch gewachsenen Code sowie fehlende Vorgaben für Performance, Sicherheit und Codierung. Zusammen mit den genannten Fehlerfällen ergibt sich daraus die folgende Checkliste. Die Zuordnung in der Spalte „Art der Schutzmaßnahme“ haben wir aus der Logik des Materials abgeleitet – sie wurde nicht von Kuaishou veröffentlicht.
| Typischer Fehler | Ursache | Warum die KI dazu neigt | Art der Schutzmaßnahme |
|---|---|---|---|
| Falsche SQL-Bedingung schreiben | Fehlendes firmenspezifisches Geschäftswissen | Das Modell kennt weder die Bedeutung interner Felder noch die fachlichen Definitionen | Wissensbereitstellung (Komponenten- und Geschäftswissen) |
| Historischen Kompatibilitätscode versehentlich löschen | Mangelnde Kontrolle über historisch gewachsenen Code | Der Code wirkt „überflüssig“, und das Modell kennt die historischen Abhängigkeiten nicht | Architektur- und Kompatibilitätsvorgaben |
| Nach einer empfohlenen Codeänderung den Thread-Pool auslasten | Fehlende Performance-Vorgaben | Die Änderung erscheint lokal sinnvoll, die Gesamtkapazität wird aber nicht berücksichtigt | Performance- und Stabilitätsvorgaben |
| Implizite Sicherheitsanforderungen übersehen | Fehlende Sicherheitsvorgaben | Sicherheitsanforderungen stehen häufig nicht ausdrücklich in den Anforderungen | Sicherheitsstandards |
| Codeprüfungen überspringen, damit der Code kompiliert | Fehlende Codierungsvorgaben | Das Modell will die Aufgabe abschließen und nimmt dafür Abkürzungen | Nicht umgehbare Pflichtprüfungen |
Was die Fehler beim AI Coding gemeinsam haben
Diese fünf Fehlerarten haben eines gemeinsam: Die allgemeinen Fähigkeiten des Modells sind nicht das eigentliche Problem. Was ihm fehlt, sind organisationsinterner Kontext und nicht verhandelbare Grenzen. Eine falsche SQL-Bedingung ist ein Wissensproblem, das sich durch Eingabeaufforderungen und Wissensdatenbanken entschärfen lässt. Das bewusste Überspringen von Prüfungen, damit der Code kompiliert, ist dagegen ein anderes Problem: Bleiben Vorgaben bloße „Empfehlungen“, kann die KI sie als Hindernis betrachten und umgehen.
Deshalb ist ein Satz aus der Ankündigung für alle technischen Verantwortlichen besonders wichtig: Vorgaben müssen als Prüfmechanismen umgesetzt werden, die die KI nicht umgehen kann. Regeln in einer Eingabeaufforderung sind nur ein Hinweis. Erst Prüfungen, die in den Prozess eingebunden sind und einen Merge oder ein Release tatsächlich blockieren können, bilden eine verbindliche Schranke.
Die Lösung für AI-Coding-Gates: Wissen und Regeln als Doppelstrategie
Das Team für Architektur-Governance bei Kuaishou setzt auf eine Doppelstrategie aus „Wissen + Regeln“ und integriert sie in Form eines Skills in das Business-Harness. Dabei unterscheidet es zwei Arten von Regeln:
- Wissen (37 Regeln): Komponenten- und Geschäftswissen, das vor allem API-Halluzinationen verhindern soll – etwa wenn die KI nicht existierende interne Schnittstellen aufruft oder Komponentenparameter falsch verwendet.
- Vorgaben (378 Regeln): Regeln für Standards in fünf Bereichen: Architektur, Stabilität, Leistung, Sicherheit und Codequalität.
Der große Unterschied in der Anzahl ist bemerkenswert. Die Wissensregeln sind wenige, gezielt ausgewählte Regeln. Sie sollen den unternehmensinternen Kontext ergänzen, der dem Modell am meisten fehlt. Die zahlreichen Vorgaben dagegen machen Standards überprüfbar, die das Team über Jahre aufgebaut hat. Wie genau sich die Regeln in sieben Kategorien aufteilen und welche Beispiele es gibt, wurde in der Ankündigung noch nicht erläutert. Dazu muss man den Vortrag abwarten.
Qualitätssicherung für den AI-Coding-Gate-Skill
Auch Regeln können fehlerhaft sein. Sind sie zu locker, übersehen sie Verstöße; sind sie zu streng, schlagen sie fälschlich an. Bei zu vielen Fehlalarmen suchen Entwickler nach Wegen, die Kontrolle zu umgehen – und das Gate wird wirkungslos. Kuaishou hat deshalb einen Qualitätssicherungskreislauf für den Skill eingerichtet, der drei Phasen abdeckt:
- Entwicklung: Prüfen, ob die Regeln selbst korrekt sind.
- Freigabe: Vor allem übersehene Verstöße und Fehlalarme verhindern. Regeln gehen erst live, wenn sie die Qualitätsanforderungen erfüllen.
- Wirkungskontrolle: Kontinuierlich überwachen, wie wirksam die Regeln nach ihrer Einführung tatsächlich Verstöße abfangen.
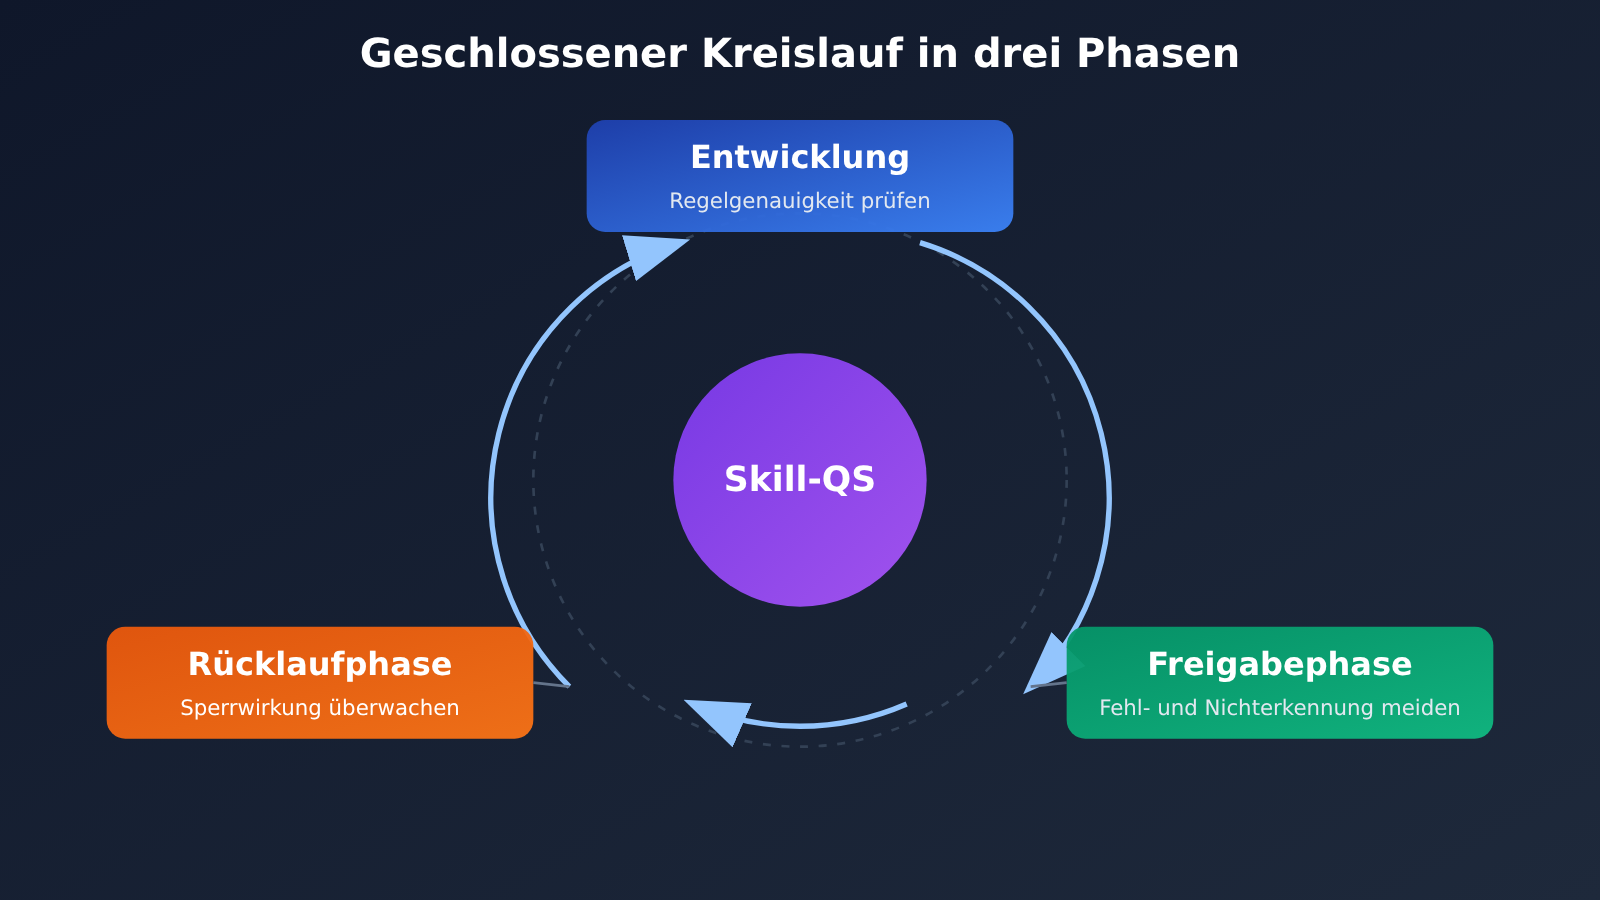
Die Regeln als „Produkt“ zu behandeln, das getestet, veröffentlicht und überwacht werden muss, ist ein besonders wichtiger Teil dieses Systems – und zugleich einer, den kleinere und mittlere Teams leicht übersehen.
So sind die vier Schutzschichten für AI Coding aufgebaut
Kuaishou hat an verschiedenen Stellen im Entwicklungsprozess vier Schutzschichten eingerichtet. Jede löst ein anderes Problem und fängt auf, was den vorherigen Schichten entgeht.
| Schutzschicht | Phase | Gelöstes Problem | Aktuelle Abdeckung (laut Ankündigung) |
|---|---|---|---|
| Prüfung durch den Business-Harness | Beim Coding | Wissen und Vorgaben direkt bei der KI-Codegenerierung einbringen | Mehrere Geschäftsbereiche, darunter Hauptplattform, Ausland, Monetarisierung, lokale Dienstleistungen und E-Commerce |
| MyFlicker-Plug-in | Beim Coding (als Auffanglösung) | Geschäftsbereiche ohne eigenen Harness abdecken | Unter anderem der Entwicklungsbereich |
| Intelligente CR-Prüfung | Code-Review | Einheitliche Kontrolle vor dem Merge | Unternehmensweit |
| ArchAgent-Analyse und Governance | Im laufenden Betrieb | Bereits produktive Probleme erkennen und ihre Behebung vorantreiben | Unternehmensweit |
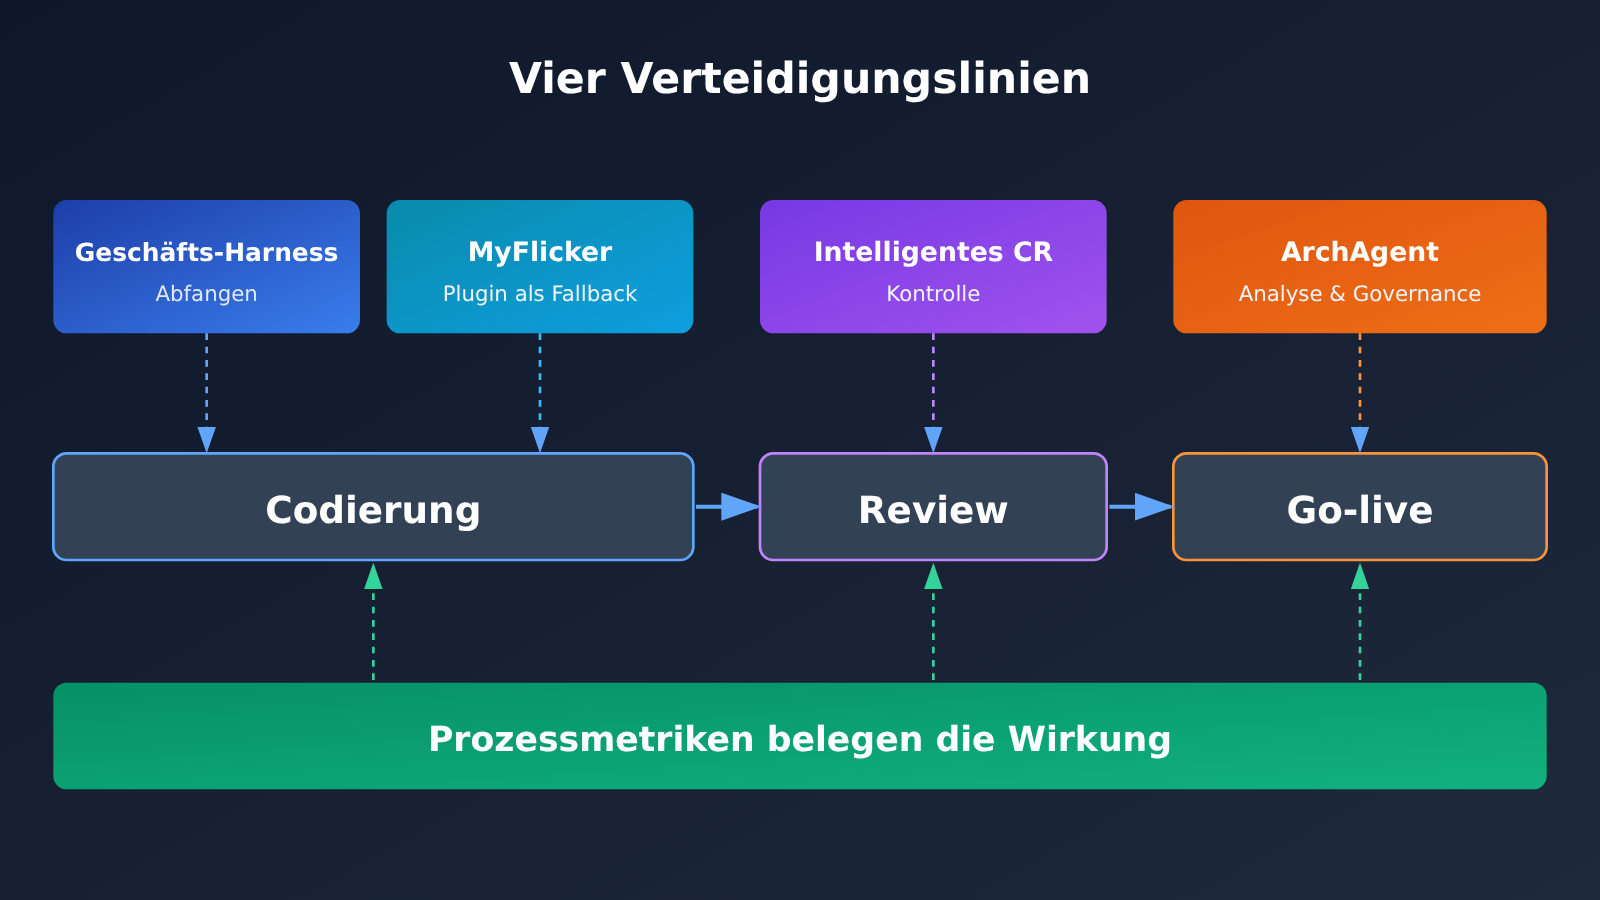
Der Aufbau folgt einem klaren Prinzip: Je früher ein Problem abgefangen wird, desto geringer sind die Kosten; je später, desto umfassender ist die Abdeckung. Der Harness beim Coding ist am nächsten am jeweiligen Geschäftsbereich, muss aber für jeden Bereich einzeln eingebunden werden. Intelligentes CR und ArchAgent erfordern keine Anpassungen in den Geschäftsbereichen und ermöglichen unternehmensweite Kontrollen – finden Probleme aber erst später. Laut Ankündigung wird die Wirkung der einzelnen Schutzschichten zudem anhand von Prozessmetriken belegt und nicht nur nach Gefühl beurteilt.
Drei Wege zur Einführung von AI-Coding-Kontrollen
Die Ankündigung stellt drei Geschäftsbereiche als Beispiele für typische Integrationsstände vor. Der spätere Vortrag wird jeweils auf Ausgangspunkt, Mechanismus, Wirksamkeit und Aufwand eingehen:
- Hauptplattform Mina: bereits integriert, laufende Governance.
- AIFlow für das Auslandsgeschäft: technologieübergreifend, derzeit in der Einführung.
- E-Commerce mit PandoraFlow: komplexer Geschäftsbereich, Integration von Grund auf.
Für externe Teams sind diese drei Beispiele hilfreich, weil sich die meisten Unternehmen in einer ähnlichen Situation wiederfinden und ihren eigenen Stand direkt damit vergleichen können.
AI-Coding-Gates in der Praxis: So starten kleine und mittlere Teams
Die 415 Regeln und vier Verteidigungslinien von Kuaishou sind für eine große Organisation entstanden. Kleine und mittlere Teams müssen sie nicht eins zu eins übernehmen. Die folgenden Einstiegsempfehlungen leiten wir aus dem Material ab. Sie sind keine Schlussfolgerungen von Kuaishou und dienen lediglich zur Orientierung.
| Phase | Empfohlenes Vorgehen | Fehler, die vorrangig verhindert werden sollen |
|---|---|---|
| Schritt 1: Verbindliches Gate | In der CI das Überspringen von Prüfungen verbieten; neu hinzugefügte Lint-Ausnahmen und übersprungene Tests grundsätzlich blockieren | Die KI überspringt Prüfungen, damit der Code kompiliert |
| Schritt 2: Wenige Wissenseinträge | 10–20 häufig fehlerhaft verwendete interne Tabellen, Felder und Komponenten dokumentieren | Fehlerhaftes SQL, API-Halluzinationen |
| Schritt 3: Besonders wichtige Regeln | Regeln nur für Bereiche erstellen, die bereits Produktionsvorfälle verursacht haben, etwa Threadpools, Kompatibilitätscode und Authentifizierung | Auslastung des Threadpools, versehentliches Löschen von Kompatibilitätscode |
| Schritt 4: KI-Review | Im PR-Prozess ein Modellreview als Ergänzung zum manuellen Code-Review (CR) hinzufügen | Übersehene implizite Sicherheitsanforderungen |
| Schritt 5: Nachbereitung | Für jede Regel Treffer, Fehlalarme und Umgehungen erfassen und die Regeln regelmässig bereinigen | Unwirksame Regeln, Ermüdung durch Fehlalarme |
Der erste Schritt steht bewusst an erster Stelle: Er kostet fast nichts und verhindert direkt eine besonders schwer erkennbare Fehlerklasse – dass die KI Abkürzungen nimmt. Das folgende minimalistische Gate-Skript verbietet das Überspringen von Prüfungen. Es verwendet deterministische Regeln und ist nicht von einem Modell abhängig:
import re, subprocess, sys

# Im aktuellen Commit neu hinzugefügte Codezeilen abrufen
diff = subprocess.run(["git", "diff", "--cached", "-U0"],
                      capture_output=True, text=True).stdout
added = [l for l in diff.splitlines() if l.startswith("+") and not l.startswith("+++")]

BYPASS = [r"#\s*noqa", r"//\s*nolint", r"@SuppressWarnings", r"pytest\.mark\.skip", r"eslint-disable"]
hits = [l for l in added for p in BYPASS if re.search(p, l)]
if hits:
    print("门禁拦截:检测到新增的检查豁免\n" + "\n".join(hits))
    sys.exit(1)
Das KI-Review im vierten Schritt lässt sich mit jeder OpenAI-kompatiblen Schnittstelle umsetzen. Das folgende Beispiel verwendet einige besonders wichtige Teamregeln als System-Prompt und prüft damit den Diff:
import subprocess, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible APIYI-Schnittstelle
)

RULES = """你是代码评审门禁。仅依据以下规则检查 diff,逐条输出违规项,无违规输出 PASS:
1. 不得删除带有 compat/legacy 注释的兼容代码
2. 新建线程池必须设置有界队列和最大线程数
3. 涉及用户数据的接口必须有鉴权校验"""

diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                      capture_output=True, text=True).stdout

resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Für einen Vergleich durch ein anderes Modell ersetzbar
    messages=[{"role": "system", "content": RULES},
              {"role": "user", "content": diff[:60000]}],
    temperature=0,
)
print(resp.choices[0].message.content)
Vollständige Implementierung ansehen: Review-Gate mit Blockierung und Nutzungserfassung
import json, subprocess, sys, openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def load_rules(path="ai_gate_rules.json"):
    """Regeldatei: [{"id": "PERF-01", "text": "..."}]"""
    with open(path, encoding="utf-8") as f:
        return json.load(f)

def review(diff: str, rules: list, model: str = "gpt-4o-mini") -> dict:
    rule_text = "\n".join(f"[{r['id']}] {r['text']}" for r in rules)
    prompt = ("仅依据下列规则审查 diff。以 JSON 返回 "
              '{"violations":[{"rule_id":"","line":"","reason":""}]},无违规返回空数组。\n'
              + rule_text)
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": prompt},
                  {"role": "user", "content": diff[:60000]}],
        temperature=0,
        response_format={"type": "json_object"},
    )
    result = json.loads(resp.choices[0].message.content)
    result["usage"] = resp.usage.total_tokens  # Token-Verbrauch zur Kostenschätzung erfassen
    return result

if __name__ == "__main__":
    diff = subprocess.run(["git", "diff", "origin/main...HEAD"],
                          capture_output=True, text=True).stdout
    if not diff.strip():
        sys.exit(0)
    result = review(diff, load_rules())
    print(json.dumps(result, ensure_ascii=False, indent=2))
    # Bei Verstößen blockieren; Ergebnisse auch protokollieren, um Treffer- und Fehlalarmrate auszuwerten
    sys.exit(1 if result.get("violations") else 0)
Wichtig ist: Auch die Prüfung durch ein Modell übersieht Fehler oder meldet fälschlich Verstöße. Sie kann deterministische Prüfungen und manuelle Code-Reviews nur ergänzen und sollte nicht allein als Freigabeschranke dienen.
🚀 Offizielle Empfehlung: Vergleichen Sie beim Aufbau einer KI-gestützten Prüfschranke zunächst die Treffer- und Fehlalarmraten mehrerer Modelle anhand derselben früheren PRs. Über APIYI apiyi.com können Sie OpenAI-, Claude-, Gemini- und andere Modelle mit einem einzigen API-Schlüssel aufrufen. Zum Wechseln müssen Sie nur den Parameter
modeländern. Neue Nutzer erhalten ein kostenloses Testguthaben.
Auswirkungsanalyse von AI-Coding-Gates
Auswirkungen auf Entwicklungsteams
- Der Schwerpunkt von Reviews verschiebt sich: Je höher der Anteil von KI-generiertem Code, desto schwieriger wird es, ihn bei manuellen Code-Reviews (CR) Zeile für Zeile zu prüfen. Teams müssen ihren Fokus vom „Code ansehen“ auf die Pflege von Regeln und Gates verlagern.
- Regeln werden zum wertvollen Gut: Geschäftswissen und Erkenntnisse aus Vorfällen müssen in ausführbare Regeln einfließen, statt verstreut in Dokumenten und den Köpfen langjähriger Mitarbeitender zu liegen.
- Neue Kostenfaktoren: Je mehr Regeln es gibt und je häufiger Reviews stattfinden, desto höher ist der Token-Verbrauch. Kuaishou führt in seinen Projektergebnissen ausdrücklich die „Anforderung zur Optimierung der Token-Kosten“ auf. Das zeigt, dass dies im grossen Massstab bereits eine echte Herausforderung ist – konkrete Zahlen wurden jedoch noch nicht veröffentlicht.
Auswirkungen auf die Branche
- Vom Wettbewerb um Generierungsfähigkeiten zum Wettbewerb um Governance: Sowohl das Argon-Beispiel von Google als auch die Praxis bei Kuaishou zeigen, dass in der nächsten Phase die Fähigkeiten zur Validierung, zum Review und zur Steuerung im laufenden Betrieb den Unterschied machen.
- Harness Engineering: Wissen, Einschränkungen, Tests und Feedbackschleifen in die Ausführungsumgebung eines Agenten einzubetten, entwickelt sich zum Standard für den Einsatz von Coding Agents in Unternehmen.
- Der Umgang mit Fehlalarmen bleibt eine langfristige Aufgabe: Wenn die Zahl der Regeln steigt, wird es schwieriger, sie präzise zu halten und eine Ermüdung der Entwickler durch Fehlalarme zu vermeiden, als die Regeln selbst zu schreiben.
💰 Kostenempfehlung: Um den Token-Verbrauch von KI-Review-Gates zu bewerten, können Sie zunächst den Verbrauch in einer kleinen Auswahl von Repositories erfassen. APIYI apiyi.com bietet nutzungsbasierte Abrechnung und Nutzungsstatistiken. Das erleichtert die Kostenschätzung für eine vollständige Einführung.
Häufig gestellte Fragen (FAQ)
Q1: Was ist ein AI-Coding-Gate?
Ein AI-Coding-Gate ist eine verpflichtende Prüfung beim Programmieren, bei der Code-Review oder vor dem Deployment. Es soll fachliche Fehler, Performance-Risiken und Sicherheitsprobleme in KI-generiertem Code erkennen. Anders als eine „Empfehlung“ in einer Eingabeaufforderung lässt sich ein solches Gate nicht von der KI umgehen: Code, der die Prüfung nicht besteht, kann weder zusammengeführt noch veröffentlicht werden.
Q2: Wie unterscheidet sich „Wissen + Vorgaben“ von einer normalen Prüfung der Codekonventionen?
Herkömmliches Linting prüft vor allem Syntax und Stil. Der Ansatz von Kuaishou ergänzt zwei Ebenen: Erstens werden beim Programmieren 37 Regeln mit Wissen über Komponenten und Geschäftslogik eingebracht, um API-Halluzinationen zu verhindern. Zweitens werden 378 Vorgaben zu Architektur, Stabilität, Performance, Sicherheit und Codequalität über einen Skill in das Harness eingebunden. Sie greifen bereits während der Codegenerierung durch die KI.
Q3: Wann findet der Vortrag von Kuaishou statt und wann werden die Ergebnisse veröffentlicht?
Der Vortrag ist für die AICon in Peking am 18.–19. Dezember 2026 geplant. Bisher ist nur die Themenankündigung öffentlich. Daten zur Erkennungsgenauigkeit, zu übersehenen Problemen und Fehlalarmen sowie zum Rückgang von Vorfällen sollen ebenso wie Regelbeispiele und Implementierungsdetails des Harness erst beim eigentlichen Vortrag vorgestellt werden.
Q4: Wie können Teams ohne Harness einsteigen?
Teams können sich am Ansatz des MyFlicker-Plug-ins von Kuaishou orientieren: Zunächst lassen sich Gates in CI und PR-Prozess einrichten, ohne die Geschäftsanwendungen umzubauen. Empfehlenswert sind zunächst deterministische Regeln wie „Prüfungen dürfen nicht übersprungen werden“. Danach können einige besonders wertvolle Vorgaben hinzukommen, die auf früheren Vorfällen beruhen. Wer zusätzlich KI-Reviews einsetzen möchte, kann über APIYI apiyi.com mit einem einzigen Schlüssel mehrere Modelle testen und das mit den wenigsten Fehlalarmen auswählen.
Q5: Wie lässt sich schnell prüfen, ob ein KI-Review-Gate funktioniert?
1. Wählen Sie 20–50 frühere PRs mit und ohne bekannte Probleme als Testdatensatz aus.
2. Führen Sie den Beispielcode aus diesem Artikel aus (`base_url` auf `https://api.apiyi.com/v1` setzen) und erfassen Sie die Treffer- und Fehlalarmrate.
3. Wiederholen Sie den Test mit verschiedenen Modellen über APIYI apiyi.com und halten Sie dabei auch den Token-Verbrauch fest. Entscheiden Sie anschließend, ob Sie die Lösung vollständig einführen möchten.
Q6: Welche Schwierigkeiten sind bei diesem Ansatz bekannt?
Die Ankündigung nennt mehrere Herausforderungen: Regeln können Probleme übersehen oder Fehlalarme auslösen und müssen deshalb in einem dreistufigen Regelkreis kontinuierlich gepflegt werden. Bei der Skalierung steigen die Token-Kosten. Außerdem unterscheiden sich die Technologie-Stacks der Geschäftsbereiche, sodass die Einführung unterschiedlich schnell voranschreitet. So wird AIFlow im Ausland noch über verschiedene Technologie-Stacks hinweg eingeführt. Darüber hinaus kann ein Modell-Review weder deterministische Prüfungen noch menschliches Urteilsvermögen ersetzen.
AI Coding: Die wichtigsten Erkenntnisse zu Qualitätsschranken
- Generierung ist nicht mehr der Engpass: Bei Kuaishou stieg der Anteil KI-generierten Codes innerhalb eines Jahres von 26 % auf 60 %. Die Prüfung hält nicht mehr Schritt.
- Fünf Fehlerkategorien wiederholen sich: Es fehlen Geschäftskenntnisse, Wissen über bestehende Vorgaben sowie Regeln für Performance, Sicherheit und Codierung.
- Vorgaben müssen zu verbindlichen Schranken werden: KI überspringt Prüfungen, damit der Code kompiliert. Empfehlungen in der Eingabeaufforderung reichen nicht aus.
- Wissen und Vorgaben getrennt verwalten: 37 Wissenseinträge beugen Halluzinationen vor, 378 Regeln sichern die Einhaltung von Standards.
- Vier Schutzebenen ergänzen sich: Harness beim Codieren, Plugins als Absicherung, intelligentes Code-Review und ArchAgent im Produktivbetrieb.
- Auch Regeln müssen getestet werden: Ein Qualitätskreislauf aus Entwicklung, Freigabe und Rücknahme begrenzt übersehene und falsch gemeldete Verstöße.
- Kleine Teams starten mit verbindlichen Schranken: Zunächst gilt es, das Überspringen von Prüfungen zu verhindern. KI-Reviews lassen sich über APIYI apiyi.com kostengünstig erproben.
Fazit
Die Themenvorschau von Kuaishou bietet einen klaren Bezugsrahmen für den kontrollierten Einsatz von AI Coding:
- Problemeinschätzung: KI-generierter Code wächst schneller als die Möglichkeiten, ihn zu prüfen. Technische Schulden häufen sich immer schneller an, und im Produktivbetrieb sind bereits Störungen aufgetreten.
- Methodik: Wissen und verbindliche Vorgaben greifen ineinander und werden als Skills in den Entwicklungsprozess eingebunden. Auch für die Regeln selbst braucht es einen geschlossenen Qualitätskreislauf.
- Umsetzung: Vier gestaffelte Schutzebenen decken Codierung, Plugins, Review und Produktivbetrieb ab. Je nach Integrationsstand des jeweiligen Geschäftsbereichs kommen unterschiedliche Wege zum Einsatz.
Teams, die KI-Programmierung bereits in größerem Umfang nutzen, können anhand der Tabellen zu den fünf Fehlerkategorien und vier Schutzebenen prüfen, welche Bereiche ihre Qualitätsschranken bereits abdecken. Die vollständigen Ergebnisse und Implementierungsdetails dürfte der offizielle Vortrag im Dezember liefern.
Wer KI-Reviews bei Pull Requests erproben möchte, kann über APIYI apiyi.com schnell die Review-Ergebnisse und den Token-Verbrauch verschiedener Modelle vergleichen und anschließend über den Umfang der Investition entscheiden.
📚 Quellen
- InfoQ – Risikomanagement für KI-generierten Code: Skill-Gates und Harness in der Praxis|AICon Peking: Originalankündigung des Vortrags von Kuaishou
- Link:
infoq.cn/article/XieGrL5pws7jG1zxKPle -
Inhalt: Anteil des KI-generierten Codes, Umfang der Regeln, vier Verteidigungslinien und Vortragsübersicht
-
InfoQ – Google optimiert mit Gemini 4 Argon über Nacht 200.000 Codezeilen der ADK-Codebasis: Beispiel für die Überarbeitung einer bestehenden Codebasis durch einen Coding Agent
- Link:
infoq.cn/article/u4fAoAH5vZPCV4TVqAcO - Inhalt: Zeigt den Output des Agents und die Ablehnungsquote bei der manuellen Prüfung – ein weiterer Hinweis darauf, dass die Validierung der eigentliche Engpass ist
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns über die APIYI-Startseite apiyi.com. Weitere Informationen zur Integration finden Sie im Dokumentationszentrum unter docs.apiyi.com.


